Qwen Image 2.0 Native 2K
Qwen Image 2.0 是 Alibaba Cloud Qwen 团队推出的新一代图像模型。它支持文本和图像输入,可原生输出 2K 图像,在创作和修改工作流中提供更强的语义一致性、更逼真的细节以及更精准的指令遵循能力。Atlas Cloud 为这两种模式提供开箱即用的 REST endpoints,无冷启动,标准价格为每张图像 $0.035。立即开始构建。
Qwen Image 2.0 由 Alibaba 开发。Atlas Cloud(由 Atlas Cloud AI LLC 运营)仅提供接入服务,并不拥有该模型。所有商标均归其各自所有者所有。
探索领先模型
Atlas Cloud 为您提供最新的行业领先创意模型。


Qwen Image 2.0 生成与编辑模式
比较两个 Qwen Image 2.0 端点,用于创建和优化最高 2K 分辨率的图像。
| 模态 | 描述 |
|---|---|
| Qwen Image 2.0 Text to Image API | 将文本提示词转换为最高 2K 分辨率的图像,并提升提示词理解能力和图像质量。适用于概念艺术、产品图像、营销素材及其他基于提示词的视觉工作流。 |
| Qwen Image 2.0 Edit API | 专为图像编辑而设计,可将文字指令应用于现有视觉素材,并生成最高 2K 分辨率的结果。适用于素材优化、创意变体、定向视觉修改及迭代式生产工作流。 |
Qwen Image 2.0:从提示词到精准成片
Qwen Image 2.0 支持最高 2K 输出,具备更强的提示词理解能力、双语文本渲染、参考图引导编辑和可复现种子,并通过 Atlas Cloud REST 提供透明的按量付费价格。
Qwen Image 2.0 2K 细节表现
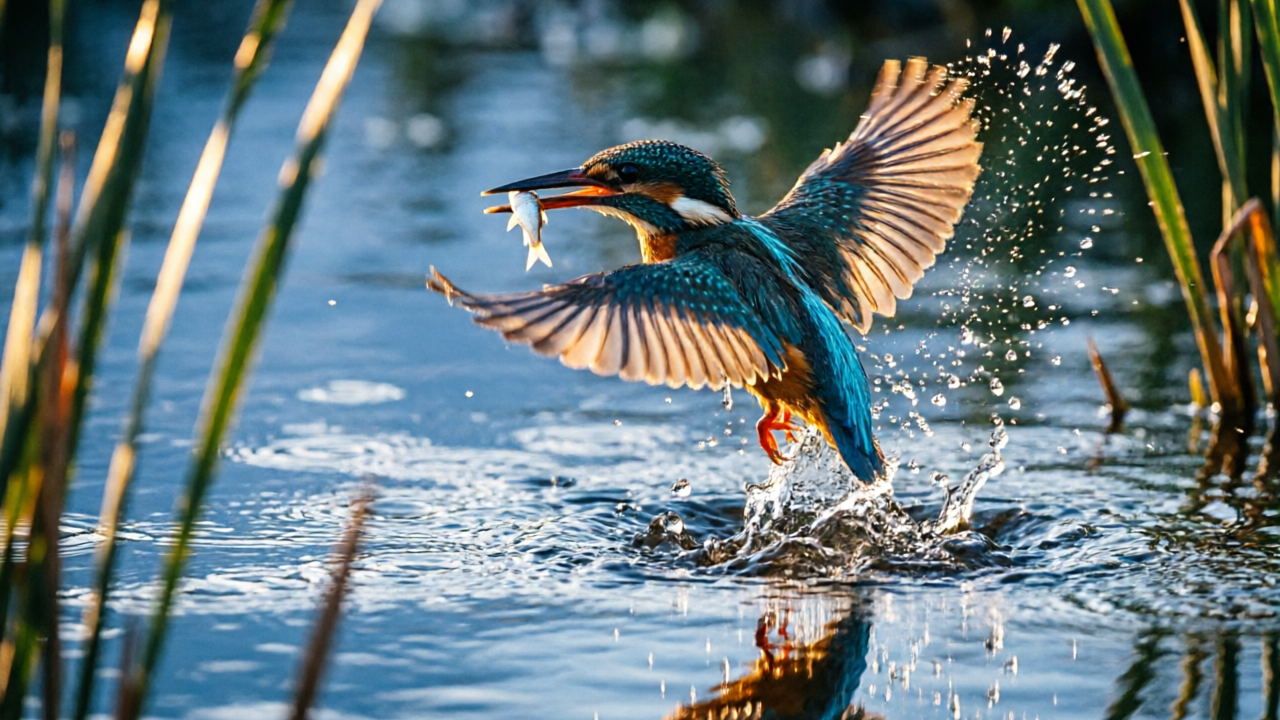
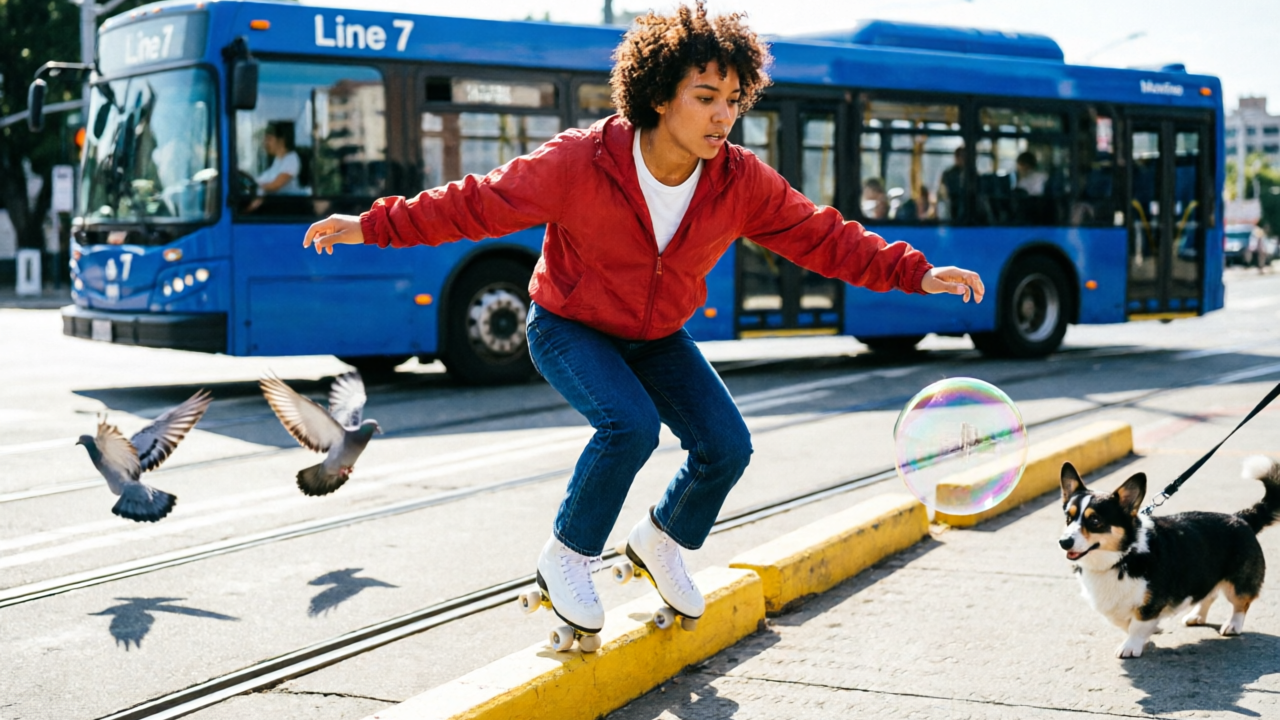
Qwen Image 2.0 支持生成每边 512 至 2048 像素的图像,最高可达 2K 输出。增强后的图像质量能够保留细腻的表面质感、层次丰富的场景和画面中的微小视觉点缀。选择与交付格式匹配的尺寸即可。该模型非常适合产品视觉、编辑摄影和细节丰富的概念艺术创作。
Qwen Image 2.0 提示词控制
通过最多 800 个字符的中英文提示词,可以轻松组织结构化创意需求。在一条指令中描述主体、光照、构图、材质和动作,并在需要可复现迭代时使用固定种子。更强的提示词理解能力有助于保持多个指定元素之间的关系。复杂概念在营销活动、建筑场景和定向创意工作流中也能获得更可预测的结果。
双语排版
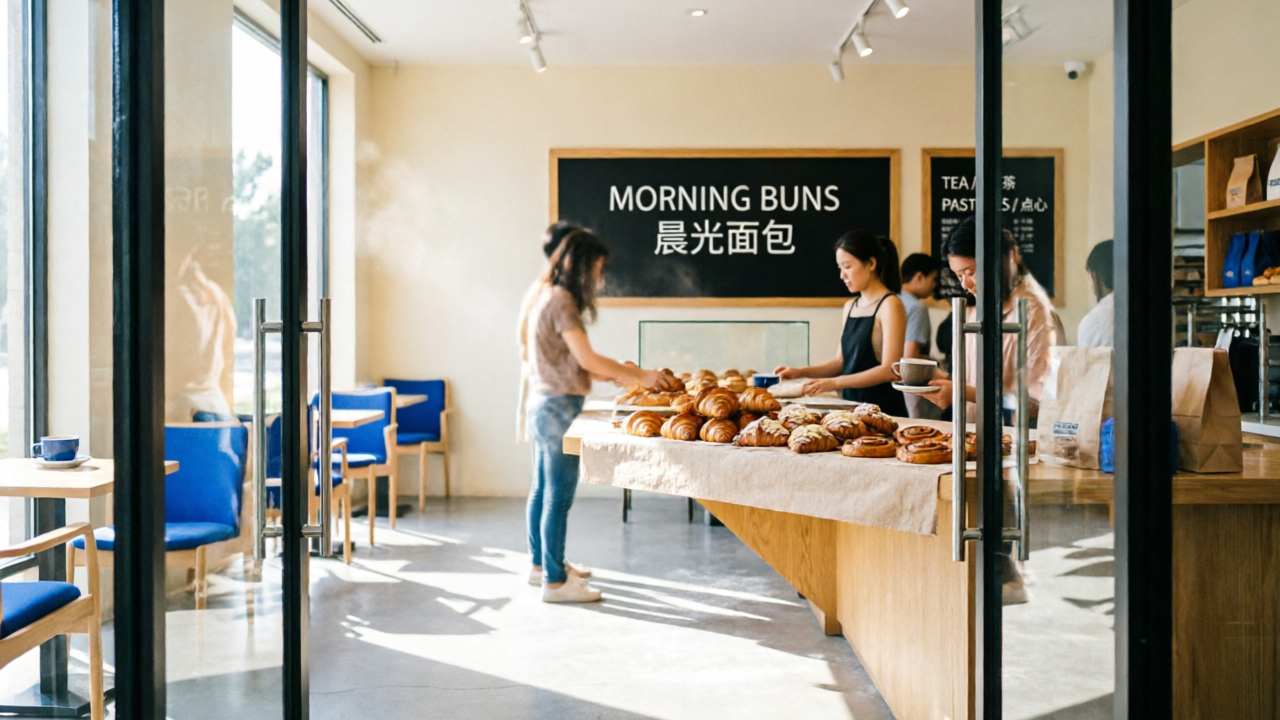
清晰易读的英文和中文文本可以融入密集且经过精心编排的视觉画面中。模型将多语言渲染与可靠的构图能力结合起来,帮助标签、标牌、标题和辅助图形与周围场景保持协调。双语设计可以直接成为图像的一部分,而无需单独叠加文字图层。适用于宽幅宣传图、演示文稿视觉、菜单和信息密集型艺术作品,减少原本需要的大量人工清理工作。
参考图引导编辑
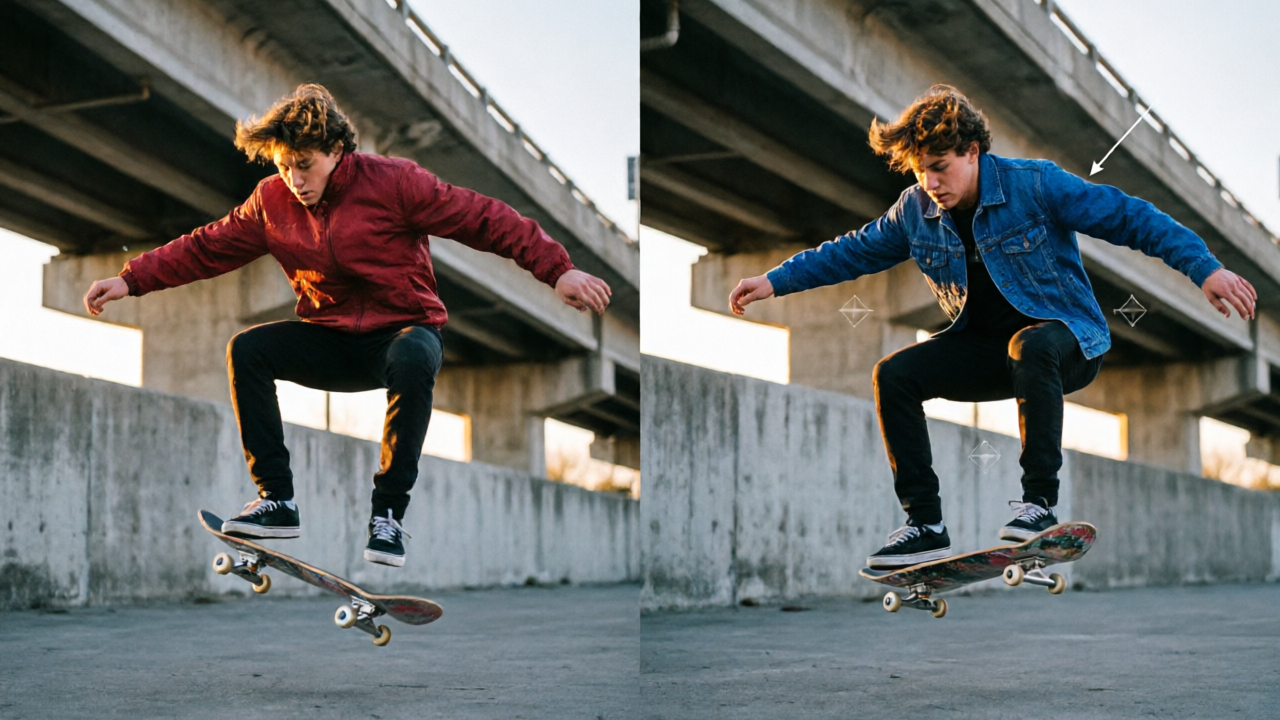
提供 1 至 3 张参考图,然后用自然语言描述所需的编辑效果。编辑 endpoint 接受最多 800 个字符的指令,并可在使用种子进行可重复运行的同时返回最高 2K 的图像。这种受控工作流适合产品修改、视觉风格重塑和迭代式创意开发,无需从头重建源构图。
可复现的画布控制
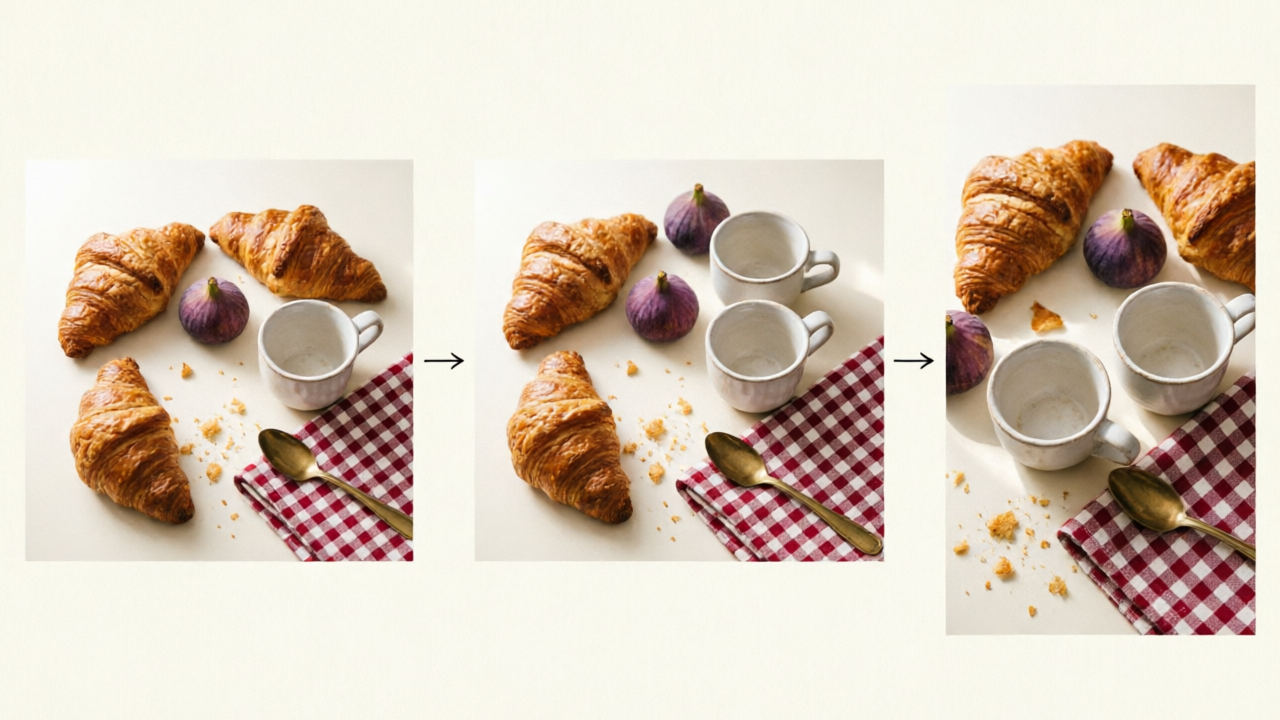
输出尺寸支持每边 512 至 2048 像素,种子支持 0 至 2147483647 的取值范围。默认值为负一时仍可使用随机种子。根据正方形、横向或纵向需求匹配画布,同时保留可复现的起始点。这些控制项简化了系统化测试,并有助于在多个投放位置持续生成风格一致的素材。
Qwen Image 2.0 REST 访问
Atlas Cloud 通过 REST endpoint 提供文生图和图像编辑能力,标准价格为每张图像 $0.035。开箱即用的推理服务、无需冷启动以及 Day 0 访问权限,免去了模型托管工作;统一 API 则确保整个模型系列的集成方式保持一致。该方案支持原型开发、生产工具和可扩展的图像处理流水线,并采用透明的按量付费计费方式。
Qwen Image 2.0:同一条提示词驱动三种图像模型
看看 Qwen Image 2.0 与另外两种同类图像模型,如何使用完全相同的提示词诠释精确的平面设计与快速变化的纪实摄影。
一部电影感十足的“桌面灾难片幕后花絮”,定格在决定性瞬间:年轻模型制作者的一只逼真手部伸入画面,试图扶稳一座被突然从乳白色茶杯中喷涌而出的高耸巨浪撞得侧翻的微型灯塔;几名携带海军蓝摄像机、三脚架、线缆和灯光设备的微型剧组人员惊慌逃窜。一块字迹清晰的微型场记板上准确写着“最后一只茶杯”和“第07镜”,字体干净且拼写正确。手工定格动画的触感与写实微距摄影相融合,突出人类尺度与微缩尺度之间幽默的碰撞。低机位贴近桌面拍摄;缠绕的电缆与闪亮的水痕形成强烈的引导线,指向倾斜的灯塔和茶杯;一个失焦的金属螺丝部分遮挡极近前景,营造层次丰富的景深与尺度错觉。午间强烈的定向阳光穿过百叶窗,在布景上投下清晰的条纹阴影;悬浮水滴闪闪发光,逃跑剧组人员身上带有细微的运动模糊。严格限定为乳白色、海军蓝和安全橙三色。极具说服力的老木纹、浸湿并隆起的纸浆、剥落的微缩模型漆面、刮花的金属、潮湿织物,以及具有准确物理折射、表面张力、飞溅效果和空间关系的透明水体。中央灾难周围动作密集,画面边缘则保留更安静的负空间;保留手工制作的不完美质感、克制的细腻胶片颗粒、浅景深、微距镜头、近距离对焦、真实的光学衰减、高级实拍特效摄影质感;不要油腻的过度渲染,不要类似 HDR 的满屏细节,不要塑料质感的皮肤,不要浑浊或脏污的色偏,不要无处不在的光晕,不要廉价的史诗奇幻灯光,不要黑暗的水下或太空废墟美学,宽幅水平 16:9 画幅,满版构图。
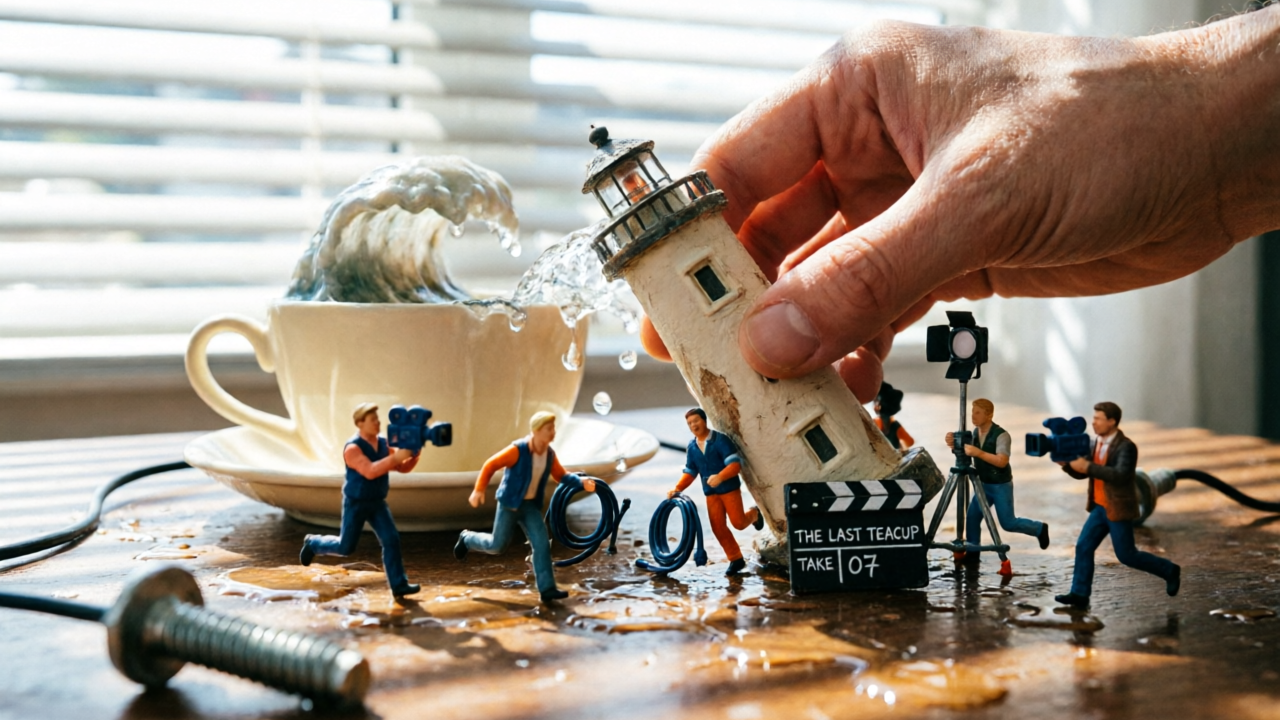
Generated with Qwen Image 2.0 Text-to-image on Atlas Cloud
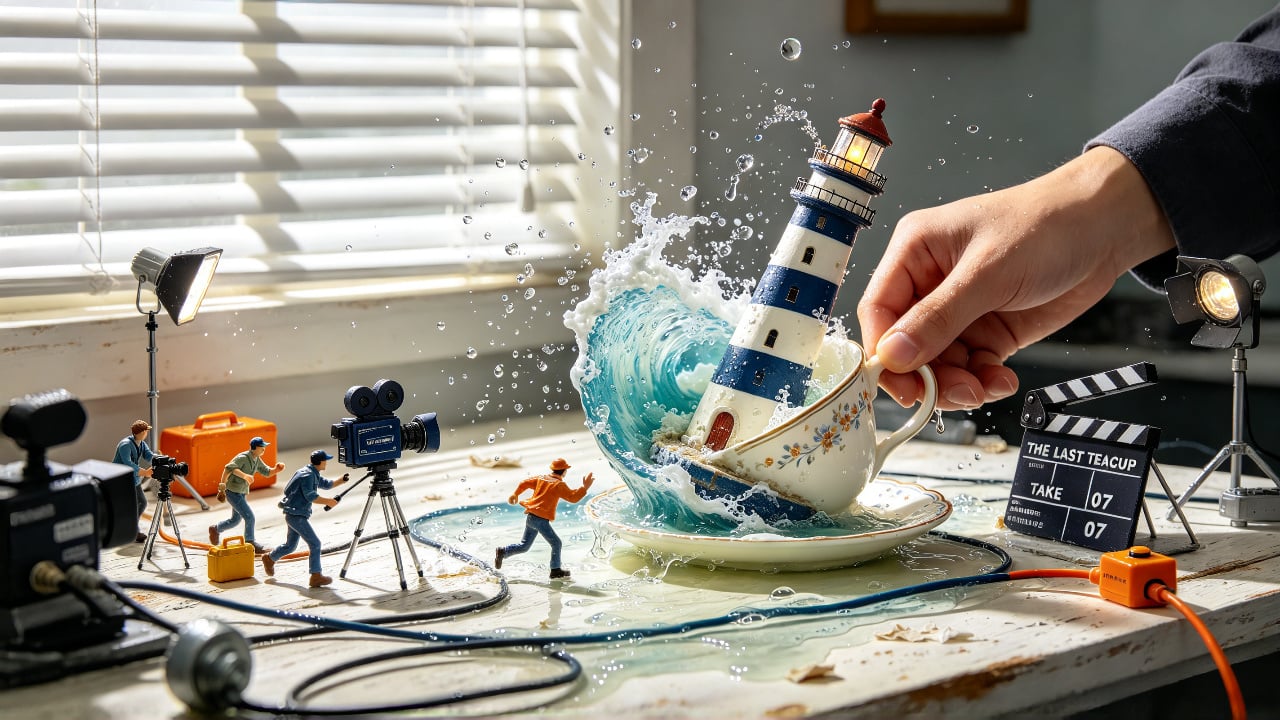
Generated with Seedream v4.7 Text-to-Image on Atlas Cloud
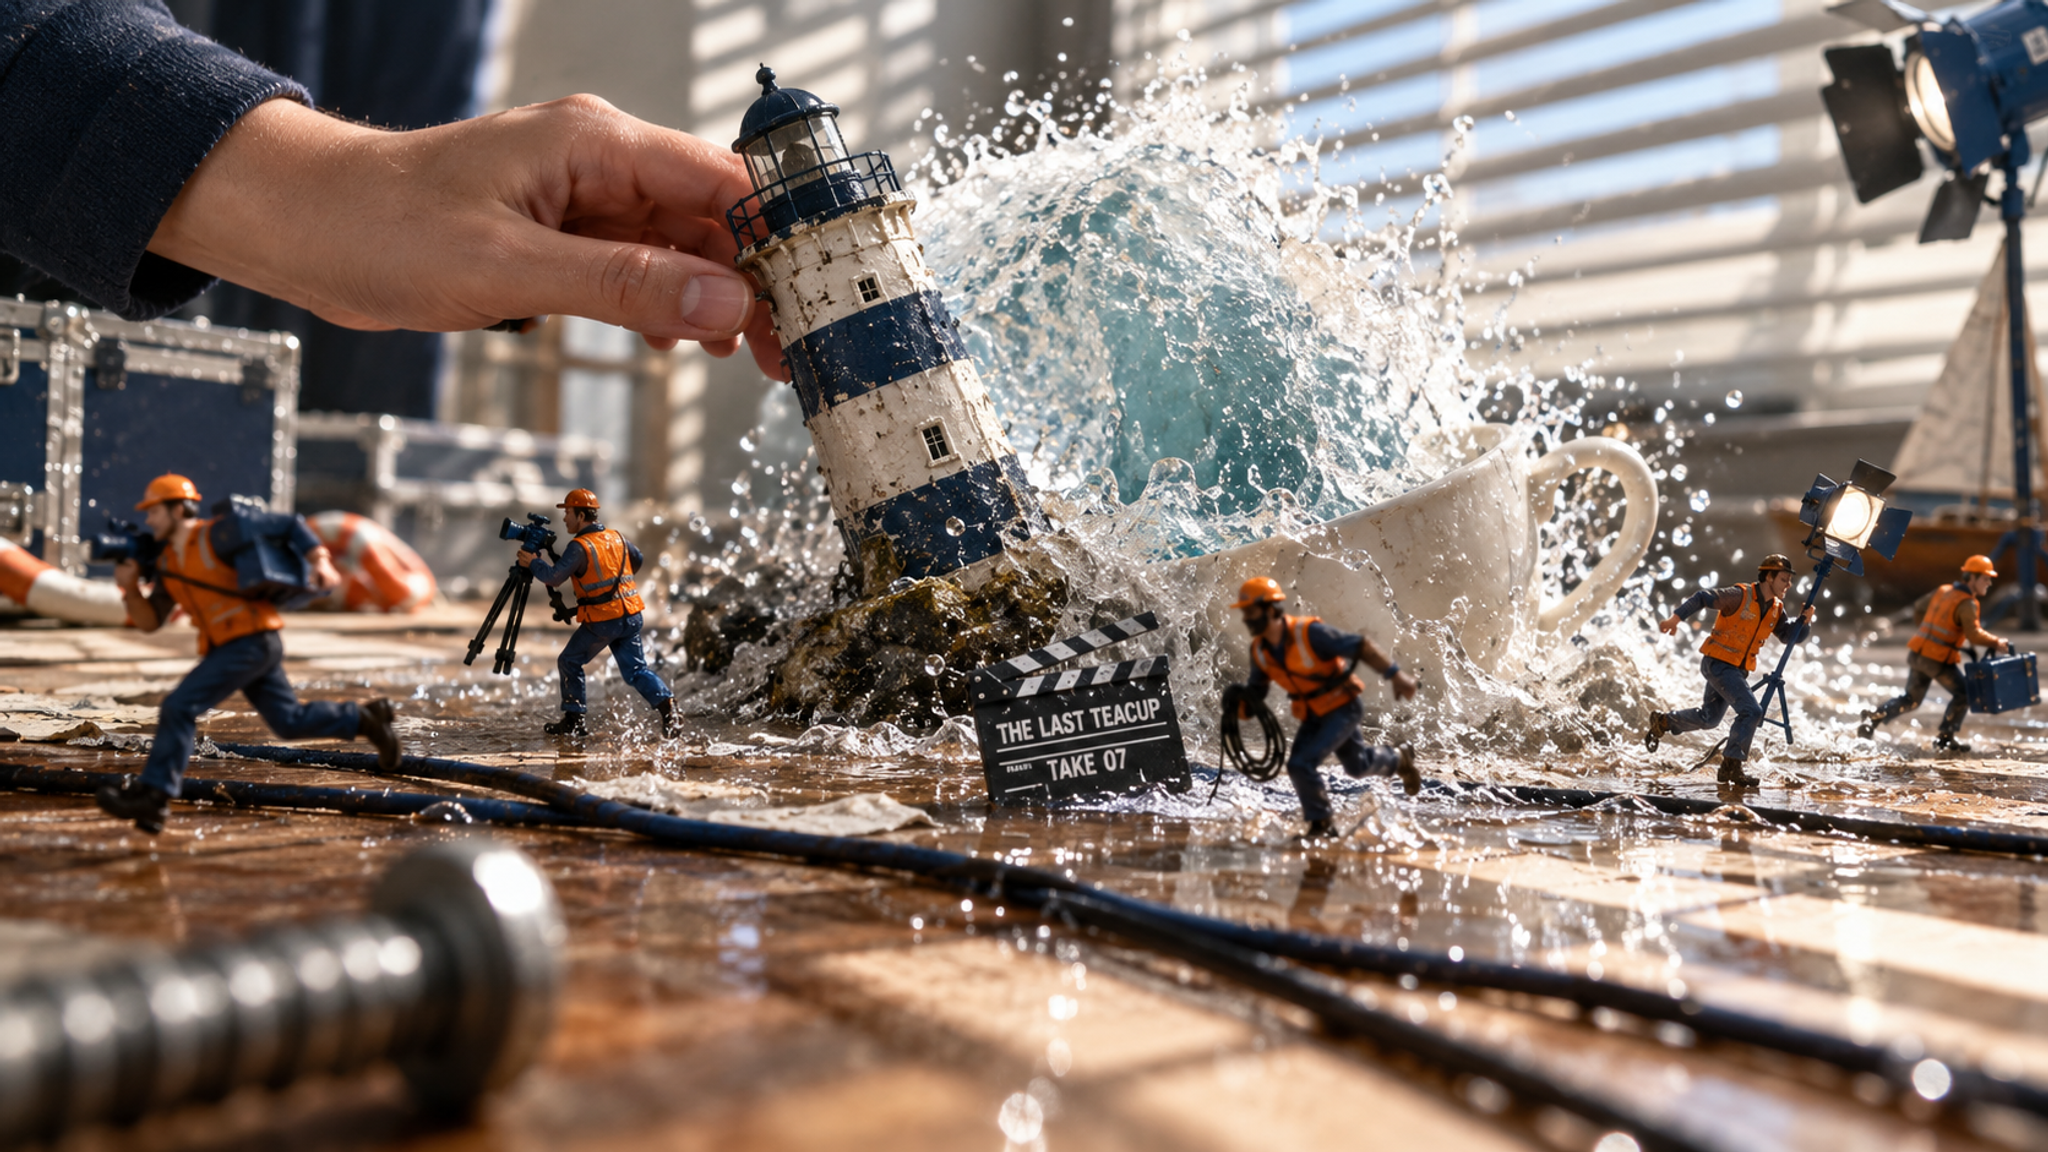
Generated with Wan-2.7 Text-to-image on Atlas Cloud
一场微缩越狱正在玩偶制作者的工作台上展开,恰逢制作者离开的决定性瞬间:一群微小的未上色白色黏土人偶巧妙地将一张纸质检查标签——上面印着小而清晰、完全可辨认的“最终检查”——折成临时热气球;其中一个人偶刚刚割断最后一根系绳,纸质气球猛然向上升起,带有一丝运动模糊,而同伴们则向后退缩、欢呼,并惊讶地仰头凝视。一个翻倒的颜料罐将蜿蜒的群青色河流洒满整个场景,河岸边布满朱红色小脚印和临时搭起的桥。精确的微缩空间叙事,每个角色都在执行独特动作。木制工具架构成强烈的框中框;镊子、雕刻针和工艺刀形成径向引导线,指向正在升起的气球;右上方保留干净、整洁的负空间。定向窗光从左侧斜射进来,形成边缘柔和的长阴影,并照亮压在生黏土上的指纹、磨损的木纹、折叠纸张的纤维、刮花的金属工具,以及半干颜料黏稠的漆膜。严格仅使用三色:黏土白、群青蓝和朱红色,同时保留克制的自然色调变化——不要添加其他强调色。精致的定格动画与写实微距电影摄影相融合,带有触感鲜明的手工不完美质感、选择性浅景深、柔和虚化的前景工具、清晰解析的中央动作、细微的模拟胶片颗粒、100mm 微距镜头;电影感与亲密感并存,呈现高级实拍特效的真实质感;不要光亮的塑料表面,不要油腻的过度渲染,不要 HDR,不要浑浊的颜色,不要无处不在的光晕,不要廉价的史诗奇幻风格,不要黑暗的水下或太空废墟氛围,宽幅水平 16:9 构图,画面边缘满版。
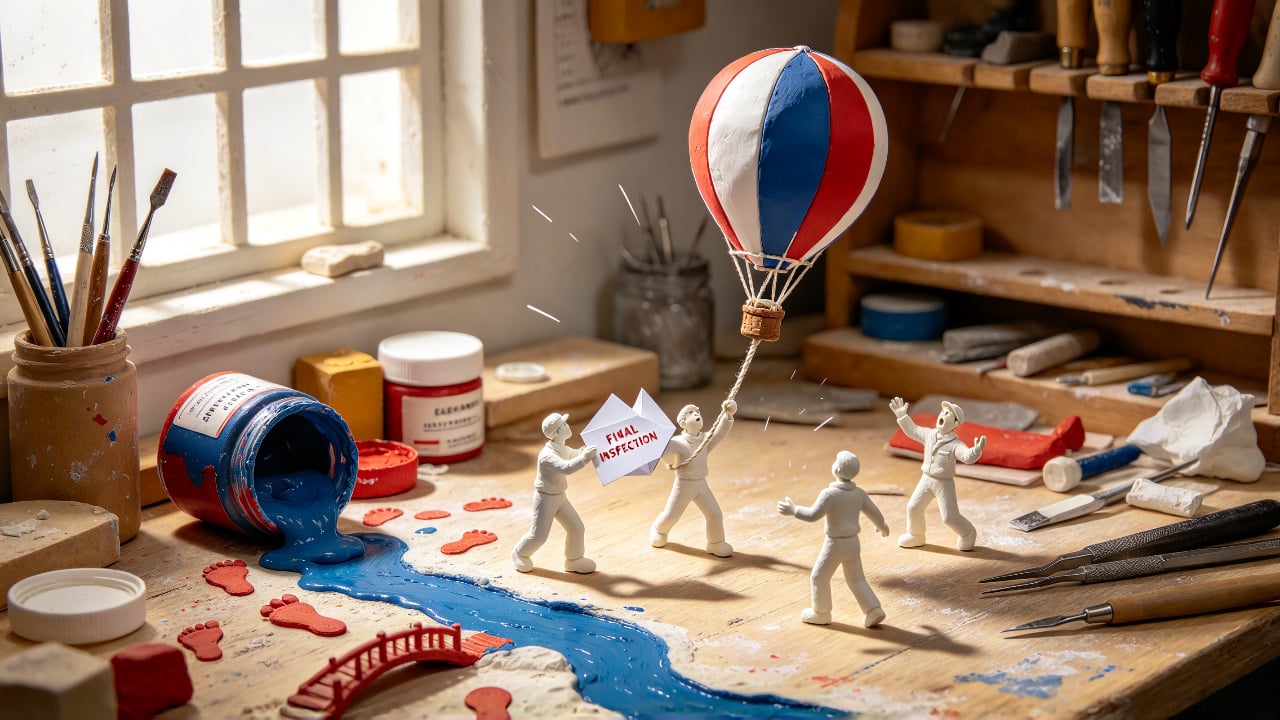
Generated with Qwen Image 2.0 Text-to-image on Atlas Cloud
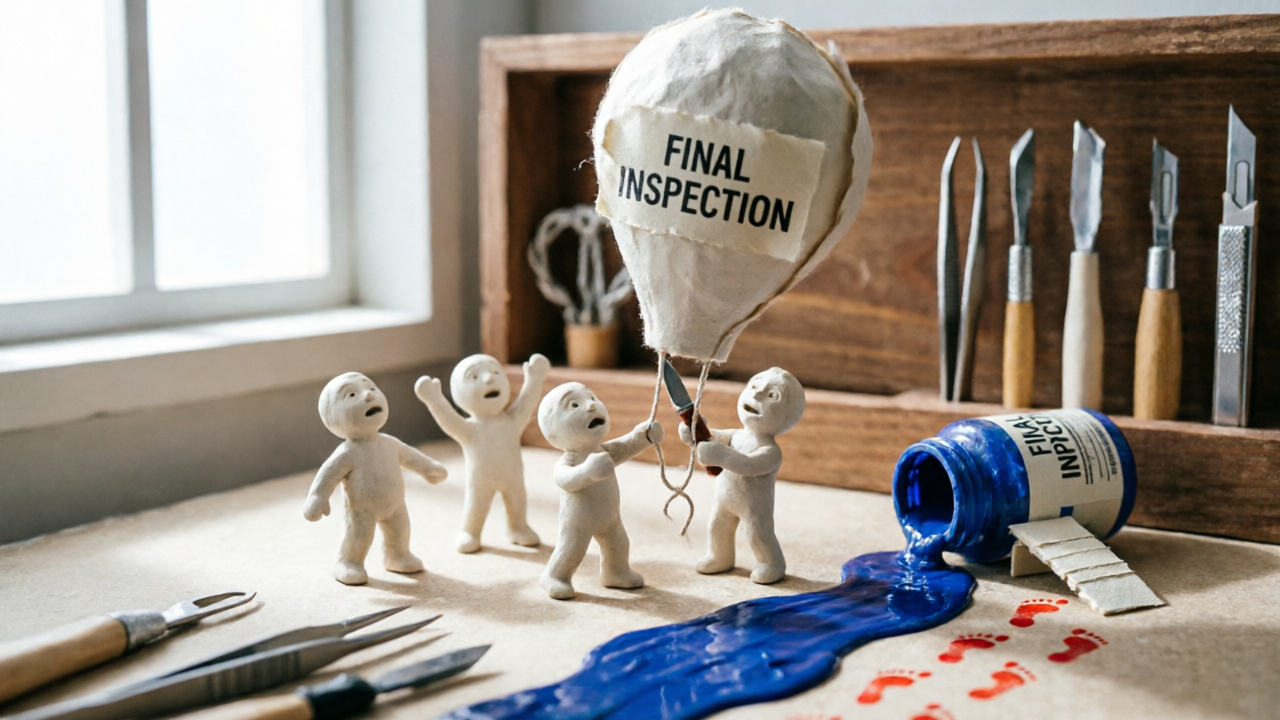
Generated with Seedream v4.7 Text-to-Image on Atlas Cloud
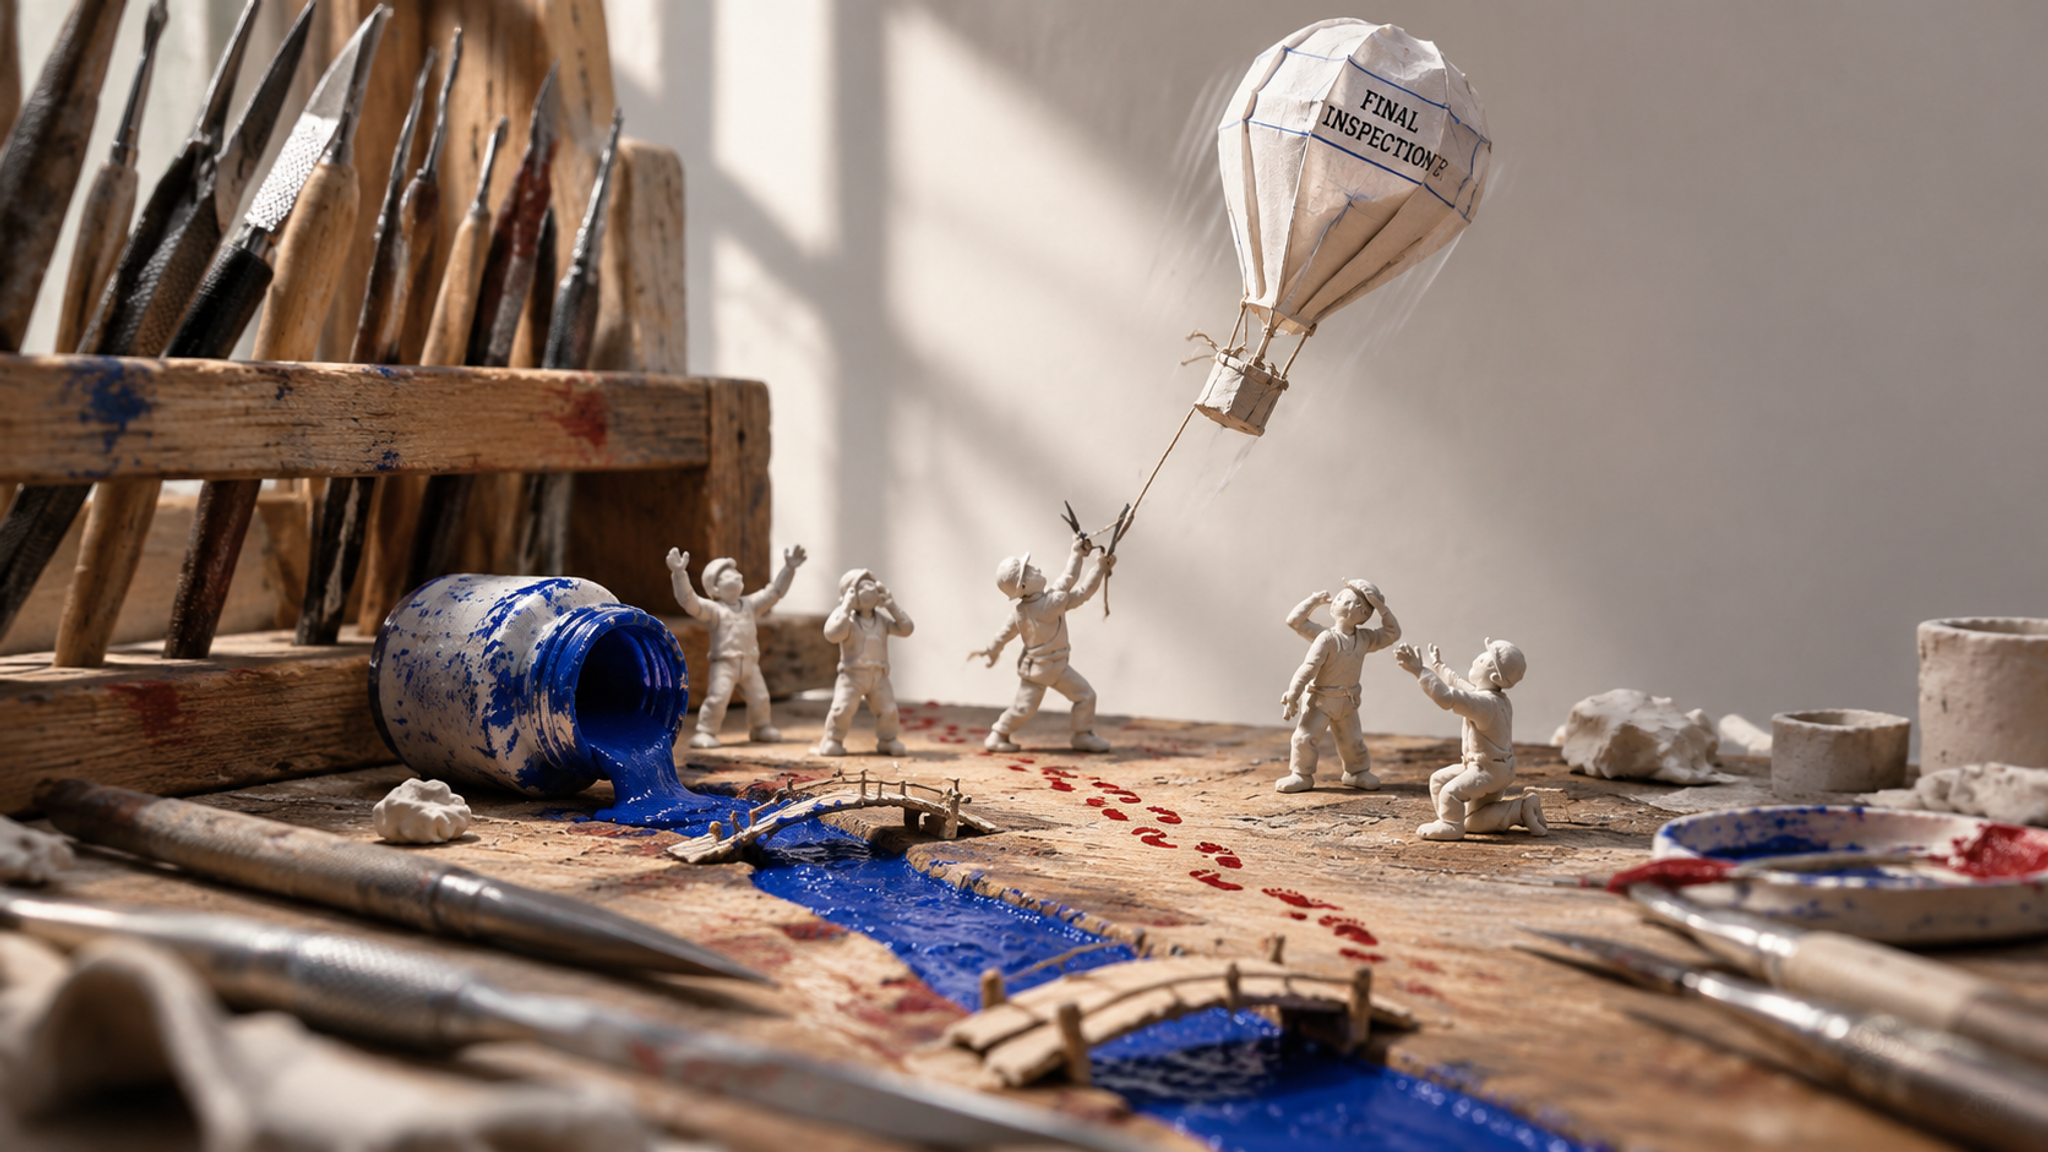
Generated with Wan-2.7 Text-to-image on Atlas Cloud
借助 Qwen Image 2.0 从需求简述到成品视觉素材
Qwen Image 2.0 可将详细提示词和现有图像转化为演示文稿图形、营销活动素材、产品场景、分镜脚本、本地化视觉内容,并支持最高 2K 分辨率下的精细编辑。

Qwen Image 2.0 演示文稿设计
将详细提示词转化为精致的演示文稿视觉内容,提供结构化布局和清晰易读的图中文字。产品团队可以生成概念页、产品解读页和内部提案素材,分辨率最高可达 2K。

营销活动素材中的字体排版
基于详细提示词生成的专业字体排版,为海报、社交媒体图形和营销活动概念带来清晰的视觉表达。营销团队无需手动重建每个构图,即可获得适用于发布、促销和品牌传播的灵活视觉方案。

使用 Qwen Image 2.0 创建产品场景
当产品场景需要丰富细节时,可通过描述性提示词生成最高 2K 分辨率的图像。零售商和创意工作室可以通过清晰的编辑指令,调整背景、周围物体或营销活动场景,以适应不同的投放场景。

精准图像修改
需要修改现有视觉内容,又不想从头开始?向编辑 endpoint 提供清晰指令,即可更新文字、物体、姿势或风格,满足客户反馈和大规模迭代式制作流程的需求。

本地化海报与指南
富含文字的海报和指南可以将视觉叙事与多语言排版结合起来。全球内容团队能够在单张合成图像中打造本地化旅行资料、活动图形和区域营销活动概念。

Qwen Image 2.0 分镜脚本
详细提示词可以将叙事内容映射为漫画、日历或具有结构化视觉构图的分镜面板。创作者可以在投入完整制作资源之前,探索故事序列、教育解读内容和营销活动概念。
Qwen Image 2.0 与同类图像 API 对比
按任务、最大输出分辨率和标准单张价格,对比 Qwen Image 2.0 端点与 Microsoft 的替代方案。
| 模型 | 任务 | 最大分辨率 | 标准价格 |
|---|---|---|---|
| Qwen Image 2.0 Text-to-image | 文生图 | 2048 × 2048 | $0.035/张 |
| Qwen Image 2.0 Edit | 图像编辑 | 2048 × 2048 | $0.035/张 |
| MAI-Image-2.6-Flash Text-to-image | 文生图 | 最高 2.36 MP,相当于 1536 × 1536 | $0.044/张 |
| MAI-Image-2.6-Flash Edit | 图像编辑 | 最高 2.36 MP,相当于 1536 × 1536 | $0.047/张 |
如何在 Atlas Cloud 上使用 Qwen Image 2.0
几分钟即可上手 — 按照以下简单步骤,通过 Atlas Cloud 平台集成和部署模型。
创建 Atlas Cloud 账户
在 atlascloud.ai 注册并完成验证。新用户可获得免费额度,用于探索平台和测试模型。
为何在 Atlas Cloud 使用 Qwen Image 2.0
将先进的 Qwen Image 2.0 模型与 Atlas Cloud 的 GPU 加速平台相结合,提供无与伦比的性能、可扩展性和开发体验。
性能与灵活性
低延迟:
GPU 优化推理,实现实时响应。
统一 API:
一次集成,畅用 Qwen Image 2.0、GPT、Gemini 和 DeepSeek。
透明定价:
按 Token 计费,支持 Serverless 模式。
企业与规模
开发者体验:
SDK、数据分析、微调工具和模板一应俱全。
可靠性:
99.99% 可用性、RBAC 权限控制、合规日志。
安全与合规:
SOC 2 Type II 认证、HIPAA 合规、美国数据主权。
Qwen Image 2.0 API 常见问题
Qwen Image 2.0 是阿里巴巴 Qwen 团队推出的图像模型,可根据文本生成视觉内容,也可以按照指令编辑现有图像。Atlas Cloud 为这两类任务提供专用 REST API 端点,输出分辨率最高可达 2K。
你可以使用该模型根据详细描述生成图像,也可以通过自然语言指令修改现有视觉内容。其增强的提示词理解能力支持营销图形、概念艺术、产品图像、信息图和视觉设计等工作流。
适合。Atlas Cloud 强调模型能够生成清晰易读的图中文字,并支持复杂提示词,因此适用于信息图、海报、营销素材及其他结构化布局。请在 API 的 800 字符提示词限制内,明确说明文案和布局要求。
在 Atlas Cloud 控制台中创建 API key,选择生成或编辑模型 ID,然后提交 REST 请求。托管推理无需配置本地 GPU,也无需部署模型权重。
向 https://api.atlascloud.ai/api/v1/model/generateImage 发送经过身份验证的 POST 请求,并在 JSON 请求体中提供模型 ID 和输入参数。异步请求会返回 prediction ID,你可以通过 prediction 端点轮询该 ID,直到处理完成。
从提示词创建新图像时,请选择 qwen/qwen-image-2.0/text-to-image。若要根据指令修改参考图像,请选择 qwen/qwen-image-2.0/edit。
文本生成需要提供 prompt,并支持可选的 size 和 seed 值。编辑还需要提供 images 数组,而 size 和 seed 仍为可选参数。两个端点都接受最多 800 个字符的中文和英文提示词。
编辑端点接受 1 到 3 个参考图像 URL,每张图像的每个维度必须介于 384 和 3072 像素之间。输出尺寸范围为 512 到 2048 像素,模型配置中列出的最高支持分辨率为 2K。
Atlas Cloud 列出的标准基础价格为每次请求 $0.035,文本生成和编辑端点均适用。该价格为原始按量付费价格,不包含临时折扣。
需要进行可重复测试时,请将 seed 设置为 0 到 2147483647 之间的特定整数;默认值 -1 会随机选择 seed。比较输出或定位异常差异时,请保持模型 ID、prompt 和 size 不变。
探索更多系列
Seedance 2.5
Seedance 2.5 API 现已在 Atlas Cloud 上线!它为开发者提供了 ByteDance 最新的视频模型。该模型可通过文本、单张图像或多达 50 个多模态参考,一次性生成长达 30 秒的原生视频,并包含同步音频和画面内的多语言文本。在 Atlas Cloud 上,您可以通过单个密钥访问它,其主体一致性和改进的物理特性能够保持长镜头的连贯性。

Wan 3.0
Wan 3.0 API 是阿里巴巴 Wan 视频系列的下一代产品,旨在将长视频生成、多参考控制和音视频质量推向新的高度。Atlas Cloud 已经托管了 Wan 2.7、2.6 和 2.5,而 Wan 3.0 使用相同的统一密钥运行,无需额外设置。立即开始构建吧。向下滚动至展示区,查看 Wan 3.0 的创作能力。
MiniMax H3
MiniMax H3 是 MiniMax 的多模态视频系列,支持文本、图像和参考内容引导创作。在支持的路由中,它能够保留参考媒体中的主体,提供灵活的宽高比,并通过 H3 Developer 将生成的声音与画面结合;输出配置则由 endpoint 选择。Atlas Cloud 通过一个 OpenAI 兼容密钥统一接入整个系列,并提供透明的按量付费定价,标准费率为每秒 $0.038。立即开始构建。
Seedream 5.0 Pro
Seedream 5.0 Pro API 为开发者在 Atlas Cloud 上提供了字节跳动的可控图像编辑模型。它通过锚点和坐标精确定位编辑,将图像分离为可编辑图层,融合多个参考,并精准匹配颜色和材质,支持 2K 和 3K 分辨率的多语言文本。在 Atlas Cloud 上,您只需一个密钥即可访问!
Seedance 2.0
Seedance 2.0 是 ByteDance 面向生产环境的视频模型,专用于精准镜头创作。将提示词转换为视频,使用首帧图像生成动画并可选用尾帧引导,或结合参考媒体和可选的联网搜索来塑造结果。Atlas Cloud 将这些工作流整合到统一的 API 中,提供透明的按量付费定价和一个兼容 OpenAI 的密钥。立即开始构建。
GPT Image 2.5
OpenAI 的 gpt-image-2.5 系列为开发者提供 Flare 和 Sunburst 两种选择,满足生产级图像工作流需求。支持最高 3840x2160 的任意分辨率渲染,并提供包括 xhigh 和 max 在内的五档质量等级,以匹配特定的输出要求。Atlas Cloud 提供开箱即用的 REST 推理服务,无冷启动,每次生成起价 $0.004,采用标准定价。立即开始构建。
GPT Image 2
GPT Image 2 API 为开发者提供了访问 OpenAI 最新图像模型的途径,它是 GPT Image 1.5 的继任者。该模型可生成和编辑图像,能够在拉丁和 CJK 文字上实现准确的文本渲染,并在海报、样机和信息图表方面具备强大的排版能力。在 Atlas Cloud 上,您可以通过一个统一的 API 与 300 多个模型一起访问它,并享受免费额度、99.99% 的正常运行时间,且无需 OpenAI 组织验证。
Gemini Omni Flash
gemini omni API 将 Google DeepMind 原生多模态的 Gemini Omni Flash 系列(包括 Gemini Omni 1.1 Flash)带给开发者。创建带同步原生音频的电影级视频,使用精确的起始帧和结束帧控制为静态图像制作动画,或通过文本引导式编辑修改现有视频,同时保留未编辑的内容。Atlas Cloud 提供一个 OpenAI 兼容密钥、统一访问能力以及透明的按量付费定价。立即开始构建。
Grok Imagine
Grok Imagine API 涵盖 xAI 的图像、视频和语音模型,包括 Image 2.0、Video 1.5 和 xAI TTS v1。支持生成跨 14 种宽高比的 1K 或 2K 静帧、生成最长 15 秒的 1080p 视频、通过最多 7 张参考图像引导镜头、或用 20 种语言进行配音。Atlas Cloud 在单一端点上运行所有功能,采用按量计费,起价为每张图像 $0.02、每秒 $0.05。立即开始使用。
Google最强大的创意模型现已在Atlas Cloud上全面可用。Veo 3.1提供电影级别的视频生成,Nano Banana 2支持高保真图像创建,而Gemini为每个工作流带来多模态智能。通过单一API key即可访问完整的Google模型套件,提供Day-0可用性和按需付费(pay-as-you-go)定价。
Seedance 2.0 Mini
Seedance 2.0 Mini 将 ByteDance 的多模态视频生成技术引入到对速度和成本要求极高的工作流中。它以更轻量的占用空间提供 Seedance 2.0 的核心能力——更快的生成速度、更低的单条视频成本,并且使用您现有的同款 API 集成。对于运行高吞吐量流水线或进行大规模原型设计的团队来说,Mini 是最实用的默认选择。
ByteDance
从电影级视频生成到高保真图像创建,ByteDance 最强大的模型现已在 Atlas Cloud 上线。以最低的推理定价和零基础设施开销,大规模运行 Seedance 和 Seedream。


