Qwen Image 3.0 pro Identity Preserving Edits
Qwen Image 3.0 pro 是 Qwen 面向开发者打造的图像生成与编辑模型系列,适用于构建生产级视觉工作流。它支持生成最高 2048×2048 的图像,可自动改写提示词,根据提示词意图选择分辨率,并在保留面部特征和身份信息的同时,遵循自然语言编辑指令。通过 Atlas Cloud,使用一个 OpenAI 兼容密钥即可访问这两个模型,并按量计费,每次调用标准价格为 $0.04。立即开始构建。
Qwen Image 3.0 Pro 由 Alibaba 开发。Atlas Cloud(由 Atlas Cloud AI LLC 运营)仅提供接入服务,并不拥有该模型。所有商标均归其各自所有者所有。
探索领先模型
Atlas Cloud 为您提供最新的行业领先创意模型。


Qwen Image 3.0 pro 生成与编辑模式
比较 Qwen Image 3.0 pro 提供的文生图和基于参考图的编辑端点。
| 模态 | 描述 |
|---|---|
| Qwen Image 3.0 Pro API (Text to Image) | 将文本提示词转换为图像,支持最高 2048×2048 分辨率,并提供自动提示词重写和基于提示词的分辨率选择功能。具备出色的复杂文本渲染能力和精准的提示词遵循能力,适用于海报、产品视觉、插画及其他对构图要求较高的素材。 |
| Qwen Image 3.0 Pro API (Image Editing) | 提供一至三张参考图像和一条自然语言指令,以生成编辑后的图像。在应用所请求的修改时,保留面部特征和人物身份等关键细节,适用于人像优化、视觉变体生成和受控素材更新。 |
深入了解 Qwen Image 3.0 pro:文字、细节与控制
Qwen Image 3.0 pro 将复杂文字渲染、精准遵循提示词、最高 2048 × 2048 的生成分辨率、自动提示词改写,以及通过 Atlas Cloud 统一按量付费 API 基于 1 至 3 张参考图的保身份编辑整合于一体。
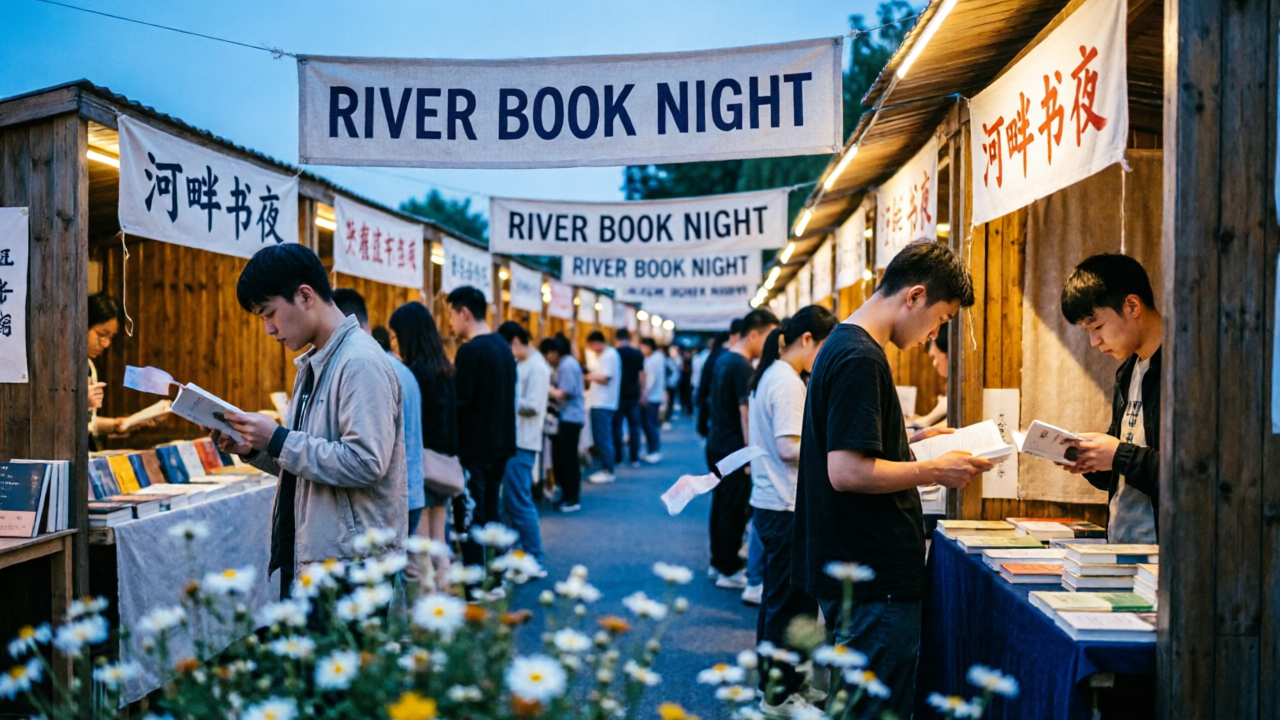
Qwen Image 3.0 pro 文字排版
Qwen Image 3.0 pro 能遵循详细提示词,同时处理英文和中文的复杂文字渲染。它可以构建信息密集的创意布局,而无需将文字与场景割裂开来。在一次请求中指定文案、层级、构图和视觉风格,然后在发布前校对名称与数字。这使其适用于横幅、编辑类图形、包装概念设计和信息丰富的艺术作品。
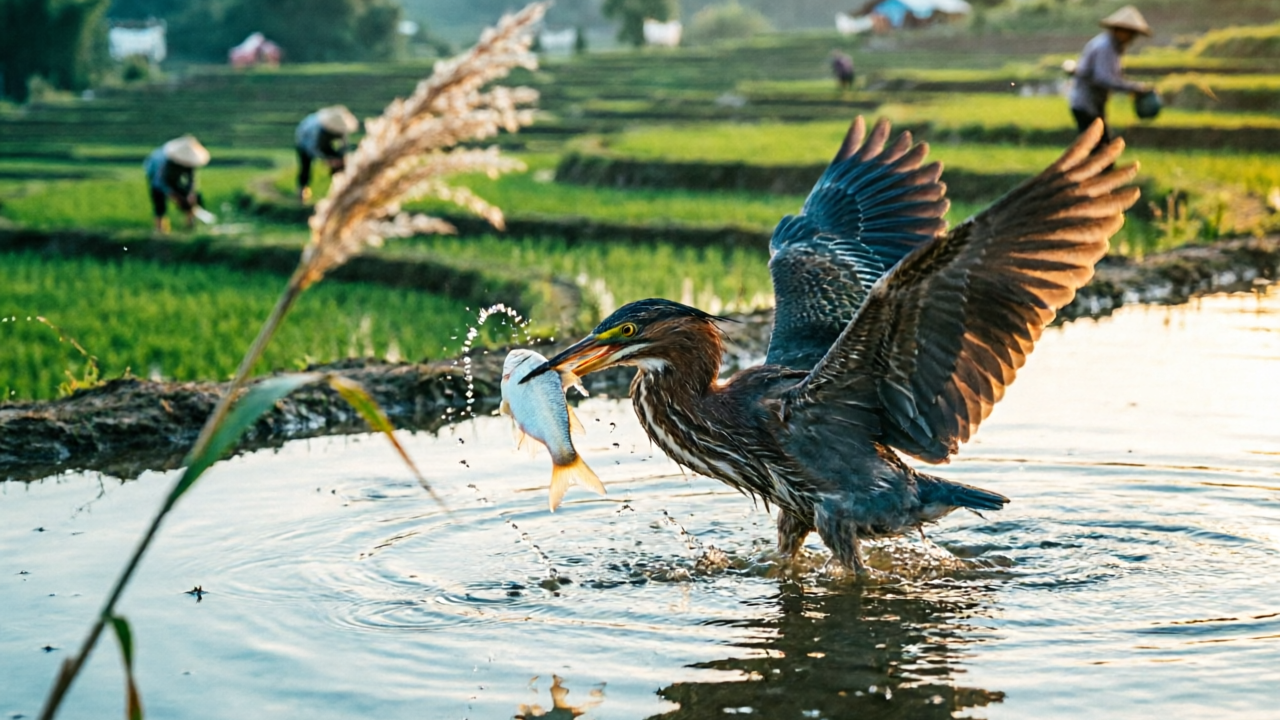
2048 × 2048 细节表现
当精细纹理和清晰细节至关重要时,可生成最高 2048 × 2048 分辨率的图像。提示词引导的尺寸选择可以自动确定输出分辨率,而显式指定尺寸则可针对已知画布进行生成。从产品摄影到编辑类肖像,更高的像素预算支持近距离检查、灵活的后续裁剪以及精致的生产素材制作。
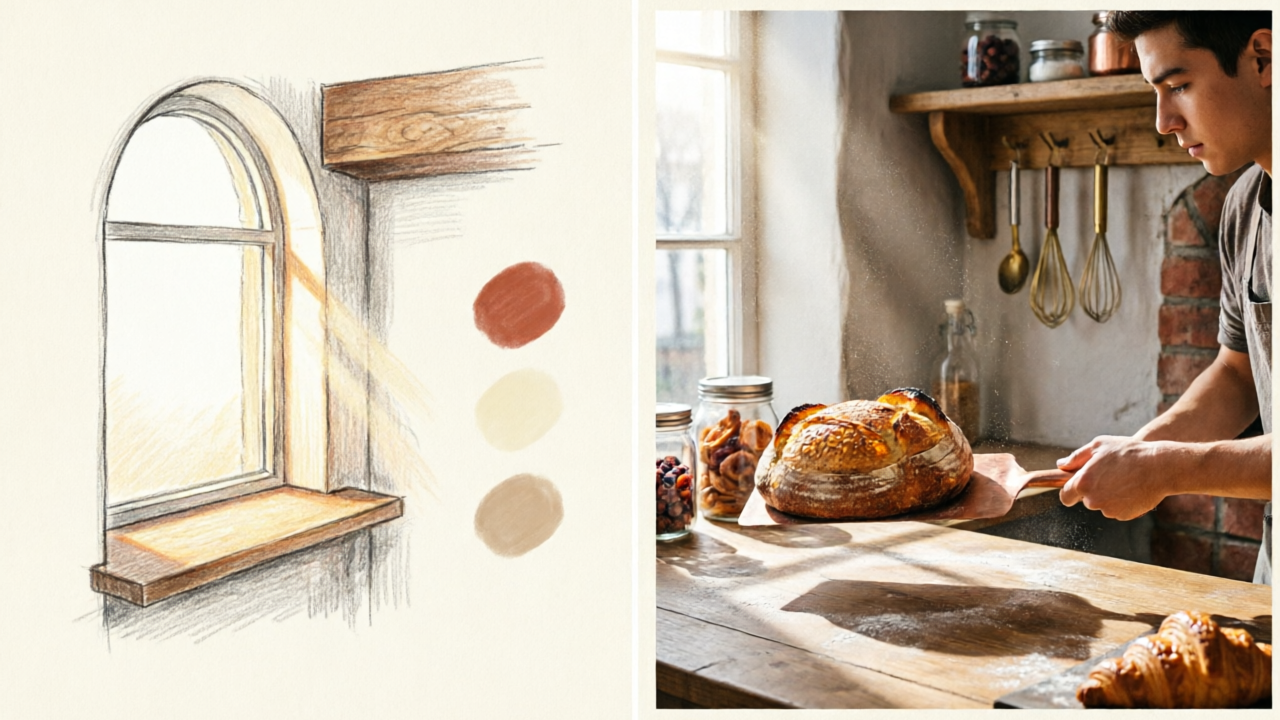
两种提示词改写模式
生成前,系统可以自动扩展简短提示词,且默认启用改写。在文本生成 endpoint 中,Direct 模式执行单次改写,而 Agent 模式则通过 agentic pipeline 丰富需求说明。探索创意概念时可保持改写开启;进入生产环节后,如果更看重精确措辞和严格可控的指令,也可以将其关闭。
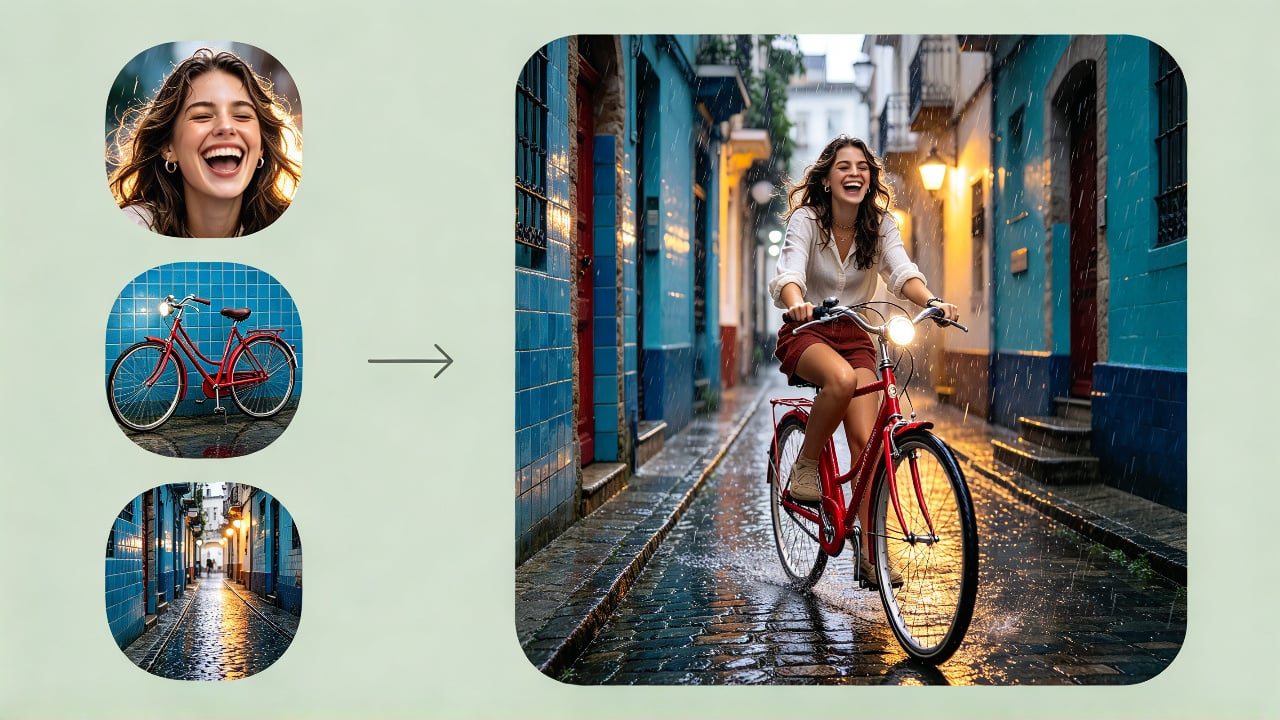
1 至 3 张参考图编辑
在编辑任务中加入 1 至 3 张参考图,并用自然语言描述修改内容。模型可以利用这些来源提供主体、上下文或视觉指导,同时保留关键面部特征和身份信息。你可以要求更换环境、造型或构图,而无需从头重建已经确认的主体。这适合制作营销活动变体、保持角色连续性,以及构建以参考图为基础的产品场景。
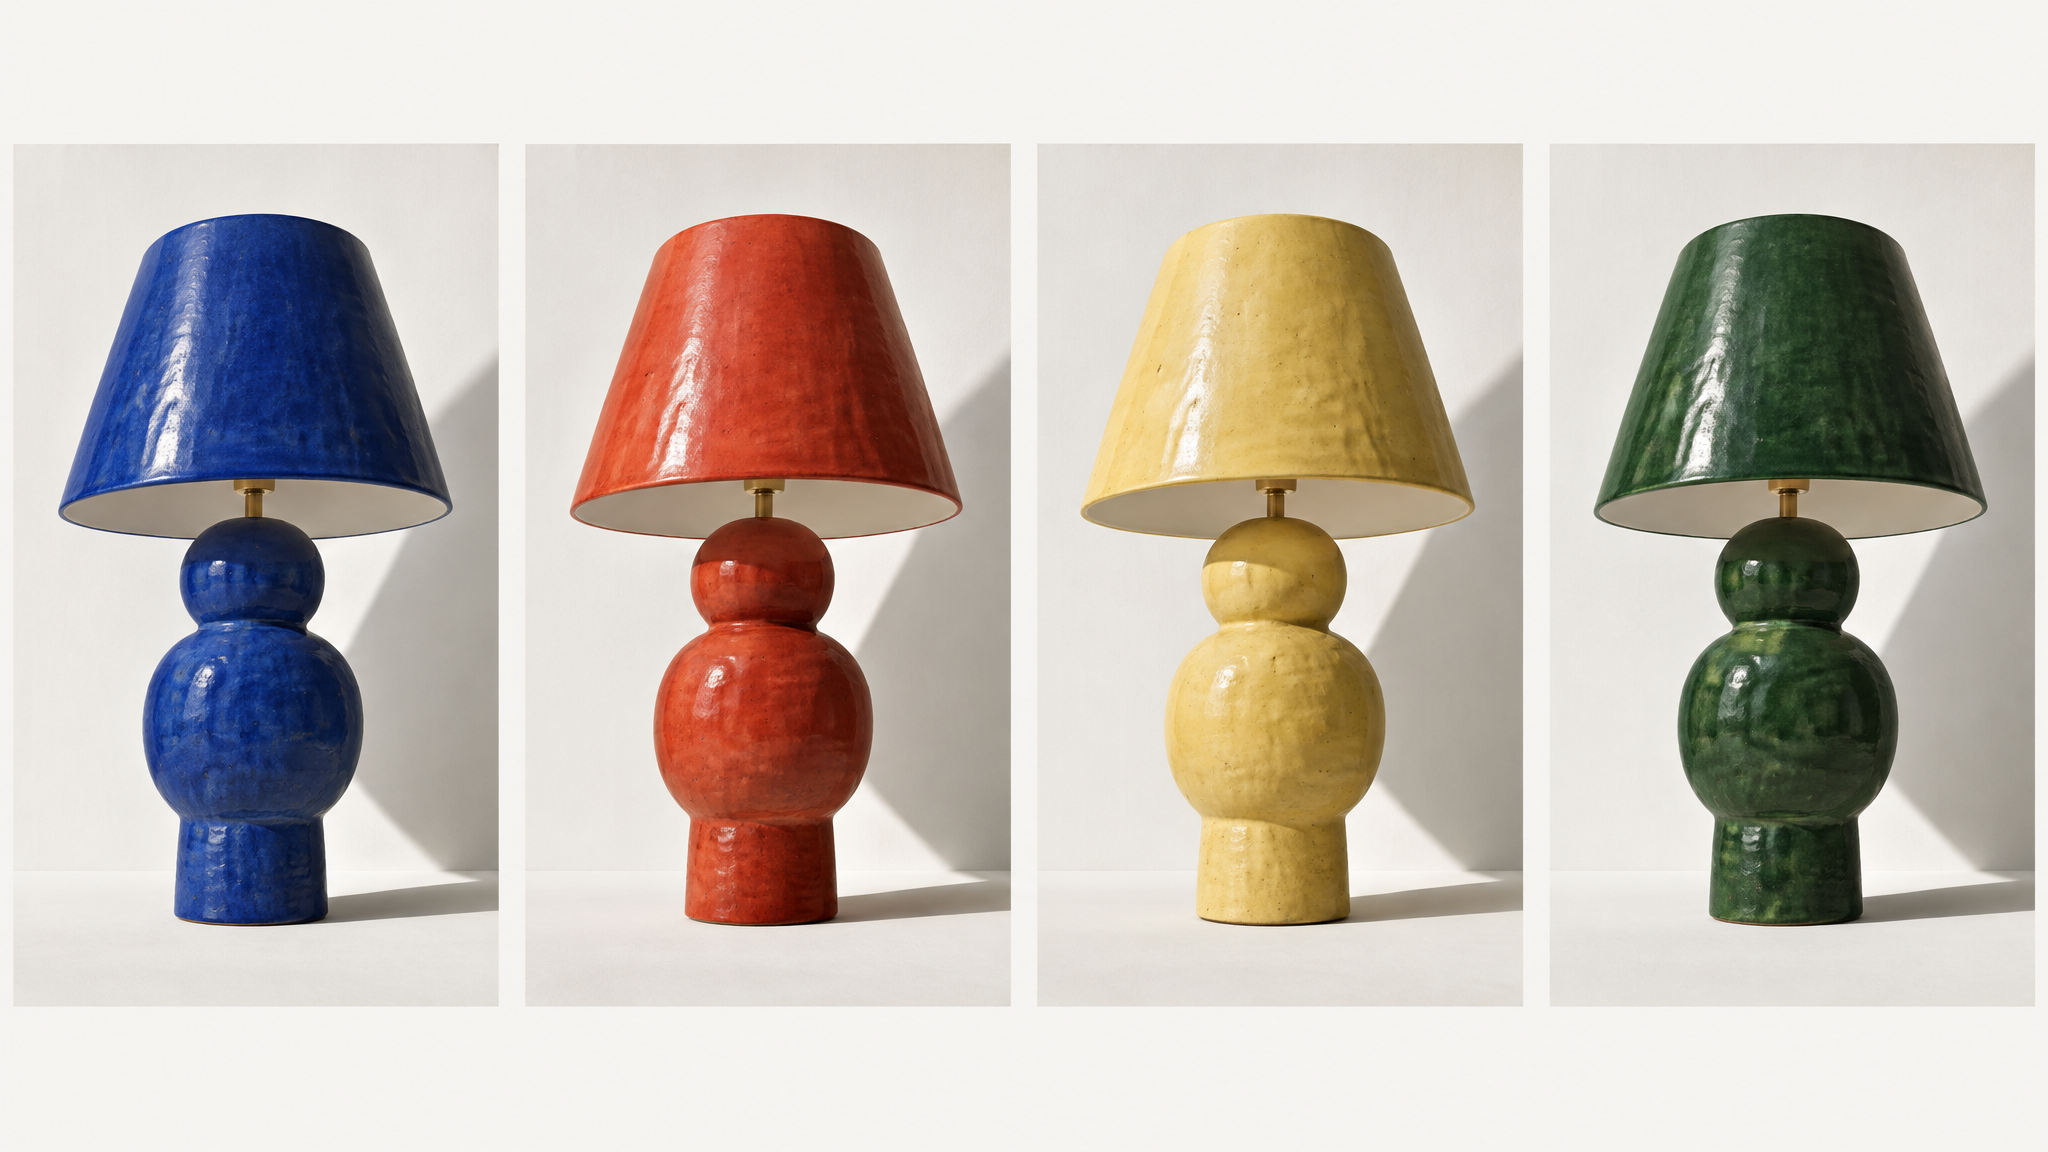
可复现的批量控制
需要可重复的实验?设置一个介于 0 和 2147483647 之间的固定 seed,添加 negative prompt,并在一次生成调用中请求最多 4 个输出。这些控制项有助于比较提示词修改、排除不需要的内容,并在一致条件下评估一组小规模选项。将它们用于结构化创意测试,而不是一次性的猜测。
一个提示词,三种视觉呈现:Qwen Image 3.0 pro 对比
了解 Qwen Image 3.0 pro、一个领先的外部竞品及其同系列前代产品,如何在富含排版设计的视觉作品与纪实摄影中解读完全相同的提示词。
正午时分,在熙熙攘攘的香料集市中,捕捉一个决定性且幽默的瞬间:一名年轻男性摊贩将粗糙的黄麻藏红花袋猛地甩向空中,恰好此时一只带有运动模糊的鸽子撞上了一堆姜黄粉,将灿亮的金色粉末扬起,悬浮在整个场景中;受惊的顾客自然又滑稽地做出反应,其中一人明显用双手护住几枚表面光泽鲜亮的红石榴,另一人则同时将折叠好的纸质香料袋紧紧抱在胸前,确保每一只手臂、手、手指、物体及互动都符合解剖结构、彼此清晰区分且易于辨认。通过层叠的石砌拱廊取景,营造强烈的框中框构图,并采用略微抬高的荷兰式倾斜视角;重复排列的深红辣椒、深靛蓝陶瓷碗和鲜艳的黄色姜黄堆,构成严格限定为红、黄、蓝三色的主色调。正午时分方向明确的强烈天光,在摊位、面孔和磨损的铺路石上投下利落的几何阴影。保留飞扬粉末颗粒、编织黄麻纤维、纸质藏红花丝、尘土覆盖的香料堆、锤纹铜制称量秤、上釉陶器、风化木纹、皱褶纸袋、自然年轻的皮肤以及细微模拟胶片颗粒的触感真实感。画面中加入一块宽幅横向手绘店招,准确写着“SPICE, SUN & SURPRISE”,使用大号且完全清晰可读的字母;另外加入数个彼此分开的手写价格标签,准确写着“SAFFRON 12”“TURMERIC 4”“CHILIES 6”和“POMEGRANATES 3”,所有文字拼写正确、字形规整,并自然融入摊位环境。复古 1970 年代旅行杂志纪实摄影风格,洋溢真挚的人情温度,克制的写实感,28mm 环境镜头,深层次景深与柔和遮挡的前景边缘,轻微的鸽子运动模糊,面孔和手部清晰锐利,真实曝光,无摆拍感,无油腻过度渲染,无 HDR 观感,无塑料质感皮肤,无浑浊色彩,无过度发光,无奇幻史诗式灯光,无杂乱的彩虹色盘,无畸形手部,无多余手指,无人物重复,无乱码文字,无边框,无样机图,宽幅横向 16:9 画幅比例,满版铺陈。
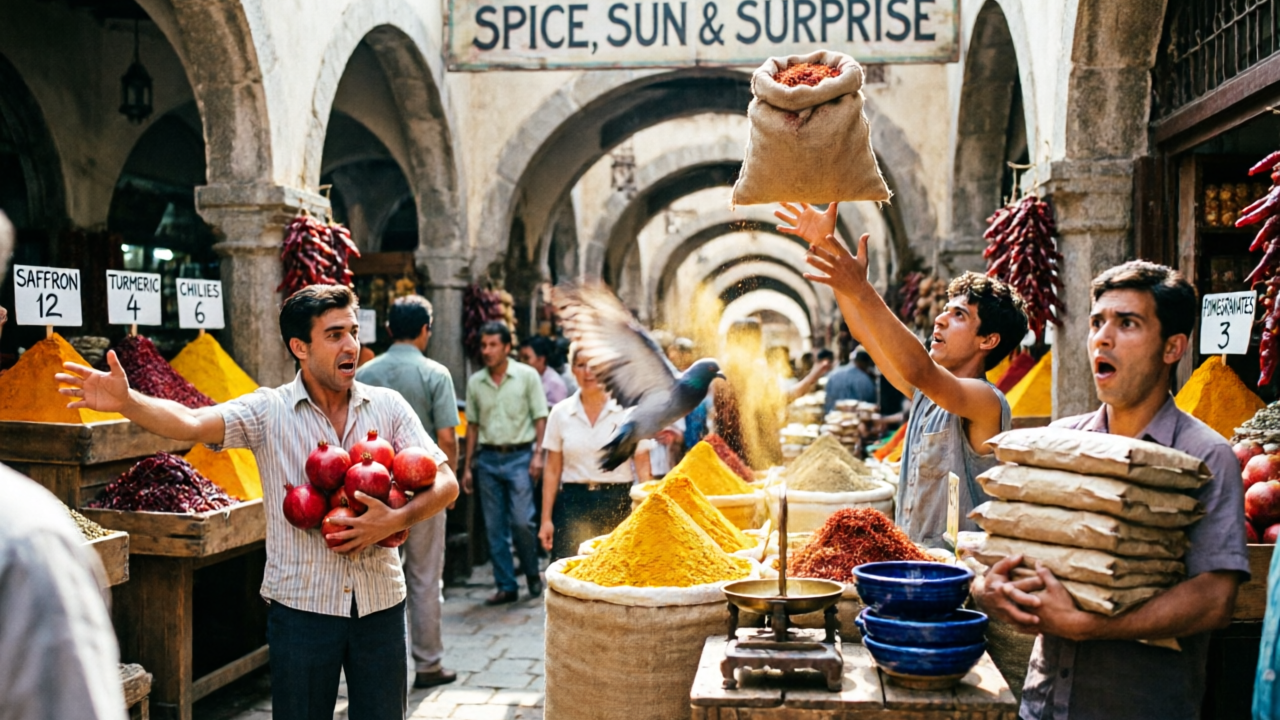
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
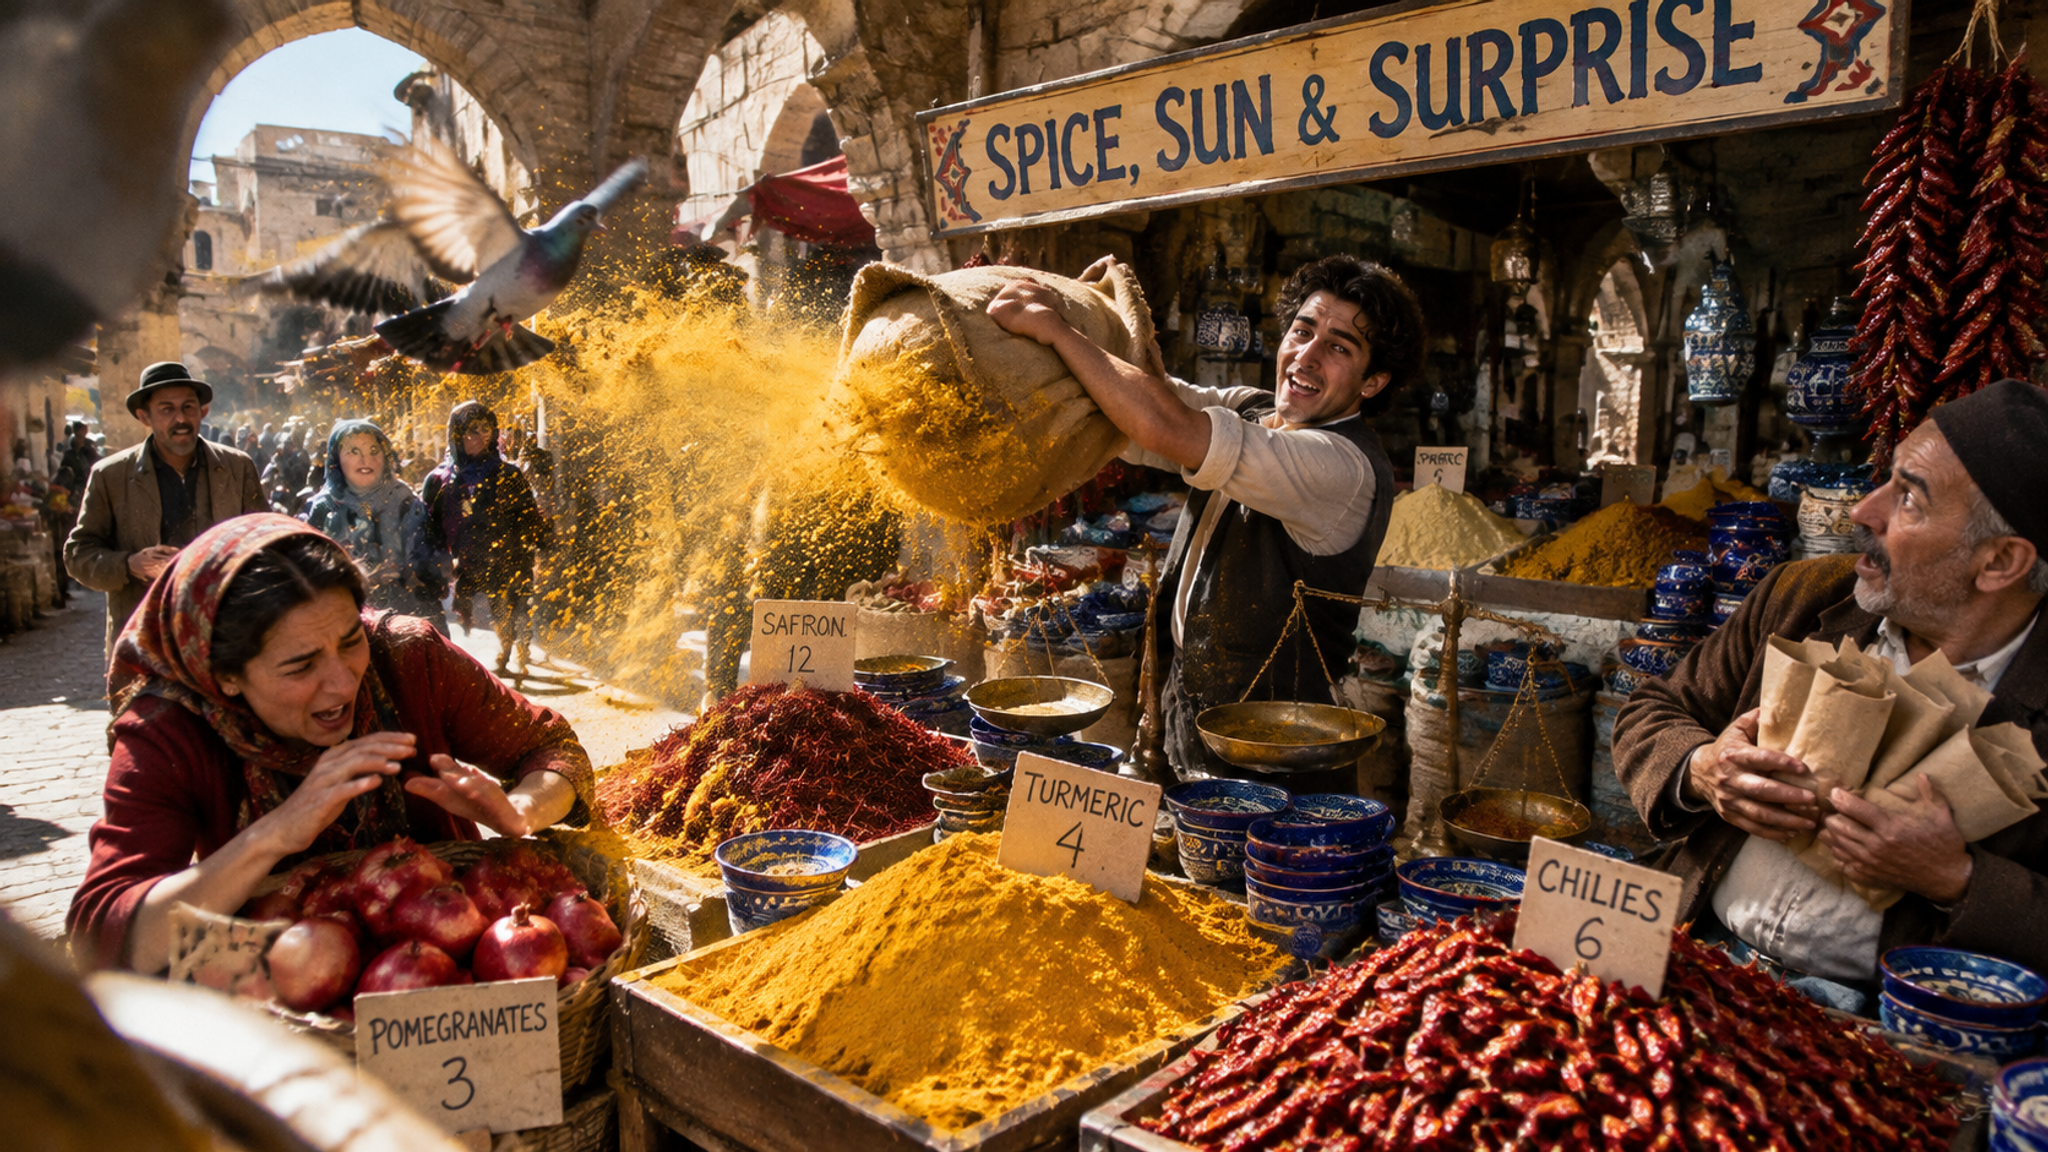
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
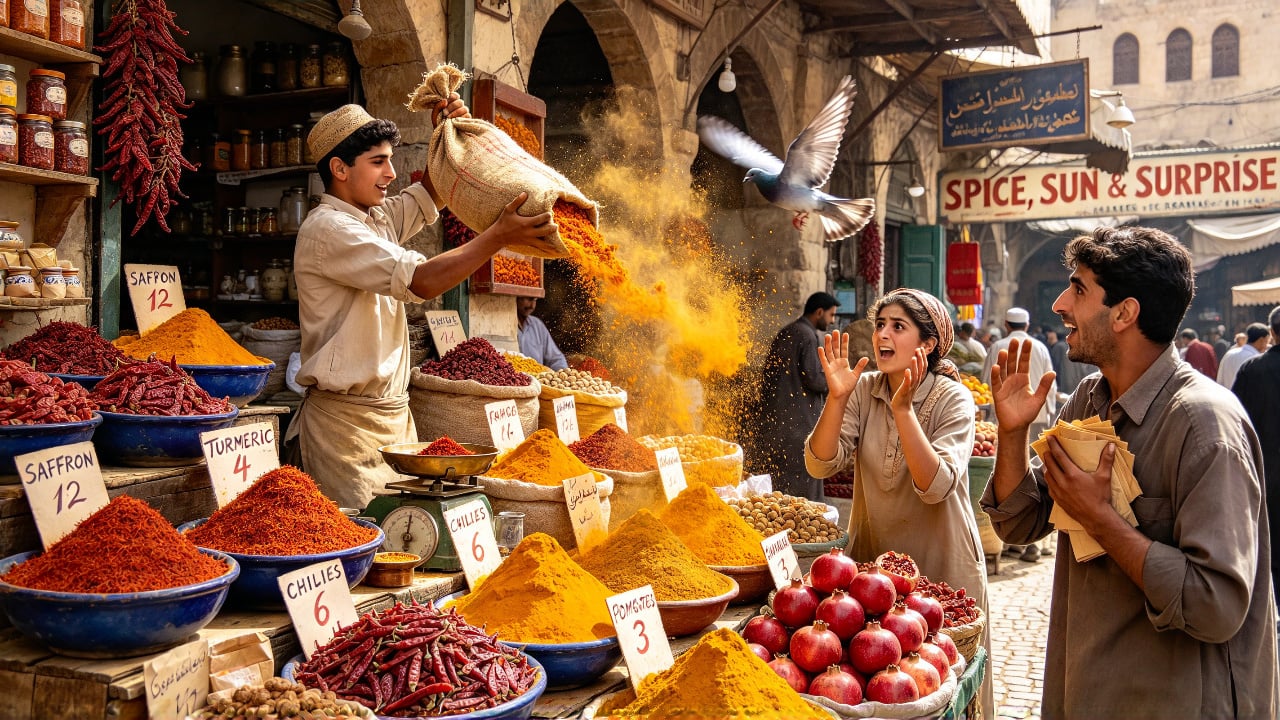
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
雨夜中,一家自助洗衣店内部的电影感纪实照片,捕捉一个决定性瞬间:一台前置式洗衣机突然喷涌出大量白色泡沫;一名穿着亮黄色雨衣的年轻女性自然大笑着,用红色塑料洗衣盆接住溢出的泡沫,她的双手自然抓住盆沿,手指符合解剖结构;与此同时,她的朋友站在起雾的玻璃外,清晰地用手指写下准确的镜像反转文字“LAST WASH 11:30”,从洗衣店内部看清晰可读;就在同一时刻,一只湿袜子拍打并粘在玻璃上。成排的圆形洗衣机门形成醒目的重复几何形状,并以强烈的引导线延伸至深远空间;窗玻璃上的层叠倒影同时呈现店内充满玩趣的动作与外部被雨水浸润的霓虹街道,形成连贯的双重叙事。方向明确的冷白色荧光顶灯,在面孔、雨衣、双手、泡沫和铬制金属表面勾勒出清晰的轮廓与利落的剪影;克制的洋红色霓虹透过窗户渗入,并映照在路面积水中,采用由青蓝、鲜黄和洋红构成的严格三色调。玻璃上的写实水滴、半透明气泡、潮湿的织物纤维、拉丝金属、橡胶门封、凝结水、积水倒影、飞溅泡沫中的细微运动模糊、柔和的高 ISO 胶片颗粒、自然年轻的皮肤纹理、真实抓拍式表情,以及复杂但空间关系一致的倒影与透明表面。平视环境纪实摄影,35mm 镜头,中等景深,电影感写实风格,保留细微瑕疵,无刻意摆拍,无油腻过度渲染,无 HDR 观感,无塑料质感皮肤,无浑浊色彩,无过度发光,无廉价史诗式灯光,宽幅横向 16:9 画幅比例,满版铺陈。
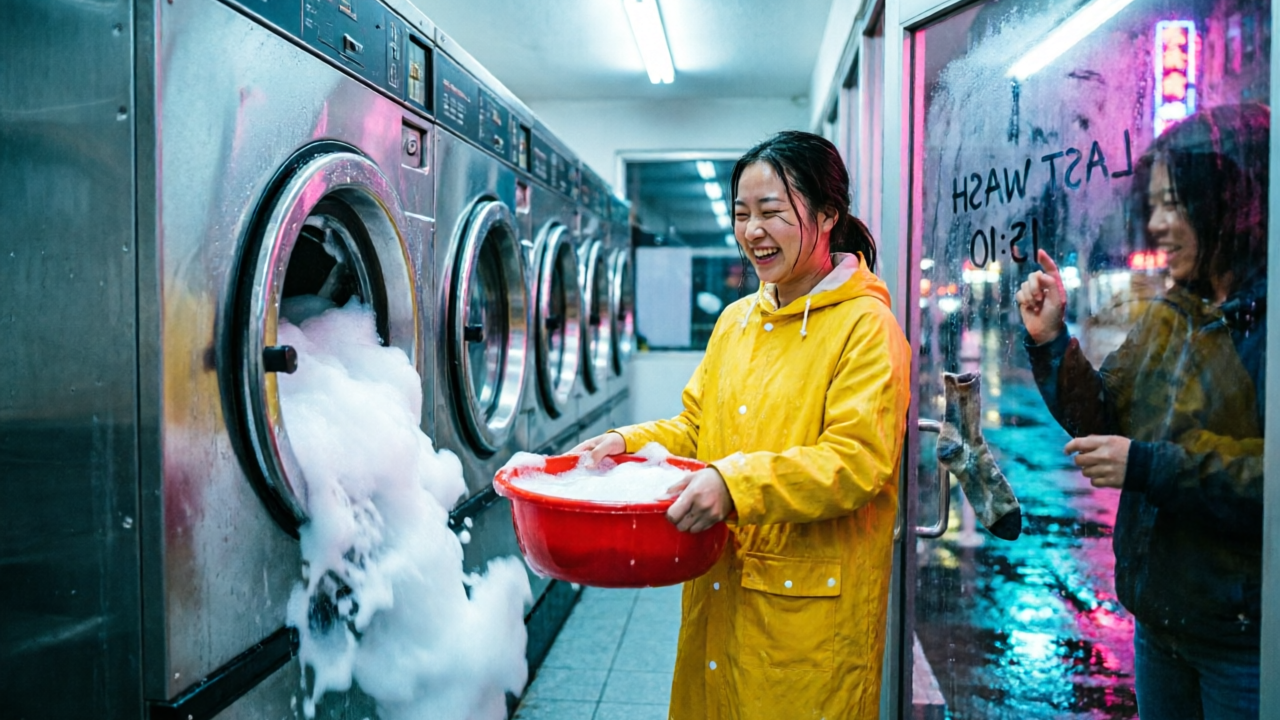
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
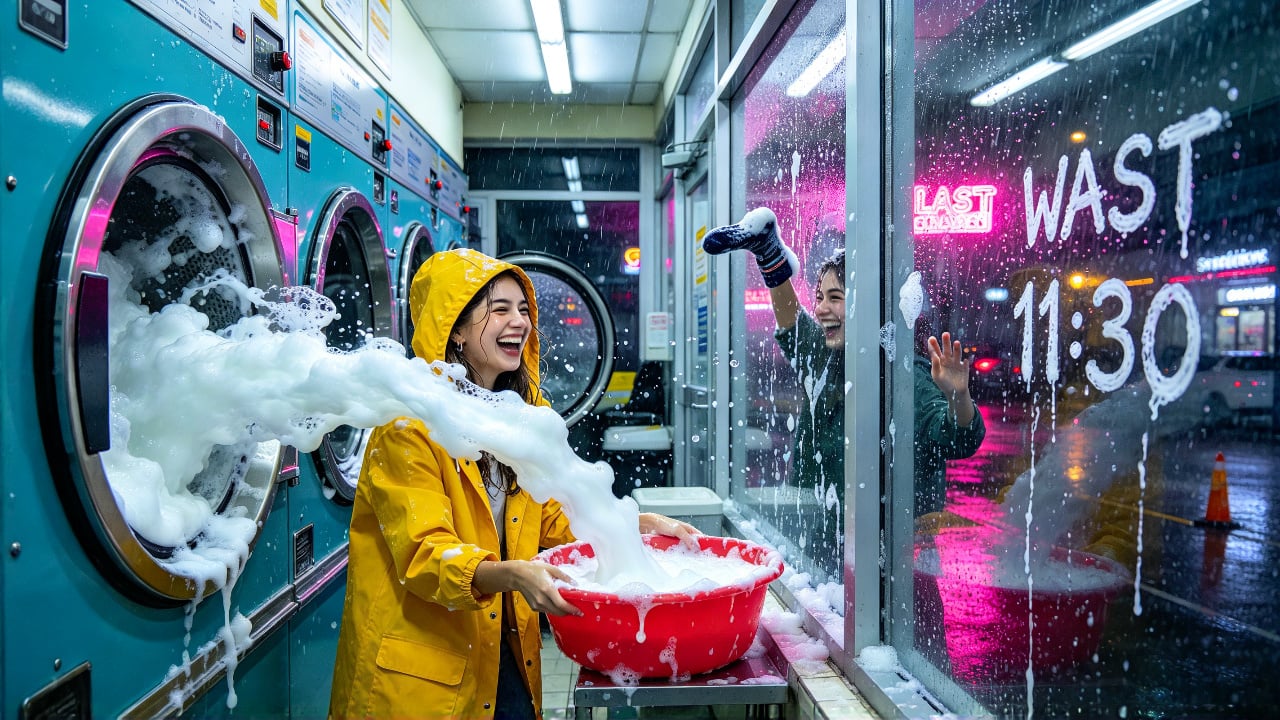
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
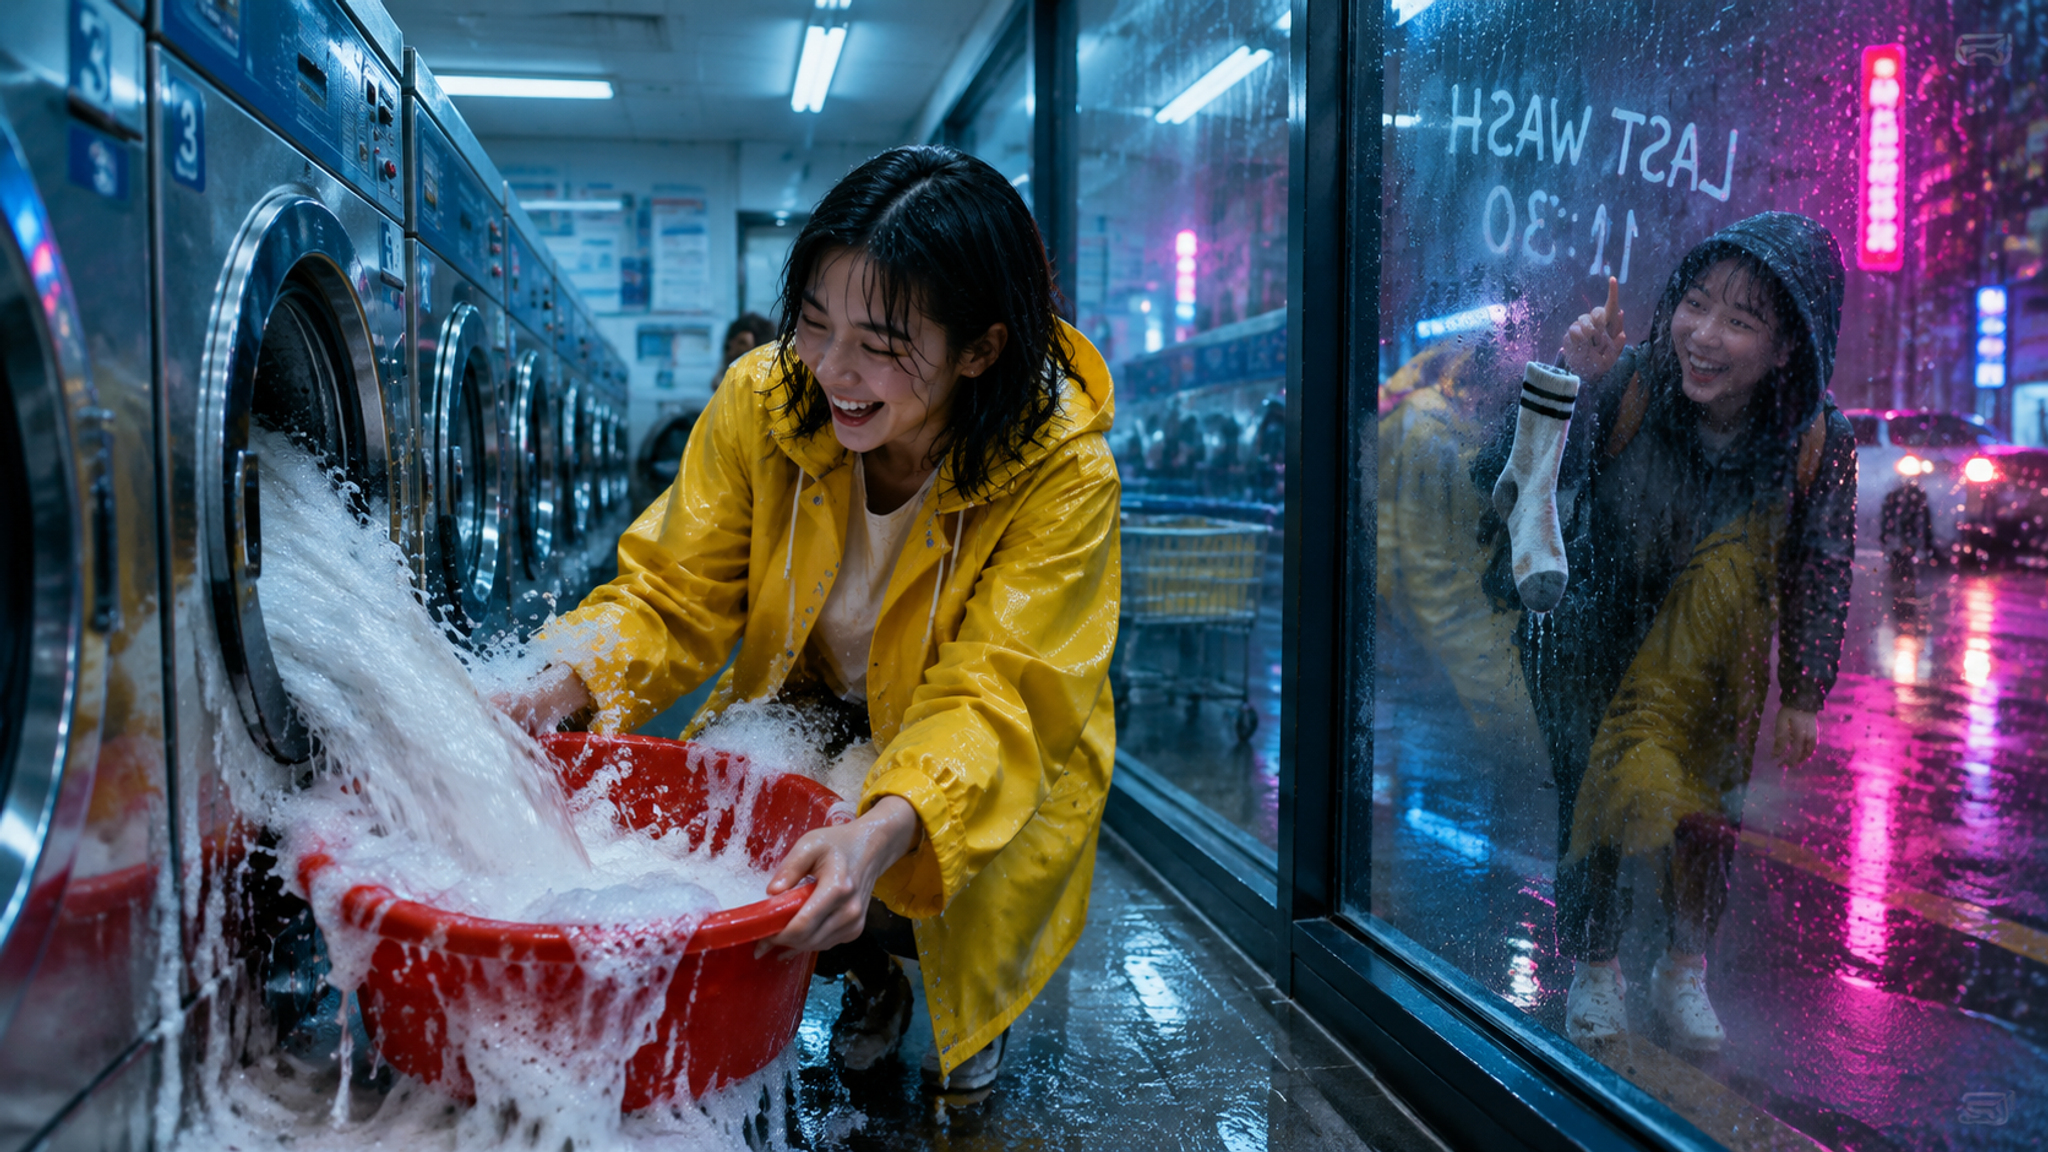
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
使用 Qwen Image 3.0 Pro 构建视觉系统
Qwen Image 3.0 Pro 支持制作营销活动平面素材、产品视觉、界面概念、分镜,以及保持身份特征的编辑,具备精准提示词遵循、复杂文本渲染、最高 2048×2048 输出,以及支持一至三张参考图等能力。

使用 Qwen Image 3.0 Pro 制作营销海报
利用 Qwen 在复杂文本渲染和精准提示词遵循方面的优势,将高要求的提示词转化为营销海报、横幅和社交媒体平面素材。为发布会、活动和促销制作最高 2048×2048 的品牌素材。

Qwen Image 3.0 Pro 产品视觉
根据文本生成产品场景,同时通过自动提示词改写扩展简要创意,并通过提示词引导的尺寸选择匹配的画布。生成结果适用于目录图片、电商促销,以及小团队的快速概念测试。

保持身份特征的人像编辑
通过自然语言编辑,在更换服装、场景、光照或视觉风格的同时保留面部特征和身份特征。人像工作室和创作者应用可以基于一至三张参考图,生成具有辨识度的营销活动变体。

界面与信息图概念
需要根据详细说明制作信息丰富的视觉内容?利用精准提示词遵循和复杂文本渲染,为产品或学习团队快速构思界面概念、教学图表、带注释的讲解图和演示文稿平面素材。

多参考图合成
在一次编辑请求中引入最多三张参考图,然后通过自然语言指定修改,同时保留关键细节。这适用于合成图、商品变体,以及以角色为中心的创意工作流。

使用 Qwen Image 3.0 Pro 制作分镜
根据精心编写的提示词勾勒连续场景,提示词遵循能力可帮助每一帧符合指定的主体、场景和视觉方向。电影制作人、代理机构和游戏团队可以将早期创意转化为分镜面板。
Qwen Image 3.0 pro 与主流图像 API 对比
从工作流、最大输出尺寸、参考图容量、提示词工具和 Atlas Cloud 标准价格等方面,对比 Qwen Image 3.0 pro、Seedream 和 Nano Banana 端点。
| 模型 | 工作流 | 最大输出尺寸 | 最大参考图数量 | 提示词工具 | 标准价格 |
|---|---|---|---|---|---|
| Qwen Image 3.0 Pro Text-to-Image | 文本生成图像 | 2048×2048 | - | 自动提示词重写 | $0.04/图 |
| Qwen Image 3.0 Pro Edit | 图像编辑 | 1440×1440 | 3 | 自动提示词重写 | $0.04/图 |
| Seedream v5.0 Pro Text-to-Image | 文本生成图像 | 最高 4.19 MP | - | 思考与提示词优化 | $0.045/图 |
| Seedream v5.0 Pro Edit | 图像编辑 | 最高 4.19 MP | 10 | 思考与提示词优化 | $0.045/图 |
| Nano Banana 2 Text-to-Image | 文本生成图像 | 4K | - | 思考与搜索增强 | $0.08/图 |
| Nano Banana 2 Edit | 图像编辑 | 4K | 14 | 思考与搜索增强 | $0.08/图 |
如何在 Atlas Cloud 上使用 Qwen Image 3.0 Pro
几分钟即可上手 — 按照以下简单步骤,通过 Atlas Cloud 平台集成和部署模型。
创建 Atlas Cloud 账户
在 atlascloud.ai 注册并完成验证。新用户可获得免费额度,用于探索平台和测试模型。
为何在 Atlas Cloud 使用 Qwen Image 3.0 Pro
将先进的 Qwen Image 3.0 Pro 模型与 Atlas Cloud 的 GPU 加速平台相结合,提供无与伦比的性能、可扩展性和开发体验。
性能与灵活性
低延迟:
GPU 优化推理,实现实时响应。
统一 API:
一次集成,畅用 Qwen Image 3.0 Pro、GPT、Gemini 和 DeepSeek。
透明定价:
按 Token 计费,支持 Serverless 模式。
企业与规模
开发者体验:
SDK、数据分析、微调工具和模板一应俱全。
可靠性:
99.99% 可用性、RBAC 权限控制、合规日志。
安全与合规:
SOC 2 Type II 认证、HIPAA 合规、美国数据主权。
Qwen Image 3.0 Pro API 常见问题解答
Qwen Image 3.0 Pro 是阿里巴巴推出的图像生成与编辑模型,可根据文本生成图像,或使用自然语言指令修改现有视觉内容。在 Atlas Cloud 上,它支持最高 2048×2048 的输出,并支持使用一至三张参考图像进行编辑。
你可以使用它生成需要高度遵循提示词、复杂文字渲染或高分辨率输出的图像。在编辑工作流中,自然语言指令可以在保留面部特征和身份等重要细节的同时修改图像。
选择文生图或编辑路由,然后通过 Atlas Cloud 的 OpenAI 兼容 API,使用对应的模型 ID 调用。构造和验证请求时,请以关联的 Playground 参数 Schema 作为唯一依据。
从提示词生成图像时,选择 qwen-image-3.0-pro/text-to-image;修改参考图像时,选择 qwen-image-3.0-pro/edit。两个路由分别使用独立的 Playground Schema,因此请使用与你选择的工作流对应的 Schema。
文生图支持最高 2048×2048 的分辨率。如果未手动选择分辨率,模型可以根据提示词来决定合适的分辨率。
你可以同时提供一至三张参考图像,以及一条自然语言编辑指令。编辑模型会根据这些输入执行所需修改,同时保留包括面部特征和身份在内的关键视觉细节。
会。文生图模型支持自动改写提示词,并会根据提示词选择分辨率。如果文字表述、布局或嵌入文本非常重要,请将输出与原始指令进行比对。
Atlas Cloud 对文生图和编辑模型均列出每张图像 $0.04 的标准基础价格。计费采用按量付费模式,开发者无需订阅即可使用任一工作流。
两个版本都支持文生图和图像编辑。阿里巴巴的官方概览将标准模型描述为兼顾质量与速度,但本文审阅的已验证来源未提供 Pro 与标准模型之间的量化对比。在确定生产环境默认版本前,请分别使用具有代表性的提示词测试两个版本。
首先使用清晰的参考图像,并明确说明哪些面部或身份细节必须保持不变。编辑端点最多接受三张参考图像,设计目标就是保留这些细节。如果仍然出现偏移,请简化所请求的变换,并评估另一次生成结果。
探索更多系列
Seedance 2.5
Seedance 2.5 API 现已在 Atlas Cloud 上线!它为开发者提供了 ByteDance 最新的视频模型。该模型可通过文本、单张图像或多达 50 个多模态参考,一次性生成长达 30 秒的原生视频,并包含同步音频和画面内的多语言文本。在 Atlas Cloud 上,您可以通过单个密钥访问它,其主体一致性和改进的物理特性能够保持长镜头的连贯性。

Wan 3.0
Wan 3.0 API 是阿里巴巴 Wan 视频系列的下一代产品,旨在将长视频生成、多参考控制和音视频质量推向新的高度。Atlas Cloud 已经托管了 Wan 2.7、2.6 和 2.5,而 Wan 3.0 使用相同的统一密钥运行,无需额外设置。立即开始构建吧。向下滚动至展示区,查看 Wan 3.0 的创作能力。
MiniMax H3
MiniMax H3 是 MiniMax 的多模态视频系列,支持文本、图像和参考内容引导创作。在支持的路由中,它能够保留参考媒体中的主体,提供灵活的宽高比,并通过 H3 Developer 将生成的声音与画面结合;输出配置则由 endpoint 选择。Atlas Cloud 通过一个 OpenAI 兼容密钥统一接入整个系列,并提供透明的按量付费定价,标准费率为每秒 $0.038。立即开始构建。
Seedream 5.0 Pro
Seedream 5.0 Pro API 为开发者在 Atlas Cloud 上提供了字节跳动的可控图像编辑模型。它通过锚点和坐标精确定位编辑,将图像分离为可编辑图层,融合多个参考,并精准匹配颜色和材质,支持 2K 和 3K 分辨率的多语言文本。在 Atlas Cloud 上,您只需一个密钥即可访问!
Seedance 2.0
Seedance 2.0 是 ByteDance 面向生产环境的视频模型,专用于精准镜头创作。将提示词转换为视频,使用首帧图像生成动画并可选用尾帧引导,或结合参考媒体和可选的联网搜索来塑造结果。Atlas Cloud 将这些工作流整合到统一的 API 中,提供透明的按量付费定价和一个兼容 OpenAI 的密钥。立即开始构建。
GPT Image 2.5
OpenAI 的 gpt-image-2.5 系列为开发者提供 Flare 和 Sunburst 两种选择,满足生产级图像工作流需求。支持最高 3840x2160 的任意分辨率渲染,并提供包括 xhigh 和 max 在内的五档质量等级,以匹配特定的输出要求。Atlas Cloud 提供开箱即用的 REST 推理服务,无冷启动,每次生成起价 $0.004,采用标准定价。立即开始构建。
GPT Image 2
GPT Image 2 API 为开发者提供了访问 OpenAI 最新图像模型的途径,它是 GPT Image 1.5 的继任者。该模型可生成和编辑图像,能够在拉丁和 CJK 文字上实现准确的文本渲染,并在海报、样机和信息图表方面具备强大的排版能力。在 Atlas Cloud 上,您可以通过一个统一的 API 与 300 多个模型一起访问它,并享受免费额度、99.99% 的正常运行时间,且无需 OpenAI 组织验证。
Gemini Omni Flash
gemini omni API 将 Google DeepMind 原生多模态的 Gemini Omni Flash 系列(包括 Gemini Omni 1.1 Flash)带给开发者。创建带同步原生音频的电影级视频,使用精确的起始帧和结束帧控制为静态图像制作动画,或通过文本引导式编辑修改现有视频,同时保留未编辑的内容。Atlas Cloud 提供一个 OpenAI 兼容密钥、统一访问能力以及透明的按量付费定价。立即开始构建。
Grok Imagine
Grok Imagine API 涵盖 xAI 的图像、视频和语音模型,包括 Image 2.0、Video 1.5 和 xAI TTS v1。支持生成跨 14 种宽高比的 1K 或 2K 静帧、生成最长 15 秒的 1080p 视频、通过最多 7 张参考图像引导镜头、或用 20 种语言进行配音。Atlas Cloud 在单一端点上运行所有功能,采用按量计费,起价为每张图像 $0.02、每秒 $0.05。立即开始使用。
Google最强大的创意模型现已在Atlas Cloud上全面可用。Veo 3.1提供电影级别的视频生成,Nano Banana 2支持高保真图像创建,而Gemini为每个工作流带来多模态智能。通过单一API key即可访问完整的Google模型套件,提供Day-0可用性和按需付费(pay-as-you-go)定价。
Seedance 2.0 Mini
Seedance 2.0 Mini 将 ByteDance 的多模态视频生成技术引入到对速度和成本要求极高的工作流中。它以更轻量的占用空间提供 Seedance 2.0 的核心能力——更快的生成速度、更低的单条视频成本,并且使用您现有的同款 API 集成。对于运行高吞吐量流水线或进行大规模原型设计的团队来说,Mini 是最实用的默认选择。
ByteDance
从电影级视频生成到高保真图像创建,ByteDance 最强大的模型现已在 Atlas Cloud 上线。以最低的推理定价和零基础设施开销,大规模运行 Seedance 和 Seedream。
推荐文章
指南、教程与产品动态,助你充分发挥 Atlas Cloud 的价值。


