


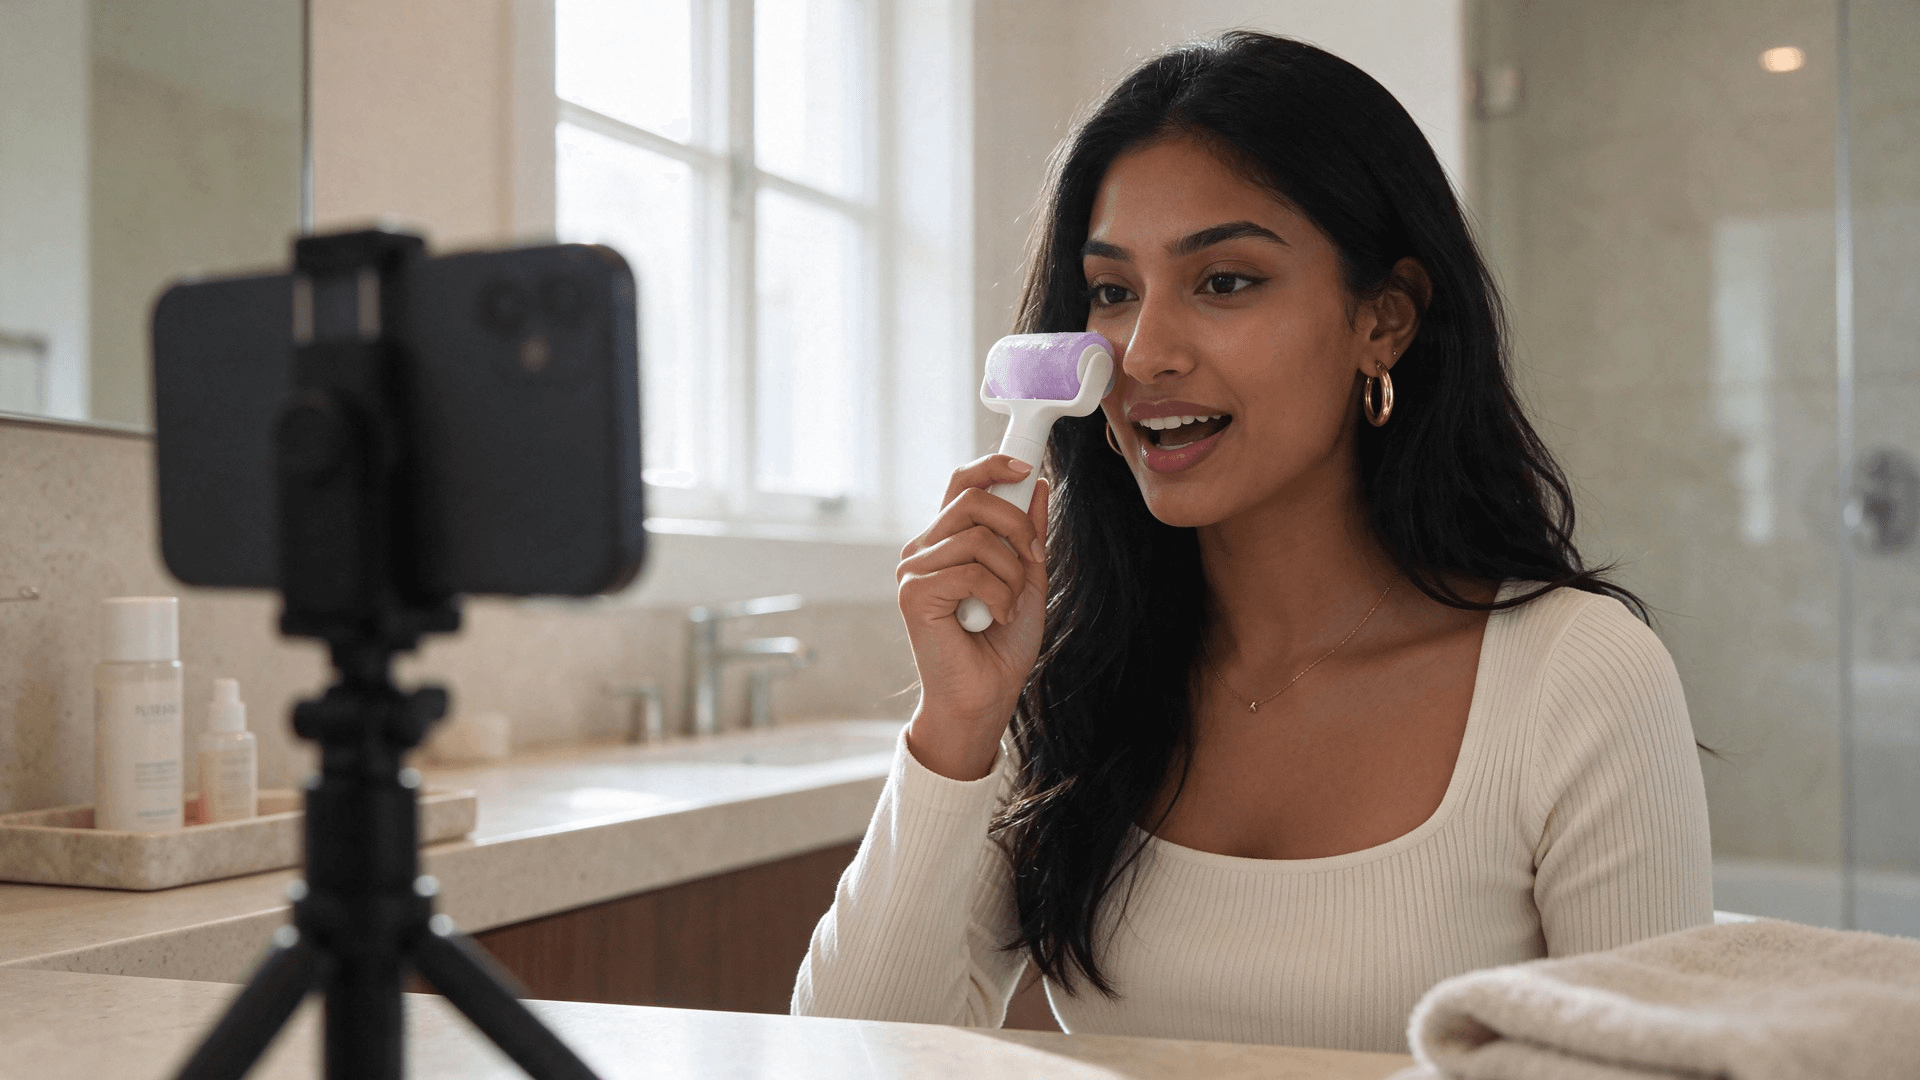
La vidéo s'ouvre sur une femme devant son vanity de salle de bain. Elle fait rouler un rouleau à glace givré sur sa pommette et se plaint d'un appel à 7 h du matin pris après quatre heures de sommeil. Personne n'a pointé de caméra vers elle. La vidéo provient d'un portrait, d'une photo produit et d'une réplique vocale de huit secondes.
Ce guide détaille comment créer un influenceur IA comme elle pour des vidéos de marque : un visage réutilisable dans n'importe quelle scène, des accroches empruntées à des vidéos déjà virales, et un clip parlant que vous pouvez régénérer à chaque changement de script. Nous avons construit le nôtre pendant la rédaction de l'article, donc chaque étape montre les entrées et sorties réelles.
Points clés
- Un influenceur IA est un visage cohérent que vous réutilisez dans vos vidéos, construit à partir d'une seule photo de référence.
- Partez d'accroches TikTok éprouvées : décortiquez une vidéo virale avant d'écrire la moindre ligne de script.
- Seedance 2.5 transforme un portrait, une photo produit et une réplique vocale en une vidéo parlante synchronisée.
- Écrivez trois accroches, générez chacune comme un clip, puis gardez celle dont les trois premières secondes fonctionnent.
- Étiquetez les présentateurs créés par IA sur TikTok, et n'utilisez qu'un visage réel pour lequel vous avez l'autorisation.
Qu'est-ce qu'un influenceur IA et qui en crée un
Un influenceur IA est une personne générée qui apparaît à l'écran encore et encore avec le même visage, la même voix et le même style. Le « encore et encore » est tout l'enjeu. Une belle image isolée est facile à produire. Un présentateur qui ressemble à la même femme dans une cuisine le lundi et dans une voiture le vendredi, voilà ce que les gens recherchent réellement.
Deux groupes en créent, et ils veulent des choses différentes :
| Compte persona | Présentateur de marque | |
|---|---|---|
| Objectif | Gagner des abonnés en tant que personne virtuelle | Mettre en avant des vidéos produit et des publicités |
| Ce qui doit rester fixe | Visage, personnalité, histoire personnelle | Visage, voix, style de prestation |
| Production type | Posts quotidiens, stories, lives | Accroches et démos de 10 à 30 secondes |
| Indicateur de succès | Taille de l'audience | Temps de visionnage et clics sur le produit |
Ce guide couvre la deuxième colonne. Si le format lui-même ne vous est pas familier, notre explication sur ce qu'est l'UGC IA couvre d'abord les bases.
Transformez une photo en influenceur IA parlant sur Atlas Cloud
Voici le clip final avant toute théorie : dix secondes, vertical, avec sa voix, un gros plan du rouleau en action, et le produit présenté à la fin.
Il a été créé sur Atlas Cloud avec Seedance 2.5 Reference-to-Video. En tant que générateur d'influenceur IA, il part de vos entrées : vous apportez le visage, le produit et la voix, et il construit le plan autour.
Il accepte jusqu'à 30 images de référence dans une seule requête, y compris des photos de personnes réelles, et un seul clip audio peut piloter le lip-sync à lui seul.
Cela compte pour un présentateur de marque. Le visage reste le vôtre dans chaque vidéo, et quand le script change, vous remplacez un fichier audio au lieu de planifier un nouveau tournage.
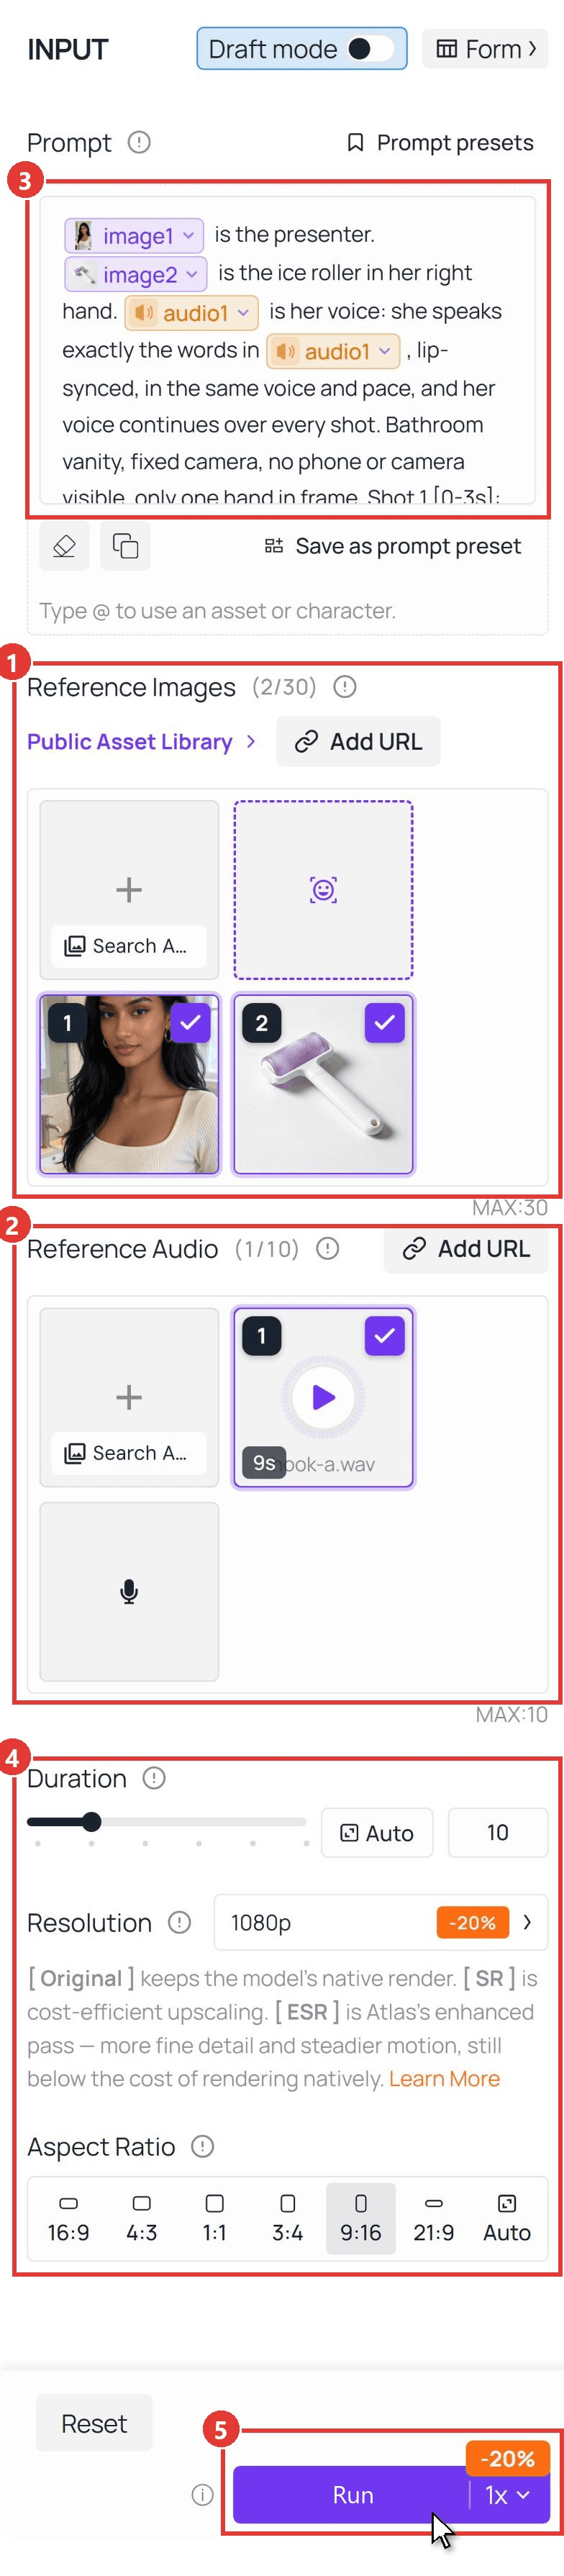
Toute l'exécution se fait sur une page du playground Seedance 2.5 Reference-to-Video :
- Téléchargez d'abord le portrait, puis la photo produit, sous Reference Images. L'ordre compte : le premier fichier devient Image1.
- Téléchargez la réplique vocale sous Reference Audio.
- Collez le prompt, puis retapez chaque mention @ et sélectionnez le fichier correspondant dans la liste pour qu'il devienne un tag.
- Réglez Duration sur 10, Resolution sur 1080p et Aspect Ratio sur 9:16.
- Cliquez sur Run.
Comment créer un influenceur IA en 5 étapes
Le playground est le dernier clic. Ce qui décide si la vidéo arrête le scroll, c'est tout ce que vous lui fournissez, alors voici comment créer un influenceur IA, de la recherche à l'accroche finale.
Étape 1 : décortiquez les accroches TikTok d'une véritable vidéo virale
Ne commencez pas avec un script vierge. Choisissez un short dans votre niche qui a déjà généré des vues, et démontez-le.
Nous avons utilisé une routine de 19 secondes de la chaîne All You Can Face, One Routine For A Puffy Face, Puffy Eyelids And Puffy Under Eyes. Plutôt que de la regarder dix fois, nous avons confié le lien à Gemini 3.5 Flash via l'API Atlas Cloud. Un lien YouTube public fonctionne directement comme entrée vidéo :
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
Voici ce qui est revenu, condensé :
| Ce que nous avons demandé | Ce que fait la vidéo |
|---|---|
| Ligne d'ouverture | « Faites ceci 20 fois si vous vous réveillez avec le visage gonflé. » |
| Type d'accroche | Point de douleur formulé comme une instruction directe |
| Structure | Quatre plans, un par problème, chacun ouvrant sur la même structure de phrase |
| Texte à l'écran | Une checklist qui ajoute un élément par plan |
| Cadrage | Poitrine et tête, yeux sur l'objectif tout du long |
| Schéma réutilisable | [Action] pendant [durée] si vous vous réveillez avec [problème] |
Une liste d'accroches TikTok vous donne des premières lignes. La partie utile d'un décorticage, c'est la structure sous la ligne : une structure de phrase répétée, un bénéfice visible par plan, pas d'intro. C'est ce que nous avons repris dans le script.
Étape 2 : figez un visage et réutilisez-le dans toutes les scènes
Votre influenceur n'est crédible pour les spectateurs que s'il ressemble à la même personne à chaque fois. Partez d'un portrait que vous avez le droit d'utiliser, puis changez tout sauf le visage : tenue, pièce, lumière.
N'importe quel modèle d'image qui édite à partir d'une référence peut le faire. Nous avons utilisé Seedream sur Atlas Cloud : le modèle 5.5 Edit pour transformer un portrait studio en plan maître de vanity de salle de bain, et l'éditeur séquentiel 5.0 Lite pour décliner trois scènes supplémentaires à partir de ce plan maître en une seule requête.
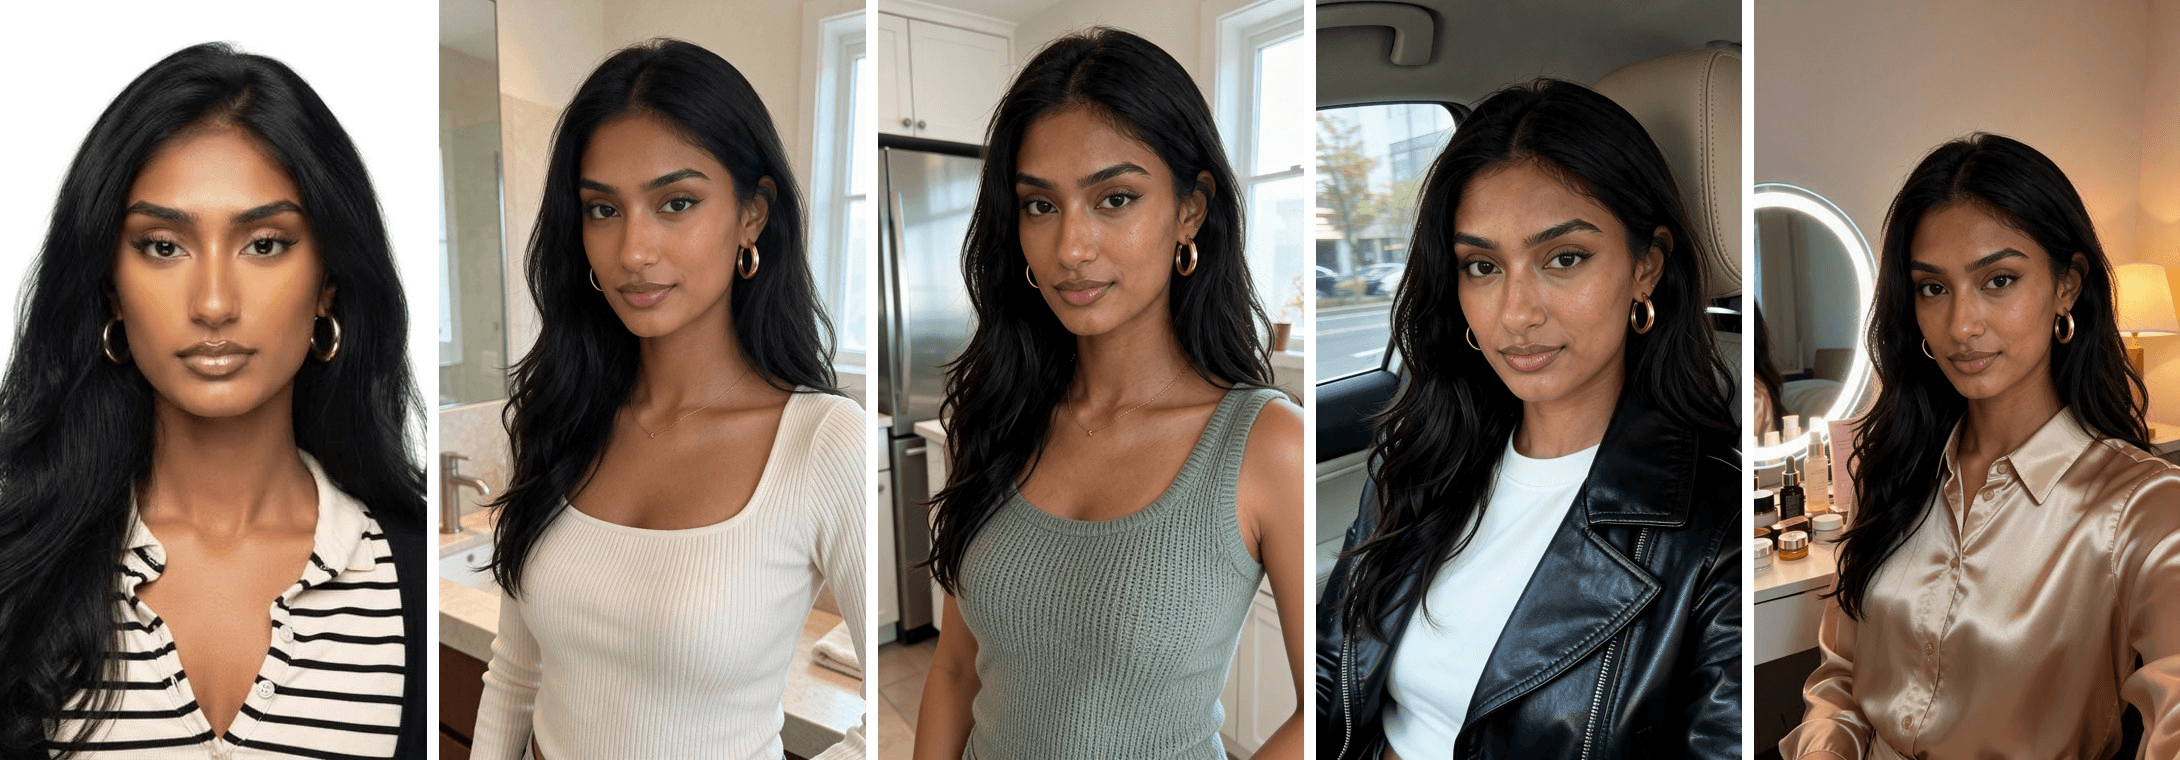
Trois éléments ont maintenu le visage stable chez nous :
- Figez l'identité, libérez le style. Nommez ce qui ne doit pas changer (visage, teint, coiffure, boucles d'oreilles) dans la première phrase, puis décrivez la nouvelle tenue et la pièce.
- Décrivez la caméra, pas le gadget. « Prise de vue avec une caméra fixe à hauteur de poitrine » donne un cadre propre façon selfie. Mentionnez un téléphone sur le comptoir et le modèle aura tendance à dessiner le téléphone.
- Habillez-la comme une créatrice. Les sweats basiques ressemblent à des images de stock. Un haut côtelé à encolure carrée ou une chemise en satin évoque quelqu'un qui se filme volontairement.
Étape 3 : écrivez des accroches virales pour TikTok sur un schéma éprouvé
Avec le schéma de l'étape 1, l'écriture devient un exercice à trous. Nous avons rédigé trois lignes pour le rouleau à glace, chacune empruntant une ouverture différente :
| Accroche | Ligne | Type d'ouverture |
|---|---|---|
| A | J'ai dormi quatre heures et j'avais un appel à 7 h. Deux minutes avec ce truc et personne ne m'a demandé si j'étais fatiguée. Voici comment je l'utilise. | Coup d'éclat plus un chiffre |
| B | Faites ceci pendant deux minutes si vous vous réveillez avec le visage gonflé. Remontez depuis la mâchoire, sous chaque œil, puis sur le front. C'est tout. | Le schéma de l'étape 1 |
| C | Arrêtez d'acheter de la crème contour des yeux contre les poches. Je mets ceci au congélateur toute la nuit, je roule pendant deux minutes, et la différence se voit à l'écran. | Conseil à contre-courant |
Ensuite, donnez à chaque ligne sa propre piste vocale. Seedance 2.5 synchronise les lèvres sur l'audio de référence lui-même, donc l'audio est le script : enregistrez ou générez chaque accroche comme un fichier séparé dans la même voix.
Nous avons généré les nôtres avec Gemini 2.5 Pro TTS sur Atlas Cloud, avec la voix Sulafat et une note de style d'une ligne avant le texte demandant une lecture décontractée, chaleureuse et légèrement enjouée.
Étape 4 (méthode 1) : générez la vidéo parlante dans le playground
Exécutez les cinq clics de la capture ci-dessus une fois par accroche. Seul le fichier audio change entre les exécutions. Le prompt reste le même :
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
Deux choix dans ce prompt font l'essentiel du travail. Le plan du milieu est un gros plan parce que les petits détails mécaniques, comme un cylindre qui tourne, se lisent mieux quand le produit remplit le cadre. Et la réplique vocale se poursuit explicitement par-dessus la coupe, pour que le gros plan ressemble à du B-roll au sein d'une seule prise.
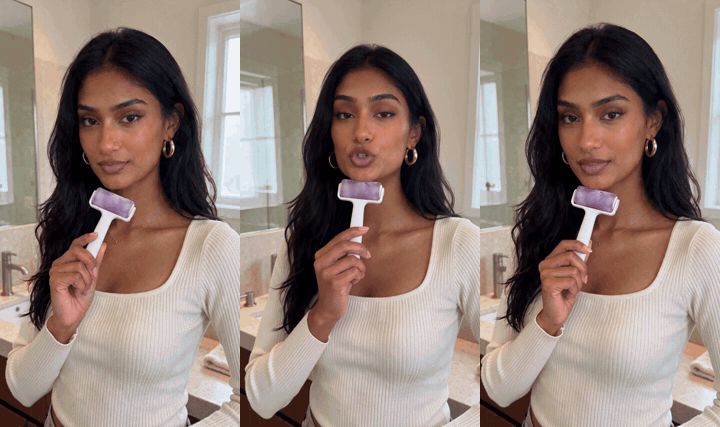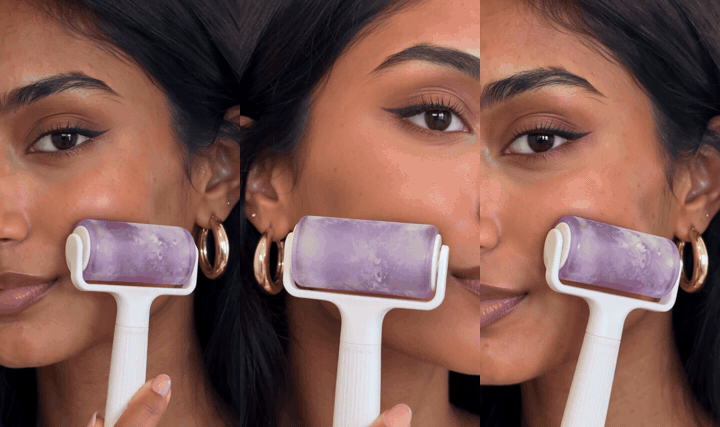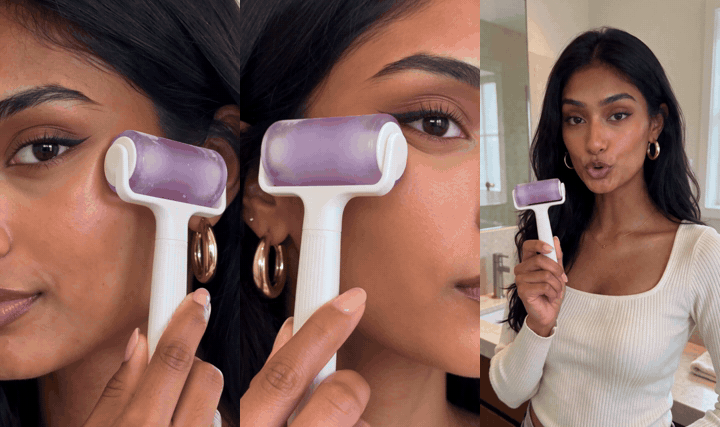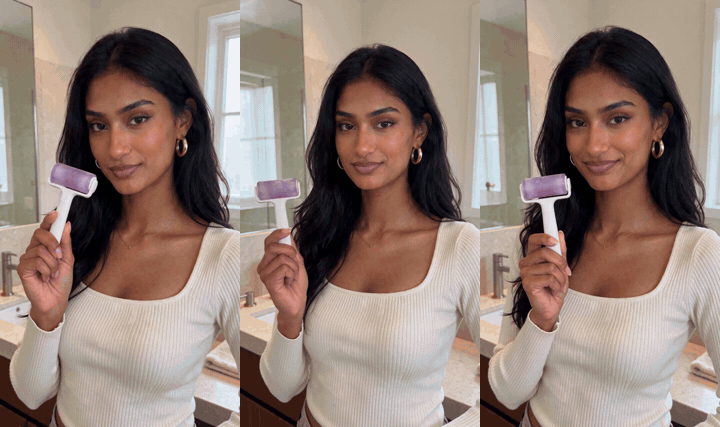
Nous avons gardé l'accroche A pour la version 1080p. Ses deux premières secondes portent un chiffre et un enjeu (quatre heures de sommeil, un appel à 7 h), donc le spectateur connaît le bénéfice avant la première coupe. Si vous préférez écrire à la main chaque plan et chaque liste de plans, notre workflow de pub UGC IA en 20 minutes suit cette voie.
Étape 5 (méthode 2) : traitez les accroches en lot via l'API
Une fois qu'une accroche fonctionne, l'API transforme les dix autres en une boucle sur les fichiers audio.
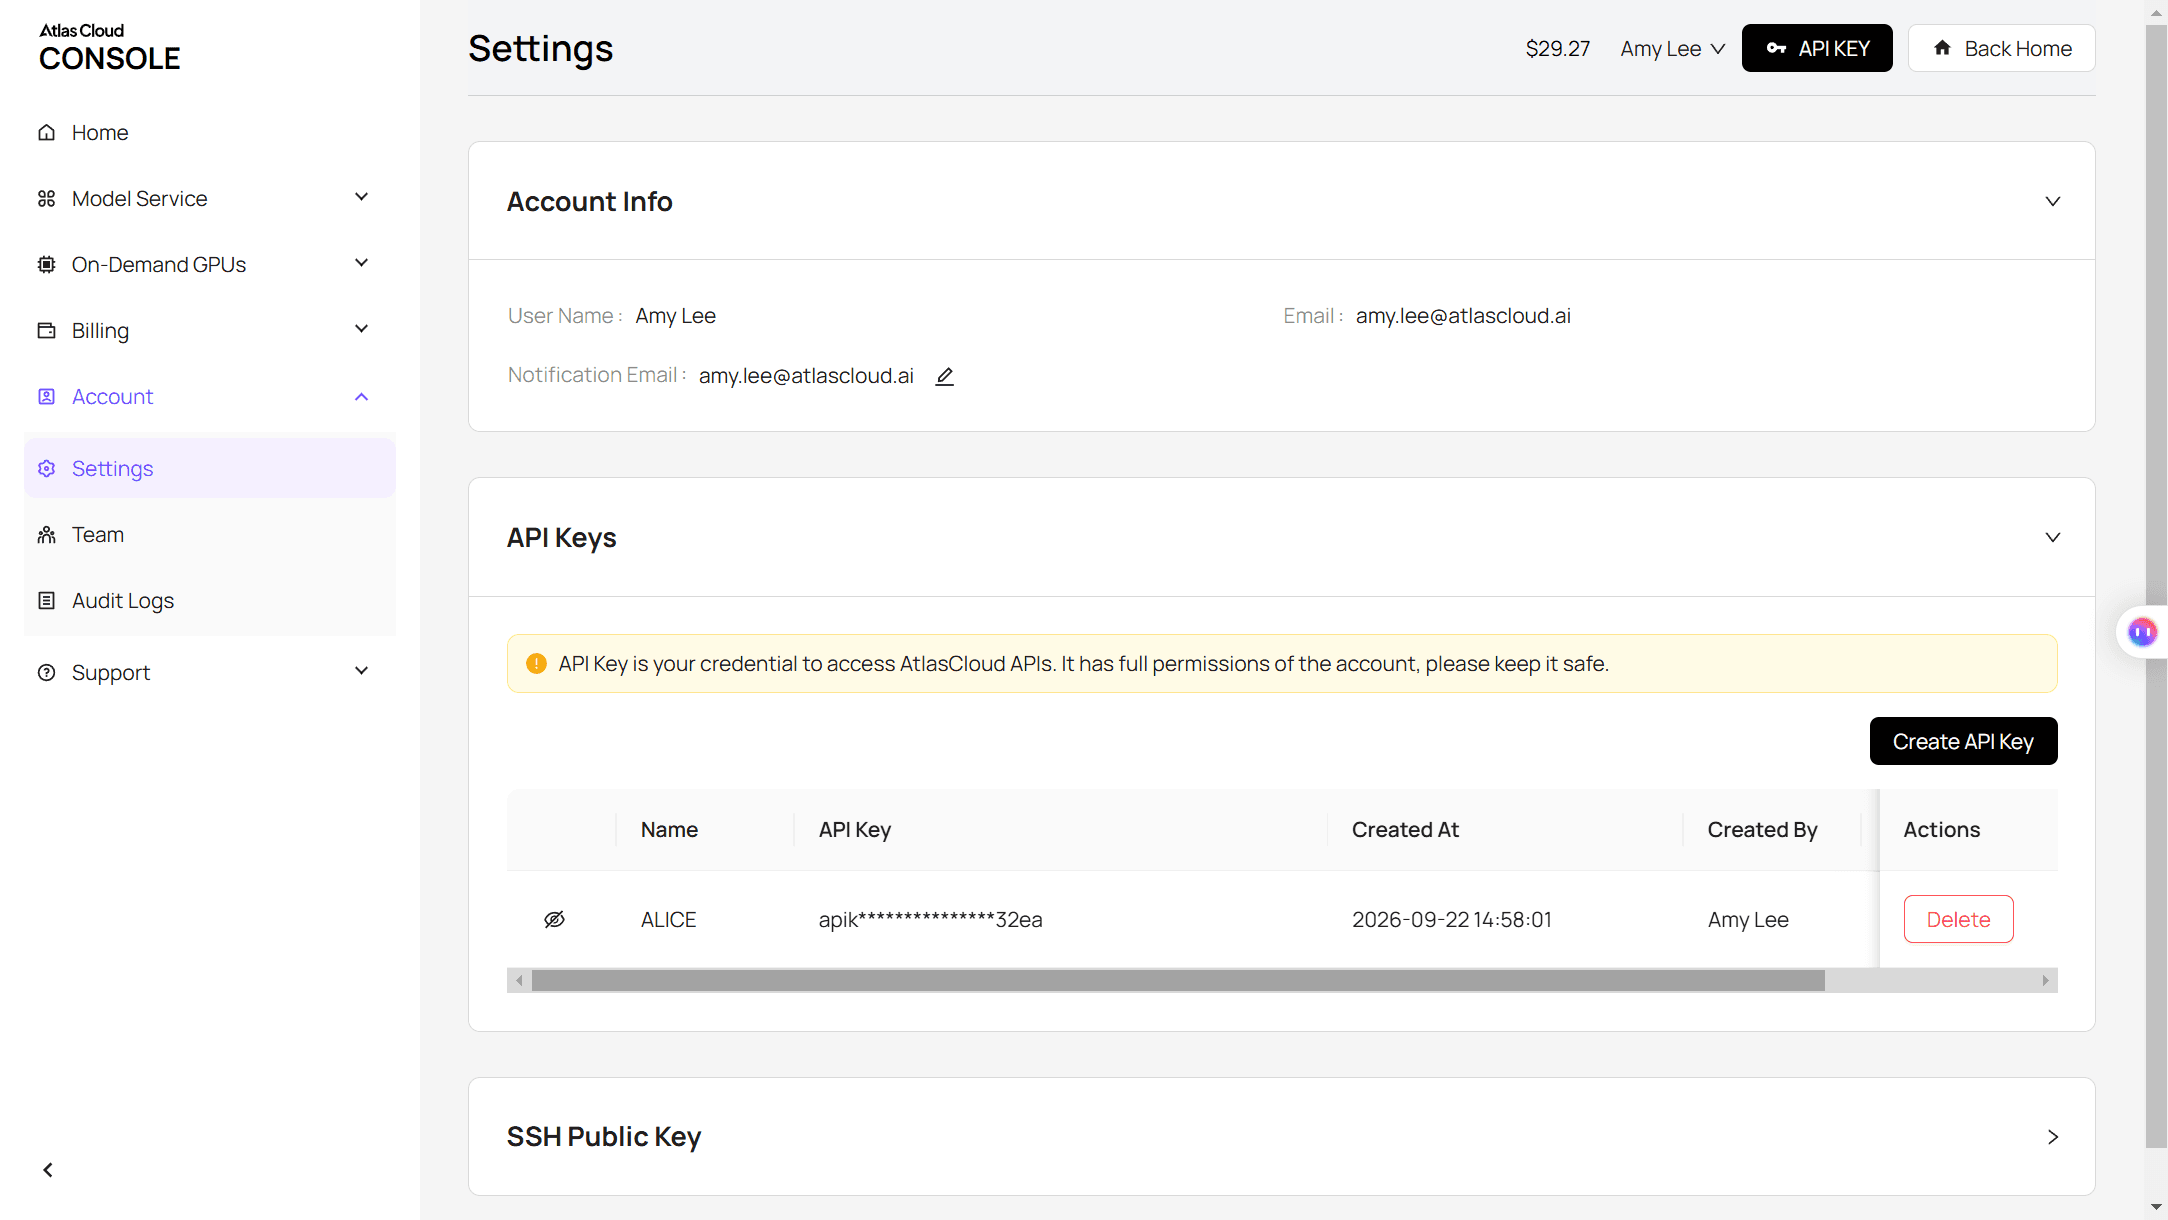
Étape 1 : créez et copiez votre clé API. Ouvrez la console Atlas Cloud, allez dans Settings, puis API Keys, et cliquez sur Create API Key.
Étape 2 : consultez la doc API. Les paramètres de chaque modèle, y compris les champs de référence utilisés ici, se trouvent dans la documentation API.
Étape 3 : faites votre première requête. Soumettez une accroche :
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
La réponse renvoie un ID de prédiction. Interrogez-le jusqu'à ce que le statut affiche completed :
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
Pour traiter en lot, gardez le corps fixe et remplacez l'URL de reference_audios pour chaque accroche. Atlas Cloud fait tourner une seule API sur tous ses modèles : chaque modèle vidéo partage ce endpoint, cette clé et cette boucle d'interrogation, donc changer de modèle revient à changer la chaîne du modèle. Les étapes image et voix ci-dessus utilisent la même clé et le même schéma soumettre-puis-interroger.
Pour une grille de test complète accroche par format, voir comment industrialiser la production de pubs UGC.
Règles des influenceurs IA : étiquetage et droit à l'image
Avant qu'elle ne vende quoi que ce soit, vérifiez deux types de règles : les étiquettes des plateformes et les lois sur les personnes synthétiques dans la publicité.
| Où | Ce qui est demandé | Ce qu'il faut faire |
|---|---|---|
| TikTok | Étiqueter le contenu généré par IA qui montre des scènes ou des personnes réalistes | Activez l'étiquette IA-généré ou ajoutez une légende ou un sticker au moment de publier |
| Publicités dans l'État de New York | Divulguer un interprète synthétique dans une pub quand l'annonceur sait qu'un tel interprète est utilisé | Ajoutez une mention claire et visible à la pub |
| Visages réels comme références | Autorisation de la personne dont vous utilisez l'image | Obtenez un consentement écrit, ou partez d'un portrait dont vous détenez les droits |
TikTok a introduit son étiquette de contenu généré par IA en septembre 2023 et demande aux créateurs de l'utiliser sur les contenus IA réalistes. La loi de New York sur les interprètes synthétiques, S.8420-A, a été signée le 11 décembre 2025 et est entrée en vigueur le 9 juin 2026, avec des sanctions civiles de 1 000 $ pour une première infraction et de 5 000 $ pour chaque infraction suivante.
Côté modèle, Seedance 2.5 sur Atlas Cloud accepte des photos de personnes réelles comme références et les enregistre automatiquement comme ressources. Sa documentation demande de n'utiliser l'image d'une personne réelle qu'avec son autorisation, soit la même règle que vous appliqueriez avec un créateur humain.
Questions fréquentes
Combien coûte la création d'un influenceur IA ?
Les portraits ont coûté environ 0,03 $ chacun avec Seedream 5.5 Edit en 9:16. La vidéo Seedance 2.5 est facturée selon la résolution et la durée : un clip vertical de 10 secondes avec deux images de référence et un fichier voix revient à environ 3,02 $ en 720p et à environ 5,94 $ en 1080p sur Atlas Cloud.
Ces prix sont valables au 13 novembre 2026, avec une remise de 20 % appliquée. Comme chaque accroche est son propre clip, le principal coût de l'UGC IA dépend du nombre d'accroches que vous testez avant d'en choisir une gagnante.
Existe-t-il un générateur d'accroches TikTok que je peux utiliser ?
N'importe quel modèle de texte peut générer des accroches, mais le résultat s'améliore quand vous lui donnez un schéma plutôt qu'un sujet. Décortiquez d'abord une vidéo virale (étape 1), puis demandez au modèle dix lignes dans cette structure de phrase exacte pour votre produit. Choisir trois accroches à filmer vaut mieux que d'en générer cinquante et n'en filmer aucune.
Mon influenceur IA peut-il parler d'autres langues ?
Oui. Seedance 2.5 génère la parole nativement dans plus de 10 langues, selon la documentation de son modèle. Pour une synchronisation labiale plus précise, générez d'abord la réplique vocale dans la langue cible et passez-la comme audio de référence, exactement comme vous le feriez pour l'anglais.
Quelle durée peut avoir une vidéo d'influenceur IA ?
Une génération Seedance 2.5 va de 4 à 30 secondes. Les accroches fonctionnent mieux courtes : nos trois clips font 10 secondes chacun, ce qui laisse la place à une ligne, un gros plan et une présentation produit. Pour des pubs plus longues, générez les scènes séparément et montez-les ensemble.
Conclusion
Le visage est la partie facile désormais. Ce qui distingue un présentateur qui vend d'un présentateur qui se contente d'être beau, c'est le travail autour : un schéma d'accroche repris d'un contenu déjà viral, un seul portrait réutilisé dans toutes les scènes, et une piste vocale pour chaque ligne afin que les lèvres correspondent aux mots.
Si vous cherchez comment créer un influenceur IA pour votre propre produit, commencez petit. Décortiquez une vidéo, écrivez trois lignes, générez trois clips, et gardez celui qui mérite ses trois premières secondes. Ensuite, laissez l'API répéter la boucle pour chaque accroche suivante.




