La barra di download arriva a 65 GB, le ventole iniziano a girare e la domanda vera si fa strada: si caricherà davvero? La risposta breve ai requisiti di memoria di GPT-OSS-120B è di circa 61 GB per i pesi più qualcosa per lo spazio di lavoro, motivo per cui OpenAI lo presenta come un modello per singola GPU da 80GB.
Di seguito, suddividiamo quel numero in parti, mostriamo l'hardware che lo ha eseguito con velocità misurate e copriamo la soluzione ospitata per quando il tuo hardware non è sufficiente.
Punti chiave
- GPT-OSS-120B viene distribuito come checkpoint MXFP4 da 60,8 GiB, motivo per cui OpenAI punta a una singola GPU da 80GB.
- La lunghezza del contesto aggiunge poca memoria: la KV cache raggiunge solo circa 4,5 GiB a 131K token completi.
- Con meno di 80GB di VRAM, llama.cpp può scaricare i livelli esperti sulla RAM di sistema e continuare a eseguirlo.
- I Mac con più di 96GB di memoria e i mini PC da 128GB possono contenere il modello completo in un'unica macchina.
- Nessun hardware adatto? Chiama Qwen3.5 122B A10B su Atlas Cloud tramite un'API compatibile con OpenAI.
Requisiti di memoria di GPT-OSS-120B: pesi più KV cache
OpenAI ha rilasciato gpt-oss-120b il 5 agosto 2025, con licenza Apache 2.0. È un modello mixture-of-experts, quindi solo 5,1B dei suoi 116,8B parametri lavorano su ogni token. Questo aiuta la velocità, non la memoria: ogni esperto deve comunque risiedere in memoria pronto per essere scelto.
Il trucco che lo mantiene piccolo è MXFP4. Secondo la scheda del modello gpt-oss, i pesi esperti, che costituiscono oltre il 90% dei parametri, sono memorizzati a 4,25 bit ciascuno. Una copia a 16 bit dello stesso modello richiederebbe circa quattro volte lo spazio.
| Specifica | GPT-OSS-120B |
|---|---|
| Parametri totali | 116.8B |
| Parametri attivi per token | 5.1B |
| Livelli ed esperti | 36 livelli, 128 esperti, 4 attivi per token |
| Formato dei pesi | MXFP4 per i livelli esperti, BF16 per il resto |
| Dimensione del checkpoint | 60.8 GiB |
| Finestra di contesto | 131.072 token |
Come la finestra di contesto modifica la memoria di GPT-OSS-120B
Ogni token lascia una chiave e un valore in ogni livello di attenzione. Quello store è la KV cache, e quando ogni livello presta attenzione all'intero contesto, cresce in base alla lunghezza del contesto.
GPT-OSS-120B ne evita la maggior parte. Metà dei suoi 36 livelli utilizza una finestra scorrevole che guarda indietro solo 128 token, e ogni livello memorizza solo 8 teste KV di 64 dimensioni. Solo 18 livelli mantengono l'intero contesto. Abbiamo calcolato la KV cache dalla configurazione del modello e corrisponde ai totali misurati nella guida gpt-oss di llama.cpp.
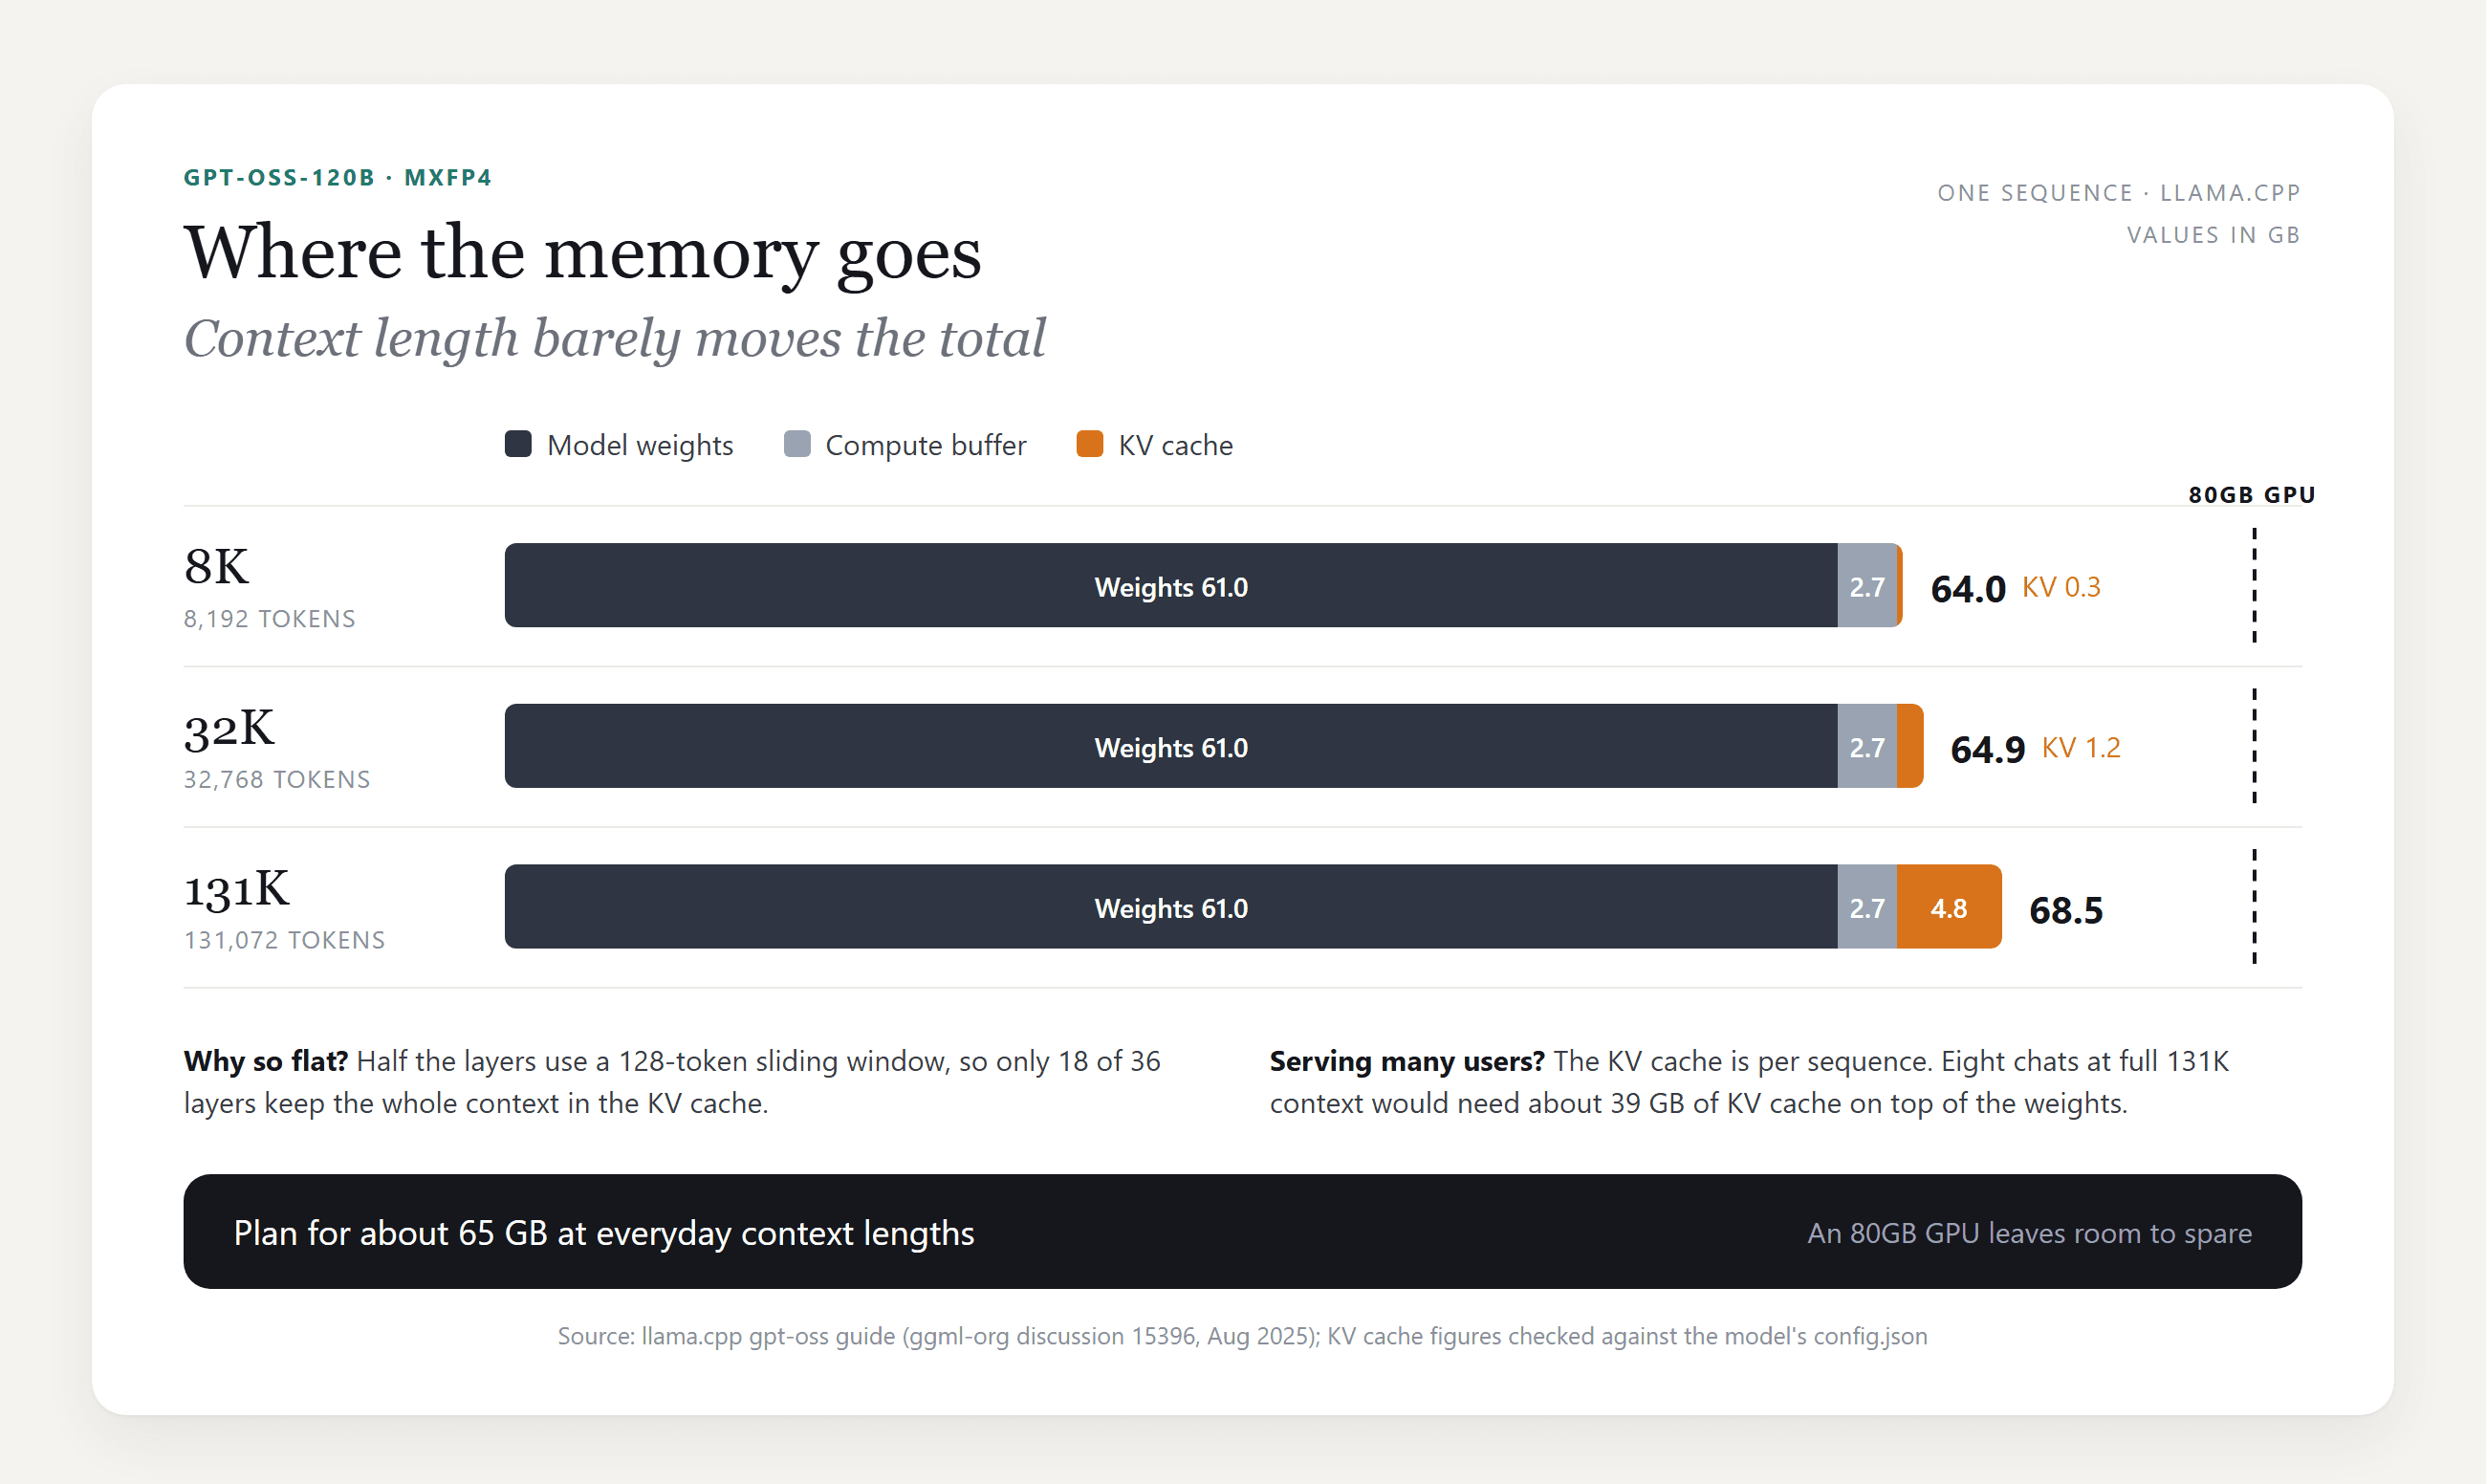
Passare da 8K a 131K completi costa meno di 5 GB. Dove si accumula è nella concorrenza: la KV cache è per conversazione, quindi un server che gestisce otto chat a lunghezza completa necessita di circa 39 GB in aggiunta ai pesi.
Posso eseguire GPT-OSS-120B localmente? Requisiti hardware per configurazione
Sì, se puoi allocare circa 65 GB da qualche parte veloce: una grande GPU, una GPU più RAM di sistema, o una macchina con memoria unificata.
Requisiti GPU per GPT-OSS-120B
Il caso più semplice è una scheda data center da 80GB. La ricetta vLLM per gpt-oss afferma che il modello 120b "starà su una singola A100 (80GB)", e che dividerlo su più GPU aiuta il throughput.
Sotto gli 80GB, la guida di llama.cpp offre una via d'uscita. Il suo flag --n-cpu-moe mantiene alcuni livelli esperti nella RAM di sistema e il resto sulla GPU. La guida indica il minimo a circa 8GB di VRAM, a condizione che GPU e memoria di sistema insieme contengano ancora il modello.
| Configurazione | Dove risiedono i pesi | Velocità di generazione riportata |
|---|---|---|
| RTX Pro 6000, 96GB | Tutto sulla GPU | 196 token/s (guida llama.cpp) |
| A100 o H100, 80GB | Tutto sulla GPU | Sta su una scheda (ricetta vLLM) |
| RTX 5090, 32GB, più RAM di sistema | 21 livelli esperti mantenuti nella RAM di sistema | Circa 30 token/s a contesto zero (guida llama.cpp) |
Una trappola di Windows dalla stessa guida: il driver può riversarsi silenziosamente nella RAM di sistema quando la VRAM si esaurisce, quindi il modello si carica e poi si trascina. Controlla GPU Memory in Task Manager e aumenta il conteggio di offload finché non rimane sotto la dimensione della tua scheda.
Eseguire GPT-OSS-120B su un Mac o mini PC da 128GB
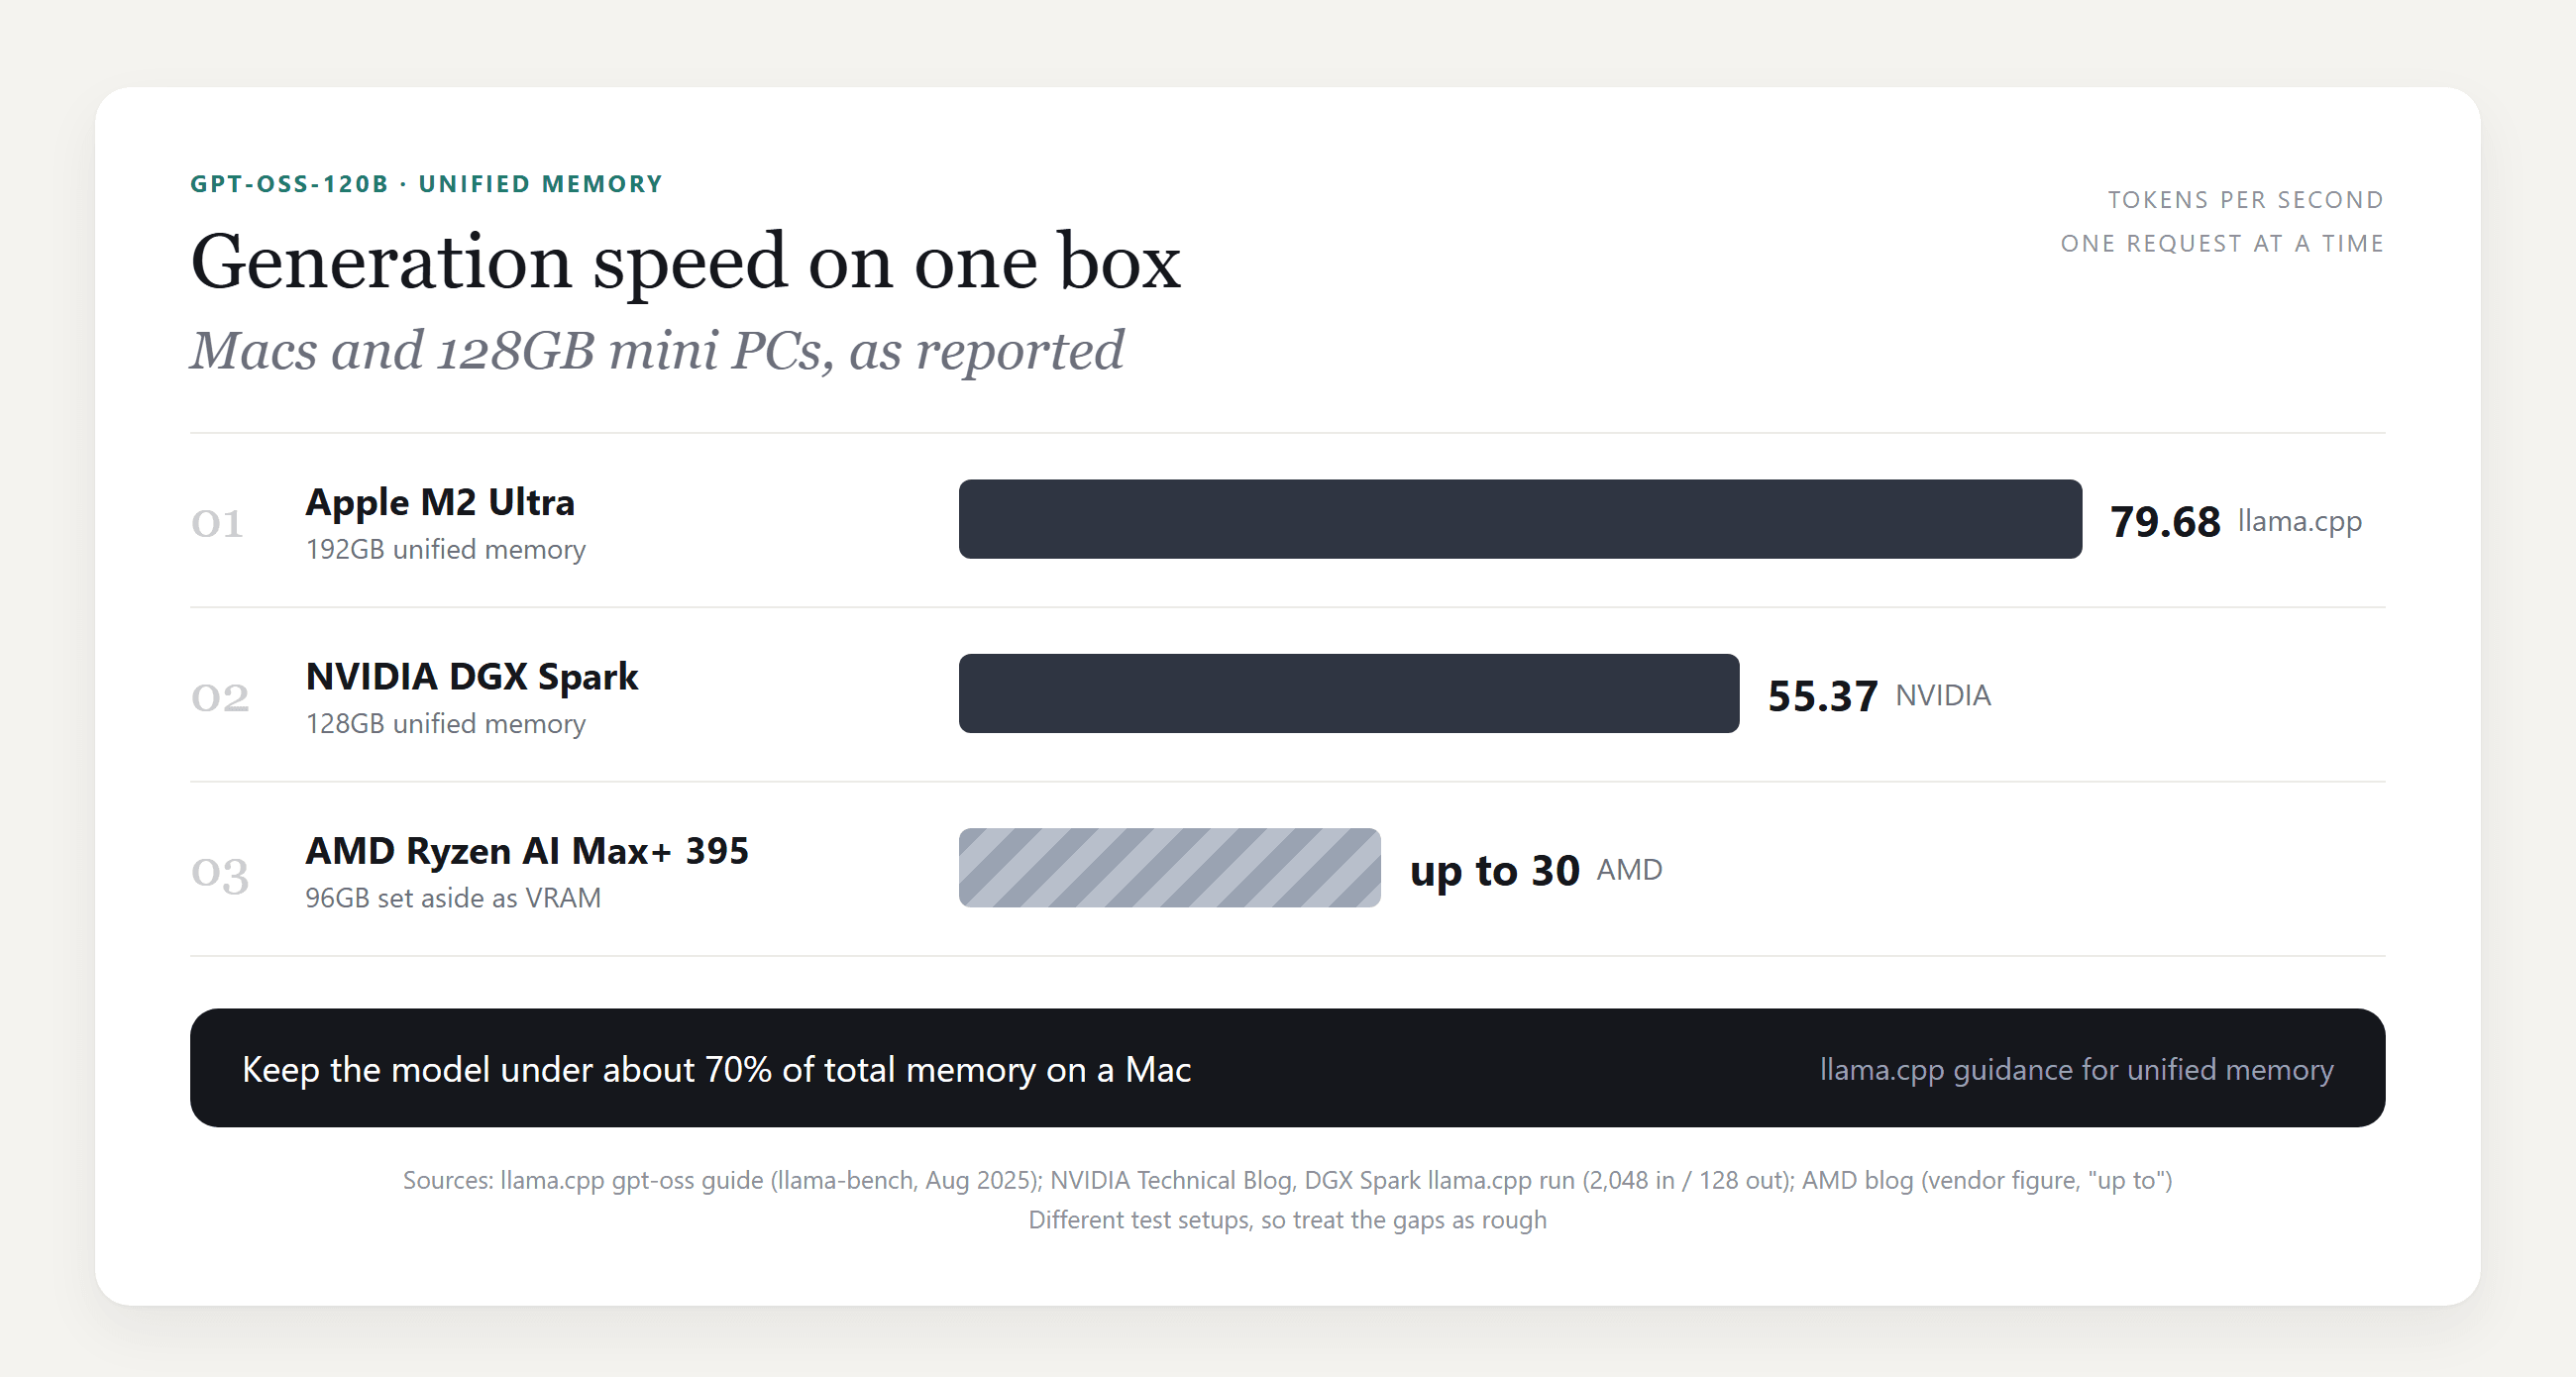
La memoria unificata elimina la divisione tra GPU e RAM. La guida di llama.cpp afferma che i Mac con più di 96GB di RAM, come le macchine M2 Ultra o M3 Max, possono eseguire il modello a contesto completo, e consiglia di rimanere sotto circa il 70% della memoria totale.
macOS limita la quantità di memoria che la GPU può allocare per impostazione predefinita. Su una macchina da 192GB, la guida alza quel limite da 154GB a 180GB con un comando:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
I nuovi mini PC da 128GB rientrano nella stessa classe. NVIDIA riporta 55,37 token/s per gpt-oss-120b su un DGX Spark con llama.cpp. AMD afferma che una macchina Ryzen AI Max+ 395 con 96GB riservati come VRAM raggiunge "fino a 30 token al secondo", che è il dato dell'azienda stessa.
Memoria insufficiente? Usa un modello open-weight ospitato tramite API
Se nessuna di quelle macchine è sulla tua scrivania, un modello open-weight ospitato salta completamente la questione hardware.
Atlas Cloud serve Qwen3.5 122B A10B, parte della sua linea di modelli Qwen. Sulla carta è un'ottima corrispondenza per gpt-oss-120b: un modello mixture-of-experts Apache 2.0 del team Qwen di Alibaba, con 122B totali e 10B parametri attivi. Legge fino a 262.144 token di contesto.
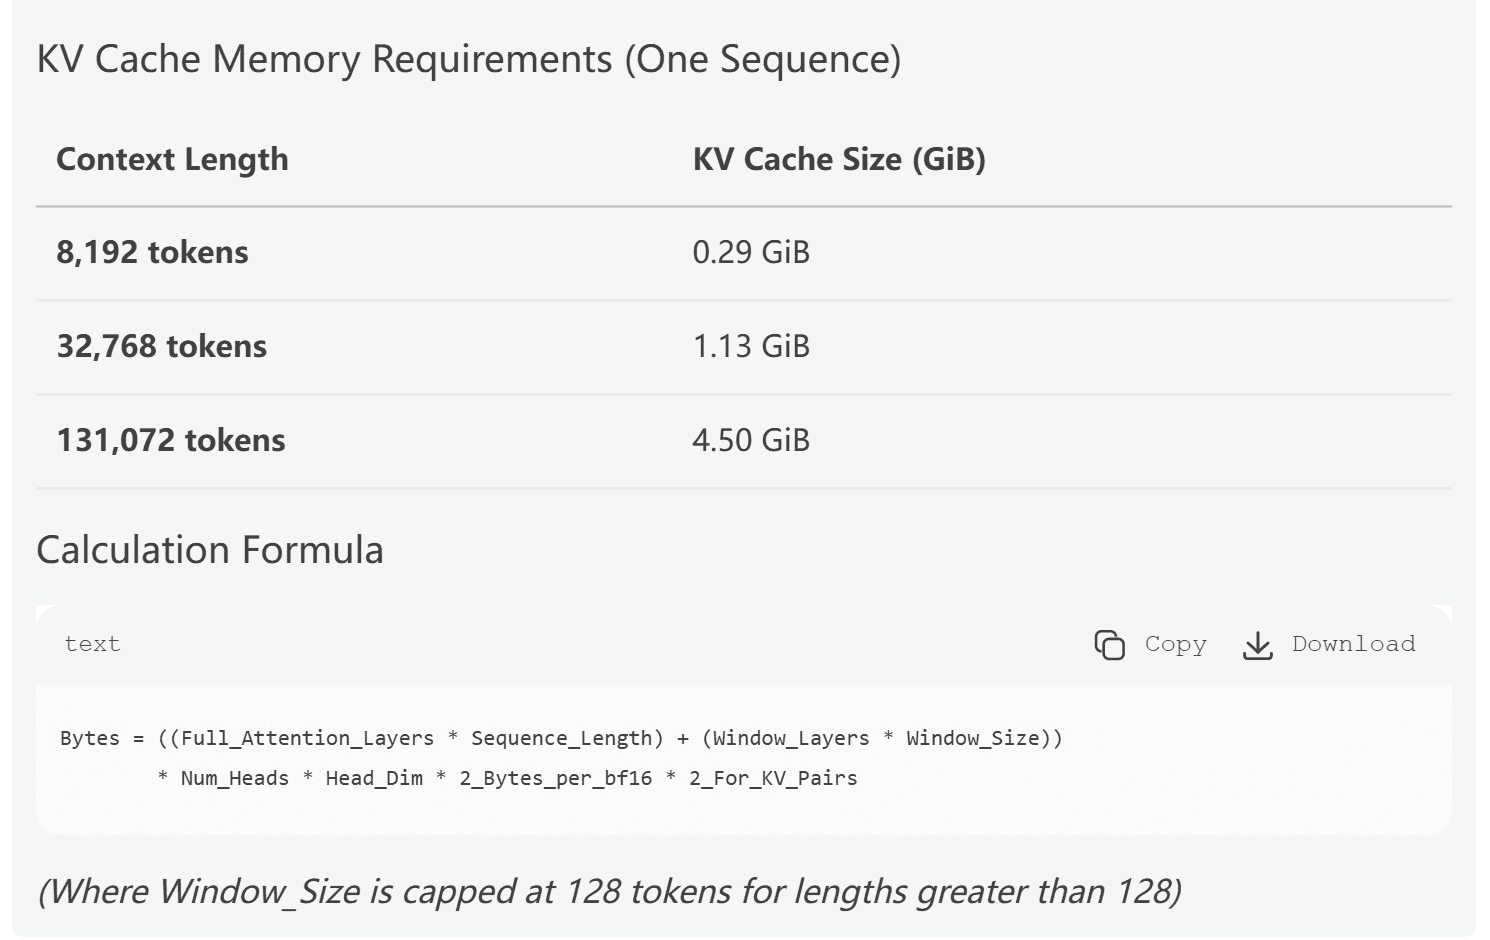
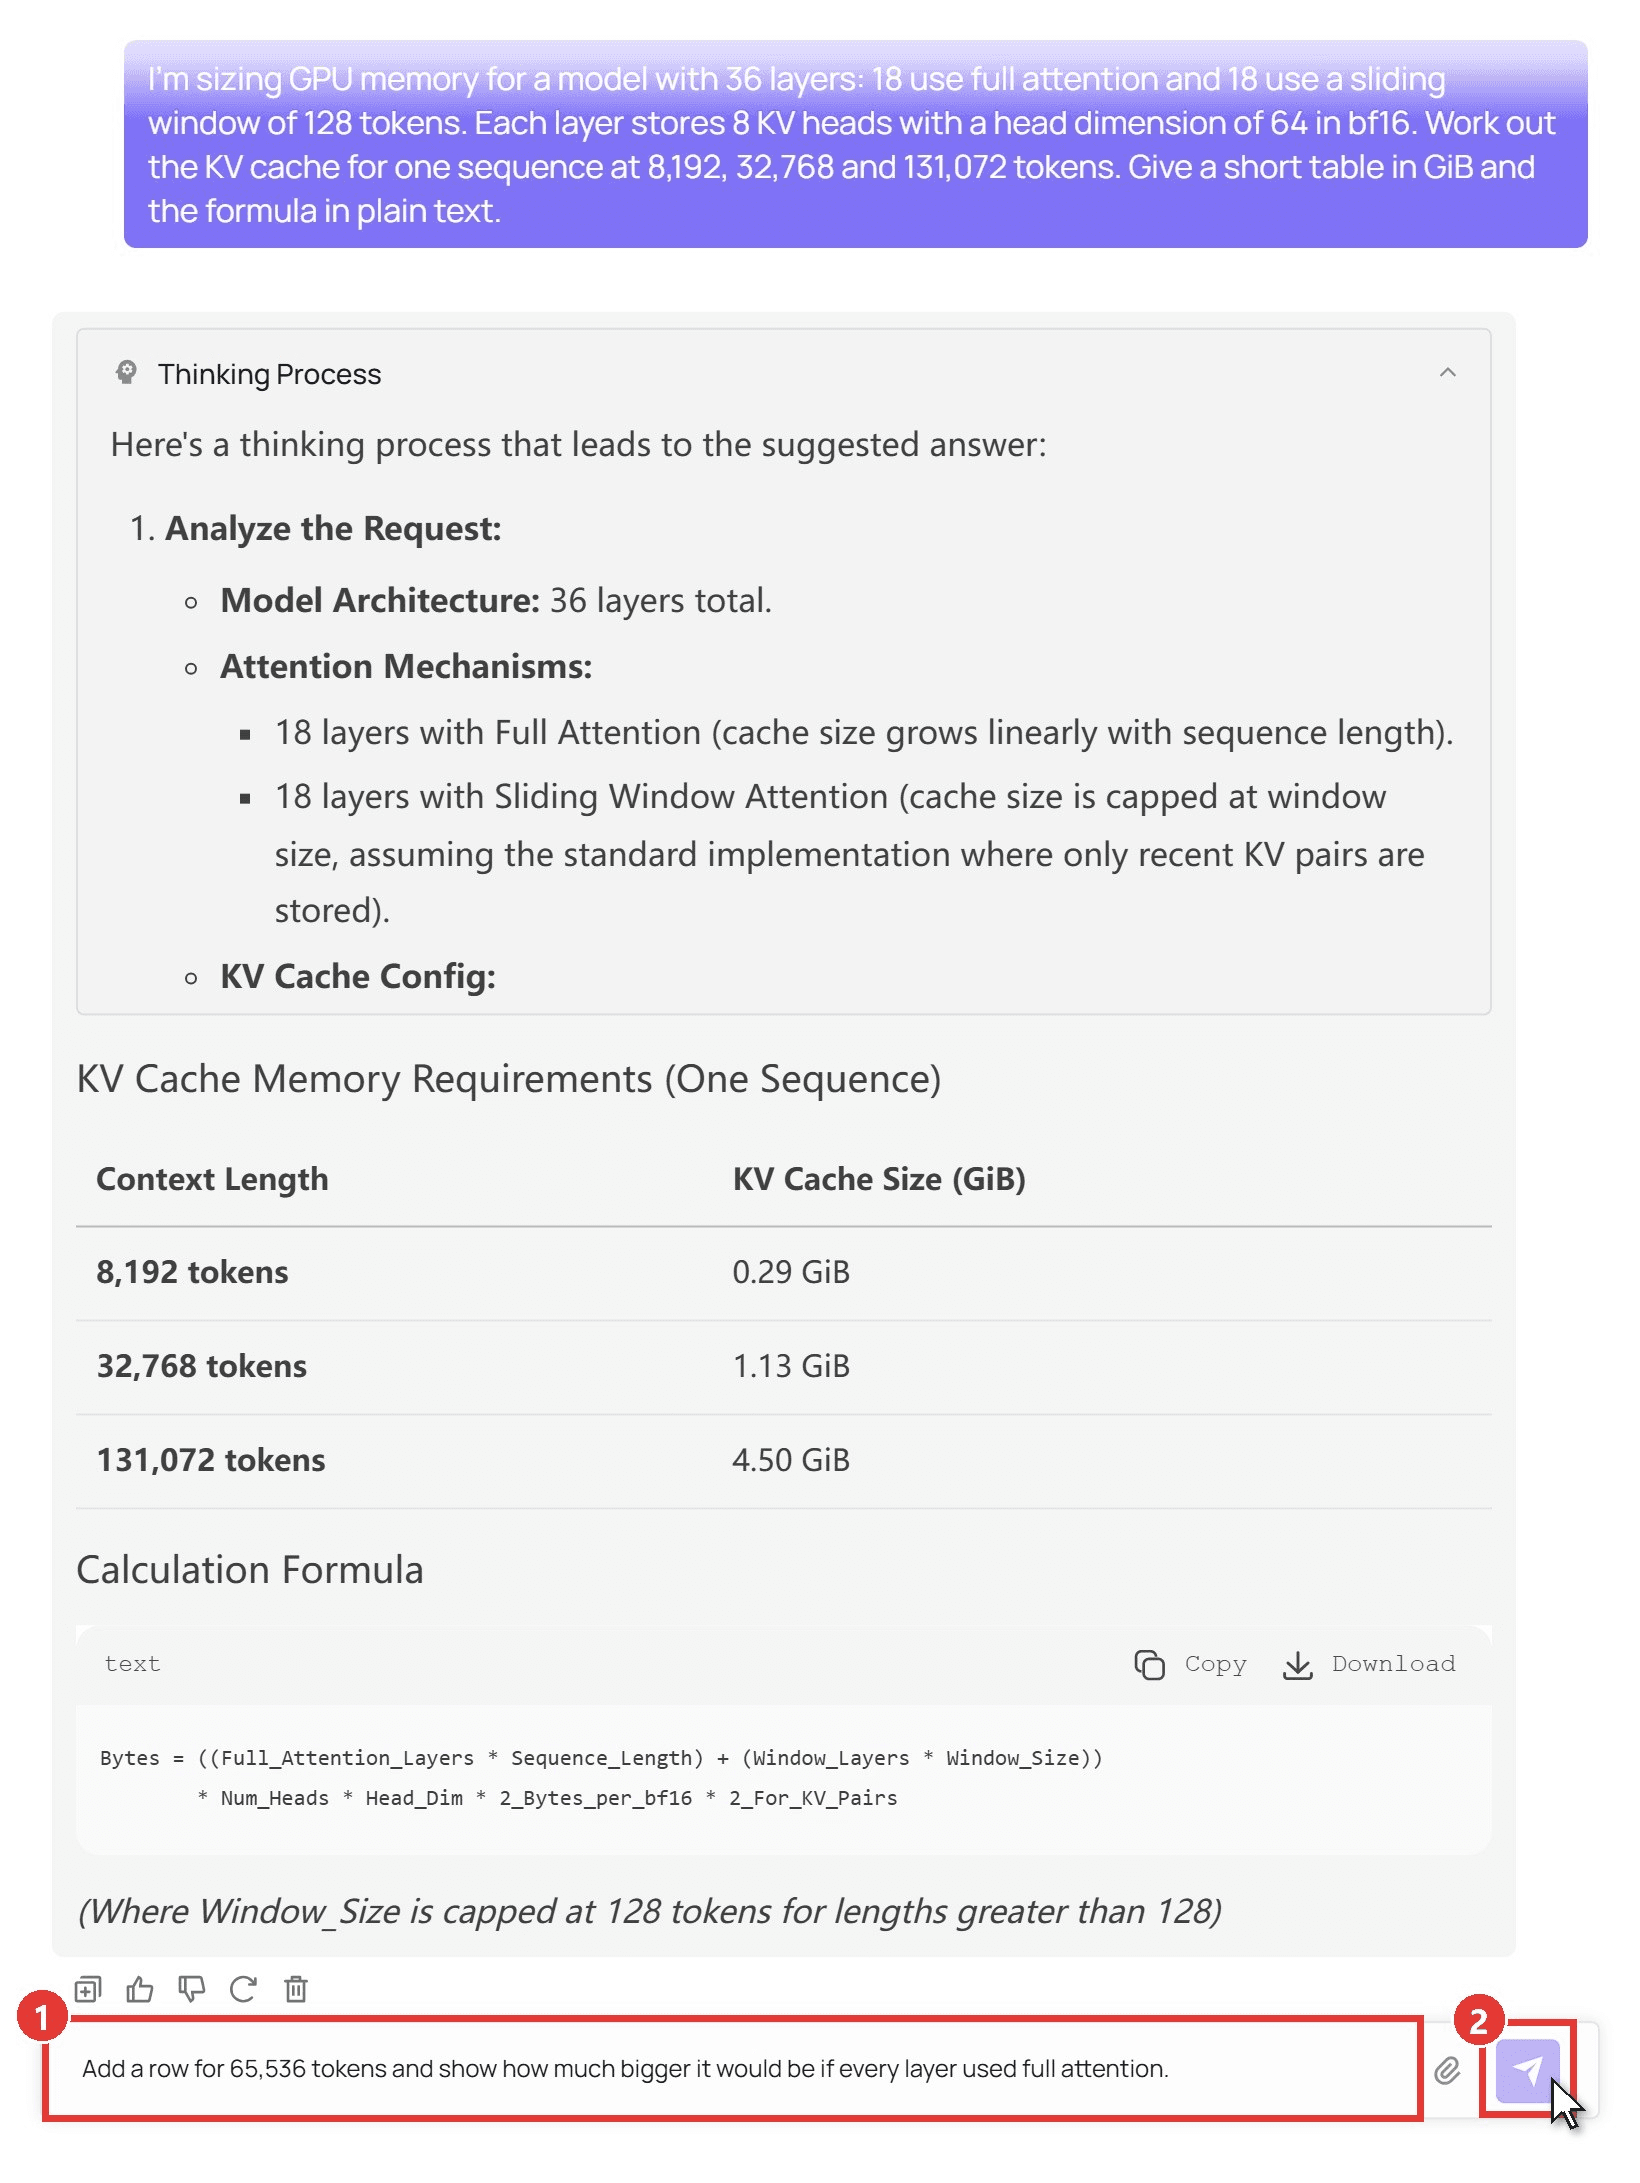
Gli abbiamo fornito il layout di attenzione dalla configurazione di gpt-oss e abbiamo chiesto la KV cache a tre lunghezze. La sua tabella corrispondeva ai nostri calcoli fino a due decimali. Se in seguito desideri un Qwen per la tua macchina, la nostra guida al miglior modello Qwen per il coding locale li dimensiona in base alla RAM.
Metodo 1: Prova Qwen3.5 122B A10B nel Playground
Accedi e apri il playground di Qwen3.5 122B A10B, quindi:
- Digita la tua domanda nella casella dei messaggi.
- Clicca la freccia di invio. Il ragionamento appare in un pannello Thinking Process sopra la risposta.
Metodo 2: Chiama Qwen3.5 122B A10B con l'API di Atlas Cloud
Per script e app:
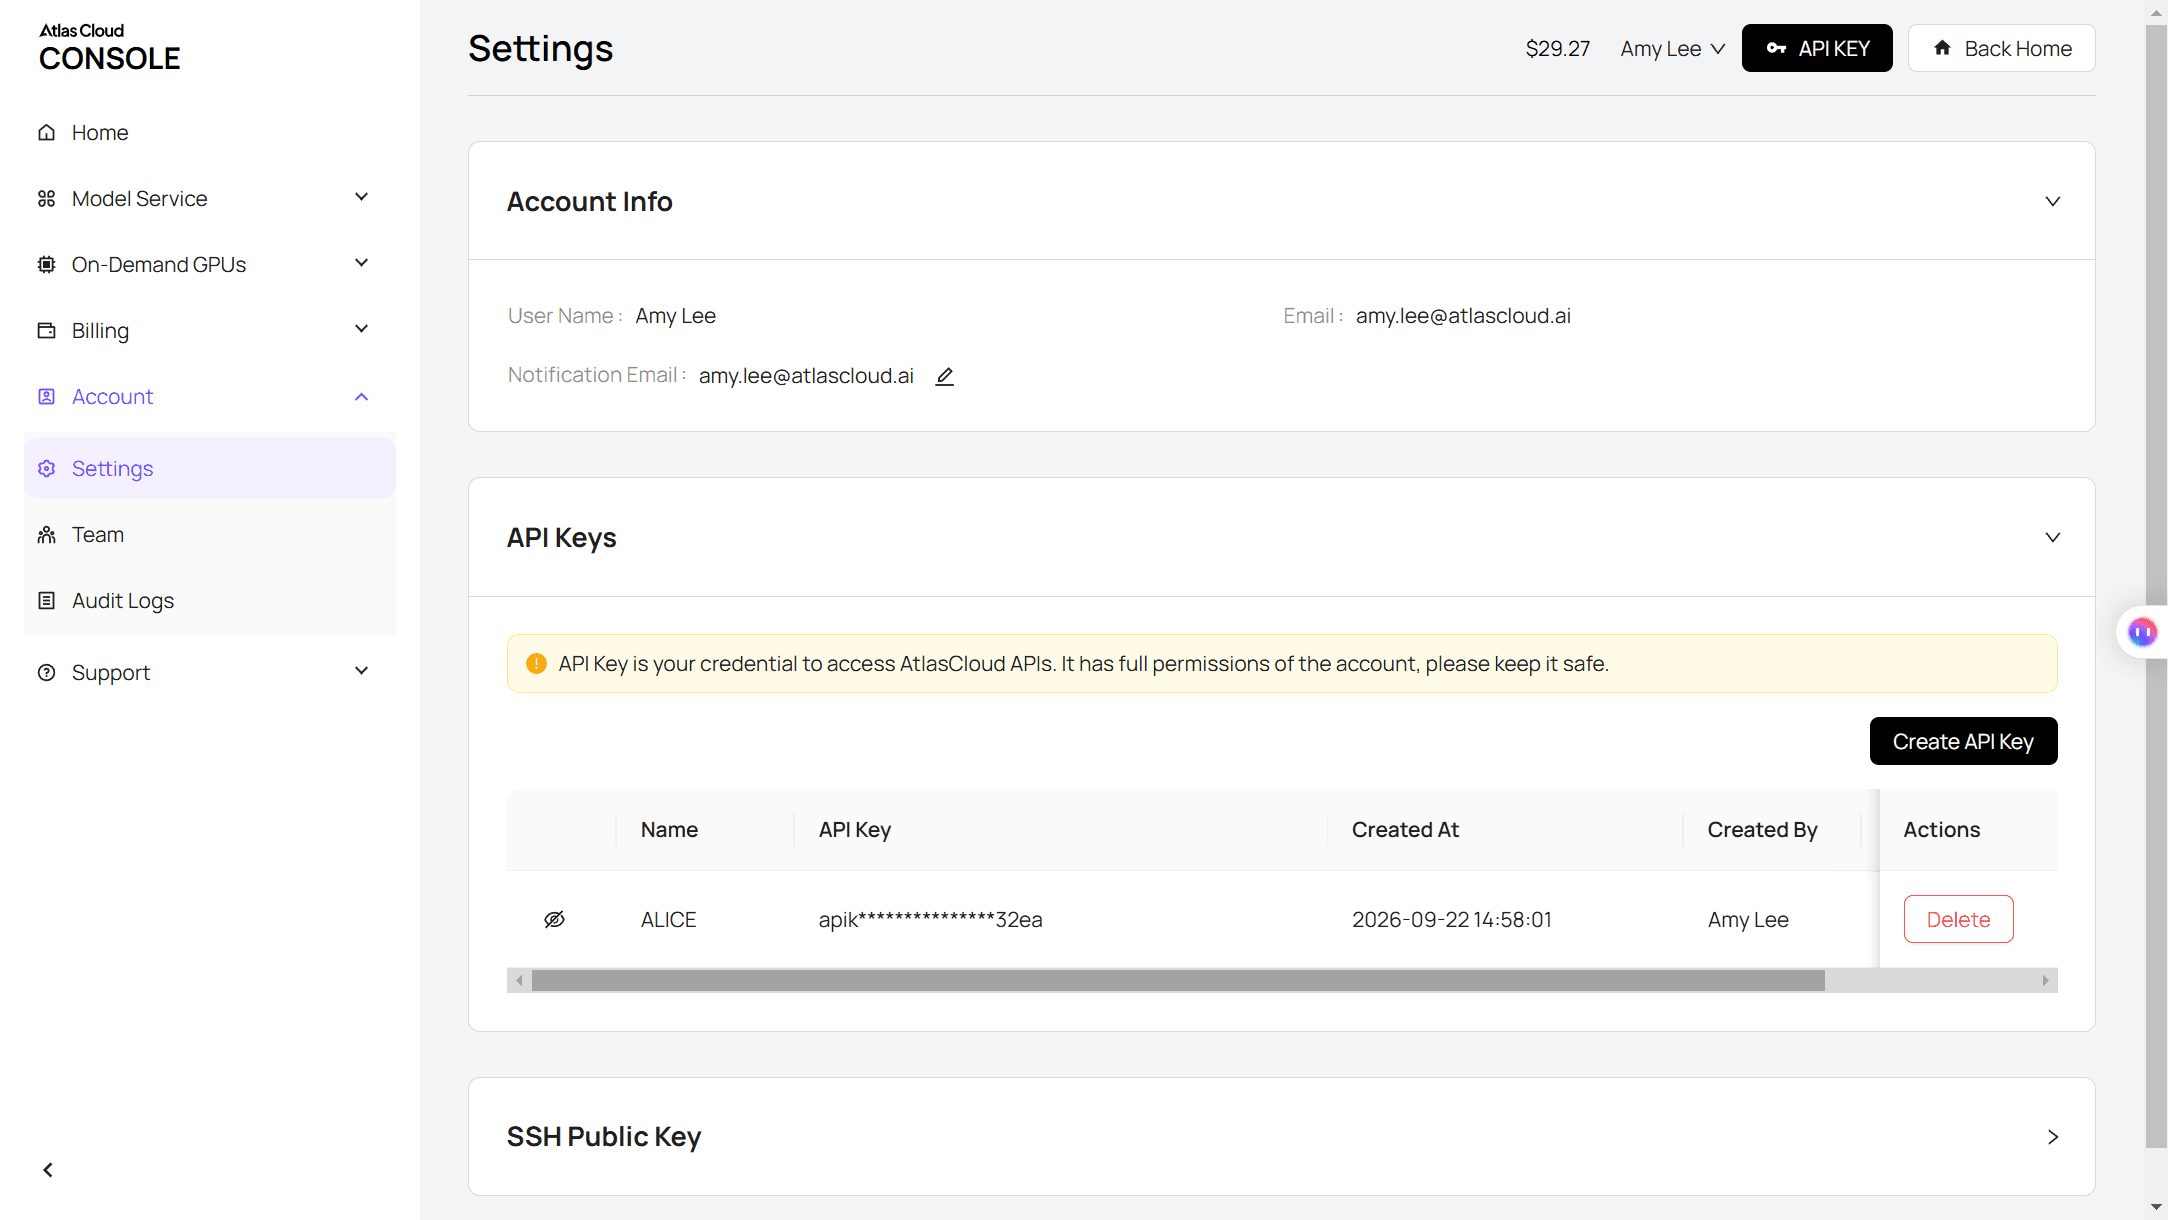
Passo 1: Crea una chiave API. Apri Impostazioni nella console, vai su API Keys e clicca Crea API Key. Conservala lato server.
Passo 2: Controlla il formato della richiesta. La documentazione API copre il formato chat completions, e la pagina del modello ha una scheda API con un esempio pronto all'uso.
Passo 3: Invia la tua prima richiesta.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
La risposta torna in choices[0].message.content. Poiché l'endpoint segue il formato OpenAI, il codice scritto per un server gpt-oss locale di solito necessita solo di un nuovo base URL, chiave e stringa del modello. La stessa chiave funziona anche con gli altri modelli di chat sulla piattaforma, come illustra il nostro articolo su un gateway API LLM unificato.
GPT-OSS-120B vs GPT-OSS-20B: compromesso tra memoria e benchmark
Il fratello minore necessita di un quinto della memoria. gpt-oss-20b ha 20,9B parametri con 3,6B attivi, e OpenAI afferma che funziona con "soli 16GB di memoria". La domanda è cosa si sacrifica.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Memoria a contesto 8K (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (senza strumenti) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (senza strumenti) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
I punteggi provengono dalla scheda del modello con sforzo di ragionamento alto. Il divario di coding è sotto i due punti su SWE-Bench Verified, mentre il divario di conoscenza è di circa 9 punti su scienza di livello laurea e 15 su HealthBench. Per lo più codice su una scheda da 16GB a 24GB, 20b è la scelta sensata. Hai bisogno della conoscenza extra? È qui che 120b guadagna il suo conto di memoria.
GGUF, Ollama o vLLM: scegliere un runtime per il tuo budget di memoria
Ognuno esegue i pesi MXFP4 rilasciati da OpenAI; differiscono in dove quei pesi possono risiedere.
| Runtime | Download | Ideale per |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Un utente su una macchina che contiene l'intero modello |
| LM Studio | 65 GB | Un'app desktop su Mac o PC Windows |
| llama.cpp (ggml-org GGUF) | Circa 63 GB | Meno di 65 GB di VRAM, con livelli esperti scaricati sulla RAM |
| vLLM | Circa 65 GB di safetensors | Servire molti utenti da una o più GPU data center |
Per un avvio rapido su una macchina con molta memoria:
plaintext1ollama run gpt-oss:120b
Per una GPU più piccola, usa llama.cpp e regola il numero di offload:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Tutti e quattro gestiscono il formato di chat harmony di OpenAI, necessario per il corretto funzionamento del modello. È rilevante solo se scrivi il tuo codice di servizio.
FAQ
GPT-OSS-120B è migliore di GPT-5 o Gemini 3 Pro?
Appartengono a categorie diverse: GPT-5 e Gemini sono modelli chiusi a cui accedi tramite un'app o API, mentre gpt-oss-120b viene eseguito sul tuo hardware. Inoltre, Gemini 3 Pro Preview è stato dismesso il 9 marzo 2026, e il suo nome ora punta a Gemini 3.1 Pro Preview. Se il controllo locale è importante, la linea open-weight di Google è la famiglia Gemma 4.
Perché alcuni siti dicono che GPT-OSS-120B richiede 255 GB?
Quelle cifre presumono pesi a 16 bit: circa 117B parametri per 2 byte, più overhead. Il checkpoint pubblicato da OpenAI è già MXFP4, quindi il download realistico è nell'ordine dei 61 GB.
Lo sforzo di ragionamento cambia l'uso della memoria?
Non per i pesi. Le impostazioni basso, medio e alto cambiano per quanto tempo il modello pensa. Lo sforzo alto scrive più token di ragionamento, che riempiono la finestra di contesto e fanno crescere la KV cache, quindi le sessioni lunghe si avvicinano ai totali maggiori nel grafico sopra.
Perché si dice che GPT-OSS-120B abbia difficoltà con i giochi basati su testo?
Le prove sono aneddotiche. Sulla pagina di discussione Hugging Face del modello, alcuni utenti segnalano rifiuti quando scrivono narrativa violenta, mentre altri dicono che il role-play funziona bene. Per la narrativa interattiva, testa i tuoi prompt prima di acquistare hardware per questo.
Quanto costa un modello ospitato di classe 120B?
A ottobre 2026, Qwen3.5 122B A10B costa $0.3 per milione di token di input e $2.4 per milione di token di output su Atlas Cloud. Si tratta di uno sconto del 25% rispetto alle tariffe regolari di $0.4 e $3.2. La nostra domanda di dimensionamento ha utilizzato circa 5.000 token di output una volta contato il ragionamento, circa un centesimo alla tariffa scontata.
Conclusione
GPT-OSS-120B è più facile da inserire di quanto suggerisca il suo conteggio di parametri. Prevedi circa 65 GB a lunghezze di contesto quotidiane e sotto i 70 GB a 131K completi. Una GPU da 80GB, un Mac con più di 96GB, o un mini PC da 128GB lo contengono, e schede più piccole possono eseguirlo spostando i livelli esperti nella RAM di sistema.
Se questi numeri escludono la tua macchina, passa a gpt-oss-20b per la maggior parte del lavoro di coding, o chiama un modello open-weight ospitato quando hai bisogno del cervello più grande senza acquistare hardware. In ogni caso, i requisiti di memoria di gpt oss 120b smettono di essere un gioco a indovinare una volta che sai che i pesi occupano 61 GB e il resto è margine.


