TikTokやInstagramで、自撮り写真に「ゴースト」が現れる動画を見たことはありませんか?背後からこっそり忍び寄ったり、突然飛びかかってきたりするものです。人々はこのゴーストエフェクトを使って友達を驚かせています。私はここ数日、AIを使ってこうしたゴーストエフェクトを作る方法を調べていました。その方法を皆さんに共有したいと思います。
上の動画では、私がChatGPTとVeo 3.1を使って作成したゴーストエフェクトを紹介しています。左から右へ、それぞれ次のとおりです:
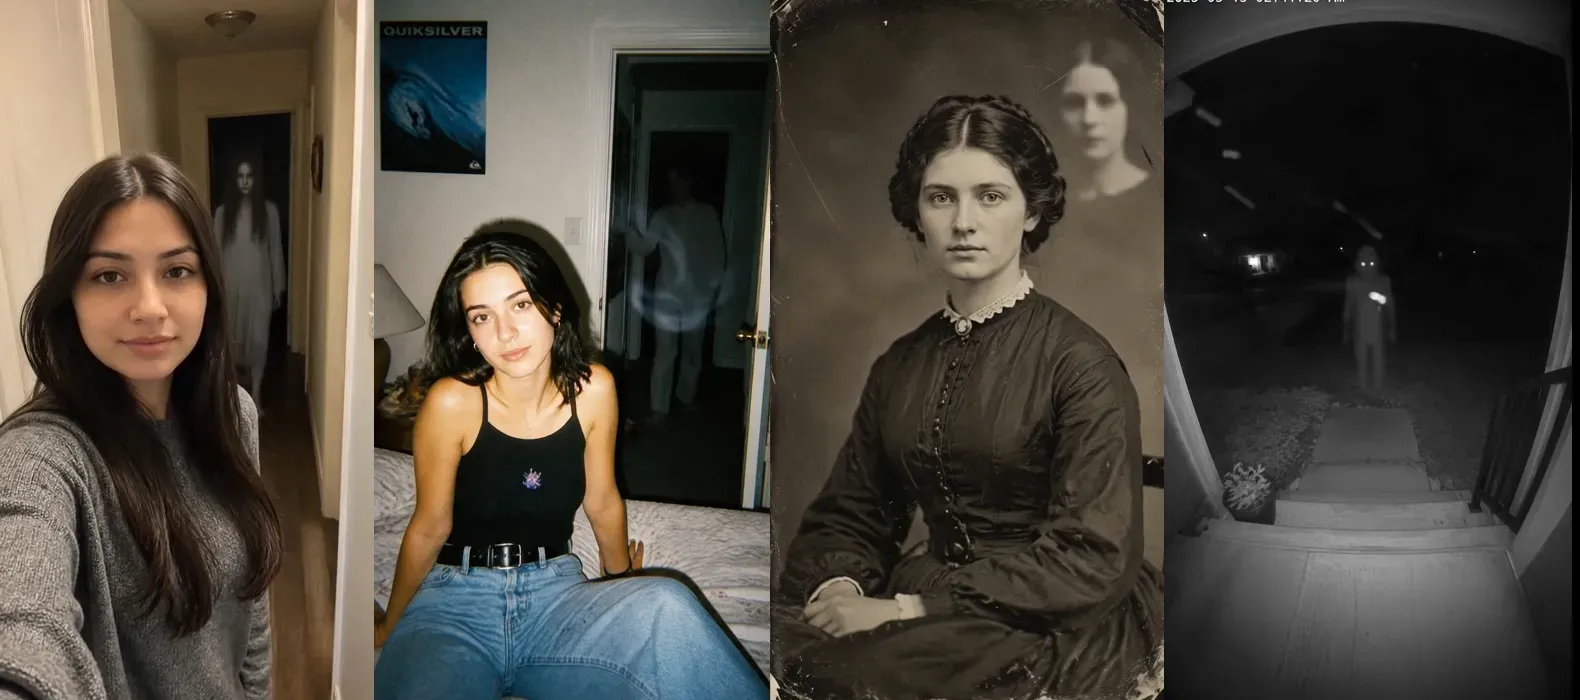
- パネル1:廊下のプロンプト反復(透明感と似姿のテスト)
- パネル2:スタイル1 - 90年代使い捨てフラッシュの寝室の潜む者
- パネル3:スタイル2 - ヴィクトリア朝風スペクトル二重露光
- パネル4:スタイル3 - ドアベルカメラ赤外線暗視グリッチ
次に、私がどのようにしてこれらを作ったのか見ていきましょう。
AIゴースト動画生成に適した元写真の選び方
ゴースト変換の失敗の多くは、プロンプトを入力する前に起きます。顔いっぱいの寄った自撮り写真をアップロードすると、拡散モデルは被写体の背後に別の姿を配置するのではなく、顔の特徴をモンスターのように歪めてしまいます。写真からゴースト動画へのワークフローを成功させるには、きれいなネガティブスペースが必要です。
被写体は胸から上を、フラットでニュートラルな照明の下で構図に入れましょう。背景の少なくとも30%は空けておきます。空の出入り口、薄暗い廊下、何もない角は、深度推定器に幻影を描画するための明確な平面を与えます。花柄の多い壁紙、人混みのパーティー写真、低解像度のサムネイルは避けてください。強い圧縮はエッジ検出を損ない、前景の被写体に視覚的なアーティファクトをにじませます。
事前確認の写真チェックリスト
フレーム生成を始める前に、元写真をこの技術的基準に照らして確認してください:
- 背景スペース: ゴーストを配置できるよう、被写体の横または後ろに十分な見える背景を残します。出入り口や空の角は奥行きの基準づくりに役立ちます。
- 画像解像度: 使用するツールが推奨する解像度から始めます。鮮明で十分に明るい元写真を使い、強く圧縮された画像は避けます。
- 表情: リラックスした表情は顔のディテールを保ちやすくする場合がありますが、結果はモデルと元画像によって異なります。
- 被写体の配置: 可能な限り人物を背景から明確に分離します。特に髪、肩、手の周りで重要です。
任意の写真からゴーストをアニメーション化するステップバイステップのワークフロー
日常的な写真をそのまま動画生成ツールに投入すると、出力が台無しになります。ほとんどの写真から動画へのモデルは、カメラの動きを予測しながら同時にゴーストを作り出そうとします。これにより被写体の顔が液体ゴムのように引き裂かれます。ゴーストフィルター動画のパイプラインを2つの制御された段階に分けることで、顔の歪みを排除できます。
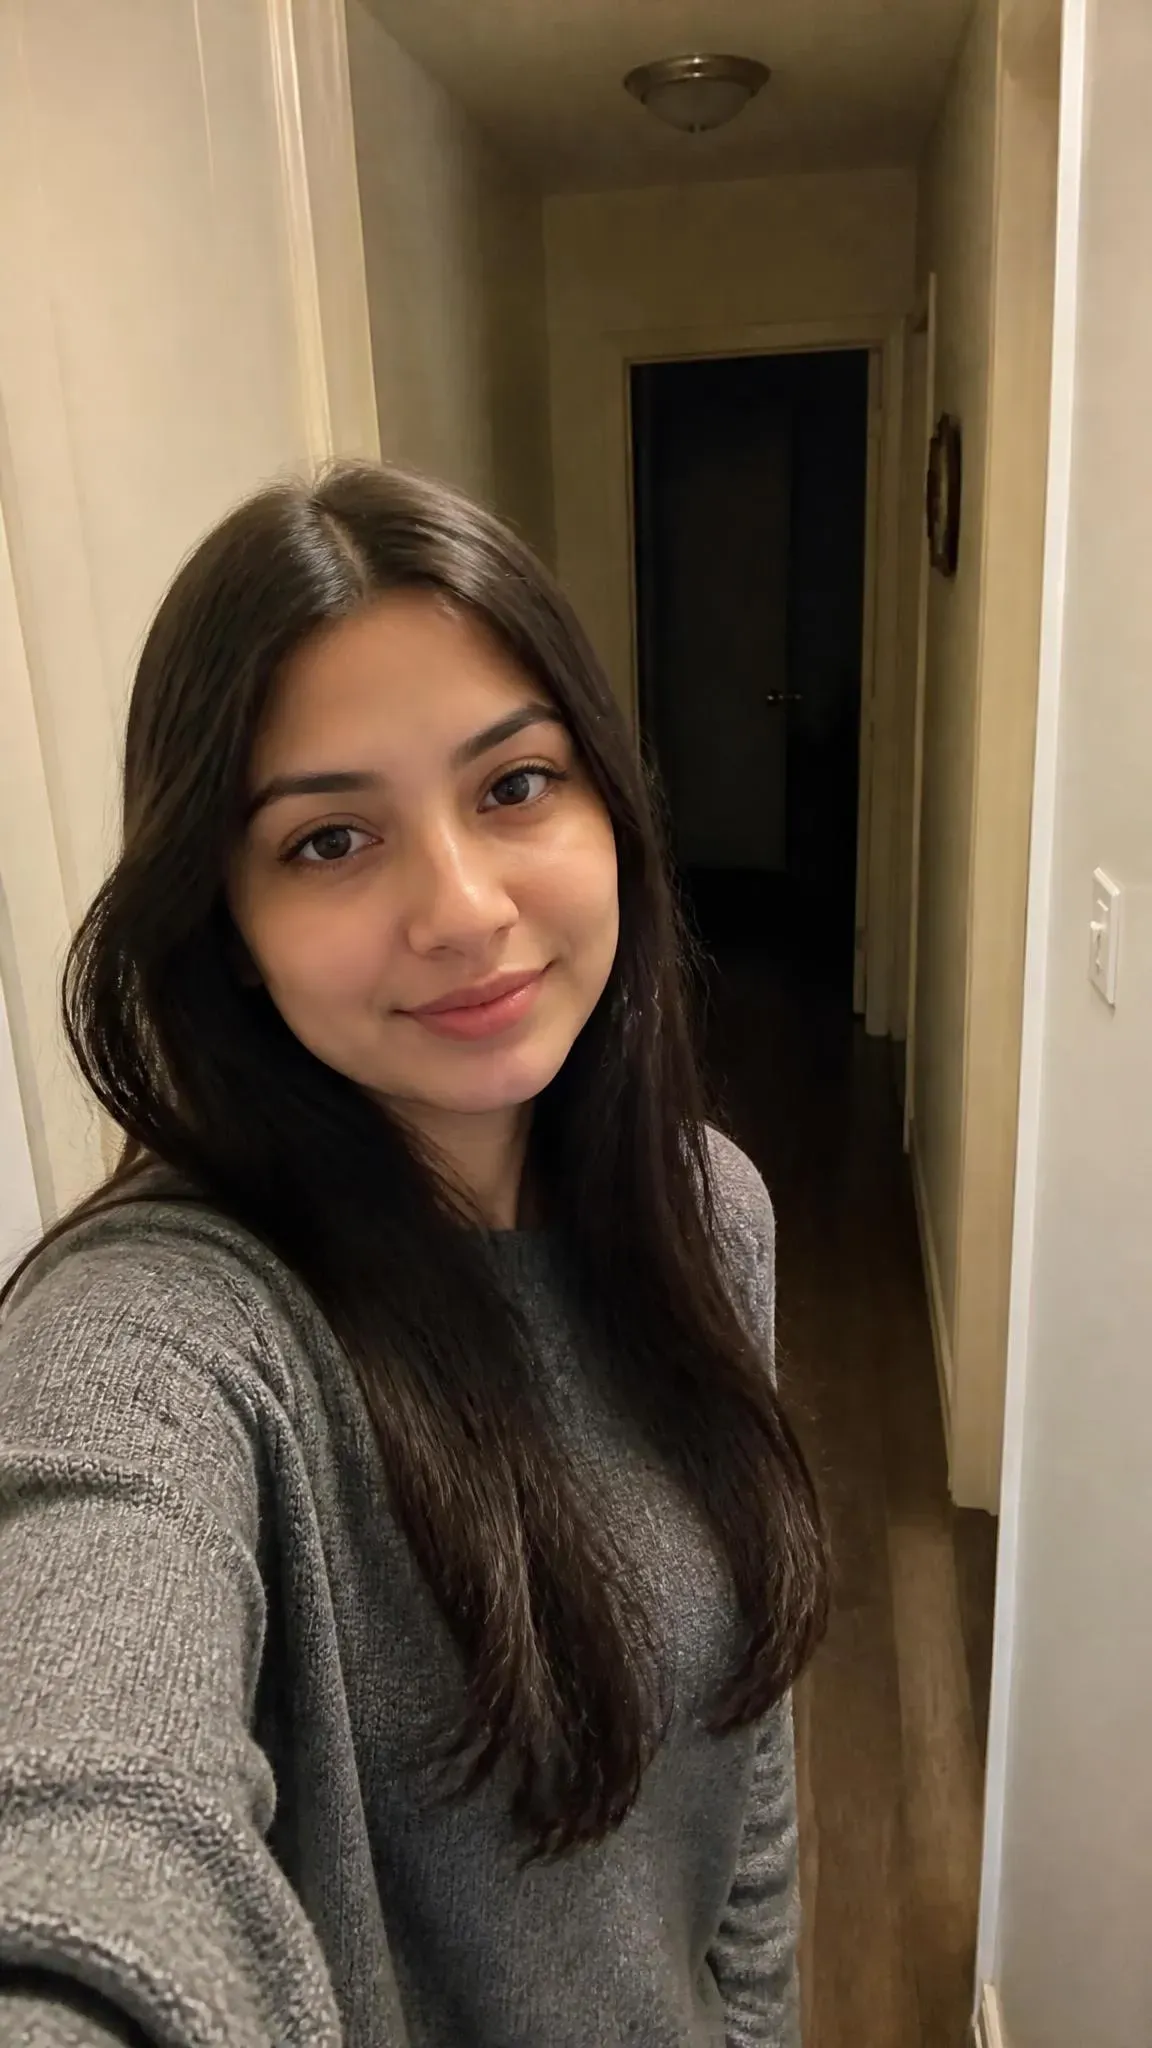
ステージ1:元になる写真を生成する
ワークフローの出発点となる、標準的でゴーストのない画像を生成することから始めます。すでに適切な画像がある場合は、このステップを省略できます。
このテストでは、コスト効率が良いため、再びChatGPT Image 2.0を使用しています。低品質の画像1枚にかかるコストはわずか$0.00971です。
ステージ2:モーション拡散を設定する
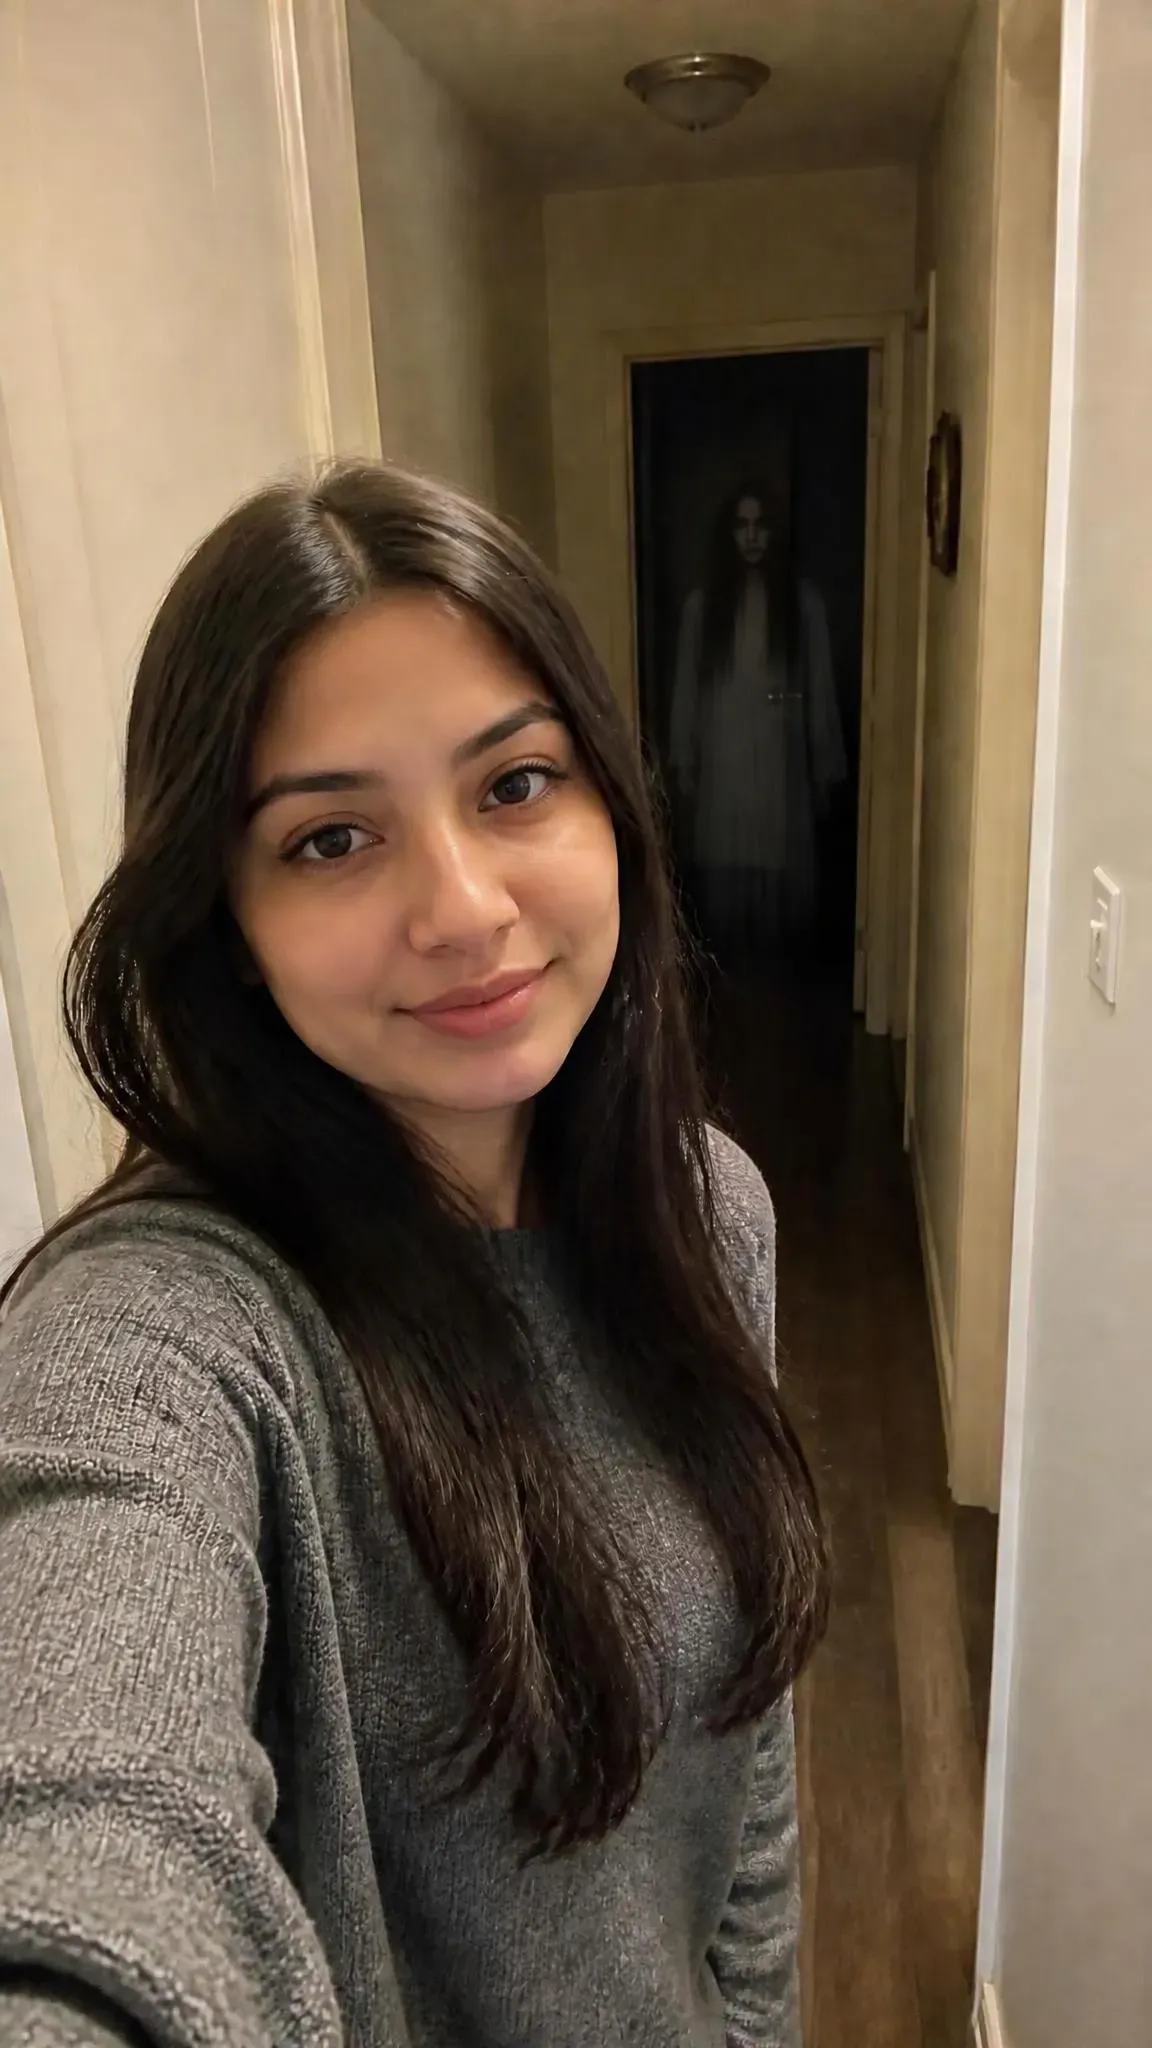
次に、生成した画像をChatGPTにアップロードし直し、その画像編集機能を使ってゴーストを含む写真を作成します。
ステージ3:AIツールでゴーストをアニメーション化する
このホラーシーケンスを生成するために、Veo 3.1で3回プロンプトを反復しました。その中でテスト3が最も満足のいく結果です。
結果はこちらです:
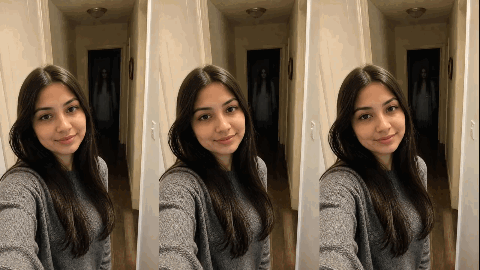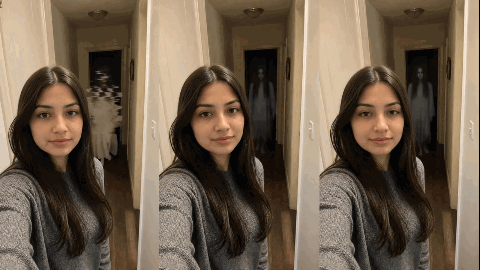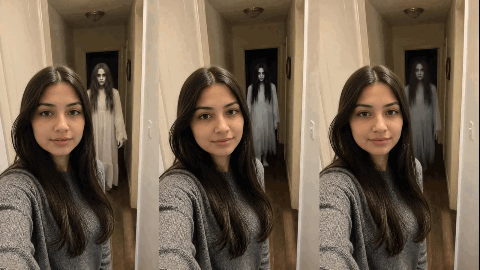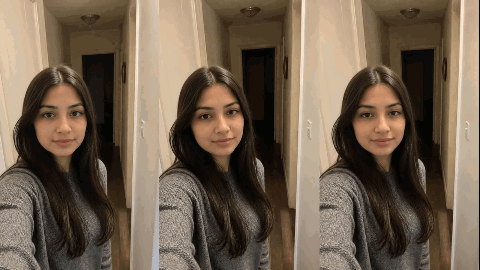
動画では、左から右へ test1、test2、test3 です。
このテストに基づき、AI「ゴースト」動画を作成するための重要なプロンプトの知見を次のようにまとめました:
1. ゴーストの透明性で固体俳優バイアスを上書きする
- 光学用語を使う:「ghost」や「spirit」のような説明的な言葉は、白い服を着た不透明な俳優を描画してしまいます。代わりに物理的な光学記述子を使います:faint translucent haze、optical double exposure、5% to 10% opacity などです。拡散エンジンにピクセルを合成させます。
- 背景の透過を強制する:背景の可視性を明示的に指定します:「Hallway walls and doorframe remain 90% visible THROUGH the figure」。実体のすぐ背後にあるシーンの形状を固定します。
- 顔のディテールを抑制する:顔の再構築を阻止します。NO distinct eyes or sharp facial features を必須にします。拡散モデルが元画像から高コントラストの顔の輪郭を再構築しないようにします。
- 重要なネガティブプロンプト:固体人間の形状と接地した照明を排除します:solid human, opaque body, real actress, solid white dress, clear face, floor shadow
2. 出現と動きのダイナミクス
- 歩かず、滑るように動かす:歩行プロンプトは脚の運動学と布のシミュレーションを引き起こします。空中を静かに前方へ滑るように指示します。
- 位相変化と明滅:環境影は誤ったオクルージョンを生みます。直接的なアルファ変化を強制します:0%(不可視)と10%の不透明度の間で断続的に明滅します。時間フレームをまたいで真の光学的非実体化を促します。
- 消滅タイムスタンプを固定する:拡散モデルは曖昧な消滅コマンドでずれます。正確なタイムライン座標を固定します:「At second 6, completely dematerializes into thin air, leaving the hallway 100% empty for the final 2 seconds」。退場後の背景の絶対的な連続性を強制します。
- ハードカットのジャンプスケア:段階的なブレンドを排除します。単一フレーム挿入を必須にします:「Manifests instantly in a single frame at second X without transition」。フレーム間補間とモーションブラーの立ち上がりを抑制します。
3. 空間距離とカメラフレーミング
- 深度境界: 固定距離制約を指定します。たとえば
strictly remains 6 to 8 feet behind the subjectなどで、人物が極端な前景に滑り込むのを防ぎます。 - デュアルフォーンバグの修正: 視点を
front-facing smartphone camera POV, camera handheld off-screenと定義し、ネガティブプロンプトにphone in hands, visible handsを追加します。
異なるゴースト美学のためのモジュール式プロンプト式
上記の経験を活かし、私はさまざまなスタイルでゴーストをテーマにした動画の作成を試しました。幻影を分離しつつ顔の似姿を保つには、構造化されたプロンプト式が必要なだけです。
マルチモーダルな画像・動画エンジンで、この5部構成のモジュール式スロット式を使用します:
プロンプト = [POV Rig] + [Subject Anchor] + [Entity Optics] + [Entity Timeline] + [Negatives]
| スロット | 目的 | 構文トークン |
| POV Rig | 視点をオフスクリーンに固定し、余計なスマホの生成を防ぎます。 | POV front-facing smartphone camera, camera off-screen, empty hands |
| Subject Anchor | ベースラインの表情を固定し、動的な笑みや顔の歪みを止めます。 | neutral baseline expression, subtle blink only, no smile transitions |
| Entity Optics | 極端な透明性を強制し、鋭い顔の特徴を除去します。 | 5%-10% opacity, see-through double exposure, no sharp face/eyes |
| Entity Timeline | 滑る動き、空間深度、明滅、時間指定の退場を制御します。 | glides 6-8ft behind, flickers 0%-10%, dematerializes cleanly at 6s |
| Negatives | 人間の物理、不透明な布、影、小道具をブロックします。 | solid human, opaque cloth, sharp face, floor shadow, phone in hands |
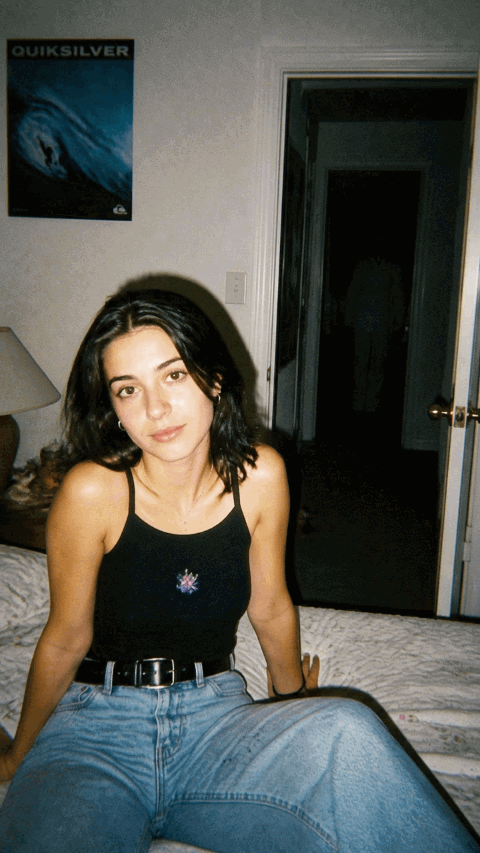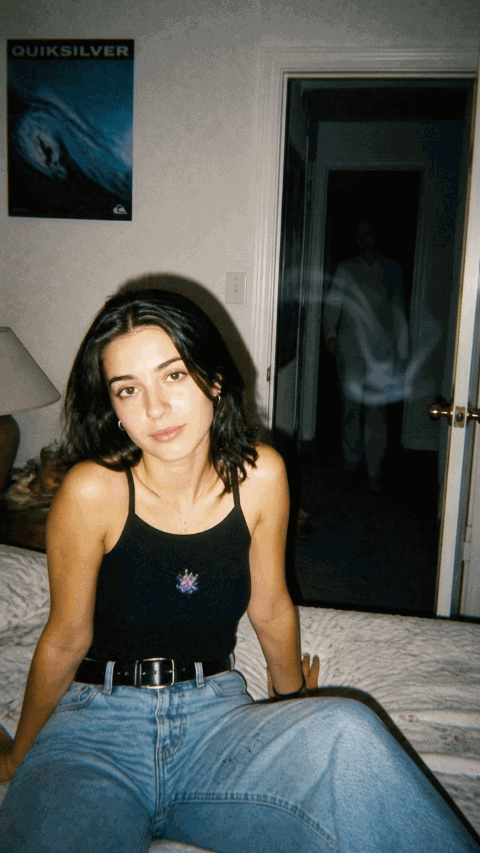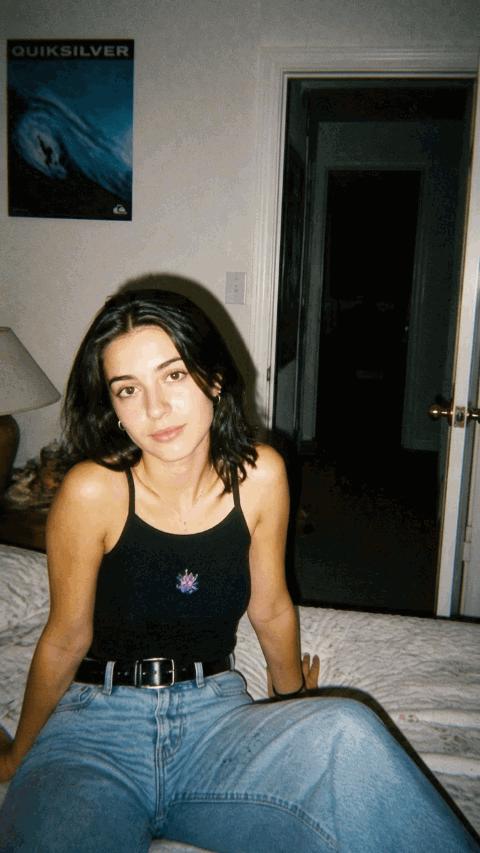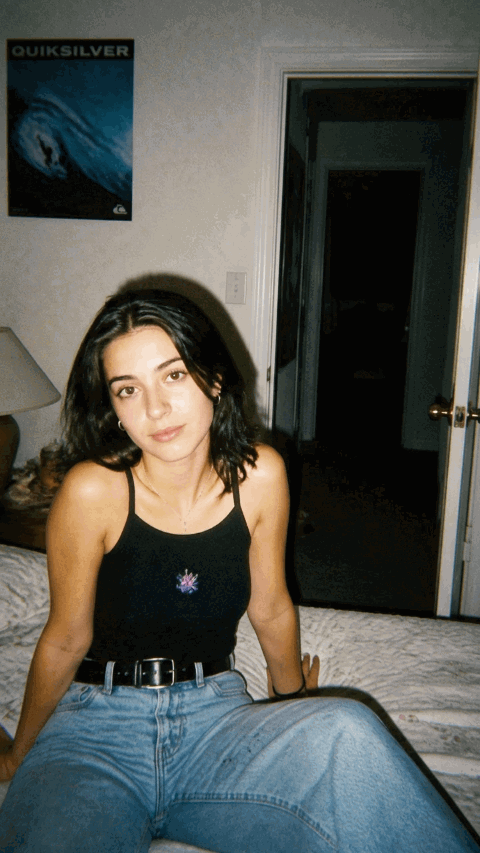
スタイル1:90年代使い捨てフラッシュの寝室の潜む者
コンパクトカメラのフラッシュ撮影は、粗い生成エッジを隠します。強い光は背後の壁に深いドロップシャドウを落とします。この影の減衰が、ゴーストフィルタープロンプトにきれいな空間的根拠を与えます。
目標とする見た目
直接的なオンスカメラフラッシュ照明、強いKodak 35mm粒子、硬い壁のドロップシャドウ、そして背景の影を漂う極めてかすかな透けて見えるスペクトルの蜃気楼。
コピー&ペースト用プロンプト式
plaintext11996 point-and-shoot camera POV, direct disposable flash, harsh wall drop shadows, heavy 35mm grain. Camera handheld off-screen, no devices in frame. 2Foreground {SUBJECT_DESC}. Strictly locks baseline neutral expression, subtle blinks only; no smiling, no expression transitions. 3In {SPATIAL_ANCHOR}, a faint translucent {ENTITY_FORM} (strictly 5%-10% opacity, see-through double exposure). Background remains 90% visible through it. Soft-edged, no sharp facial features, no eyes, no cloned face. 4Entity {TRAJECTORY} without leg motion. Opacity flickers 0%-10%. At second {VANISH_TIME}, completely dissolves into dark air, leaving the area empty. 5Negative Prompt: solid human, opaque cloth, sharp eyes, cloned face, floor shadow, walking legs, phone in hands, smiling.
スタイル2:ヴィクトリア朝風スペクトル二重露光
現代の室内照明はゴシック美学としばしば衝突します。二重露光の式は、フレーム全体をアンティークなティンタイプ写真のように演出することでこの問題を回避します。これにより、空灵的でファインアートなゴーストポートレートが生まれます。
目標とする見た目
モノクロのダゲレオタイプの傷、銀塩のテクスチャ、そして背景の露光フラッシュを通して実体化するかすかな二重露光の霊。
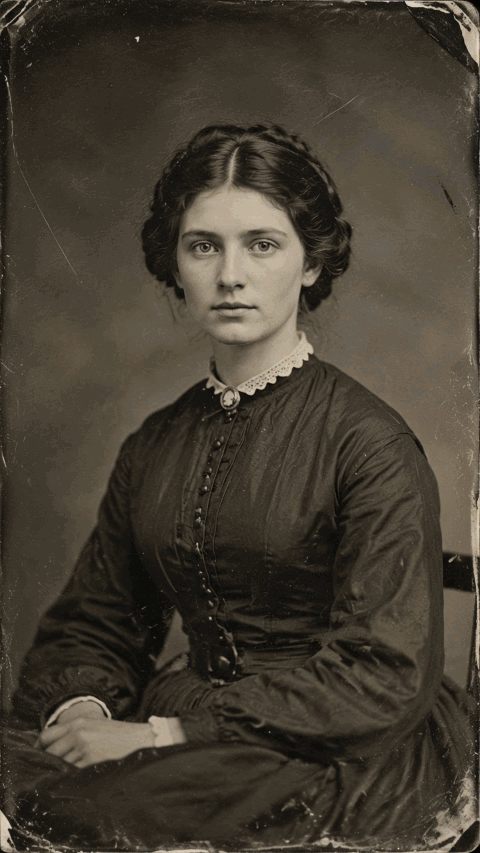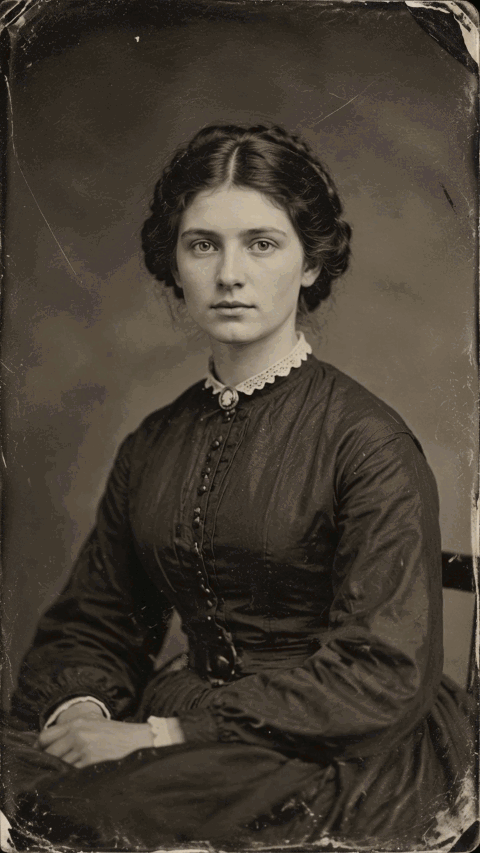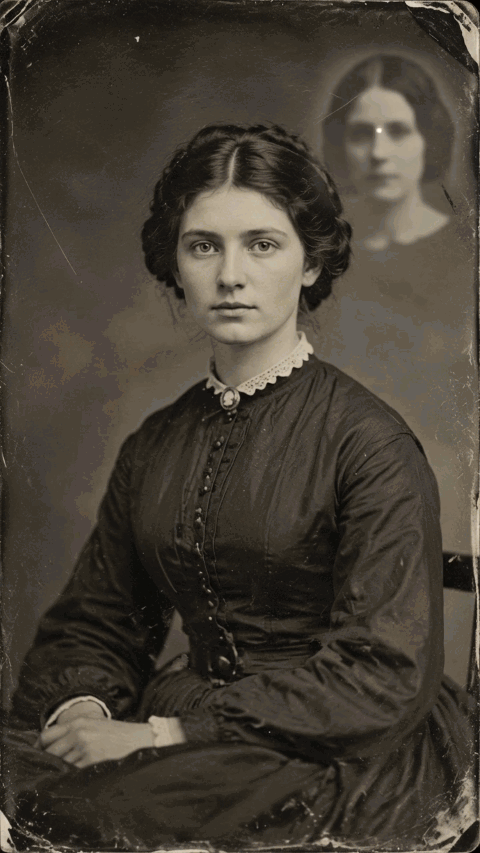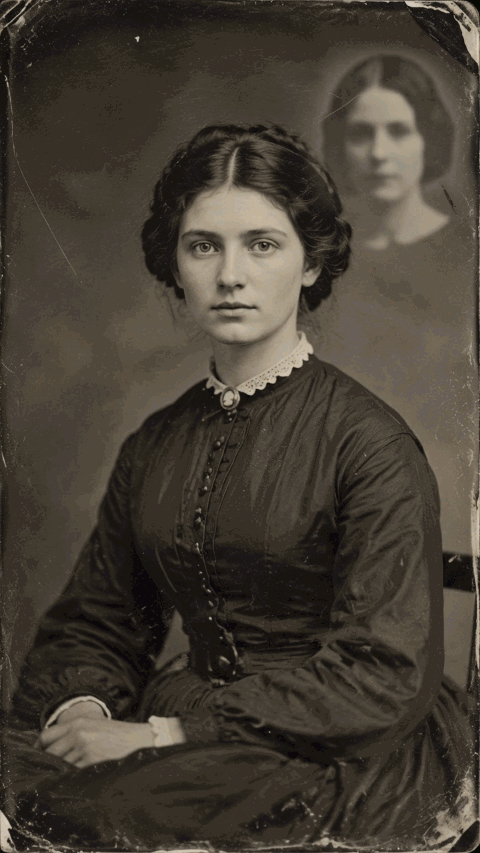
コピー&ペースト用プロンプト式
plaintext1Static 19th-century studio camera framing, authentic tintype aesthetic, silver halide grain, scratches, sepia tones. Zero camera movement. 2Foreground {SUBJECT_DESC}. Formal still pose, preserving exact facial identity from source image. Subtle breathing and slow eye blinks only. 3In {SPATIAL_ANCHOR}, an ultra-faint translucent ghostly haze (strictly 5%-10% opacity, double exposure effect). Blurry contour, NO sharp face, NO eyes. 4- 0 to {APPEAR_TIME}s: Subject sits calmly, background completely normal and empty. 5- {APPEAR_TIME} to {FLASH_TIME}s: Indistinct ghostly blur faintly drifts into view. 6- At {FLASH_TIME}s: Sudden bright magnesium flash fires, instantly freezing the scene into a static antique photograph for the remaining duration. 7Negative: solid human, sharp face, distinct eyes, modern digital lighting, color frames, moving after flash, cartoon.
スタイル3:ポーチのドアベル暗視の忍び寄る者
監視カメラ映像はソーシャルフィードで見る者に即座に緊張感を与えます。低解像度の緑またはグレーのカメラノイズは、動画生成中のわずかな時間的アーティファクトを隠すため、このスタイルはバイラルなイタズラループに最適です。
目標とする見た目
ドアベルカメラ視点、モノクロ赤外線暗視、デジタルタイムスタンプのオーバーレイ、そして遠くの庭の影で実体化して消えていく不気味な青白い存在。
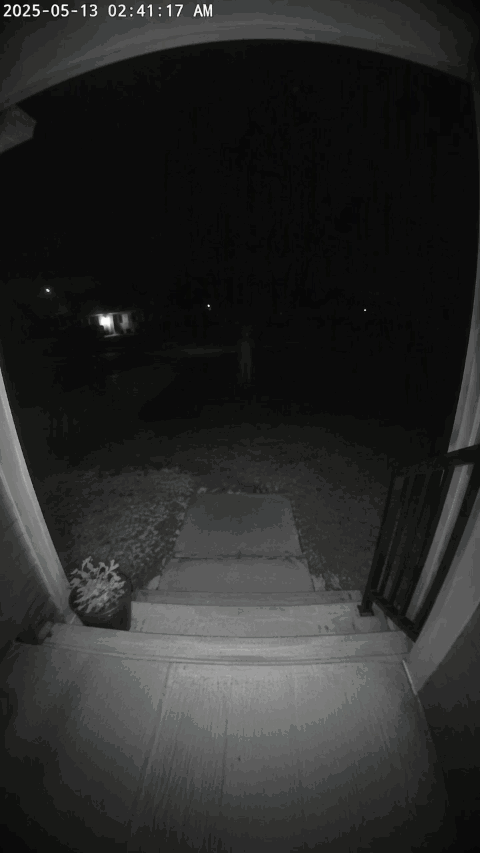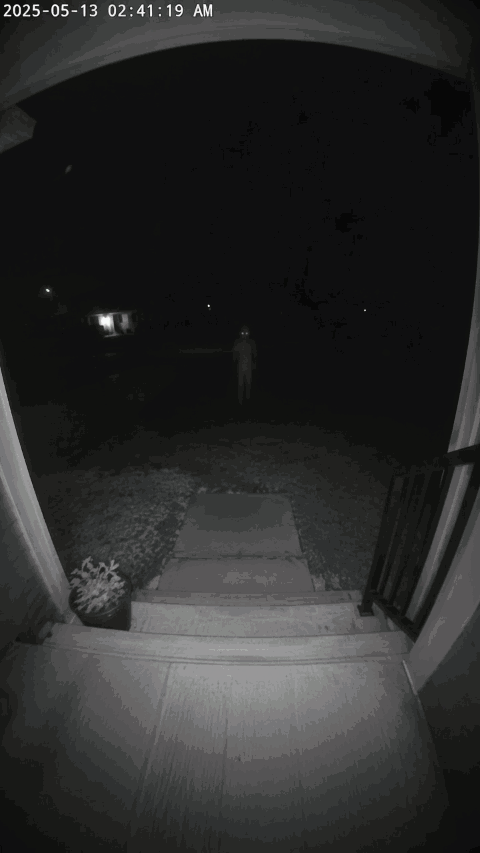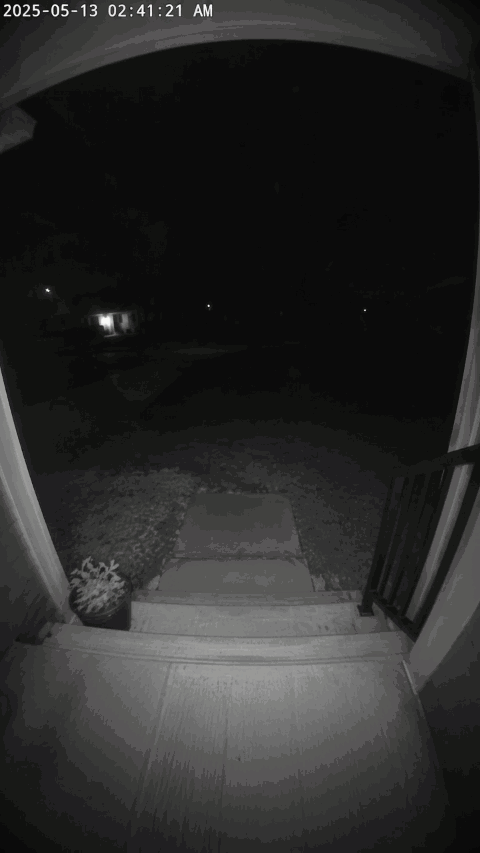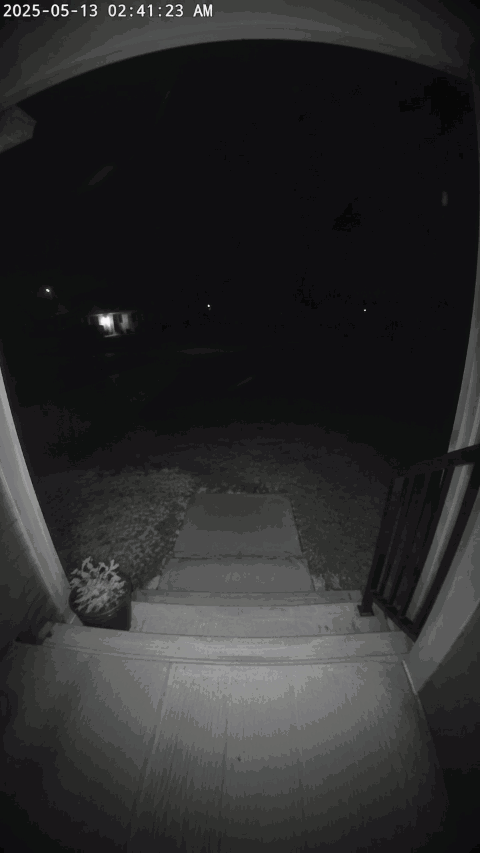
コピー&ペースト用プロンプト式
plaintext1Static 9:16 doorbell infrared night vision, digital sensor noise, timestamp overlay. Zero camera motion. 2Foreground {FOREGROUND_OBJ} remains completely frozen, empty, and unaltered throughout. 3In {SPATIAL_ZONE} only: an ultra-faint, barely visible translucent {ENTITY_FORM} (strictly 5% opacity, IR sensor artifact). Background remains 95% visible through it. NO clothing texture, NO hoodie, NO glowing eyes, NO distinct face. 40 to {APPEAR_TIME}s: {SPATIAL_ZONE} is completely empty. 5{APPEAR_TIME} to {VANISH_TIME}s: The faint entity drifts slightly, strictly locked {DISTANCE}. No walking steps, no forward approach. 6At {VANISH_TIME}s: Instantly dissolves into black shadows, leaving the scene 100% empty until end. 7Negative Constraints: solid human, real person, hoodie, clothes, walking legs, approaching steps, glowing eyes, intruder, burglar, solid silhouette.
ゴースト動画におけるAIアーティファクトの修正と顔の似姿の保持
動画拡散モデルは時間処理中に誤った顔のピクセルに固定してしまい、目をぼやけた空洞にしたり、顎のラインを引き伸ばしたりすることがよくあります。こうした視覚的な崩れはAIゴースト動画のリアリズムを損ないます。クリップを生成する前に根本的な失敗モードを特定することで、これらのレンダリングエラーを解決できます。
AIゴースト動画の診断マトリクス
| 視覚的アーティファクト | 根本原因 | 即時対応策 |
| 固体の人型 / 俳優 | 不透明度しきい値が高すぎる(>15%)ため、不透明メッシュ合成が引き起こされる。 | 不透明度を厳密に5%-10%に固定する。服装の言葉をvapor glitch、optical smear、double exposureに置き換える。 |
| 被写体の顔のクローン | 拡散モデルが前景アンカーから最も強い顔トークンを借用する。 | Opticsスロットに NO cloned face of subject, NO distinct eyes, no sharp facial features を追加する。 |
| 近づく / 歩く動き | モデルが人型を物理的な歩行者として解釈する。 | locked distance, glides without leg motion, NO walking steps, no approaching steps を追加する。 |
| 壁とシーンの呼吸 | センサー視点が固定されていない。 | zero camera motion, static camera framing, stationary background をプロンプトに入れる。 |
ネガティブプロンプトの武器庫
チェックされていないモデルは、低照度シーンにランダムな視覚的ノイズを持ち込みます。顔の形状を保護し、おもちゃのようなテクスチャを除去するには、この専用のネガティブブロックを生成ツールに直接貼り付けます:
negative_prompt: [solid human, opaque body, real actor, walking legs, approaching steps, floor shadow, cloned face of subject, glowing eyes, hoodie, clothes texture, phone in hands, sudden smile, camera shake]
反復生成のためのシード固定
生成シードを固定せずにプロンプトを変更すると、被写体の一貫性が失われます。ランダムシードごとに空間レイアウト全体が再構築され、被写体の顎のライン、髪、服装が変わります。最初に成功したベース生成から正確な数値シードをコピーします。実体の配置、影の深さ、不透明度の値を調整する前に、その整数を生成ツールの設定で固定します。このパラメータ固定により、プロンプト編集の影響を背景の幻影だけに限定し、すべてのテストレンダリングで顔の似姿を保持できます。
TikTokとReels向けのプラットフォーム別エクスポート設定とバイラルペーシング
15秒のスローペースはリーチを破壊します。静止フレームは2秒以内にスワイプを引き起こします。ショートフォームアルゴリズムは完視聴率と即時のループ再生を優先します。8秒目に現れる幻影は視聴者を完全に失います。高い保持率のゴースト動画は、視覚的な見せ場全体を厳密な6秒ループに圧縮します。
3秒リビールのフレームワーク
リテンションを最大化し、コメント欄での議論を促すために、バイラルペーシングのルールに沿って動画のタイムラインを構成します:
| タイムスタンプ | 視覚的アクション | 視聴者の心理 |
| 0:00〜0:02 | 普通の日常シーン。 | 視聴者は被写体に注目するか、キャプションを読みます。 |
| 0:02〜0:04 | 幻影が動くか振り向く。 | 視聴者は周辺の動きを捉え、二度見します。 |
| 0:04〜0:06 | 被写体は気づかないまま。 | 視聴者は視覚的な異常を確認するためにクリップを再生し直します。 |
このタイミングはアルゴリズムのエンゲージメントを引き起こします。視聴者は背景の動きを確認するためにクリップを何度も見ます。多くの人が個々のフレームで一時停止したり、映像がやらせかどうかをコメント欄で議論したりして、それがTikTokとReelsで動画をより広いオーディエンスへ押し上げます。
技術的エンコード基準
プラットフォームの圧縮アルゴリズムは、低コントラストの影や暗い廊下のディテールを劣化させます。プラットフォーム別のエクスポート設定を使ってAIゴーストフィルター動画を書き出すことで、圧縮アーティファクトを防げます:
- 解像度: 1080×1920 px(厳密な9:16縦比率)。
- ビデオコーデック: MP4コンテナのH.264。
- フレームレート: 24 fpsまたは30 fps。より高いフレームレートは合成モーションの欠陥を露呈します。
- ターゲットビットレート: 15〜20 Mbpsの固定ビットレート。低い可変ビットレートは暗い角にブロック状のバンディングを引き起こします。
Instagramカルーセルの成長ハック
Instagramフィードに単体クリップを投稿しないでください。2枚のスライドのカルーセルを作成します。
スライド1に未編集の元写真を設定します。スライド2にレンダリングしたゴースト動画を読み込みます。キャプションで視聴者に左へスワイプするよう促します。無邪気なポートレートとスペクトルの露見の間をスワイプすることで、複数のインタラクションイベントが記録されます。アルゴリズムはこの高い滞在時間を検出し、投稿を新しいオーディエンスに再配信します。
式を実践に移す
超リアルなAIゴースト動画の作成は、シンプルなバランスに帰着します。前景のアイデンティティをネガティブスペースで固定し、幻影の不透明度を厳密に5%〜10%の間に制限し、物理的なタイミングにストーリーテリングを任せます。
90年代使い捨てフラッシュの粗いざらつき、ヴィクトリア朝二重露光のファインアート的な退廃、スマートドアベルのグリッチの不穏なリアリズムのどれを選んでも、この2段階パイプラインは固体俳優バイアスを排除しつつ顔の似姿を保ちます。
これらのモジュール式を自分のポートレートプロンプトで試して、どの美学が自分のフィードで最も成果を出したかテストしてみてください!





