ほとんどのクリエイターは静的なArenaリーダーボードから画像モデルを選び、編集を3ターン重ねただけでリアルなポートレートが崩壊してしまうのをただ眺めることになる。GPT Image 2.5対Qwen Image 2.1のこの実世界ベンチマークでは、OpenAIがゼロショットのフォトリアリズムで勝利し、Qwen 2.1が反復修正を通じた背景の構造的安定性でリードしている。
実証ベンチマークサマリー
| 実証指標 | GPT Image 2.5 | 評価 | Qwen Image 2.1 | 評価 |
| ゼロショットリアリズム | フォトリアルな肌と自然なRAWライティング | ★★★★☆ (4.5) | シャープなディテール;やや滑らか/脂っぽい肌 | ★★★☆☆ (3.0) |
| マルチターン安定性 | ターン5までに全体的なノイズとプロポーションのずれ | ★★★☆☆ (3.5) | 背景をロック;構造的劣化ゼロ | ★★★★☆ (4.0) |
| 素材保持 | 本物らしいダークウールとシャドウテクスチャ | ★★★★☆ (4.5) | 高コントラスト;光沢/プラスチック化のリスク | ★★★☆☆ (3.0) |
| 編集コントロール | ビジュアルピンポイント;フルキャンバス再エンコード | ★★★★☆ (4.0) | ペイントマスクとネイティブ透過RGBA | ★★★★☆ (4.5) |
| 最適な制作用途 | ハイエンドのシングルパス商用アセット | 4.1 / 5 | セルフホストワークフローと背景ロック編集 | 3.6 / 5 |
重要なポイント
- GPT Image 2.5はシングルショットのフォトリアリズムを完璧に実現し、1回のレンダリングで本物らしい肌の透光性とRAWライクなダイナミックレンジを描き出す。しかし、フルキャンバス再エンコードにより、ターン5までに全体的なノイズ蓄積と解剖学的な短縮歪みが発生する。
- Qwen Image 2.1はKVキャッシュロックを備えた32層DiTを活用し、マルチターン編集を通じて背景のジオメトリを完全にアーティファクトフリーに保つ。トレードオフは局所的なパスにある。繰り返しのターゲットマスク編集はスペキュラハイライトを過飽和させ、自然な肌を脂っぽく、マットな生地を光沢のあるものにしてしまう。
最優先事項が完璧なシングルショットのリアリズムなら、GPT Image 2.5を選ぼう。パイプラインがセルフホスト制御、背景ロック編集、またはネイティブRGBAカットアウトを必要とするなら、Qwen Image 2.1を選ぼう。
シングルプロンプトのフォトリアリズム:照明物理、肌テクスチャ、素材再現度
プロンプトエンジニアリングを行うクリエイターは、照明プロンプトの微調整に何時間も費やした末に、視覚的な欠陥が反復編集ではなくベースラインのレンダリングに起因することに気づくことが多い。修正指示を出す前にゼロショットの視覚的忠実度をテストすることで、不可欠なコントロールベースラインが確立され、フォトグラファーは既存のモデル限界と真のマルチターン編集劣化を切り分けられる。
テスト1:厳しい直射光下での人間の肌の微細ディテール
厳しい条件での生のレンダリングメカニクスを評価するため、両モデルは、強烈な真昼の日光、肌テクスチャの変化、解剖学的な微細表情を特徴とする未レタッチのクローズアップポートレートプロンプトを使用してテストされた。
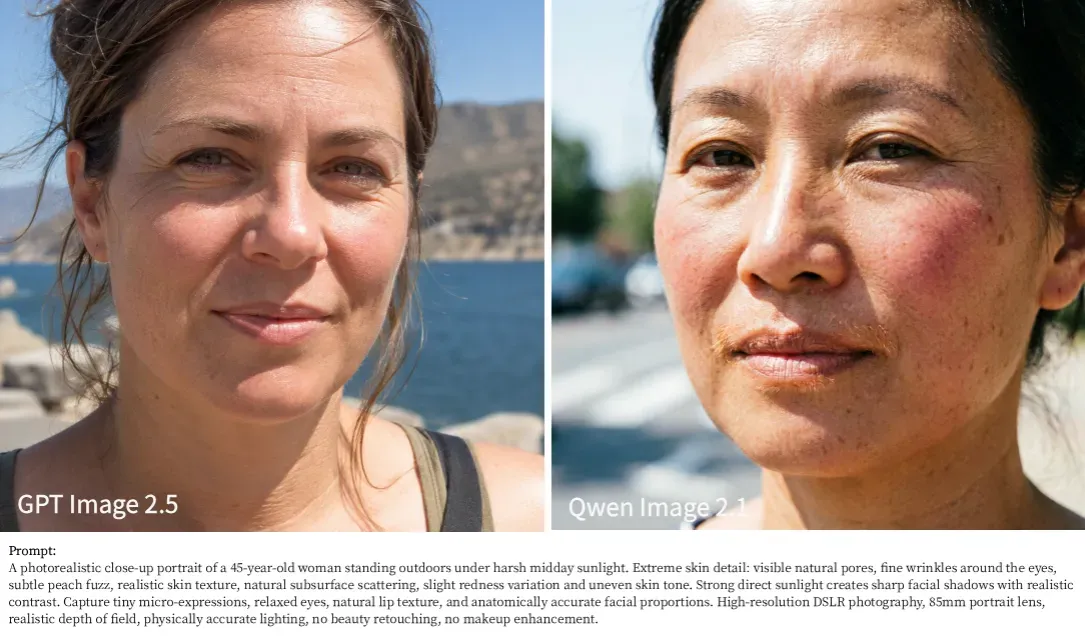
主な視覚的観察とディテール分析:
- 表面下散乱と影の遷移(GPT Image 2.5の勝利):
GPT Image 2.5は光学物理を高い精度でシミュレートする。85mmポートレート設定では、光が頬と額全体に自然に拡散して本物らしい表面下散乱を生み出し、目と鼻筋周辺の滑らかな影の減衰を伴う。
- 文字通りのプロンプト順守 vs プラスチック感(Qwen Image 2.1のトレードオフ):
Qwen Image 2.1は詳細なプロンプトに忠実に反応し、顔の産毛や頬の不均一な色素沈着を正確にレンダリングする。しかし、そのスペキュラハイライトは過度に強く見えることがあり、鼻と額全体に人工的な脂っぽい光沢を残す。
- 微細表情と解剖学的正確性:
GPT Image 2.5は驚くほどリラックスした表情筋をレンダリングし、解剖学的に正確な目のシワと唇のシワを描き出す。Qwen 2.1は高い表面シャープネスを達成するものの、肌テクスチャはズーム時に微細パターンの繰り返しを示し、高コントラスト照明にさらされると合成的な拡散由来であることが露呈する。
テスト2:生地と素材の再現度(ウールの粗さ vs リムハイライト)
マットなウールでの光吸収と織られたリネンの不均一なスラブテクスチャなど、物理的な素材の相互作用を理解することは、Eコマースや商用ファッションワークフローにとって極めて重要である。
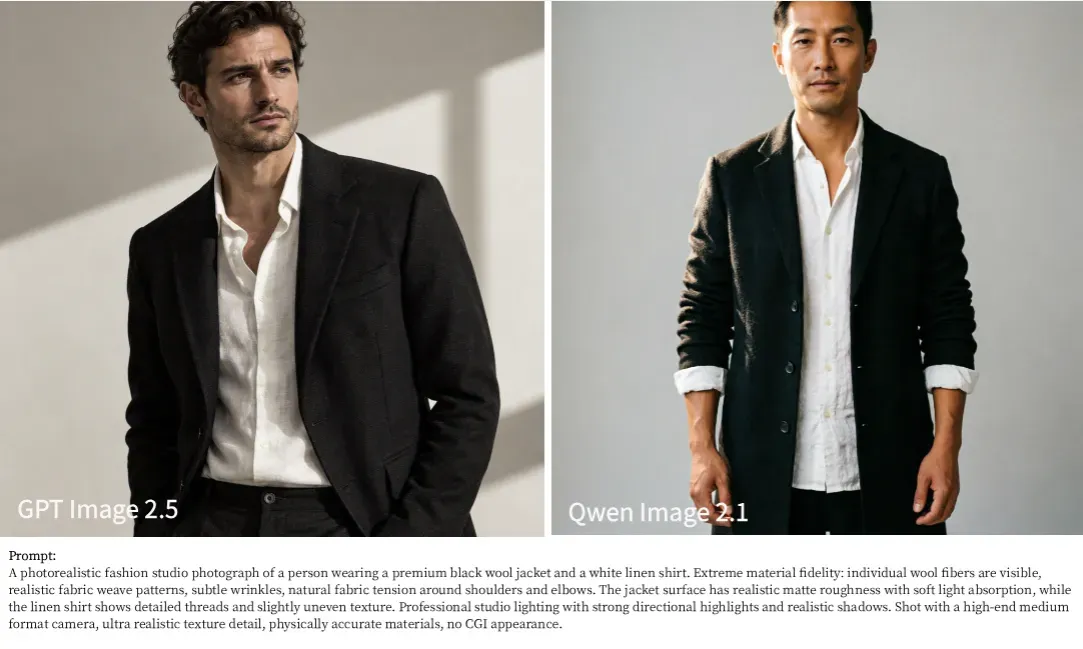
主な視覚的観察と素材の反応:
- 暗い生地の分離と影の深み(GPT Image 2.5の勝利):
GPT Image 2.5はディテールを犠牲にすることなく低周波の暗いトーンを処理する。黒いウールジャケットでは折り目、ラペルのステッチ、繊細なマイクロシャドウが見え続け、白いリネンシャツではリアルな織りテクスチャとボタンの張り跡によってバランスが取れている。
- エッジ分離とリムライティングの精度(Qwen Image 2.1の強み):
Qwen Image 2.1は直接的な指向性照明の制御において卓越した能力を示す。ダークコートのエッジに当たるリムライトは、肩と腕に沿った微細なウール繊維を明確に浮かび上がらせる。
- 素材の密度と影の圧縮(Qwen Image 2.1の限界):
Qwen 2.1は例外的にシャープな外側の輪郭を生み出す一方、暗いウールのレンダリングは影の圧縮傾向があり、非照明領域の黒が潰れる。ジャケットの内側の折り目はOpenAIのSunburstティアと比較して繊細な織りパターンを失い、影の下での全体的な素材の反応が平坦になる。
テスト3:製品写真、金属ヘアライン加工テクスチャとスペキュラ反射
金属のスペキュラハイライト、ガラスの屈折、環境反射を評価することで、モデルが商用製品写真においてPBRレンダリングパイプラインをどれだけ忠実に実装しているかが明らかになる。
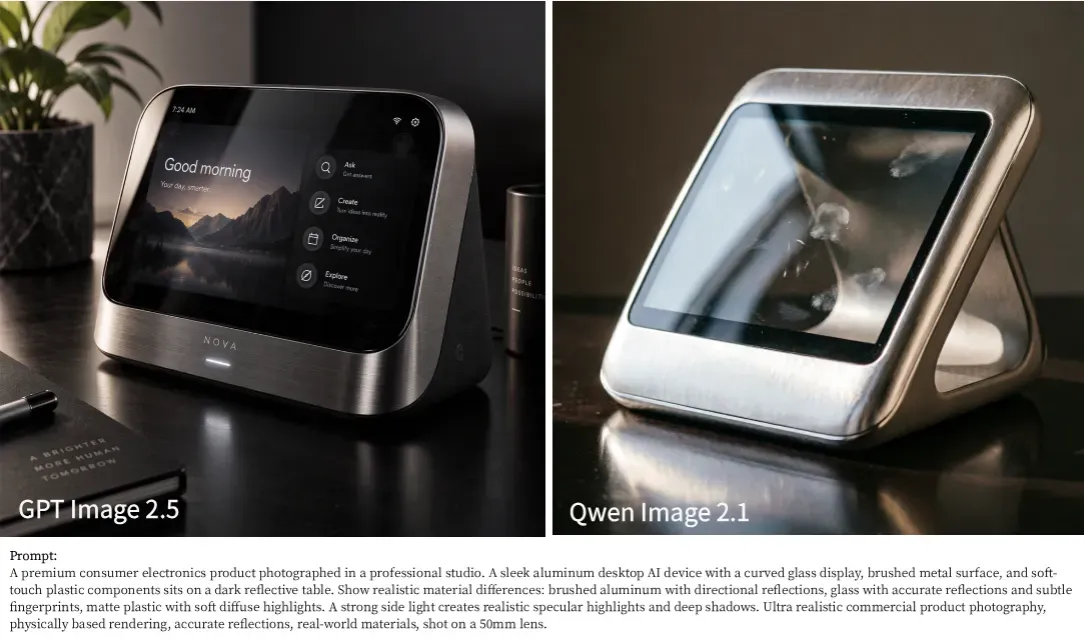
主な視覚的観察と光学物理:
- 金属表面の物理と異方性反射(GPT Image 2.5の勝利):
GPT Image 2.5はヘアラインアルミニウムを高い精度で処理する。下部ベゼルの水平なヘアラインはテクスチャに沿ってスペキュラハイライトを自然に反射し、塗装された金属のような平坦な見た目を避ける。また、リアルなガラス反射の下にシャープで判読可能なUI要素をきれいに重ねる。
- 超シャープなスペキュラエッジハイライトとガラスの汚れ(Qwen Image 2.1の強み):
産業デザインの被写体について仮説通り、Qwen Image 2.1は高コントラストのスペキュラ反射のレンダリングに優れる。ガラス表面全体に当たる直接的なソフトボックス光の反射は、クリーンで鮮明な境界ジオメトリを特徴とする。また、指紋の汚れ要求に厳密に従い、ガラス上の微細な不完全さを高い視覚的インパクトで捉える。
- 反射するテーブルのロールオフと素材の差別化:
Qwen 2.1は印象的なハイライトエッジをレンダリングする一方、その金属フレームは影の領域で滑らかなシルバープラスチックにやや傾く。対照的に、GPT Image 2.5はヘアライン金属の前面、ダークマットプラスチックの裏面、光沢のあるガラスディスプレイの間で明確な素材の区別を維持しつつ、暗いテーブルトップ上の自然なスペキュラの減衰を保つ。
テスト4:複雑なHDR環境、ダイナミックレンジと大気のもや
雨上がりの逆光の街路など、反射する濡れた舗装と重い影を伴う高コントラスト環境は、モデルの露出精度の限界を明確に露呈する。
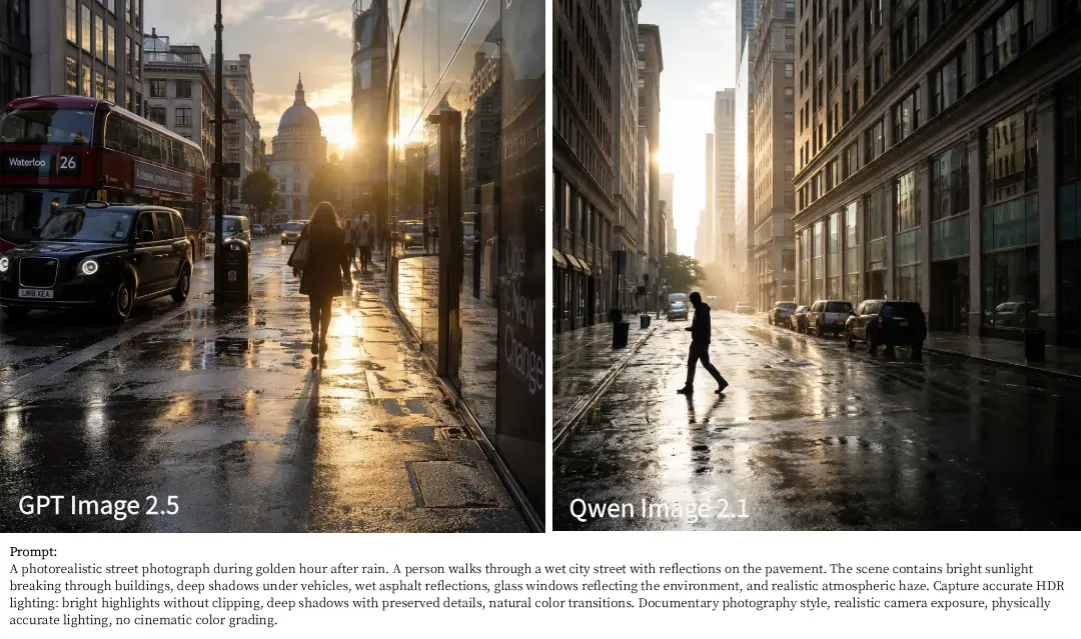
主な視覚的観察と露出メカニクス:
- 広いダイナミックレンジと影のディテール保持(GPT Image 2.5の勝利):
GPT Image 2.5は優れたカメラセンサーのエミュレーションを示し、フルサイズRAW露出を模倣する。背景の建築物を通して直接ゴールデンアワーの日光が差し込んでいても、左側の二階建てバスと黒いタクシーの下にある影のディテールを驚くほど保持し、ナンバープレートの文字とタイヤの輪郭を明瞭にレンダリングしつつ、空の明るいハイライトを飛ばさない。
- 舗装の反射の明瞭さとエッジのシャープネス(Qwen Image 2.1の強み):
Qwen Image 2.1は鮮明な環境反射のレンダリングに優れる。前景の濡れたアスファルトは、歩行者の超シャープな鏡面反射と高い石造りのファサードを捉える。複雑な建物の窓にわたる全体的な幾何学的明瞭さも、極めてクリーンなままである。
- ハイライトのクリッピングと大気の減衰:
Qwen 2.1は濡れた地面に印象的なスペキュラの筋をレンダリングする一方、その露出エンジンは強烈な逆光領域で軽度のハイライトクリッピングに悩まされ、太陽が地平線と交わる場所で純白の光のフレアを生じる。対照的に、GPT Image 2.5は立体的なもやと繊細な黄金光のロールオフをより高い光学的精度で処理し、厳しいクリッピングアーティファクトを避ける。
サマリースコアカード:フォトリアリズムベンチマーク(テスト1〜4)
4つの厳格なフォトリアリズムベンチマークにわたる発見を総括するため、以下の表は各モデルが8つの重要な視覚的忠実度指標のどこで優れているかを強調している。
| カテゴリ | GPT Image 2.5 | Qwen Image 2.1 | 主要な光学的差異 |
| 肌の毛穴 | ✓ | GPT 2.5はAIエアブラシなしで本物らしい肌の微細テクスチャと繊細な毛穴をレンダリングする。 | |
| 微細表情 | ✓ | GPT 2.5は有機的な表情筋の緊張と温かみを捉え、硬直した表情を避ける。 | |
| 影の深み | ✓ | GPT 2.5は車両や建物の下の暗い影のディテールをフルRAWライクなダイナミックレンジで保持する。 | |
| 生地テクスチャ | ✓ | GPT 2.5は過剰なシャープ化なしで自然なウールの織りと触感的な有機繊維の毛羽をレンダリングする。 | |
| スペキュラハイライト | ✓ | Qwen 2.1は濡れた舗装と金属表面に鮮明で高コントラストなスペキュラ反射を生み出す。 | |
| 製品素材 | ✓ | GPT 2.5はマットと光沢が混在するテクスチャ全体で物理的に正確な拡散/スペキュラのバランスを達成する。 | |
| クリーンなエッジ | ✓ | Qwen 2.1は超シャープな幾何学的ライン、ハードサーフェス建築、エッジ定義において卓越する。 | |
| 自然なリアリズム | ✓ | GPT 2.5は合成的な「AI光沢」のない、未編集のドキュメンタリースタイルのカメラルックを提供する。 |
シングルプロンプトテストの重要なポイント:
- ドキュメンタリーフォトリアリズムにおけるGPT Image 2.5の総合勝者:有機的な人間の物理(肌/表情)、複雑な影の深み、自然なカラーサイエンスで圧倒する。高コントラストシーンでもクリッピングを避け、商用ポートレート、リアルなストリートフォトグラフィー、エディトリアルデザインに最適な選択となる。
- 鋭い建築とハードサーフェスに最適なQwen Image 2.1:超クリーンなエッジ、鮮明なスペキュラハイライト、建築的な精度を通じて例外的な視覚的インパクトを示すが、より高い光学的コントラストに傾き、時折ハイライトクリッピングが発生する。
マルチターン反復編集ストレステスト:5ターン劣化ベンチマーク
クリエイティブディレクターは、わずか3回の連続プロンプト修正の後に、完璧なAIポートレートがピクセル化した泥に劣化するのをよく目にする。ベンダーのマーケティング主張に頼らずマルチステップのプロンプト忠実度を評価するため、両システムは標準化された5ターン編集ストレステストを受けた。
5ステップベンチマーク方法論
ストレステストは、5つの連続する編集指示にわたる被写体保持、背景差し替えの維持、ターンごとの品質損失を測定した:
- ターン1(ベース): スタジオ設定でレンダリングされた高ディテールのフォトリアルな人物ポートレート。
- ターン2(被写体編集): 顔のアイデンティティを維持しながら衣服の色とジャケットの素材を変更。
- ターン3(背景差し替え): 被写体をスタジオ設定から夕暮れの屋外都市街路へ移動。
- ターン4(照明調整): 環境光源を高コントラストのネオン夜景反射へシフト。
- ターン5(微細ディテール追加): リアルな雨粒と肌の水反射を追加。
反復ターンにわたるモデルパフォーマンス
両視覚エンジンをターンごとに評価することで、マルチターンレタッチ中の潜在空間ノイズ蓄積方法における主要なアーキテクチャの違いが浮き彫りになる。
| 編集ターン | GPT Image 2.5のパフォーマンス | Qwen Image 2.1のパフォーマンス |
| ターン1〜2 | 完璧な被写体保持と衣服テクスチャの調整;ターン2の背景差し替え中に自然なゴールデンアワーのリムライトの巻き込み。 | ターン1で鮮明な顔の保持;ターン2で背景を効果的に差し替えるが、環境光の巻き込みと背景のボケはGPT 2.5よりもやや有機的に感じられない。 |
| ターン3 | スムーズな背景とネオンの再照明パスでリアルな肌色と繊細な環境グロー。 | 過飽和なネオンハイライトが不自然に脂っぽくプラスチック的な顔の肌テクスチャを生み出す。 |
| ターン4 | 顔の輪郭をクリーンに再照明;繊細な表面の湿気を伴うマットコットンコートのテクスチャを保持。 | 深刻な素材の崩壊:マットなトレンチコートが不自然な光沢ビニール/プラスチックのレインコートに変容。 |
| ターン5 | 全身へ拡張するが、ぎこちない身体プロポーションと不自然な短縮歪みを生じる。 | 適切なプロポーションのフレーミング:解剖学的に正確な全身歩行ポーズをレンダリングするが、持続的な脂っぽい肌の反射が全体的なリアリズムを低下させる。 |
視覚的反復の進行(5ターンベンチマーク
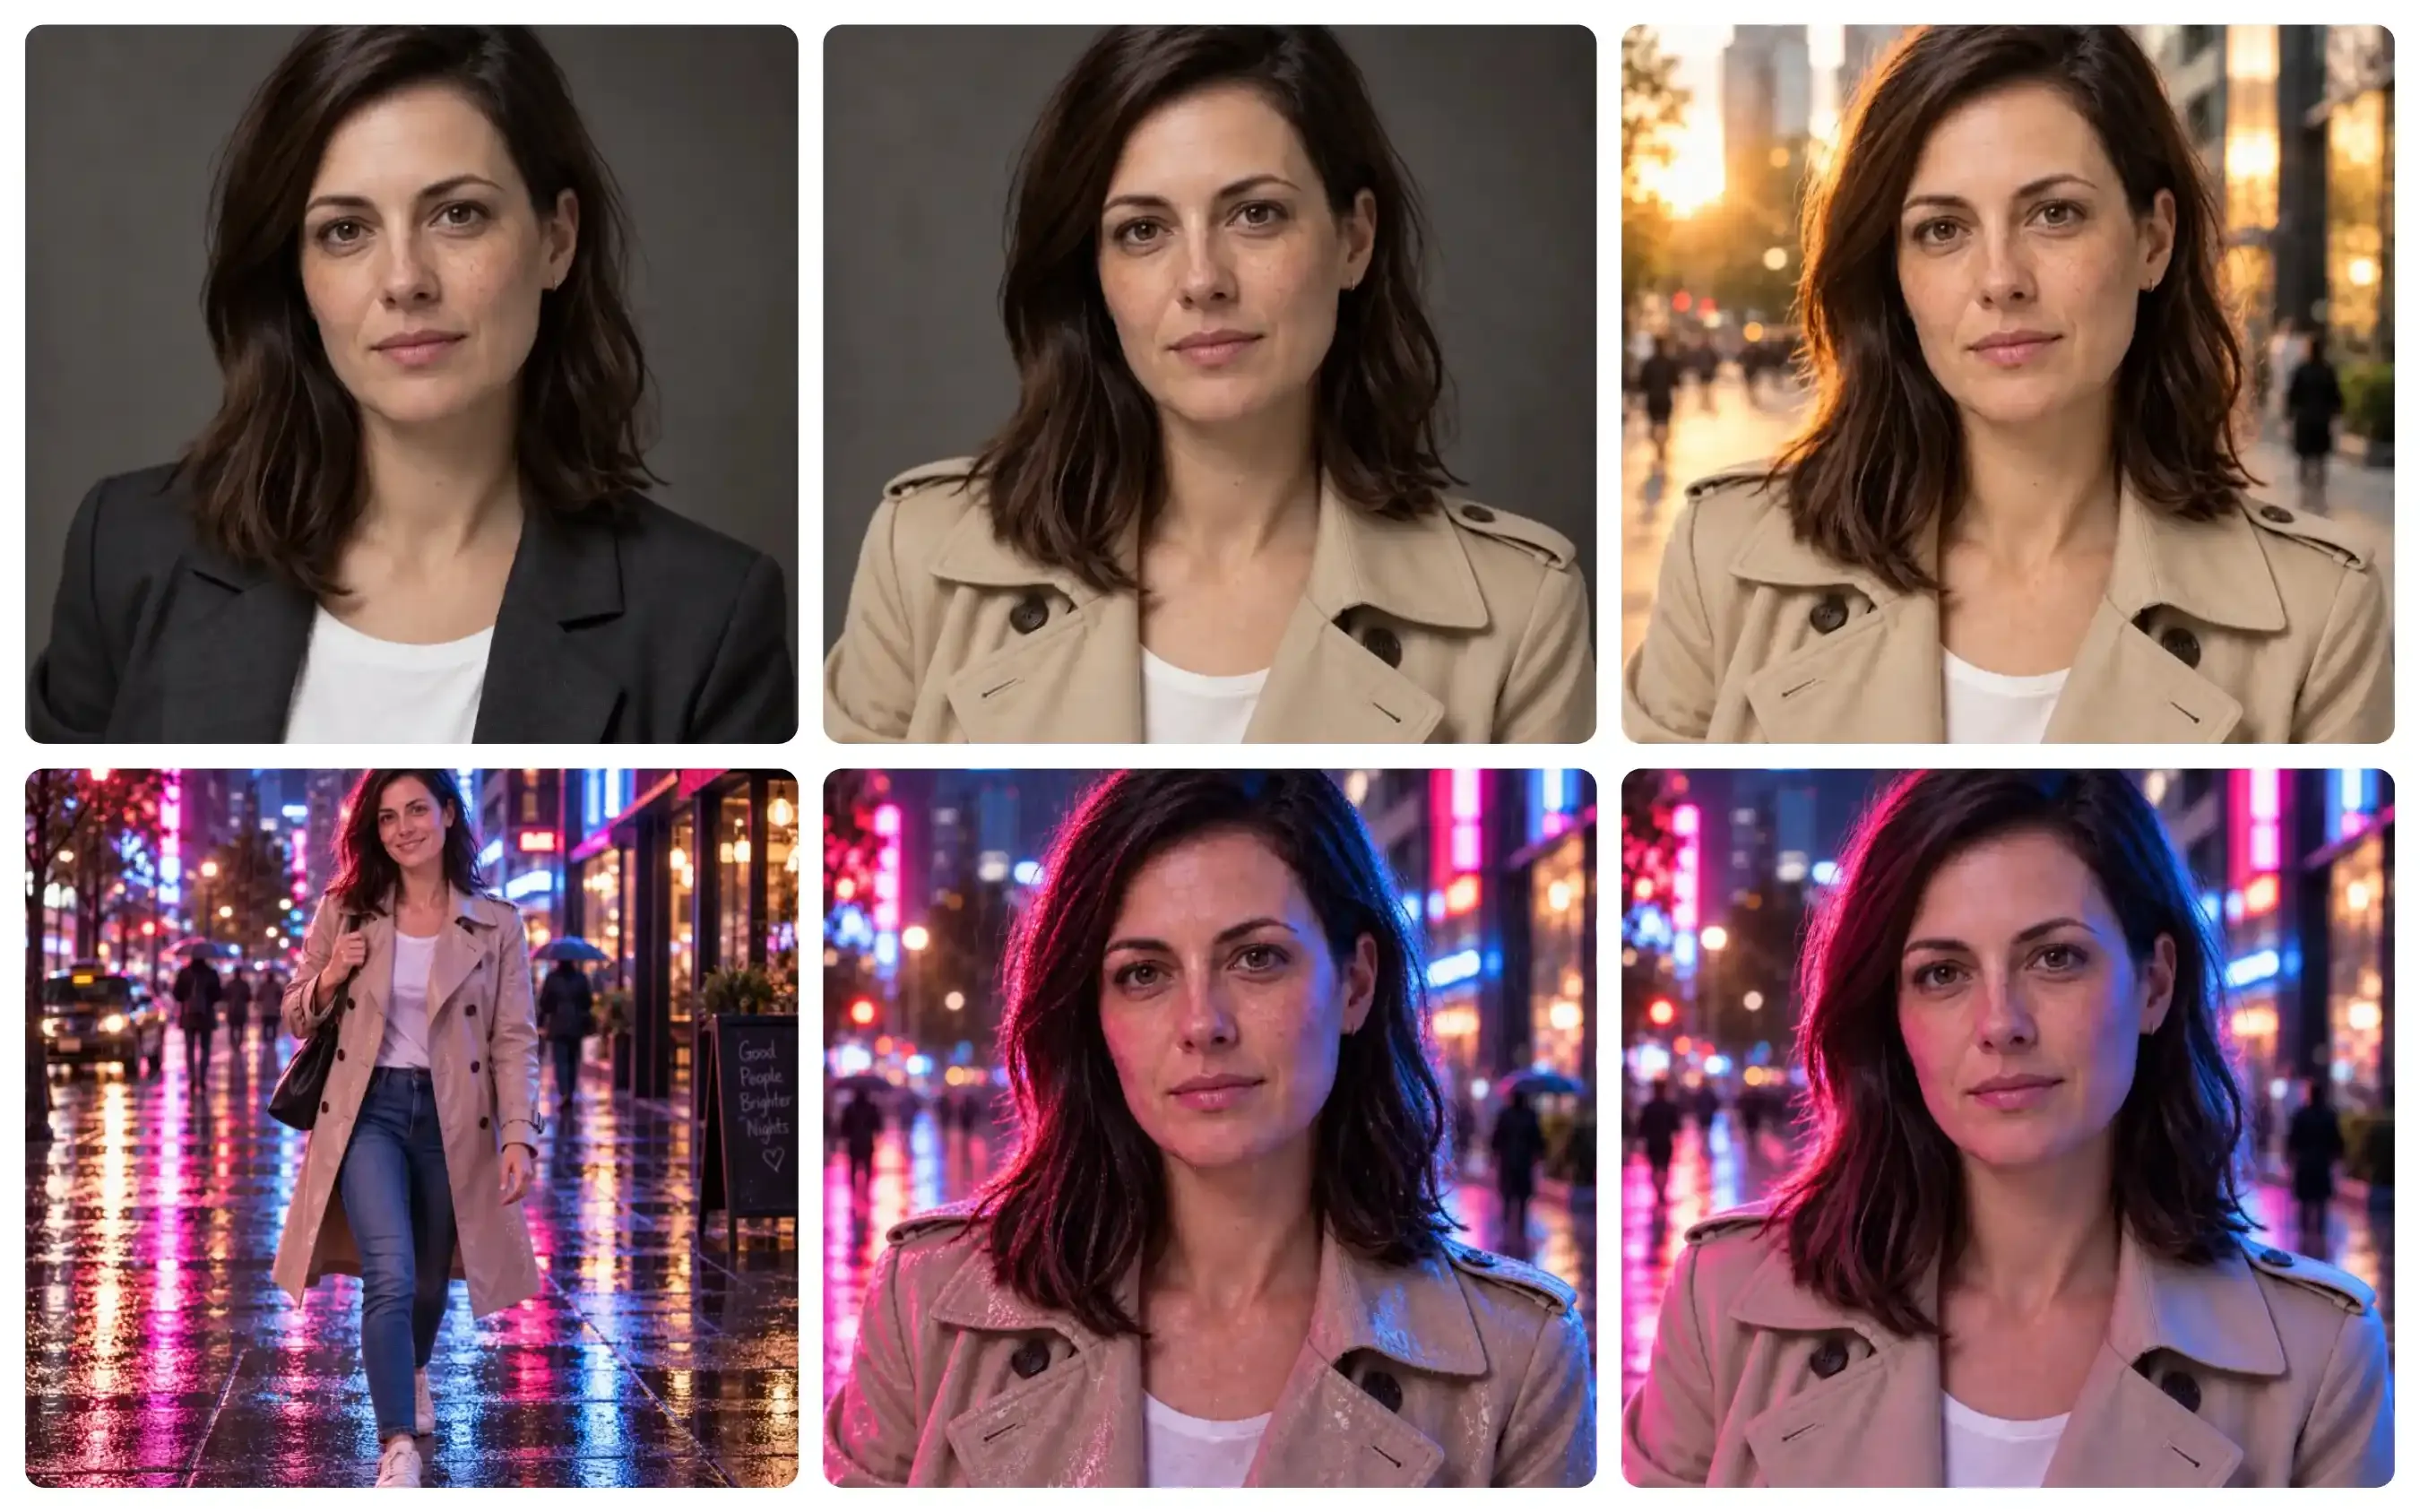
GPT Image 2.5のマルチターン反復シーケンスパネル1〜6、最初の画像がベース画像。
GPT Image 2.5の反復編集中、Sunburstモデルは全ターンを通じて強い顔のアイデンティティとリアルな光の巻き込みを維持する。背景と再照明パス(ターン2と3)で複雑な環境逆光を自然に統合し、コンポジットアーティファクトや生地テクスチャの崩壊なしに被写体をネオンとゴールデンアワー環境へシームレスに溶け込ませる。しかし、ターン5の全身拡張では、やや歪んだ身体プロポーションとぎこちない短縮歪みを生じる。
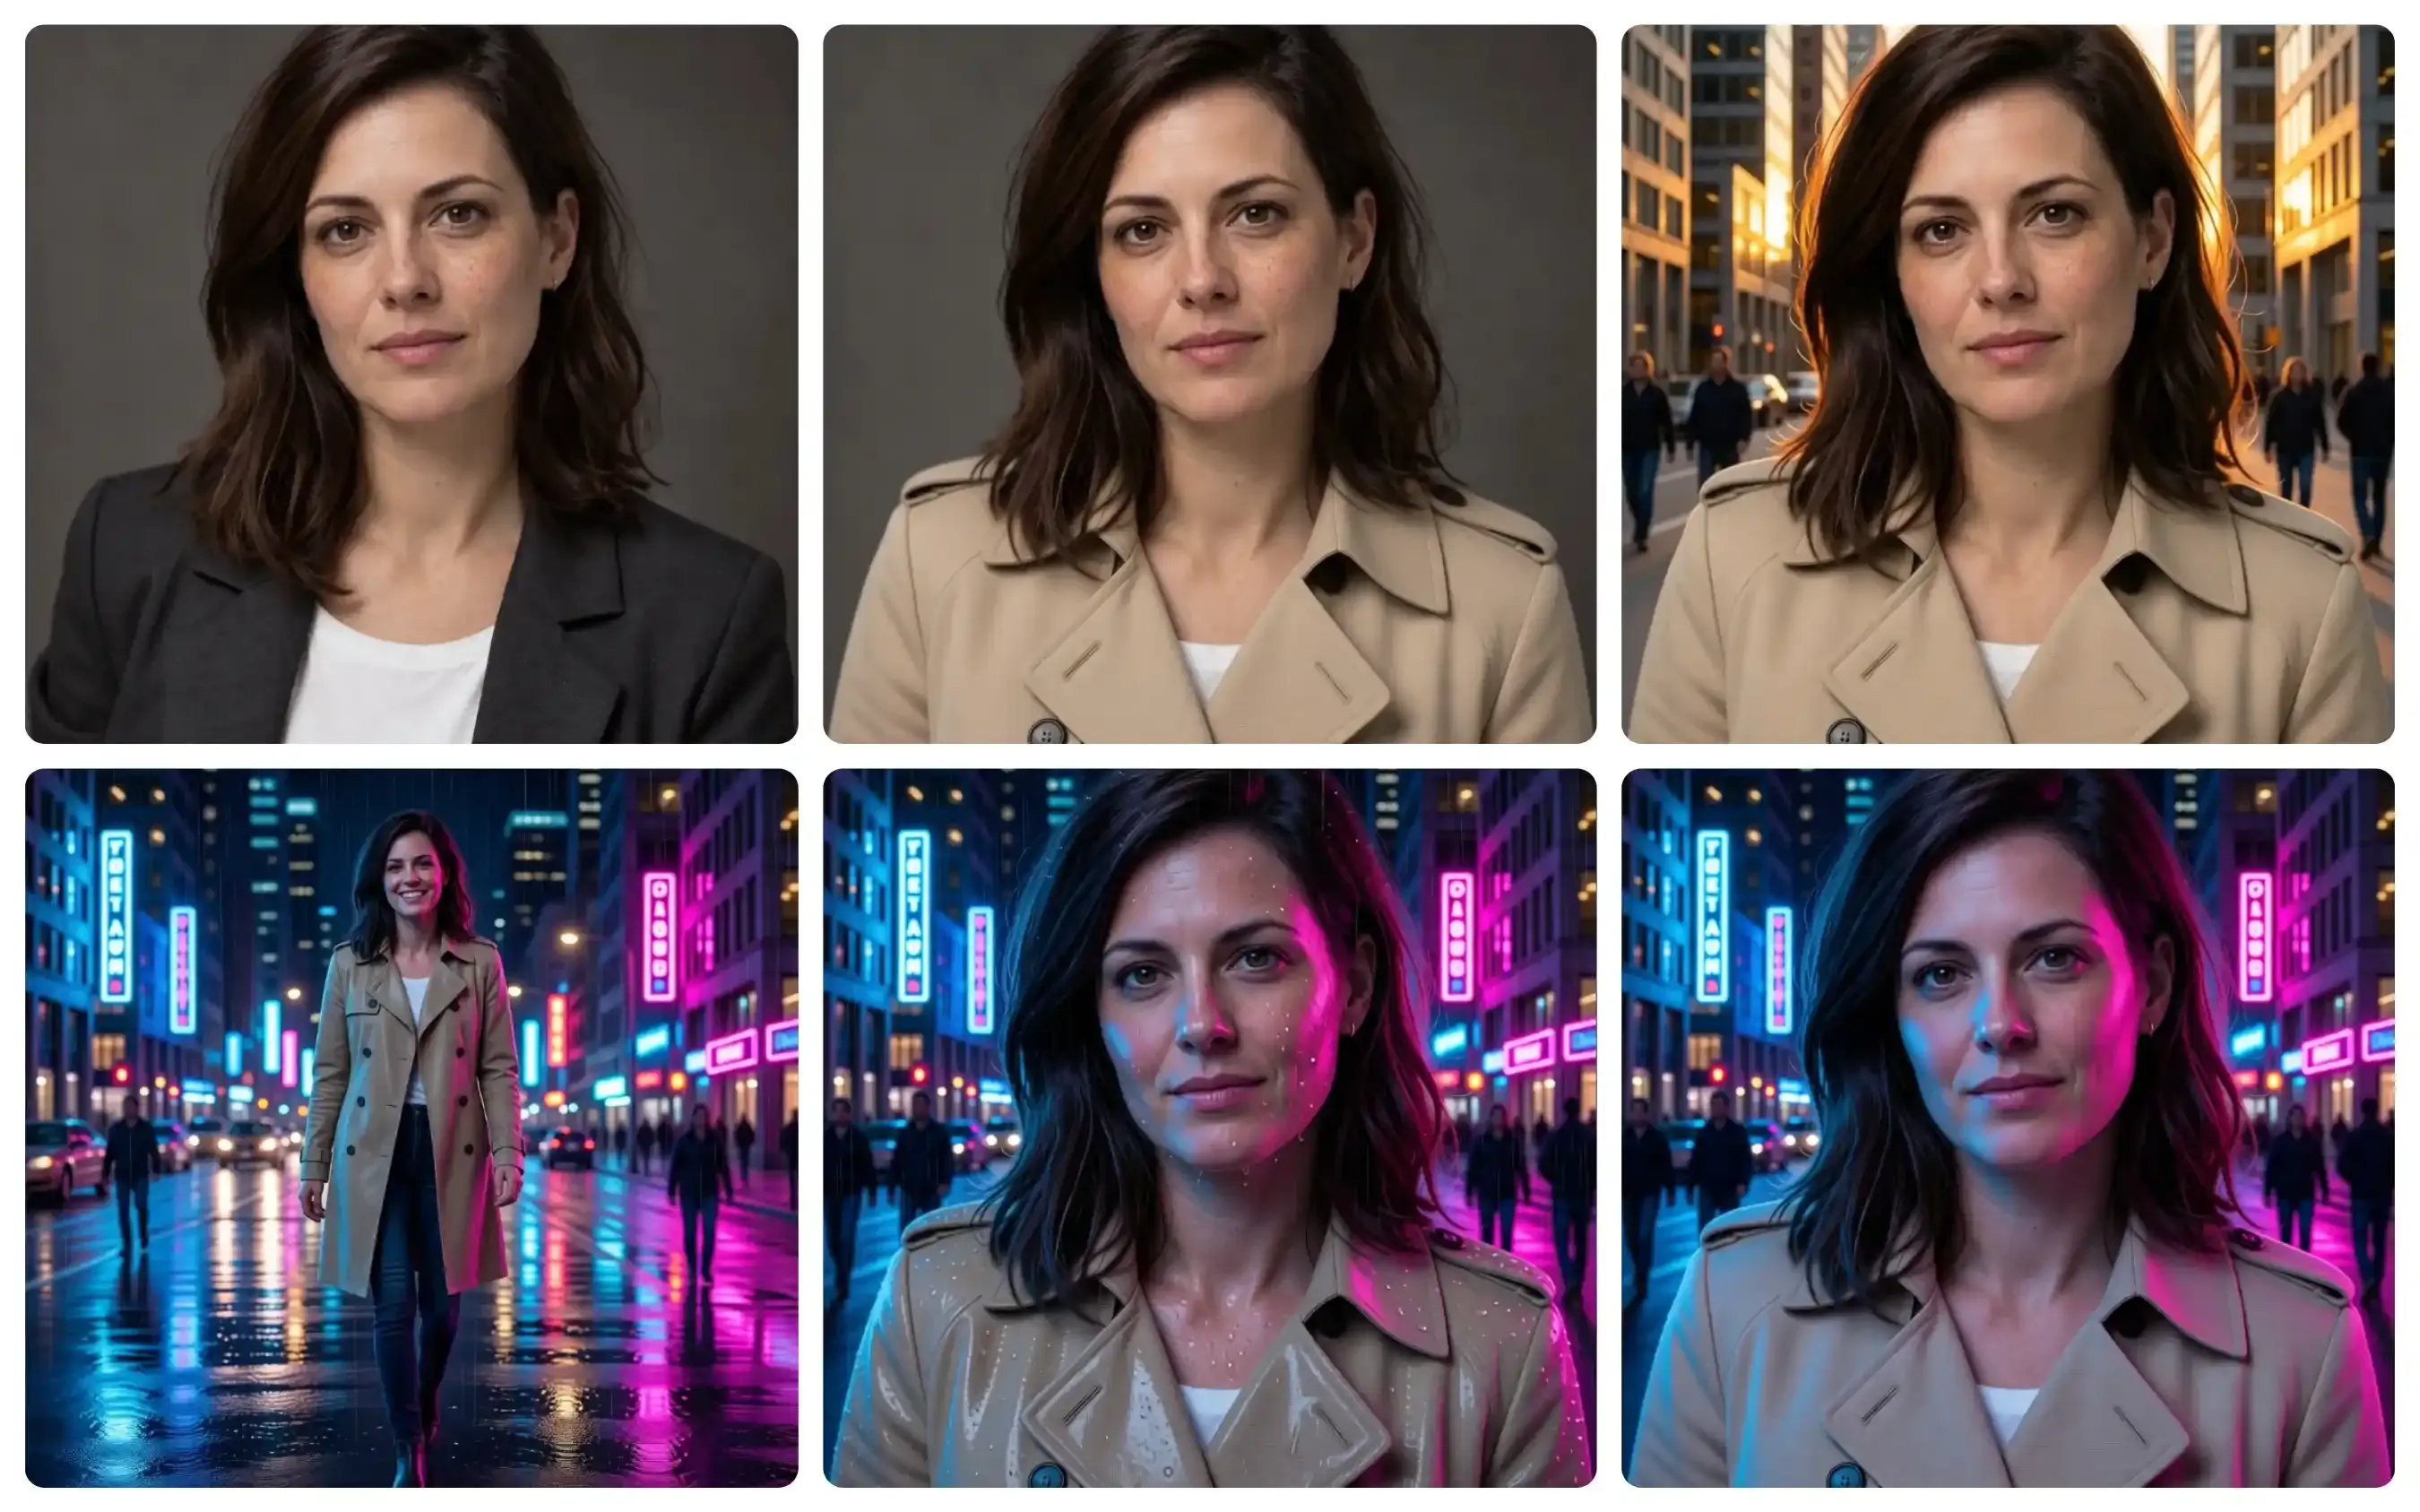
Qwen Image 2.1のマルチターン反復シーケンスパネル1〜6、最初の画像がベース画像。
対照的に、Qwen Image 2.1は初期の被写体保持と背景配置をうまく処理するが、編集が蓄積するにつれて顕著な潜在ドリフトを示す。ターン2の背景差し替えは構造的に健全だが、その光の統合はGPTよりも繊細さに欠ける。その後の再照明と雨のパス(ターン3と4)が素材シフトを引き起こし、衣服のコットンテクスチャを高光沢プラスチックレインコートに変え、肌のハイライトが過飽和になる。
「ブロック状」アーティファクト現象:反復画像編集が品質を劣化させる理由
繰り返しのプロンプト修正はしばしば微細テクスチャを侵食し、繊細な髪をブロック状アーティファクトに変え、肌の反射を過飽和にし、マットな生地を光沢プラスチックへ変異させる。 Tこのパターンは、視覚エンジンが連続編集にわたって潜在空間変換をどのように管理するかという根本的なアーキテクチャの違いに直接起因する。
アーキテクチャメカニクス vs ピクセル劣化
| 技術パラメータ | OpenAI GPT Image 2.5パイプライン | Qwen Image 2.1 DiTフレームワーク |
| 再エンコード方式 | フルキャンバスVAE再エンコード | プレフィックスKVキャッシュ再利用とチャンクマスキング |
| ノイズ蓄積 | 全体的な潜在空間ドリフト | 局所的な編集マスクに限定 |
| 5ターンベンチマークでの観察効果 | 自然な環境光のブレンド;後半ターンでの繊細な全体的ノイズ蓄積と解剖学的/プロポーションのずれ。 | 高い背景構造剛性;局所的な潜在再処理がスペキュラ飽和(脂っぽい肌)と素材の崩壊(コットンからビニールへ)を引き起こす。 |
| 緩和戦略 | 拡張サンプリング(Sunburstモード) | 混合粒度アテンションとマスク分離 |
アーキテクチャをベンチマーク結果に結びつける
アーキテクチャの選択がマルチパスのピクセル劣化にどう影響するかを理解することで、5ターンストレステストの結果が直接説明される:
- 完全潜在再エンコード(GPT Image 2.5):
フルフレームワークフローでは、GPT Image 2.5は各編集ターンで潜在キャンバス全体を再エンコードする。_シングルプロンプトフォトリアリズム_テストで示されたように、この全体的アプローチは複雑な光学的相互作用の計算に優れる—たとえばターン2での髪と肌にわたる自然なゴールデンアワーのリムライトの計算など。しかし、すべてのパスがキャンバス全体を処理するため、拡散ノイズが複数ターンにわたって全体的に蓄積する。ターン4と5までに、これが繊細な高周波ディテールの損失、影のマクロピクセル量子化、全身フレーム拡張中の解剖学的短縮歪みを生み出す。
- 局所マスキングとキャッシュ再利用(Qwen Image 2.1):
Qwen 2.1の32層シングルストリームDiTアーキテクチャは、チャンクレベルのマスキングとプレフィックスKVキャッシュ再利用を活用する。静的コンテキスト計算はノイズ除去ステップ中に未編集領域をロックし、背景ピクセル全体の再エンコード損失を排除し、超シャープな建築ラインを保持する。しかし、生成的更新が局所マスク内に限定され集中的に処理されるため、同じサブ領域への繰り返しパスはスペキュラハイライトを過飽和させる傾向があり、ターン3での脂っぽい肌反射への移行とターン4でのコートの素材シフト(マットコットンから高光沢ビニールへ)が説明される。
GPT Image 2.5のSunburstモードは拡張サンプリングを使用して初期ターンを通じて優れた光物理と有機的な肌テクスチャを維持する一方、その全体的処理は最終的に繊細なキャンバス全体のドリフトを引き起こす。逆に、Qwen Image 2.1はKVキャッシュを介して未編集トークンをロックすることで背景ジオメトリの劣化を防ぐが、長時間のレタッチチェーン中の局所ハイライト飽和を避けるには慎重なプロンプト処理を必要とする。
編集メカニクスとワークフロー制御:コメントハイライト vs ローカルマスキング
AIモデルにモデルのジャケットを差し替えるようプロンプトすると、システムが背景を再設計したり顔の特徴を変更したりすることがよくある。正確な入力メカニクスが、反復編集中の更新が局所にとどまるか、コンポジションの残りを破壊するかを決定する。
GPT Image 2.5対Qwen Image 2.1を比較すると、マルチステップのプロンプト忠実度を維持するための2つの異なる運用フレームワークが明らかになる。
制御インターフェースと入力メカニクス
| 機能能力 | GPT Image 2.5キャンバスツール | Qwen Image 2.1編集システム |
| ローカルターゲット選択 | 座標ピンとベクターストローク | ペイント注釈、円、バイナリマスクファイル |
| 参照画像アンカリング | 最大16枚の参照画像をサポート | 最大10枚の参照画像をサポート |
| ピクセル分離 | フルフレーム潜在再エンコードパス | チャンクレベルマスクロック付きプレフィックスKVキャッシュ |
| レイヤー出力オプション | 標準RGB出力 | ネイティブ透過RGBA生成 |
ピンポイント注釈 vs バウンドマスキング
OpenAIはChatGPTインターフェース内の座標ピンとフリーハンドベクターストロークに依存している。ChatGPTコメント編集機能を通じて座標ピンを配置すると、ターゲットゾーンへのセマンティックテキスト更新がシグナルされ、スケッチガイド付きワークフローでは描画したベクターラインを使用してレイアウトジオメトリを方向付ける。参照画像アンカリングと最大16枚の入力画像の組み合わせにより、バリエーション全体で被写体スタイルが揃う。しかし、基盤モデルが画像キャンバス全体を再エンコードするため、ピンポイント座標を超えてわずかなピクセルブリードが発生する可能性がある。
逆に、Qwen Image 2.1はユーザーが注釈をペイントしたり、複数の編集ターゲットの周りに色付きの円を描いたり、別のバイナリマスクファイルを提供したりできる厳密なローカルマスク編集を強制する。その際立った能力であるネイティブ透過RGBA生成により、クリエイターは実際のアルファチャンネルで直接透過カットアウトを生成または編集でき、後処理の背景除去ツールを回避できる。参照画像アンカリングは最大10枚の入力画像をサポートするが、明示的なマスク境界の背後に未編集ピクセルをロックすることで、より高いユーザー意図の精度が得られ、望まない全体的シフトを防ぐ。
マルチターンAI編集中のアーティファクト蓄積を防ぐ実用的な回避策
洗練された商用コンポジットが4回目のプロンプト修正までにぼやけたピクセルに劣化するのを見ると、制作チームは何時間もの編集の進捗を捨てざるを得なくなる。構造化されたマルチターン編集の回避策を実装することで、クリエイターは複雑な修正ワークフローにわたって画像の明瞭さを維持し、ピクセル劣化を避けられる。
クリーンなAI画像編集のための制作戦略
4つの的を絞った制作テクニックを適用することで、チームはマルチパス生成中のAI画像劣化を防げる:
- 参照の再アンカリング: 最新の編集プロンプトと共に元のターン1ベース生成を明示的な参照画像として再注入することで、モデルに顔のプロポーションと背景照明ベクターを再調整させる。この参照画像再アンカリングテクニックは、連続する生成パスにわたる潜在ドリフトをリセットするのに役立つ。
- 戦略的精度ティア選択: GPT Image 2.5 Flareで迅速なビジュアルドラフトを実行すると、以前のモデルと比較してレイテンシが50%削減される。最終編集パスにはSunburst品質ティア(
xhighまたはmax)に切り替えることで、拡張サンプリング時間が適用され、複雑なディテールを保持し再エンコードノイズを制限する。 - 分離されたローカルマスキング: Qwen Image 2.1のマスクバウンド編集を利用して、生成的更新をターゲット境界内に厳密に閉じ込める。明示的なバイナリマスクまたはペイント注釈を提供することで、未編集の背景ピクセルがノイズ除去パイプラインを完全にバイパスし、元の画像のシャープネスが維持される。
- シングルパス複合プロンプティング: 複数の小さな編集リクエストを1つの統合された指示パスに組み合わせることで、マルチターンの品質劣化を避ける。ジャケットの色、背景環境、照明角度を1ステップで変更する複合プロンプティングを実践することで、総再エンコードサイクルが削減される。
これらの実用的なGPT Image 2.5編集のヒントに従うことで、デザイナーはマルチステップの商用プロジェクト全体で厳密な検査に耐えるクリーンなAI画像編集を提供できる。
最終判断ガイド:ワークフローにはどのモデルを選ぶべきか?
静的なリーダーボードスコアだけに基づいて画像生成プラットフォームを選ぶと、複雑なクライアント修正が来たときに制作のボトルネックが生じることが多い。編集に最適なAI画像モデルの選択は、クリエイティブチームが商用ゼロショットの完璧さを優先するか、反復編集パイプライン全体でのオープンウェイトの柔軟性を優先するかによって決まる。
制作比較マトリクス
| ワークフロー要件 | GPT Image 2.5 (Sunburst / Flare) | Qwen Image 2.1 (7B DiT) |
| 主要なデプロイ | マネージドAPIとChatGPT UI | オープンウェイトのセルフホスト |
| 最大ネイティブ解像度 | 4K API出力(最大3840px) | 2Kネイティブ出力(2048px+) |
| マスキングと透過性 | ビジュアルピンポイントコメント | ネイティブ透過ステッカー(RGBA) |
| マルチターンコスト管理 | 生成ごとの従量制API価格 | コンシューマーGPUでの無料ローカル実行 |
制作パイプラインに基づく選択
具体的な技術設定が、どちらのモデルがより高い効率を提供するかを決定する:
- GPT Image 2.5を選ぶべき場合: チームが最高クラスのゼロショットディテール、4K API出力、複雑なテキストレンダリングを必要とする商用フォトリアリズムワークフローパイプラインを管理している場合。ハイエンドブランディング、広告ポスター、シームレスなWeb利用向けに構築されており、そのSunburst品質ティアはChatGPTインターフェースまたはマネージドエンドポイントを通じてクリーンな照明と正確な解剖学的構造を直接提供する。
- Qwen Image 2.1を選ぶべき場合: 生成ごとのAPIコストなしでコンシューマーハードウェア上でローカルに動作するセルフホスト画像モデルが必要な場合。オープンウェイトアーキテクチャとして動作し、開発者に完全なデータプライバシー、64チャンネルRGBA生成によるネイティブ透過ステッカー、明示的なマスク境界を使用したコスト効率の良いマルチ参照コンポジションを提供する。
GPT Image 2.5対Qwen Image 2.1をスタジオのインフラストラクチャに対して評価することで、初期の視覚的忠実度と長期的な運用コストのバランスを確実に取れる。


