ダウンロードバーが65 GBに達し、ファンが回り始め、本当の疑問が浮かぶ。実際にロードできるのか? GPT-OSS-120Bのメモリ要件 に対する簡単な答えは、重みに約61 GB、さらに作業スペースに数GBが必要で、だからこそOpenAIは単一の80GB GPUモデルとして売り込んでいる。
以下では、その数字を部分ごとに分解し、実際に測定された速度で実行したハードウェアを示し、自分のマシンが要件を満たさない場合のホステッドルートについて説明します。
主なポイント
- GPT-OSS-120Bは60.8 GiBのMXFP4チェックポイントとして提供されるため、OpenAIは単一の80GB GPUをターゲットにしています。
- コンテキスト長によるメモリ増加はわずかです。KVキャッシュは最大131Kトークンでも約4.5 GiBにしか達しません。
- VRAMが80GB未満でも、llama.cppはエキスパート層をシステムRAMにオフロードして実行できます。
- 96GBを超えるメモリを搭載したMacや128GBのミニPCは、1台でフルモデルを保持できます。
- 適切なハードウェアがない場合は、OpenAI互換APIを通じて Qwen3.5 122B A10B on Atlas Cloud を呼び出してください。
GPT-OSS-120Bのメモリ要件:重みとKVキャッシュ
OpenAIは2025年8月5日にgpt-oss-120bをApache 2.0ライセンスの下でリリースしました。これはMixture-of-Expertsモデルであるため、116.8Bのパラメータのうち各トークンで動作するのはわずか5.1Bです。これは速度には役立ちますが、メモリには役立ちません。すべてのエキスパートは選択されるためにメモリ上に待機している必要があります。
それを小さく保つ秘訣はMXFP4です。gpt-ossモデルカードによると、パラメータの90%以上を占めるエキスパートの重みは、それぞれ4.25ビットで保存されています。同じモデルの16ビットコピーは約4倍のスペースを必要とします。
| 仕様 | GPT-OSS-120B |
|---|---|
| 総パラメータ数 | 116.8B |
| トークンあたりのアクティブパラメータ数 | 5.1B |
| レイヤーとエキスパート | 36レイヤー、128エキスパート、トークンあたり4アクティブ |
| 重み形式 | エキスパート層はMXFP4、その他はBF16 |
| チェックポイントサイズ | 60.8 GiB |
| コンテキストウィンドウ | 131,072トークン |
コンテキストウィンドウがGPT-OSS-120Bのメモリをどう変えるか
各トークンは、各アテンション層にキーと値を残します。その保存領域がKVキャッシュであり、すべての層が完全なコンテキストにアテンションする場合、コンテキスト長に比例して増加します。
GPT-OSS-120Bはそのほとんどを回避します。36層のうち半分は、128トークンだけ後方を見るスライディングウィンドウを使用し、各層は64次元のKVヘッドをわずか8つ保存します。完全なコンテキストを保持するのは18層だけです。モデルの設定からKVキャッシュを計算したところ、llama.cpp gpt-ossガイドの測定値と一致しました。
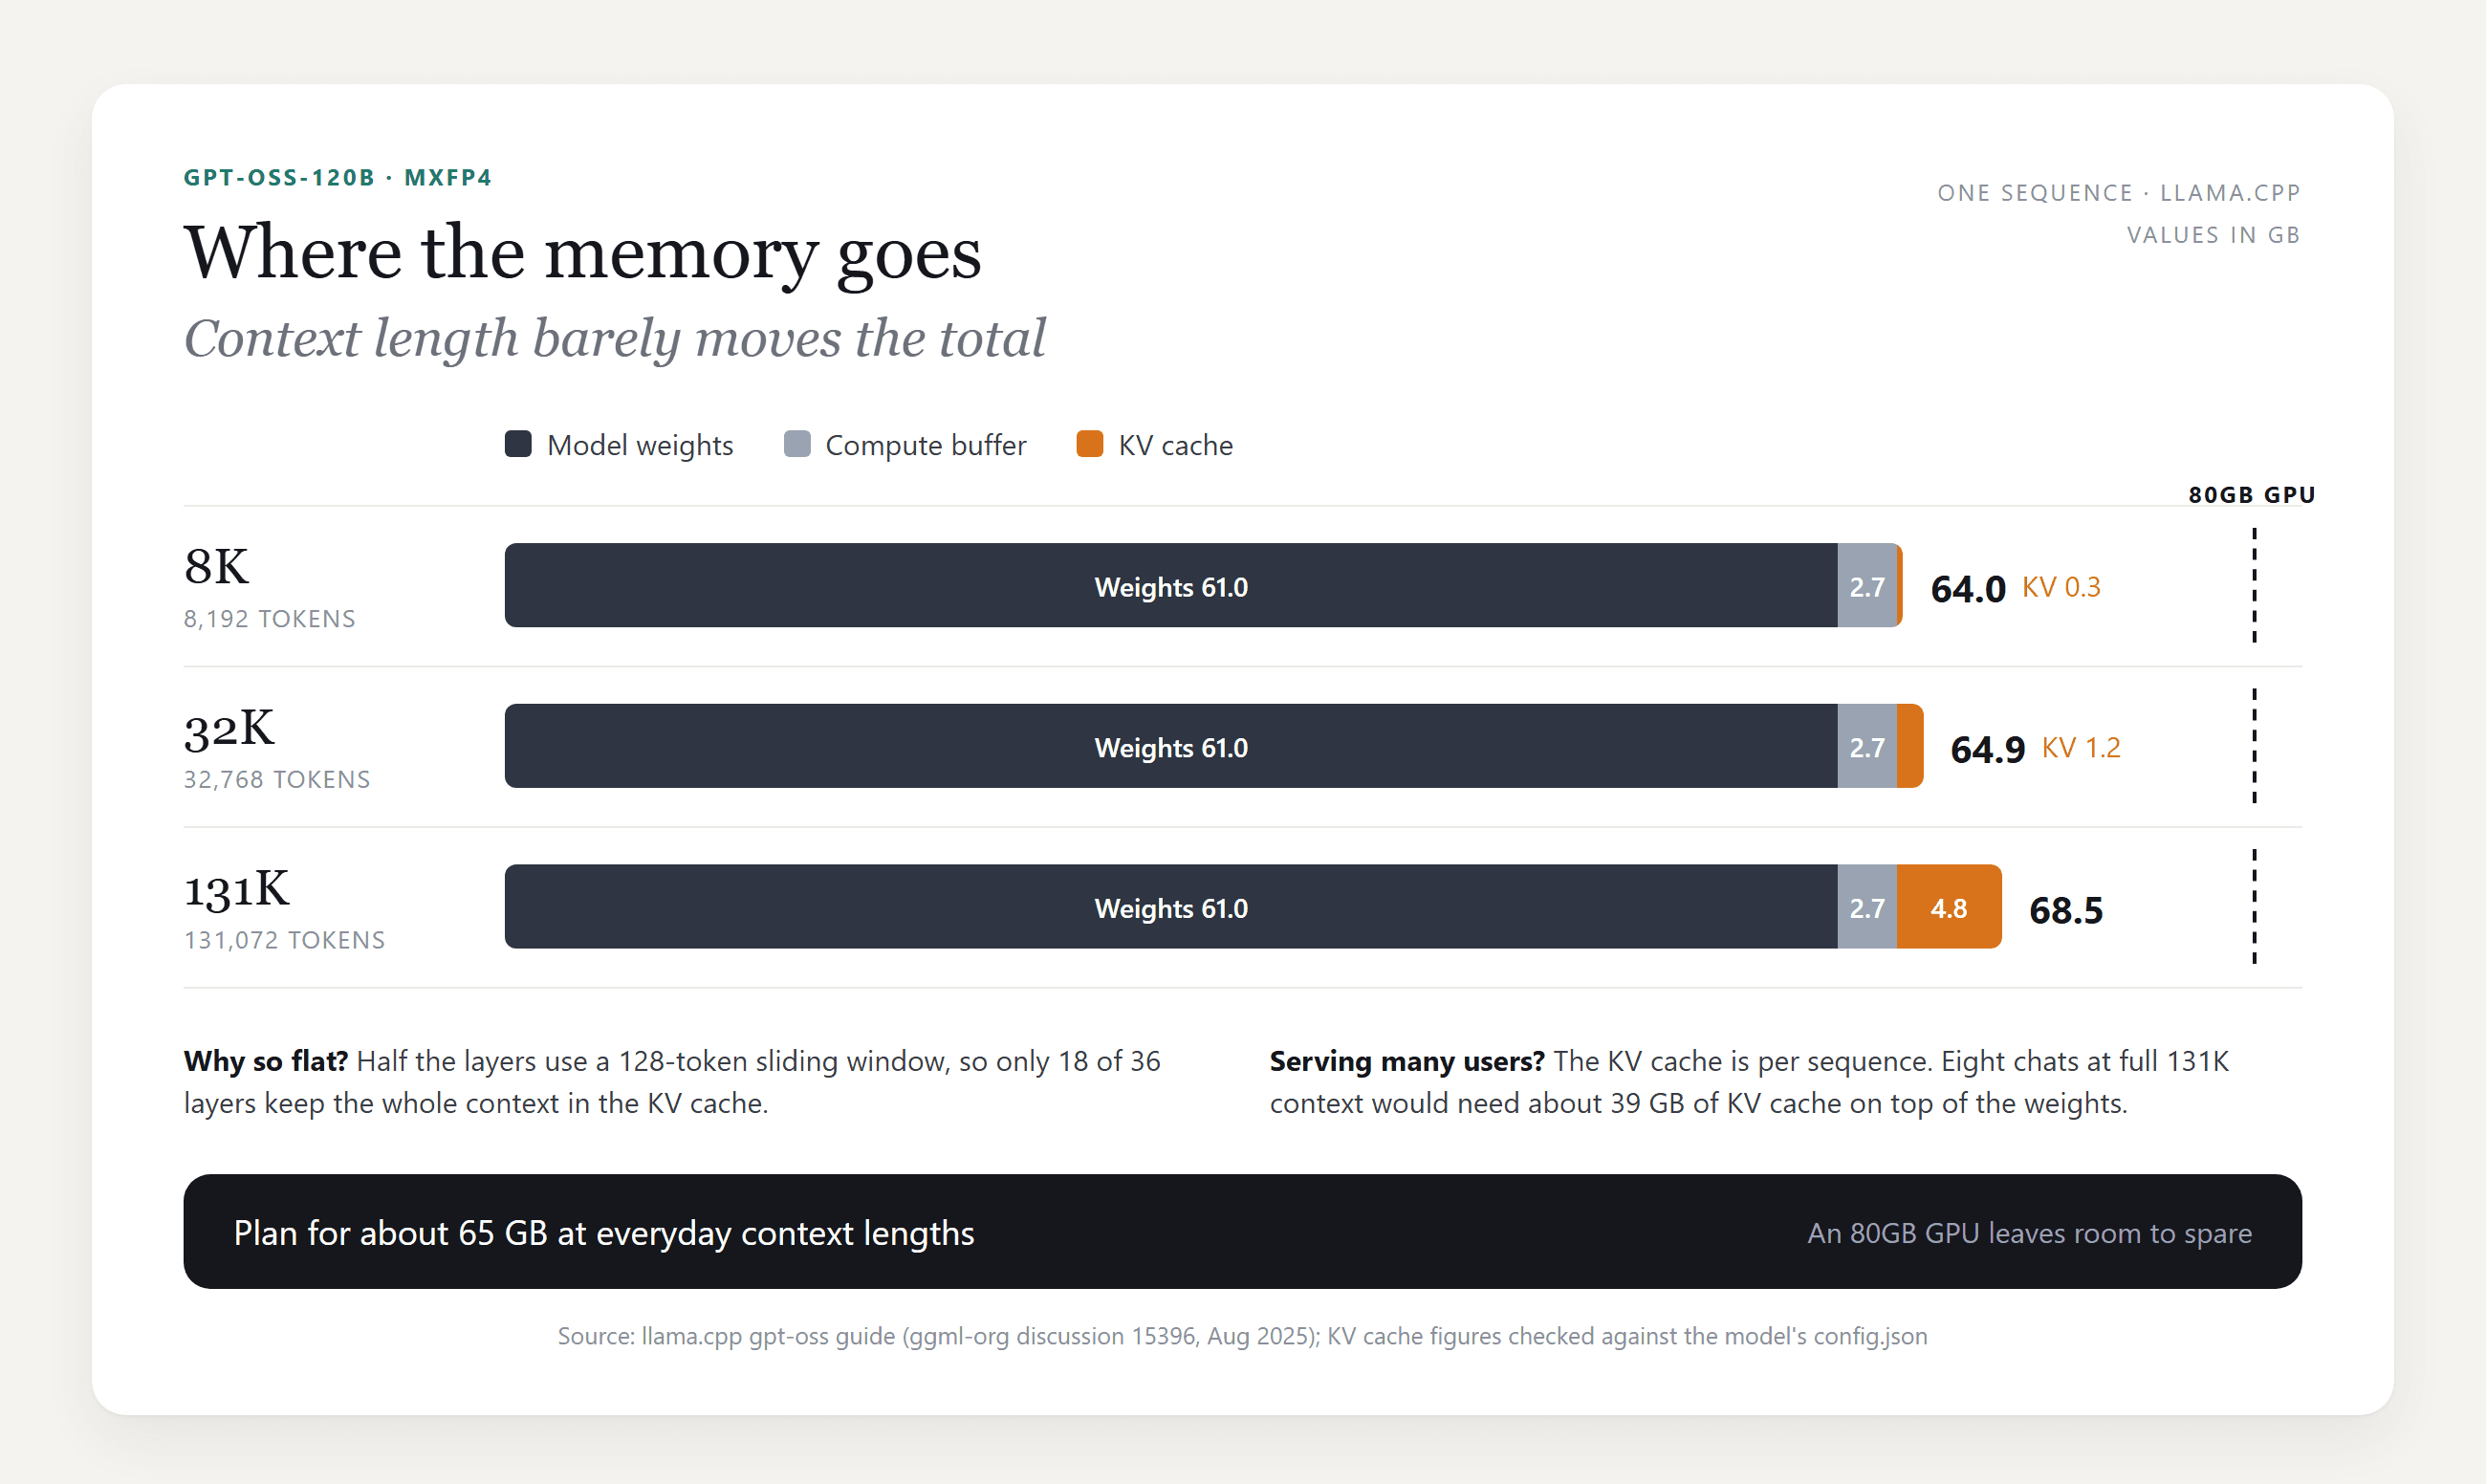
8Kから最大131Kに増やしても、コストは5 GB未満です。積み上がるのは同時実行数です。KVキャッシュは会話ごとなので、8つのフルレングスのチャットを保持するサーバーは、重みに加えて約39 GBが必要です。
GPT-OSS-120Bをローカルで実行できる?セットアップ別のハードウェア要件
はい、約65 GBを高速な場所に置ければ可能です。大きなGPU1基、GPUとシステムRAMの組み合わせ、または統合メモリを搭載したマシンです。
GPT-OSS-120BのGPU要件
最も単純なケースは、80GBのデータセンターカード1枚です。gpt-ossのvLLMレシピによると、120bモデルは「単一のA100(80GB)に収まる」とされ、より多くのGPUに分割するとスループットが向上します。
80GB未満の場合、llama.cppガイドが解決策を提供します。その--n-cpu-moeフラグは、一部のエキスパート層をシステムRAMに置き、残りをGPUに置きます。ガイドでは、GPUとシステムメモリを合わせてモデルを保持できる限り、最小約8GBのVRAMとしています。
| セットアップ | 重みの保存場所 | 報告された生成速度 |
|---|---|---|
| RTX Pro 6000, 96GB | すべてGPU上 | 196 tokens/s(llama.cppガイド) |
| A100またはH100, 80GB | すべてGPU上 | 1枚のカードに収まる(vLLMレシピ) |
| RTX 5090, 32GB, プラスシステムRAM | 21のエキスパート層をシステムRAMに保持 | ゼロコンテキストで約30 tokens/s(llama.cppガイド) |
同じガイドからのWindowsの落とし穴:ドライバはVRAMが不足すると、静かにシステムRAMに流出することがあり、モデルはロードされるものの、その後這うように遅くなります。タスクマネージャーでGPUメモリを監視し、カードのサイズ以下に収まるまでオフロード数を増やしてください。
Macまたは128GBミニPCでGPT-OSS-120Bを実行する
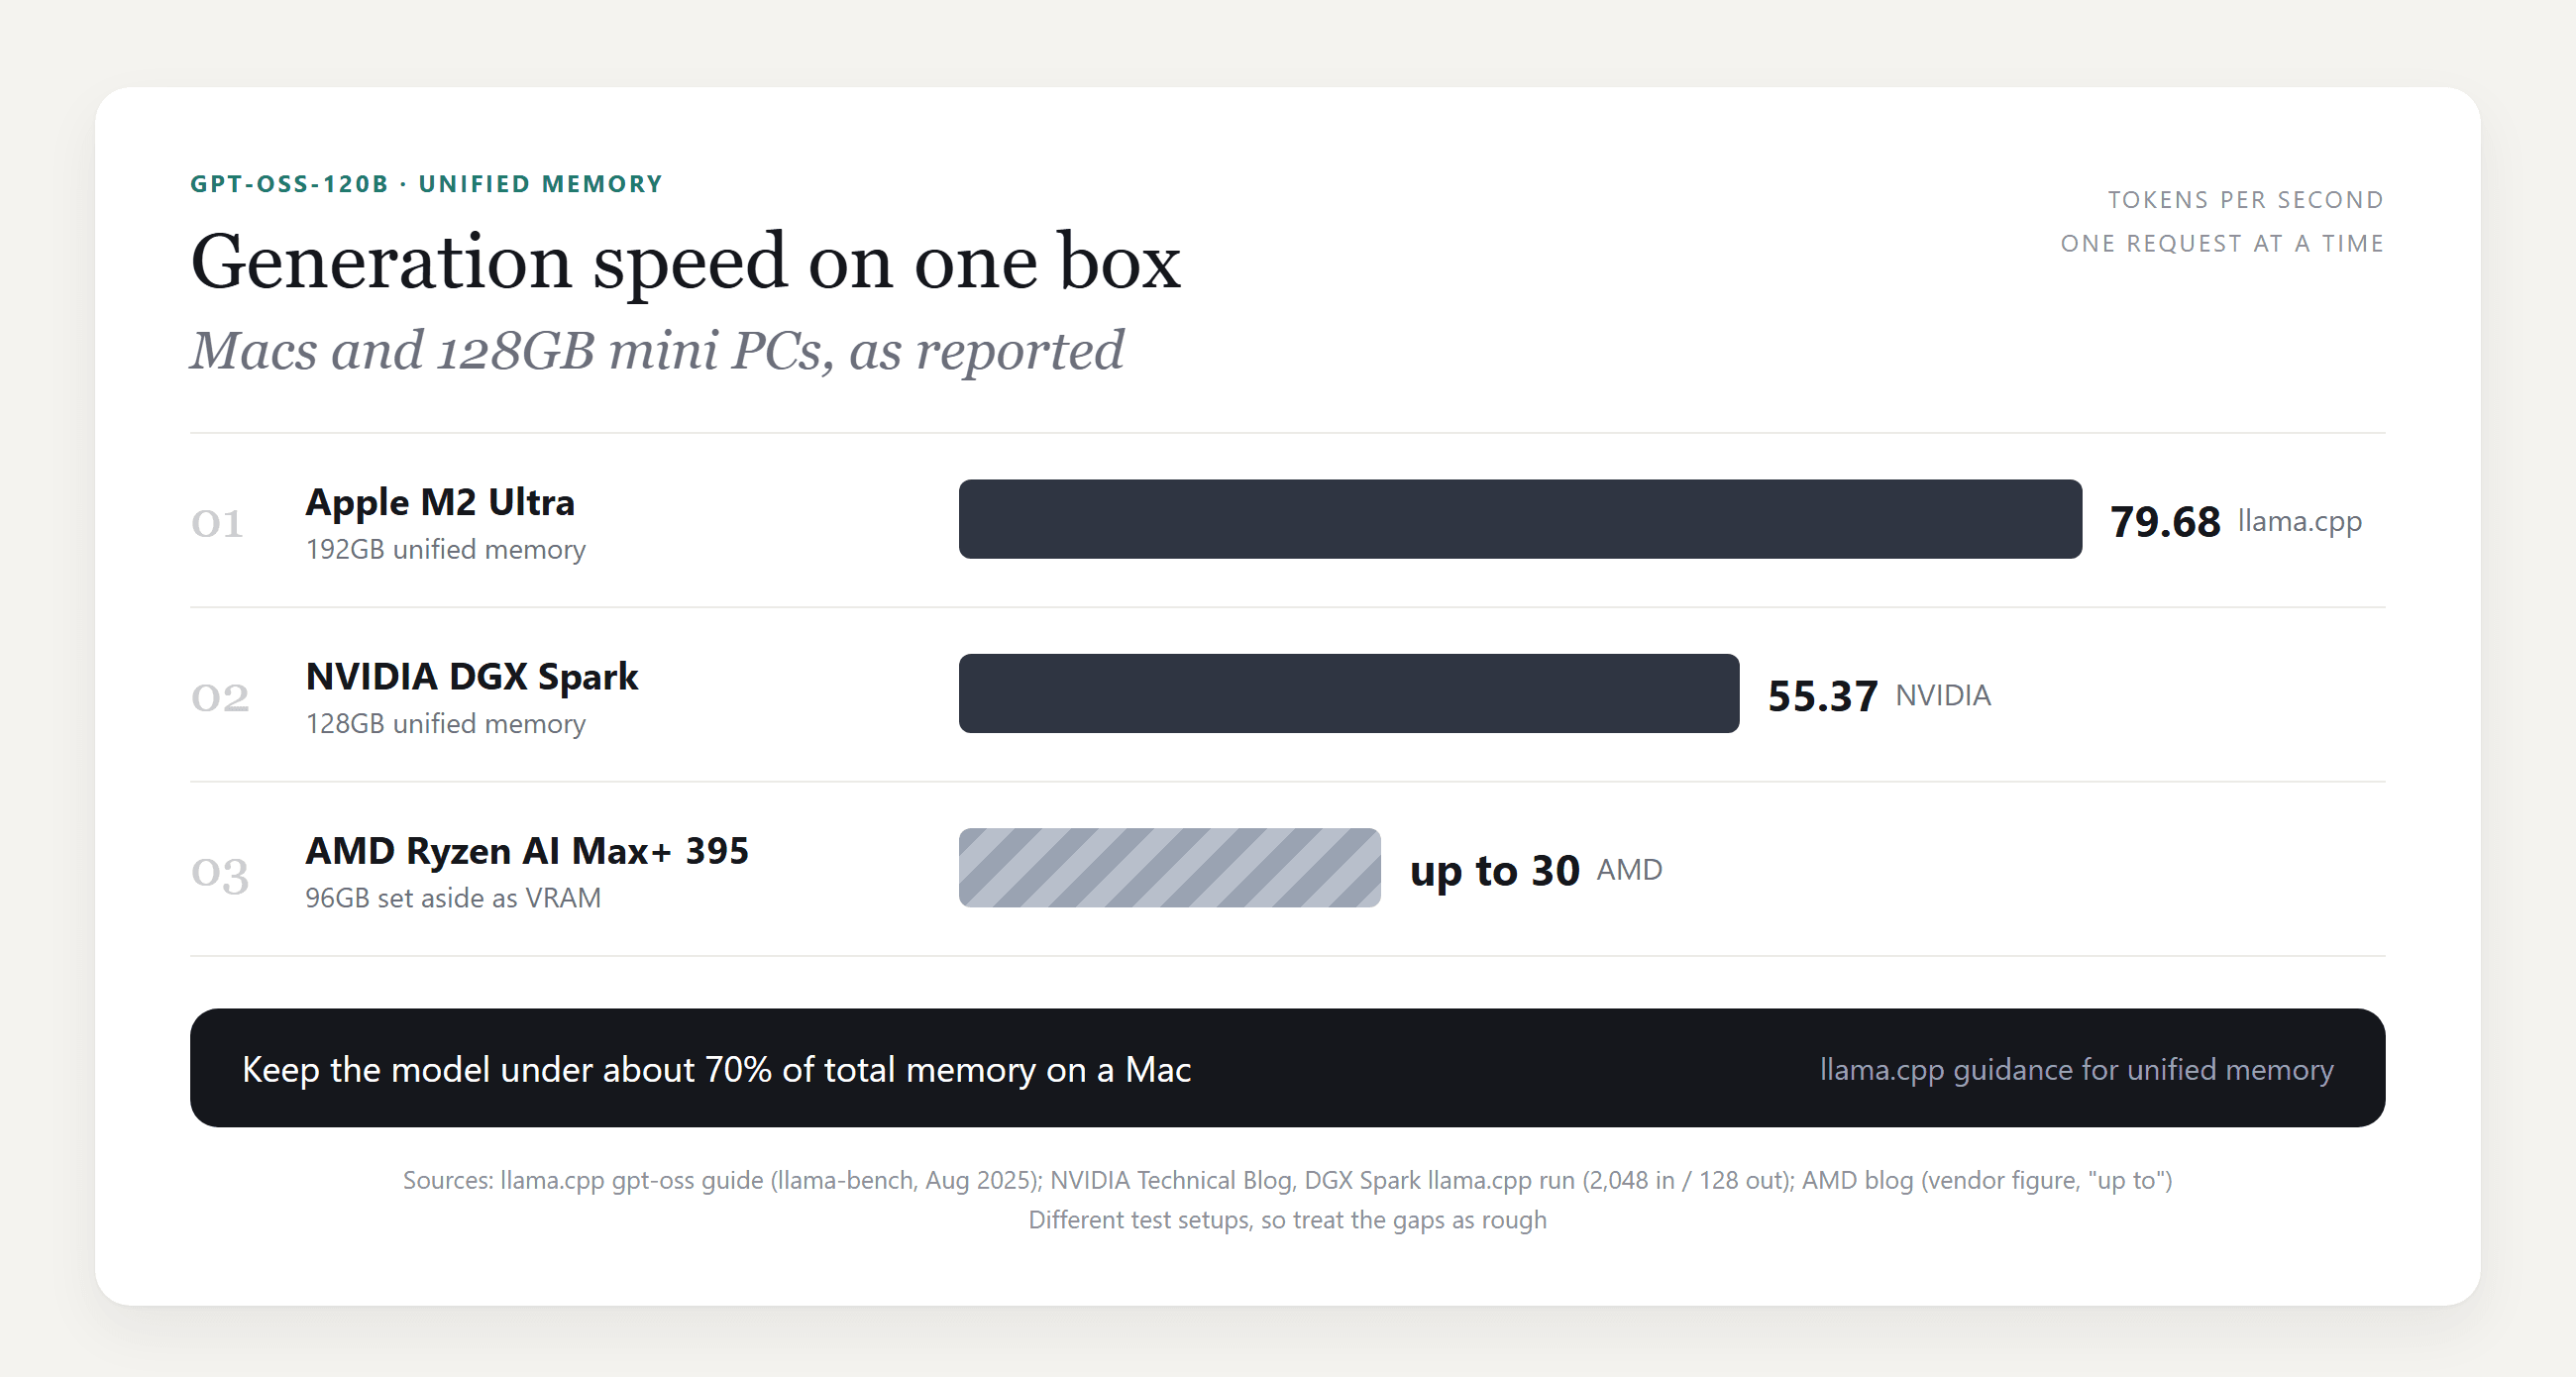
統合メモリはGPUとRAMの分割を解消します。llama.cppガイドによると、M2 UltraやM3 Maxマシンなど、96GBを超えるRAMを搭載したMacはフルコンテキストでモデルを実行でき、総メモリの約70%未満に抑えることを推奨しています。
macOSはデフォルトでGPUがワイヤードできるメモリ量を制限します。192GBのマシンでは、ガイドは1つのコマンドでその上限を154GBから180GBに引き上げます:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
新しい128GBミニPCも同じクラスです。NVIDIAはDGX Sparkでllama.cppを実行した場合、gpt-oss-120bで55.37 tokens/sを報告しています。AMDは、VRAMとして96GBを確保したRyzen AI Max+ 395マシンが「最大30トークン/秒」に達すると述べていますが、これは同社自身の数字です。
メモリが足りない?API経由でホステッドのオープンウェイトモデルを使う
それらのマシンが手元にない場合、ホステッドのオープンウェイトモデルはハードウェアの問題を完全に回避します。
Atlas CloudはQwen3.5 122B A10Bを提供しています。これは同社のQwenモデルラインナップの一部です。スペック上はgpt-oss-120bに近いものです。AlibabaのQwenチームによるApache 2.0のMixture-of-Expertsモデルで、総パラメータ数122B、アクティブパラメータ数10Bです。最大262,144トークンのコンテキストを読み取ります。
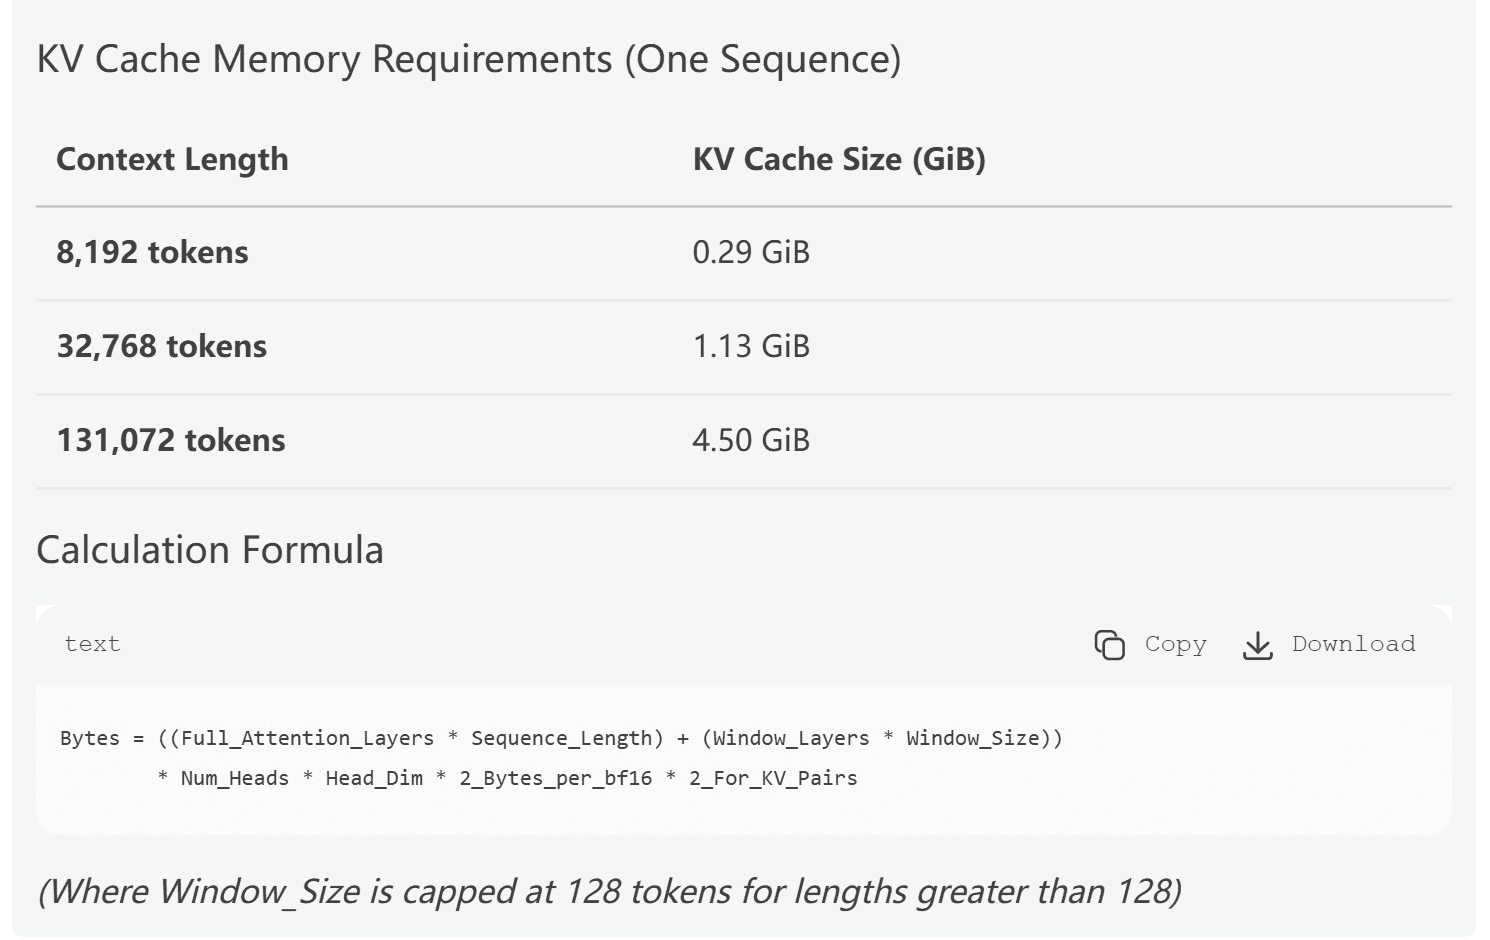
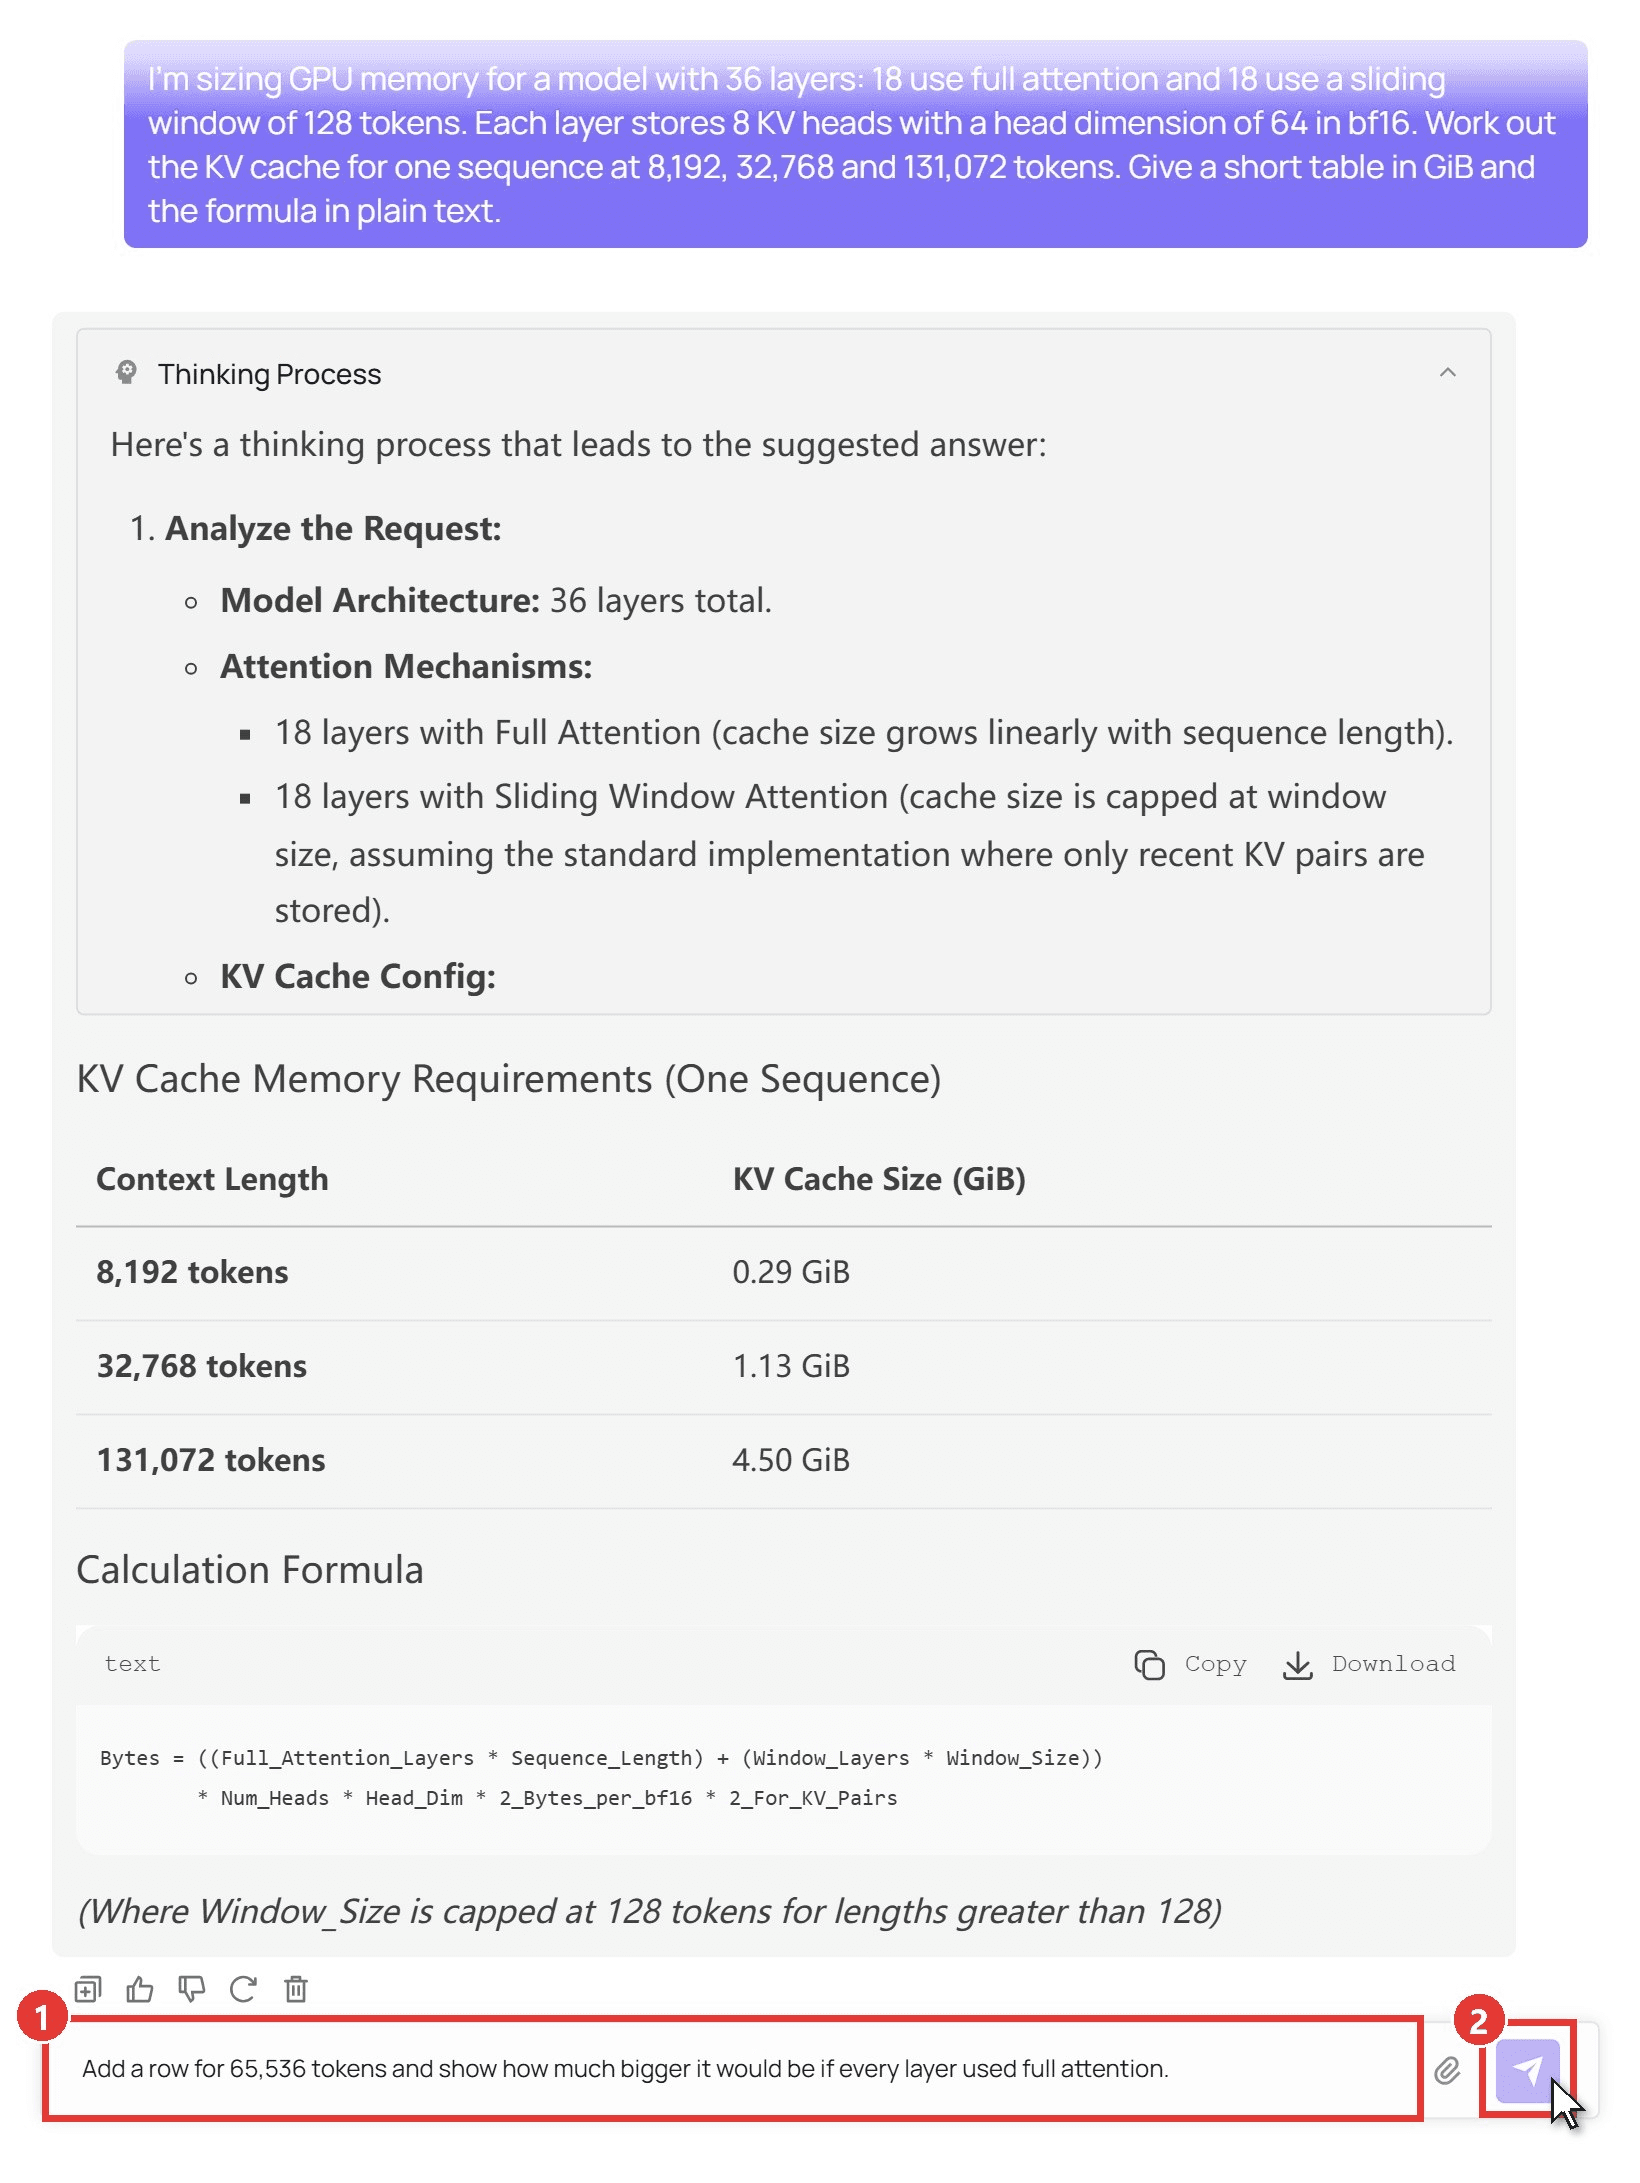
私たちはgpt-ossの設定からアテンションのレイアウトを与え、3つの長さでのKVキャッシュを尋ねました。その表は私たち自身の計算と小数点以下2桁まで一致しました。後で自分のマシン用にQwenが欲しくなったら、ローカルコーディングに最適なQwenモデルに関するガイドでRAM別にサイズを説明しています。
方法1:プレイグラウンドでQwen3.5 122B A10Bを試す
サインインしてQwen3.5 122B A10Bプレイグラウンドを開き、次に:
- メッセージボックスに質問を入力します。
- 送信矢印をクリックします。推論は回答の上のThinking Processパネルに表示されます。
方法2:Atlas Cloud APIでQwen3.5 122B A10Bを呼び出す
スクリプトやアプリの場合:
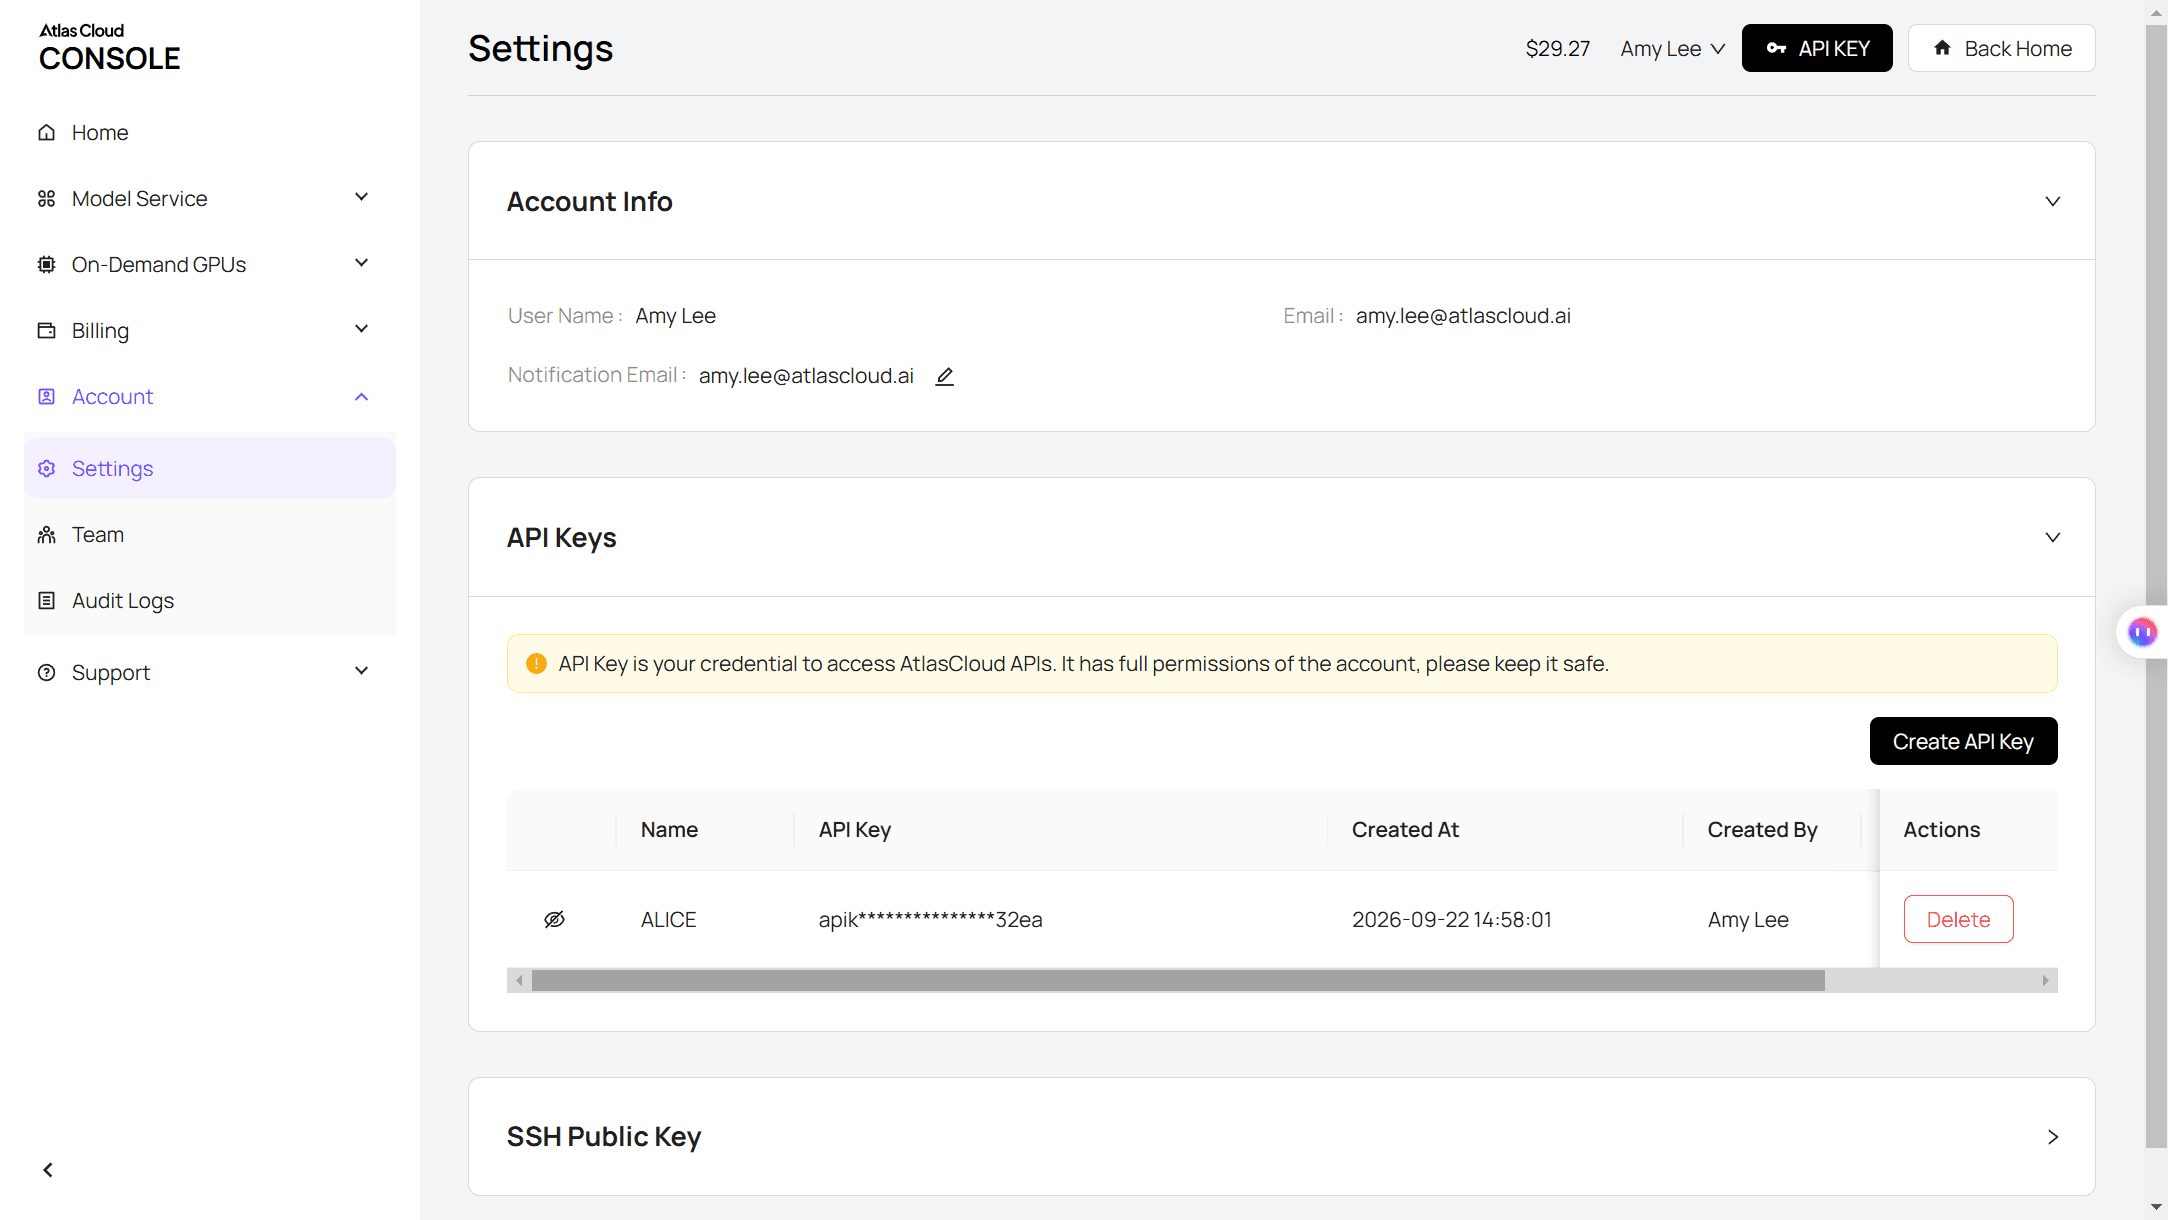
ステップ1:APIキーを作成します。 コンソールで設定を開き、API Keysに移動し、Create API Keyをクリックします。サーバー側に保管してください。
ステップ2:リクエスト形式を確認します。 APIドキュメントではチャット補完形式を説明しており、モデルページにはすぐに使える例が記載されたAPIタブがあります。
ステップ3:最初のリクエストを送信します。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
回答はchoices[0].message.contentで返されます。エンドポイントはOpenAI形式に従っているため、ローカルのgpt-ossサーバー用に書かれたコードは通常、新しいベースURL、キー、モデル文字列のみが必要です。同じキーはプラットフォーム上の他のチャットモデルでも機能します。これは統合LLM APIゲートウェイに関する記事で説明しています。
GPT-OSS-120B vs GPT-OSS-20B:メモリとベンチマークのトレードオフ
小さい方の兄弟は5分の1のメモリで済みます。gpt-oss-20bは20.9Bのパラメータを持ち、アクティブは3.6Bで、OpenAIは「最小16GBのメモリ」で動作すると述べています。問題は何を犠牲にするかです。
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | 8Kコンテキストでのメモリ(llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond(ツールなし) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo(ツールなし) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
スコアは高い推論努力でのモデルカードから来ています。コーディングの差はSWE-Bench Verifiedで2ポイント未満ですが、知識の差は大学院レベルの科学で約9ポイント、HealthBenchで15ポイントです。16GBから24GBのカードで主にコードを扱うなら、20bが賢明な選択です。追加の知識が必要ですか?そこが120bがメモリ代を稼ぐところです。
GGUF、Ollama、vLLM:メモリ予算に合わせたランタイムの選択
それぞれがOpenAIがリリースしたMXFP4の重みを実行しますが、それらの重みをどこに置けるかが異なります。
| ランタイム | ダウンロード | 最適な用途 |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | モデル全体を保持できるマシンでの1ユーザー |
| LM Studio | 65 GB | MacまたはWindows PC上のデスクトップアプリ |
| llama.cpp (ggml-org GGUF) | 約63 GB | VRAMが65GB未満で、エキスパート層をRAMにオフロードする場合 |
| vLLM | 約65 GBのsafetensors | 1つ以上のデータセンターGPUから多数のユーザーにサービス提供 |
大メモリマシンでのクイックスタート:
plaintext1ollama run gpt-oss:120b
小さいGPUの場合、llama.cppを使用し、オフロード数を調整します:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
4つすべてがOpenAIのハーモニーチャット形式を処理し、モデルが正しく動作するために必要です。これは独自のサービングコードを書く場合にのみ重要です。
FAQ
GPT-OSS-120BはGPT-5やGemini 3 Proより優れていますか?
それらは異なるカテゴリに属します。GPT-5とGeminiはアプリやAPIを通じてアクセスするクローズドモデルである一方、gpt-oss-120bは自分のハードウェア上で動作します。また、Gemini 3 Pro Previewは2026年3月9日にシャットダウンされ、その名前は現在Gemini 3.1 Pro Previewを指しています。ローカル制御が重要なら、GoogleのオープンウェイトラインはGemma 4ファミリーです。
なぜ一部のサイトはGPT-OSS-120Bが255 GB必要と言うのですか?
それらの数字は16ビットの重みを想定しています。約117Bパラメータ×2バイト、さらにオーバーヘッドです。OpenAIが公開しているチェックポイントはすでにMXFP4なので、現実的なダウンロードサイズは61 GB程度です。
推論努力はメモリ使用量を変えますか?
重みには影響しません。低、中、高の設定はモデルが考える長さを変えます。高い努力はより多くの推論トークンを書き込み、それがコンテキストウィンドウを埋め、KVキャッシュを成長させるので、長いセッションは上のチャートのより大きな合計に近づきます。
なぜ人々はGPT-OSS-120Bがテキストベースのゲームで苦戦すると言うのですか?
証拠は逸話的です。モデルのHugging Faceディスカッションページでは、暴力的なフィクションを書く際に拒否されると報告するユーザーもいれば、ロールプレイは問題なく動作すると言うユーザーもいます。インタラクティブフィクションについては、そのためにハードウェアを購入する前に自分のプロンプトをテストしてください。
ホステッドの120Bクラスモデルはいくらかかりますか?
2026年10月現在、Atlas CloudでのQwen3.5 122B A10Bは、入力トークン100万あたり$0.3、出力トークン100万あたり$2.4です。これは通常料金の$0.4と$3.2から25%の割引です。私たちのサイジングの質問は、推論をカウントすると約5,000出力トークンを使用し、割引料金でおよそ1セントでした。
結論
GPT-OSS-120Bは、そのパラメータ数が示唆するよりはるかに収まりが良いです。日常的なコンテキスト長では約65 GB、最大131Kでは70 GB未満を計画してください。80GBのGPU1基、96GBを超えるMac、または128GBのミニPCがそれを保持でき、より小さなカードでもエキスパート層をシステムRAMに移動することで実行できます。
それらの数字で自分のマシンが除外される場合は、主にコーディング作業ならgpt-oss-20bに下げるか、ハードウェアを購入せずにより大きな脳が必要な場合はホステッドのオープンウェイトモデルを呼び出してください。いずれにせよ、gpt oss 120bのメモリ要件は、重みが61 GBを占め、残りがヘッドルームであることを知れば、推測ゲームではなくなります。


