Kod wygląda na gotowy. Potem testy nie przechodzą, poprawka zmienia interfejs, a kolejne zlecenie zaczyna być realizowane. Wybór najlepszego API AI do kodowania oznacza znalezienie modelu i punktu końcowego, które wykonają twoją pracę w akceptowalnym budżecie.
Zacznij od Claude, GPT lub Gemini jako kandydatów referencyjnych. Porównaj DeepSeek, Qwen i Kimi na tych samych zadaniach, jeśli chcesz alternatywnych opcji wdrożenia i wydatków. Przy debugowaniu stawiaj na testy regresji. Przy refaktoryzacji sprawdź diff. Przy agencie kodującym zweryfikuj całą pętlę narzędziową, zanim porównasz ceny tokenów.
Frustracja jest wymierna. W ankiecie Stack Overflow Developer Survey z 2025 r. 66% respondentów pytanych o frustracje zgłosiło prawie poprawne rozwiązania AI; 45% zgłosiło spędzanie więcej czasu na debugowaniu wygenerowanego kodu. To odpowiedzi z ankiety, a nie ocena modeli z 2026 r. (Stack Overflow Developer Survey, 2025)
Najważniejsze wnioski
- Wybieraj API i agenta osobno.
- Twórz listę kandydatów według zadania i wymaganych funkcji punktu końcowego.
- Zapisuj pierwsze odpowiedzi i oceniaj je względem ustalonych testów akceptacyjnych.
- Uwzględnij nieudane próby i poprawki w kalkulacji kosztów.
Ten przewodnik zawiera listę kandydatów, trzy gotowe do skopiowania zadania ewaluacyjne oraz arkusz kosztów. Badania sprawdzono 21 września 2026 r. Dostępność modeli, udokumentowane możliwości i zmierzone wyniki są w całym tekście odrębnymi kategoriami dowodów.
Najlepsze API AI do kodowania: lista kandydatów
Zacznij od dwóch kandydatów: jednego, który pasuje do twojej istniejącej aplikacji, i jednej alternatywy. Użyj tych sześciu rodzin, aby zbudować tę wstępną parę.
Tabela proponuje testy, nie twierdząc, że istnieje porównywalna wydajność. Dostęp zależy od twojego konta, regionu, limitu i punktu końcowego; wpis w dokumentacji nie potwierdza, że twoje poświadczenia mogą go wywołać.
| Konkretny model i ID | Ścieżka dostępu | Zadanie warte oceny | Główna granica decyzyjna | Dowód z punktu końcowego | Sprawdzenie ceny |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Ograniczone zmiany w wielu plikach | Zweryfikuj kontrolki klienta i rozumowania | Przegląd modeli Claude Platform; dostęp do konta niesprawdzony | Brak podanej stawki |
GPT-6 Astra, gpt-6-astra | OpenAI API | Zadania kodowania z wieloma warunkami | Zweryfikuj trasę i narzędzia | Dokumentacja modeli OpenAI; dostęp do konta niesprawdzony | Brak podanej stawki |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Interaktywne generowanie i przegląd | Zweryfikuj opóźnienie i protokół | Katalog modeli Google AI; dostęp do konta niesprawdzony | Brak podanej stawki |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Trasa modelu Atlas Cloud | Poprawki numeryczne; eksperymenty z kontekstem | Trzymaj wersję 0813 osobno | Zweryfikowano dokładną stronę modelu; funkcje środowiska uruchomieniowego niesprawdzone | 21 września 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Trasa modelu Atlas Cloud | Refaktoryzacje; samodzielne interfejsy | Określona wersja; nie najnowsza | Zweryfikowano dokładną stronę modelu; funkcje środowiska uruchomieniowego niesprawdzone | 21 września 2026 |
Kimi K3, moonshotai/kimi-k3 | Trasa modelu Atlas Cloud | Te same trzy zadania; interfejs CSV | Zweryfikuj limity wyjścia i ukończenia | Zweryfikowano dokładną stronę modelu; funkcje środowiska uruchomieniowego niesprawdzone | 21 września 2026 |
Claude, GPT i Gemini dostarczają użytecznych kandydatów referencyjnych. Ich oficjalne katalogi modeli wskazują powyższe wersje. Użyj dostawcy, którego już znasz, jako punktu odniesienia, a następnie sprawdź, czy alternatywa zmniejsza koszt akceptowanego zadania lub pracę integracyjną. Nie traktuj zachowania asystenta konsumenckiego jako wyniku odpowiadającego API.
Katalog modeli OpenAI wymienia GPT-6 Astra obok rodziny GPT-5.6. To ustanawia aktualnego kandydata, a nie zwycięstwo w kodowaniu nad pozostałymi wierszami. Tabela celowo unika przenoszenia starych identyfikatorów modeli ze stron porównawczych bez daty. (Katalog modeli OpenAI, dostęp wrzesień 2026)
DeepSeek zasługuje na miejsce jako odrębna rodzina modeli do zbadania. Sprawdź, czy naprawia konkretny błąd bez rozszerzania zmiany. Wybierz innego kandydata, jeśli wdrożona trasa nie może spełnić wymaganego formatu odpowiedzi, zachowania narzędzi lub górnego limitu opóźnienia, niezależnie od ogólnej reputacji modelu.
Oceniaj Qwen według wersji. Wymienione wdrożenie 122B A10B dostarcza konkretnego punktu odniesienia cenowego. Przeprowadź testy parsowania i przeglądarki przed wyciągnięciem wniosku o wartości. Liczby dotyczące kontekstu z innych wydań Qwen nie mogą być przypisane do tego modelu.
Kimi to kandydat do gotowej konfiguracji. Jego publiczna strona wskazuje ID modelu. Przegląd konfiguracji jest możliwy; udane generowanie pozostaje niesprawdzone. Oceń jego ukończone wyjście względem tych samych ograniczeń co innych kandydatów.
Atlas Cloud znajduje się w tej porównaniu na warstwie dostępu. Nie jest siódmym modelem. Jego znaczenie jest praktyczne: możesz przejrzeć kilka stron modeli kandydujących i porównać ich wymagania integracyjne, zanim zobowiążesz się do workflow.
W przypadku otwartych wag zweryfikuj dokładną licencję wydania i artefakt wdrożeniowy. Hostowana inferencja ma odrębne warunki usługi i koszty operacyjne; sama rodzina modeli nie może ich ustalić.
API kodowania, modele i agenci — wyjaśnienie
Model generuje treść w odpowiedzi na dane wejściowe. API definiuje, jak twoja aplikacja wysyła te dane wejściowe i odbiera wynik. Agent kodujący organizuje pracę wokół tego: odczytuje pliki, wywołuje narzędzia, stosuje zmiany, uruchamia testy i decyduje, czy kontynuować.
Te trzy warstwy mogą zawieść niezależnie. Model może zaproponować poprawną łatkę, a agent zapisze ją do niewłaściwego pliku. API może zwrócić poprawny JSON, a aplikacja zignoruje wywołanie narzędzia. Zdolny agent może utknąć, ponieważ wybrany punkt końcowy odrzuca parametr.
Załóżmy, że wysyłasz handler i prosisz o parser identyfikatora. Podstawowe API generowania kodu zwraca tekst zawierający kod. Twój program nadal musi wyodrębnić ten kod, umieścić go w odpowiednim obszarze roboczym i uruchomić testy. Udana odpowiedź HTTP potwierdza dostarczenie, a nie poprawność.
Agent może zautomatyzować te kroki tylko wtedy, gdy dostarczysz narzędzia i uprawnienia. Potrzebuje też warunku zatrzymania. Bez niego może wielokrotnie edytować już akceptowalną funkcję, rozszerzać zadanie lub zużywać dodatkowe żądania, próbując poprawić nieistotny szczegół.
Utrzymuj trzy odrębne pozycje budżetowe:
- Subskrypcja narzędzia: aplikacja, integracja z edytorem lub usługa agenta, której używasz.
- Użycie inferencji: żądania do wybranego punktu końcowego modelu, zgodnie z jego warunkami rozliczeń.
- Środowisko wykonawcze: kontenery, programy uruchamiające testy, przechowywanie i inna infrastruktura.
Niektóre produkty łączą części tego stosu. Inne oczekują, że dostarczysz osobne poświadczenia. Sprawdź konkretny plan, zanim założysz, że subskrypcja edytora obejmuje dowolny ruch API z twojej własnej aplikacji.
Zgodność protokołu również ma granicę. Usługa, która akceptuje znaną tablicę messages, może nadal udostępniać inne zachowanie narzędzi, zdarzenia strumieniowania, limity kontekstu lub kontrolki rozumowania. Skopiowanie bazowego adresu URL nie może potwierdzić obsługi każdej funkcji w ekosystemie innego dostawcy.
Zmapuj aplikację, agenta, punkt końcowy, model, narzędzia i testy. Zidentyfikuj rozliczany komponent i odpowiedzialnego operatora na każdym etapie przed zmianą modeli.
Najlepsze API AI do kodowania: 7 kontroli wyboru
1. Poprawność funkcjonalna i zachowanie regresji. Napisz oczekiwane wyniki przed poproszeniem o kod. Funkcja ceny, która obsługuje zwykłe liczby całkowite, ale akceptuje null jako zero, narusza kontrakt. Uruchom zarówno nowe przypadki brzegowe, jak i istniejące testy projektu; przejście jednego nowego testu może ukryć zepsutego wywołującego w innym miejscu.
2. Zakres zmiany. Porównaj łatkę z żądaniem. Wyodrębnienie parsera identyfikatora powinno zachować URL, odpowiedź sukcesu i odpowiedź błędu. Niezamówiona migracja frameworka dodaje pracę przeglądową, nawet gdy zamiennik się kompiluje. Zdecyduj z góry, czy niepowiązane zmiany dyskwalifikują odpowiedź, czy wymagają poprawki.
3. Użyteczny kontekst i miejsce na wyjście. Twoje żądanie zawiera instrukcje, istotne pliki, definicje narzędzi i wcześniejszą rozmowę. Zarezerwuj też wystarczająco dużo miejsca na odpowiedź. Duże reklamowane okno kontekstu nie potwierdza, że model znajdzie istotny niezmiennik, ani że twój punkt końcowy akceptuje takie samo maksimum.
Przetestuj jakość kontekstu za pomocą zależności, która ma znaczenie. Uwzględnij wywołującego, którego interfejs musi pozostać stabilny, i sprawdź, czy model to respektuje. Zmierz obcinanie osobno: odpowiedzi kończącej się w połowie funkcji nie można zaakceptować tylko dlatego, że jej początkowe linie wyglądały obiecująco.
4. Wywoływanie narzędzi i wyjście strukturalne. Zweryfikuj wdrożoną trasę za pomocą rzeczywistego schematu narzędzi. Sprawdź typy argumentów, brakujące pola, identyfikatory narzędzi i odpowiedź następczą po wyniku narzędzia. Model, który zapisuje wiarygodny obiekt JSON, niekoniecznie ukończył natywną pełną rundę wywołania narzędzia.
5. Czas do zaakceptowanego wyniku. Zapisz czas trwania całej próby, w tym poprawki i testy. W przypadku asystenta interaktywnego liczy się też czas do pierwszego widocznego tekstu, ale nie może on zastąpić czasu ukończenia. Szybki pierwszy token, po którym następuje długa bezużyteczna odpowiedź, nadal blokuje dewelopera.
6. Opłaty za wejście, wyjście, pamięć podręczną i ponowienia. Przeczytaj kategorie rozliczeń, które faktycznie raportuje wybrany punkt końcowy. Oddziel odczyty pamięci podręcznej od zwykłego wejścia, gdy ma to zastosowanie. Śledź nieudane żądania i przerwane pętle. Jeśli dostawca nie udostępnia potrzebnego szczegółu, wyraźnie oznacz brakujące założenia w oszacowaniu.
7. Warunki integracji i obsługi kodu. Potwierdź, że twój edytor lub aplikacja obsługuje trasę, metodę uwierzytelniania i format błędów. Przejrzyj aktualne warunki obsługi danych dostawcy przed wysłaniem prywatnego kodu źródłowego. Otwarte wagi opisują wybór dystrybucji modelu; nie ustalają, jak hostowana usługa traktuje twoje żądania.
Publiczne benchmarki mogą pomóc w wyborze kandydatów, pod warunkiem że przeczytasz ich warunki. SWE-bench Verified zawiera 500 instancji filtrowanych przez ludzi. Jego aktualna strona opisuje także widok Bash Only korzystający z tego samego środowiska mini-SWE-agent. Te szczegóły pomagają wyjaśnić, co jest porównywane. (SWE-bench, dostęp wrzesień 2026)
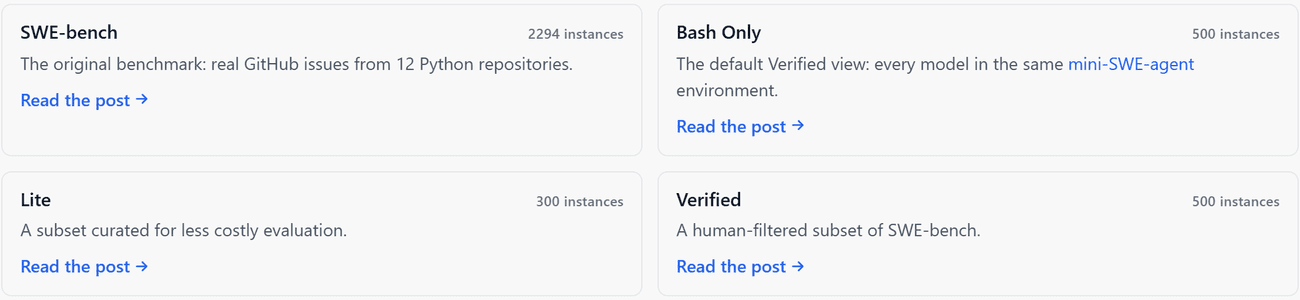 Strona SWE-bench pokazująca rozmiar zbioru danych Verified i wspólne środowisko agenta
Źródło dowodowe: rzeczywista strona benchmarku, zrzut z 21 września 2026 r. Zbiór danych i warunki wykonania należą obok każdego twierdzenia o wydajności.
Wyniki benchmarków opisują konkretną konfigurację. Twój język, reguły biznesowe, uprawnienia i standardy przeglądu mogą się różnić. Ostateczną decyzję podejmuj na podstawie pracy, którą możesz sprawdzić.
Najlepsze API AI do kodowania: uruchom trzy praktyczne testy
Te trzy powtarzalne przykłady ewaluacji ujawniają różne tryby awarii. Ustal ich reguły akceptacji przed poproszeniem o wynik. Oceniaj funkcję lub stronę względem jej kontraktu, niezależnie od jakości wyjaśnienia.
Dla DeepSeek V4 Pro, Qwen3.5 122B A10B i Kimi K3 zamierzonym protokołem są trzy niezależne przebiegi na zadanie. To oznacza 27 początkowych prób. Zezwól na co najwyżej jedną poprawkę na podstawie informacji zwrotnej na próbę, zachowaj pierwszą odpowiedź i raportuj wyniki początkowe i poprawione osobno.
Żądaj temperatury zero tylko tam, gdzie jest obsługiwana, zapisując faktycznie zaakceptowane ustawienie. Użyj żądanego górnego limitu wyjścia 4096 tokenów dla A i B oraz 8192 dla C po sprawdzeniu limitów punktu końcowego. Wartości domyślne i nieobsługiwane kontrolki należy zapisać. Niska temperatura nie gwarantuje identycznych odpowiedzi.
Status dowodów: dostęp do środowiska testowego był zablokowany przez ekran logowania Cloudflare Access. 27 prób kandydatów nie mogło zostać wykonanych. Poniższe dowody pokazują lokalnie wykonany oryginalny kod i przygotowany na potrzeby artykułu wzorzec referencyjny CSV, a nie wyniki modeli kandydujących. Wskaźniki przejścia modeli, użycie tokenów i koszty zadań pozostają niezmierzone.
Zadanie A: napraw wybór ceny numerycznej. Wklej ten dokładny prompt do świeżej sesji:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Ustalonymi danymi wejściowymi akceptacji są [2,10,3], ["12","3"], pusta tablica, wyłącznie nieprawidłowe wartości, zero, liczby ujemne i ciągi zawierające wyłącznie białe znaki. Odrzuć puste ciągi po przycięciu. Sprawdź, czy oryginalna tablica ma dokładnie te same elementy w tej samej kolejności po wywołaniu.
Oryginał używa domyślnego sortowania JavaScriptu i modyfikuje swoje dane wejściowe. Zadanie sprawdza więc dwa odrębne obowiązki: wybranie poprawnego minimum numerycznego i uniknięcie zmiany danych wywołującego. Przetestuj reguły konwersji jawnie, ponieważ krótkie rozwiązanie oparte na koercji może przypadkowo zaakceptować wartości logiczne lub null.
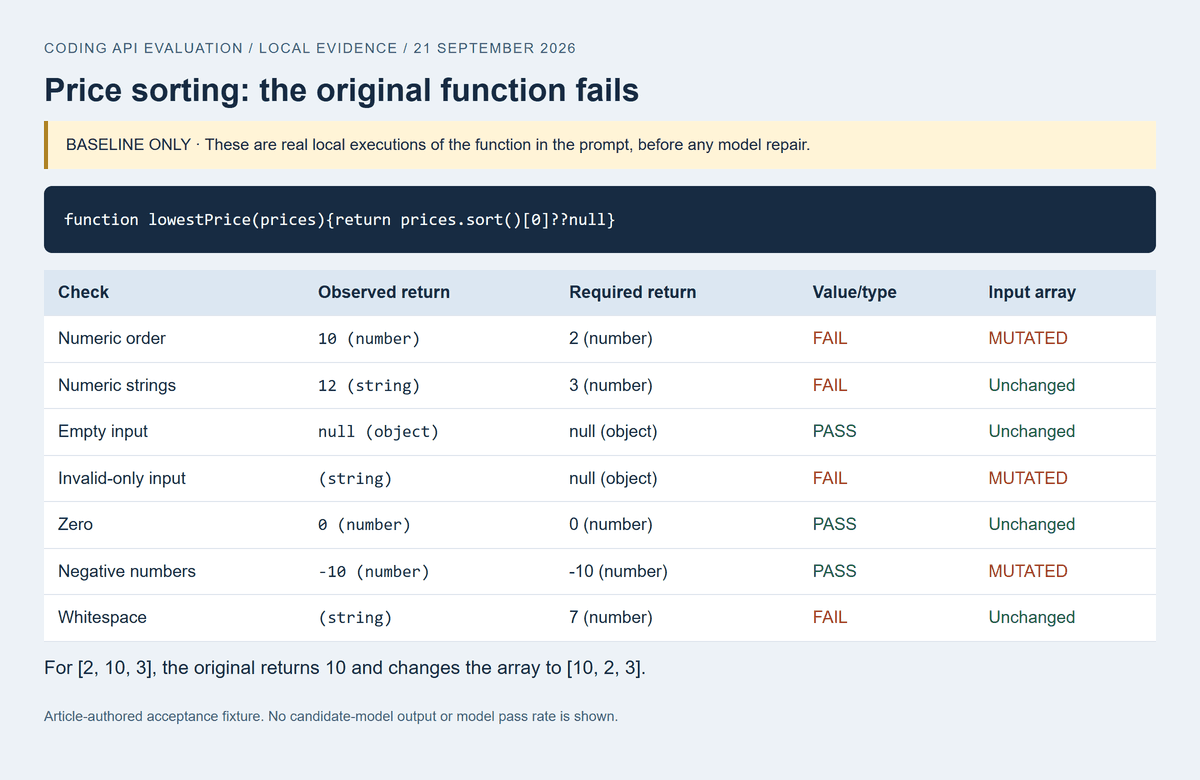 Lokalne wykonanie oryginalnej funkcji ceny pokazujące niepoprawne sortowanie numeryczne i zmodyfikowane dane wejściowe
Wykonany punkt odniesienia: oryginalna funkcja zwraca 10 dla [2,10,3] i zmienia tablicę na [10,2,3]. Ciągi numeryczne również nie spełniają kontraktu wartości zwracanej. Nie pokazano żadnej poprawki modelu.
Zadanie B: zachowaj interfejs podczas małej refaktoryzacji. Użyj tego promptu bez zmian:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Zaakceptuj "12" i "0012" jako 12. Odrzuć "1e2", "1.0", liczby ujemne, zero, białe znaki, dane wejściowe niebędące ciągami i wartości przekraczające zakres bezpiecznych liczb całkowitych JavaScriptu. Zweryfikuj zarejestrowaną ścieżkę i oba ciała odpowiedzi. Nieprawidłowe dane wejściowe nie mogą dotrzeć do findUser.
To zadanie sprawdza, czy model rozumie różnicę między konwersją numeryczną a określoną gramatyką ciągów. Sprawdź diff pod kątem niepowiązanych zmian, a następnie wywołaj handler z zaślepionymi obiektami żądania i odpowiedzi. Poprawny pomocnik połączony z niezmienionym, permisywnym handlerem nadal nie przechodzi.
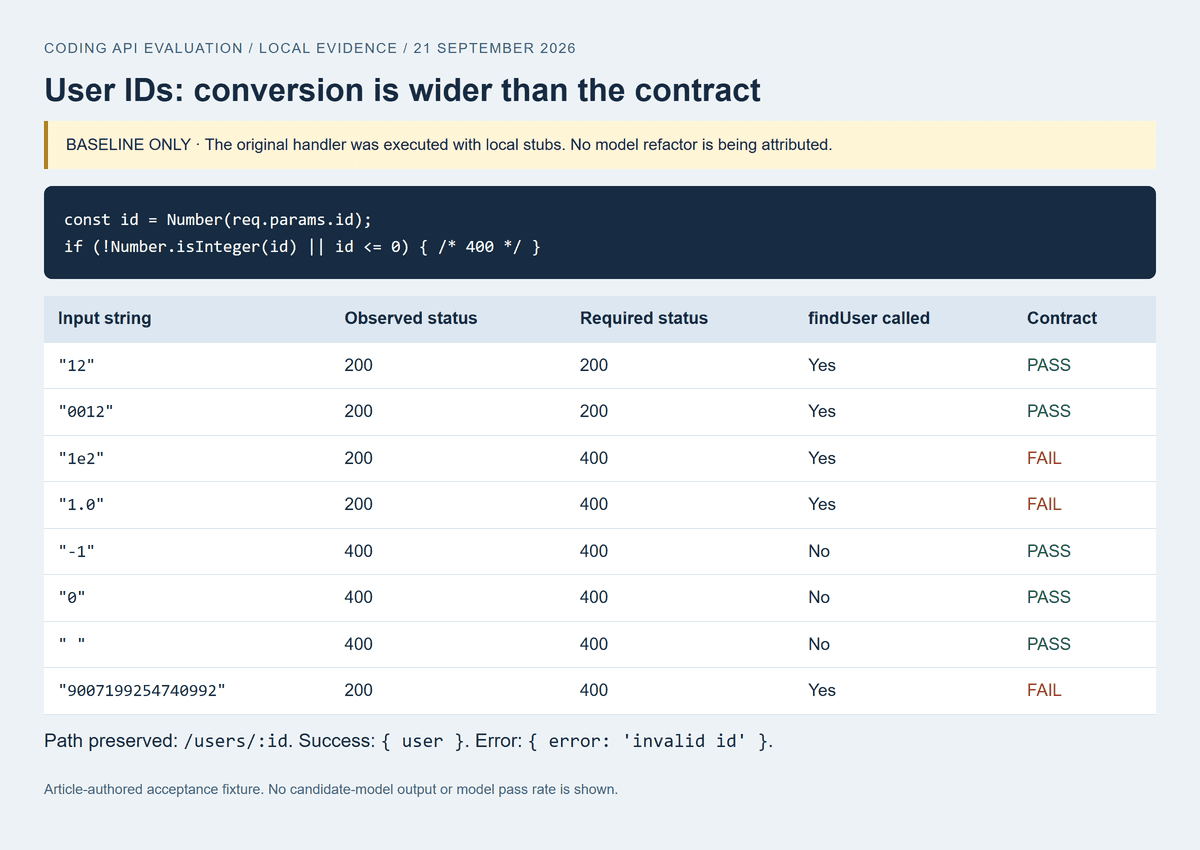 Log testu oryginalnego handlera pokazujący nieprawidłowe ciągi numeryczne akceptowane ze statusem 200
Wykonany punkt odniesienia: oryginalny handler zwraca 200 dla "1e2", "1.0" i "9007199254740992", mimo wymaganej odpowiedzi 400. Lokalne zaślepki zarejestrowały wywołania; to nie jest refaktoryzacja wygenerowana przez model.
Zadanie C: zbuduj podgląd CSV, którym możesz operować. Prześlij:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Przetestuj za pomocą tych dokładnych rekordów, najpierw używając LF, a potem CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Oczekuj dwóch kolumn, trzech wierszy danych, przecinka Alice w jednej komórce i poprawnie wyświetlonego znaku ucieczki cudzysłowu Boba. Wartość Eve musi pojawić się jako dosłowny tekst, bez elementu obrazu, wykonania zdarzenia lub żądania sieciowego. Dodaj wiersz z trzema polami i potwierdź, że strona widocznie zgłasza niezgodność.
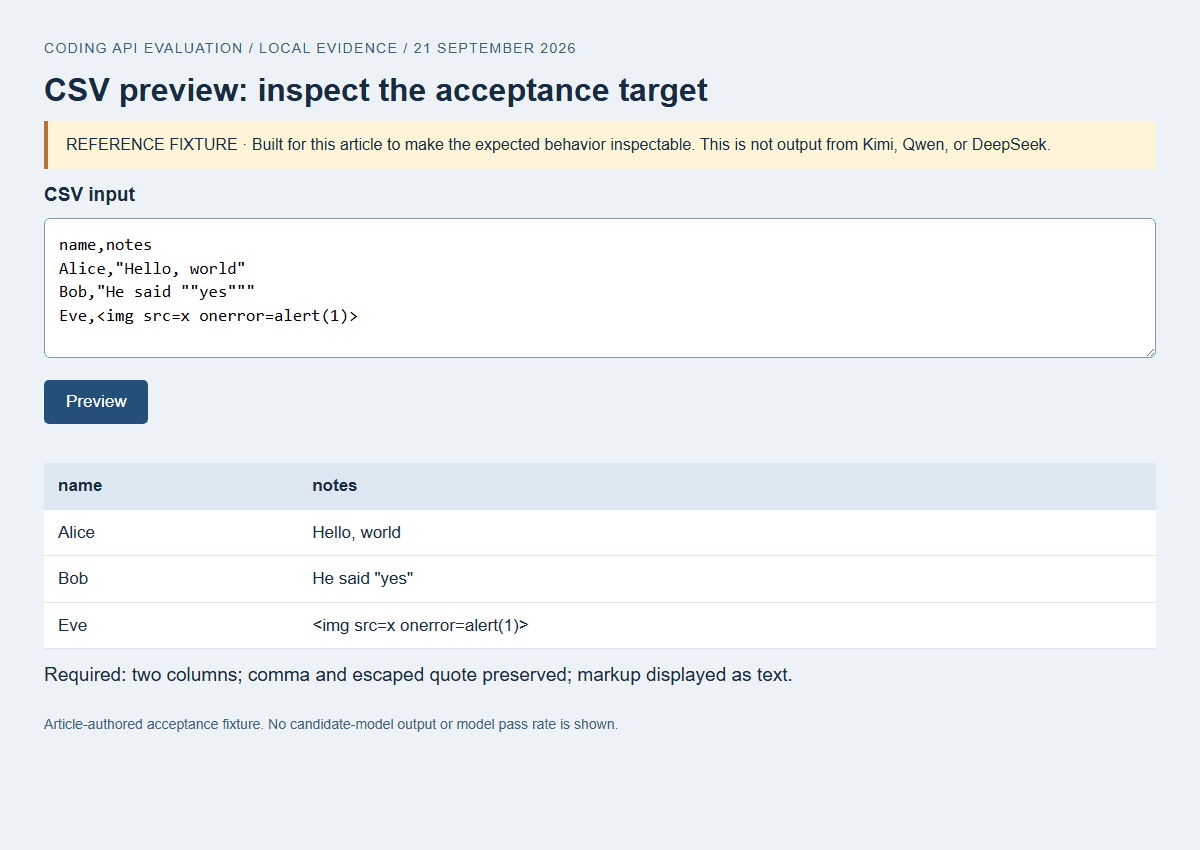 Wzorzec akceptacji CSV pokazujący wartości w cudzysłowach i wymagania dotyczące dosłownego znacznika
Wzorzec referencyjny operowany, zbudowany na potrzeby tego artykułu, nie wygenerowany przez model kandydujący. Testy w przeglądarce zweryfikowały parsowanie LF/CRLF, znaki ucieczki cudzysłowów, dosłowny znacznik, widoczne błędy liczby pól i brak żądań HTTP. Zrzut ekranu pokazuje stan prawidłowych danych wejściowych po kliknięciu Preview.
Zapisuj surowe wyjście, logi, ID modelu, datę, parametry, czasy, poprawki i ręczne edycje. Wysyłaj nieudane asercje do poprawki bez zmiany oczekiwanych wyników. Zachowuj odmowy, obcięcia i błędy obok sukcesów.
Najlepsze API AI do kodowania w budżecie
Porównaj stawki za tokeny obok jakości ukończenia i użycia. Powtarzane dane wejściowe mogą dominować w kosztach przeglądu kodu; generowanie całych plików może zwiększać opłaty za wyjście. Powtarzane poprawki dodają jedno i drugie.
Katalog Atlas i dokładne strony szczegółów pokazały 21 września 2026 r. następujące stawki w USD za milion tokenów:
- DeepSeek V4 Pro: 1,68 USD za wejście i 3,38 USD za wyjście. Odrębny wpis V4 Pro 0813 używa innych stawek; nie zastępuj go.
- Qwen3.5 122B A10B: 0,30 USD za wejście i 2,40 USD za wyjście. Katalog wyświetlał regularne stawki 0,40 USD i 3,20 USD z 25% zniżką, według stanu na wrzesień 2026 r.
- Kimi K3: 3,00 USD za wejście i 15,00 USD za wyjście.
To wyświetlane stawki produkcyjne, a nie faktury z ewaluacji w artykule. Stawki specyficzne dla pamięci podręcznej i ich zastosowanie nie zostały potwierdzone. Rabaty promocyjne dla DeepSeek i Kimi nie zostały potwierdzone. Brak obserwacji rabatu nie dowodzi, że żadna oferta nie istnieje.
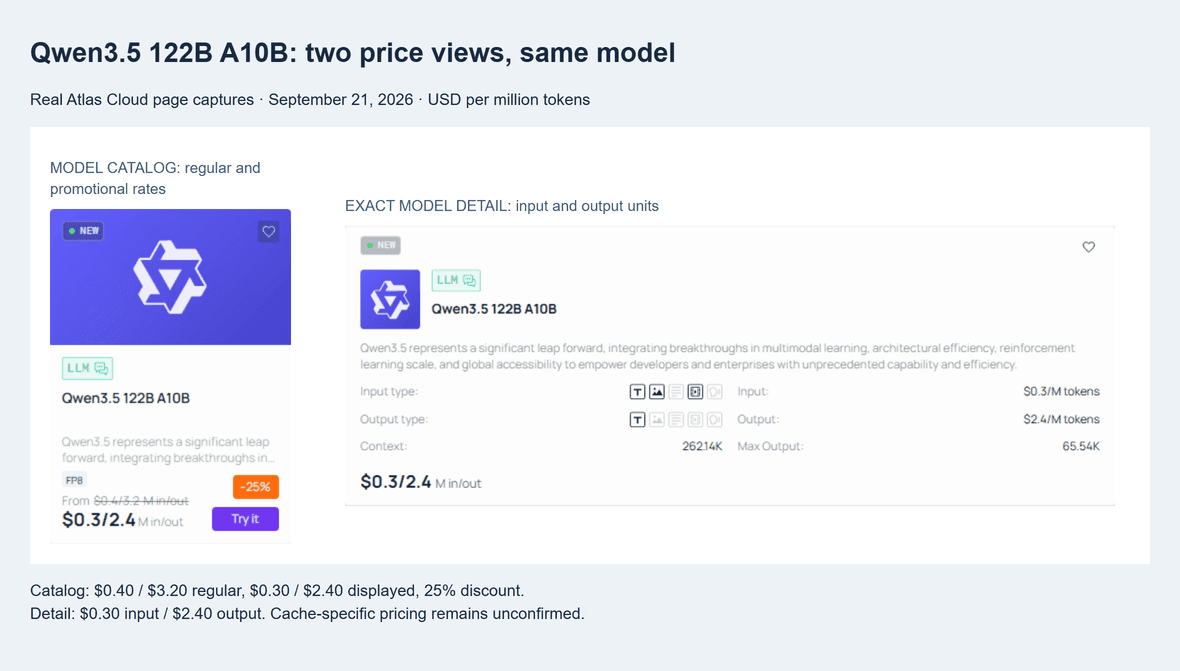 Zniżka w katalogu Qwen3.5 122B A10B obok dokładnych stawek wejścia i wyjścia na stronie szczegółów modelu
Kontrola krzyżowa cen Qwen, 21 września 2026 r.: katalog pokazuje 25% promocję; dokładna strona szczegółów modelu potwierdza 0,30 USD za wejście i 2,40 USD za wyjście za milion tokenów. Stawki specyficzne dla pamięci podręcznej pozostają niepotwierdzone.
Oblicz część modelową zadania jako:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Nie naliczaj ponownie opłat za tokeny z pamięci podręcznej jako zwykłego wejścia, jeśli rekord rozliczeniowy traktuje je osobno. Sprawdź, czy użycie rozumowania jest wliczone w rozliczane wyjście. Jeśli żadne zadanie nie przejdzie, zgłoś „brak udanego wyniku”; dzielenie przez zero lub wyświetlanie zerowego kosztu ukończenia wprowadzałoby czytelnika w błąd.
Dla przejrzystego przykładu arytmetycznego załóż 10 000 zwykłych tokenów wejściowych i 2000 tokenów wyjściowych przy wyświetlanych stawkach Qwen. Szacowana opłata za model wynosi 0,0078 USD, przed wszelkimi innymi mającymi zastosowanie pozycjami. To hipotetyczne żądanie, a nie zaobserwowane użycie tokenów lub rzeczywisty rachunek.
Jedna równie duża poprawka podniosłaby oszacowanie do 0,0156 USD. Rzeczywiste poprawki obejmują inny kontekst i wyjście, więc obliczaj każde żądanie na podstawie jego zapisanego użycia.
| Zadanie | Model | Pierwsze przejście | Po poprawce | Użycie tokenów | Źródło kosztu | Całkowita opłata | Całkowity czas | Ręczne zmiany |
|---|---|---|---|---|---|---|---|---|
| A, B, C; po 3 powtórzenia planowane | DeepSeek V4 Pro | Niezmierzone | Niezmierzone | Niezapisane | Brak rekordu użycia | Nieznana | Niezmierzony | Brak ocenianych |
| A, B, C; po 3 powtórzenia planowane | Qwen3.5 122B A10B | Niezmierzone | Niezmierzone | Niezapisane | Brak rekordu użycia | Nieznana | Niezmierzony | Brak ocenianych |
| A, B, C; po 3 powtórzenia planowane | Kimi K3 | Niezmierzone | Niezmierzone | Niezapisane | Brak rekordu użycia | Nieznana | Niezmierzony | Brak ocenianych |
W swoim własnym arkuszu rozwiń każdy wiersz na jeden wiersz na model i powtórzenie. Policz naprawiony sukces raz w mianowniku zaakceptowanych zadań. Uwzględnij nieudane próby w liczniku i zachowaj osobne kolumny pierwszego przejścia i końcowej akceptacji.
Śledź przegląd ludzki i infrastrukturę osobno. Rozplątanie niepotrzebnego przepisania może zniweczyć oszczędność na inferencji. Porównaj kandydatów, którzy spełniają zarówno wymagania akceptacji, jak i twój budżet czasu przeglądu.
Najlepsze API AI do kodowania z Atlas Cloud
Zacznij od strony modelu Kimi K3, potwierdź ID i przejrzyj widoki API i Code. Trzymaj wybraną wersję obok rekordu testu.
Przeczytaj dokumentację protokołu LLM, zanim uznasz dwie trasy za wymienne. Wskazuje ona Chat Completions jako trasę o szerokim zasięgu i kieruje użytkowników do supported_apis każdego modelu. Kontrolki próbkowania i funkcje narzędzi również zależą od reklamowanego wsparcia modelu.
Są tu konkretne szczegóły integracji warte sprawdzenia. Dokumentacja mówi, że tłumaczone żądania Anthropic nie stosują cache_control, a narzędzia hostowane przez dostawcę są niedostępne na tej tłumaczonej trasie. Te ograniczenia mają znaczenie, jeśli twój istniejący agent zakłada natywne buforowanie lub hostowane narzędzie przeglądania. Dopasuj klienta do rzeczywistej trasy.
Poniższy przykład w Node.js ilustruje jedno żądanie tekstowe. Używa wbudowanego fetch, zmiennej środowiskowej na poświadczenia i zweryfikowanego ID modelu Kimi. Zapisz dokładny prompt zadania A jako task-a.txt. Ustaw zmienną środowiskową bazowego adresu URL na bazowy adres API Atlas pokazany w jego dokumentacji, kończący się na /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages przenosi zadanie; model wybiera wdrożenie; max_tokens żąda górnego limitu wyjścia. Czytnik odpowiedzi sprawdza zwykły ukończony tekst przed zwróceniem kodu. Limit czasu ogranicza oczekiwanie w tym przykładzie; nie potwierdza, że serwer zaprzestał przetwarzania lub że nie naliczono opłaty.
Temperatura jest pominięta, ponieważ wsparcie dla poszczególnych modeli i zatwierdzone zachowanie wymagają weryfikacji. Przykład nie ponawia automatycznie. Przejrzyj klasę awarii przed dodaniem ograniczonej polityki ponowień i nigdy nie loguj nagłówka autoryzacji. Ten kod publikacyjny nie został wykonany z kluczem API podczas produkcji artykułu.
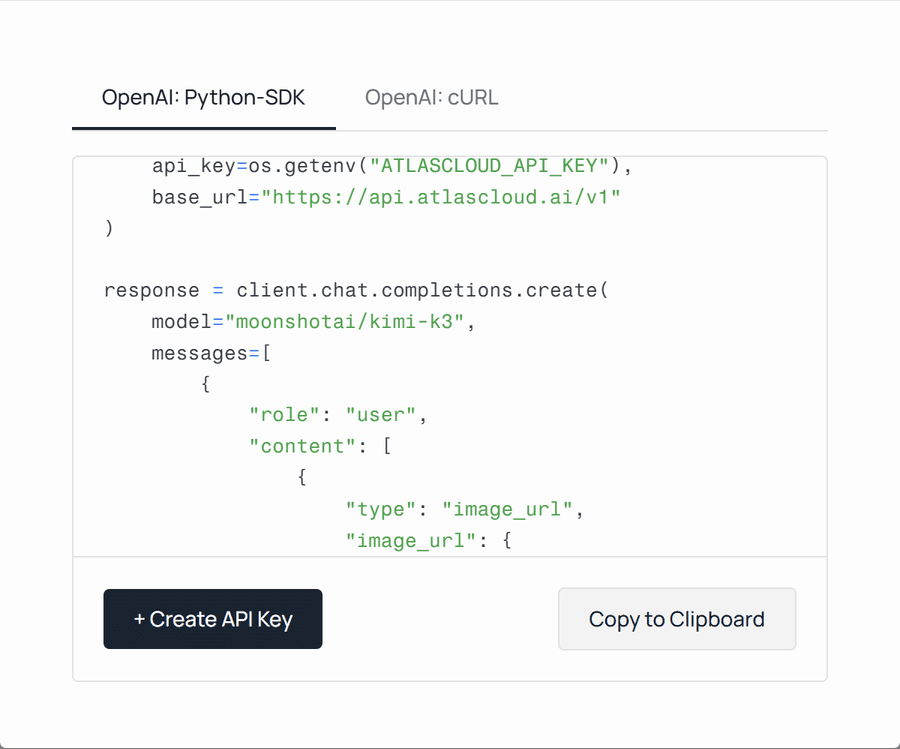 Publiczny przykład kodu API Kimi K3 pokazujący punkt końcowy Atlas i identyfikator modelu
Publiczne okno dialogowe Code Kimi K3, zrzut z 21 września 2026 r. To dowód konfiguracji, a nie ukończony przebieg kodowania. Przykład na stronie zawiera wejście multimedialne; przykład w artykule używa tylko tekstu.
Uruchom testy akceptacji zadania A na każdej zwróconej funkcji. Przed przejściem na DeepSeek lub Qwen zweryfikuj jego protokół i parametry. Utrzymuj prompty i testy bez zmian podczas porównywania wyjścia i użycia; wspólny kształt żądania nie potwierdza identycznego zachowania.
Zanim użyjesz API kodowania w produkcji
Uruchom wygenerowany kod najpierw w jednorazowej gałęzi lub izolowanym obszarze roboczym. W przypadku zadania CSV użyj lokalnego kontekstu przeglądarki z zablokowanymi żądaniami sieciowymi i bez dostępu do wrażliwego stanu aplikacji. W przypadku zadań repozytorium daj procesowi tylko pliki i polecenia potrzebne do ewaluacji.
Zdefiniuj sukces poza odpowiedzią modelu. Gdy agent mówi „wszystkie testy przeszły”, powinieneś sięgnąć po rzeczywisty log testów, kod wyjścia i sprawdzoną wersję. Zachowaj diff wraz z tym dowodem. W przeciwnym razie późniejsza poprawka może zmienić pliki po pozornym sukcesie i pozostawić raport nieaktualnym.
Traktuj limity czasu i ponowienia jako zachowanie aplikacji, za które odpowiadasz. Ustaw termin żądania i całkowity budżet zadania. Oddziel błędy spowodowane poświadczeniami lub nieprawidłowymi parametrami od przejściowych awarii transportu. Powtarzanie nieprawidłowego żądania marnuje czas; powtarzanie żądania, które wywołuje efekty uboczne, może tworzyć zduplikowaną pracę.
Gdy agent może wywoływać narzędzia, rozróżniaj inspekcję tylko do odczytu od zapisu. Przypisz identyfikatory operacji tam, gdzie twój projekt narzędzia to obsługuje, i potwierdź stan przed powtórzeniem niepewnego zapisu. Polityka ponowień punktu końcowego modelu nie może zagwarantować idempotencji dla narzędzi, które twoja aplikacja wykonuje później.
Chroń logi równie celowo jak pliki źródłowe. Zapisuj identyfikatory modeli, znaczniki czasu, status, czas i użycie bez rutynowego kopiowania sekretów lub całych prywatnych repozytoriów do telemetrii. Przechowuj wszelkie wymagane dowody surowego wyjścia w odpowiednio ograniczonym miejscu i ustal, jak długo zespół musi je przechowywać.
Sprawdź strumieniowanie z rzeczywistym klientem. Musi obsługiwać częściowe zdarzenia, zakończenie, błędy i rekordy użycia, gdzie są dostępne. Potwierdź limity szybkości dla rzeczywistego konta i wdrożenia. Cichy eksperyment jednoosobowy nie może ustalić, jak ta sama trasa zachowuje się, gdy zespół wysyła żądania jednocześnie.
Użyj tej krótkiej listy kontrolnej wydania:
- Testy akceptacyjne i istniejące regresje przechodzą na ostatecznej wersji.
- Diff pozostaje w zatwierdzonej granicy zadania.
- Zachowanie limitu czasu, anulowania i ponowień zostało przećwiczone.
- Wywołania narzędzi i odpowiedzi strukturalne działają na wybranym punkcie końcowym.
- Logi nie zawierają poświadczeń ani niepotrzebnego prywatnego kodu.
- Warunki obsługi danych spełniają wymagania zespołu.
- Rozwiązanie zapasowe ma własną zweryfikowaną konfigurację i rekord testu.
Prywatne repozytoria wymagają decyzji specyficznej dla usługi. Przejrzyj aktualne warunki przechowywania, wykorzystania do trenowania, dostępu i warunki umowne z osobą odpowiedzialną za kod. Wysyłaj tylko zatwierdzony materiał. Nie wnioskuj o poufności z faktu, że wagi modelu są dostępne, ani z protokołu przypominającego ten, którego już używasz.
Najlepsze API AI do kodowania: dokonaj ostatecznego wyboru
Podejmij decyzję w trzech krokach.
Po pierwsze, wyeliminuj kandydatów, którym brakuje wymaganej możliwości. Zapisz warunki, które muszą być spełnione: akceptowany format wyjścia, działająca pętla narzędziowa, odpowiednie rozwiązanie w zakresie obsługi danych lub wykonalny termin odpowiedzi. Kandydat, któremu brakuje jednego, wymaga odrębnej decyzji o środkach zaradczych, zanim znajdzie się w ostatecznym porównaniu.
Po drugie, porównaj koszt zaakceptowanego zadania i czas, jaki upłynął. Użyj wszystkich prób w ramach tej samej polityki poprawek. Oddziel sukcesy pierwszego przejścia od sukcesów po poprawkach i pokaż brakujące rekordy użycia. Jeśli dwa modele oba spełniają kontrakt, porównaj ich obciążenie przeglądem, a także opłaty za model. Twoi deweloperzy będą żyć z wynikowymi łatkami.
Po trzecie, zachowaj jedno rozwiązanie zapasowe i zdefiniuj jego wyzwalacz. Przykłady obejmują długotrwałą awarię punktu końcowego, powtarzające się awarie wyjścia strukturalnego lub koszty zadań przekraczające wybrany pułap. Przetestuj konfigurację alternatywną z wyprzedzeniem. Zmiana identyfikatora modelu pod presją może wprowadzić drugi problem integracyjny, jeśli jego kontrolki lub zachowanie odpowiedzi się różnią.
Trzy małe zadania w tym przewodniku to ćwiczenie przesiewowe. Rozszerz zestaw o reprezentatywną pracę z własnej bazy kodu, zanim zaczniesz polegać na kandydacie przy szerokich zmianach. Zachowaj kilka zadań poza dostrajaniem promptów, abyś mógł sprawdzić, czy ulepszenia przenoszą się poza zoptymalizowane przykłady.
Najlepsze API AI do kodowania to kombinacja, którą potrafisz wyjaśnić: wykonuje wymaganą pracę, ujawnia koszty, które możesz śledzić, i pasuje do sposobu działania twojej aplikacji. Do podjęcia tej decyzji nie jest potrzebny uniwersalny zwycięzca.
Otwórz aktualny katalog modeli, wybierz dwóch kandydatów i zapisz ich dokładne identyfikatory i ustawienia. Następnie użyj tego samego zadania, tych samych testów i tej samej reguły zatrzymania dla obu.
Często zadawane pytania
Jaki jest najlepszy AI API do kodowania przy małym budżecie?
Zacznij od kandydata, którego wyświetlane stawki pasują do prawdopodobnych wolumenów wejścia i wyjścia, a następnie porównaj koszt zaakceptowanego zadania. Wiersze Qwen, DeepSeek i Kimi dostarczają konkretnych wersji do zbadania, nie twierdząc, że istnieje przetestowany zwycięzca pod względem wartości. Ogranicz próby poprawek, świadomie ponownie używaj istotnego kontekstu i śledź nieudane żądania. Uwzględnij czas przeglądu osobno, aby niski rachunek za inferencję nie ukrył dużego obciążenia porządkowaniem.
Czy subskrypcja kodowania jest tańsza niż płacenie za tokeny API?
To zależy od twojego obciążenia i tego, co obejmuje plan. Subskrypcja może pasować do interaktywnego użytku w obsługiwanej aplikacji, podczas gdy rozliczenie za użycie może pasować do usługi niestandardowej ze zmiennym ruchem. Sprawdź dostęp do modeli, limity, współbieżność i to, czy zewnętrzne wywołania API są w ogóle uwzględnione. Porównaj tę samą ilość użytecznej pracy w reprezentatywnym okresie; miesięczna cena katalogowa i stawka za token mierzą różne rzeczy.
Jaka jest różnica między modelem kodującym a agentem kodującym?
Model generuje odpowiedzi. Agent zarządza pętlą wokół tych odpowiedzi, w tym dostępem do plików, wykonywaniem narzędzi, testami i regułami zatrzymania. Możesz wywołać model kodujący przez API bez budowania agenta, na przykład aby zaproponować funkcję do przeglądu przez człowieka. Jeśli chcesz autonomicznych zmian, oceń model razem z agentem i uprawnieniami, których faktycznie będzie używać.
Którego AI API powinienem użyć do debugowania i refaktoryzacji?
Utwórz listę kandydatów pasujących do twoich wymagań dotyczących punktu końcowego i obsługi kodu, a następnie użyj małych błędów i ograniczonych refaktoryzacji z twojej pracy. Zadanie A sprawdza poprawność i modyfikację danych wejściowych; zadanie B sprawdza parsowanie i zachowanie interfejsu. Po nich przeprowadź reprezentatywne testy repozytorium.
Preferuj kandydata, który spełnia twoje warunki akceptacji przy możliwym do opanowania wysiłku przeglądu, a nie takiego, który po prostu daje najdłuższe wyjaśnienie lub najbardziej rozległe przepisanie.
Czy istnieje darmowe AI API do kodowania?
Kredyt próbny, aplikacja z darmowym planem i wagi modelu do pobrania to różne oferty. Żadna z nich automatycznie nie daje twojej aplikacji nieograniczonej hostowanej inferencji. Zweryfikuj aktualną kwalifikowalność, wygaśnięcie, limity i obsługiwane modele, zanim zaplanujesz budżet wokół darmowego dostępu. Ten artykuł nie twierdzi, że obecnie dostępny jest darmowy limit.
Jeśli sam hostujesz wagi, uwzględnij moc obliczeniową i eksploatację, nawet gdy pobranie wag nic nie kosztuje.
Czy mogę wysyłać kod prywatnego repozytorium do API kodowania?
Wysyłaj tylko kod, na którego udostępnianie twoja organizacja zezwala zgodnie z mającymi zastosowanie warunkami konkretnej usługi. Przejrzyj przechowywanie, wykorzystanie do trenowania, kontrole dostępu i wymagania umowne dla wybranego wdrożenia.
Usuń poświadczenia i niepowiązane pliki oraz sprawdź, co twój agent automatycznie umieszcza w promptach i logach. Model o otwartych wagach lub znany format API sam w sobie nie potwierdza, że hostowana usługa spełnia wymagania poufności twojego zespołu.


