
Kimi API for Vision-to-Code Generation
Kimi API to linia modeli open-weight K2 od Moonshot AI — od natywnie multimodalnego K2.5 po wyspecjalizowany do kodowania K2.7 Code. Ponieważ obsługa obrazu jest wbudowana w model, możesz przekształcać zrzuty ekranu, makiety UI i krótkie filmy w działający kod frontendu, koordynować do 100 równoległych sub-agentów i wnioskować w kontekście 256K tokenów. Atlas Cloud udostępnia całą rodzinę modeli przez jeden zunifikowany endpoint z przejrzystym cennikiem pay-as-you-go. Zacznij tworzyć już dziś.
Kimi został opracowany przez Moonshot AI. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.

Dopasuj obciążenie robocze do właściwego modelu Kimi API
Porównaj w skrócie przeznaczenie każdego endpointu Kimi oraz standardowe ceny za milion tokenów.
| Modalność | Opis |
|---|---|
| Kimi K2.7 Code API (Text to Text) | Ten endpoint, zaprojektowany specjalnie do prac inżynieryjnych, przekształca prompty w języku naturalnym i istniejące pliki źródłowe w działający kod, poprawki oraz automatyzacje dla deweloperów. Jest przeznaczony do programowania, debugowania i przepływów pracy AI dla deweloperów, w których priorytetem jest niezawodne generowanie kodu; standardowa opłata wynosi $0.95 za milion tokenów wejściowych i $4 za milion tokenów wyjściowych. |
| Kimi K2.6 API (Text to Text) | Podaj prompty tekstowe, a Kimi K2.6 zwróci przemyślane odpowiedzi, kod i ustrukturyzowane dane wyjściowe do codziennych zadań produktywnościowych. Ulepszony zarówno pod kątem rozumowania, jak i kodowania, sprawdzi się w zespołach, które chcą jednego modelu ogólnego przeznaczenia do analizy, tworzenia treści i rozwoju oprogramowania, z cache’owanym wejściem w cenie $0.16 za milion tokenów dla powtarzanego kontekstu. |
| Kimi K2.5 API (Text to Text) | Gdy zadanie obejmuje długie dokumenty lub wieloetapowe potoki, Kimi K2.5 przyjmuje rozbudowane dane tekstowe i zwraca spójne odpowiedzi uwzględniające kontekst. Zbudowany z myślą o rozumieniu długiego kontekstu i inteligentnych przepływach pracy, działa w przejrzystym modelu pay-as-you-go w cenie $0.60 za milion tokenów wejściowych i $3 za milion tokenów wyjściowych, pomagając utrzymać opłacalność analiz na dużą skalę. |
Kimi API: od kontekstu 256K po roje 300 agentów
Kimi API udostępnia bilionparametrowe modele K2 od Moonshot AI przez jeden endpoint, łącząc okno kontekstu 262,144 tokenów z natywnym wejściem obrazu i wideo, samodzielnie działającymi rojami agentów oraz wyspecjalizowanymi modelami dostrojonymi do programowania, debugowania i rozumowania w długim horyzoncie.
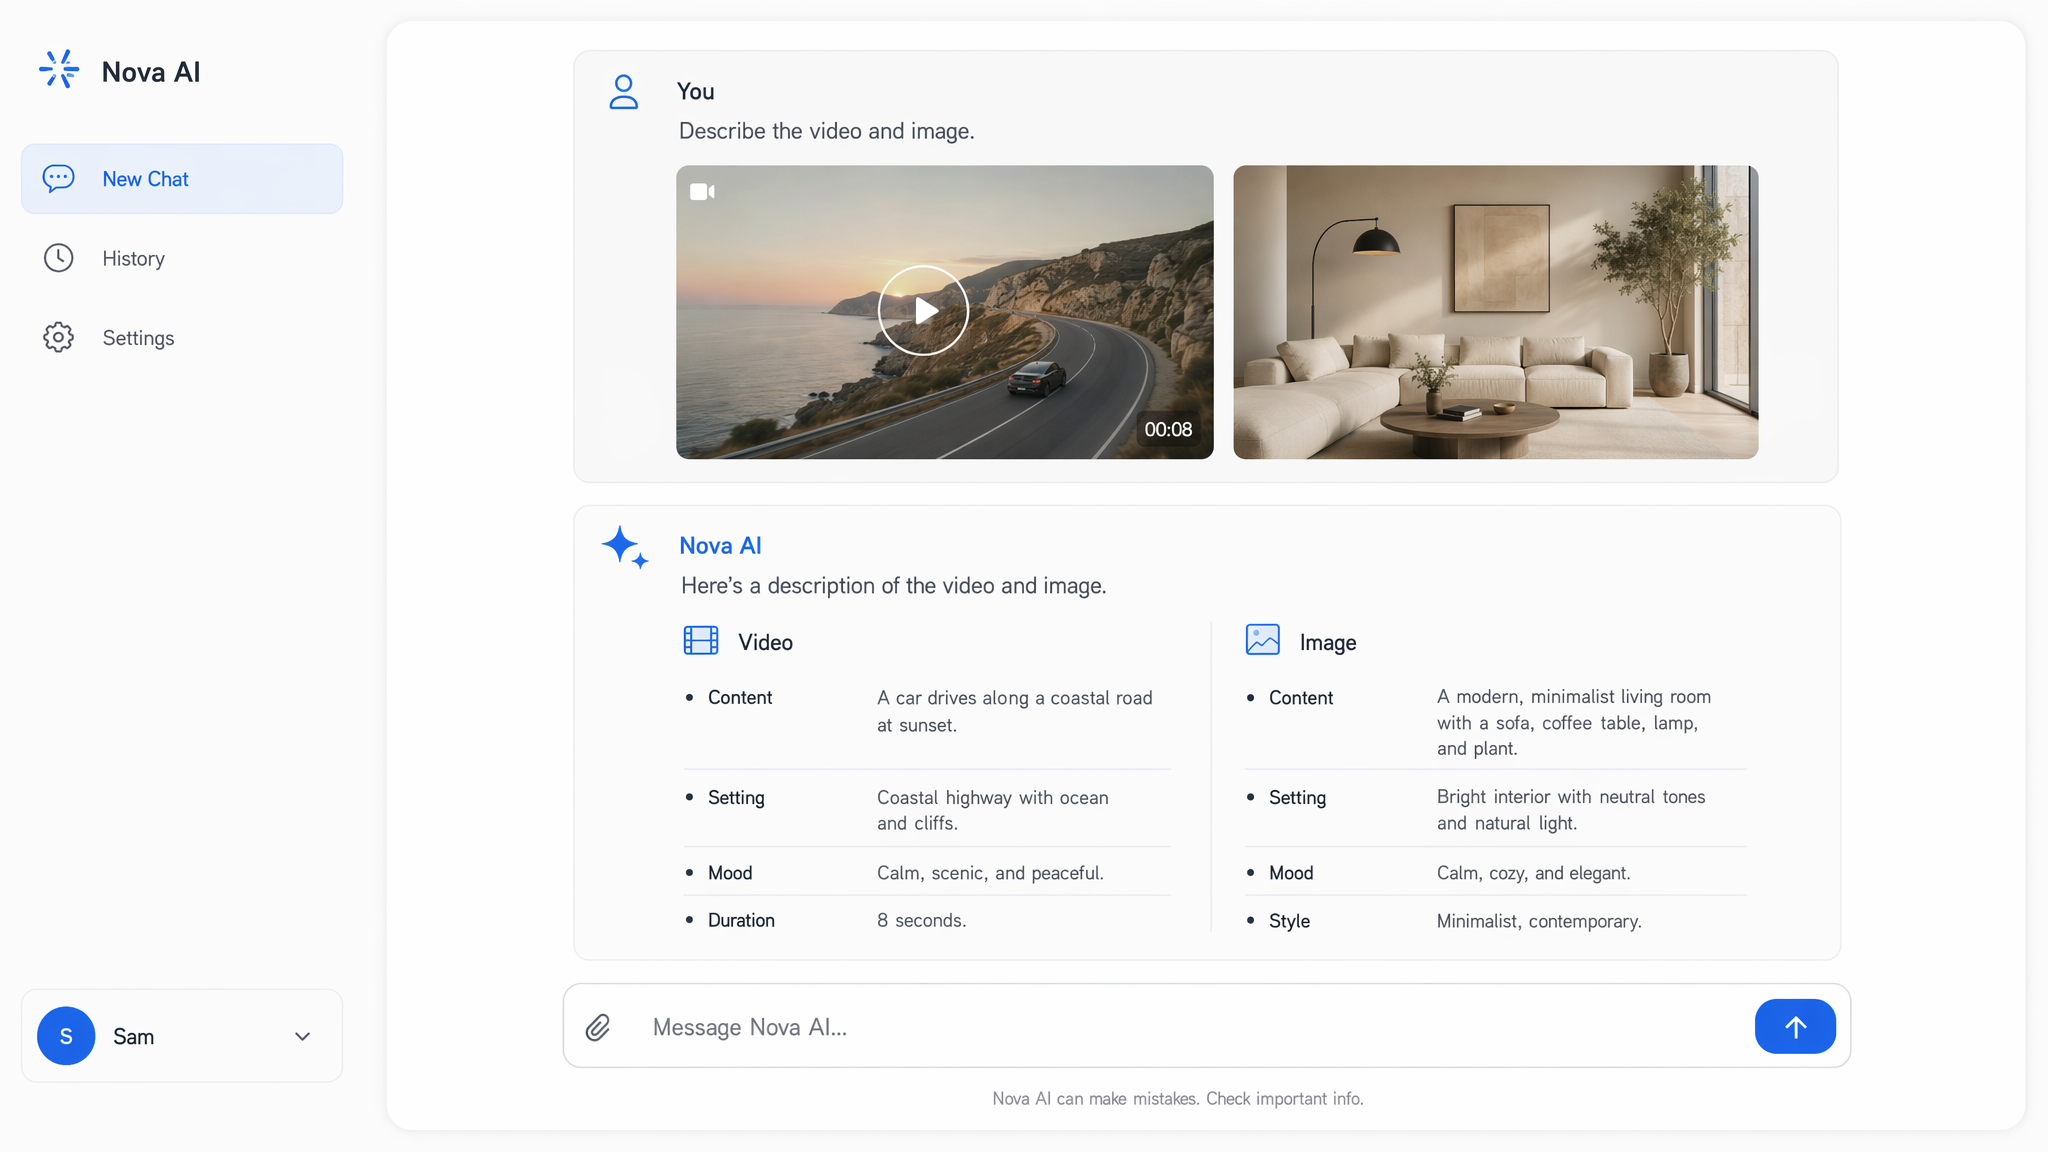
Natywne rozumienie obrazów i wideo
K2.6 przetwarza tekst, obrazy i wideo w ramach jednej natywnej architektury multimodalnej, obsługując formaty od PNG i WebP po MP4, MOV i WebM bez zewnętrznych wtyczek. Jego enkoder wizyjny MoonViT bezpośrednio odczytuje nagrania ekranu, pliki projektowe i diagramy. Tam, gdzie wcześniejszy K2.5 obsługiwał tekst i obrazy, K2.6 rozszerza ten sam stos o pełne rozumienie wideo, dzięki czemu kontekst wizualny staje się po prostu kolejnym wejściem.
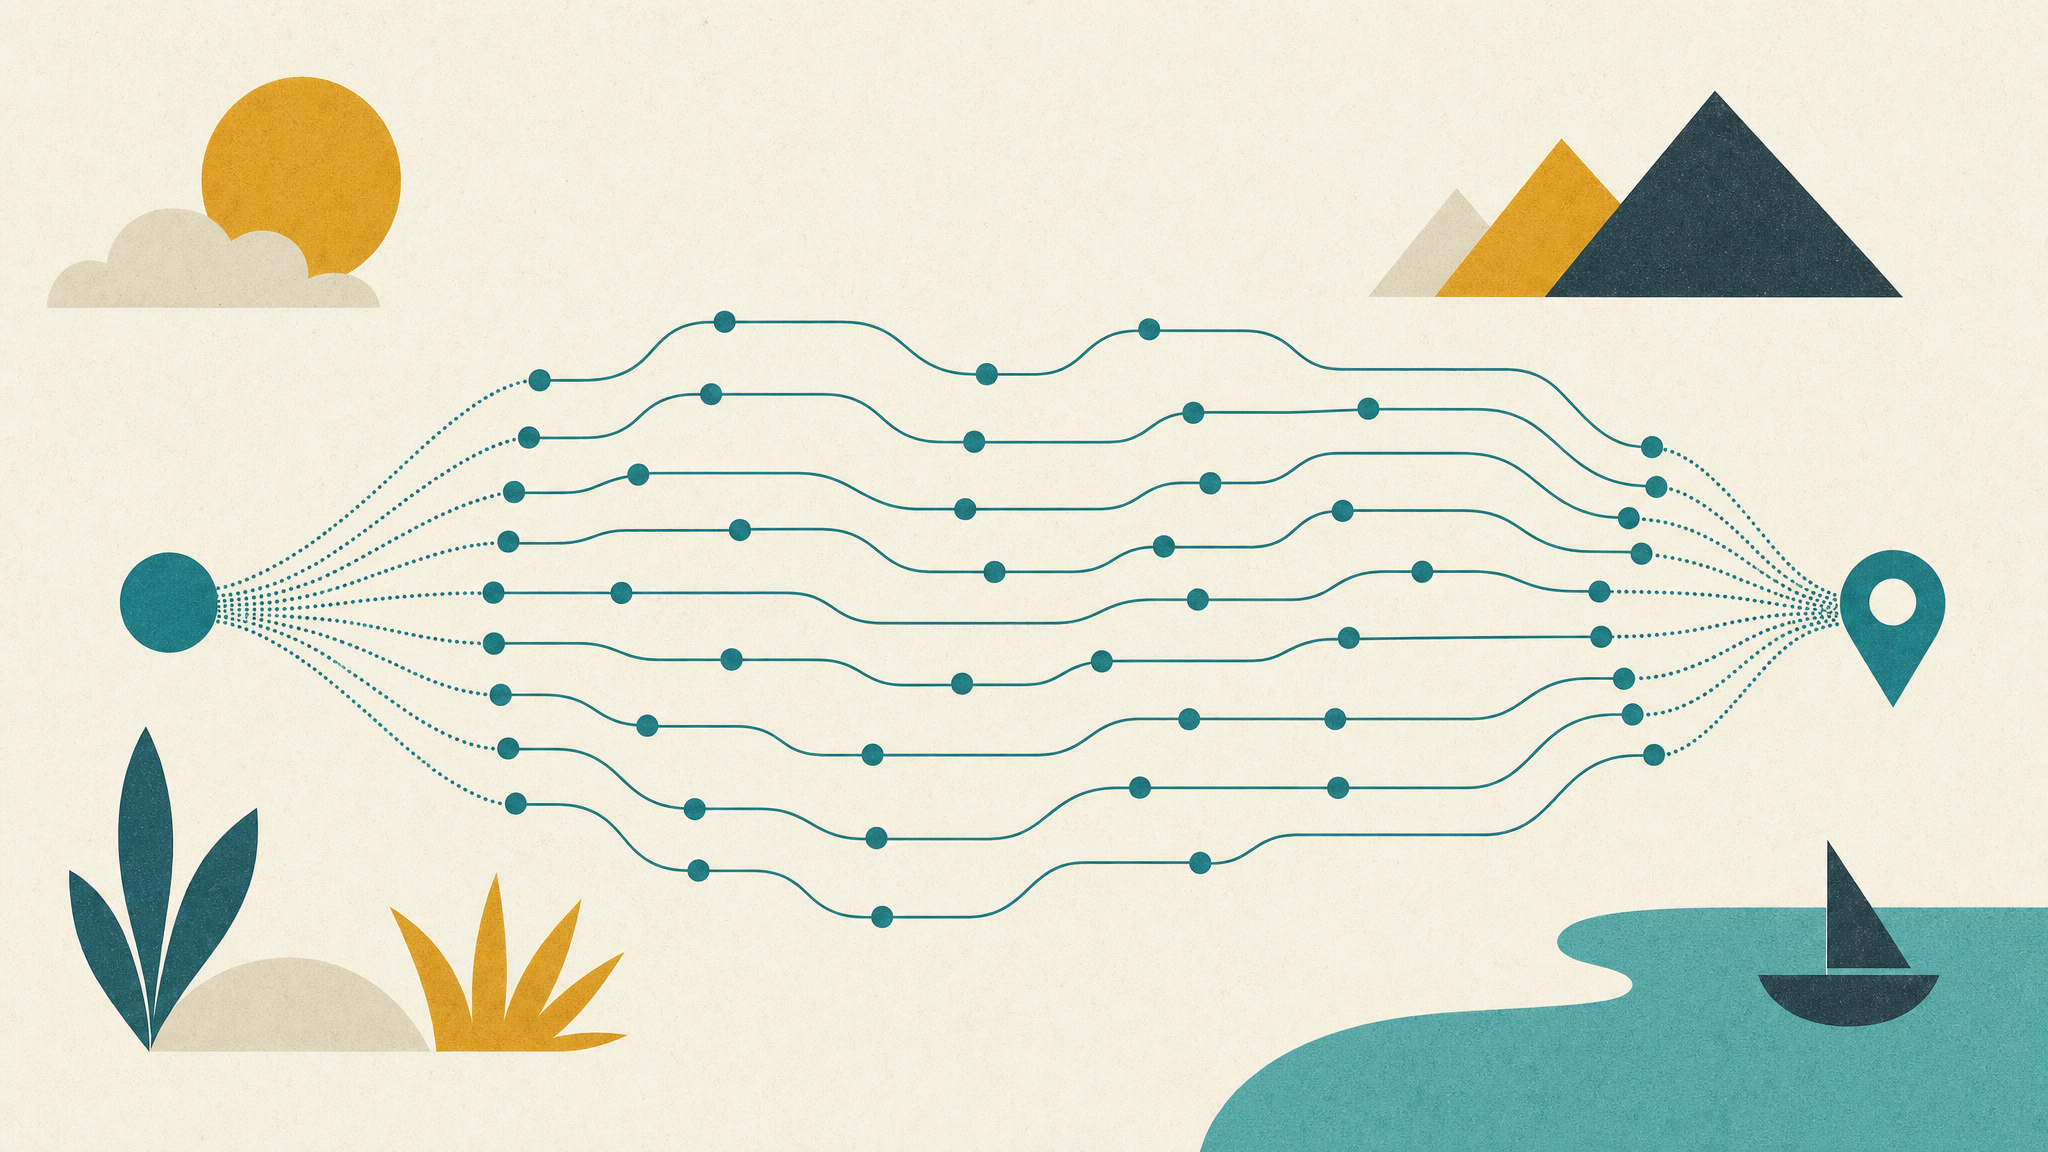
Samodzielne roje agentów przez Kimi API
Kimi API udostępnia samodzielnie działający rój agentów, który skaluje się do 300 podagentów pracujących w ramach około 4,000 skoordynowanych kroków. Zamiast rozumować w jednym wątku, K2.6 rozkłada jeden duży cel na równoległe gałęzie i orkiestruje je aż do ukończenia. Każdy podagent realizuje własny wycinek zadania, a następnie raportuje wyniki do wspólnego planu. Taka konstrukcja dobrze sprawdza się w automatyzacji w długim horyzoncie, gdy projekt obejmuje wiele zależnych od siebie etapów.
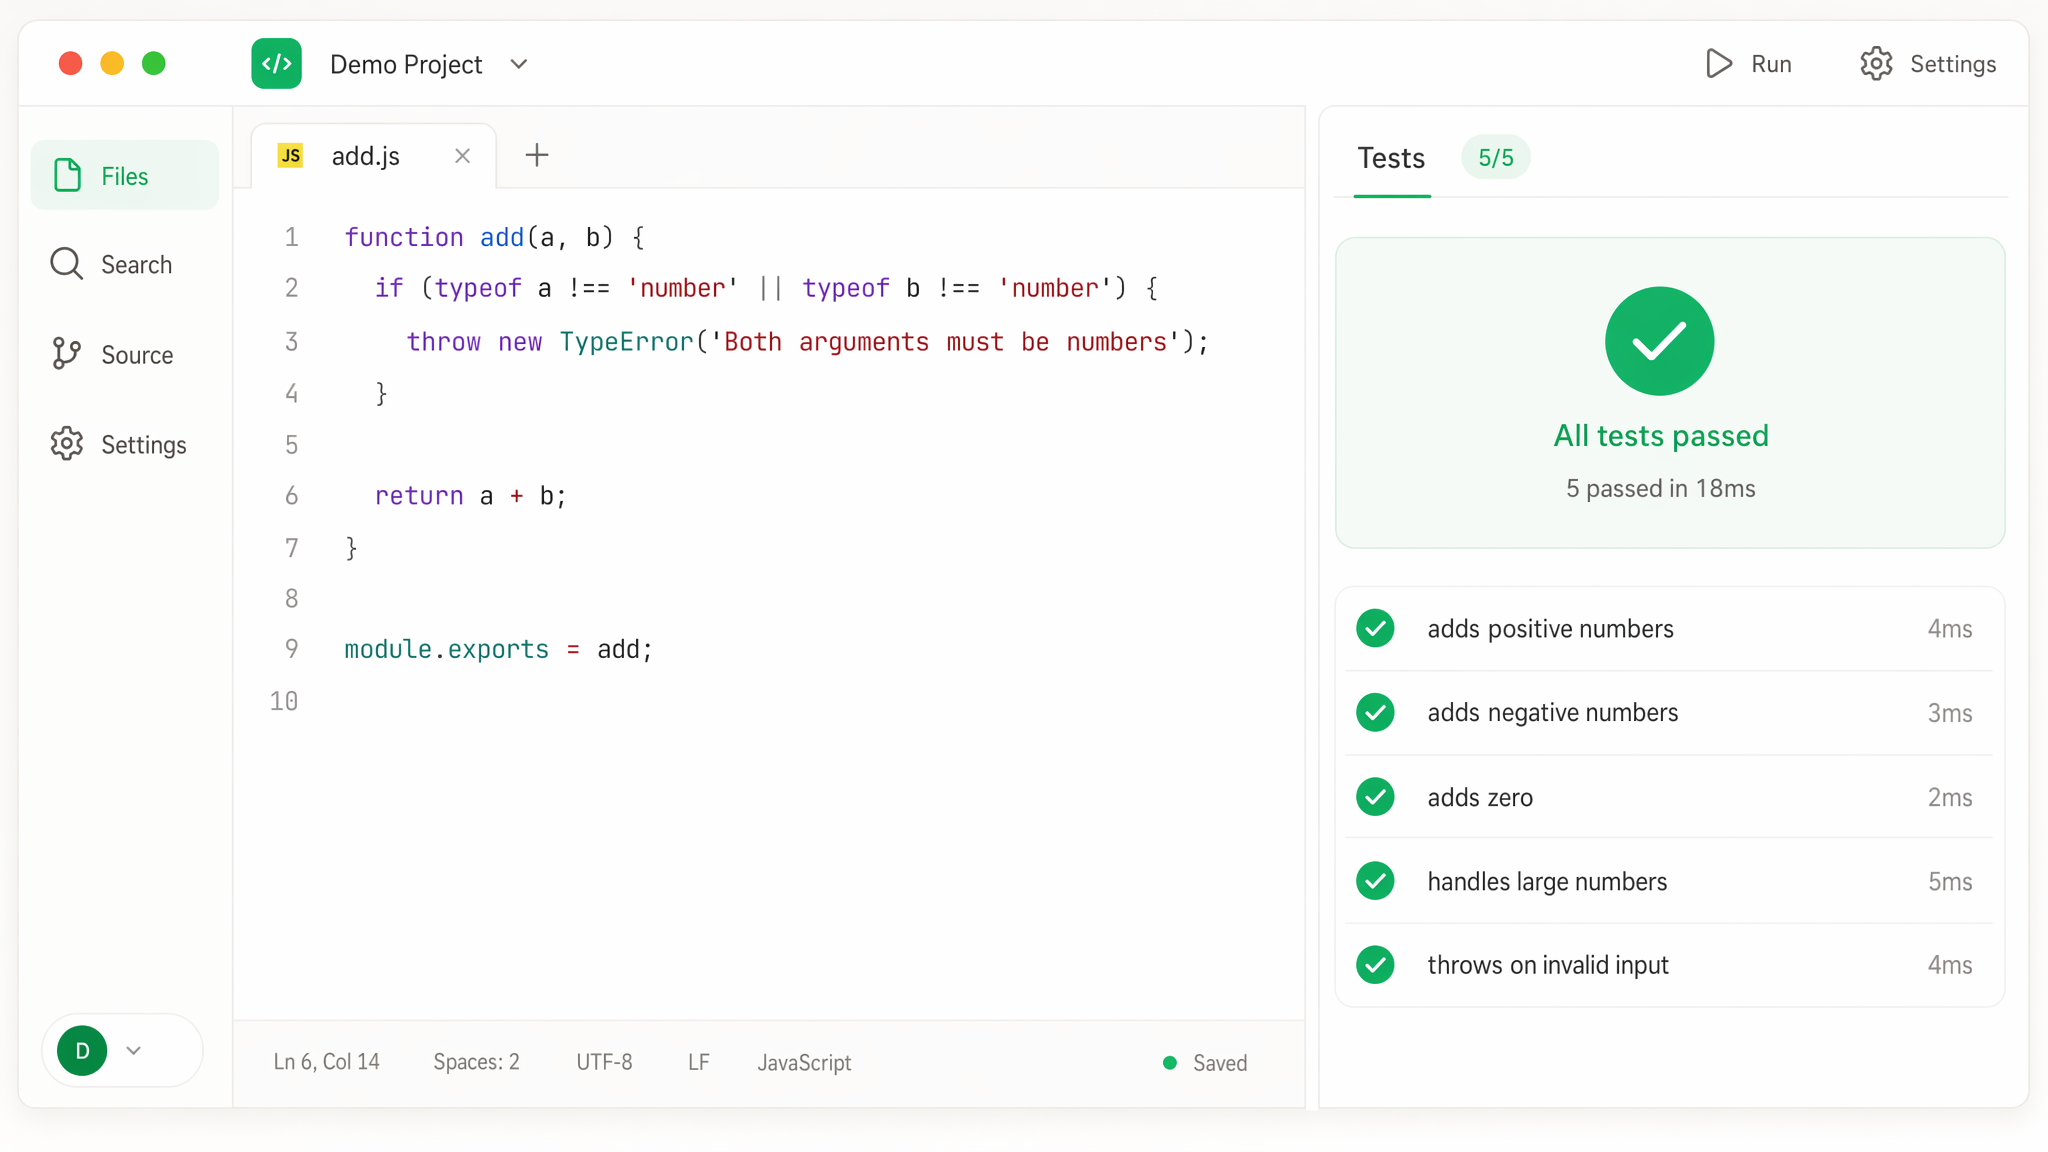
Wbudowane programowanie i debugowanie
Programowanie jest centralnym elementem tej rodziny modeli, a Kimi K2.7 Code został zaprojektowany specjalnie do tworzenia oprogramowania, debugowania i przepływów pracy agentów deweloperskich. W benchmarku programistycznym SWE-Bench Pro model K2.6 osiąga wynik 58.6, wyprzedzając kilka modeli frontier w naprawach rzeczywistych repozytoriów. Skieruj dowolny z tych modeli na niesprawny zestaw testów, a prześledzi błąd, zaproponuje poprawkę i będzie iterować, aż build przejdzie na zielono.
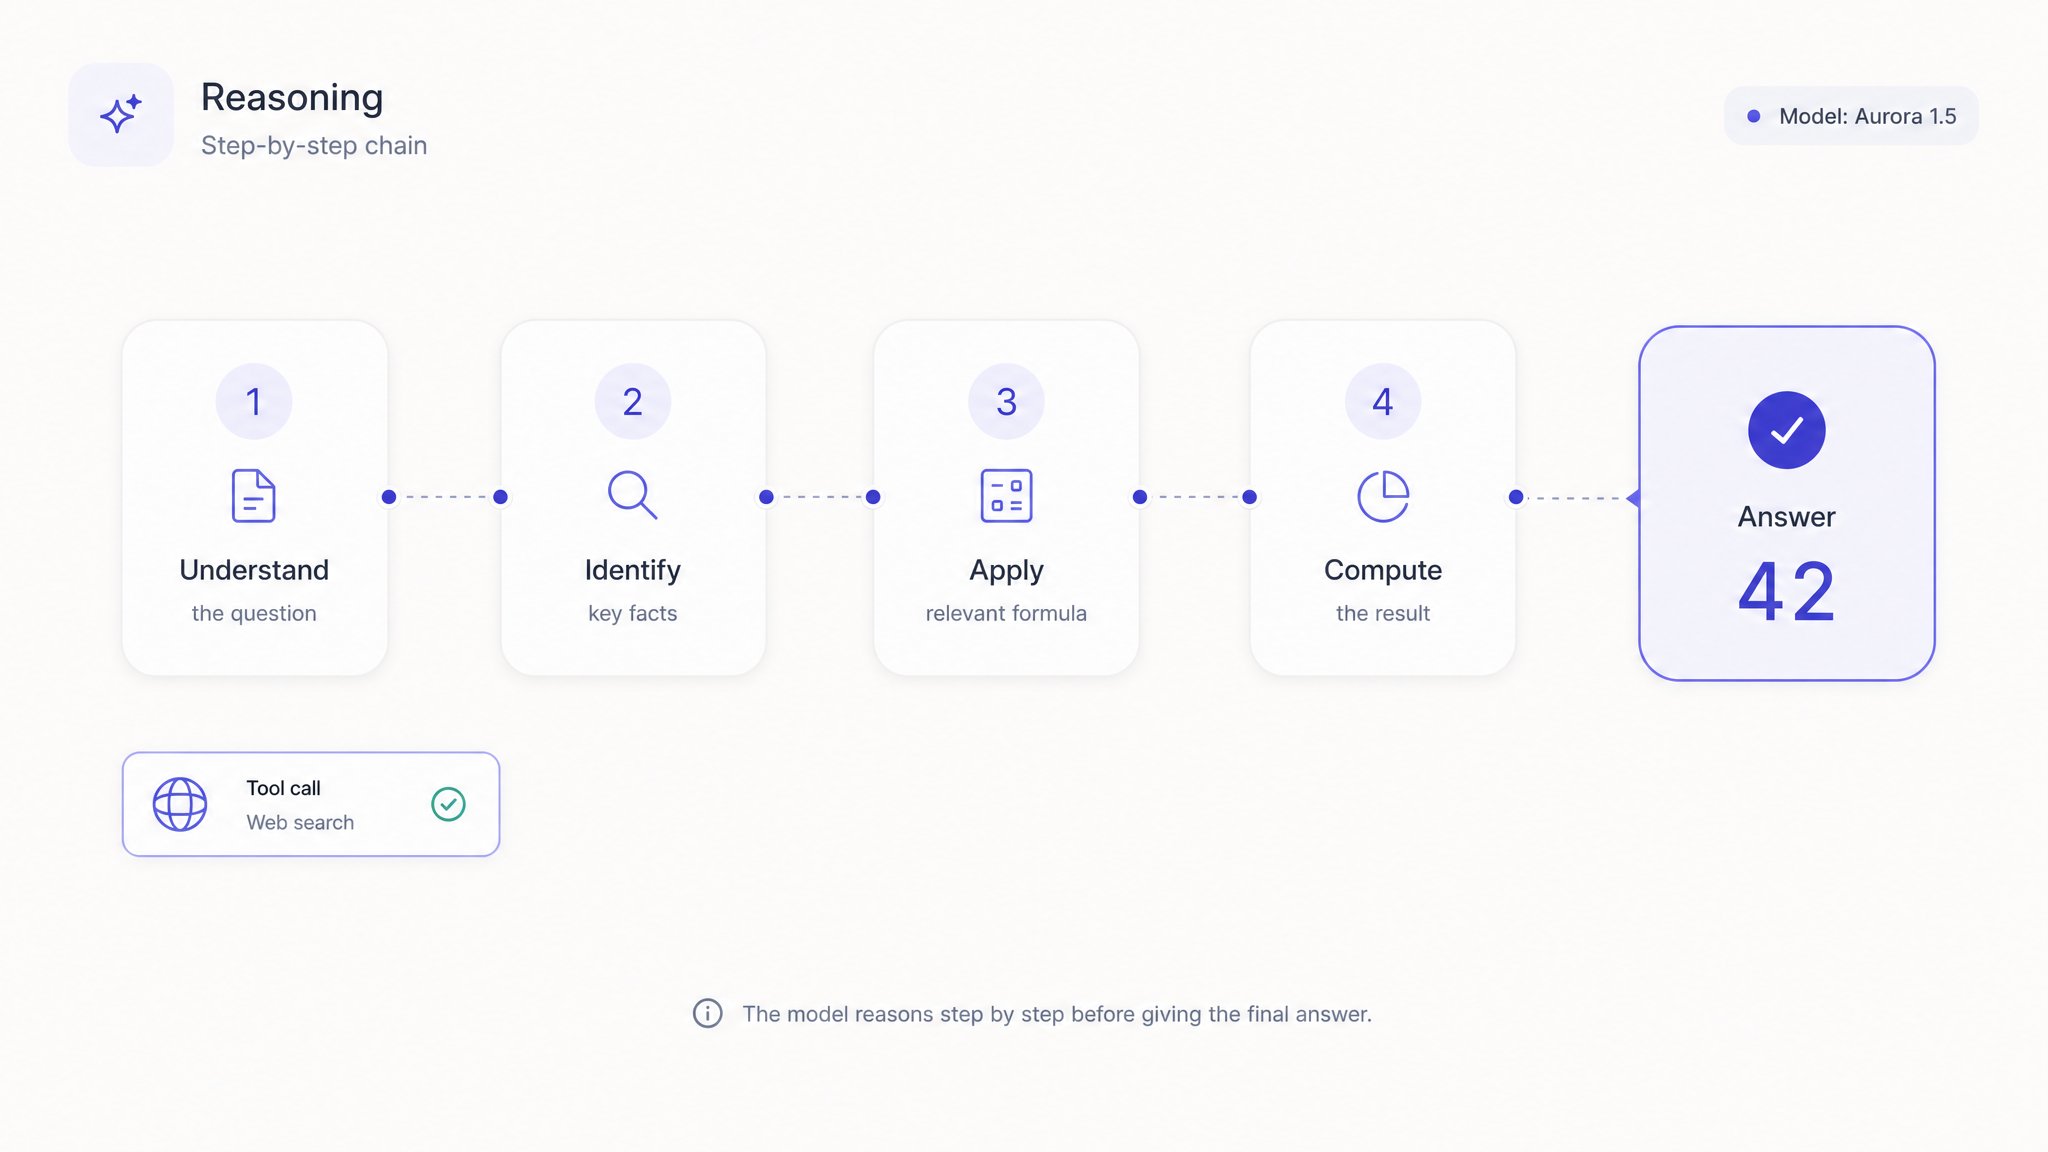
Agentowe rozumowanie przez jeden klucz Kimi API
Potrzebujesz przejrzystego rozumowania? Włącz konfigurowalny tryb myślenia, a model pokaże swój krok po kroku łańcuch rozumowania przed udzieleniem odpowiedzi, wraz z natywnym wywoływaniem narzędzi i funkcji. W Atlas Cloud całe Kimi API działa za jednym kluczem zgodnym z OpenAI, z rozliczeniem pay-as-you-go za każde wywołanie i dostępem Day-0 do każdej nowej wersji. Podmień bazowy URL, a istniejący kod będzie nadal działać.
Starcie Kimi API: jeden prompt, trzy modele
Wyślij jeden identyczny brief do Kimi API i dwóch konkurencyjnych modeli, a następnie porównaj interaktywną stronę HTML, którą każdy z nich zbuduje na podstawie dokładnie tych samych instrukcji.
Zbuduj kompletną, jednoplikową stronę HTML z grywalną arcade'ową grą Snake, z całym CSS i JavaScript osadzonym inline oraz bez żadnych zewnętrznych zależności, CDN-ów, obrazów ani fontów. Renderuj planszę na canvasie w nowoczesnej kolorystyce neon-on-dark, z płynnym ruchem i delikatną, świecącą smugą za wężem. Obsłuż sterowanie strzałkami i WASD oraz gesty przesuwania na urządzeniach dotykowych, pokazuj wynik na żywo i trwały rekord, a wraz ze wzrostem wyniku stopniowo przyspieszaj grę. Wywołuj mały wybuch cząsteczek za każdym razem, gdy jedzenie zostanie zjedzone, wyświetlaj animowaną nakładkę końca gry z przyciskiem restartu i utrzymuj responsywny układ, tak aby plansza pozostawała wyśrodkowana i czytelna zarówno na desktopie, jak i na urządzeniach mobilnych.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Utwórz pojedynczy, w pełni samowystarczalny plik HTML (cały CSS i JavaScript inline, absolutnie bez zewnętrznych zależności, CDN-ów, obrazów ani web fontów), który renderuje interaktywne „żywe cyfrowe terrarium” — szczelnie zamknięty szklany słój umieszczony na środku ekranu, zawierający samowystarczalny miniaturowy las deszczowy rosnący w czasie rzeczywistym. Po otwarciu w dowolnej nowoczesnej przeglądarce musi od razu działać w 60fps, bez etapu buildowania. Główna scena i układ: wyśrodkuj kompozycję symetrycznie, traktując szklany słój jako główną scenę na głębokim, winietowanym ciemnym tle (gradient radialny od miękkiego, mchowo podświetlonego centrum przechodzący ku niemal czarnym krawędziom), tak aby cała uwaga skupiała się na słoju. Renderuj wszystko na pełnoekranowym HTML5 Canvas, warstwowanym pod rzeczywistą glassmorphismową oprawą DOM/CSS: ścianka słoja musi pokazywać autentyczne cechy szkła — zakrzywione refleksy refrakcji, jasną smugę światła krawędziowego, delikatne matowe rozmycie oraz rozproszone krople kondensacji z drobnym efektem soczewkowania — uzyskane za pomocą warstwowych gradientów radialnych/liniowych, backdrop-filter blur, półprzezroczystych białych obrysów i miękkich box-shadow. Wewnątrz słoja na dnie znajduje się ciemna, wilgotna próchnica oraz subtelna wolumetryczna mgiełka, która powoli dryfuje. Trzy warstwy techniczne, które muszą się na siebie nakładać i współistnieć (to tutaj odróżnia się słabe modele od mocnych — słaby model stworzy statyczny obrazek, mocny ożywi cały słój): 1. Rekurencyjny wzrost L-system: pnącza, liście paproci i mchy są generowane przez algorytm L-system / rekurencyjnego rozgałęziania i animują swoje rozwijanie w czasie — łodygi się wydłużają, gałęzie dzielą, liście paproci rozwijają, a liście skalują się z easingiem. Wzrost jest organiczny i lekko losowy dla każdej gałęzi (odchylenie kąta, zwężanie grubości, zanik długości), dzięki czemu po ponownym wczytaniu żadne dwie rośliny nie wyglądają identycznie. 2. System cząsteczek: bursztynowe świetliki podobne do drobinek światła (dziesiątki) dryfują i kołyszą się w mgle z miękkim addytywnym blaskiem i delikatną paralaksą, a do tego unoszą się drobinki kondensacji/pyłku; cząsteczki subtelnie reagują na nowo wyrosłe rośliny. 3. Cykl dnia i nocy: ciągła pętla światła otoczenia przesuwa główne światło z góry od chłodnego białego świtu → ciepłego złotego zmierzchu → głębokiej indygo nocy i z powrotem, odpowiednio przebarwiając całą scenę, refleksy szkła, mgłę i odcienie roślin. Rośliny wykazują fototropizm — łodygi wyginają się i kierują czubki ku aktualnemu kierunkowi światła, gdy ten się porusza. Główna interakcja: kliknięcie w dowolnym miejscu na ściance słoja lub w jego wnętrzu upuszcza pojedyncze nasiono do próchnicy w pozycji x kliknięcia, a to nasiono odtwarza pełny, widoczny cykl życia w sekwencji — nasiono spada i osiada, kiełkuje pęd, pęd rozgałęzia się rekurencyjnie przez L-system, a po osiągnięciu dojrzałości rozkwita małym świecącym kwiatem — każdy etap z easingiem i wyraźnie czytelny, z miękką falą/obłoczkiem pyłu przy lądowaniu. Wielokrotne kliknięcia tworzą wiele roślin, które współistnieją i dalej rosną, stopniowo wypełniając terrarium gęstszymi zaroślami. Dodaj kilka subtelnych kontrolek inline w glassmorphismowych przyciskach typu pill (np. „Reset terrarium” oraz przełącznik „Day/Night: auto ⇄ drag”, w którym użytkownik może przewijać porę dnia, plus opcjonalną pauzę). Dodaj delikatną linię podpowiedzi („tap the glass to plant a seed”), która znika po pierwszej interakcji. Paleta i nastrój: leśna atramentowa zieleń oraz mchowa żółtawa zieleń liści, bursztynowo-miodowy blask drobinek światła i kwiatów, chłodne turkusowo-szklane odcienie słoja, ciepłe złoto i chłodne indygo przechodzące przez cykl dnia i nocy. Całość ma sprawiać wrażenie cichej, oddychającej, medytacyjnej sceny — powolny łagodny ruch, bez ostrych przejść. Wymagania techniczne: użyj requestAnimationFrame z delta-time, aby animacja była niezależna od liczby klatek; spraw, by canvas responsywnie reagował na zmianę rozmiaru okna z poprawnym skalowaniem devicePixelRatio i utrzymaniem słoja w centrum; rozsądnie ogranicz liczbę cząsteczek i gałęzi, aby zachować płynność; zachowaj całe losowanie seeded per-plant, żeby wzrost wyglądał naturalnie. Wszystko — geometria, blask, szkło, mgła, oświetlenie, cząsteczki i rekurencyjne rośliny — musi być rysowane lub obliczane w kodzie, bez żadnych zewnętrznych zasobów. Dostarcz wyłącznie kompletny dokument HTML, gotowy do zapisania jako jeden plik .html i otwarcia.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Wykorzystaj Kimi API w całym swoim stacku
Niezależnie od tego, czy wdrażasz kod w ogromnych repozytoriach, zamieniasz projekty w interfejsy, czy orkiestrujesz roje agentów, Kimi API wnosi wnioskowanie w długim kontekście i natywne użycie narzędzi do rzeczywistych obciążeń produkcyjnych.

Programowanie w skali repozytorium z Kimi API
Kimi K2.7 Code odczytuje całe repozytoria w oknie 262K-token, refaktoryzując, debugując i rozwijając bazy kodu w jednym przebiegu. Zespoły korzystają z niego, aby modernizować systemy legacy i dostarczać funkcje obejmujące wiele plików bez utraty kontekstu projektu.

Zamieniaj projekty w kod front-endowy
Przekaż Kimi K2.5 zrzut ekranu, makietę lub krótkie wideo demonstracyjne, a model zwróci działający kod front-endowy na podstawie danych wizualnych. Projektanci i zespoły produktowe w kilka minut zmieniają statyczne koncepcje w interaktywne strony i prototypy.

Analizuj długie dokumenty i dane
Gdy raporty lub umowy liczą setki stron, modele Kimi przetwarzają je w kontekście 256K-token, aby wydobyć trendy i sprzeczności. Analitycy uzyskują ustrukturyzowane odpowiedzi z cytowaniami zamiast ręcznie czytać każdą stronę.

Orkiestruj roje agentów przez Kimi API
Roje agentów pozwalają Kimi K2.5 podzielić jeden cel na maksymalnie 100 równoległych sub-agentów, skracając czas wykonania nawet 4.5x. Zespoły automatyzują analizę wsadową i rozbudowane procesy tworzenia, których pojedynczy model nie byłby w stanie ukończyć.

Zasilaj autonomicznych agentów korzystających z narzędzi
Wytrenowane pod kątem agentowego użycia narzędzi modele Kimi wywołują zewnętrzne funkcje, APIs i wyszukiwanie, aby realizować zadania bez promptowania krok po kroku. Deweloperzy budują asystentów, którzy w imieniu użytkownika rezerwują, odpytują i działają w rzeczywistych systemach.

Przejdź na Kimi API w kilka minut
Ponieważ Kimi API jest zgodne z OpenAI, wystarczy podmienić base URL i jeden klucz, aby kierować ruch do modeli Moonshot. Startupy wdrażają Kimi bez przepisywania logiki aplikacji i płacą według przejrzystego cennika za wywołanie.
Kimi API kontra interfejsy API konkurencyjnych LLM: kontekst, modalność i koszt
Porównaj Kimi API z innymi flagowymi interfejsami API modeli językowych w Atlas Cloud i sprawdź, gdzie wyróżnia się długością kontekstu, elastycznością danych wejściowych oraz ceną za token.
| Model | Okno kontekstu | Typy danych wejściowych | Cena wejścia ($/1M tokens) | Cena wyjścia ($/1M tokens) |
|---|---|---|---|---|
| Kimi K2.7 Code | 256K tokens | Tekst, obraz | $0.95 | $4.00 |
| Kimi K2.6 | 256K tokens | Tekst, obraz, wideo | $0.95 | $4.00 |
| Kimi K2.5 | 256K tokens | Tekst, obraz, wideo | $0.60 | $3.00 |
| DeepSeek V4 Pro | 1M tokens | Tekst | $1.74 | $3.45 |
| GLM 5.2 | 1M tokens | Tekst | $1.40 | $4.40 |
| Grok 4.5 | 500K tokens | Tekst | $2.00 | $6.00 |
| Doubao Seed 2.1 Pro | 256K tokens | Tekst | $0.90 | $4.50 |
Jak używać Kimi na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać Kimi na Atlas Cloud
Połączenie zaawansowanych modeli Kimi z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj Kimi, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
Kimi API — pytania i odpowiedzi
Kimi API daje deweloperom programowy dostęp do rodziny dużych modeli językowych Kimi od Moonshot AI, przeznaczonych do rozumowania, kodowania i pracy z długim kontekstem. W Atlas Cloud korzystasz z niego przez jeden endpoint zgodny z OpenAI, więc jeden klucz obejmuje każdą wersję Kimi w modelu pay-as-you-go z rozliczaniem za każde wywołanie.
Atlas Cloud udostępnia kilka wersji, w tym Kimi K2.5 do długiego kontekstu i agentowych przepływów pracy, Kimi K2.6 jako najbardziej inteligentny ogólny model Moonshot oraz Kimi K2.7 Code do programowania i debugowania. Ponieważ korzystają z tego samego formatu żądań, przejście między nimi oznacza jedynie zmianę jednego ciągu znaków z nazwą modelu.
Te modele świetnie sprawdzają się w złożonym kodowaniu, analizie repozytoriów obejmujących wiele plików, rozumowaniu na podstawie dużej liczby dokumentów oraz agentowym wywoływaniu narzędzi. Zespoły sięgają po Kimi, gdy zadanie wymaga zarówno dużej pamięci roboczej, jak i silnej logiki krok po kroku, na przykład przy refaktoryzacji całej bazy kodu lub audycie obszernych raportów.
Rozliczenie działa w modelu pay-as-you-go, bez subskrypcji i bez minimów. Kimi K2.5 kosztuje $0.60 za milion tokenów wejściowych i $3.00 za milion tokenów wyjściowych, natomiast Kimi K2.6 oraz Kimi K2.7 Code kosztują $0.95 za milion tokenów wejściowych i $4.00 za milion tokenów wyjściowych. Buforowanie kontekstu obniża koszt powtarzanych lub współdzielonych promptów.
Ponieważ Atlas Cloud udostępnia Kimi przez API zgodne z OpenAI, możesz skierować obecny OpenAI SDK na endpoint Atlas i podmienić nazwę modelu na Kimi. Nie trzeba przepisywać logiki aplikacji, dzięki czemu jest to prawdziwy zamiennik typu drop-in dla czatów, kodowania i potoków agentowych.
Kimi K2.5, K2.6 i K2.7 Code obsługują okno kontekstu o długości 262,144 tokenów, czyli około 256K tokenów. Taka pojemność pozwala przekazywać całe bazy kodu, długie podręczniki techniczne lub setki stron raportów w jednym żądaniu, bez ręcznego dzielenia na fragmenty.
Najnowsze wersje Kimi są natywnie multimodalne, a nie wyłącznie tekstowe. Kimi K2.6 przyjmuje dane wejściowe w postaci tekstu, obrazów i wideo, a Kimi K2.5 rozumuje na połączonych tokenach wizualnych i tekstowych, więc możesz przekazywać zrzuty ekranu, pliki projektowe lub nagrania, a model zinterpretuje je razem z Twoim promptem.
Deweloperzy najczęściej wybierają je ze względu na koszt i kontekst. Raporty społeczności wskazują na znaczące oszczędności względem wiodących modeli własnościowych przy porównywalnej jakości kodowania, a okno 256K obsługuje zadania obejmujące całe repozytoria i pełne dokumenty, z którymi modele o krótszym kontekście sobie nie poradzą. Zacznij budować już dziś.
Poznaj Więcej Rodzin
Kling 4.0
Interfejs API Kling 4 udostępnia Kling 4.0, model wideo wydany przez Kuaishou 15 października 2026 r. Generuje do 30 sekund w jednym przebiegu, podąża za maksymalnie 10 klatkami kluczowymi, łączy 15 obrazów, filmów i obiektów za pośrednictwem Omni Reference oraz dodaje dźwięk stereo z synchronizacją ruchu warg. Atlas Cloud obsługuje wszystkie cztery punkty końcowe, w tym edycję wideo, za pomocą jednego klucza kompatybilnego z OpenAI w cenie od 0,11 USD za sekundę. Rozpocznij budowanie już dziś.

Seedance 2.5
API Seedance 2.5 udostępnia programistom wspólny model audio i wideo ByteDance Seed, generujący od 4 do 30 sekund w jednym przejściu na podstawie tekstu, pierwszej klatki lub do 50 odniesień z obrazów, wideo i audio. Edytuje wybrane obszary, wydłuża klipy i podąża za wejściami typu white-model oraz green-screen. Atlas Cloud, autoryzowany sprzedawca w USA, dodaje tryb roboczy 480p, natywne wersje końcowe 1080p oraz ulepszone dostarczanie 4K w modelu cenowym pay-as-you-go.
Wan 3.0
Wan 3.0 to najnowszy model wideo od Alibaba, generujący do 30 sekund wideo 1080p przy 30fps z dźwiękiem w jednym procesie generowania. Steruj nim za pomocą promptu tekstowego, pierwszej klatki, do 10 obrazów referencyjnych lub dokumentu. Wersja Standard kosztuje mniej za sekundę, podczas gdy Prime zachowuje te same możliwości i szybciej zwraca wyniki. Obie wersje działają na tym samym kluczu Atlas Cloud co Wan 2.7, 2.6 i 2.5.
GPT Image 2.6
Interfejs API GPT Image 2.6 udostępnia programistom model obrazu OpenAI wydany 4 listopada 2026 r. w dwóch wersjach: Flare do szybkiej iteracji i Sunburst do szczegółowej pracy wizualnej. Generuje obrazy o 50% szybciej niż poprzednio i dodaje obsługę animowanych plików GIF, eksport do SVG, edycję znaczników skierowaną na zakreślony obszar oraz ustawienie złożoności. Atlas Cloud obsługuje oba modele za pomocą jednego klucza zgodnego z OpenAI w modelu płatności za użycie.
MiniMax H3
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
GPT Image 2.5
GPT Image 2.5 to model OpenAI do generowania i edycji obrazów, wydany 8 września 2026 roku w dwóch wersjach API. Flare to wersja domyślna, charakteryzująca się o 50% niższą latencją niż GPT Image 2, podczas gdy Sunburst działa wolniej, aby zapewnić bardziej precyzyjną kontrolę nad szczegółowymi edycjami. Obie wersje obsługują do 16 obrazów referencyjnych, pięć poziomów jakości, przezroczyste tła oraz niestandardowe rozmiary do 3840px. Atlas Cloud udostępnia API GPT Image 2.5 według stawek za token OpenAI lub w cenie stałej za obraz w podziale na poziomy 1K, 2K lub 4K.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling V3.0
Rodzina API Kling V3 firmy Kuaishou obsługuje przepływy pracy z tekstem, obrazami i wideo referencyjnym. Przenoś ruch, zachowując tożsamość postaci, kieruj generowaniem za pomocą odniesień wizualnych i edytuj filmy poleceniami w języku naturalnym. Atlas Cloud oferuje endpointy Standard i Pro dostosowane do różnych potrzeb produkcyjnych. Aktualizacja: Kling V4 jest już dostępny w Atlas Cloud. Poznaj go na stronie [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 Preview
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.


