Twoje żądanie kończy się sukcesem. Aplikacja nadal nie ma obrazu, którego można użyć. Być może odpowiedź zawiera identyfikator zadania albo gotowy obraz zawiera dodatkowy obiekt, który czyni go nieodpowiednim dla strony.
Generatywne API AI dla programistów pozwala aplikacji wysyłać dane wejściowe do modelu i odbierać wygenerowaną treść. Wybierz je, kierując się wymaganymi danymi wejściowymi, formatem wyników, czasem oczekiwania i kryteriami akceptacji. Następnie zbuduj obsługę zadań i kontrole, które zamienią odpowiedź w coś, z czego użytkownik może skorzystać.
Ten przewodnik opisuje proces pracy z obrazem od wyboru po dostarczenie. Znajdziesz w nim tabelę wyboru zadań, zgodne przykłady w JavaScripcie i Pythonie, 3 konkretne briefy obrazowe oraz arkusz kosztów. Ten sam proces decyzyjny stosuje się do tekstu i wideo, z innymi protokołami i kontrolami wyników.
Najważniejsze wnioski
- Wybierz zadanie i kryteria akceptacji przed wyborem modelu.
- Zapisuj identyfikatory zadań asynchronicznych, aby przerwaną pracę można było wznowić.
- Mierz koszt na zaakceptowany wynik, uwzględniając odrzucone generacje.
- Przetestuj pliki i ograniczenia biznesowe, zanim pokażesz gotowy wynik.
Generatywne API AI dla programistów: co robi
Generowanie wykonuje model. API określa, w jaki sposób Twoje oprogramowanie zleca tę pracę. SDK opakowuje interfejs w pomocniki charakterystyczne dla danego języka. Hostowana platforma obsługuje dostęp do modeli, a Twoja aplikacja dostarcza warstwę doświadczenia użytkownika, uprawnienia i zasady akceptacji wyniku.
Te rozróżnienia mają znaczenie przy czytaniu strony produktu. Aplikacja czatowa, która tworzy obrazy, nie dowodzi, że jej endpoint dla programistów przyjmuje takie same dane wejściowe. SDK z wygodną metodą nie usuwa potrzeby zrozumienia leżącej u podstaw odpowiedzi i stanów błędów.
Zacznij od poniższej mapy zadań. Kolumna interakcji opisuje projekt aplikacji do oceny, a nie obietnicę, że każdy dostawca obsługuje ten tryb.
| Zadanie | Dane wejściowe | Wymagana możliwość | Wynik | Interakcja do oceny | Kryteria akceptacji |
|---|---|---|---|---|---|
| Szkic odpowiedzi wsparcia | Zgłoszenie i zatwierdzona treść pomocy | Generowanie tekstu oparte na źródłach | Szkic tekstu | Synchronicznie lub strumieniowo | Odpowiada na zgłoszenie; brak wymyślonych zasad |
| Ekstrakcja pól z dokumentu | Tekst dokumentu lub obsługiwany plik | Ekstrakcja strukturalna | Pola JSON | Żądanie lub zadanie w kolejce | Poprawny schemat i dowód źródłowy |
| Ilustracja redakcyjna | Pisemny brief wizualny | Tekst na obraz | Plik obrazu | Zadanie asynchroniczne | Poprawne obiekty, układ, wymiary |
| Edycja obrazu | Obraz źródłowy i instrukcja | Edycja warunkowana obrazem | Edytowany obraz | Zadanie asynchroniczne | Żądana zmiana; zachowane szczegóły |
| Generowanie wideo | Prompt lub obsługiwane odniesienie | Generowanie wideo | Plik wideo | Zadanie w kolejce | Poprawna długość, ruch, dźwięk, jeśli wymagany |
| Odpowiedź wspomagana wyszukiwaniem | Pytanie i pobrane fragmenty | Wyszukiwanie plus generowanie | Odpowiedź i źródła | Synchronicznie lub strumieniowo | Twierdzenia poparte pobranymi fragmentami |
Generowanie obrazu, analizowanie przesłanego obrazu i edycja istniejącego obrazu to odrębne możliwości. Zweryfikuj każdą z nich osobno. Podobnie endpoint wideo może obsługiwać klatkę początkową, nie obsługując dowolnych odniesień do wielu obrazów.
Osadzenia (embeddings) przekształcają dane wejściowe w wektory przydatne do wyszukiwania i podobieństwa. Mogą pomóc znaleźć istotne dokumenty, zanim zostanie wygenerowana odpowiedź. Same nie tworzą odpowiedzi ani nie dowodzą, że pobrana treść potwierdza jej twierdzenia.
Praktyczna granica to dane wejściowe → żądanie → wynik → akceptacja w aplikacji. Ostatni etap należy do Ciebie. Wygenerowane pole faktury nadal wymaga walidacji; obraz nadal wymaga przeglądu; odpowiedź wsparcia nadal wymaga zgody na złożenie obietnicy, którą zawiera.
Wybory protokołów również się różnią. Dokumentacja Google rozróżnia standardowe generowanie, strumieniowanie i interakcję na żywo. Traktuj to jako dowód, że tryby interakcji się różnią, zamiast zakładać identyczne wsparcie gdzie indziej. (Dokumentacja Google Gemini API, dostęp: wrzesień 2026.)
Generatywne API AI dla programistów: jak wybierać
Napisz krótki brief akceptacyjny, zanim zaczniesz porównywać katalogi. Dla funkcji ilustracji redakcyjnej może on określać wynik w orientacji poziomej, ograniczoną liczbę obiektów, brak widocznych znaków firmowych i etap przeglądu przez człowieka. Dla klasyfikacji zgłoszeń może określać stały zestaw etykiet i jawny wynik niepewny.
Oceniaj kandydatów w tej kolejności:
- Dane wejściowe i wyjściowe. Sprawdź konkretny endpoint modelu pod kątem obsługiwanych plików, limitów danych wejściowych, formatów wyjściowych i zachowania przy obrazach referencyjnych. Nazwa rodziny modeli jest zbyt ogólna, by służyć jako umowa.
- Zgodność z zadaniem. Wypróbuj reprezentatywne briefy, w tym te niewygodne. Licz błędy ograniczeń osobno od błędów plików lub sieci, aby wiedzieć, co wymaga poprawy.
- Dopasowanie integracji. Potwierdź uwierzytelnianie, koperty odpowiedzi, wartości statusu zadania i wsparcie bibliotek klienckich. Uwzględnij pracę potrzebną do dostosowania ich do Twojego istniejącego backendu.
- Czas oczekiwania i współbieżność. Zdecyduj, czy użytkownicy mogą odejść i wrócić. Przetestuj oczekiwane obciążenie, zanim zobowiążesz się do interaktywnego doświadczenia z krótkim terminem.
- Jasność rozliczeń. Ustal jednostkę rozliczeniową i to, które ustawienia ją zmieniają. Sprawdź obsługę błędów i zwrotów, zamiast zakładać, że każde wysłane żądanie wiąże się z tą samą opłatą.
- Wymagania dotyczące danych. Przejrzyj obsługę danych wejściowych, przechowywanie, usuwanie i obowiązujące warunki w odniesieniu do rzeczywistych danych, które zamierzasz wysłać. Udokumentuj nierozstrzygnięte kwestie przed użyciem materiałów wrażliwych.
- Zarządzanie zmianami. Prowadź zestaw regresyjny i zapisuj identyfikatory modeli, prompty i parametry. Zaplanuj, jak ponownie ocenisz działanie po aktualizacji lub wymianie.
Wytyczne instytucjonalne pokazują, dlaczego zasady dostępu i danych należą do tej decyzji: Harvard opisuje zatwierdzone ścieżki dostępu i ograniczenia dotyczące swoich narzędzi AI dla programistów. To rozwiązania Harvardu, a nie uniwersalne uprawnienia dla Twojej aplikacji. (Harvard University Information Technology, dostęp: wrzesień 2026.)
| Ścieżka dostępu | Odpowiedni zespół | Praca integracyjna | Odpowiedzialność operacyjna | Główne ograniczenie | Zweryfikuj przed wyborem |
|---|---|---|---|---|---|
| Bezpośredni dostawca modelu | Zespół skupiony na możliwościach jednego dostawcy | API, konta i adaptery specyficzne dla dostawcy | Twoja aplikacja i zadania; wnioskowanie dostawcy | Dodatkowi dostawcy wiążą się z odrębnymi umowami | Funkcje endpointu, regiony, limity, warunki |
| Hostowana platforma wielu modeli | Zespół oceniający kilka obsługiwanych modeli | Wspólny dostęp plus walidacja specyficzna dla modelu | Twoja aplikacja i zadania; wnioskowanie hostowane na platformie | Wspólny dostęp nie standaryzuje każdego parametru | Konkretne modele, schematy, rozliczenia, ścieżka danych |
| Samodzielnie hostowany model otwarty | Zespół z umiejętnościami w zakresie infrastruktury i obsługi modeli | Wdrażanie, udostępnianie, zabezpieczanie i utrzymanie wnioskowania | Sprzęt, obsługa, skalowanie, monitorowanie, aktualizacje | Koszty związane z wydajnością i inżynierią | Licencja, dopasowanie sprzętu, przepustowość, utrzymanie |
Atlas Cloud to jedna z hostowanych opcji do oceny, gdy w tej samej aplikacji mają znaleźć się możliwości kilku modeli. W tym artykule jej interfejs zadań obrazowych posłużył jako konkretny przykład. Nadal musisz zweryfikować dane wejściowe i wyjściowe każdego modelu; sama zmiana identyfikatora modelu nie wystarczy.
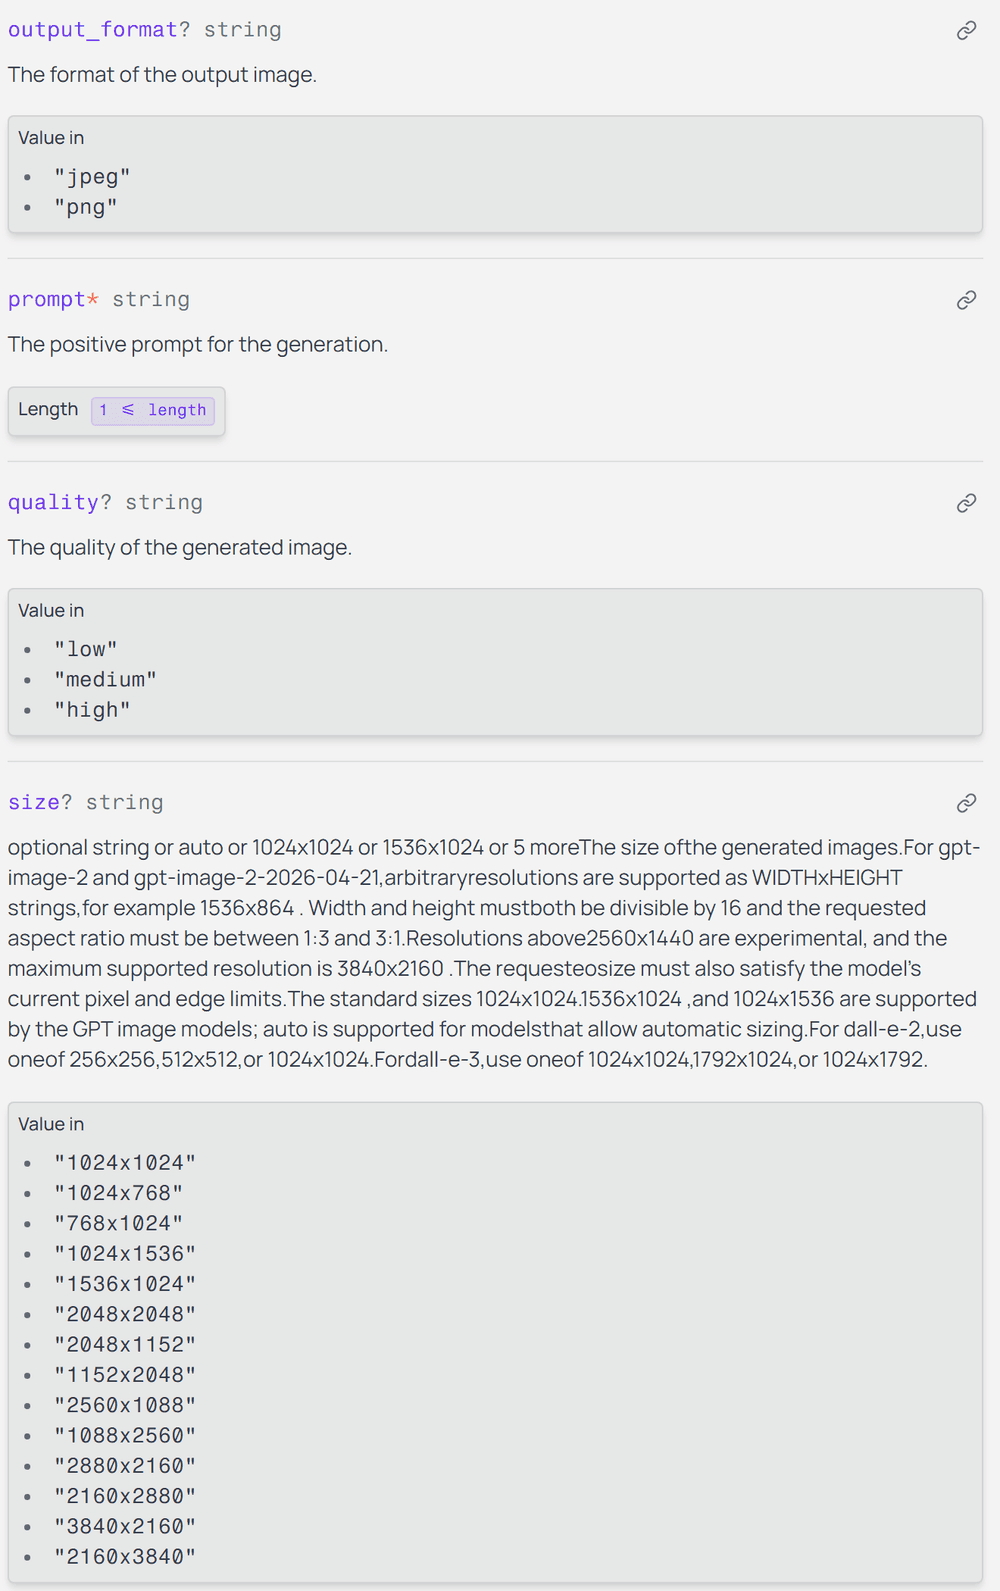
Oficjalna dokumentacja endpointu obrazów pokazująca format wyjściowy, jakość i ograniczenia rozmiaru
Parametry specyficzne dla modelu są częścią umowy integracyjnej. Przeczytaj ich dozwolone wartości, zanim ponownie użyjesz treści żądania.
Dla małego zespołu SaaS użytecznym porównaniem jest całkowity nakład pracy potrzebny do dostarczenia jednego zaakceptowanego wyniku. Uwzględnij kod adaptera, analizę wsparcia, czas przeglądu i testy migracyjne obok opłaty za wnioskowanie. Dzięki temu wygodny prototyp nie ukryje kosztownego procesu produkcyjnego.
Generatywne API AI dla programistów: pierwsze żądanie
W przykładzie użyto GPT Image 2 Text-to-Image, z identyfikatorem modelu openai/gpt-image-2/text-to-image. Dokumentacja jego endpointu wymienia quality: high, size: 2048x1152 i output_format: png. To ustawienia żądane w poniższych przykładach.
1. Ustal prompt w playgroundzie. Użyj poniższego briefu śniadaniowego bez dodawania obrazu referencyjnego. Sprawdź nazwę modelu i zatwierdzone ustawienia przed naciśnięciem przycisku Uruchom. Wybór, który cofa się po opuszczeniu pola, nie jest ustawieniem, o które prosiłeś.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Trzymaj uwierzytelnianie po stronie serwera. Twój frontend powinien poprosić własny backend o rozpoczęcie zadania. Przechowuj ATLAS_API_KEY w środowisku serwera. Nigdy nie umieszczaj go w JavaScripcie w przeglądarce, adresach URL obrazów ani logach widocznych dla klienta. Ustaw ATLAS_API_HOST na api.atlascloud.ai; to nazwa hosta, bez schematu i ścieżki.
3. Wyślij raz i zapisz identyfikator. Udokumentowana trasa generowania to POST /api/v1/model/generateImage. Odczytaj data.id, a następnie zapisz go przy zadaniu w Twojej aplikacji. Jeśli odpowiedź na wysłanie zostanie utracona, zbadaj sprawę, zanim utworzysz kolejne potencjalnie płatne zadanie.
4. Odpytuj zapisane zadanie. Wywołaj GET /api/v1/model/prediction/{prediction_id}. Dokumentacja predykcji opisuje stany processing, completed i failed, z adresami URL wyników w data.outputs. Status ukończenia nadal należy sprawdzić pod kątem niepustej tablicy wyników.
5. Pobierz i zwaliduj. Zapisz plik pod własną kontrolą, sprawdź, czy daje się zdekodować, i obejrzyj go pod kątem zgodności z briefem. Dopiero wtedy zwróć zaakceptowany wynik do aplikacji. Błąd pobierania lub walidacji powinien pozostać przypisany do istniejącego zadania.
Poniższy kod został złożony z oficjalnej dokumentacji interfejsu. Nie jest przedstawiany jako test wydajności działającego API. Proces pracy z mediami w tym artykule korzysta z testowego playgroundu w przeglądarce, a nie z klucza API.
Zapisz dokładnie prompt śniadaniowy jako prompt.txt. W Node.js użyj środowiska z wbudowanym fetch, zainstaluj sharp i zapisz ten kod jako generate.mjs. Uruchom go w dedykowanym katalogu roboczym. Uruchom tylko jeden z dwóch przykładów językowych, chyba że celowo chcesz mieć dwa zadania.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
Krótszy odpowiednik w Pythonie używa requests i Pillow, tego samego pliku prompt.txt i identycznych ustawień. Przyjmuje również PREDICTION_ID do wznowienia. Te skrypty demonstrują jedno lokalne zadanie; wdrożona usługa potrzebuje trwałych rekordów zadań i ograniczonych pobierań.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
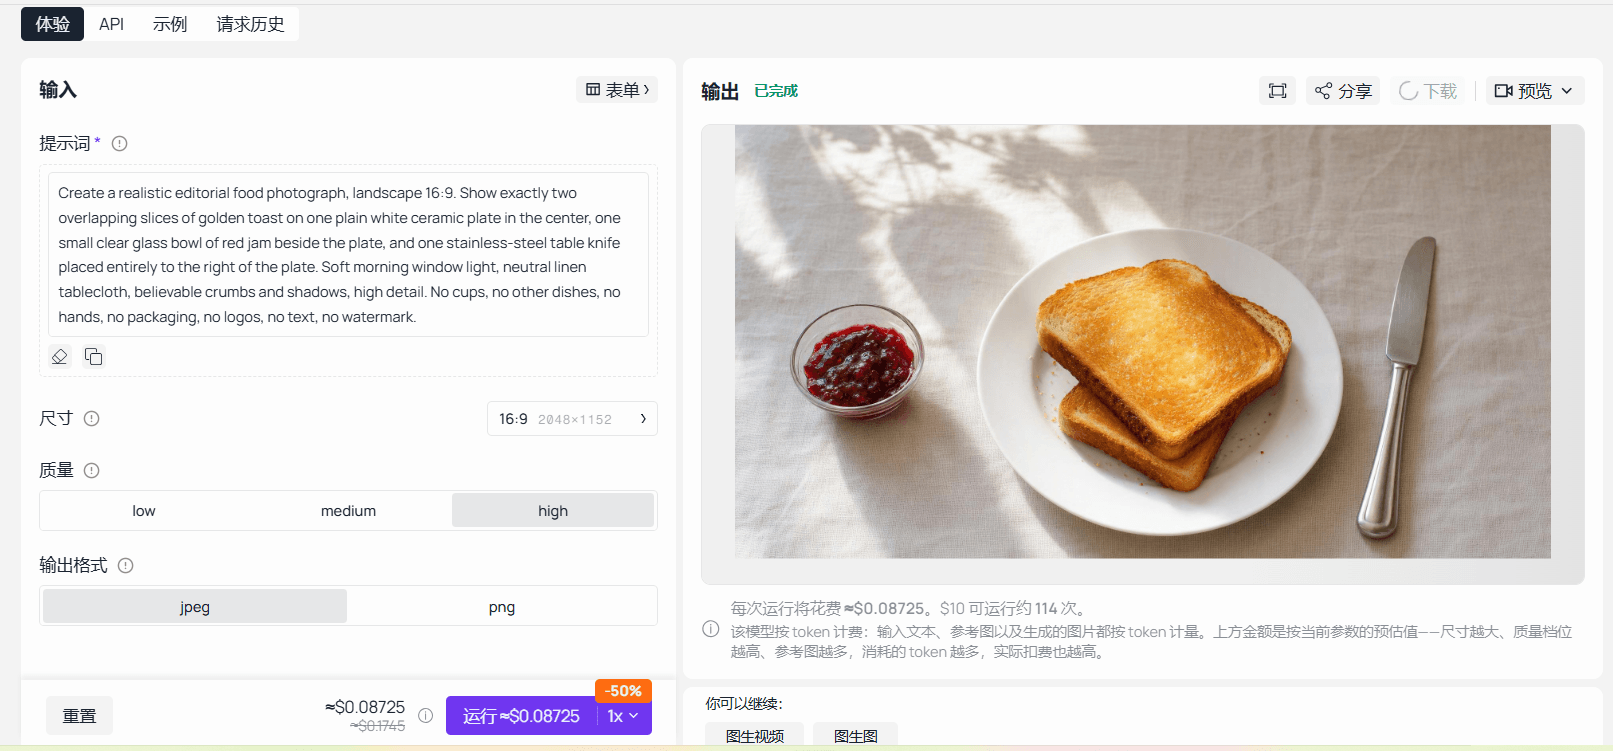 Ukończony playground GPT Image 2 pokazujący wysłany prompt śniadaniowy i gotowy wynik
Ukończone uruchomienie w playgroundzie zapisuje razem wysłany prompt, rozmiar wyniku, ustawienie jakości i wygenerowany rezultat.
Termin odpytywania powstrzymuje tego klienta przed dalszym oczekiwaniem; nie anuluje jednak pracy po stronie serwera. Żądanie już w toku może zakończyć się po zakończeniu okna odpytywania, więc nie jest to ścisła gwarancja opóźnienia end-to-end. Zachowaj identyfikator i pozwól procesowi roboczemu sprawdzić go później.
Generatywne API AI dla programistów: praktyczne zastosowania
Poniższe 3 briefy testują różne wymagania. To niezależne żądania, a nie łańcuch, w którym jeden wynik staje się następnym wejściem. Zachowaj ten sam model i żądane ustawienia, aby różnice między briefami pozostały łatwe do zrozumienia.
A. Redakcyjny obraz kulinarny: liczba i rozmieszczenie. Prompt śniadaniowy sprawdza, czy wynik zawiera 2 kromki tostu, 1 talerz, 1 miseczkę dżemu i 1 nóż. Nóż musi znajdować się po prawej stronie talerza, a wszystkie wymagane obiekty muszą pozostać w kadrze.
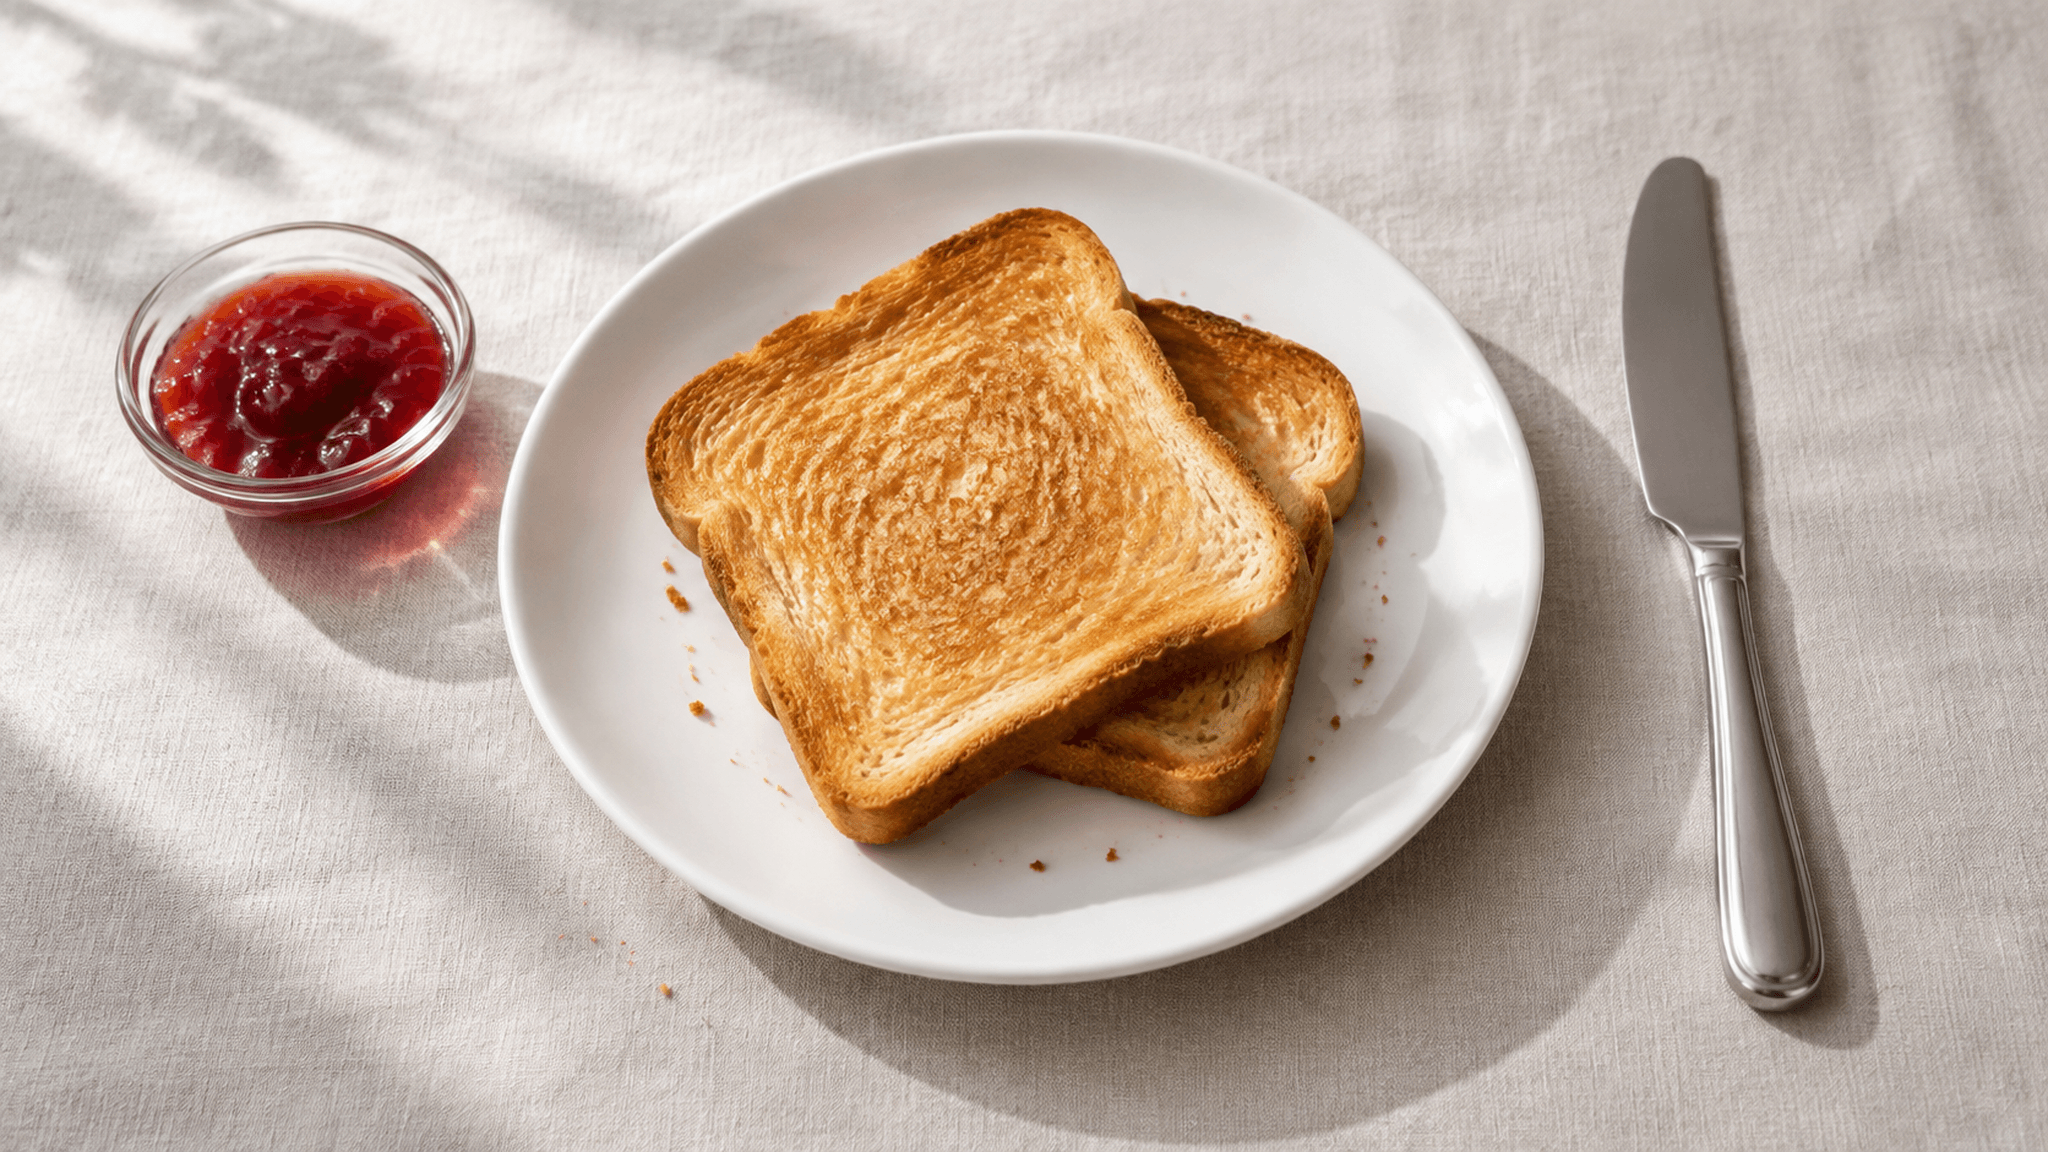
Przykład generowania obrazu śniadania wraz z kontrolą liczby obiektów i rozmieszczenia nożas_Twygenerowany wynik zawiera żądany talerz, tost, miseczkę dżemu i nóż po prawej stronie, gotowy do poniższego przeglądu rozmieszczenia.
Oglądaj nakładające się kromki pojedynczo. Wizualnie przekonujące śniadanie może mimo to zostać odrzucone, jeśli w tle pojawi się kubek albo nóż przesunie się na talerz. Jeśli wynik nie przechodzi kontroli, popraw niejednoznaczną instrukcję przestrzenną, zmień jedną zmienną i zachowaj powód odrzucenia. Nie proś wielokrotnie o ogólnie lepszy obraz.
B. Okładka artykułu: użyteczna przestrzeń na nagłówek. To żądanie traktuje kompozycję jako zależność układu. Redaktor strony potrzebuje pustej przestrzeni po lewej, podczas gdy prawa strona zawiera narzędzia i doniczkę. Właściwy tytuł dodaj później za pomocą HTML/CSS, aby pozostał edytowalny i czytelny.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
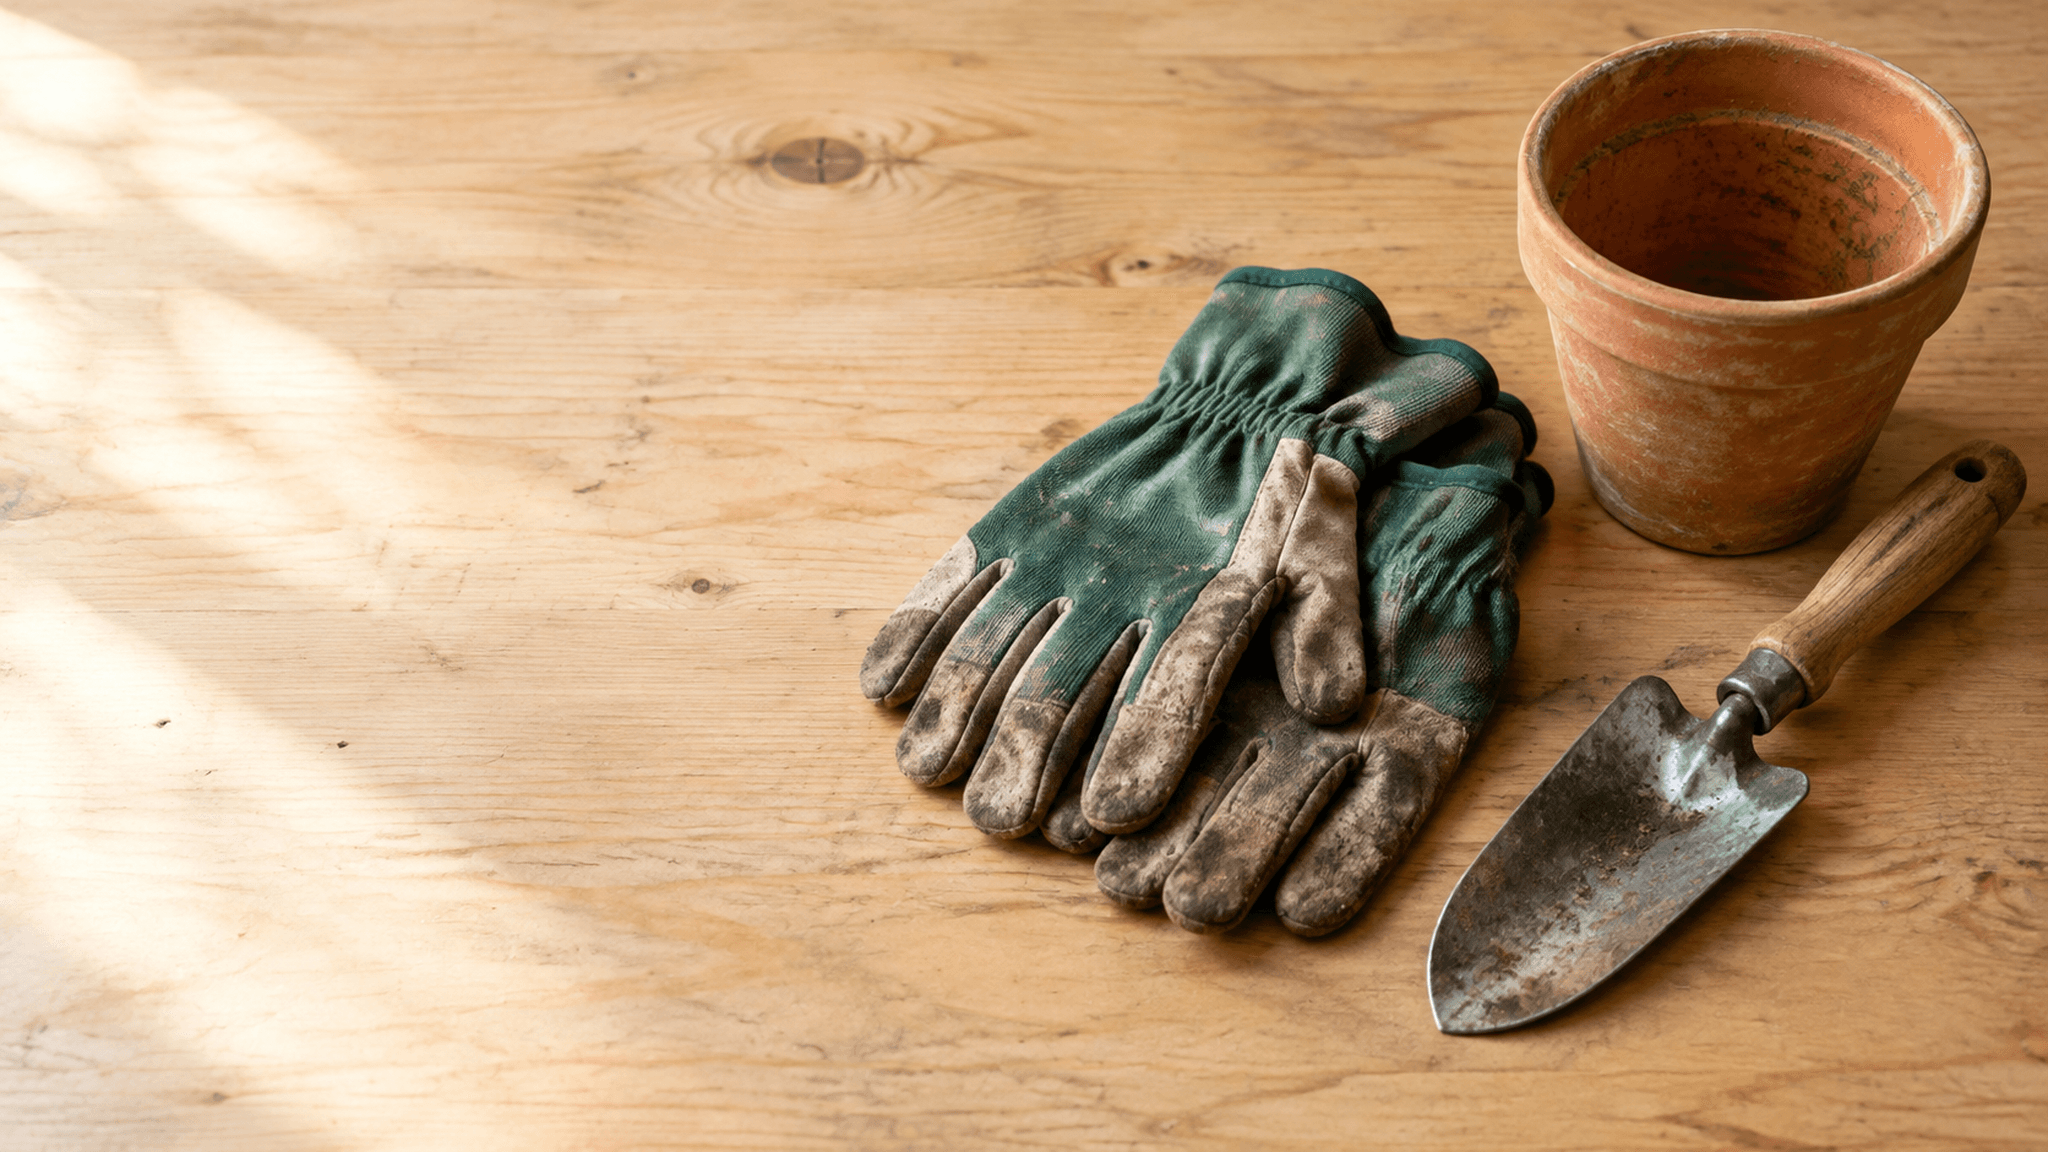 Przykład okładki ze stołem warsztatowym pokazujący żądaną przestrzeń na nagłówek po lewej i obiekty po prawej
Wynik zachowuje użyteczną pustą przestrzeń po lewej, utrzymując rękawice, doniczkę i łopatkę po prawej.
Sprawdź wynik w docelowym kadrze publikacji. Poziomy materiał główny może stracić użyteczny pusty obszar, gdy karta mobilna kadruje centralnie. Jeśli kompozycja nie przechodzi kontroli, określ ściślejsze granice obiektów lub zmień kadrowanie w aplikacji. Nie ukrywaj niepowodzenia, umieszczając tekst na żądanych obiektach.
C. Ilustracja tkanin: detal i kolejność. Następne żądanie prosi o 3 złożone próbki tkanin o rozróżnialnych widocznych fakturach. Testuje liczbę, położenie i to, czy wynik nadaje się na ilustrację objaśniającą w rozmiarze, w jakim zobaczą ją czytelnicy.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
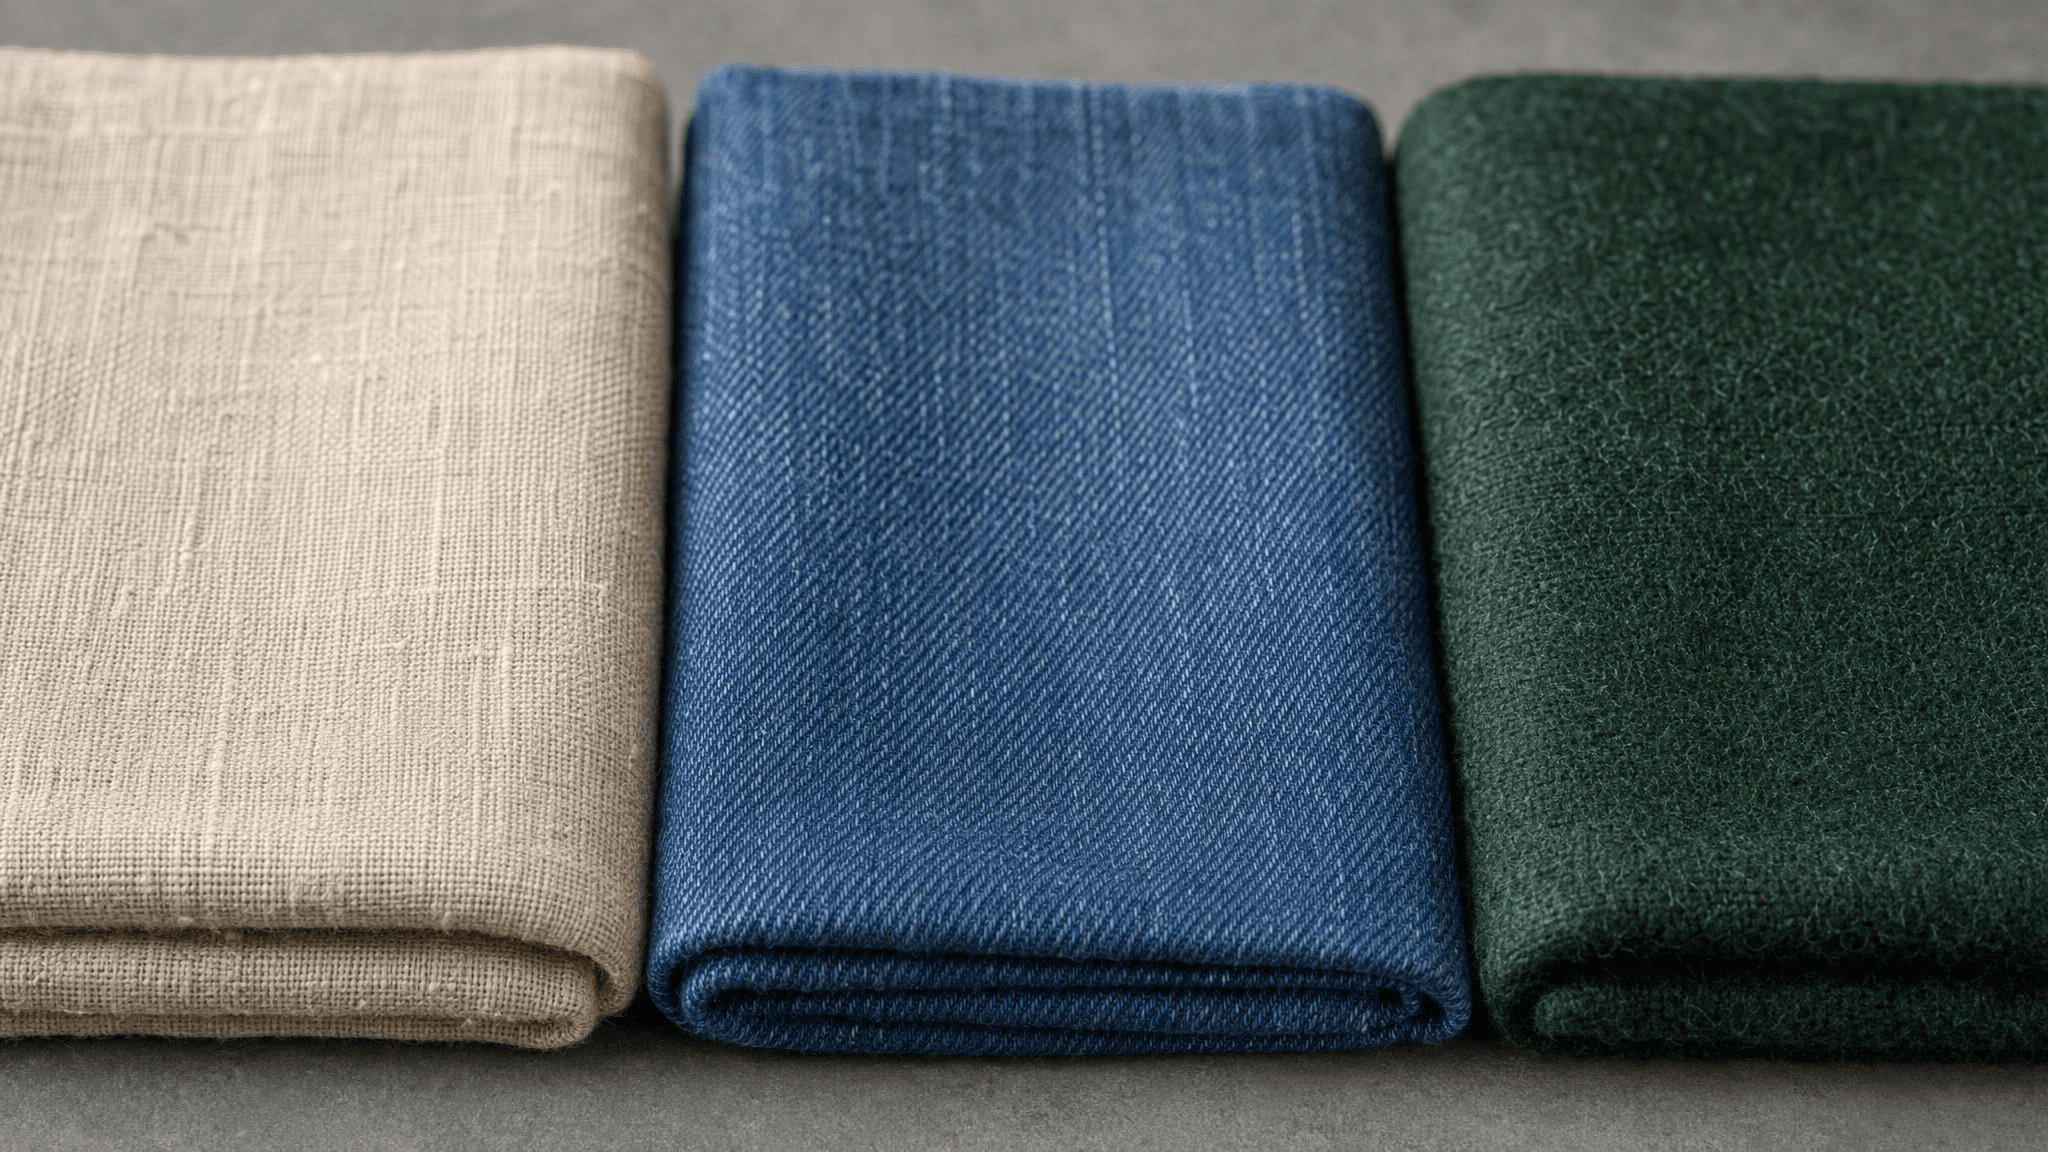 Wygenerowana przez AI ilustracja tkanin z kontrolą rozmieszczenia próbek w kolorze beżowym, niebieskim i ciemnozielonym
Trzy żądane próbki są wizualnie rozróżnialne. Ta wygenerowana faktura to ilustracja, a nie dowód na skład włókien rzeczywistego produktu.
Jeśli środkowa próbka nie ma czytelnego splotu, zapisz ten problem i dostosuj kadrowanie lub instrukcję dotyczącą detalu. Nigdy nie opisuj wygenerowanej faktury jako zmierzonej właściwości rzeczywistego produktu.
Funkcje tekstowe wymagają podobnie precyzyjnych kontroli. W przypadku klasyfikacji zgłoszeń odrzucaj etykiety spoza dozwolonego zestawu i zachowaj ścieżkę niepewności. W przypadku ekstrakcji z dokumentów wymagaj pól i fragmentów źródłowych obok możliwego do sparsowania JSON-a. Składniowo poprawna odpowiedź może nadal umieścić niewłaściwą kwotę w niewłaściwym polu.
Generatywne API AI dla programistów: obsługa błędów
Śledź osobno sukces transportu, ukończenie zadania i akceptację biznesową. Udana odpowiedź HTTP może zawierać zadanie w trakcie przetwarzania. Ukończone zadanie może dać uszkodzone pobranie. Czytelny obraz może naruszać brief. Każdy przypadek wymaga innego działania naprawczego.
Ustaw świadomie 3 zegary: indywidualny limit czasu HTTP, interwał odpytywania i całkowite okno oczekiwania. W przykładach zastosowano 30-sekundowy limit czasu żądania API, 2-sekundowe odpytywanie i 10-minutowe okno odpytywania. To wybory aplikacji, a nie reklamowana wydajność usługi.
| Objaw | Możliwa przyczyna | Co sprawdzić dalej | Podejście do ponawiania |
|---|---|---|---|
| Błąd parametru | Nieobsługiwane pole lub wartość | Dokładny schemat endpointu i wysłana treść żądania | Najpierw popraw żądanie |
| HTTP 401 | Problem z uwierzytelnianiem lub błędna trasa | Konfiguracja klucza i ścieżka endpointu | Brak ponawiania bez zmian |
| Niewystarczające saldo | Dostępne saldo lub limit | Stan rozliczeń konta | Najpierw uzupełnij środki lub limit |
| HTTP 429 | Osiągnięto limit szybkości | Współbieżność konta/modelu i szybkość żądań | Ograniczone opóźnienie z losowym rozrzutem |
| Zadanie zgłasza błąd | Błąd modelu, danych wejściowych lub polityki | Identyfikator predykcji, kod błędu, szczegóły błędu | Zbadaj, zanim uruchomisz nowe generowanie |
| Limit czasu odpytywania | Termin klienta lub wolne zadanie | Status istniejącego zadania | Wznów odpytywanie tego samego identyfikatora |
| Ukończone z pustym wynikiem | Brakujący lub nieoczekiwany wynik | Pełna strukturalna odpowiedź zadania | Oznacz do zbadania; bez ponownego wysyłania na ślepo |
Bieżąca dokumentacja błędów platformy mówi, że endpointy LLM i mediów nie udostępniają nagłówków Retry-After ani pozostałego limitu szybkości. Stosuj politykę opóźnień po stronie klienta; nie uzależniaj odzyskiwania od nagłówka, którego te trasy nie zwracają. Inne rodziny API mogą zachowywać się inaczej.
Utrzymuj automatyczne ponawianie odczytów w ograniczonych ramach. Opóźnienia wykładnicze plus niewielki losowy rozrzut pomagają zapobiec jednoczesnemu ponawianiu przez wielu procesów roboczych. Zmniejsz współbieżność, jeśli ograniczanie ruchu się utrzymuje. Powtarzające się błędy powinny stać się obserwowalnym incydentem, a nie nieskończoną pętlą ukrytą za wskaźnikiem ładowania.
Ponawianie wysyłania zasługuje na bardziej rygorystyczne podejście. Gdy połączenie zamyka się po wysłaniu treści, możesz nie wiedzieć, czy serwer utworzył zadanie. Zapisz lokalny zamiar przed wysłaniem i zbadaj historię żądań lub ślady wsparcia, gdy nie pojawi się identyfikator predykcji. Nie wymyślaj nagłówka idempotencji, chyba że endpoint go dokumentuje.
Gdy masz identyfikator, użyj go do wznowienia. Błąd pobierania powinien wywołać kolejną próbę pobrania lub sprawdzenie statusu, a nie kolejne żądanie generowania obrazu. Przykłady celowo zachowują automatyczne ponawianie przy odczytach odpytywania i zatrzymują się przy nieudanym wysłaniu.
Dla każdego zadania zachowuj identyfikator zadania w aplikacji, identyfikator predykcji, identyfikatory żądań, model, ustawienia, znaczniki czasu i końcowy wynik. Przechowuj prompty wyłącznie zgodnie z odpowiednią polityką danych. Nigdy nie umieszczaj nagłówków autoryzacji ani wrażliwych treści użytkownika w ogólnych logach błędów.
Zapewnij frontendowi stany, które potrafi wyjaśnić: przygotowywanie, przetwarzanie, sprawdzanie wyniku, gotowe lub wymaga uwagi. Pokazuj zadanie możliwe do wznowienia, gdy ktoś odświeży stronę. Wyłącz wielokrotne wysyłanie, gdy to samo lokalne zadanie jest w toku, ale nadal pozwalaj na celowe nowe żądanie, gdy jest to właściwe.
Generatywne API AI dla programistów: rzeczywiste koszty
Niska cena żądania nie mówi, ile kosztuje funkcja, z której można korzystać. Twój budżet potrzebuje kwoty pobranej opłaty, liczby zaakceptowanych wyników i pracy wspierającej wymaganej do ich dostarczenia.
API tekstowe zwykle rozróżniają tokeny wejściowe i wyjściowe. Długi kontekst, pobrane fragmenty, historia rozmowy i powtarzane odpowiedzi mogą przyczyniać się do zużycia. Zapisuj kategorie, które wybrany endpoint faktycznie rozlicza, zamiast stosować jedno oszacowanie liczby tokenów do każdego obciążenia.
W przypadku obrazów sprawdź jednostkę rozliczeniową i konfigurację konkretnego modelu. Rozmiar i jakość mogą wpływać na rozliczenia różnie w zależności od modelu. W przypadku wideo koszt może zmieniać długość, rozdzielczość i wybór modelu. Nie zamieniaj ceny startowej z katalogu na wycenę konkretnej konfiguracji.
Dokładna cena wybranego modelu obrazowego w jakości high i rozmiarze 2048 × 1152 nie została zweryfikowana jednocześnie w katalogu i na stronie szczegółów podczas badań do tego artykułu. Nie podaje się tu żadnej aktualnej ceny jednostkowej ani rabatu. Potwierdź ją przed przeprowadzeniem płatnej oceny produkcyjnej.
Użyj 2 powiązanych obliczeń:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Utrzymuj spójny okres obserwacji. W przypadku stałego przechowywania określ, czy obliczenie obejmuje pierwszy miesiąc, zdefiniowany okres przechowywania czy przypisany koszt cykliczny. Unikaj porównywania liczby dotyczącej wyłącznie wnioskowania jednego modelu z pełnym kosztem innego procesu.
Przykład hipotetyczny: wysyłasz 100 żądań i akceptujesz 80 wyników. Podziel rzeczywistą łączną opłatę za tę partię przez 80. Gdyby wszystkie 100 żądań zostało obciążonych identyczną kwotą c, koszt API na zaakceptowany wynik wyniósłby 1.25c. Ten warunek ma znaczenie: nie zakłada, że każde nieudane żądanie jest rozliczane.
| Model | Ustawienia | Wysłane żądania | Rzeczywista opłata | Zaakceptowane wyniki | Koszt API na zaakceptowany wynik | Data pomiaru |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | Do zapisania | Do zapisania | Do zapisania | Do obliczenia | Do zapisania |
| Ten sam model, następna partia oceny | Zapisz dokładne ustawienia | Do zapisania | Do zapisania | Do zapisania | Do obliczenia | Do zapisania |
Traktuj to jako arkusz roboczy, a nie tabelę wyników. Demonstracje obrazów nie ustalają reprezentatywnego wskaźnika akceptacji ani kosztu produkcyjnego. Trzymaj szacunki z playgroundu osobno od rozliczonych rekordów płatności, zwłaszcza przy ocenie w środowisku testowym.
Gdy liczba zaakceptowanych wyników wynosi zero, zgłoś partię jako nieudaną i pokaż całkowite wydatki. Wskaźnik kosztu na zaakceptowany wynik jest wtedy nieokreślony. Ukrywanie nieudanych partii sprawiłoby, że budżet wyglądałby lepiej niż działanie aplikacji.
Najpierw ogranicz marnotrawstwo: waliduj dane wejściowe przed wysłaniem, zapisuj identyfikatory zadań, zapobiegaj przypadkowym duplikatom i ponownie wykorzystuj zaakceptowane zasoby, gdy produkt na to pozwala. Następnie porównaj tańsze ustawienia na tych samych briefach i kontrolach. Ustawienie, które obniża wycenę, ale podwaja pracę związaną z odrzuceniami, może zwiększyć koszt funkcji.
Testuj wynik, nie tylko odpowiedź
Pisz kryteria akceptacji już podczas tworzenia promptu. Zapobiega to zmianie definicji sukcesu po fakcie przez przekonujący obraz. Trzymaj twarde wymagania osobno od opcjonalnych preferencji i zapisuj, dlaczego recenzent odrzucił wynik.
Automatyzuj kontrole, które mają jasne, mechaniczne odpowiedzi: powodzenie pobrania, dekodowanie pliku, format, wymiary i limity rozmiaru pliku. W przypadku JSON-a waliduj schemat, wymagane pola, dozwolone etykiety i typy. Brakujące wymagane pole nie powinno po cichu stać się wymyśloną wartością domyślną.
Wykorzystuj przegląd przez człowieka przy wymaganiach, które wymagają interpretacji. W przykładzie ze śniadaniem recenzent musi rozróżnić nakładające się kromki, rozpoznać nóż, ocenić jego położenie i wypatrzyć dodatkowe obiekty. Zautomatyzowany program sprawdzający obraz może pomóc, ale oceń jego błędy, zanim pozwolisz mu samodzielnie zatwierdzać wyniki.
Przegląd śniadania powinien obejmować następujące niezależne kontrole:
- Dokładnie 2 kromki tostu, 1 biały talerz, 1 przezroczysta miseczka dżemu i 1 nóż.
- Nóż po prawej stronie talerza; wymagane obiekty w pełni w kadrze.
- Brak dodatkowych kubków, naczyń, dłoni, opakowań ani widocznych znaków firmowych.
- Czytelny plik PNG w żądanych wymiarach.
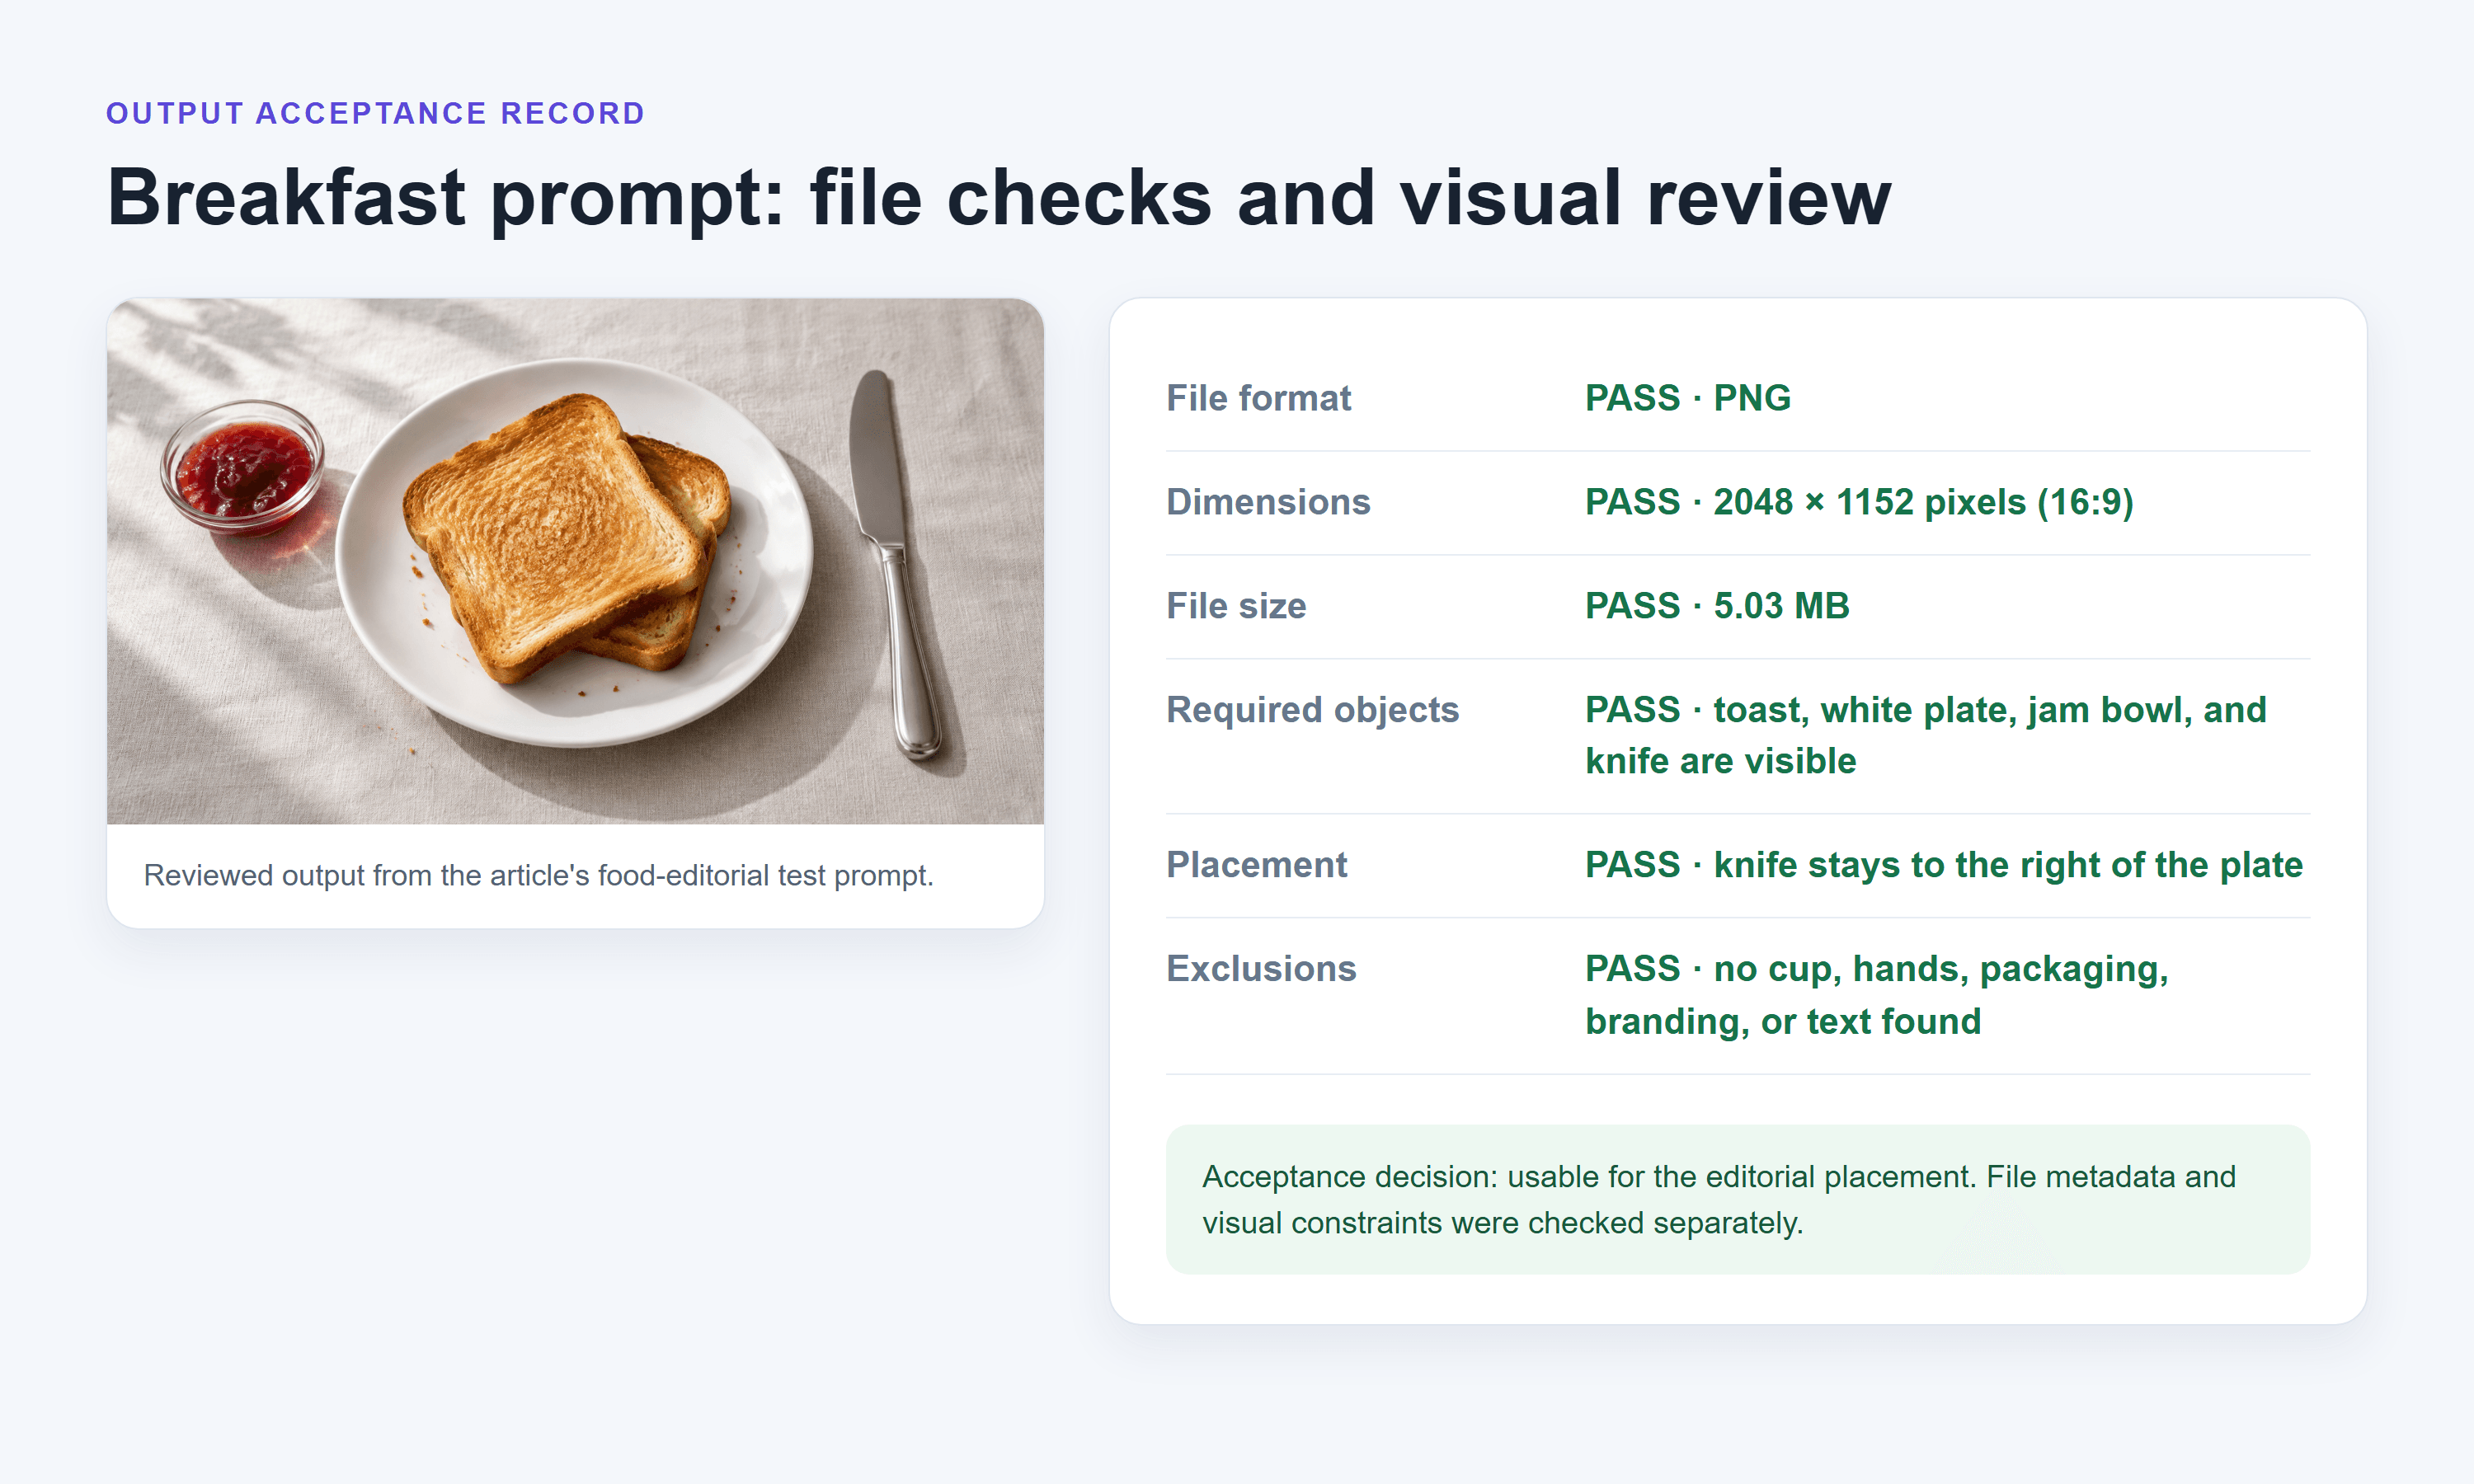 Rekord walidacji oddzielający kontrole metadanych pliku od wizualnych kontroli akceptacji
Rekord podaje rzeczywiste wymiary i rozmiar wygenerowanego pliku osobno od jego wizualnych kontroli akceptacji.
Zbuduj stały zestaw regresyjny na podstawie rzeczywistej funkcji: zwykłe żądania, zatłoczone kompozycje, sprzeczne instrukcje, trudne kadrowania i odpowiednie limity danych wejściowych. Wersjonuj briefy i zasady recenzenta. Powtarzaj je przy zmianie modelu, szablonu promptu lub ustawień wyjściowych.
Raportuj osobno sukces techniczny i wskaźnik zaakceptowanych wyników. Czytelny plik zawierający dodatkowy obiekt liczy się jako udane dostarczenie i odrzucenie treści. Łączenie tych wyników w jedną liczbę sukcesu ukrywa poprawkę, której potrzebuje Twój zespół.
Badanie deweloperów z 2025 r. wykazało, że 46% nie ufało dokładności narzędzi AI, a 33% jej ufało; 3% zgłosiło wysokie zaufanie. Te odpowiedzi dotyczą narzędzi AI w procesach tworzenia oprogramowania, a nie zmierzonego wskaźnika błędów API generowania. (Stack Overflow Developer Survey, 2025.)
Podobnie 3 poglądowe uruchomienia nie mogą ustalić ogólnej dokładności ani użytecznego opóźnienia p95. Zbierz większą, istotną próbę w warunkach, których oczekujesz w produkcji, i zachowuj wartości odstające. Użyj demonstracji do opracowania kontroli, a następnie systematycznej oceny do podjęcia decyzji o wydaniu.
Lista kontrolna dla produkcji przed wdrożeniem
Pierwsze działające żądanie rozstrzyga tylko niewielką część decyzji o wydaniu. Twoja aplikacja musi także kontrolować wydatki, wznawiać niedokończoną pracę i wyjaśniać, co się stało, gdy wynik jest niedostępny.
Chroń dostęp. Trzymaj poświadczenia na backendzie, rozdziel środowiska, ogranicz dostęp do rekordów zadań i zaplanuj rotację poświadczeń. Autoryzuj każde żądanie statusu i pobrania względem użytkownika, do którego należy to zadanie. Nieodgadywalny identyfikator zadania nie zastępuje kontroli uprawnień.
Ogranicz dane wejściowe i zużycie zasobów. Waliduj długość promptu, typ i rozmiar przesyłanego pliku, żądane ustawienia wyjściowe i obsługiwane kombinacje. W przypadku pobieranych mediów egzekwuj dozwolone miejsca docelowe, przekierowania, limity bajtów i limity dekodowania. Kompaktowe skrypty powyżej ilustrują cykl życia; nie są utwardzoną publiczną usługą pobierania.
Ustal budżety przed wysłaniem. Zdefiniuj limity na użytkownika i na zadanie, maksymalną liczbę równoczesnych zadań oraz to, kto może żądać droższych ustawień. Rezerwuj budżet, gdy praca jest w toku, aby równoczesne żądania nie mogły wszystkie przejść tego samego sprawdzenia pozostałego salda.
Utrwal stan. Zapisz lokalne zadanie przed wywołaniem dostawcy. Natychmiast zapisz zwrócony identyfikator predykcji i umożliw wznowienie odpytywania po restarcie procesu. Jeśli status wysłania jest nieznany, użyj stanu „do zbadania”, zamiast mówić użytkownikom, że zadanie z pewnością się nie udało.
Zapanuj nad dostarczonym zasobem. Zdecyduj, gdzie przechowywane są zaakceptowane pliki, kto ma do nich dostęp i kiedy wygasają. Zweryfikuj czas życia linków dostawcy i warunki przechowywania, zamiast polegać bez końca na tymczasowym adresie URL wyniku. Uwzględnij usuwanie plików pochodnych w procesie danych aplikacji.
Spraw, by błędy były zrozumiałe. Rozróżniaj opóźnione zadanie, odrzucony wynik i błąd usługi. Zaproponuj jasną ścieżkę celowego ponowienia lub zgłoszenia do przeglądu. Zachowaj brief użytkownika, aby odzyskanie nie wymagało odtwarzania pracy od zera.
Monitoruj zmiany. Śledź osobno ukończenie, akceptację, koszt i czas oczekiwania. Uruchom ponownie zestaw regresyjny po zmianach modelu lub parametrów i zachowaj poprzednią konfigurację tam, gdzie to wykonalne. Redaguj wrażliwe logi i przypisz okresy przechowywania zarówno do treści, jak i do rekordów operacyjnych.
Aby ocenić przykładową platformę pod kątem własnej aplikacji, zacznij od katalogu modeli Atlas Cloud, a następnie przeczytaj dokumentację wybranego endpointu i predykcji. Wybierz jedno zadanie, zdefiniuj akceptację i zapisz, co ocena faktycznie daje, zanim rozszerzysz dostęp.
Najczęściej zadawane pytania
Które generatywne API AI powinienem wybrać dla swojej aplikacji?
Wybieraj, kierując się danymi wejściowymi funkcji, wynikami, akceptowalnym czasem oczekiwania i wymaganiami dotyczącymi przeglądu. Uruchom te same reprezentatywne briefy na kandydatach, których możesz legalnie i operacyjnie używać. Porównaj koszt zaakceptowanego wyniku i pracę integracyjną obok możliwości. Te 3 przykłady obrazów nie ustalają uniwersalnego wyboru.
Czy istnieją darmowe generatywne API AI dla programistów?
Niektóre usługi oferują okresy próbne lub ograniczone darmowe użycie, ale dostępność, kwalifikowalność, limity i dozwolone zastosowania się zmieniają. Zweryfikuj aktualne warunki dla konkretnego endpointu. Darmowy limit w narzędziu konsumenckim niekoniecznie obejmuje dostęp do API. Samodzielne hostowanie również zużywa sprzęt, energię elektryczną i czas inżynierów, nawet gdy wagi modelu można pobrać.
Czy potrzebuję doświadczenia w uczeniu maszynowym, aby korzystać z generatywnego API AI?
Możesz zacząć od znajomości HTTP, JSON, uwierzytelniania i zwykłego programowania backendu. Dostarczenie niezawodnej funkcji wymaga dodatkowo pracy nad oceną i eksploatacją. Musisz rozumieć ograniczenia modelu na tyle, by zdefiniować akceptowalny wynik, niekoniecznie samodzielnie trenując model.
Czy jedno API może obsługiwać tekst, obrazy i wideo?
Platforma może udostępniać wszystkie 3, ale każda możliwość może używać innych endpointów, parametrów, typów wyników i wzorców oczekiwania. Zweryfikuj każdy interfejs osobno. Wspólne konto lub poświadczenie nie czyni treści żądania tekstowego zgodnej z modelem obrazu lub wideo.
Dlaczego moje żądanie obrazu zwraca identyfikator zadania zamiast obrazu?
Endpoint zleca pracę asynchronicznie. Zapisz identyfikator i odpytuj udokumentowaną trasę statusu. Pobierz plik, gdy zadanie się zakończy, a następnie go zwaliduj. Jeśli Twój klient przestanie czekać, zadanie po stronie serwera może nadal działać; wznów to zadanie, zanim wyślesz kolejne.
Jak mogę obniżyć koszty API, nie psując procesu pracy?
Zapobiegaj duplikatom wysyłania, waliduj dane wejściowe wcześnie, ponownie wykorzystuj zaakceptowane zasoby tam, gdzie to właściwe, i testuj tańsze konfiguracje według niezmienionych kryteriów akceptacji. Mierz rzeczywiste opłaty na zaakceptowany wynik. Generatywne API AI dla programistów zasługuje na swoje miejsce, gdy otaczająca je aplikacja potrafi dostarczać użyteczną pracę za koszt, który możesz utrzymać.


