API AI do generowania wsadowego jest przydatne, gdy każdy wynik można znaleźć, zweryfikować i ponowić niezależnie. To ma większe znaczenie niż liczba promptów wysyłanych jednocześnie. Kosztowny moment to nie żądanie numer 1000. To sytuacja, gdy zadanie 37 przekracza limit czasu, zadanie 38 kończy się sukcesem, dwa pliki mają tę samą nazwę i nikt nie potrafi powiedzieć, który obraz można bezpiecznie opublikować.
Traktuj partię wsadową jako zbiór odzyskiwalnych zadań zasobów. Nadaj każdemu zadaniu trwały identyfikator biznesowy, zapisz dokładny input i ustawienia modelu, ogranicz współbieżność i ponawiaj wyłącznie element, który faktycznie zawiódł. Ten przewodnik wykorzystuje przepływ pracy kampanii postaci z 8 zasobami, aby deweloper lub zespół ds. wzrostu mógł przekształcić manifest w kontrolowany przebieg produkcyjny.
Najważniejsze wnioski
- Zadanie wsadowe i żądania równoległe rozwiązują różne problemy związane z opóźnieniem i kontrolą.
- Stabilne identyfikatory zasobów i klucze idempotencji sprawiają, że częściowe niepowodzenie staje się zarządzalne.
- Zacznij od 4 do 8 zasobów wizualnych, zweryfikuj je, a następnie rozszerzaj.
- Pomyślna odpowiedź API nadal wymaga weryfikacji wizualnej i prawnej przed publikacją.
API AI do generowania wsadowego: odpowiedź na wstępie
API AI do generowania wsadowego przesyła zestaw odrębnych zadań generowania do asynchronicznej kolejki, a następnie zwraca ich wyniki poprzez sprawdzanie statusu, wywołanie zwrotne zakończenia lub plik wyjściowy do pobrania. Każde zadanie potrzebuje tożsamości istniejącej poza dostawcą modelu. Identyfikator zadania dostawcy pomaga w operacjach, ale maya-ridgeline-001 to element, który pozwala twojemu systemowi redakcyjnemu lub kampanijnemu zidentyfikować zasób wiele miesięcy później.
Nie mieszaj trzech powiązanych pojęć. Pojedynczy prompt może zażądać kilku wariantów. Twój własny worker może wysłać kilka zwykłych żądań jednocześnie. Zadanie wsadowe po stronie serwera to zarządzana przez dostawcę kolekcja, która kończy się później. Ta ostatnia opcja często pasuje do pracy offline, podczas gdy kontrolowane żądania równoległe pasują do panelu wymagającego natychmiastowego postępu.
Aktualna dokumentacja Batch API OpenAI ilustruje wzorzec asynchroniczny: żądania są gromadzone w JSONL, przesyłane jako zadanie, sprawdzane pod kątem zakończenia i pobierane jako wyniki. Jej 24-godzinne okno, oddzielne limity szybkości wsadowej i ograniczenia są specyficzne dla tej usługi, a nie obietnicą składaną przez każdego dostawcę obrazów (dokumentacja OpenAI Batch API, wrzesień 2026). Aktualna dokumentacja Gemini podobnie opisuje długotrwałe zadania wsadowe, sprawdzanie statusu i obsługę webhooków dla swojej usługi (dokumentacja Gemini Batch API, wrzesień 2026).
| Punkt decyzyjny | Batch API | Kontrolowane żądania równoległe |
|---|---|---|
| Oczekiwana odpowiedź | Odroczone zakończenie | Każde żądanie zwraca wynik po zakończeniu |
| Najlepsze dla | Praca offline nad katalogiem, storyboardem i biblioteką treści | Narzędzia interaktywne i krótkie pętle weryfikacji |
| Obsługa błędów | Odczyt wyników dla poszczególnych elementów po zakończeniu zadania | Obsługa każdego żądania podrzędnego w miarę jego rozstrzygania |
| Koszt i limity | Reguły wsadowe specyficzne dla dostawcy mogą różnić się od ruchu na żywo | Wykorzystuje zwykłe limity żądań konta |
| Istotny zapis | ID zasobu, ID żądania, stan wyniku, lokalizacja wyjścia | Te same pola plus stan próby w toku |
Wybierz kontrolowane żądania równoległe, gdy recenzent potrzebuje szybko zobaczyć pierwszy użyteczny obraz. Wybierz zadanie wsadowe po stronie serwera, gdy praca może poczekać, a dostawca dokumentuje ścieżkę wsadową. W obu przypadkach zapisz asset_id, znormalizowany input, hash referencyjny, model, liczbę prób i URL wyjścia. Ta wspólna warstwa utrzymuje przenośność przepływu pracy, jeśli mechanizm dostarczania ulegnie zmianie.
Dlaczego projekty wsadowe obrazów zawodzą na dużą skalę
Partie produkcyjne zwykle zawodzą fragmentarycznie. Żądanie może zostać ukończone, przekroczyć limit czasu, zostać odrzucone lub zwrócić wynik, który jest technicznie poprawny, ale wizualnie bezużyteczny. Aplikacja, która rejestruje tylko końcowy URL, odrzuca informacje potrzebne do odzyskania ze wszystkich, poza najprostszym przypadkiem sukcesu.
Pierwszym niepowodzeniem jest brak tożsamości. Jeśli żądanie zawiera tylko ciąg promptu, nie można wiarygodnie przypisać wyniku do produktu, lokalizacji kampanii ani wiersza źródłowego. Nazwy plików pochodzące z promptu są zawodne, ponieważ wersje promptów i powtarzające się produkty kolidują. Używaj stabilnego identyfikatora zasobu z rekordu biznesowego, a następnie nadaj każdej próbie generowania własny sufiks.
Drugim niepowodzeniem jest ponawianie bez idempotencji. Przekroczenie limitu czasu sieci nie dowodzi, że dostawca nie wykonał żadnej pracy. Jeśli worker natychmiast ponownie zgłasza ten sam zasób z nową tożsamością żądania, może utworzyć zduplikowane wyniki i zduplikowane opłaty. Klucz idempotencji pozwala wywołującemu powiedzieć w istocie: „to wciąż ten sam żądany zasób". To, czy konkretny punkt końcowy obsługuje ten mechanizm, zależy od dostawcy, więc potwierdź to w dokumentacji API, zanim na nim polegasz.
Trzecim niepowodzeniem jest ślepa kolejka 40 lub 60 promptów. Dryf koloru, kompozycji lub tożsamości produktu może stać się widoczny dopiero po zakończeniu przebiegu. Niedawna dyskusja twórców opisuje weryfikację stron storyboardu zawierających około 7 do 8 obrazów przed wysłaniem następnej strony, konkretnie w celu wychwycenia błędów dokładności i spójności (dyskusja o wsadowym generowaniu obrazów, czerwiec 2026). To doświadczenie społeczności, a nie benchmark, ale jest to rozsądny punkt kontrolny operacyjny.
Stosuj zasadę QC dla małych partii: uruchom 4 do 8 zasobów, sprawdź je, w razie potrzeby popraw prompt lub referencję, a następnie odblokuj następną grupę. Zachowaj oryginalny prompt, wersję promptu, referencję wejściową, wersję modelu, gdy jest dostępna, ustawienie jakości, proporcje, znaczniki czasu, klasę błędu i decyzję recenzenta. Sam URL nie może odpowiedzieć, dlaczego zasób istnieje lub czy powinien zostać ponownie wykorzystany.
Zaprojektuj niezawodne API AI do generowania wsadowego
Implementacja może być niewielka. Manifest, worker kolejki, rejestr zadań tylko do dopisywania i przyjazny dla recenzenta folder wyjściowy wystarczą na początek. Celem nie jest duży system orkiestracji. Celem jest przepływ pracy, w którym osoba może odpowiedzieć: o co poproszono, co się stało i co powinno zostać uruchomione dalej?
Nadaj każdemu wynikowi wsadowemu trwałą tożsamość zasobu
Uczyń asset_id kluczem biznesowym, a nie identyfikatorem zadania dostawcy. Przydatny rekord zadania może zawierać pola poniżej. Przechowuj go w bazie danych, gdy działa kilku workerów, lub w wersjonowanym pliku CSV plus logu JSONL dla mniejszego zespołu.
| Pole | Dlaczego istnieje |
|---|---|
asset_id | Niezmienna tożsamość zasobu nadającego się do publikacji |
source_row | Mapuje z powrotem do rekordu produktu, kampanii lub treści |
prompt_version | Pokazuje, który szablon instrukcji wygenerował wynik |
reference_hash | Potwierdza, który zablokowany obraz źródłowy został użyty |
model, aspect_ratio, quality | Czyni przebieg wystarczająco powtarzalnym do diagnozy |
attempt, idempotency_key, status | Oddziela ponowienie zadania podrzędnego od nowego żądania |
output_url, review_status, failure_reason | Łączy dostarczenie i akceptację człowieka |
Na przykład maya-train-001 pozostaje tożsamością zasobu. maya-train-001-a2 to próba 2. Klucz idempotencji może brzmieć maya-train-001-v1, gdzie v1 identyfikuje niezmienną specyfikację żądania. Jeśli brief zmieni się istotnie, utwórz nową wersję promptu zamiast nadpisywać stary rekord.
Używaj kolejki wsadowej, a nie nieograniczonej pętli
Ustaw pułap współbieżności, limit liczby zasobów, ograniczenie finansowe i limit ponowień przed wysłaniem. Praktyczna konfiguracja początkowa to 4 zadania w toku, maksymalnie 2 próby generowania na zadanie i nie więcej niż 8 zadań wizualnych przed następną bramką jakości. To wartości początkowe, a nie gwarancje platformy. Ustaw je poniżej udokumentowanych limitów konta i dostosuj po obserwacji rzeczywistych czasów ukończenia i wskaźników błędów.
Worker powinien pobrać jedno oczekujące zadanie, oznaczyć je jako submitted, zapisać identyfikator żądania dostawcy i zaktualizować ten sam rekord po nadejściu wyniku. Gdy limit budżetu zostanie osiągnięty, przestań pobierać pracę. Gdy kolejka jest wstrzymana do weryfikacji, pozwól już przesłanej pracy się zakończyć, ale nie zwalniaj automatycznie kolejnej grupy.
Ponawiaj tylko zadanie podrzędne, które zawiodło
Ponawiaj stany failed, timed_out lub specyficzne dla dostawcy stany podlegające ponowieniu, po jednym zasobie naraz. Stosuj ograniczony wykładniczy backoff z jitterem dla odpowiedzi 429, przejściowych odpowiedzi 5xx i rzeczywistych przekroczeń limitu czasu transportu. Zapisz klasyfikację błędu i zaplanowany czas ponowienia. Nie powtarzaj automatycznie odmowy polityki treści, nieprawidłowego inputu, brakującej referencji ani odrzucenia wizualnego przez recenzenta.
Nigdy nie zgłaszaj ponownie całej partii z powodu awarii jednego elementu podrzędnego. Natychmiast archiwizuj pomyślne wyniki i zachowaj mapowanie źródło-wynik. Jeśli zadanie wsadowe wygaśnie z częściowymi wynikami, pobierz ukończone elementy podrzędne, zidentyfikuj nieukończone identyfikatory zasobów i utwórz nowe zadanie zawierające tylko te pozostałe rekordy. To jest różnica między odzyskiwaniem a duplikowaniem.
Kopiowalny przepływ pracy wsadowego generowania obrazów z 8 zasobami
Poniższy przykład jest celowo fikcyjny: Maya, dorosła fotograf podróżnicza na górskim zleceniu. Czyni mechanikę operacyjną konkretną, nie sugerując, że prawdziwa osoba poparła kampanię. Zastąp pola własnymi dozwolonymi danymi postaci, zwolnienia talentu lub kampanii i zachowaj strukturę.
Krok 0: Utwórz manifest, zanim zaczniesz generować
Utwórz batch-manifest.csv przed otwarciem playgroundu lub wywołaniem punktu końcowego. Daje operatorowi jasny cel akceptacji dla każdego zasobu.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | kanoniczna referencja postaci | 16:9 | pending |
| maya-ridgeline-001 | a | obraz kampanii ze wschodem słońca na grzbiecie górskim | 16:9 | pending |
| maya-market-001 | a | obraz redakcyjny z górskiego targu | 16:9 | pending |
| maya-cabin-001 | a | obraz redakcyjny z planowania w chatce | 16:9 | pending |
| maya-lake-001 | a | obraz z notatkami terenowymi nad jeziorem | 16:9 | pending |
| maya-forest-001 | b | obraz kampanii ze szlaku leśnego | 16:9 | pending |
| maya-train-001 | b | obraz redakcyjny z podróży pociągiem | 16:9 | pending |
| maya-workbench-001 | b | obraz z przygotowania zestawu terenowego | 16:9 | pending |
| maya-portrait-001 | b | obraz kampanii z portretem zbliżeniowym | 16:9 | pending |
Wygeneruj deterministyczny klucz idempotencji dla każdego niezmiennego żądania, taki jak maya-ridgeline-001-v1. Poniższy kształt jest celowo neutralny wobec dostawcy. Umieść punkt końcowy dostawcy i jego udokumentowane parametry wewnątrz request; nie kopiuj fikcyjnego prywatnego punktu końcowego do produkcji.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Krok 1: Utwórz jedną kanoniczną referencję postaci
Wygeneruj obraz główny osobno. Jest kotwicą tożsamości dla każdej późniejszej sceny, więc zasługuje na krótką weryfikację przed rozpoczęciem jakiejkolwiek partii. W playgroundzie GPT Image 2 wybierz jakość High i 16:9, a następnie użyj tego promptu:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Zachowaj jeden obraz, który wyraźnie pokazuje twarz Mai, włosy, kurtkę, pasek aparatu i jedną kompletną parę dłoni, bez tekstu i zduplikowanej osoby. Zapisz go jako maya-master-001.png, oblicz hash referencyjny i dołącz to samo źródło do podrzędnych zadań. Nie rób tego kroku wsadowo. Słaba referencja główna mnoży niejednoznaczność w każdej scenie.
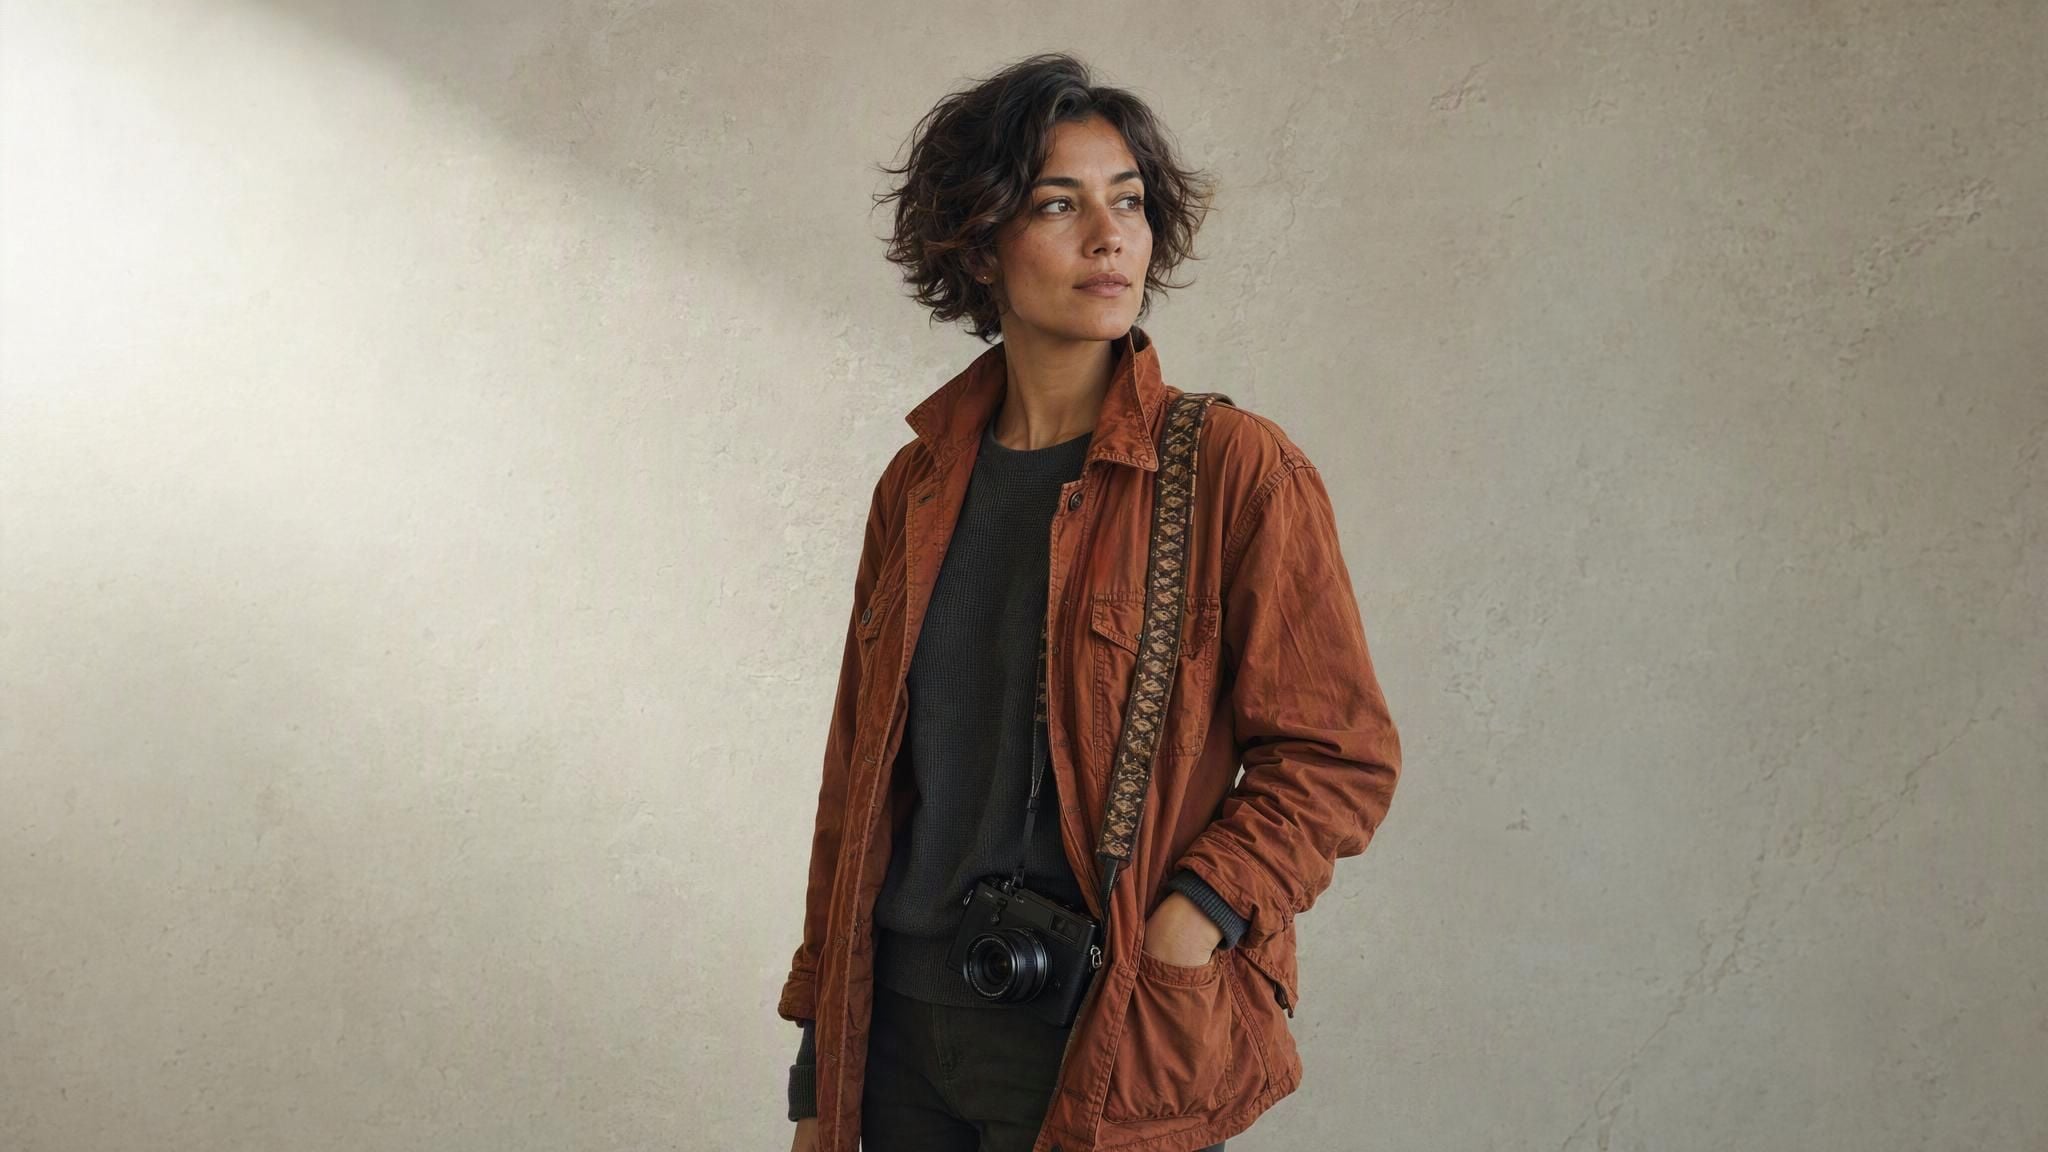
Prezentacja funkcji API AI do generowania wsadowego: prompt referencyjny postaci Mai obok wygenerowanego portretu fotografa podróżniczego
Prawdziwy przebieg referencji głównej w GPT Image 2: prompt ustanawia fikcyjną fotograf, której tożsamość muszą później zachować zadania scen.
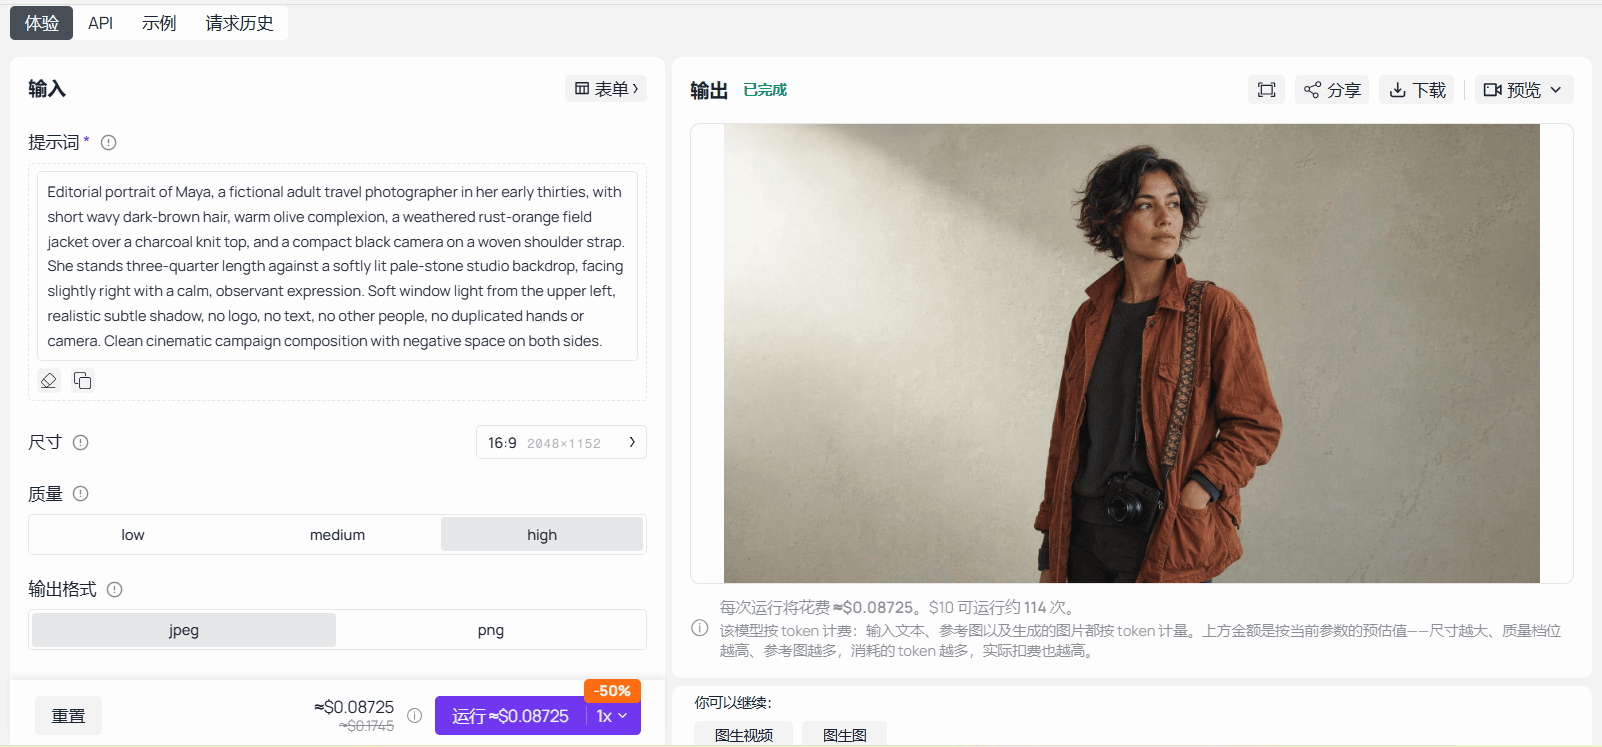
Playground GPT Image 2 ukończony z ustawieniem High, 16:9 i portretem głównym Mai
GPT Image 2 na Atlas Cloud z promptem referencji postaci z artykułu i jego ukończonym wynikiem w panelu wyjściowym.
Krok 2: Uruchom partię A jako 4 połączone sceny postaci
Wgraj maya-master-001.png do Seedream v4.7 Sequential. Utrzymuj stałą referencję, szablon promptu i proporcję 16:9. Użyj tego promptu:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Użyj trybu sekwencyjnego lub spójnej partii, który faktycznie udostępnia strona na żywo. Akceptuj tylko wyniki, które można jednoznacznie przypisać do maya-ridgeline-001 przez maya-lake-001. Jeśli playground zwraca jeden wynik na żądanie zamiast 4 oddzielnych zasobów podrzędnych, zgłoś ten sam zablokowany szablon jako 4 zadania podrzędne. Zachowaj ten sam hash referencyjny i parametry, zamiast udawać, że interfejs zwrócił funkcję, której nie ma.
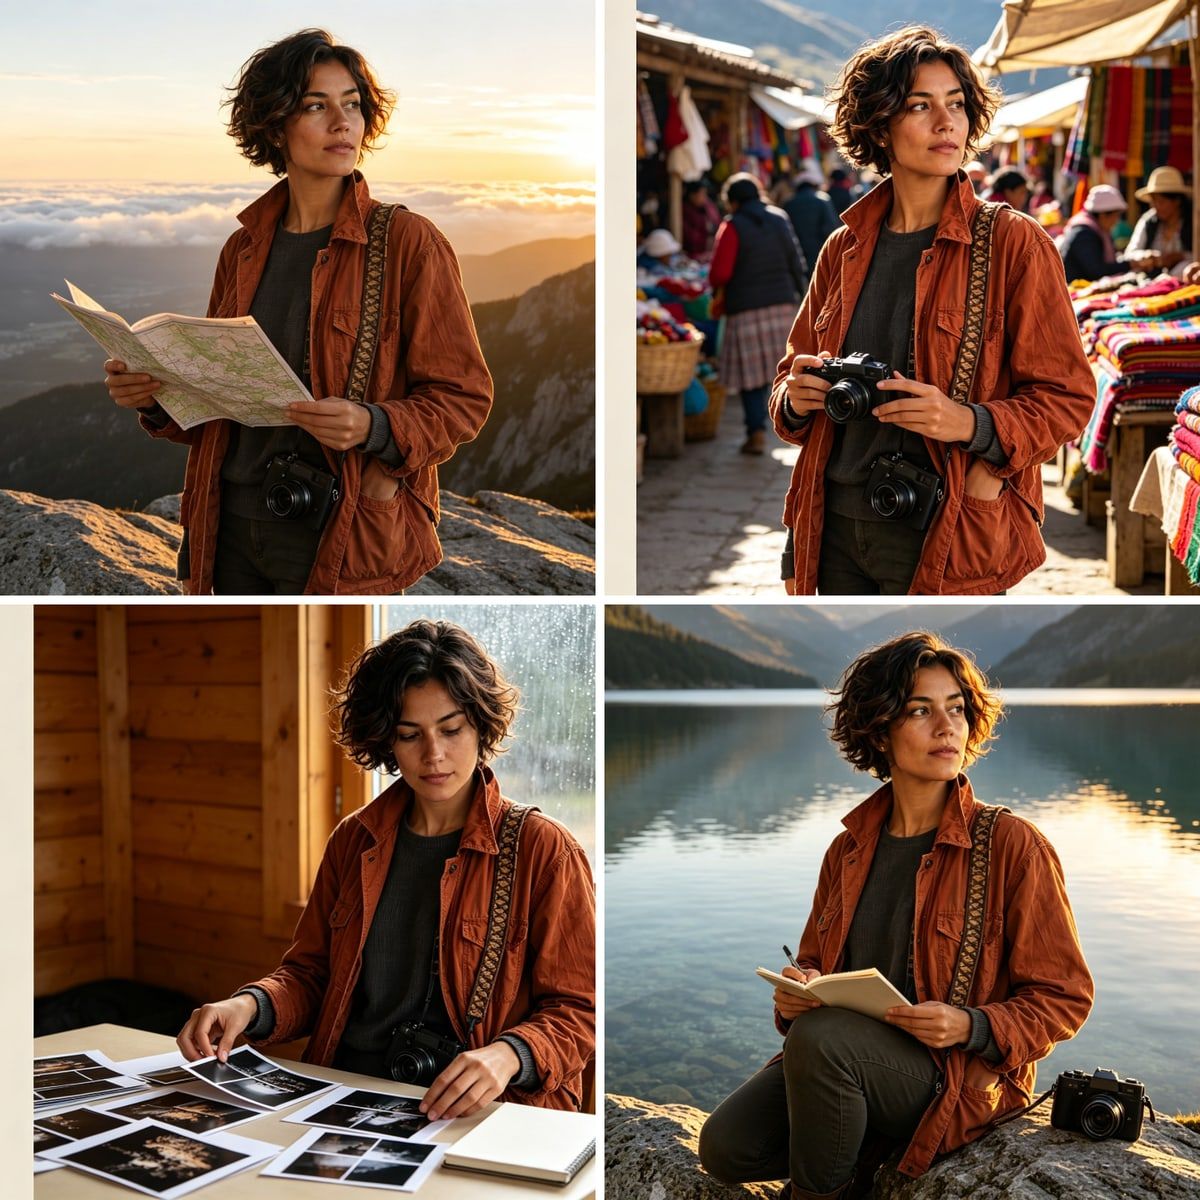
Cztery prawdziwe wyniki scen Mai z Seedream v4.7 Sequential w siatce, przypisane do identyfikatorów zasobów grzbietu, targu, chatki i jeziora
Siatka wyników partii A z 4 scenami: każda klatka pozostaje oddzielnym rekordem zasobu, nawet gdy model tworzy spójną sekwencję.
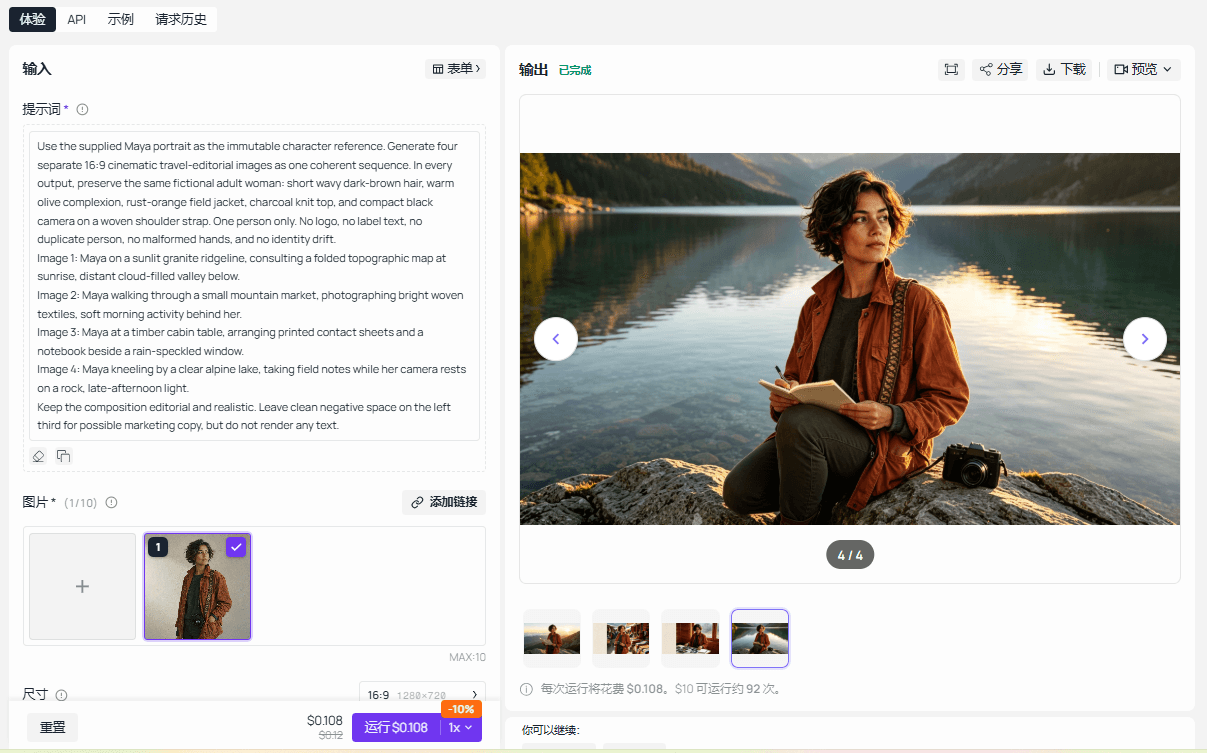
Playground Seedream v4.7 Sequential ukończony z połączonym promptem sceny Mai i jego prawdziwym wynikiem
Seedream v4.7 Sequential na Atlas Cloud z połączonym promptem sceny postaci z artykułu i ukończonym wynikiem.
Krok 3: Uruchom partię B, a następnie zatrzymaj się na kontrolę jakości
Użyj ponownie zatwierdzonej referencji głównej. Nie twórz jej ponownie i nie przepisuj reguł tożsamości. Zgłoś następne 4 sceny z nową etykietą partii i tymi samymi kontrolami akceptacji:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Po partii B zatrzymaj się. Zweryfikuj wszystkie 8 rekordów scen przed zwolnieniem kolejnej sekwencji kampanii. Ta pauza wychwytuje rodzaje dryfu, które kolejki ukrywają: zmieniające się włosy lub garderoba, pojawiająca się druga osoba, niezamówione liternictwo, zniekształcone dłonie lub scena, która przestała służyć swojemu kanałowi. Zapisz decyzję recenzenta obok zasobu, a nie w nieśledzonej wiadomości czatu.
Krok 4: Zastosuj decyzję o publikacji, ponowieniu lub odrzuceniu
Oznacz obraz jako approved, gdy zawiera jedną Maję, pasuje do referencji głównej pod względem twarzy, włosów, garderoby i aparatu, nie zawiera zepsutego tekstu ani zniekształconej anatomii i pasuje do przypisanej sceny. Oznacz go jako retry, gdy Maya się duplikuje, dryfuje, traci niezbędny rekwizyt lub wykazuje zniekształcone dłonie albo liternictwo. Oznacz go jako rejected, gdy kompozycja nie może służyć docelowemu kanałowi lub postać przestaje być rozpoznawalna.
W przypadku ponowienia zachowaj maya-train-001 jako zasób biznesowy i utwórz próbę maya-train-001-a2. Zgłoś tylko to zadanie podrzędne z oryginalną specyfikacją klucza idempotencji, dostosowaną tylko wtedy, gdy prompt jest celowo wersjonowany. Nie uruchamiaj ponownie pozostałych 7 zasobów tylko dlatego, że jedna scena wymaga naprawy.
Wybór modeli do generowania wsadowego
Wybierz model wokół jednostki pracy, a nie rankingu. Czysta referencja główna i spójna sekwencja scen to różne zadania. Edycja jednego nieudanego obrazu to znowu coś innego. Jeśli zespół chce przetestować te etapy przez jedną integrację zgodną z OpenAI, Atlas Cloud zapewnia naturalne miejsce do walidacji dwóch stron modeli użytych w tym przykładzie.
| Zadanie | Model i metoda pracy | Kontekst cenowy do weryfikacji przed kolejką |
|---|---|---|
| Utworzenie czystej referencji głównej postaci | GPT Image 2, jeden przebieg High w 16:9, który staje się kotwicą referencyjną | GPT Image 2 Developer text-to-image jest wyceniony od około 0,004 USD za obraz wobec 0,009 USD w standardzie, co daje 50% wyświetlanego rabatu na wrzesień 2026 |
| Zbudowanie spójnego zestawu scen | Seedream v4.7 Sequential, ta sama referencja i zablokowany schemat promptu w zadaniach podrzędnych | Aktualny katalog podaje 0,03 USD za obraz; zweryfikuj tryb wyjścia na żywo i cenę przed produkcją |
| Naprawa jednego nieudanego zasobu | Tryb edycji GPT Image 2, ograniczony do zasobu, który nie przeszedł weryfikacji | Potwierdź punkt końcowy edycji, rozmiar wyjścia, jakość i aktualną cenę przed zatwierdzeniem |
Ceny zmieniają się w zależności od modelu, trybu i wybranych ustawień. Użyj katalogu modeli Atlas Cloud, aby ponownie sprawdzić dostępność, rabaty i dokładny tryb w dniu, w którym kolejkujesz pracę. Traktuj tabelę jako dane wejściowe do szacowania, nigdy jako twierdzenie promocyjne ani gwarancję kosztów.
Kontrola jakości, koszty i prawa przed skalowaniem
Ukończenie generowania ma 3 oddzielne znaczenia: dostawca zgłasza sukces, plik został poprawnie zarchiwizowany i recenzent akceptuje go do publikacji. Uczyń wszystkie 3 widocznymi w swoich rekordach. Ukończone zadanie z brakującym plikiem wyjściowym to awaria operacyjna. Zapisany plik ze zduplikowaną postacią to awaria kreatywna. Żadne z nich nie powinno automatycznie przechodzić do publikacji.
Użyj listy kontrolnej recenzenta, która jest wystarczająco prosta, aby zastosować ją do każdego zasobu podrzędnego:
| Kontrola | Pytanie recenzenta |
|---|---|
| Tożsamość postaci | Czy Maya pasuje do zatwierdzonej referencji głównej pod względem twarzy, włosów, garderoby i aparatu? |
| Liczba obiektów | Czy jest dokładnie oczekiwana liczba kluczowych obiektów? |
| Zgodność z promptem | Czy scena realizuje przypisany przypadek użycia? |
| Artefakty tekstowe | Czy występuje niechciany, zniekształcony lub nieobsługiwany tekst? |
| Proporcja i nazwa pliku | Czy zapisany plik pasuje do rekordu manifestu? |
| Weryfikacja praw | Czy referencja i zamierzone twierdzenia są dozwolone dla tego zastosowania? |
Oszacuj koszt po przebiegu za pomocą approved asset cost = total completed attempts cost / approved assets. Ujawnia to koszt ponowień i odrzuconych wyników bez udawania, że każdy obraz ma ten sam końcowy koszt. Ustaw limit zadania, limit partii i limit dzienny przed rozpoczęciem. Wstrzymaj wysyłanie, jeśli którykolwiek z tych pułapów zostanie osiągnięty.
Używaj wyłącznie posiadanych, licencjonowanych lub w inny sposób dozwolonych obrazów referencyjnych. Sprawdź aktualne polityki platformy i warunki modelu przed użyciem komercyjnym. Nie proś modelu o wymyślanie certyfikacji, wyników laboratoryjnych, obietnic bezpieczeństwa, twierdzeń medycznych ani niezweryfikowanych specyfikacji produktu. Dopracowany wynik nie zamienia niepopartego twierdzenia w publikowalne.
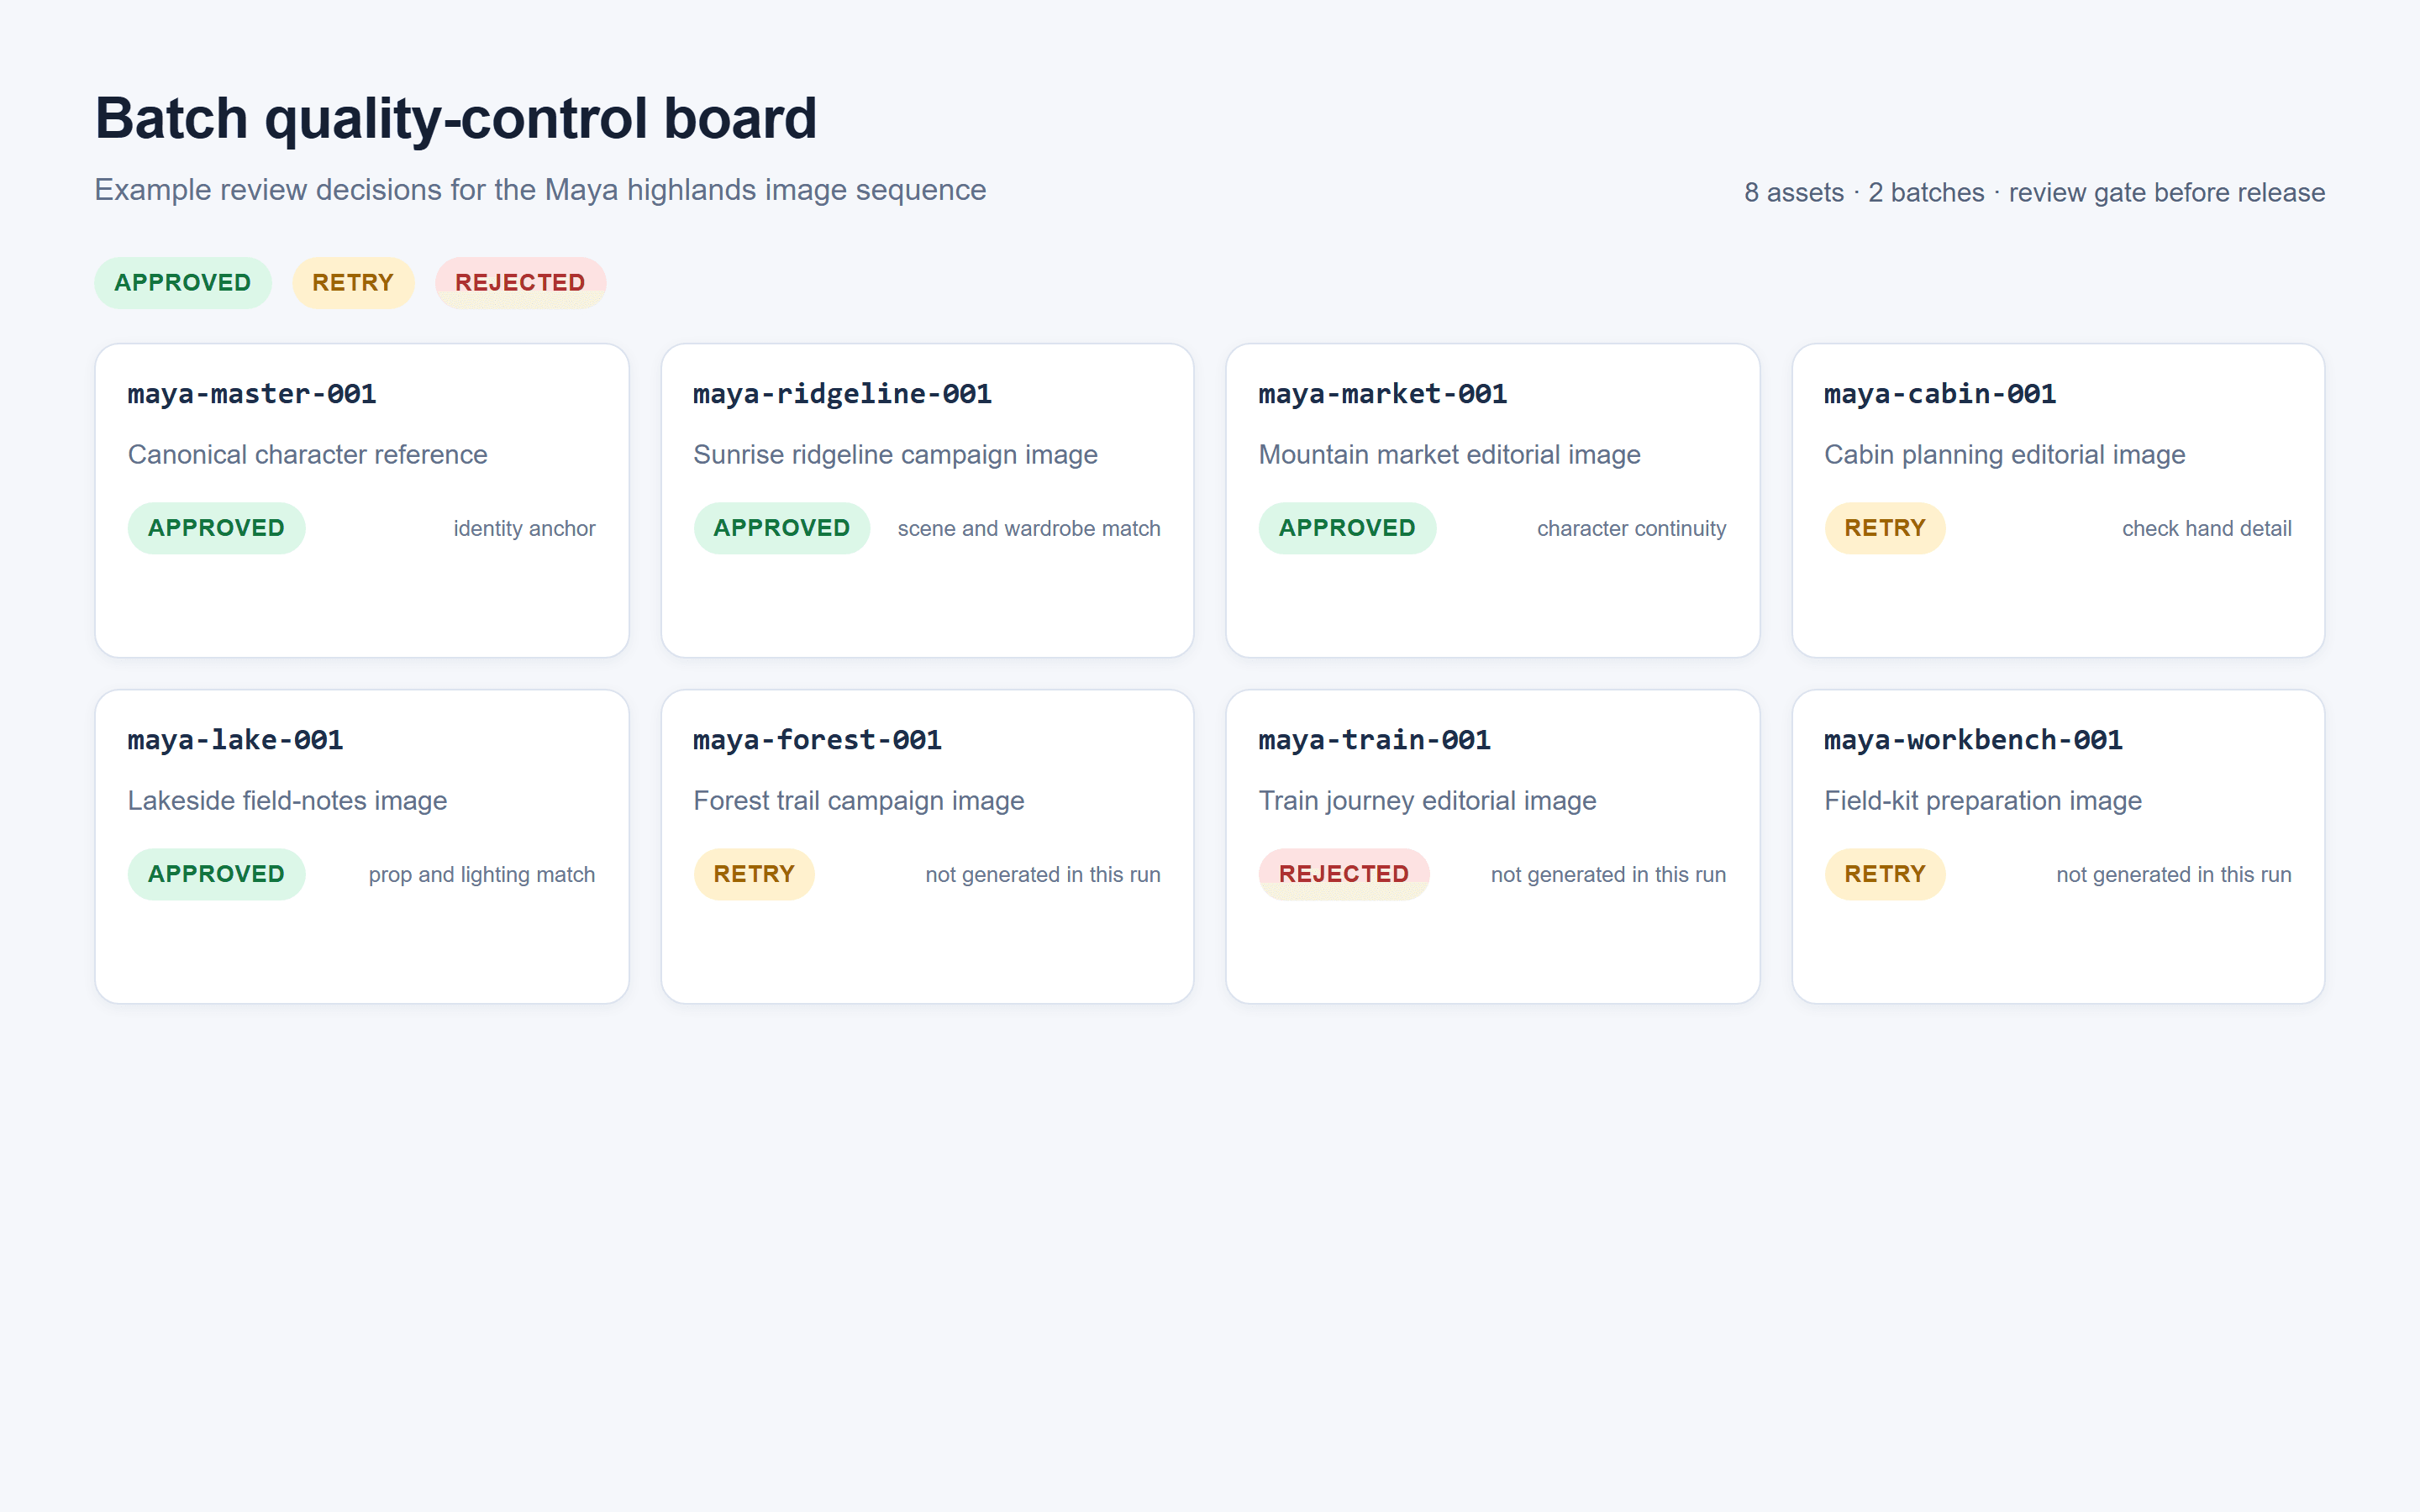
Wyrenderowana w przeglądarce tablica kontroli jakości partii pokazująca 8 identyfikatorów zasobów Mai ze stanami weryfikacji approved, retry i rejected
Wyrenderowana w przeglądarce tablica weryfikacji mapuje rzeczywiste pliki przebiegu z powrotem do ich 8 identyfikatorów zasobów i uwidacznia decyzję o publikacji, ponowieniu lub odrzuceniu.
API AI do generowania wsadowego: lista kontrolna wdrożenia produkcyjnego
Przed przejściem od ćwiczenia z 8 zasobami do aktywnego katalogu lub biblioteki treści potwierdź każdy z poniższych punktów.
- Każdy zasób ma niezmienny
asset_id. - Prompt, hash referencyjny, model, proporcja i jakość są zapisane.
- Każde zgłoszenie ma klucz idempotencji, jeśli dostawca go obsługuje.
- Współbieżność pozostaje poniżej rzeczywistego udokumentowanego limitu konta.
- Istnieją limity budżetu zadania, partii i dzienny.
- Odpowiedzi 429, odpowiedzi 5xx, przekroczenia limitu czasu i odmowy treści podlegają różnym regułom.
- Ponowienia mają twardy maksymalny limit.
- Pomyślne wyniki są natychmiast archiwizowane i mapowane z powrotem do danych źródłowych.
- Bramka QC dla małych partii przechodzi przed zwolnieniem następnej grupy.
- Końcowa weryfikacja próbki sprawdza tożsamość postaci, tekst, proporcję, nazwy plików i prawa.
Ta lista kontrolna utrzymuje API AI do generowania wsadowego użytecznym, gdy wolumen rośnie. Pozostawia także jasny ścieżkę audytu, gdy redaktor pyta, dlaczego dany obraz został wygenerowany, zaakceptowany lub uruchomiony ponownie.
FAQ: API AI do generowania wsadowego
Czym jest API AI do generowania wsadowego?
To sposób na zgłaszanie wielu niezależnych zadań AI, śledzenie ich wykonania i późniejsze zbieranie wyników. Dobra implementacja zachowuje trwały biznesowy identyfikator zasobu dla każdego zadania, niezależnie od tego, czy dostawca używa asynchronicznego zadania wsadowego, czy zwykłych żądań współbieżnych.
Czy Batch API jest lepsze od wysyłania żądań obrazów równolegle?
Żadne nie jest automatycznie lepsze. Użyj kontrolowanych żądań równoległych, gdy przepływ pracy wymaga natychmiastowego postępu. Użyj zadania wsadowego dostawcy do niepilnego wolumenu, gdy jego udokumentowane zasady kolejki, czasu realizacji i kosztów pasują do twojej pracy. Oba wymagają dzienników poszczególnych zasobów i weryfikacji.
Ile obrazów AI powinienem umieścić w jednej partii?
Zacznij od 4 do 8 zasobów wizualnych, gdy walidujesz nowy schemat promptu lub referencję postaci. Zwiększaj dopiero po tym, jak zespół może zmapować każdy wynik, szybko zauważyć dryf i odzyskać nieudane zadanie podrzędne bez ponownego uruchamiania grupy. Limity dostawcy mogą pozwalać na znacznie więcej, ale operacyjnie użyteczna partia to partia podlegająca weryfikacji.
Jak klucze idempotencji zapobiegają duplikowaniu kosztów generowania?
Identyfikują zgłoszenie jako tę samą zamierzoną operację po ponowieniu. Jeśli punkt końcowy obsługuje idempotencję, dostawca może uniknąć traktowania powtórzonego wywołania sieciowego jako całkowicie nowego generowania. Zapisz klucz z rekordem zasobu i potwierdź dokładną semantykę w dokumentacji dostawcy.
Czy mogę wsadowo generować obrazy na podstawie tej samej referencji postaci?
Tak. Użyj jednego zatwierdzonego, dozwolonego obrazu referencyjnego; dołącz jego hash do każdego zadania podrzędnego; zablokuj instrukcje tożsamości; i zweryfikuj małą grupę scen przed rozszerzeniem. Spójność referencji zmniejsza niejednoznaczność, ale nie zastępuje QC wizualnego.
Czy powinienem ponowić całą nieudaną partię, czy tylko nieudane zasoby?
Ponów tylko nieudane zasoby. Najpierw zarchiwizuj sukcesy, sklasyfikuj błąd i utwórz nowy rekord próby dla dotkniętego zadania podrzędnego. Ponowne zgłoszenie całej partii zwiększa prawdopodobieństwo zduplikowanych zasobów i niepotrzebnych wydatków.


