Zielony raport z testów API wygląda uspokajająco, dopóki nie zauważysz, że każde sprawdzenie weryfikuje tylko HTTP 200. Odpowiedź może zawierać rekord niewłaściwego klienta i nadal przejść.
Wybierz narzędzia AI do testowania API w oparciu o pracę, którą już wykonujesz. Oceń Postman Agent Mode, jeśli Twój zespół utrzymuje kolekcje, KushoAI, jeśli punktem wyjścia jest specyfikacja, oraz Keploy, jeśli potrzebujesz wygenerowanych przepływów lub testów regresyjnych tworzonych na podstawie zarejestrowanego ruchu. Przejrzyj i uruchom powstałe testy, zanim im zaufasz.
Ten przewodnik obejmuje wsparcie AI w testowaniu zwykłych API. Testowanie dokładności odpowiedzi modelu AI to odrębny problem oceny.
Kluczowe wnioski
- Dostarcz kontrakt, zależności żądań i zatwierdzone oczekiwania biznesowe.
- Sprawdź, czy asercje odrzucają błędne dane, brakujące pola i nieprawidłowe typy.
- Kupuj tylko wtedy, gdy przejrzane testy będą wielokrotnie uruchamiane w docelowym środowisku CI.
Poniższe porównanie produktów odzwierciedla oficjalną dokumentację sprawdzoną 21 września 2026 r. Nie jest to bezpośredni benchmark trzech płatnych kont.
Przykład praktyczny wykorzystuje przypiętą specyfikację Swagger Petstore i rozdziela oczekiwania kontraktu, zaobserwowane zachowanie oraz celowo zmodyfikowane kopie odpowiedzi.
Nasze lokalne uruchomienie przeszło 5 testów na żywo i odrzuciło wszystkie 3 celowo zmienione kopie odpowiedzi. Osobna próba brakującej nazwy nadal zwróciła 200, co pokazuje, dlaczego zakres zielonego raportu ma znaczenie.
Co faktycznie robią narzędzia AI do testowania API
Wsparcie AI zwykle wchodzi w cztery części testowania API. Model czyta Twoją specyfikację, proponuje scenariusze, tworzy szkice asercji i pomaga wyjaśnić błędy. Każda część wymaga innych dowodów. Prawdopodobne wyjaśnienie błędu nie dowodzi, że proponowana poprawka jest właściwa.
Do przeglądu specyfikacji dostarcz plik OpenAPI i odpowiednie reguły biznesowe. Do planowania scenariuszy dodaj przykłady prawidłowych danych i znane granice. Do skryptów wykonywalnych dołącz swój runner, konfigurację uwierzytelniania i konwencje fixture'ów. Do diagnozy podaj rzeczywiste żądanie, odpowiedź i komunikat o błędzie po usunięciu sekretów.
Podczas oceny produktów rozdzielaj te cztery mechanizmy:
- Generowanie przez LLM: proponuje testy na podstawie języka, schematów i przykładów. Recenzent musi sprawdzić oczekiwane wyniki.
- Odtwarzanie ruchu: porównuje późniejsze zachowanie z przechwyconymi interakcjami, często z wykorzystaniem zarejestrowanych odpowiedzi zależności.
- Testowanie oparte na właściwościach: systematycznie konstruuje dane wejściowe, aby zakwestionować właściwości, takie jak zgodność ze schematem.
- Wykonywanie testów: wysyła żądania, ocenia asercje i zwraca raporty oraz kody wyjścia.
Produkt może łączyć kilka mechanizmów. Zapytaj, który mechanizm wytworzył każdy test i co określa jego oczekiwany wynik. Zarejestrowanie nieprawidłowej odpowiedzi może zachować ten sam błąd jako punkt odniesienia regresji. Wygenerowanie dopracowanej nazwy testu może zamaskować nieuzasadnione oczekiwanie.
Rozważ asercje na trzech poziomach. Po pierwsze, czy serwer odpowiedział pomyślnie? Po drugie, czy treść ma udokumentowane pola i typy? Po trzecie, czy ta treść reprezentuje zasób i operację, o które prosiłeś?
W przypadku wyszukiwania zwierzaka prawidłowy obiekt z całkowitym ID nadal nie przechodzi trzeciego sprawdzenia, jeśli to ID należy do innego zwierzaka. I odwrotnie, zgodność z żądanym ID nie dowodzi, że każde pole spełnia schemat. Używaj obu sprawdzeń i dodawaj reguły biznesowe tylko tam, gdzie zespół ma uzgodnione źródło.
Praktycznym wynikiem, którego chcesz, jest utrzymywalny zasób testowy z wyjaśnialnym oracle: jasnym powodem, dla którego każdy wynik powinien przejść lub nie. Policz przydatne scenariusze po przeglądzie, w tym te odrzucone, zamiast świętować długość początkowej wygenerowanej listy.
Narzędzia AI do testowania API porównane według przepływu pracy
Zacznij od artefaktu, który Twój zespół może dostarczyć dzisiaj. Migracja istniejącej kolekcji, odtworzenie brakujących reguł biznesowych i skonfigurowanie rejestrowania zależności to różne projekty. Narzędzie odpowiednie dla jednego punktu wyjścia może tworzyć dodatkową pracę w innym.
| Narzędzie lub podejście | Przydatne dane wejściowe | Rola AI lub automatyzacji | Ścieżka wykonania i CI | Możliwy do przeglądu wynik | Główne pytanie próbne |
|---|---|---|---|---|---|
| Postman Agent Mode | Kolekcje, żądania, odpowiedzi, środowiska, specyfikacje | Tworzy i edytuje skrypty testowe w kontekście przestrzeni roboczej | Collection Runner i zgodny przepływ pracy CLI | Standardowe asercje JavaScript Postman | Czy zachowuje Twoje zmienne i testuje kontrakt? |
| KushoAI | OpenAPI, kolekcja Postman, cURL | Generuje scenariusze i zestawy testów; obsługuje udoskonalanie językiem naturalnym | Wykonanie na platformie i udokumentowana integracja CI; sprawdź uprawnienia | Sprawdź wygenerowane żądania, zależności i oczekiwane wyniki | Czy wybrany plan może uruchomić i zachować zestaw tam, gdzie go potrzebujesz? |
| Keploy | Specyfikacje lub definicje żądań; alternatywnie rzeczywisty ruch | Generowanie AI i oddzielna ścieżka rejestrowania/odtwarzania | Wygenerowane przepływy lub zarejestrowane testy w obsługiwanych środowiskach lokalnych/CI | Przejrzyj definicje testów, punkty odniesienia i mocki zależności | Która ścieżka obejmuje Twoje rzeczywiste tryby awarii? |
| Istniejący runner plus LLM | Zatwierdzona macierz, specyfikacja, konwencje fixture'ów | Tworzy kod do przeglądu | Twój pytest lub inny ustalony runner | Kod zatwierdzony w Twoim repozytorium | Czy przegląd jest tańszy niż bezpośrednie napisanie tych samych testów? |
Postman Agent Mode dla istniejących kolekcji
Postman to rozsądna pierwsza ocena, gdy Twoja kolekcja zawiera już przydatną kolejność żądań, zmienne środowiskowe i konfigurację uwierzytelniania. Agent Mode może wykorzystać ten kontekst do wygenerowania standardowych skryptów testowych JavaScript. Te skrypty mogą wejść do istniejącego przepływu wykonywania kolekcji, zamiast wymagać nowego języka asercji.
Skoncentrowana próba jest bardziej odkrywcza niż proszenie go o przetestowanie wszystkiego. Wybierz żądanie, które pobiera zasób utworzony wcześniej w kolekcji. Dostarcz jego schemat i poproś o walidację wymaganych pól, udokumentowane typy pól oraz asercję łączącą zwrócone ID z przechowywanym ID utworzenia.
Następnie sprawdź proponowane zmiany przed ich zaakceptowaniem. Przykładowa odpowiedź może zawierać zwierzaka o imieniu Milo. Równość z Milo ma sens, jeśli Twoje fixture wyraźnie utworzyło Milo; jest krucha, jeśli generator skopiował nazwę ze wspólnego przykładowego rekordu. Ten sam literał może być prawidłową asercją lub przypadkową zależnością, w zależności od źródła.
Dokładnie sprawdź zakres zmiennych. ID przechowywane w zmiennej środowiskowej musi być dostępne dla późniejszego żądania i musi należeć do tego uruchomienia. Współdzielone zmienne między równoczesnymi uruchomieniami mogą powodować sporadyczne błędy przypominające defekty serwera. Poproś generator o wyjaśnienie konfiguracji i czyszczenia, a także asercji.
W pierwszym teście akceptacyjnym uruchom kolekcję dwukrotnie na izolowanych danych, a następnie sprawdź wyeksportowaną lub wersjonowaną reprezentację. Potwierdź, że współpracownik może przejrzeć zmienione skrypty bez powtarzania rozmowy z AI. Sprawdź również, czy wybrany CLI, reporter i plan obsługują ścieżkę wykonania, której zamierzasz użyć.
Nie przedstawiono tutaj obsługiwanego generowania Postman. Przydatnym pytaniem oceniającym jest to, czy jego kontekst przestrzeni roboczej zmniejsza pracę związaną z przeglądem istniejącej kolekcji. Wymaga to własnej kolekcji i próby na poziomie konta, a nie wniosku wyciągniętego ze zrzutu ekranu produktu.
KushoAI do generowania testów na podstawie specyfikacji
KushoAI akceptuje dane wejściowe Swagger/OpenAPI, Postman i cURL oraz dokumentuje generowanie testów, udoskonalanie językiem naturalnym i wykonywanie w CI. To czyni go kandydatem, gdy zespół ma przydatne definicje API, ale zaległości w niezapisanych testach. Są to możliwości opisane przez dostawcę, a nie zmierzone wyniki wykrywania defektów. (Dokumentacja KushoAI, wrzesień 2026)
Wybierz dane wejściowe z najbogatszym godnym zaufania kontekstem. Żądanie cURL może opisać jedno prawidłowe żądanie, ale zwykle niewiele mówi o polach opcjonalnych, dozwolonych wartościach enum lub udokumentowanych błędach. Plik OpenAPI dodaje strukturę; zatwierdzona macierz scenariuszy dodaje intencję, którą struktura może pozostawiać niejednoznaczną.
W próbie Petstore poproś o oddzielne przypadki dla prawidłowego zwierzaka, brakującej wymaganej nazwy, ID z niewłaściwym typem i nieprawidłowego filtra statusu. Sprawdź, czy narzędzie rozróżnia wymagania dotyczące treści żądania od wymagań dotyczących schematu odpowiedzi. Mogą wyglądać podobnie w przykładzie, nakładając różne obowiązki.
Następnie zbadaj połączony przepływ create-read-update. Odczyt musi używać ID powiązanego z bieżącą konfiguracją. Aktualizacja musi dotyczyć tego samego zasobu, a późniejszy odczyt musi zweryfikować zmienione pole. Cztery niezależne żądania z atrakcyjnymi nazwami testów nie dowodzą, że łańcuch zależności działa.
Potraktuj pierwsze generowanie jako propozycję. Zachowaj udokumentowane oczekiwania, popraw skrypty z nieprawidłowym przepływem danych i oznacz niedoprecyzowane wyniki do decyzji o wymaganiach. Jeśli narzędzie sugeruje kilka równoważnych przypadków brakującego pola, zachowaj przydatne rozróżnienia, zamiast płacić za utrzymywanie duplikatów.
Przed zakupem poproś o wykonanie zestawu z zamierzonego potoku i sprawdź artefakt awarii. Potwierdź bieżące uprawnienia CI, obsługę poświadczeń i dostępne formaty eksportu w wybranym planie. Nie zakładaj, że darmowa próba interaktywna przyznaje takie same prawa automatyzacji jak wdrożenie zespołowe.
Keploy do generowanych testów i odtwarzania ruchu
Dokumentacja Keploy przedstawia dwie odrębne ścieżki startowe. Generowanie AI akceptuje zasoby, takie jak OpenAPI, Postman, cURL lub endpointy, i buduje połączone przepływy API. Rejestrowanie i odtwarzanie przechwytuje interakcje API i ich zależności do późniejszego wykonania z mockami. Opisu przepływu AI i opisu rejestrowania zależności nie należy traktować jako identycznych mechanizmów. (Dokumentacja Keploy, wrzesień 2026)
Jeśli Twoją trudnością jest odtworzenie tego, co aplikacja zrobiła z bazą danych lub usługą nadrzędną, oceń ścieżkę rejestrowania. Przechwyć małą podróż create-read-update w izolowanym środowisku, sprawdź przechwycone zależności i odtwórz po kontrolowanej zmianie aplikacji. Sprawdź, co obsługuje środowisko uruchomieniowe, przed planowaniem większego wdrożenia.
Jeśli Twoją trudnością jest wyprowadzanie przypadków ze specyfikacji, oceń ścieżkę generowania osobno. Zapytaj, w jaki sposób proponowane żądania uzyskują poświadczenia, przenoszą ID między krokami i czyszczą dane. Obecność funkcji rejestrowania w innych częściach produktu nie odpowiada na te pytania dla wygenerowanego zestawu.
Wartości dynamiczne wymagają osądu. Znacznik czasu może zasadnie się zmieniać; ID zasobu może łączyć dwa żądania i dlatego wymaga porównania. Szerokie ignorowanie każdego zmieniającego się pola może ukryć błędy. Przejrzyj wykluczenia pole po polu i zachowaj porównania wyrażające istotne relacje.
Sprawdź również punkt odniesienia przed jego akceptacją. Nagranie zawierające błędną sumę, przypadkową odpowiedź awaryjną lub nieaktualne dane może być odtwarzane spójnie. Spójność pomaga wykryć zmiany, ale zespół nadal decyduje, czy przechwycone zachowanie było poprawne.
Przydatne uzupełnienie: Schemathesis zapewnia oparte na schemacie testowanie API oparte na właściwościach. Może kwestionować API wygenerowanymi danymi wejściowymi obok przejrzanych przykładów. Traktuj je jako inny mechanizm testowania, a nie synonim generatora testów LLM. Jego wyniki nadal wymagają interpretacji w kontekście kontraktu i implementacji.
Darmowe narzędzia AI do testowania API: ograniczenia i koszty
„Darmowe” może opisywać klienta, ograniczony limit AI, runner open source lub tymczasową próbę. Te oferty obejmują różne części przepływu pracy. Darmowy klient nie dowodzi, że automatyczne generowanie, zaplanowane wykonywanie lub eksport raportów są również darmowe.
Według stanu na 21 września 2026 r. darmowy plan Postman wymienia 50 kredytów AI miesięcznie. Kredyty to jego jednostka rozliczeniowa; nie oznaczają 50 testów ani 50 kompletnych zestawów. Jego tabela porównawcza rozróżnia limit AI od wykonywania, funkcji opartych na danych i eksportu wyników. (Cennik Postman, wrzesień 2026)
Obecna prezentacja cen KushoAI używa Developer Edition i Enterprise. Keploy rozróżnia Playground, Pro i Enterprise obok swojej oferty open source. Użyj aktualnego ekranu zakupu, aby potwierdzić odpowiednie limity. Starsze zestawienia narzędzi mogą opisywać wycofane nazwy planów lub łączyć limity rozliczane osobno.
| Składnik kosztu | Co zapisać w próbie | Co może wprowadzać w błąd w rachunku |
|---|---|---|
| Miejsca i plan | Edytorzy, recenzenci, interwał rozliczeniowy, wymagane funkcje | Porównywanie rocznych cen nagłówkowych z miesięcznymi zobowiązaniami |
| Generowanie AI | Zużycie kredytów na to samo zatwierdzone zadanie, w tym ponowne próby | Zakładanie, że jeden kredyt równa się jednemu testowi |
| Wykonanie | Uruchomienia lokalne, hostowane, zadania CI, harmonogramy, raporty | Traktowanie uruchomień interaktywnych jako pozwolenia na każdą ścieżkę automatyzacji |
| Niezależny model | Tokeny wejściowe i wyjściowe do tworzenia i przeglądu | Ignorowanie powtarzanych zgłoszeń pełnej specyfikacji |
| Czas inżynierii | Przegląd, naprawa fixture'ów, analiza awarii, utrzymanie | Liczenie początkowego czasu generowania jako całkowitego czasu dostarczenia |
Użyj małego zadania akceptacyjnego do oszacowania kosztu. Daj każdemu kandydatowi te same operacje i oczekiwania, a następnie zapisz, ile scenariuszy przechodzi przegląd. Prowadź czas generowania, czas ręcznego przeglądu i czas wykonania w osobnych kolumnach. Oczekiwanie na model i poprawianie niebezpiecznej asercji nakładają na zespół różne koszty.
Przydatnym mianownikiem są przejrzane, uruchamialne scenariusze, które Twój zespół zachowa. Zapobiega to sytuacji, w której generator z wieloma redundantnymi przypadkami wydaje się tańszy tylko dlatego, że jego wynik jest dłuższy. Zapisz nieobsługiwane przypadki, które usunąłeś, oraz wymagania, które pozostają nierozwiązane.
Ten artykuł nie twierdzi, że zmierzono procent oszczędności pracy, ani nie porównuje przepustowości płatnych planów. Te liczby wymagają kontrolowanej próby z równoważnymi danymi wejściowymi. W decyzji o zakupie uwzględnij jedną realistyczną zmianę konserwacyjną, taką jak dodanie wymaganego pola, aby oszacowanie obejmowało następny sprint, a także pierwsze demo.
Narzędzia AI do testowania API: OpenAPI do pierwszego uruchomienia
Użyj izolowanej lokalnej instancji prawdziwego projektu Swagger Petstore. Przypnij commit d57941e8fe959e508796b27469b1e8bba73392dc; jego specyfikacja deklaruje OpenAPI 3.0.4 i wersję aplikacji 1.0.29-SNAPSHOT. Czytaj przypnięty plik, a nie niezależnie aktualizowane publiczne demo. (Specyfikacja Swagger Petstore, wrzesień 2026)
1. Przygotuj usługę i zapisz środowisko. Pobierz repozytorium przez tę stronę źródłową, przełącz się na przypiętą wersję i zainstaluj zgodny JDK oraz Maven. README projektu podaje to polecenie uruchomienia z katalogu repozytorium:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty używa portu 8080. Ustaw BASE_URL na swoje lokalne pochodzenie HTTP na tym porcie z dołączonym /api/v3. Przed testowaniem potwierdź, że /openapi.json jest czytelny względem tej bazy.
To uruchomienie użyło Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 i jsonschema 4.26.0. Zapisz również swoje wersje. Kompilacja źródłowa pobiera zależności i Swagger UI, więc samo przypięcie commita aplikacji nie jest w pełni hermetyczną kompilacją.
2. Zaimportuj przypiętą specyfikację. Wybierz /pet, /pet/{petId} i /pet/findByStatus. Zachowaj delete dostępny do czyszczenia. Zastąp publiczną lokalizację serwera ze specyfikacji swoją lokalną bazą. Sprawdź to ustawienie przed wysłaniem jakiegokolwiek żądania zapisu.
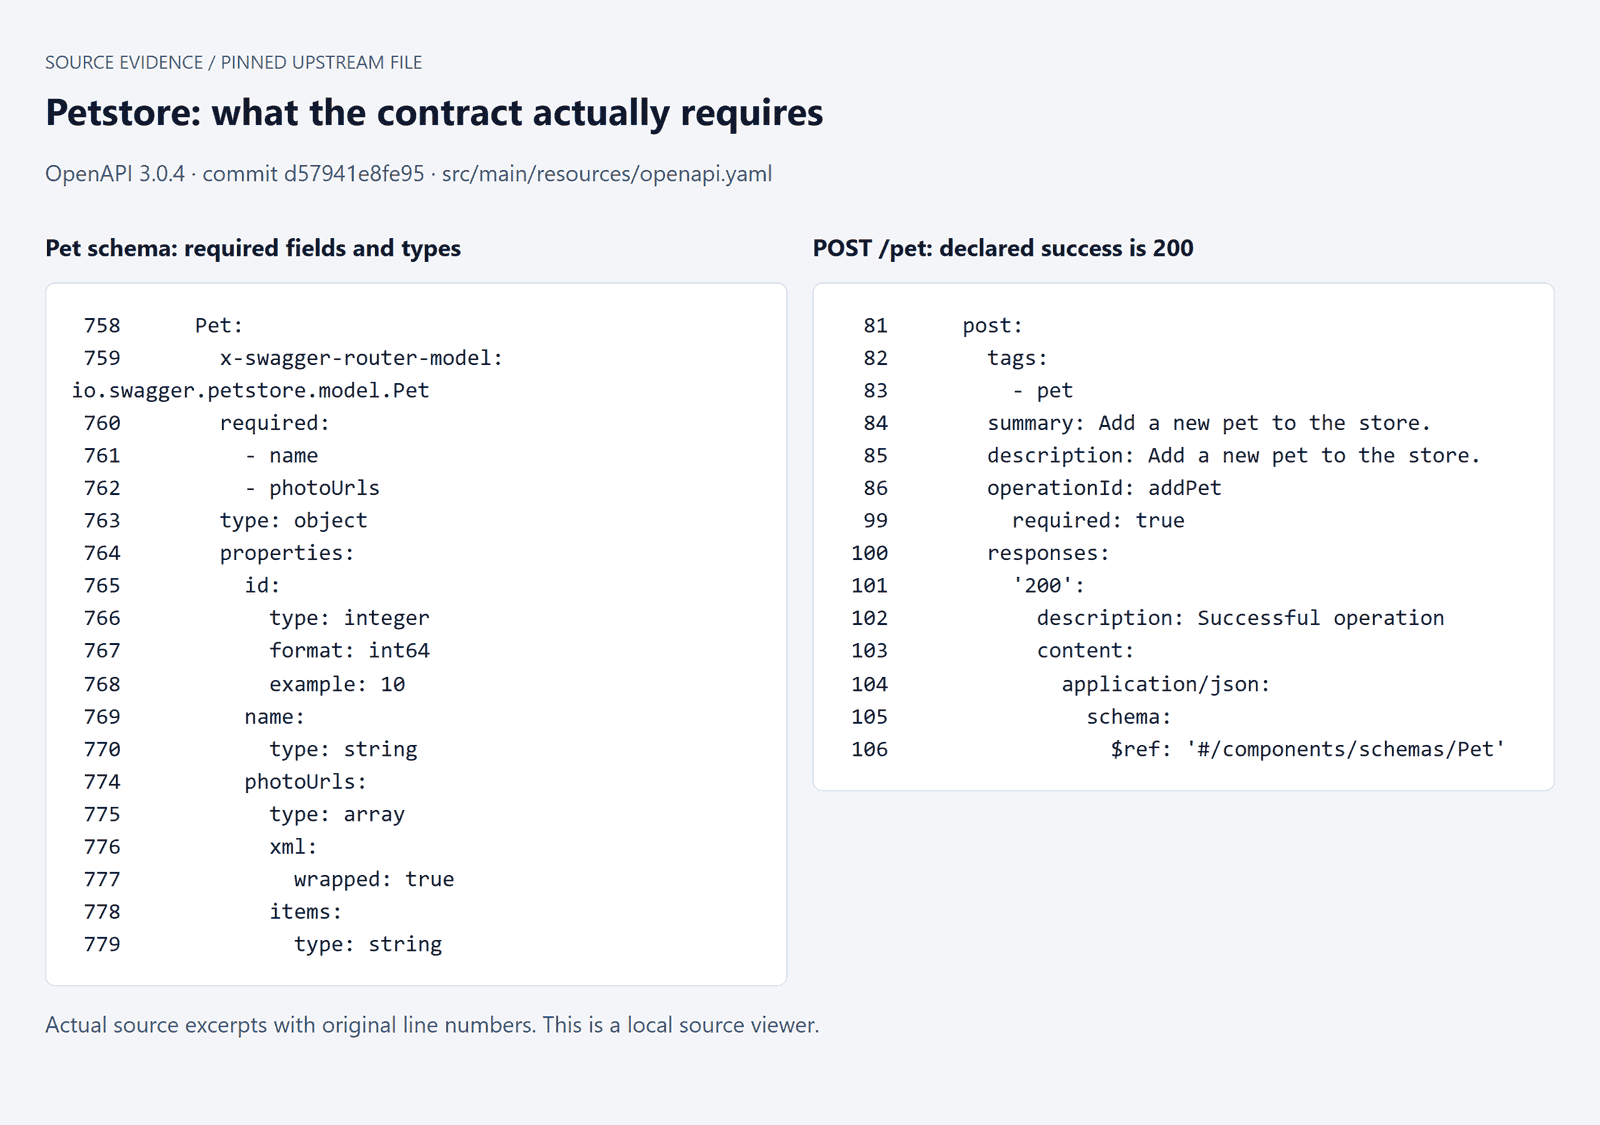 Przypięte źródło OpenAPI Petstore pokazujące wymagane pola i wybrane definicje operacji
Rzeczywiste fragmenty źródła renderowane lokalnie: Pet wymaga name i photoUrls; POST /pet deklaruje 200 dla sukcesu. Oryginalne numery wierszy są zachowane.
3. Wygeneruj macierz przed kodem wykonywalnym (Prompt A). Załącz specyfikację i wklej ten prompt do wybranego generatora:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Przejrzyj oracle dla każdego scenariusza. Petstore dokumentuje udane utworzenie jako 200. Jego schemat Pet wymaga name i photoUrls; id ma typ całkowity, ale nie znajduje się na liście wymaganych. Walidacja brakującego pola i tożsamość żądanie-odpowiedź wymagają zatem różnych sprawdzeń.
| Operacja | Dane wejściowe lub sekwencja | Dowód oczekiwanego wyniku | Asercja do przeglądu | Status wykonania |
|---|---|---|---|---|
| addPet, getPetById | Utwórz, następnie odczytaj bieżące ID | Udokumentowane 200 i schemat Pet; wyraźne oczekiwanie przepływu | Zweryfikuj treść i porównaj zwrócone ID | Przeszło lokalnie |
| updatePet, getPetById | Zmień nazwę i odczytaj ponownie | Operacja aktualizacji plus zatwierdzona intencja fixture | To samo ID, nowa nazwa, prawidłowy schemat | Przeszło lokalnie |
| findPetsByStatus | Zapytanie available po konfiguracji | Udokumentowany enum i pomyślna odpowiedź tablicy | Wszystkie zwrócone statusy się zgadzają; utworzone ID jest obecne | Przeszło lokalnie |
| getPetById | Niecałkowite ID ścieżki | Udokumentowane 400 dla nieprawidłowego ID | Dokładny status dla tego udokumentowanego przypadku | Przeszło: 400 |
| findPetsByStatus | Nieudokumentowana wartość enum | Udokumentowane 400 dla nieprawidłowego statusu | Dokładny status, zachowaj wszelkie niezgodności | Przeszło: 400 |
| addPet | Pomiń wymagane name | Wymagane pole schematu; opisy 400 i 422 nie mapują każdej zmiany | Zapisz zachowanie; rozstrzygnij dokładne mapowanie przed bramkowaniem | Zwrócono 200 bez name; niezgodność zachowana |
5. Wygeneruj i sprawdź plik wykonawczy (Prompt B). Załącz zatwierdzoną macierz i specyfikację z tym promptem:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Wykonaj, zachowaj i posprzątaj. Użyj ID zwierzaka specyficznego dla uruchomienia, przechwyć odpowiedź utworzenia i przekaż jego ID do późniejszych żądań. Zweryfikuj aktualizację przez świeży odczyt. Sama pomyślna odpowiedź aktualizacji nie dowodzi, że serwer utrwalił zmianę.
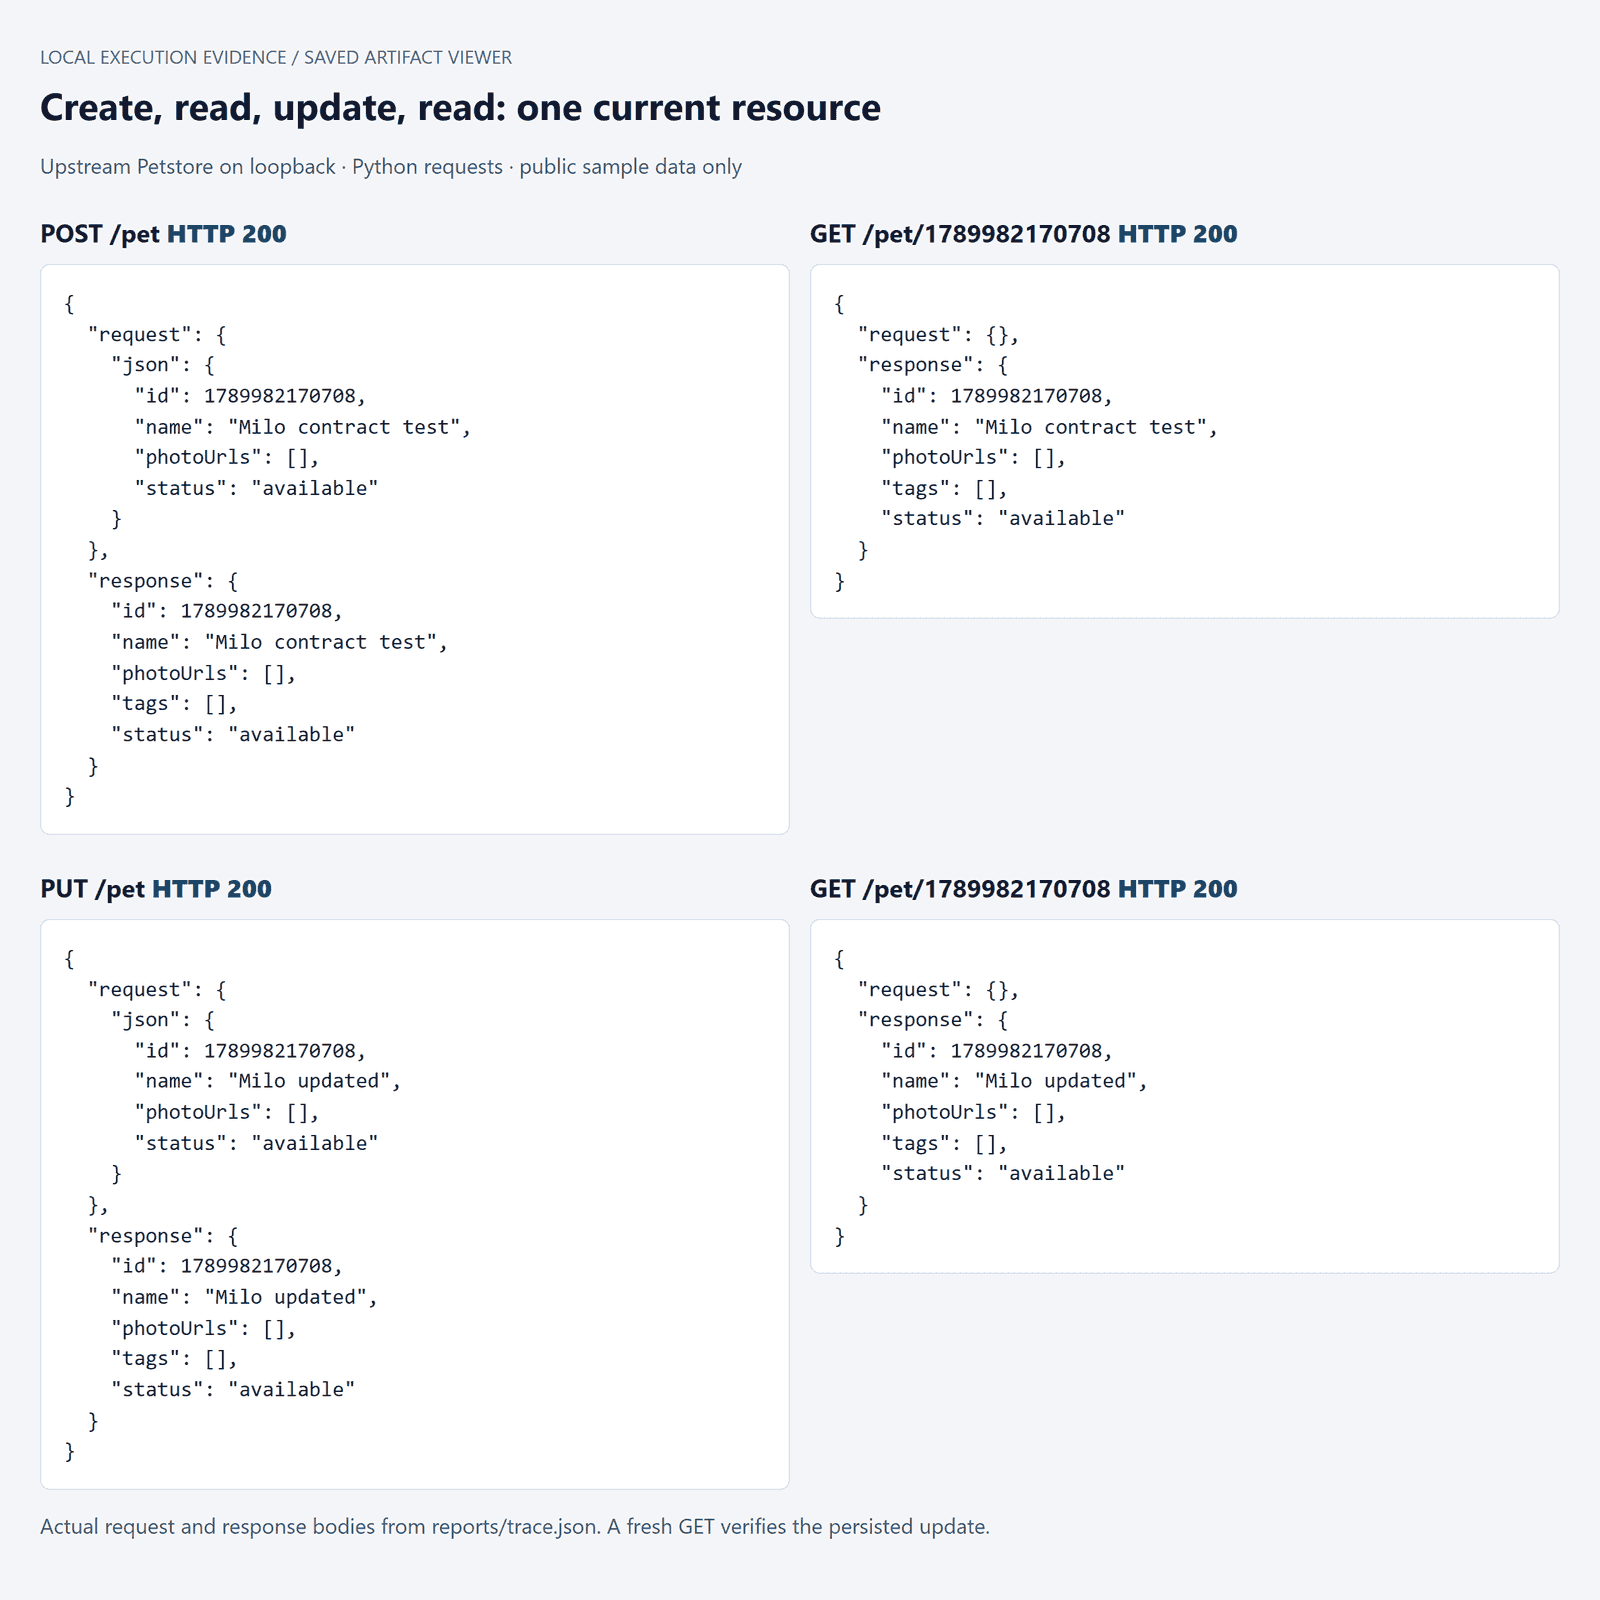 Dowód łańcucha żądań lokalnego Petstore pokazujący utworzenie, wyszukanie, aktualizację i przekazanie ID
Zapisane lokalne żądania i odpowiedzi: to samo ID specyficzne dla uruchomienia przetrwało utworzenie, odczyt, aktualizację i świeży odczyt. Wszystkie 4 wyświetlone żądania zwróciły 200.
Zapisz treści żądań, odpowiedzi, błędy asercji i wynik czyszczenia. Ogranicz usuwanie do ID utworzonych przez to uruchomienie. Zachowaj nieoczekiwane odpowiedzi jako ustalenia, w tym przypadki, w których implementacja demonstracyjna akceptuje nieprawidłowe dane wejściowe. Nie dostosowuj asercji tylko po to, aby uzyskać zielony zrzut ekranu.
Co znalazło to uruchomienie: 5 funkcji testowych na żywo przeszło, w tym sprawdzenia nieprawidłowego ID i nieprawidłowego statusu zwracające 400. Osobna próba brakującej nazwy zwróciła 200 i treść bez name. Zachowaliśmy tę rozbieżność schematu poza zielonym zestawem; jej dokładne zamierzone mapowanie błędów nadal wymaga wyjaśnienia. Oba utworzone rekordy zostały pomyślnie usunięte.
Testy lokalne zostały napisane w tym uruchomieniu artykułu, niezależnie od trzech komercyjnych narzędzi. Wszystkie 5 testów na żywo zachowano; żadnego nie usunięto ani nie złagodzono jego oczekiwań po wykonaniu. Czas przeglądu przez człowieka nie został zmierzony. Folder dowodów zawiera pliki testów, blokadę zależności, surowe odpowiedzi i instrukcje odtworzenia.
Jak zweryfikować narzędzia AI do testowania API
Przydatna asercja powinna odrzucać istotną błędną odpowiedź. Możesz przetestować tę właściwość bez zmiany działającej usługi: zapisz prawdziwą pomyślną odpowiedź, skopiuj ją i celowo zmodyfikuj jedno pole na raz. Są to kontrolowane mutacje odpowiedzi, a nie luki produkcyjne ani pełny benchmark testowania mutacyjnego.
Zachowaj razem oryginalny status i treść. Najpierw uruchom walidator na niezmienionej odpowiedzi i sprawdź, czy akceptuje punkt odniesienia. Następnie utwórz trzy niezależne kopie. Zmień ID, zmień typ nazwy i usuń wymaganą nazwę. Każda kopia powinna nie przejść z powodu odpowiadającego zmianie.
| Zapisany punkt odniesienia | Kontrolowana modyfikacja | Istotne sprawdzenie | Rzeczywisty wynik |
|---|---|---|---|
| Pomyślne wyszukanie bieżącego zwierzaka | Zastąp innym całkowitym ID; zachowaj status 200 | Zwrócone ID równa się oczekiwanemu ID tego uruchomienia | Niepowodzenie: oczekiwane i rzeczywiste ID różnią się |
Ciąg name | Zastąp nazwę liczbą | Typ string schematu Pet | Niepowodzenie: 42 nie jest ciągiem |
Obecne wymagane name | Usuń name | Lista wymaganych schematu Pet | Niepowodzenie: name jest wymagane |
Przykład z ID ujawnia częstą słabość. Walidator schematu może zaakceptować błędną liczbę całkowitą, ponieważ kształt pozostaje prawidłowy. Asercja relacji dostarcza brakujące ograniczenie. W pozostałych dwóch przykładach walidacja schematu dostarcza ograniczenia, których sprawdzenie tylko statusu nie widzi.
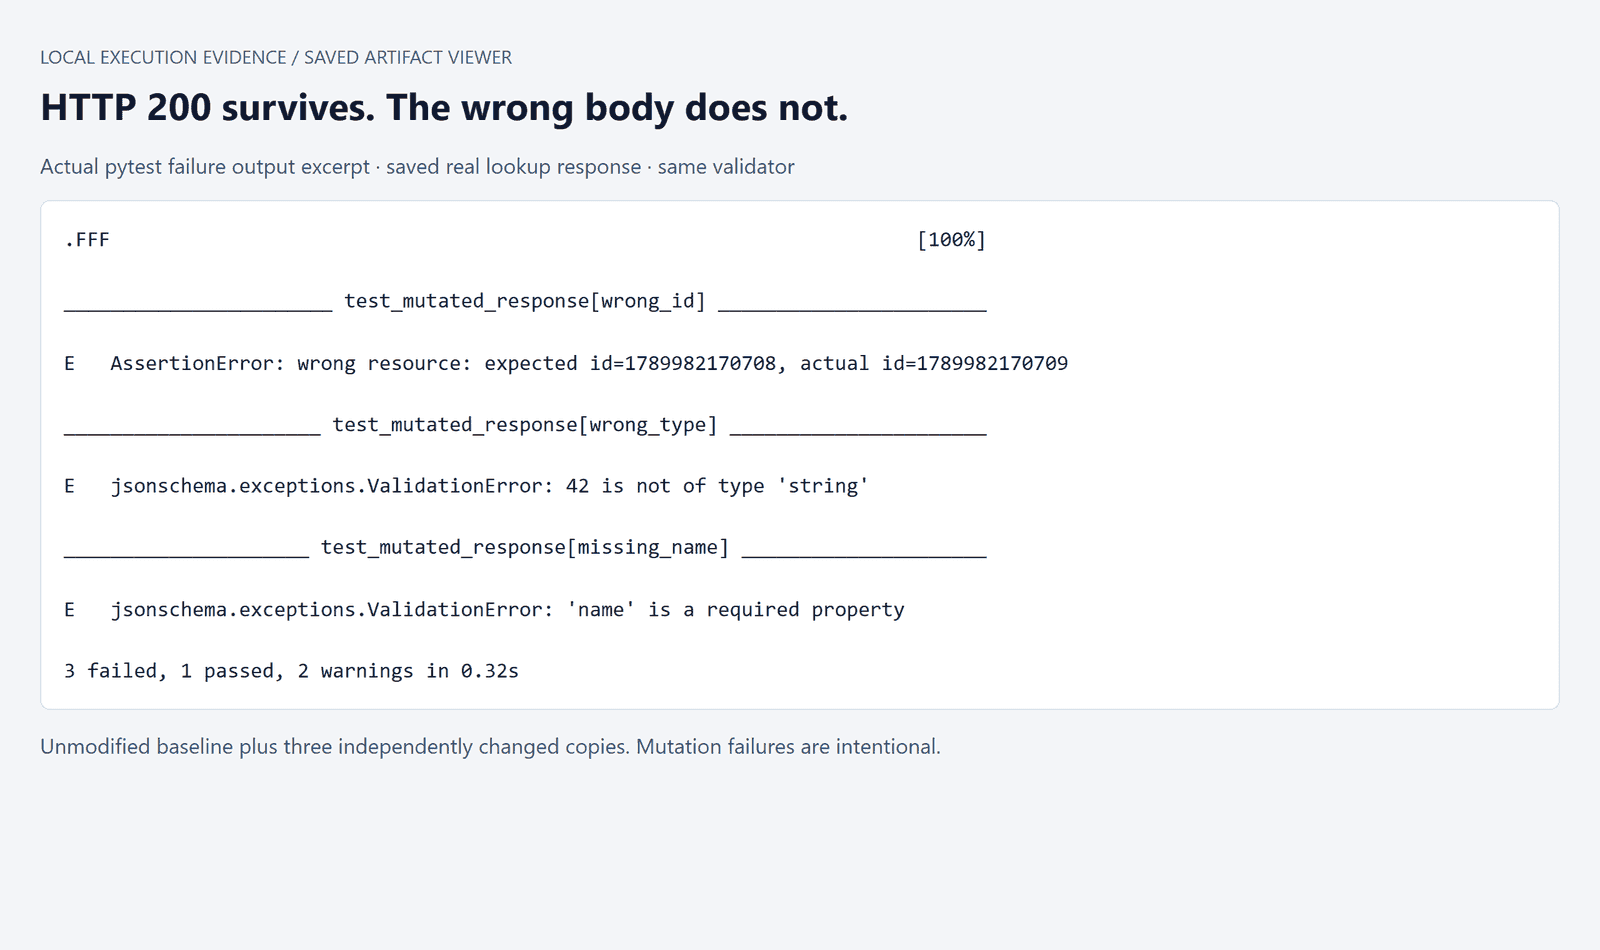 Rzeczywisty wynik błędu asercji dla kontrolowanych mutacji odpowiedzi Petstore
Rzeczywiste fragmenty błędów pytest: oryginalna odpowiedź przeszła, a wszystkie 3 niezależne mutacje nie przeszły. Te błędy zostały celowo wywołane w zapisanych kopiach.
W tym uruchomieniu niezmieniony punkt odniesienia przeszedł, a 3 z 3 zmienionych kopii nie przeszło. Uruchomienie mutacji zwróciło kod wyjścia 1, zachowując sygnał błędu. Walidator stosuje odpowiednie ograniczenia strukturalne schematu Pet i oddzielne sprawdzenie relacji ID; ta mała demonstracja nie jest kompletnym walidatorem zgodności OpenAPI.
Aby uzyskać powtarzalny audyt, załącz plik testowy i przypiętą specyfikację do Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Przejrzyj sugerowane zmiany „samonaprawiające” ze szczególną ostrożnością. Zastąpienie oczekiwanego 400 przez 200 może ukryć regresję. Uzasadniona zmiana kontraktu wymaga odniesienia do wymagań i przejrzanej zmiany testu. Zaobserwowana odpowiedź jest dowodem do zbadania, a nie automatycznym pozwoleniem na przedefiniowanie poprawności.
Rozdziel kategorie błędów przed poproszeniem AI o poprawkę. Limit czasu może wskazywać na niedostępne środowisko. Błąd wyszukiwania może pochodzić z uszkodzonego fixture. Błąd importu należy do kodu testowego. Powtarzalna niezgodność z uzgodnionym kontraktem może należeć do produktu. Zachowaj wystarczający kontekst, aby je rozróżnić.
Podaj mianownik uczciwie. Wykrycie trzech wybranych zmian odpowiedzi dowodzi wrażliwości na te trzy zmiany. Nie ustala pokrycia endpointów, pokrycia kodu, pokrycia bezpieczeństwa ani ogólnego wskaźnika wykrywania defektów. Podobnie duża liczba testów niewiele mówi o duplikatach scenariuszy lub sile ich asercji.
Uwierzytelnianie i autoryzacja zasługują na niezależne testy w odpowiedniej aplikacji: brakujące poświadczenia, wygasłe poświadczenia i dostęp do zasobów innego użytkownika. Zachowanie demonstracyjne Petstore nie może ustalić, że Twoje produkcyjne kontrole dostępu działają.
Narzędzia AI do testowania API w CI/CD
Gdy recenzent zaakceptuje zestaw, zatwierdź tę konkretną wersję. Kompilacja powinna wykonywać znane oczekiwania wobec kandydackiej aplikacji. Ponowne generowanie testów podczas każdej kompilacji wprowadza kolejny zmieniający się komponent i utrudnia odtworzenie błędów.
Przypnij runner, zależności, fixture'y i specyfikację. Przechowuj blokadę zależności obok testów i zachowaj wersję aplikacji w raporcie. Pobieraj sekrety ze środowiska CI, trzymaj je poza generowanymi plikami i sprawdź, czy logi błędów ich nie ujawniają.
W przypadku pytest podstawowy kształt raportowania jest prosty:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Dostarcz BASE_URL przez środowisko zadania. Uruchom lokalną usługę w cyklu życia zadania, poczekaj na gotowość, a następnie uruchom zestaw. Zawsze zbieraj raport i log usługi, nawet w przypadku błędu. Zakończ, zatrzymując własną usługę zadania i czyszcząc jej dane; unikaj poleceń czyszczenia obejmujących cały proces na współdzielonych agentach.
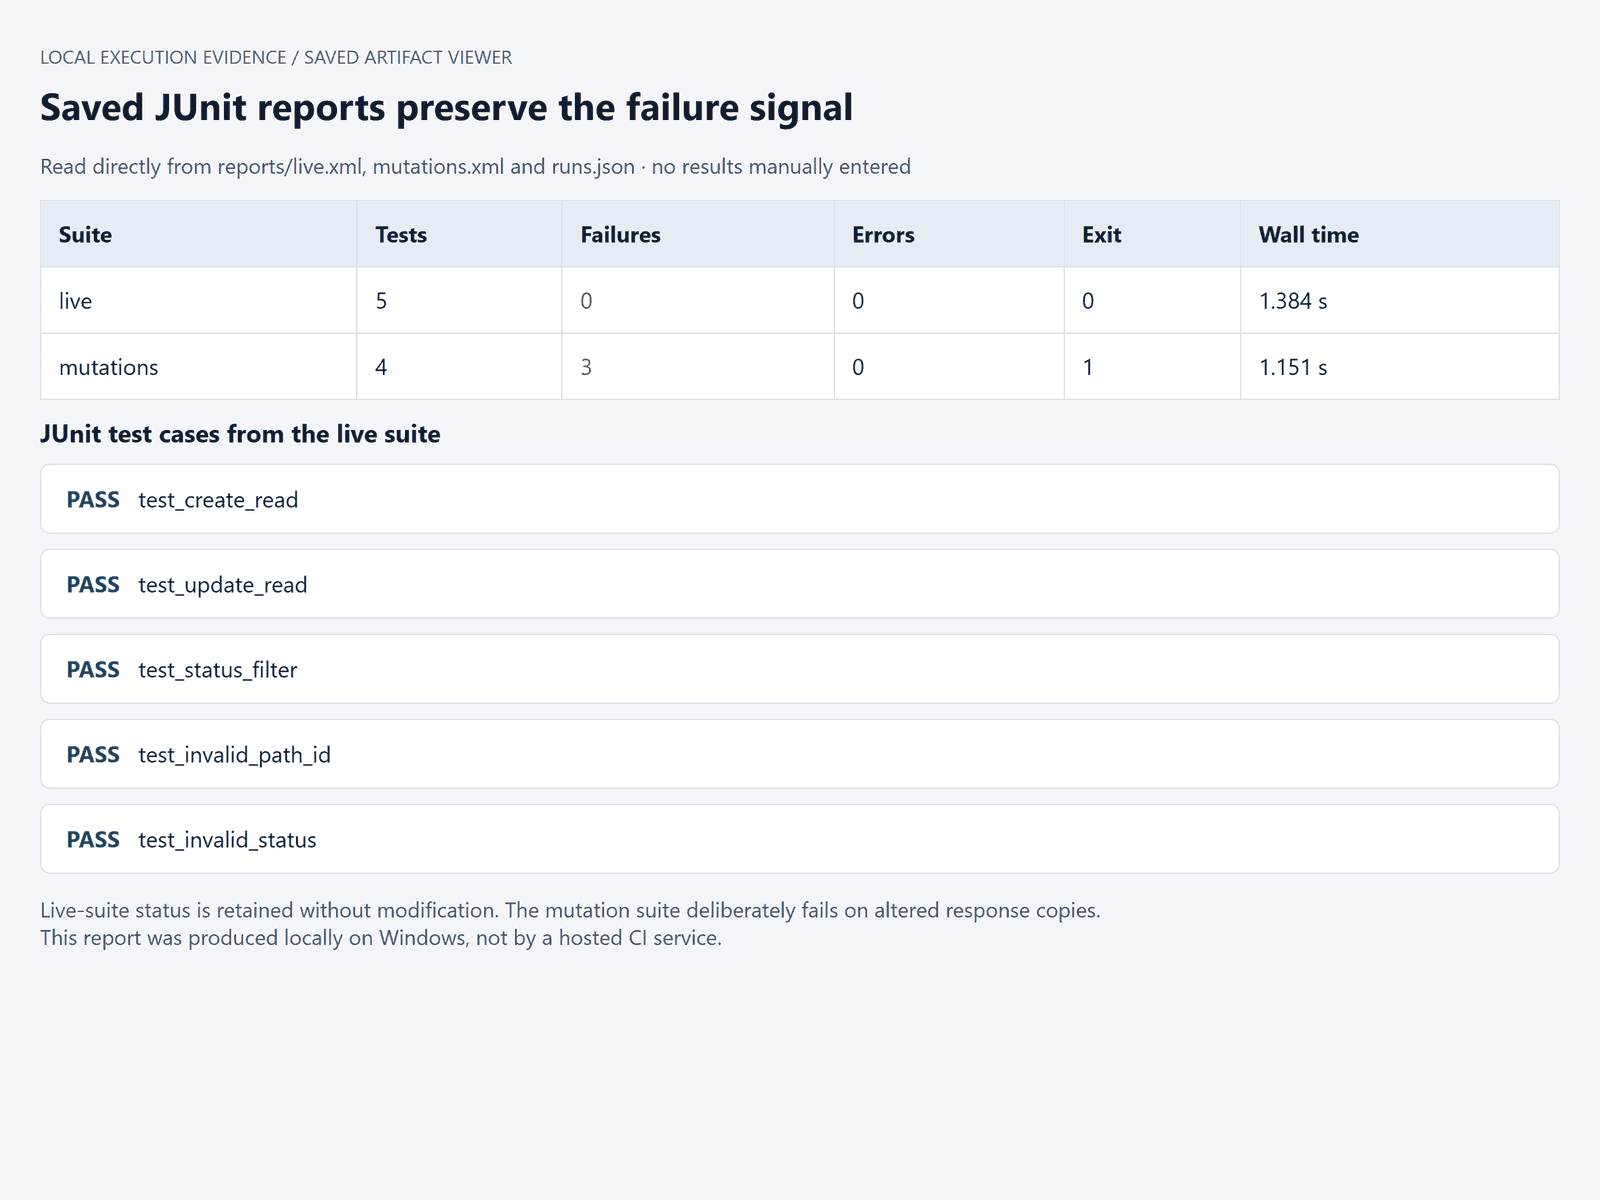 Lokalny raport pytest JUnit z oddzielnym wynikiem testu kontraktu na żywo i sprawdzenia asercji resultsActual local
Wyniki JUnit: 5 testów na żywo przeszło; zestaw kontrolowanych kopii zawiera 1 przechodzący punkt odniesienia i 3 zamierzone błędy. Nie twierdzi się, że uruchomiono hostowane CI.
Zmierzony czas rzeczywisty, w tym uruchomienie procesu Python, wyniósł 1,384 sekundy dla zestawu na żywo i 1,151 sekundy dla zestawu kontrolowanych kopii. Nie obejmują one kompilacji/uruchomienia usługi, instalacji zależności, tworzenia i przeglądu. Pliki JUnit i pełne logi są zapisane osobno.
Przetestuj ścieżkę awarii przed poleganiem na bramce. Nieudana asercja musi spowodować niezerowy kod wyjścia zadania. Ponowne próby powinny być ograniczone i uzasadnione dla znanych przejściowych problemów infrastruktury; powtarzane próby, które ostatecznie ukrywają awarię produktu, czynią bramkę mniej informacyjną.
Obsłuż błędy czyszczenia jawnie. Zachowaj widoczny główny błąd asercji, zapisz, który zasób pozostał, i pozwól, aby teardown zgłosił własny problem. Równoległe zadania wymagają oddzielnych identyfikatorów lub przestrzeni nazw. Test, który przechodzi sam, ale odczytuje dane innego zadania, nie jest gotowy do użycia bez nadzoru.
Jeśli masz już pytest, możesz wybrać model do tworzenia szkiców osobno. Atlas Cloud pasuje do tej węższej roli: warstwa modelu dla niestandardowego przepływu pracy, którego wykonanie i raportowanie już istnieją. Nie jest tu przedstawiany jako pełna platforma do testowania API ani natywny backend dla trzech powyższych produktów.
W tej ocenie otwórz DeepSeek V4.1 Flash, identyfikator modelu deepseek-ai/deepseek-v4.1-flash, i dostarcz tę samą publiczną specyfikację i przejrzaną macierz użyte lokalnie. Użyj Prompt B, a następnie zapisz zwrócony szkic oddzielnie od przejrzanego testu. Porównaj jego założenia z kontraktem przed wykonaniem czegokolwiek.
Jeśli interfejs to udostępnia, temperatura 0,2 to ustawienie początkowe do tworzenia szkiców, a nie gwarancja determinizmu. Sprawdź dostępny limit wyjścia w odniesieniu do rozmiaru zestawu. Sprawdź aktualny katalog modeli, aby poznać ceny tokenów, zamiast budżetować na podstawie starego artykułu.
Podział pracy pozostaje wyraźny: model proponuje kod, recenzent zatwierdza oczekiwania, a runner produkuje wyniki. Brama dostępu do środowiska testowego uniemożliwiła ukończenie uruchomienia Atlas dla tego artykułu, więc jest to przepis oceny, a nie zmierzony wynik modelu. Możesz ocenić tę ścieżkę bez migrowania działającego runnera testowego lub przekazywania jego obowiązków wykonawczych modelowi czatu.
Wybór narzędzi AI do testowania API dla Twojego zespołu
Wybierz najmniejszą ocenę, która może zmienić Twoją decyzję. Użyj jednego połączonego przepływu pracy, jednego udokumentowanego przypadku negatywnego i kilku kontrolowanych błędnych odpowiedzi. Utrzymuj równoważne dane wejściowe u wszystkich kandydatów. Wypolerowane doświadczenie wdrożeniowe nie powinno przeważać nad testem, który nie potrafi zidentyfikować niewłaściwego zasobu.
W przypadku dojrzałego przepływu pracy z kolekcjami zacznij od oceny funkcji AI w tej przestrzeni roboczej. Istniejąca konfiguracja środowiska i zależności żądań to cenny kontekst. Zmierz, czy generowane zmiany oszczędzają wysiłek związany z przeglądem, nie wprowadzając kruchych założeń.
W przypadku zespołu z solidną specyfikacją i zaległościami w pisaniu testów oceń generowanie na podstawie specyfikacji. Zwróć uwagę, co dzieje się, gdy specyfikacja jest niekompletna. Generator, który wyraźnie oznacza brakujące oczekiwania, jest łatwiejszy do przejrzenia niż taki, który pewnie je wymyśla.
W przypadku aplikacji, której awarie zależą od zachowania usług nadrzędnych, oceń rejestrowanie i odtwarzanie. Sprawdź przechwycone punkty odniesienia i obsługę zależności przed inwestowaniem w duże nagrania. Zdecyduj, które pola dynamiczne mogą się zmieniać, a które relacje muszą pozostać nienaruszone.
W przypadku zespołu ze stabilnym runnerem oceń niezależny model do tworzenia szkiców i przeglądu. Zachowujesz znany format wykonywania, ale przejmujesz również odpowiedzialność za integrację, projekt fixture'ów i utrzymanie. Uwzględnij tę odpowiedzialność w kalkulacji kosztów.
Przed zapłaceniem za narzędzia AI do testowania API wymagaj pięciu konkretnych demonstracji:
- Przejrzany zestaw działa w zamierzonym środowisku.
- Istotne kontrolowane błędy powodują niepowodzenie odpowiednich asercji.
- Testy i przydatne raporty można zachować w akceptowalnym formacie.
- Powtarzane uruchomienia, w tym wykonywanie w CI, zachowują izolację i sygnały błędów.
- Koszty generowania, wykonywania i utrzymania mieszczą się w budżecie zespołu.
Wyznacz kogoś do utrzymania zaakceptowanego zestawu. Zmiana specyfikacji powinna wywołać przegląd dotkniętych asercji, fixture'ów i konsumentów. Zachowaj stare dowody błędów, dopóki zmiana nie zostanie zrozumiana. Ułatwia to ocenę następnego wydania i daje zespołowi powód do zaufania zielonemu raportowi.
Często zadawane pytania
Którego narzędzia AI powinienem użyć do testowania API?
Zacznij od istniejących danych wejściowych. Oceń Postman Agent Mode dla istniejących kolekcji, KushoAI do generowania na podstawie specyfikacji i Keploy ze względu na jego odrębne ścieżki generowania przepływów i rejestrowania. Jeśli Twój zespół utrzymuje już pytest lub inny runner, może pasować oddzielny model do tworzenia szkiców. Użyj tego samego małego przepływu pracy, aby ocenić asercje, wykonanie i wysiłek przeglądu każdego kandydata.
Czy istnieją darmowe narzędzia AI do testowania API?
Istnieją darmowi klienci, narzędzia testowe open source i ograniczone limity AI. Obejmują różne potrzeby. Darmowy plan Postman wymienia 50 miesięcznych kredytów AI na dzień 21 września 2026 r.; to nie jest liczba testów. Sprawdź, czy wymagane funkcje eksportu, automatyzacji, raportowania i współpracy są uwzględnione, zanim uznasz próbę interaktywną za darmowe rozwiązanie CI.
Czy AI może generować testy API ze specyfikacji OpenAPI?
Tak, generator może użyć operacji, schematów, parametrów i definicji odpowiedzi do zaproponowania testów. Specyfikacja może jednak pomijać reguły biznesowe lub pozostawiać niejednoznaczne mapowania błędów. Dostarcz zatwierdzone oczekiwania i przejrzyj wynik. W przypiętym przykładzie Petstore pomyślne utworzenie jest udokumentowane jako 200, co ilustruje, dlaczego znane konwencje REST nie mogą zastąpić rzeczywistego kontraktu.
Skąd mam wiedzieć, czy asercje wygenerowane przez AI są przydatne?
Sprawdź trzy rzeczy: udokumentowane ograniczenia schematu, relacje między żądaniami a odpowiedziami oraz wrażliwość na celowo nieprawidłowe dane. Zapisz prawdziwą odpowiedź, zmodyfikuj jedną istotną właściwość i uruchom ponownie ten sam walidator. Zachowaj komunikat o błędzie. Daje to wąskie, powtarzalne dowody dotyczące tych asercji, pozostawiając szersze pytania o pokrycie i bezpieczeństwo do oddzielnego testowania.
Czy mogę uruchamiać testy API wygenerowane przez AI w CI/CD?
Tak, gdy wygenerowany format, runner, środowisko i plan obsługują tę ścieżkę. Zatwierdź przejrzane testy, zainstaluj przypięte zależności, użyj izolowanych fixture'ów i wyeksportuj ustrukturyzowany raport, taki jak JUnit. Sprawdź, czy błędy zwracają niezerowy kod wyjścia. Pomyślne uruchomienie lokalne przygotowuje zestaw do CI; nie dowodzi, że hostowany potok został uruchomiony.
Czy AI może zastąpić ręczne testowanie API?
AI może ograniczyć powtarzalne tworzenie szkiców i pomóc recenzentom znaleźć słabe asercje. Ludzie nadal decydują o zamierzonym zachowaniu, badają niejednoznaczne awarie i odkrywają ryzyka poza dostarczonymi przykładami. Używaj narzędzi AI do testowania API, aby tworzyć zasoby testowe nadające się do przeglądu, a następnie oceniaj je na podstawie powtarzalnych dowodów. Mniejszy zestaw, który wychwytuje istotne błędy,łatwiej zaufać niż niewyjaśnionemu zbiorowi zielonych znaczników.


