DeepSeek Harness nie brał udziału w tym benchmarku. Został wydany dwa dni później. Oznacza to, że użyteczne pytanie nie brzmi „który wygrał?”. Użyteczne pytanie brzmi: jak uruchomić to samo zadanie przez oba narzędzia, na tym samym modelu i odczytać rachunek bez oszukiwania samego siebie.
Kluczowe wnioski
- Wybór uprzęży może zmienić zużycie tokenów nawet o około 7x w porównywalnych zadaniach agentowych.
- Mierz DeepSeek Harness i OpenCode z tym samym modelem i tym samym stanem repozytorium.
- Używaj oddzielnych kluczy API, zanim wybierzesz jeden do codziennej pracy.
Dwa laptopy wykonujące to samo zadanie programistyczne przez dwie uprzęże agentowe
Uczciwa konfiguracja: jeden model, jedno zadanie, dwa terminale.
Co mówi nam publiczny benchmark
Composio uruchomił 30 złożonych przepływów wieloapowych przez 8 uprzęży agentowych, wszystkie korzystające z DeepSeek V4 Flash, limit 900 sekund na zadanie i binarna ocena programistyczna w 240 uruchomieniach (Composio, sierpień 2026). Ten sam model, różne uprzęże.
| Uprząż | Wskaźnik zaliczeń | Mediana czasu | Średnia liczba tokenów na zadanie |
|---|---|---|---|
| Pi Agent | 66,7% | 132,2s | 559 000 |
| Prime Agent | 62,5% | 242,1s | 1 400 000 |
| OMP | 56,7% | 272,4s | 742 000 |
| Claude Code | 53,3% | 122,7s | 742 000 |
| Codex | 53,3% | 245,0s | 678 000 |
| DeepAgents | 53,3% | 187,1s | 665 000 |
| Hermes Agent | 50,0% | 175,5s | 192 000 |
| OpenCode | 46,7% | 129,7s | 692 000 |
Kolumna tokenów ma większe znaczenie niż ranking. Rozpiętość wynosi od 192 000 do 1 400 000 średnich tokenów na zadanie. To ten sam model wykonujący porównywalną pracę przez różne środowiska uruchomieniowe.
OpenCode daje nam źródłową wartość bazową: 692 000 tokenów na zadanie, 46,7% wskaźnik zaliczeń i 129,7 sekundy mediany czasu. DeepSeek Harness nie ma publicznej liczby z tego benchmarku, ponieważ DeepSeek wydał go 13 sierpnia 2026, dwa dni po opublikowaniu benchmarku.
Potraktuj tabelę jako ostrzeżenie, a nie werdykt. Pokazuje, że uprząż może zdominować koszt. Nie dowodzi, czy DeepSeek Harness bije OpenCode w twoim repozytorium.
Co się zmienia, gdy zmieniasz uprzęże
Przed testowaniem porównaj oba narzędzia pod kątem elementów, które wpływają na pracującego programistę: powierzchnia konfiguracji, dojrzałość, widoczność tokenów i jak dużą część pętli agenta możesz wymienić.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Od | DeepSeek AI | Anomaly (pierwotnie SST) |
| Wydany | 13 sierpnia 2026 | Koniec 2025 |
| Gwiazdy na GitHub | ~143k | ~198k |
| Licencja | MIT | MIT |
| Język | TypeScript | Go |
| Interfejs | Web UI na 127.0.0.1:3080 | Terminal TUI |
| Status | Wersja deweloperska, spodziewane zmiany przełomowe | Dojrzały, szeroko wdrożony |
| Architektura | Zastępowalne wtyczki dla modeli, narzędzi, sesji, piaskownic, pamięci, pętli i UI | Stały rdzeń z agentami budowania/planowania, wsparcie MCP i rozszerzenia LSP |
| Konfiguracja | $DSH_HOME/settings.yaml | opencode.json |
| Rachunkowość tokenów | Licznik tokenów z informacjami o ciśnieniu kontekstu i prognozami rozbicia | Śledzenie tokenów i kosztów na sesję w TUI |
| Najlepsze dla | Zespołów, które chcą modyfikować samą pętlę agenta | Zespołów, które potrzebują agenta kodującego działającego dziś |
OpenCode daje stabilnego agenta kodującego z punktami rozszerzeń na obrzeżach. DeepSeek Harness daje środowisko uruchomieniowe, w którym sama pętla może być wymieniona. Ta elastyczność pomaga, jeśli budujesz infrastrukturę agentową. Dodaje ryzyko, jeśli potrzebujesz domyślnego narzędzia do produkcyjnego kodu w tym tygodniu.
Oba narzędzia mogą korzystać z tego samego kompatybilnego z OpenAI punktu końcowego. To umożliwia uczciwy test: jeden model, jeden podstawowy URL, jedno zadanie i jeden początkowy stan repozytorium.
W tym przewodniku DeepSeek V4 Flash działa przez Atlas Cloud, który udostępnia kompatybilny z OpenAI punkt końcowy akceptowany przez oba narzędzia. Lista deepseek-v4-flash-0731 pokazuje 0,14 USD za milion tokenów wejściowych, 0,28 USD za milion tokenów wyjściowych, okno kontekstu 1 048 576 tokenów i maksymalny wynik 393 216 od sierpnia 2026. Każdy dostawca działa, jeśli obie uprzęże używają tego samego punktu końcowego i identyfikatora modelu.
OpenCode publikuje również zagregowane dane dotyczące użycia. Modele DeepSeek przeniosły 233 biliony tokenów przez OpenCode, z czego V4 Flash stanowi 85,5%, a V4 Pro 14,5% (OpenCode, sierpień 2026). Ten wzorzec użycia czyni V4 Flash praktycznym domyślnym wyborem do porównania.
Krok 1: Skieruj oba narzędzia na ten sam model
Utwórz jeden klucz API i jeden podstawowy URL, a następnie podaj obu narzędziom tę samą parę. Utwórz klucz w konsoli Atlas Cloud i wyeksportuj go raz:
plaintext1export ATLAS_API_KEY="your-api-key" 2
Sprawdź punkt końcowy, zanim przekażesz go którejś z uprzęży:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
To wywołanie dowodzi, że trasa, klucz i identyfikator modelu działają, zanim uprząż doda narzędzia, ponowienia lub odtwarzanie konwersacji.
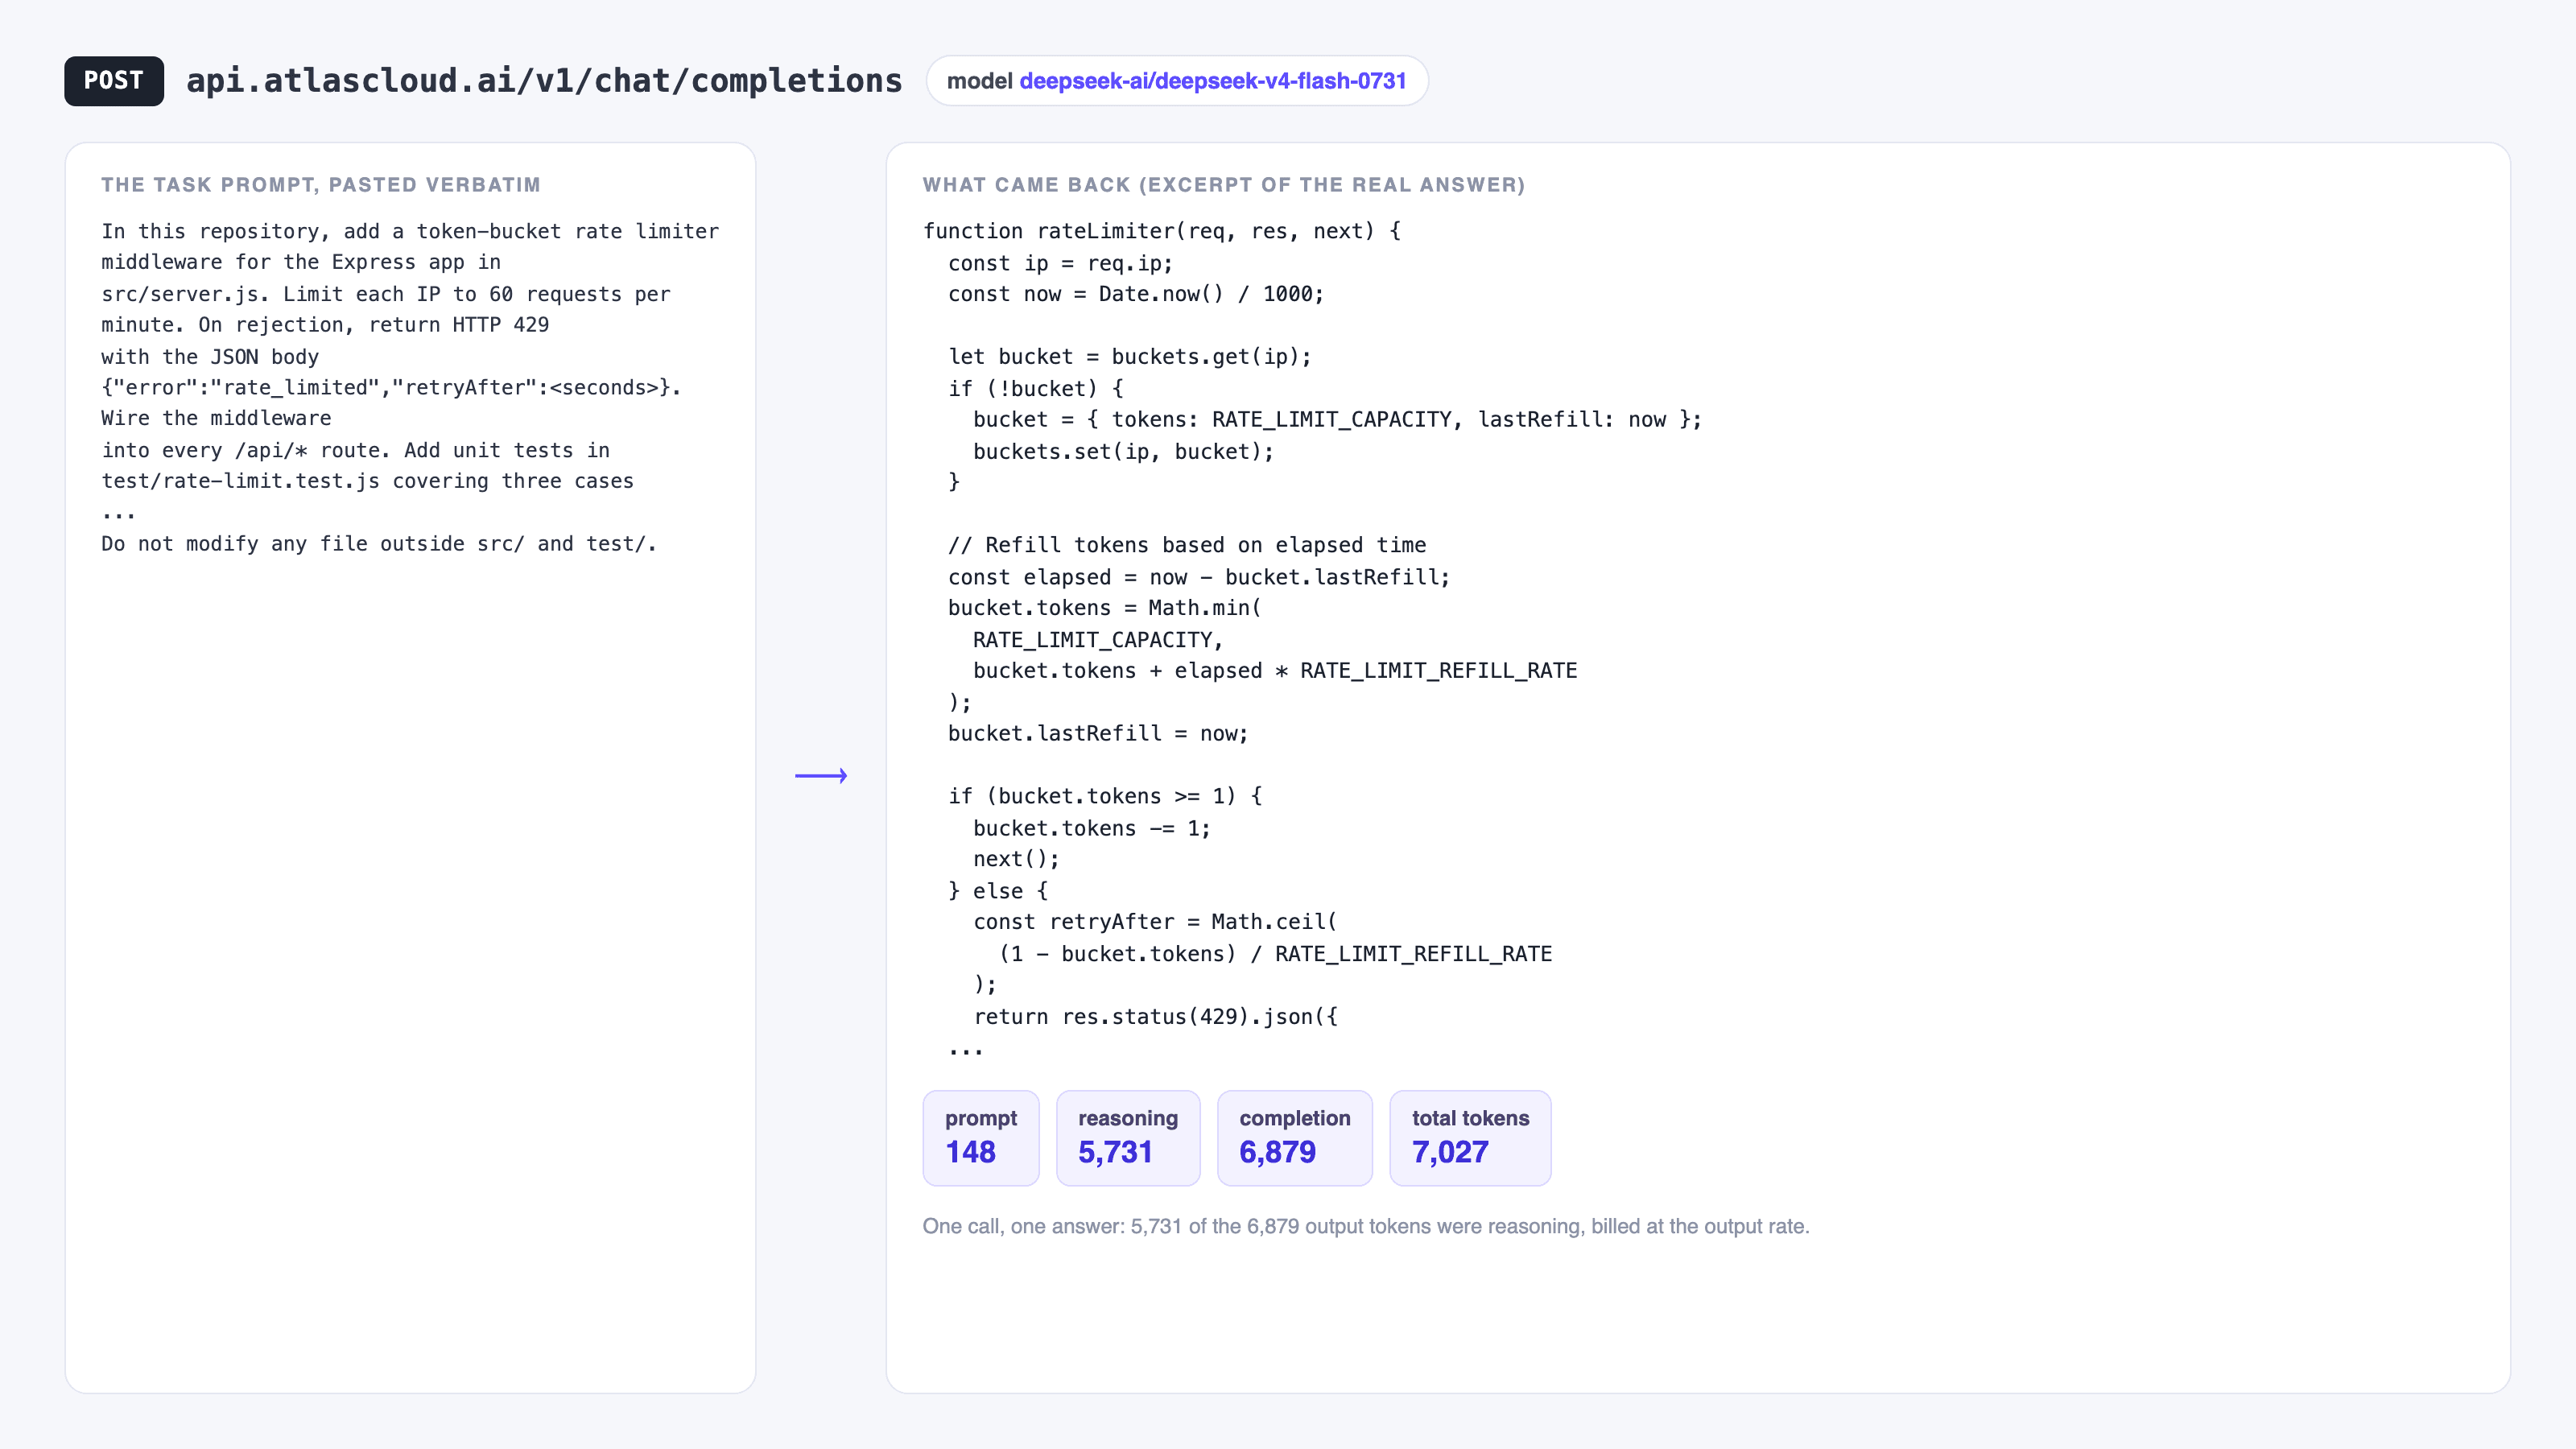
Monit programistyczny, wygenerowany kod i statystyki tokenów z jednego wywołania modelu
Jedno bezpośrednie wywołanie deepseek-ai/deepseek-v4-flash-0731: 148 tokenów promptu wejściowego, 6 879 tokenów wyjściowych, w tym 5 731 tokenów wnioskowania. Traktuj to jako podłogę przed dodaniem przez uprząż schematów narzędzi i historii.
DeepSeek Harness odczytuje $DSH_HOME/settings.yaml, a niestandardowi dostawcy kompatybilni z OpenAI umieszczani są pod wtyczką llm-pi-ai (dokumentacja DeepSeek Harness, sierpień 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Użyj openai-completions dla tego punktu końcowego. Interfejs webowy może zapisać ten sam blok dostawcy w Ustawienia, Modele, Dodaj niestandardowego dostawcę, a następnie przechować klucz w $DSH_HOME/.credentials.yaml.
OpenCode odczytuje opencode.json w katalogu głównym projektu lub globalnym katalogu konfiguracyjnym (dokumentacja OpenCode, sierpień 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Użyj @ai-sdk/openai-compatible, ponieważ ten punkt końcowy obsługuje /v1/chat/completions. Ustaw rzeczywiste limity kontekstu i wyjścia. OpenCode używa ich przy podejmowaniu decyzji o podsumowaniu, a błędne limity mogą zniekształcić porównanie tokenów.
Krok 2: Uruchom to samo zadanie benchmarkowe w DeepSeek Harness
Wybierz zadanie wystarczająco duże, aby wymagać kilku wywołań narzędzi, i wystarczająco małe, aby ocenić. Użyj tego samego stanu repozytorium dla obu uruchomień, więc zatwierdź lub schowaj przed rozpoczęciem.
Wklej to dokładne zadanie do obu narzędzi:
plaintext1W tym repozytorium dodaj oprogramowanie pośredniczące ogranicznika prędkości z wiadrem tokenów dla aplikacji Express w src/server.js. Ogranicz każdy adres IP do 60 żądań na minutę. Po odrzuceniu zwróć HTTP 429 z treścią JSON {"error":"rate_limited","retryAfter":<sekundy>}. Podłącz oprogramowanie pośredniczące do każdej trasy /api/*. Dodaj testy jednostkowe w test/rate-limit.test.js obejmujące trzy przypadki: żądanie poniżej limitu jest dozwolone, żądanie powyżej limitu jest blokowane z 429, a licznik resetuje się po wygaśnięciu okna. Uruchom zestaw testów i napraw błędy, aż przejdzie. Nie modyfikuj żadnego pliku poza src/ i test/. 2
Uruchom Harness z katalogu projektu:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
Interfejs działa pod adresem http://127.0.0.1:3080. Wybierz dostawcę atlas i model deepseek-ai/deepseek-v4-flash-0731, wklej zadanie i pozwól mu zakończyć. Nie dodawaj wskazówek po uruchomieniu. Dodatkowa pomoc dla jednego narzędzia unieważnia porównanie.
Gdy Harness zakończy, otwórz widok Trajektorii. To nagranie sesji zawiera liczby tokenów.
Krok 3: Powtórz uruchomienie w OpenCode
Zresetuj repozytorium do dokładnego stanu początkowego. Druga uprząż nie może odziedziczyć plików, które pierwsza już zmieniła.
plaintext1git checkout -- . && git clean -fd 2
Następnie uruchom OpenCode z tym samym modelem:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Wklej ten sam prompt zadania z kroku 2. Użyj domyślnego agenta build. Pozwól mu zakończyć bez wskazówek.
Oceń oba uruchomienia tym samym poleceniem:
plaintext1npm test 2
Uruchomienie, które pozostawia zestaw testów czerwony, kończy się niepowodzeniem, nawet jeśli podsumowanie agenta brzmi pewnie. Użyj oceny binarnej: zaliczony lub niezaliczony.
Krok 4: Odczytaj zużycie tokenów
Oba narzędzia śledzą użycie, ale żaden licznik nie powinien być twoją ostateczną liczbą na fakturze.
DeepSeek Harness dostarcza domyślnie zamontowany licznik tokenów. Udostępnia tokenUsage, contextPressure i contextBreakdown w widoku Trajektorii. contextBreakdown mówi, czy rachunek pochodzi z promptu systemowego, schematów narzędzi, odczytów plików czy odtwarzania konwersacji. Licznik szacuje mniej więcej jeden token na cztery znaki, więc używaj go jako widoku diagnostycznego.
OpenCode śledzi tokeny i koszt na sesję i wyświetla je w pasku stanu TUI. Jego wbudowany podział jest mniejszy, więc zespoły potrzebujące atrybucji na narzędzie często sprawdzają bazę danych sesji za pomocą zewnętrznych analizatorów.
Użyj liczb po stronie dostawcy do porównania:
| Co porównać | Gdzie to uzyskać |
|---|---|
| Całkowita liczba tokenów wejściowych | Panel użycia dostawcy, na klucz API |
| Całkowita liczba tokenów wyjściowych | Panel użycia dostawcy, na klucz API |
| Liczba wywołań modelu | Widok trajektorii uprzęży / dziennik sesji OpenCode |
| Czas rzeczywisty | Stoper, od początku do ostatniego zapisu pliku |
| Zaliczony/niezaliczony | Kod wyjścia npm test |
Utwórz dwa klucze API, harness-test i opencode-test, i użyj każdego klucza dla jednego uruchomienia. Panel dostawcy da ci wtedy czyste zestawienie obok siebie bez uzgadniania dwóch wewnętrznych estymatorów.
Dlaczego rachunek się zmienia
Zużycie tokenów zmienia się z konkretnych powodów. Te pięć zwykle ma większe znaczenie niż cena modelu.
Odtwarzanie konwersacji się sumuje. Agenci wysyłają ponownie rosnącą konwersację na każdym kroku. 40-krokowe zadanie kosztuje bliżej sumy 40 rosnących promptów niż 40 identycznych promptów. Uprzęże, które wcześnie podsumowują, lądują bliżej dolnego końca rozpiętości benchmarku.
Trafienia w pamięci podręcznej obniżają koszt wejścia. Trafienia w pamięci podręcznej DeepSeek V4 Flash są wycenione na około 0,0028 USD za milion tokenów wobec 0,14 USD za milion przy chybieniu, czyli około 98% taniej. Buforowanie wymaga stabilnego prefiksu bajt po bajcie. Jeśli uprząż tasuje tekst promptu systemowego między wywołaniami, zamienia trafienia w chybienia.
Schematy narzędzi jadą razem. Dwadzieścia połączonych serwerów MCP oznacza dwadzieścia zestawów schematów w prompcie, nawet jeśli zadanie używa dwóch z nich. Odłącz narzędzia, których nie potrzebujesz, przed benchmarkiem, w przeciwnym razie mierzysz konfigurację narzędzi, a nie uprząż.
Duże wyniki narzędzi zatruwają kontekst. cat pliku z 3000 liniami lub szczegółowy dziennik nieudanego testu pozostaje w konwersacji dla późniejszych wywołań. DeepSeek Harness może przycinać duże wyniki narzędzi przed podsumowaniem. Włącz to, gdy zadanie generuje głośne wyjście.
Ponowienia ukrywają się w liczbie wywołań. Uprząż, która ponawia pętlę nieudanego testu, wydaje tokeny za każdym razem. Porównaj liczbę wywołań modelu obok całkowitych tokenów, aby oddzielić pętlę ponowień od drogiego promptu.
Przy stawce Atlas Cloud za DeepSeek V4 Flash, zadanie z 692 000 tokenów ukierunkowane na wejście ląduje w niskich jednocyfrowych centach. To mało dla jednego uruchomienia, a dużo w zespole uruchamiającym agentów przez cały dzień. Przeglądaj pełny katalog modeli, jeśli chcesz powtórzyć test na drugim modelu i oddzielić efekty modelu od efektów uprzęży.
DeepSeek Harness jest wciąż wersją deweloperską, a jego README ostrzega przed zmianami przełomowymi. Benchmarkuj go, jeśli chcesz kontrolować pętlę agenta. Standaryzuj na nim tylko wtedy, gdy twój zespół może wchłonąć zmiany. OpenCode jest stabilniejszym wyborem dla zespołów, które potrzebują narzędzia dziś.
Często zadawane pytania
Czy DeepSeek Harness jest lepszy od OpenCode?
Na razie nie dla większości zespołów. OpenCode jest dojrzały, natywny dla terminala, ma około 198k gwiazdek i duży katalog dostawców, i działa dziś. DeepSeek Harness jest nowszy, w wersji deweloperskiej i ostrzega przed zmianami przełomowymi. Wybierz Harness, jeśli chcesz modyfikować wnętrzności agenta. Wybierz OpenCode, jeśli potrzebujesz agenta kodującego do codziennej pracy.
Czy DeepSeek Harness działa tylko z modelami DeepSeek?
Nie. Jest niezależny od modelu. Dostarcza katalogowych dostawców dla DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure i Codex, a w $DSH_HOME/settings.yaml możesz dodać dowolnego niestandardowego dostawcę mówiącego openai-completions, openai-responses lub anthropic-messages. Konfiguracja z kroku 1 kieruje go na kompatybilny z OpenAI punkt końcowy bez kodu adaptera.
Jak sprawdzić zużycie tokenów w DeepSeek Harness?
Użyj wbudowanego licznika tokenów w widoku Trajektorii. Udostępnia tokenUsage, contextPressure i contextBreakdown. Traktuj to jako szacunek, ponieważ używa mniej więcej jednego tokena na cztery znaki. Dla dokładności rozliczeń odczytaj panel użycia dostawcy, najlepiej z dedykowanym kluczem API dla każdego uruchomienia.
Która uprząż zużywa mniej tokenów, DeepSeek Harness czy OpenCode?
Żaden publiczny benchmark bezpośredni nie odpowiada jeszcze na to pytanie. Benchmark Composio zmierzył OpenCode na średnio 692 000 tokenów na zadanie, ale został uruchomiony przed wydaniem DeepSeek Harness. Wykonaj test z kroków 2-4 we własnym repozytorium, ponieważ zużycie tokenów zależy od rozmiaru bazy kodu, konfiguracji narzędzi i kształtu zadania.
Czy mogę uruchomić DeepSeek Harness i OpenCode przeciwko temu samemu kluczowi API?
Tak, do zwykłego testu. Dla czystego pomiaru użyj dwóch oddzielnych kluczy, jednego na uprząż. Panel dostawcy przypisze wtedy każdy token do odpowiedniego uruchomienia.
Jaka jest różnica między agentem a uprzężą?
DeepSeek opisuje agenta jako Model plus Uprząż. Model rozumuje. Uprząż łączy model z plikami, poleceniami powłoki, narzędziami, sesjami, zatwierdzeniami i pętlą, która decyduje o następnej akcji. Zmień uprząż, a ten sam model może wydać różną liczbę tokenów na to samo zadanie.


