

Archiwum projektu liczące 900 stron łatwo przesłać. Trudniejsze pytanie brzmi, czy model potrafi wskazać dokładny zapis, commit lub punkt danych, którego potrzebujesz. Zastosowania okna kontekstowego 1M w DeepSeek V4.1 Flash mają sens, gdy kilka powiązanych źródeł trzeba rozważyć łącznie, na przykład repozytorium kodu, korpus badawczy czy wieloletnie zapisy projektu. Większe okno ogranicza potrzebę wcześniejszego dzielenia tych materiałów, ale to weryfikacja dowodów wciąż decyduje o tym, czy odpowiedź jest wiarygodna.
Najlepiej sprawdzają się tu przegląd kodu między plikami, synteza badań, porównanie polityk, analiza opinii, harmonogramy projektów oraz długie zapisy multimodalne. DeepSeek podaje kontekst 1M tokenów, ale ta pojemność nie gwarantuje, że każdy szczegół zostanie trafnie przywołany. Sprawdź limity modelu i API dla swojej ścieżki, a następnie przetestuj własny materiał, zanim oprzesz się na wyniku.
Najważniejsze wnioski
- Używaj okna miliona tokenów, gdy pytanie zależy od relacji między wieloma istotnymi źródłami.
- Proś o odniesienia do plików, sekcji lub stron i oddzielaj bezpośrednie dowody od wnioskowania.
- Zacznij od testu ze znaną odpowiedzią i rozszerzaj kontekst tylko wtedy, gdy poprawia to wynik.
- Szacuj koszt na podstawie danych wejściowych, wyjściowych i obsługi pamięci podręcznej, a nie samego limitu kontekstu.
Co oznacza okno kontekstowe 1M tokenów?
Okno kontekstowe to ilość informacji, którą model może rozważyć w jednym żądaniu lub stanie rozmowy, obejmująca dostarczony materiał i otaczające instrukcje. Aktualna strona z cennikiem API DeepSeek wymienia DeepSeek-V4.1-Flash z długością kontekstu 1M i maksymalnym wyjściem 384K tokenów. To limit podany przez dostawcę; Twoja aplikacja, endpoint lub konfiguracja żądania mogą narzucać mniejszy limit. ( Dokumentacja API DeepSeek )
Tokeny to fragmenty tekstu, a nie słowa czy strony. Archiwum źródłowe zawierające kod, tabele, znaczniki, powtarzalny szablon i skany może tokenizować się zupełnie inaczej niż czysty tekst o tej samej liczbie stron. W przypadku rzeczywistego obciążenia oszacuj tokeny za pomocą tokenizera lub raportowania zużycia dla API, które będziesz wywoływać. Uwzględnij w szacunku instrukcje systemowe, nazwy plików, metadane, treść pytania i budżet odpowiedzi.
Praktyczna korzyść to ciągłość. Możesz pytać o zależności między kilkoma modułami lub sprzeczności między aktualną polityką a jej załącznikami, bez ręcznego łączenia najpierw podsumowań. Kompromis polega na tym, że bardzo duży prompt może zawierać materiał nieistotny lub zduplikowany, dłużej się przetwarzać i mimo to utrudniać dokładne wyszukiwanie. Traktuj „mieści się w oknie” jako kontrolę pojemności, a następnie sprawdź, czy model potrafi znaleźć fakty potrzebne do Twojego zadania.
Najlepsze zastosowania okna kontekstowego 1M w DeepSeek V4.1 Flash
Właściwe pytanie nie brzmi „Czy mogę przesłać wszystko?”, lecz „Które źródła trzeba porównać, aby odpowiedzieć na to pytanie?”. Używaj długiego kontekstu, gdy odpowiedź zależy od powiązań między materiałami, i określ, jak zweryfikujesz tę odpowiedź, zanim wyślesz całe archiwum.
| Zastosowanie | Dlaczego długi kontekst pomaga | Co uwzględnić | Co zweryfikować |
|---|---|---|---|
| Przegląd dużego repozytorium kodu | Interfejsy i konwencje rozciągają się na moduły | Istotny kod źródłowy, testy, notatki architektoniczne | Ścieżki plików, symbole, dowody z testów |
| Synteza badań | Metody i wyniki wymagają porównania obok siebie | Prace, raporty, ograniczenia | Źródło każdego twierdzenia i zastrzeżenia |
| Porównanie umów lub polityk | Definicje i wyjątki powtarzają się w sekcjach | Wersje bieżące i poprzednie, załączniki | Numery klauzul i dokładne brzmienie |
| Analiza opinii | Motywy pojawiają się w wielu komentarzach | Zanonimizowane opinie i reguły kodowania | Reprezentatywne cytaty i metoda liczenia |
| Harmonogram historii projektu | Decyzje ewoluują w zapisach spotkań | Protokoły, dzienniki decyzji, informacje o wydaniach | Daty, osoby odpowiedzialne, sprzeczne zapisy |
| Przegląd długiego incydentu | Logi, zgłoszenia i analizy powypadkowe wyjaśniają różne etapy | Istotny zakres czasu i dokumenty incydentu | Znacznik czasu, źródło zdarzenia, niepewność |
| Przegląd dokumentów multimodalnych | Dowody tekstowe i wizualne mogą wymagać łącznego odczytu | Obsługiwane obrazy i ich podpisy lub kontekst | Czy endpoint obsługuje dany typ multimediów |
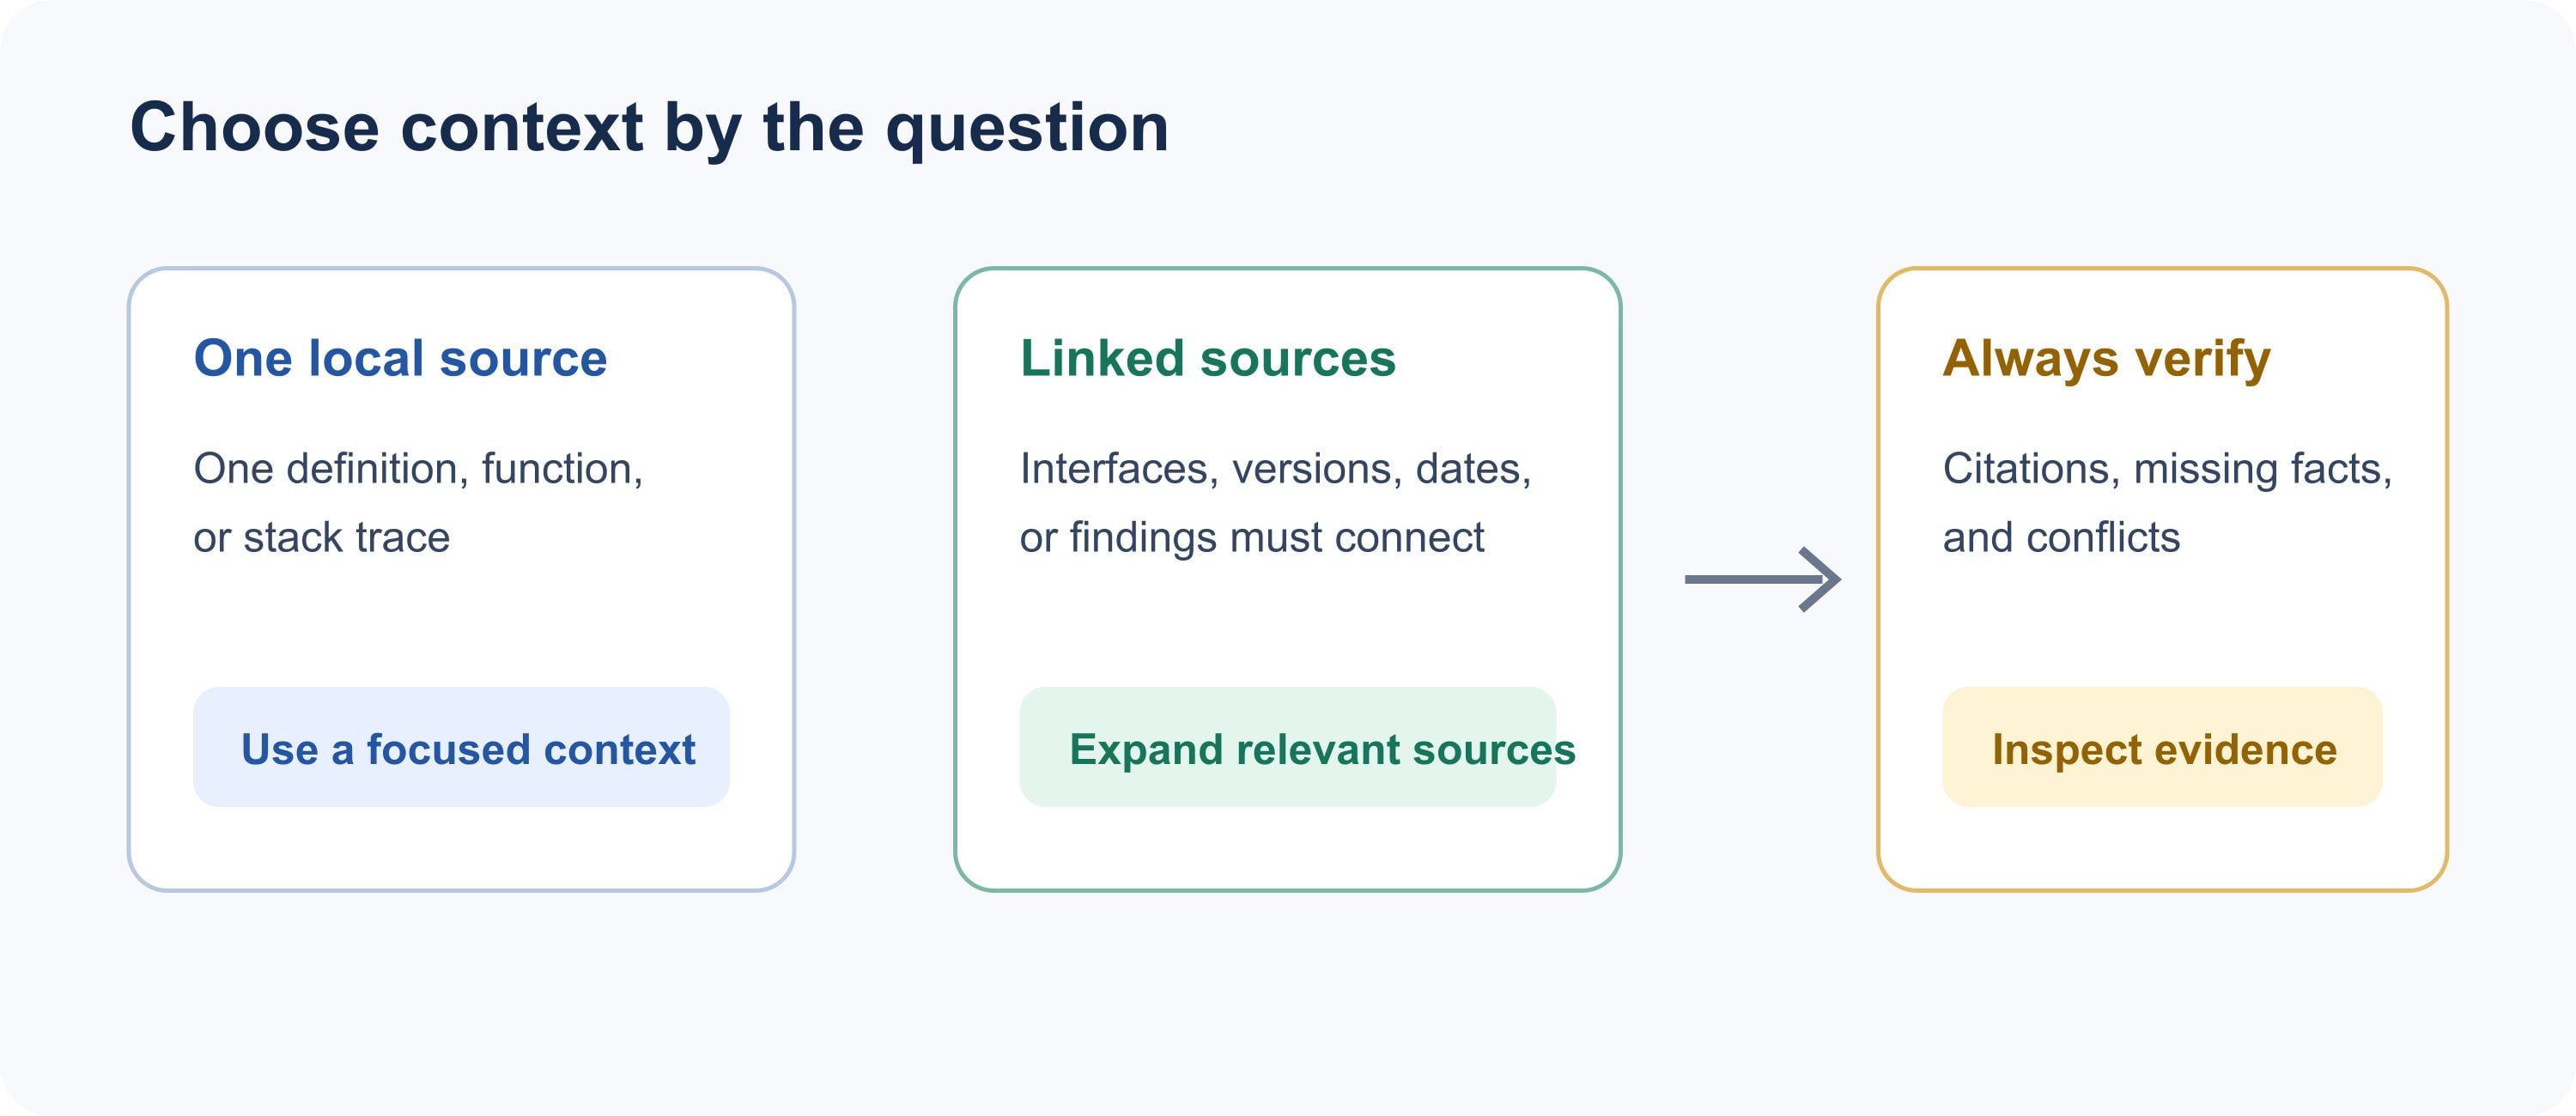
Używaj skupionego kontekstu do pytania lokalnego; rozszerzaj, gdy źródła muszą się łączyć, a następnie sprawdź dowody.
Przegląd dużego repozytorium kodu między plikami
Okno miliona tokenów może pomóc inżynierowi prześledzić strukturę danych od granicy API przez logikę usługi, przechowywanie i testy. Przydaje się do podsumowań architektury, znajdowania prawdopodobnie dotkniętych modułów i tworzenia planu refaktoryzacji zgodnego z konwencjami udokumentowanymi w kilku miejscach.
Daj modelowi ograniczony zrzut repozytorium, a nie nieprzefiltrowany zrzut dysku. Uwzględnij pliki źródłowe istotne dla zmiany, najbliższe testy, pliki manifestu zależności i notatki architektoniczne. Wyklucz wyniki kompilacji, zależności dostarczane z projektem, wygenerowane pakiety i duplikaty, chyba że pytanie ich dotyczy. Poproś o ścieżki plików i nazwy symboli dla każdej proponowanej zależności oraz o rozróżnienie między zaobserwowanym zachowaniem a założeniem.
Wykorzystaj wynik jako plan przeglądu. Potwierdź, że każdy cytowany symbol istnieje, sprawdź wskazane linie i sam uruchom kontrole projektu. Model nie powinien twierdzić, że testy zakończyły się powodzeniem, jeśli żadne narzędzie ich faktycznie nie uruchomiło i nie zwróciło wyniku. W przypadku zlokalizowanego błędu w jednej funkcji mniejszy kontekst jest często szybszy i łatwiejszy do audytu.
Synteza badań z prac i raportów
Długi kontekst pomaga, gdy badania stosują różne metody, populacje, miary lub definicje. Poproś o tabelę porównawczą z jednym wierszem na źródło i kolumnami na pytanie badawcze, dane, metodę, wynik, ograniczenia i znaczenie dla Twojego pytania. Utrzymuj twierdzenia na poziomie źródła przypisane do ich źródła, zamiast pozwalać, by scalone podsumowanie zatarło rozbieżności.
Na przykład porównując oceny narzędzia, rozróżnij wynik benchmarku od badania terenowego i od interpretacji autora. Poproś model, aby oznaczył niekompatybilne miary, zamiast szeregować wyniki, których nie da się porównać. Następnie otwórz fragmenty źródłowe stojące za twierdzeniami najbardziej istotnymi dla decyzji. Synteza to mapa dowodów, a nie substytut sprawdzenia prac.
Porównanie długich umów, polityk lub specyfikacji
Umowy i polityki często definiują termin raz i kwalifikują go w innym miejscu. Dostarczenie razem wersji obowiązującej, zmian, harmonogramów i odpowiedniego starszego projektu może pomóc ujawnić zmienione definicje, odesłania, brakujące warunki i pozorne sprzeczności.
Poproś o dokładną sekcję lub klauzulę dla każdej obserwacji oraz krótki fragment, który recenzent może zlokalizować. Oddziel różnice tekstowe od ich możliwych konsekwencji. Model może pomóc uporządkować przegląd, ale interpretacja prawna, decyzje zgodnościowe i uprawnienia do podpisu pozostają w rękach wykwalifikowanych osób, które mogą uwzględnić jurysdykcję i kontekst.
Analiza opinii klientów na dużą skalę
Duży zbiór opinii może ujawnić powtarzające się prośby i zastrzeżenia w różnych kanałach lub okresach. Dostarcz zdefiniowaną próbkę, usuń dane osobowe, które nie są potrzebne, i określ schemat kodowania, taki jak „tarcia we wdrożeniu”, „brakująca integracja” lub „niejasność cenowa”. Poproś o reprezentatywne przykłady i kontrprzykłady, a nie tylko listę motywów.
Nie przedstawiaj wygenerowanych przez model wartości procentowych motywów jako statystyk ankietowych. Jeśli potrzebujesz liczby, zdefiniuj jednostkę (wiadomość, klient lub zgłoszenie), usuń duplikaty zapisów, zastosuj spójną regułę etykietowania i zweryfikuj liczbę za pomocą powtarzalnego skryptu lub próbki zweryfikowanej przez człowieka. Model jest przydatny do proponowania kategorii i znajdowania przykładów; udokumentowana metoda uzasadnia twierdzenia ilościowe.
Budowa harmonogramu z dokumentów projektu
W przypadku przekazania projektu lub analizy powypadkowej istotne dowody mogą być rozproszone po protokołach spotkań, informacjach o wydaniach, dziennikach decyzji i zgłoszeniach. Poproś o tabelę chronologiczną z datą, zdarzeniem, wskazaną osobą odpowiedzialną, jeśli podano, lokalizacją źródła oraz pewnością lub niejednoznacznością. Poleć modelowi zachować sprzeczne daty, zamiast po cichu wybierać jedną.
Przydatny harmonogram pomaga nowemu członkowi zespołu zobaczyć, co zostało zdecydowane, kiedy zmieniło się wymaganie i który dokument potwierdza każde zdarzenie. Zweryfikuj krytyczne przejścia w zapisie źródłowym, zwłaszcza gdy notatka została napisana później lub podsumowuje spotkanie, zamiast je bezpośrednio rejestrować.
Przegląd długich zapisów incydentów i materiałów multimodalnych
Przegląd incydentu może zyskać na utrzymaniu alertów, notatek operacyjnych, zgłoszeń i analizy powypadkowej w jednym zestawie dowodów. Poproś o sekwencję zaobserwowanych zdarzeń i wyraźnie oddziel znaczniki czasu w logach od późniejszych szacunków w notatkach opisowych. Może to uczynić pierwszy przegląd bardziej spójnym, choć inżynier dyżurny nadal sprawdza systemy źródłowe przed podjęciem działań.
Oficjalne ogłoszenie DeepSeek mówi, że V4.1-Flash jest dostępny w jego API z natywnym wsparciem multimodalnym. Dokładne formaty obrazów, metody żądań i limity zależą od endpointu i integracji, więc potwierdź te szczegóły, zanim założysz, że budżet miliona tokenów tekstowych opisuje także obsługę obrazów. ( Ogłoszenie DeepSeek V4.1-Flash )
Kiedy milion tokenów pomaga, a kiedy dodaje szum?
Większy kontekst pomaga, gdy źródła wymagają wzajemnego odwoływania się. Zmiana w kodzie dotycząca współdzielonego interfejsu może wymagać kilku modułów i testów. Porównanie wersji wymaga obu pełnych wersji i ich załączników. Harmonogram projektu może wymagać zapisów rozproszonych na przestrzeni miesięcy.
Lokalny błąd z wyraźnym śladem stosu może wymagać tylko funkcji, jej wywołujących i odpowiedniego testu. Pytanie o jedną definicję może wymagać tylko sekcji autorytatywnej. W takich zadaniach uwzględnienie całego repozytorium zwiększa przestrzeń wyszukiwania i może pogrzebać przydatny fragment.
Przed rozszerzeniem promptu usuń powtarzające się eksporty, nieaktualne projekty, niepowiązane foldery, szablony i zapisy poza zakresem czasowym pytania. Prowadź manifest tego, co uwzględniłeś i dlaczego. Jeśli odpowiedź zmienia się, gdy dodajesz dużą partię niepowiązanych plików, to sygnał, aby zawęzić zestaw źródeł i ponownie uruchomić test.
Praktyczny workflow dla wiarygodnych odpowiedzi z długim kontekstem
Stosuj spójny protokół dowodowy, aby płynna odpowiedź nie została pomylona ze zweryfikowaną. Najpierw oznacz źródła stałymi nazwami plików, a tam gdzie to możliwe numerami stron, nagłówkami, numerami linii, datami lub identyfikatorami wersji. Zachowaj wystarczający kontekst otaczający, aby poprawnie interpretować fragmenty.
Następnie sformułuj jedną decyzję lub pytanie badawcze. Określ kształt wyniku i lokalizacje, które model musi zacytować. Wielokrotnego użytku prompt to:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
W przypadku repozytorium kodu dodaj: „Cytuj ścieżki w repozytorium oraz nazwy funkcji lub klas. Przed zaproponowaniem zmiany wymień dotknięte pliki i dowody z testów, które potwierdzają propozycję. Nie twierdź, że test został uruchomiony, jeśli jego wynik nie znajduje się w dostarczonych dowodach.”
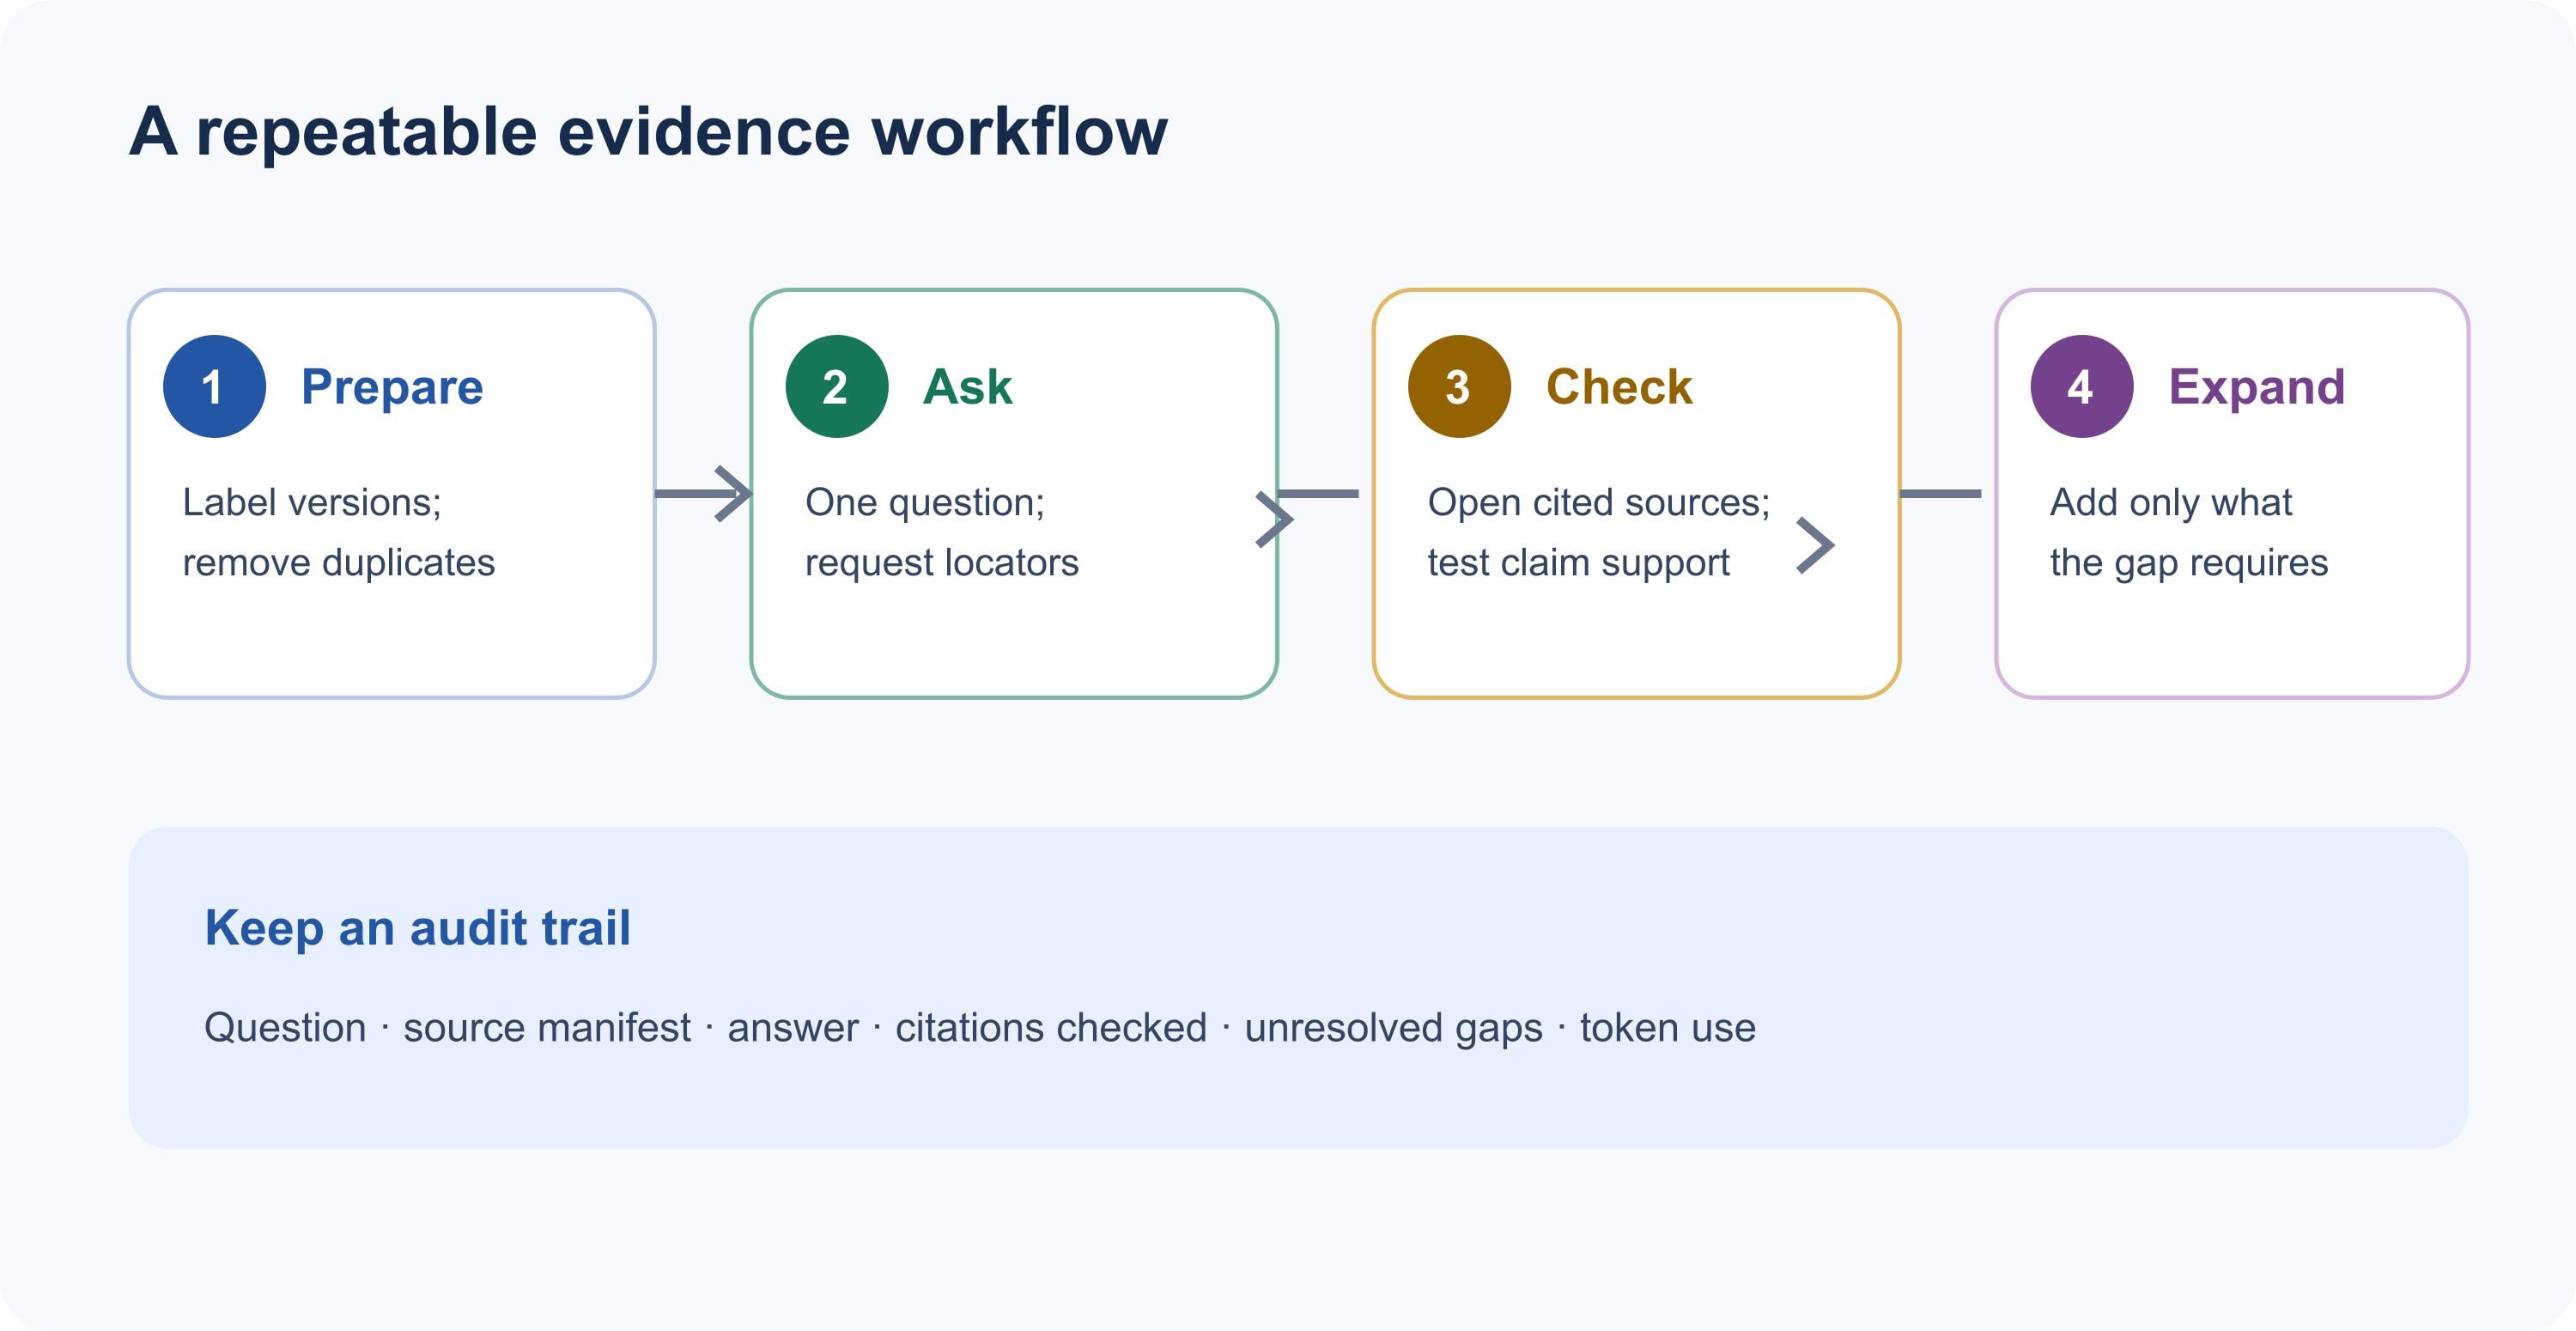
Przygotuj źródła, zadaj ograniczone pytanie, sprawdź cytowania i rozszerzaj tylko po to, aby rozwiązać lukę.
Następnie przejrzyj odpowiedź w trzech krokach. Sprawdź, czy każde cytowanie wskazuje realną lokalizację. Sprawdź, czy cytowany fragment potwierdza twierdzenie, a nie tylko wspomina temat. Na koniec przejrzyj pominięcia i sprzeczności, zadając ukierunkowane pytania uzupełniające wobec tego samego zestawu źródeł. W przypadku decyzji o wysokich stawkach poproś wykwalifikowanego recenzenta o bezpośrednie przeczytanie materiału źródłowego.
Mapa dowodów workflow z długim kontekstem
| Etap | Działanie | Zachowaj | Sygnał zatrzymania |
|---|---|---|---|
| 1. Przygotowanie | Oznacz, usuń duplikaty i określ zakres źródeł | Manifest źródeł i wersje | Nieznane pochodzenie lub nieaktualny duplikat |
| 2. Pytanie | Ustal jedno pytanie i format dowodów | Nazwy plików i lokalizatory w odpowiedzi | Szerokie żądanie bez celu decyzyjnego |
| 3. Sprawdzenie | Otwórz cytowane fragmenty i porównaj twierdzenia | Potwierdzone twierdzenia i wyraźne luki | Cytowanie nie potwierdza twierdzenia |
| 4. Rozszerzenie | Dodaj tylko źródła potrzebne do nierozwiązanych powiązań | Poprawa w testach ze znaną odpowiedzią | Więcej danych wejściowych bez lepszych dowodów |
Jak sprawdzić, czy kontekst 1M jest przydatny do Twojego zadania
Utwórz mały zestaw ewaluacyjny przed wczytaniem całego archiwum. Napisz pytania, na które znasz już odpowiedzi z materiału źródłowego. Umieść niektóre fakty na początku, niektóre w środku, a niektóre pod koniec. Dodaj co najmniej jedno pytanie wymagające połączenia dwóch dokumentów i jedno, na które nie da się odpowiedzieć z dostarczonych źródeł.
Uruchom te same pytania najpierw na mniejszym, istotnym podzbiorze, a następnie zwiększaj kontekst w odmierzonych krokach. Zapisuj poprawność faktograficzną, dokładność lokalizatorów, pominięte dowody, niepotwierdzone twierdzenia, odmowę na pytanie bez odpowiedzi, opóźnienie i zużycie tokenów. Utrzymuj stały prompt i ustawienia dekodowania, aby zmiany były interpretowalne. Powtórz pytanie, jeśli wyniki różnią się istotnie między uruchomieniami.
| Sprawdzenie | Co pokazuje odpowiedź zaliczająca | Co zrobić po niepowodzeniu |
|---|---|---|
| Znany fakt na wczesnej, środkowej, późnej pozycji | Odzyskiwanie informacji w całym zakresie źródła | Sprawdź indeksowanie, etykiety plików i długość promptu |
| Powiązanie międzydokumentowe | Dowody można połączyć między źródłami | Poproś o oba cytowania, a następnie zawęź pytanie o powiązanie |
| Pytanie bez odpowiedzi | Model potrafi zgłosić brakujące dowody | Zaostrz „używaj wyłącznie dostarczonych źródeł” i przetestuj ponownie |
| Audyt cytowań | Lokalizator i fragment potwierdzają twierdzenie | Traktuj twierdzenie jako niezweryfikowane, dopóki nie zostanie poprawione |
| Porównanie z większym kontekstem | Dodatkowy materiał poprawia zadanie docelowe | Usuń szum, jeśli dokładność lub opóźnienie się pogarsza |
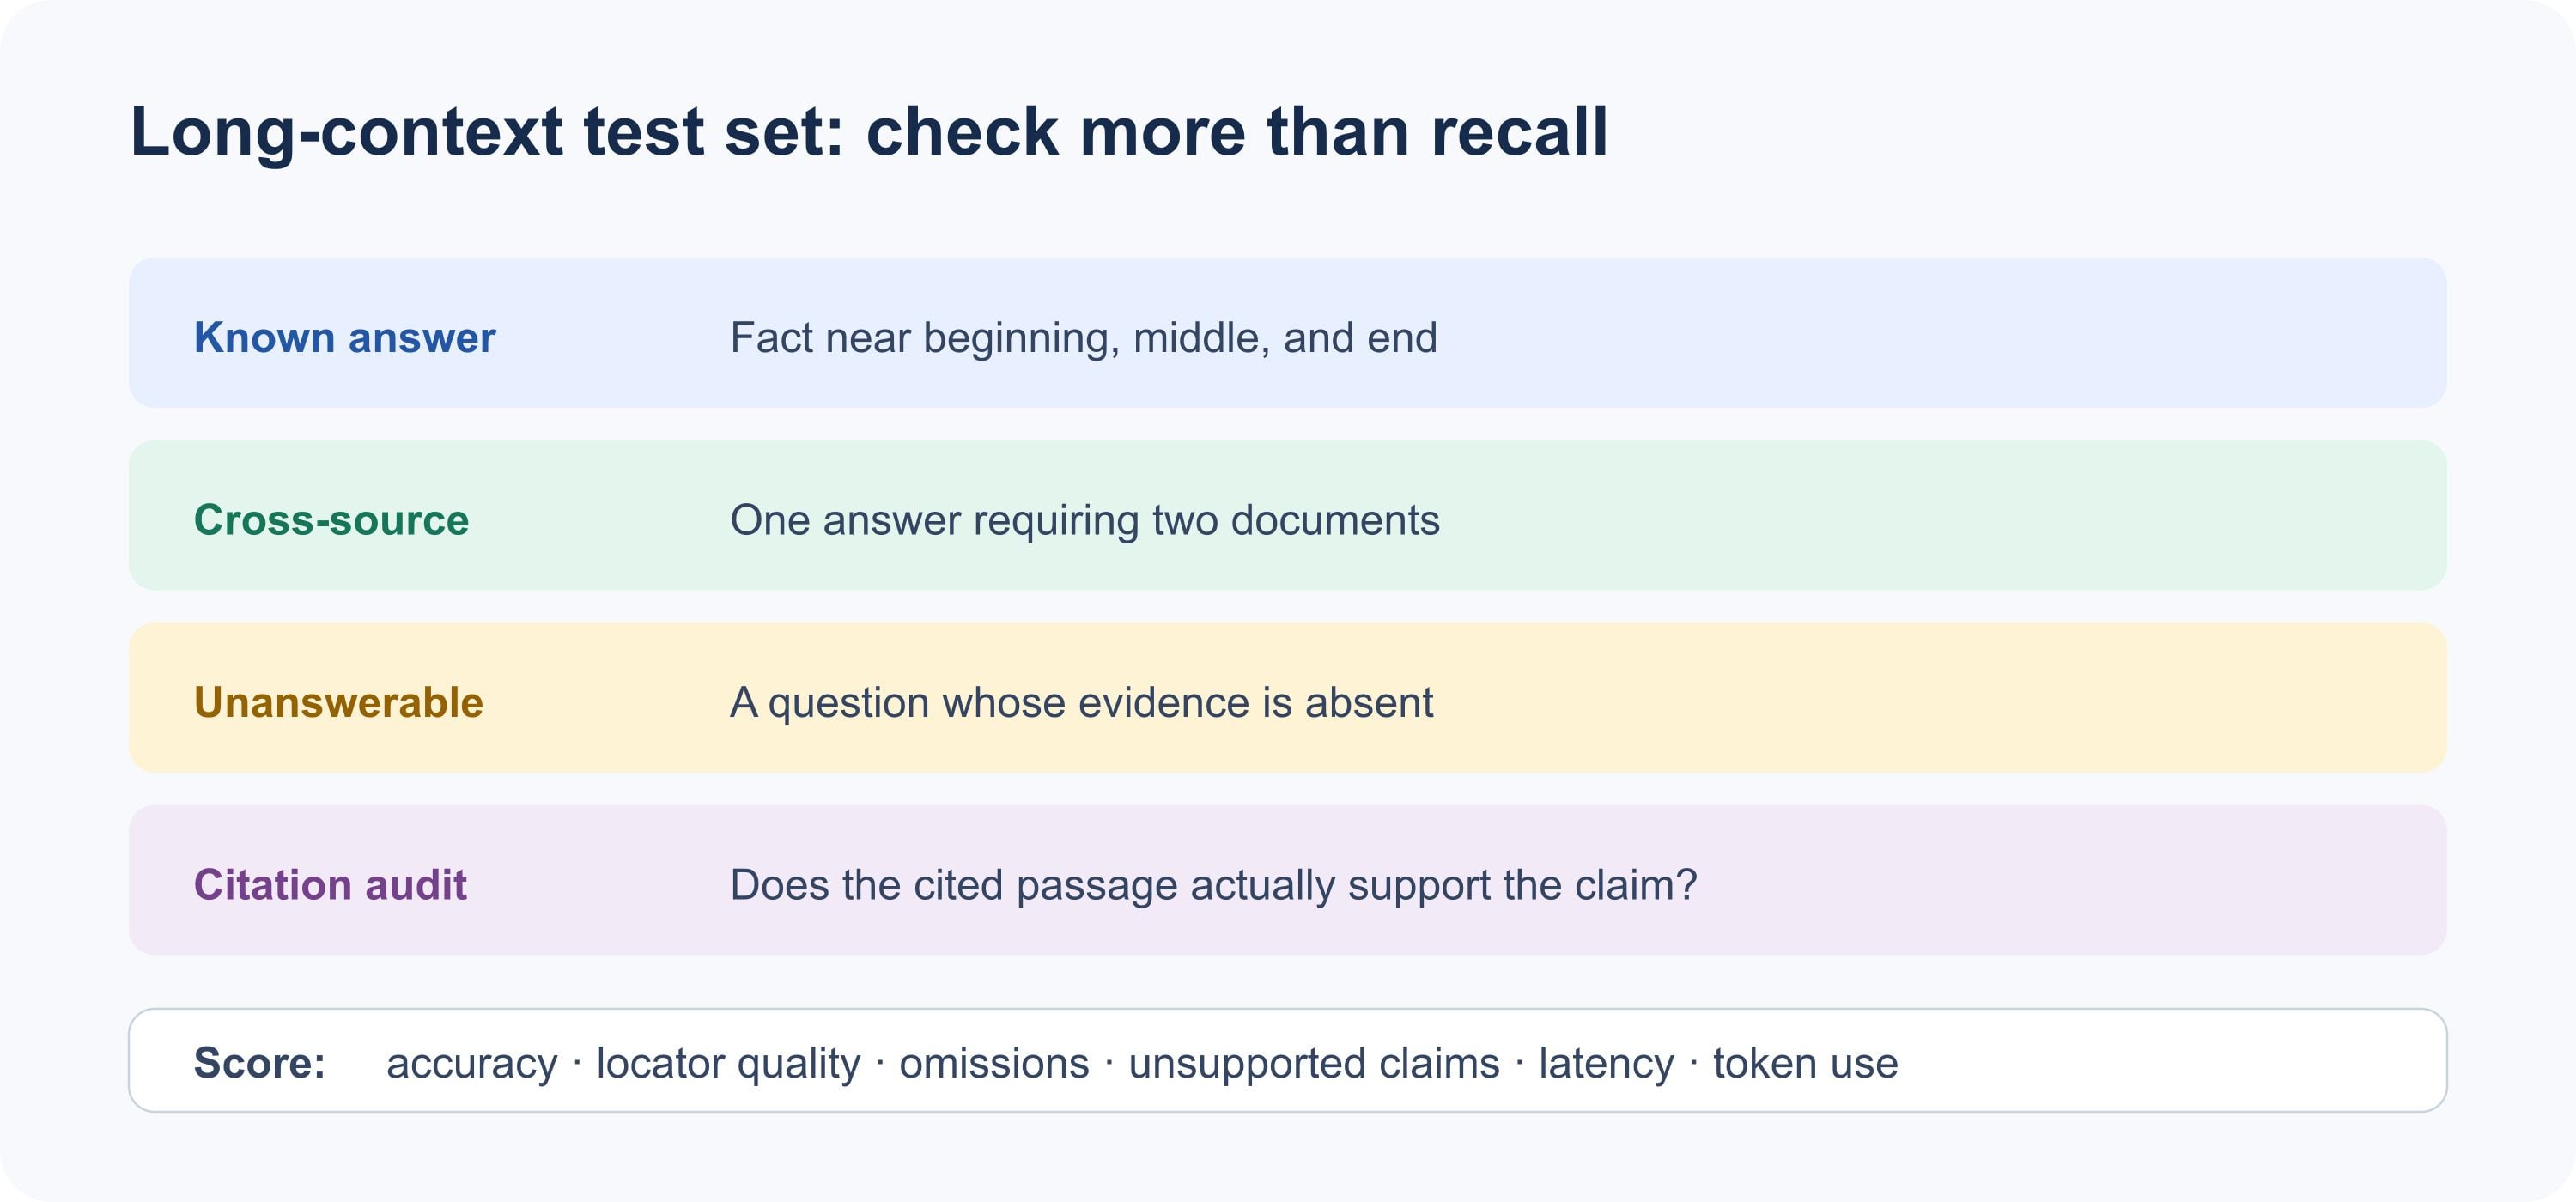
Oceń odzyskiwanie informacji, potwierdzenie cytowań, pominięcia, niepotwierdzone twierdzenia, opóźnienie i zużycie tokenów.
Raporty społeczności są mieszane i zależne od zadania. Jeden użytkownik Reddita podzielił się zależnym od środowiska wzrostem liczby błędnych argumentów narzędzi przy większych rozmiarach kontekstu, podczas gdy komentujący opisali udaną pracę przy wyższych liczbach tokenów w innych konfiguracjach. To dobry powód, aby przeprowadzić benchmark własnego środowiska, a nie dowód na uniwersalny próg awarii. ( Dyskusja o kontekście DeepSeek na Reddicie )
Rozsądne skalowanie to: zwaliduj prompt na małej próbce, dodaj grupy źródeł potrzebne do pytań międzydokumentowych, a następnie przetestuj reprezentatywne duże żądanie. Utrzymuj najmniejszy kontekst, który odpowiada na rzeczywiste pytanie z wiarygodnymi dowodami. Ułatwia to również interpretację porównań opóźnienia i kosztu.
Cennik i dostęp do API DeepSeek V4.1 Flash
W Atlas Cloud lista modeli obecnie pokazuje DeepSeek V4.1 Flash z kontekstem 1M i stawkami 0,30 USD za milion tokenów wejściowych, 1,20 USD za milion tokenów wyjściowych i 0,03 USD za milion tokenów odczytu z pamięci podręcznej. Lista nie pokazuje rabatu dla tego modelu. To stawki Atlas Cloud, różne od zależnych od czasu cen szczytowych i pozaszczytowych samego DeepSeek. Sprawdź ponownie katalog modeli Atlas Cloud i stronę z cennikiem modeli przed publikacją lub planowaniem budżetu, ponieważ stawki mogą się zmieniać.
Przy podanych stawkach żądanie ze 100 000 niebuforowanych tokenów wejściowych i 2000 tokenów wyjściowych kosztuje około 0,03 USD za dane wejściowe plus 0,0024 USD za dane wyjściowe, czyli łącznie 0,0324 USD przed wszelkimi innymi obowiązującymi opłatami. Jeśli dane wejściowe są rozliczane jako odczyty z pamięci podręcznej, 100 000 buforowanych tokenów kosztowałoby 0,003 USD. Przykład zakłada te liczby tokenów i stawki; nie jest wyceną dla konkretnego obciążenia. Pełna pojemność 1M nie jest naliczana tylko dlatego, że istnieje. Rozliczenie następuje na podstawie zużycia i obsługi pamięci podręcznej.
Dla zespołów, które chcą jednego punktu wejścia API, strona modelu DeepSeek V4.1 Flash udostępnia model i szczegóły wywołań. Porównaj zmierzone zużycie tokenów i potrzeby integracyjne również z oficjalnym endpointem; nazwy modeli, limity i ceny mogą się różnić w zależności od dostawcy.
Najczęściej zadawane pytania
Czy okno kontekstowe 1M tokenów to to samo co 1M słów?
Nie. Tokeny mogą być częściami słów, znakami interpunkcyjnymi, fragmentami kodu lub innymi jednostkami. Liczba słów lub stron, które się mieszczą, zależy od materiału i jego tokenizacji. Używaj zmierzonych liczb tokenów, a nie stałego przelicznika stron.
Czy DeepSeek V4.1 Flash zawsze używa pełnego okna kontekstowego?
Nie. Milion tokenów to maksymalna specyfikacja kontekstu, a nie cel dla każdego żądania. Krótki prompt zużywa mniej, a konkretny interfejs lub ścieżka API mogą wymuszać niższy limit. Sprawdź dokumentację endpointu i rzeczywiste pola zużycia.
Czy kontekst 1M wystarczy dla całego repozytorium kodu?
Może zmieścić niektóre repozytoria pod względem liczby tokenów, ale to nie czyni każdego pliku istotnym ani każdej odpowiedzi wiarygodnej. Uwzględnij pliki potrzebne do pytania, zweryfikuj cytowane ścieżki i symbole oraz przetestuj zmiany rzeczywistymi kontrolami projektu.
Czy powinienem umieścić każdy dostępny dokument w jednym prompcie?
Tylko jeśli dokumenty dotyczą tego samego pytania. Zacznij od manifestu źródeł, usuń duplikaty i materiał niepowiązany, a następnie dodaj więcej, gdy wymaga tego test międzydokumentowy. Najlepsze zastosowania okna kontekstowego 1M w DeepSeek V4.1 Flash określa dowody, które trzeba porównać, a nie rozmiar archiwum.





