Dwa zespoły mogą raportować setki tokenów na sekundę dla DeepSeek V4.1 Flash i wciąż mierzyć coś innego. Jeden może mieć na myśli szybkość dekodowania dla pojedynczego żądania; inny — zagregowaną generację przy dziesiątkach równoczesnych żądań. Aby poprawić optymalizację przepustowości wnioskowania DeepSeek V4.1 Flash, najpierw wybierz metrykę potrzebną Twojej usłudze, następnie wykonaj test porównawczy własnego miksu żądań, zmieniaj jedną zmienną obsługi naraz i weryfikuj opóźnienie, jakość oraz koszt łącznie. Rodzina modeli obejmuje teraz aktualizację Flash-1017 z 17 października, więc przed porównywaniem wyników zapisz dokładny checkpoint. Publiczne raporty pokazują przydatne ścieżki optymalizacji, ale żaden nie zastąpi dopasowanego testu na Twoim sprzęcie.
Najważniejsze wnioski
- Zagregowane tokeny wyjściowe/s mierzą przepustowość w obrębie żądań; szybkość dekodowania na żądanie mierzy doświadczenie pojedynczego użytkownika.
- Odtwórz własne długości promptów, limity wyjścia, współbieżność, stan rozgrzania i cel opóźnienia przed dostrajaniem.
- Skompresowany KV cache i ograniczone odtwarzanie w V4.1 Flash zmniejszają presję na pamięć, ale nie gwarantują stałego przyspieszenia end-to-end.
- Porównuj vLLM i SGLang tylko przy dopasowanym modelu, sprzęcie, obciążeniu i warunkach pomiaru.
Co oznacza przepustowość dla DeepSeek V4.1 Flash?
Przepustowość to tempo, ale licznik i granica testu mają znaczenie. W przypadku usługi wnioskowania rejestruj co najmniej pięć pomiarów:
| Metryka | Co mówi | Typowe zastosowanie |
|---|---|---|
| Zagregowane tokeny wyjściowe/s | Tokeny wyjściowe generowane przez wszystkie aktywne żądania na sekundę | Planowanie przepustowości i efektywność floty |
| Tokeny dekodowania na żądanie/s | Szybkość generowania odczuwana przez pojedyncze żądanie | Responsywność interaktywna podczas generowania |
| Tokeny prefill/s | Tokeny wejściowe przetwarzane na sekundę | Długie prompty i obciążenia intensywnie korzystające z wyszukiwania |
| Czas do pierwszego tokenu (TTFT) | Czas od nadejścia żądania do pierwszego tokenu wyjściowego | Odczuwane opóźnienie startu |
| Opóźnienie end-to-end, p50/p95 | Całkowity czas trwania żądania w rozkładzie ruchu | Cele poziomu usług i zachowanie ogona |
Serwer może zwiększyć zagregowaną przepustowość, grupując więcej sekwencji, jednocześnie wydłużając każdemu użytkownikowi oczekiwanie między tokenami. Odwrotnie, konfiguracja dostrojona do niskiej współbieżności może zapewniać szybkie pojedyncze odpowiedzi, pozostawiając akceleratory niewykorzystane. Żaden wynik nie jest uniwersalnie lepszy. Właściwym celem jest punkt na krzywej przepustowość–opóźnienie, który spełnia cel usługowy Twojego produktu.
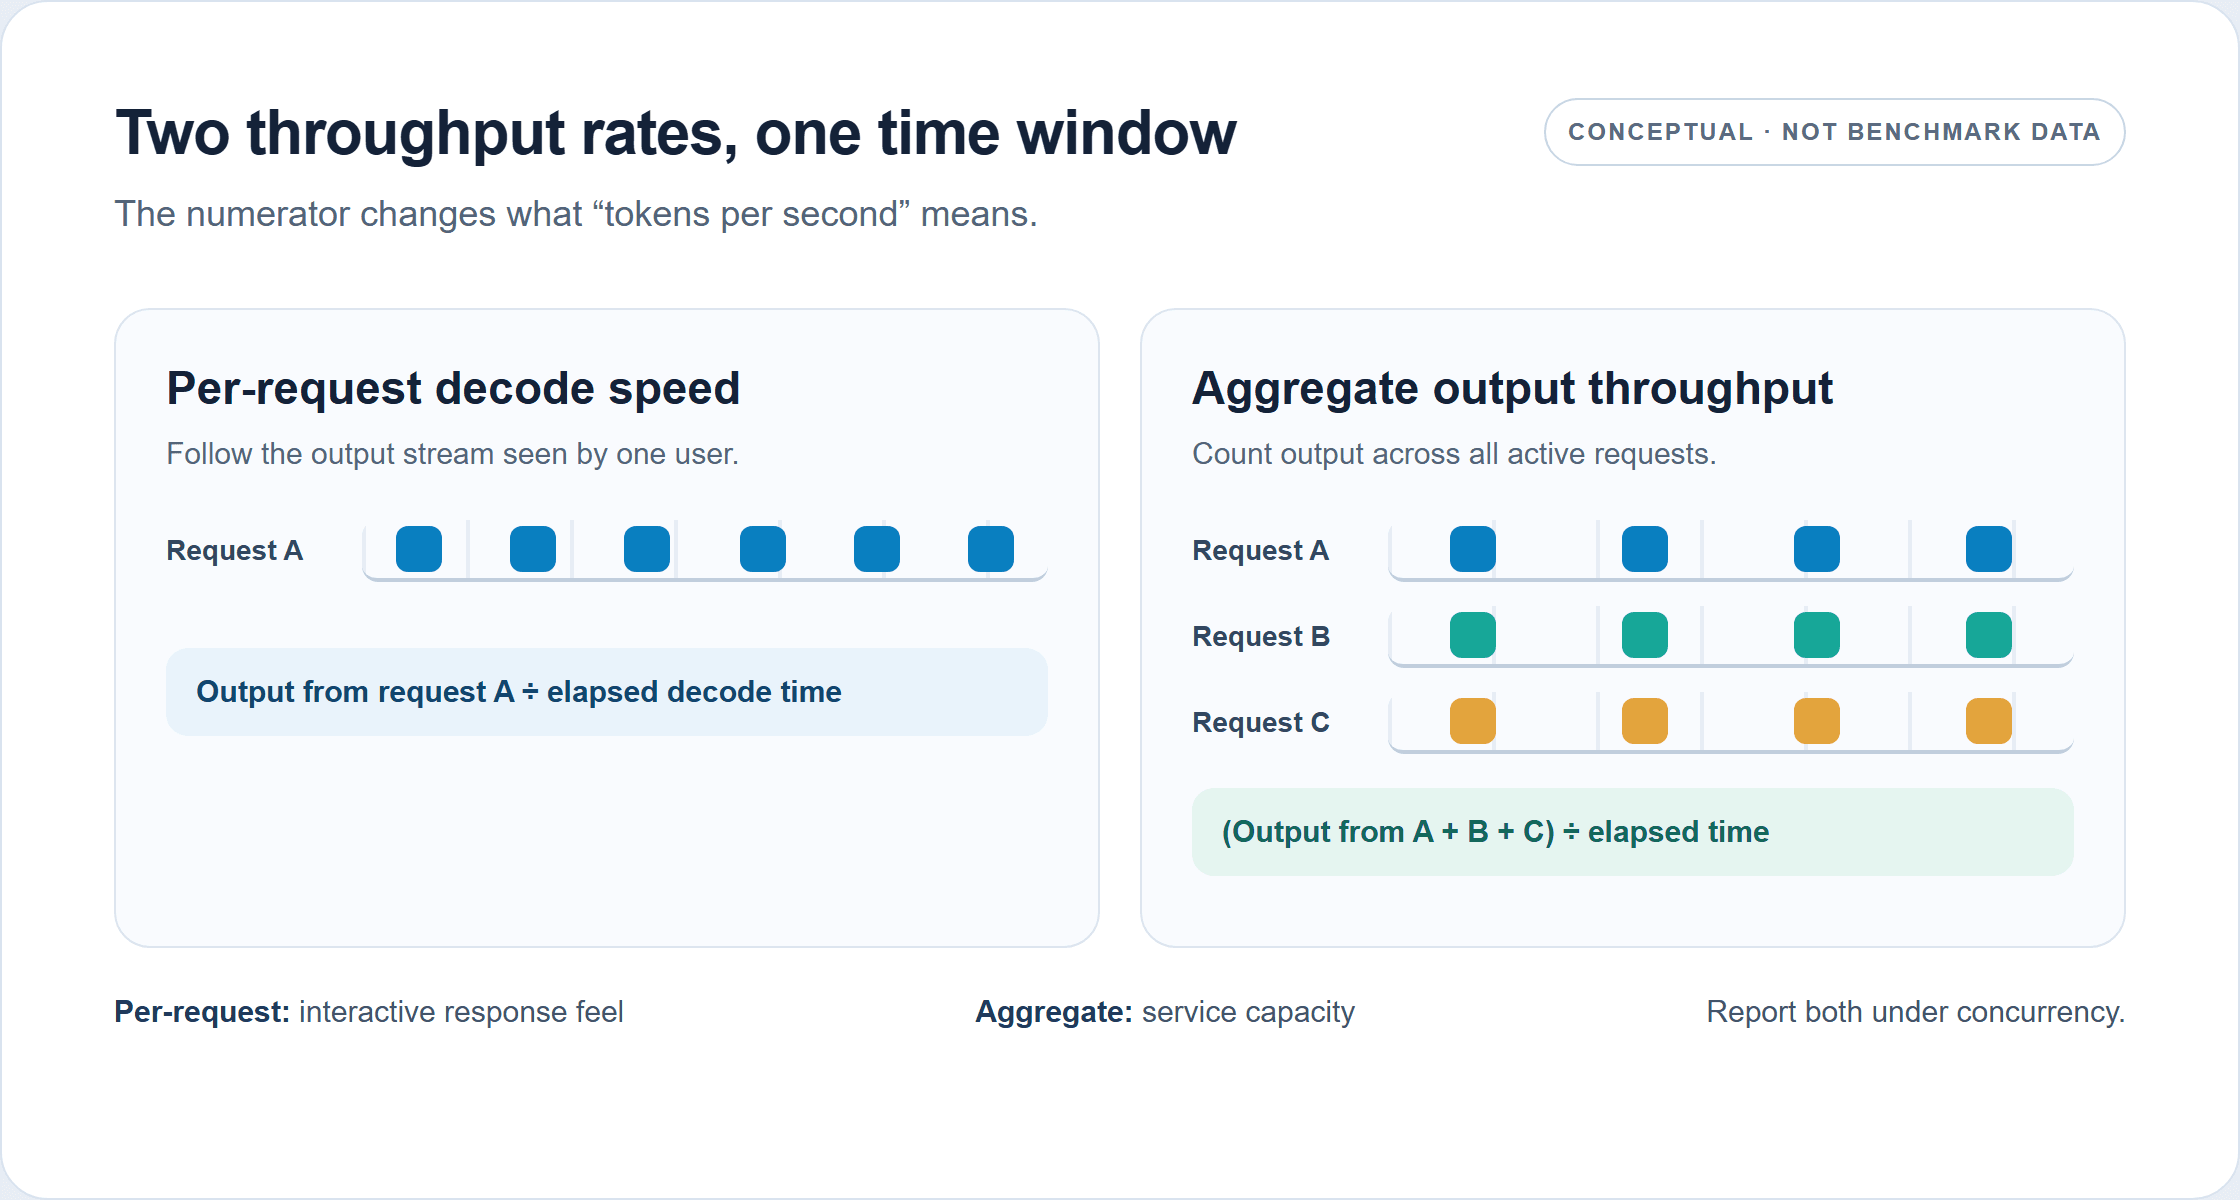
Te dwa wskaźniki liczą różne strumienie wyjściowe. To diagram koncepcyjny, a nie zmierzona wydajność DeepSeek V4.1 Flash.
Określ, czy przepustowość obejmuje prefill, dekodowanie, czy oba. Podaj, czy dzielisz przez liczbę GPU. Raportuj pomyślnie wygenerowane tokeny wyjściowe, a nie żądane maksymalne tokeny, oraz ujawniaj anulowania lub błędy. Bez tych szczegółów wartość tokens/s nie powie operatorowi, czy przewiduje działanie jego aplikacji.
Zbuduj powtarzalny baseline DeepSeek V4.1 Flash
Przydatny baseline przypomina ruch produkcyjny na tyle, by ujawnić jego wąskie gardło. Pojedynczy krótki prompt jest słabym przybliżeniem agenta, który wielokrotnie wysyła dużą historię rozmowy, a stałe wyjście 1024 tokenów pomija obciążenia, które kończą się wcześnie lub znacznie się różnią.
Ustal obciążenie i okno pomiarowe
Twórz koszyki żądań na podstawie obserwowanego ruchu. Dla każdego koszyka zachowaj przybliżoną długość wejścia, oczekiwaną długość wyjścia, wzorzec napływu i wszelkie wspólne prefiksy. Uwzględnij tury narzędzi lub rozumowania, jeśli są częścią rzeczywistej ścieżki żądania. Między uruchomieniami utrzymuj stałe prompty, ustawienia próbkowania, warunki zatrzymania i limity wyjścia.
Uruchom zarówno przypadek niskiej współbieżności, jak i współbieżność oczekiwaną przez usługę w szczycie. Następnie dodaj pośrednie poziomy współbieżności, aby ujawnić, gdzie przepustowość przestaje rosnąć lub opóźnienie przekracza limit. Użyj stabilnego okna pomiarowego po rozgrzaniu, powtórz każdy punkt i podaj medianę oraz zakres. Krótki skok może mierzyć zachowanie startowe, a nie stabilną przepustowość usługi.
Oddziel pomiary zimnego startu od rozgrzanej obsługi. Zimne uruchomienia obejmują ładowanie modelu, przechwytywanie grafu lub zapełnianie pamięci podręcznej w zależności od stosu; rozgrzane uruchomienia opisują system gotowy do obsługi. W przypadku obciążenia z buforowaniem prefiksów mierz osobno ruch trafień i chybień pamięci podręcznej. Nie łącz ich w jedną średnią, chyba że mieszanka odpowiada produkcji.
Prowadź rejestr testów porównawczych
Zapisz wiersz dla każdego uruchomienia z następującymi polami: checkpoint lub wersja modelu; środowisko uruchomieniowe i commit; model i liczba GPU; połączenia międzysystemowe; precyzja i kwantyzacja; układ równoległości tensorowej, eksperckiej lub potokowej; rozkład tokenów wejściowych i wyjściowych; współbieżność i wzorzec napływu żądań; stan rozgrzany lub zimny; czas trwania uruchomienia; współczynnik sukcesu; zagregowana przepustowość; szybkość dekodowania na żądanie; TTFT; oraz opóźnienie end-to-end p50/p95.
Ten rejestr jest bardziej przydatny niż liczba z rankingu, ponieważ czyni następny eksperyment powtarzalnym. Zamroź go przed dostrajaniem. Jeśli obciążenie lub checkpoint się zmieni, rozpocznij nowy baseline, zamiast przypisywać różnicę do flagi obsługi.
Diagnozuj prefill, dekodowanie, KV cache lub planowanie
Użyj objawów, aby wybrać następny pomiar, a nie zgadywać poprawkę. Wysokie TTFT przy akceptowalnej szybkości dekodowania wskazuje na przetwarzanie wejścia, kolejkę, chybienia pamięci podręcznej lub narzut startowy. Wolne dekodowanie przy niskiej współbieżności sugeruje zbadanie jąder, przepustowości pamięci, komunikacji równoległej i ścieżki wykonania modelu. Zagregowana przepustowość, która wypłaszcza się wraz ze wzrostem współbieżności, może wskazywać na presję na pamięć, limity planisty, narzut komunikacji lub wysyconą ścieżkę obliczeń. Degradacja przy długim kontekście wymaga pomiaru rezydencji pamięci podręcznej, pracy prefill i ruchu host–urządzenie.
| Obserwacja | Pierwsze kontrole |
|---|---|
| TTFT rośnie wraz z długością promptu | Szybkość prefill, czas w kolejce, współczynnik trafień pamięci podręcznej prefiksów, rozgrzewanie grafu lub kompilacji |
| Szybkość dekodowania jest niska nawet przy współbieżności 1 | Ścieżka modelu w środowisku uruchomieniowym, obsługa jąder, precyzja, wykorzystanie GPU, narzut komunikacji |
| Zagregowane tokeny/s wypłaszczają się wraz ze wzrostem współbieżności | Pojemność KV cache, grupowanie planisty, przepustowość pamięci, topologia równoległa |
| Opóźnienie p95 gwałtownie rośnie, podczas gdy zagregowana generacja się poprawia | Rozmiar partii, polityka kolejek, mieszanka długości żądań, cel usługowy |
| Długie prompty wypierają przydatne aktywne żądania | Rezydencja KV cache, alokacja pamięci podręcznej, rozkład kontekstu, ruch pamięci hosta |
V4.1 Flash ma cechy architektoniczne mające złagodzić część tych presji. Raport o modelu opisuje CSA2 z ponownym wykorzystaniem pamięci podręcznej między warstwami i globalnym buforowaniem KV w FP4, co daje raportowany globalny ślad KV wynoszący 890 bajtów na token, około jednej czwartej odpowiedniego śladu V4-Flash. SWA Bounded Replay rozwiązuje inny kompromis dotyczący przechowywania: zamiast utrwalać cały stan uwagi z przesuwanym oknem, wdrożenie może odtworzyć brakujący stan, powtarzając ostatnie okno. DeepSeek raportuje trwały KV cache blisko jednej ósmej śladu V4-Flash w tym projekcie, z niewielką dodatkową rekomputacją prefill. To wyniki architektury i wdrożenia, a nie obietnica ośmiokrotnej przepustowości. (Raport techniczny DeepSeek, wrzesień 2026)
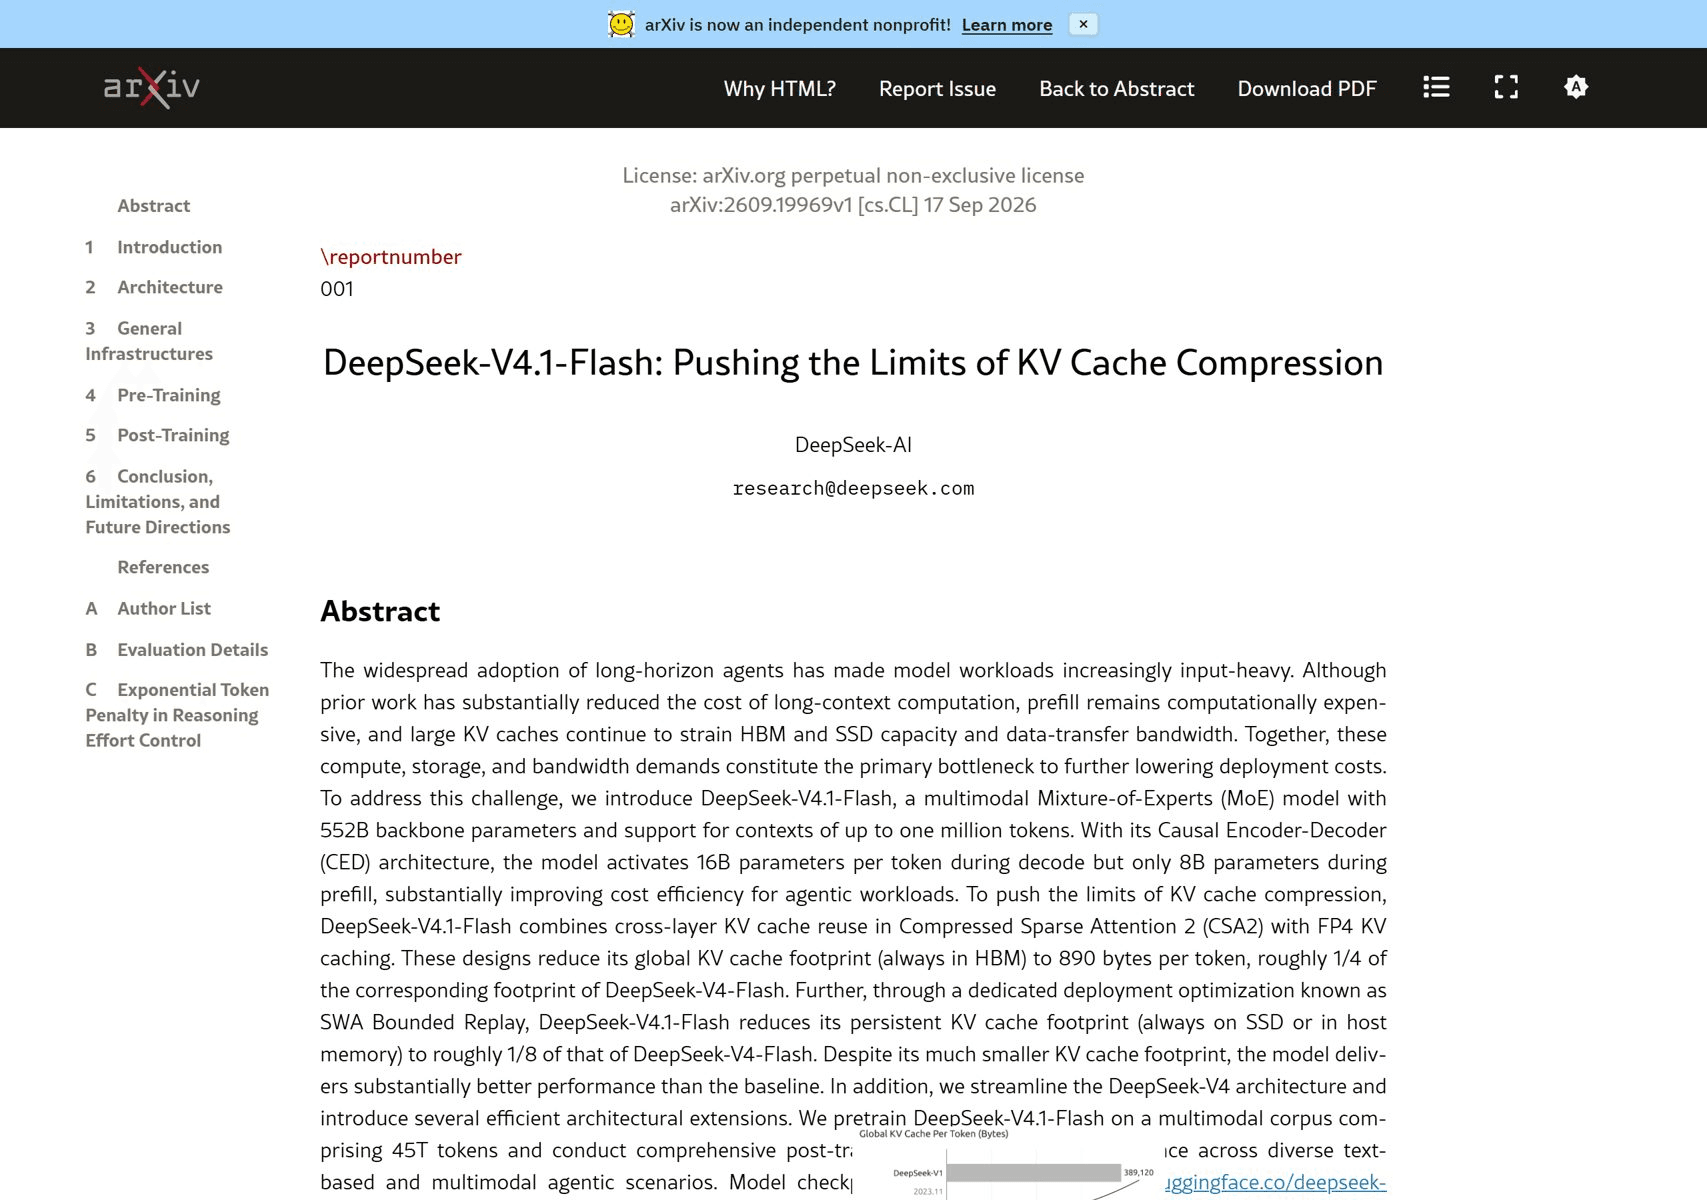
Ilustracja źródłowa opisuje pojemność pamięci podręcznej, a nie mnożnik przepustowości end-to-end dla każdego wdrożenia.
Gdy diagnoza jest niejasna, profiluj jedno reprezentatywne uruchomienie i sprawdź czas w kolejce, wykorzystanie GPU, użycie pamięci oraz czasy poszczególnych etapów. Zmień jedną zmienną, uruchom ponownie to samo obciążenie i sprawdź poprawność wyjścia lub jakość zadania. Dzięki temu pozorne przyspieszenie nie zamaskuje regresji w usłudze lub odpowiedziach.
Dostrajaj vLLM lub SGLang względem tego samego celu
Wybierz środowisko uruchomieniowe, którego bieżąca ścieżka modelu obsługuje checkpoint i sprzęt, które zamierzasz wdrożyć. Zweryfikuj dokładne wydanie, jądra, zachowanie grafu i układ równoległy. To, że model jest wymieniony jako obsługiwany, nie oznacza, że każda kwantyzacja lub topologia jest równie zoptymalizowana.
vLLM: zweryfikuj ścieżkę modelu dla konkretnego wydania
Październikowy raport zespołu vLLM opisuje postęp w jego benchmarku AgentX: około 1,9× poprawy w wyniku niskiego opóźnienia i około 5,3× przepustowości przy ograniczeniu 150 TPS względem baseline'u z dnia zerowego. Praca obejmowała SWA bounded replay z grafami CUDA i integrację jąder specyficznych dla modelu. Traktuj te wartości jako dowód, że stos zmienił się istotnie w czasie w ramach tego benchmarku, a nie jako mnożniki do zastosowania w innym klastrze. ( Raport inżynieryjny vLLM, październik 2026)
W swoim uruchomieniu najpierw ustal obsługiwane wydanie i znaną dobrą konfigurację. Następnie zmierz osobno zachowanie przechwytywania lub odtwarzania grafu, grupowanie i równoległość. Zachowaj ograniczenie opóźnienia użyte do wyboru punktu o wyższej przepustowości. Jeśli przechwytywanie grafu zmienia wymagania dotyczące startu lub pamięci, uwzględnij te koszty w decyzji o wdrożeniu.
SGLang: dopasuj profil współbieżności
Raport zespołu SGLang podaje wyjątkowo jasny przykład tego, dlaczego kontekst testu ma znaczenie. Na 8 GPU H200 jego zoptymalizowane uruchomienie bez dekodowania spekulacyjnego wzrosło z około 76 do 168 tokenów/s na użytkownika przy współbieżności 1 oraz z około 96 do 221 tokenów wyjściowych/s na GPU przy współbieżności 64. Użyto stałych wejść 8192 tokenów i wyjść 1024 tokenów. Osobne wyniki 4×GB300 używały innych długości promptów, ustawień równoległości i dekodowania spekulacyjnego DSpark. Raport wspiera zatem ocenę optymalizacji SGLang na Twoim ruchu, a nie bezpośrednie porównywanie ich z liczbami vLLM AgentX. ( Raport optymalizacji LMSYS/SGLang, wrzesień 2026)
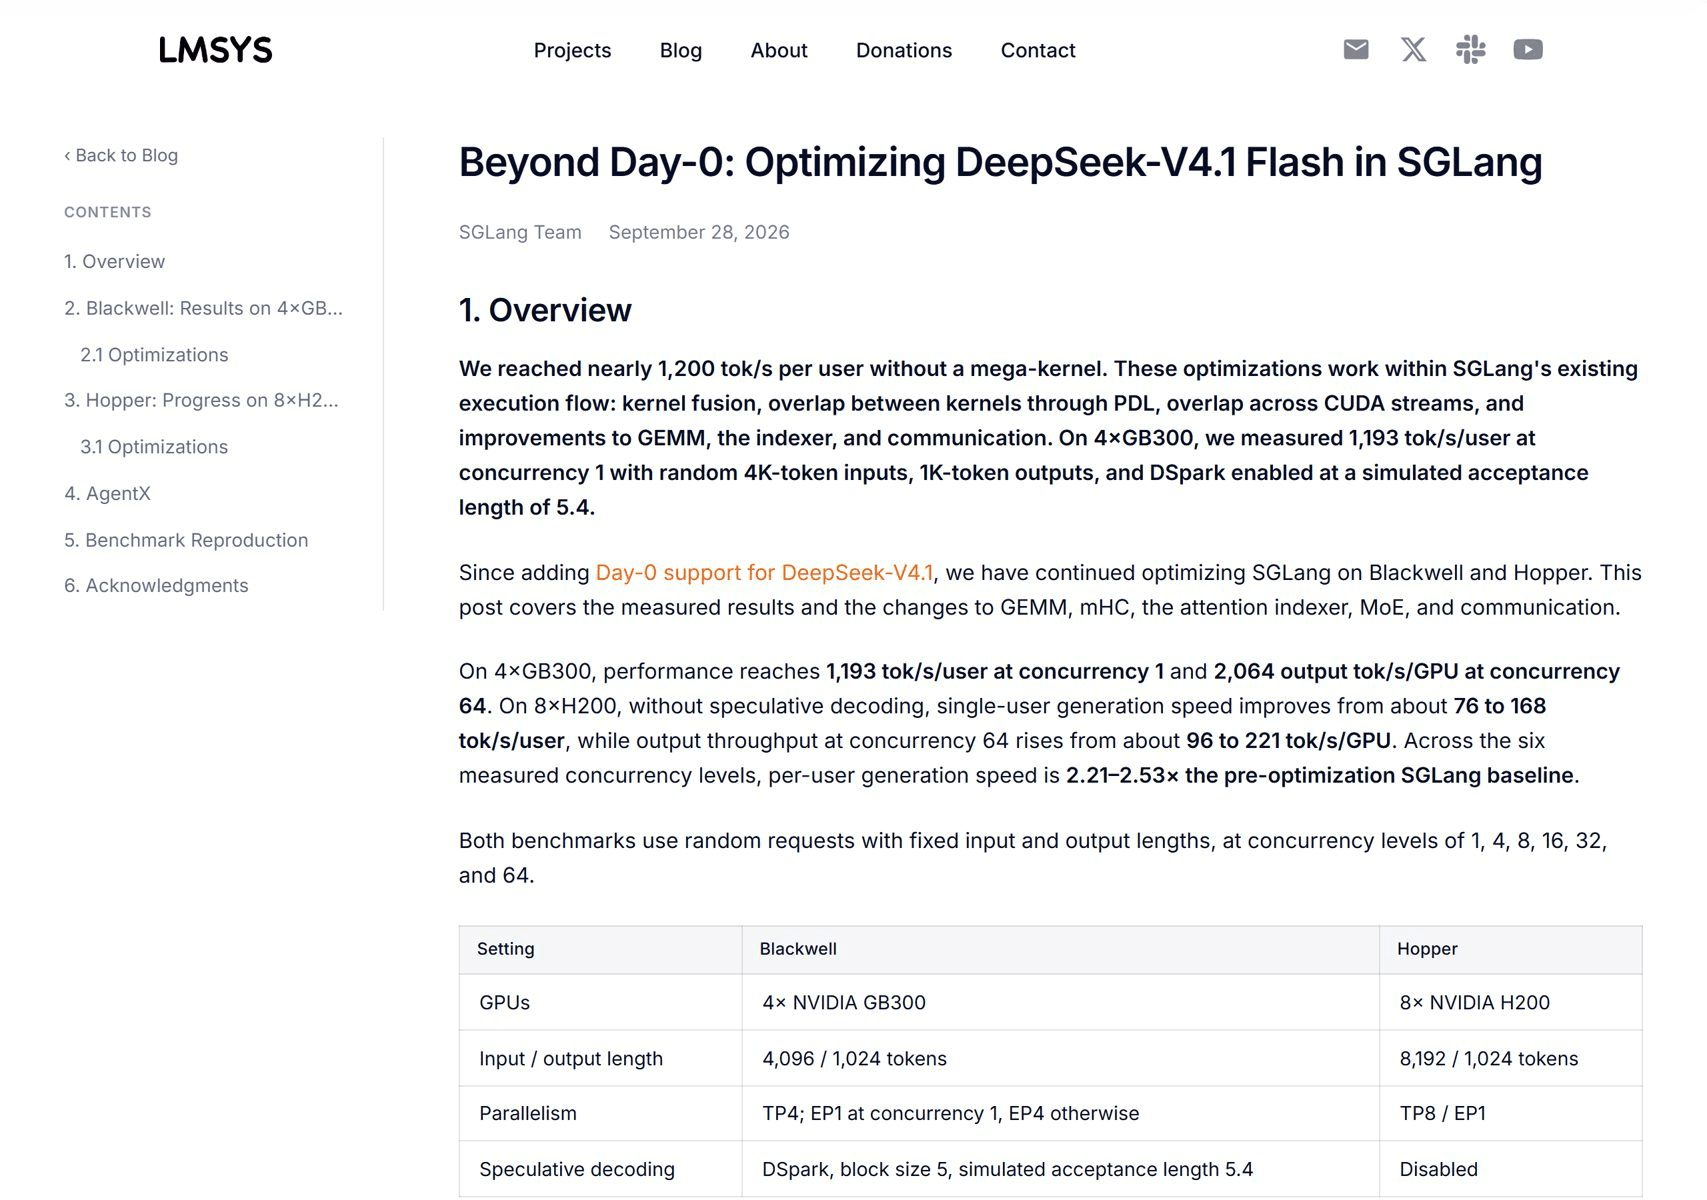
Raporty źródłowe używają różnych obciążeń i sprzętu; ich liczb nie należy odczytywać jako wykresu bezpośredniego porównania.
Zacznij od jednego środowiska uruchomieniowego i zoptymalizuj jego obsługiwaną ścieżkę. Buduj porównanie z drugim środowiskiem tylko wtedy, gdy możesz utrzymać stały checkpoint, alokację GPU, rozkłady promptów i wyjść, współbieżność, rozgrzewanie i cel usługowy. Takie porównanie kosztuje czas inżynierski, więc najpierw potwierdź, że bieżący stos rzeczywiście jest czynnikiem ograniczającym.
Optymalizuj współbieżność i długi kontekst bez łamania SLO
Zwiększaj współbieżność stopniowo i na każdym kroku rejestruj zagregowaną generację, szybkość dekodowania na żądanie, TTFT, opóźnienie p95, użycie pamięci i błędy. Zachowaj punkt o najwyższej przepustowości tylko wtedy, gdy jego opóźnienie i wskaźniki błędów nadal spełniają cel usługowy. Jeśli żądania trafiają do kolejki przed generowaniem, większa partia może poprawić wykorzystanie urządzenia, jednocześnie sprawiając, że produkt wydaje się wolniejszy.
W przypadku ruchu z długim kontekstem zmierz rozkład aktywnego kontekstu i współczynnik trafień pamięci podręcznej. Podane maksymalne okno kontekstu nie oznacza, że każde żądanie może być obsługiwane równocześnie przy tej długości. KV cache konkuruje o pamięć z wagami, aktywacjami, pulami grafów i buforami środowiska uruchomieniowego. Zostaw zapas na zmienne długości żądań i mierz wypieranie lub wywłaszczanie w realistycznym ruchu.
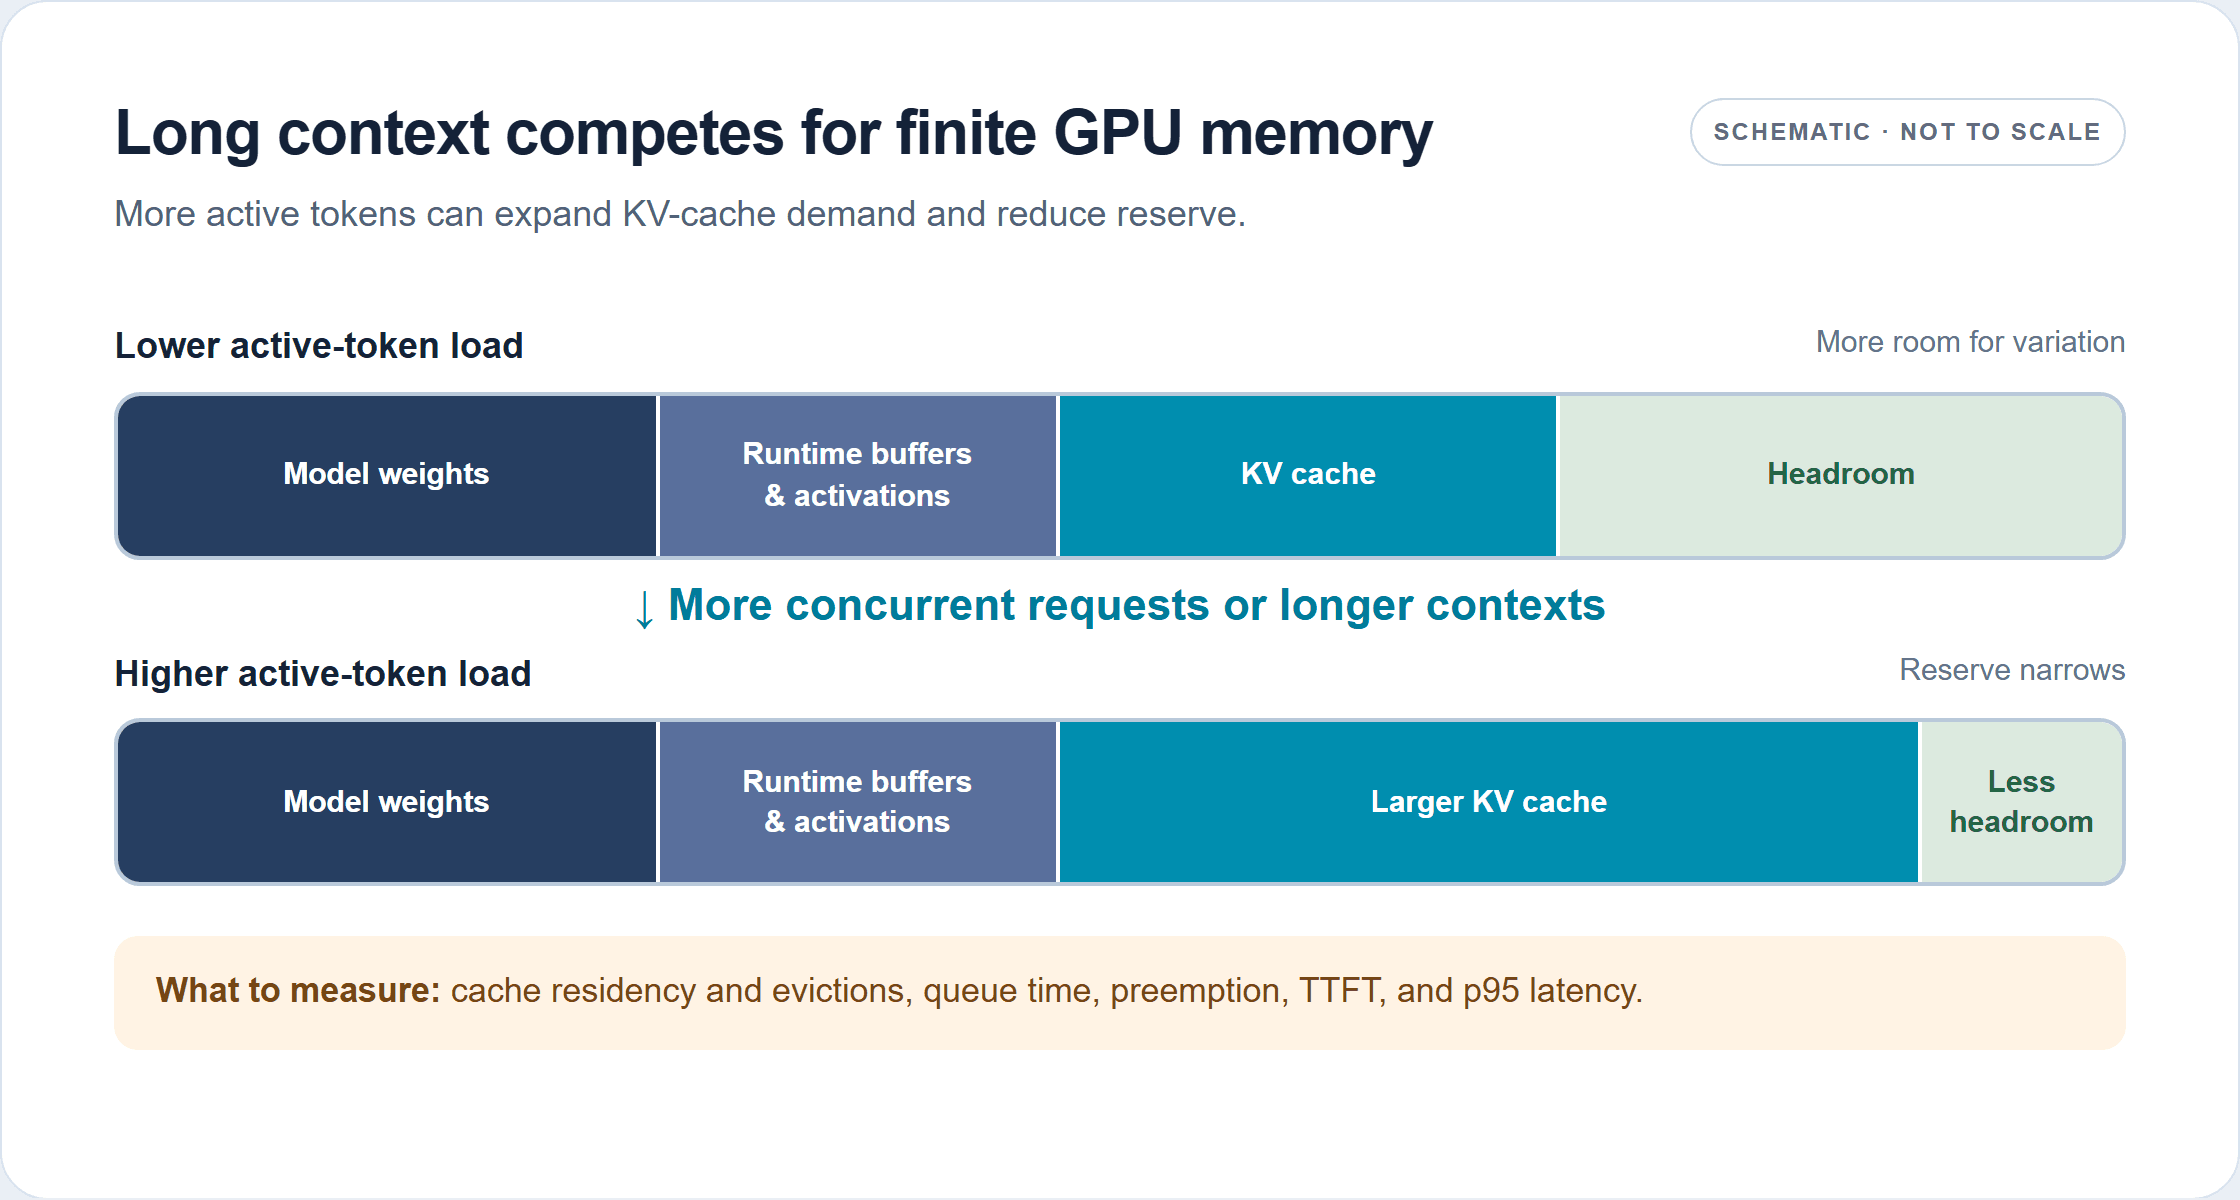
Dłuższe konteksty lub więcej równoczesnych żądań mogą zwiększać zapotrzebowanie na KV cache. Bloki pamięci są schematyczne i nie w skali.
Traktuj kwantyzację, precyzję KV cache, równoległość tensorową, równoległość ekspercką i rozdzielenie prefill/decode jako osobne eksperymenty. Mogą one zmieniać użycie pamięci, komunikację, wybór jąder, jakość wyjścia i opóźnienie. Najlepszy układ zależy od typu GPU i połączeń międzysystemowych; dodanie większej liczby GPU może zwiększyć koszty komunikacji lub pozostawić część zasobów bezczynną. Zweryfikuj dokładną jakość wyjścia i tryby awarii po zmianie precyzji lub wykonania modelu.
Praktyczna kolejność jest prosta: odtwórz baseline, zidentyfikuj metrykę, która nie osiąga celu, sformułuj jedną hipotezę o wąskim gardle, zmień jedno ustawienie i powtórz. Jeśli ustawienie poprawia jedną metrykę, szkodząc innej, zdecyduj wyraźnie, czy ten kompromis pasuje do produktu. Czyni to optymalizację kontrolowaną decyzją, a nie stosem flag.
Weryfikuj dekodowanie spekulacyjne i każde deklarowane przyspieszenie
Dekodowanie spekulacyjne może zmniejszyć szeregową pracę modelu docelowego, gdy tokeny robocze są akceptowane wydajnie, a środowisko uruchomieniowe dobrze implementuje weryfikację. Jego korzyść zależy od ścieżki roboczej, zachowania akceptacji, kształtu partii, sprzętu oraz miksu promptów/wyjść. Może pomóc w ruchu ograniczonym dekodowaniem i mieć niewielką wartość, gdy dominuje prefill, kolejkowanie lub komunikacja.
Przeprowadź test A/B z włączoną i wyłączoną spekulacją. Utrzymaj stały checkpoint modelu, zestaw promptów, limit tokenów, wzorzec napływu, współbieżność, rozgrzewanie i okno pomiarowe. Jeśli są dostępne, rejestruj zaakceptowane tokeny na krok weryfikacji wraz z zagregowaną przepustowością, szybkością na żądanie, TTFT, opóźnieniem p95, użyciem GPU, błędami i jakością zadania. Symulowana długość akceptacji w opublikowanym benchmarku jest warunkiem testu, a nie wartością, którą można założyć dla swoich promptów.
Deklarowane przyspieszenie jest przydatne tylko wtedy, gdy przechodzi trzy kontrole: ten sam cel usługowy, akceptowalna jakość odpowiedzi i uczciwe porównanie kosztów. Podawaj pełny kontekst wraz z każdą publikowaną liczbą. Unikaj porównywania różnych liczb GPU, długości promptów, długości wyjść, trybów precyzji, wersji modelu lub metryk tak, jakby były kontrolowanym eksperymentem.
Samodzielny hosting czy zarządzane API DeepSeek V4.1 Flash?
Samodzielny hosting ma sens, gdy ruch jest wystarczająco stabilny, by utrzymać użyteczność GPU, zespół potrafi obsługiwać infrastrukturę wnioskowania, a kontrola nad sprzętem lub wykonaniem uzasadnia pracę operacyjną. Uwzględnij pełny koszt akceleratorów, zapasu przepustowości, energii, sieci, pamięci masowej, konserwacji i czasu inżynierskiego. Sam wysoki szczytowy wynik tokens/s nie dowodzi niższego kosztu na udane zadanie.
Zarządzane API jest przydatne, gdy zespół musi szybko zweryfikować popyt na produkt, uniknąć prowadzenia floty obsługującej lub porównać baseline API z własnym wdrożeniem. Atlas Cloud wymienia DeepSeek V4.1 Flash pod identyfikatorem modelu deepseek-ai/deepseek-v4.1-flash z API zgodnym z OpenAI. Strona modelu DeepSeek V4.1 Flash obecnie pokazuje $0.30 za milion tokenów wejściowych, $1.20 za milion tokenów wyjściowych i $0.03 za milion tokenów odczytu z pamięci podręcznej, bez wyświetlanej zniżki na październik 2026. Sprawdź bieżący cennik przed szacowaniem wydatków. Zarządzany endpoint nie usuwa potrzeby mierzenia własnego opóźnienia żądań ani ekonomiki ruchu.
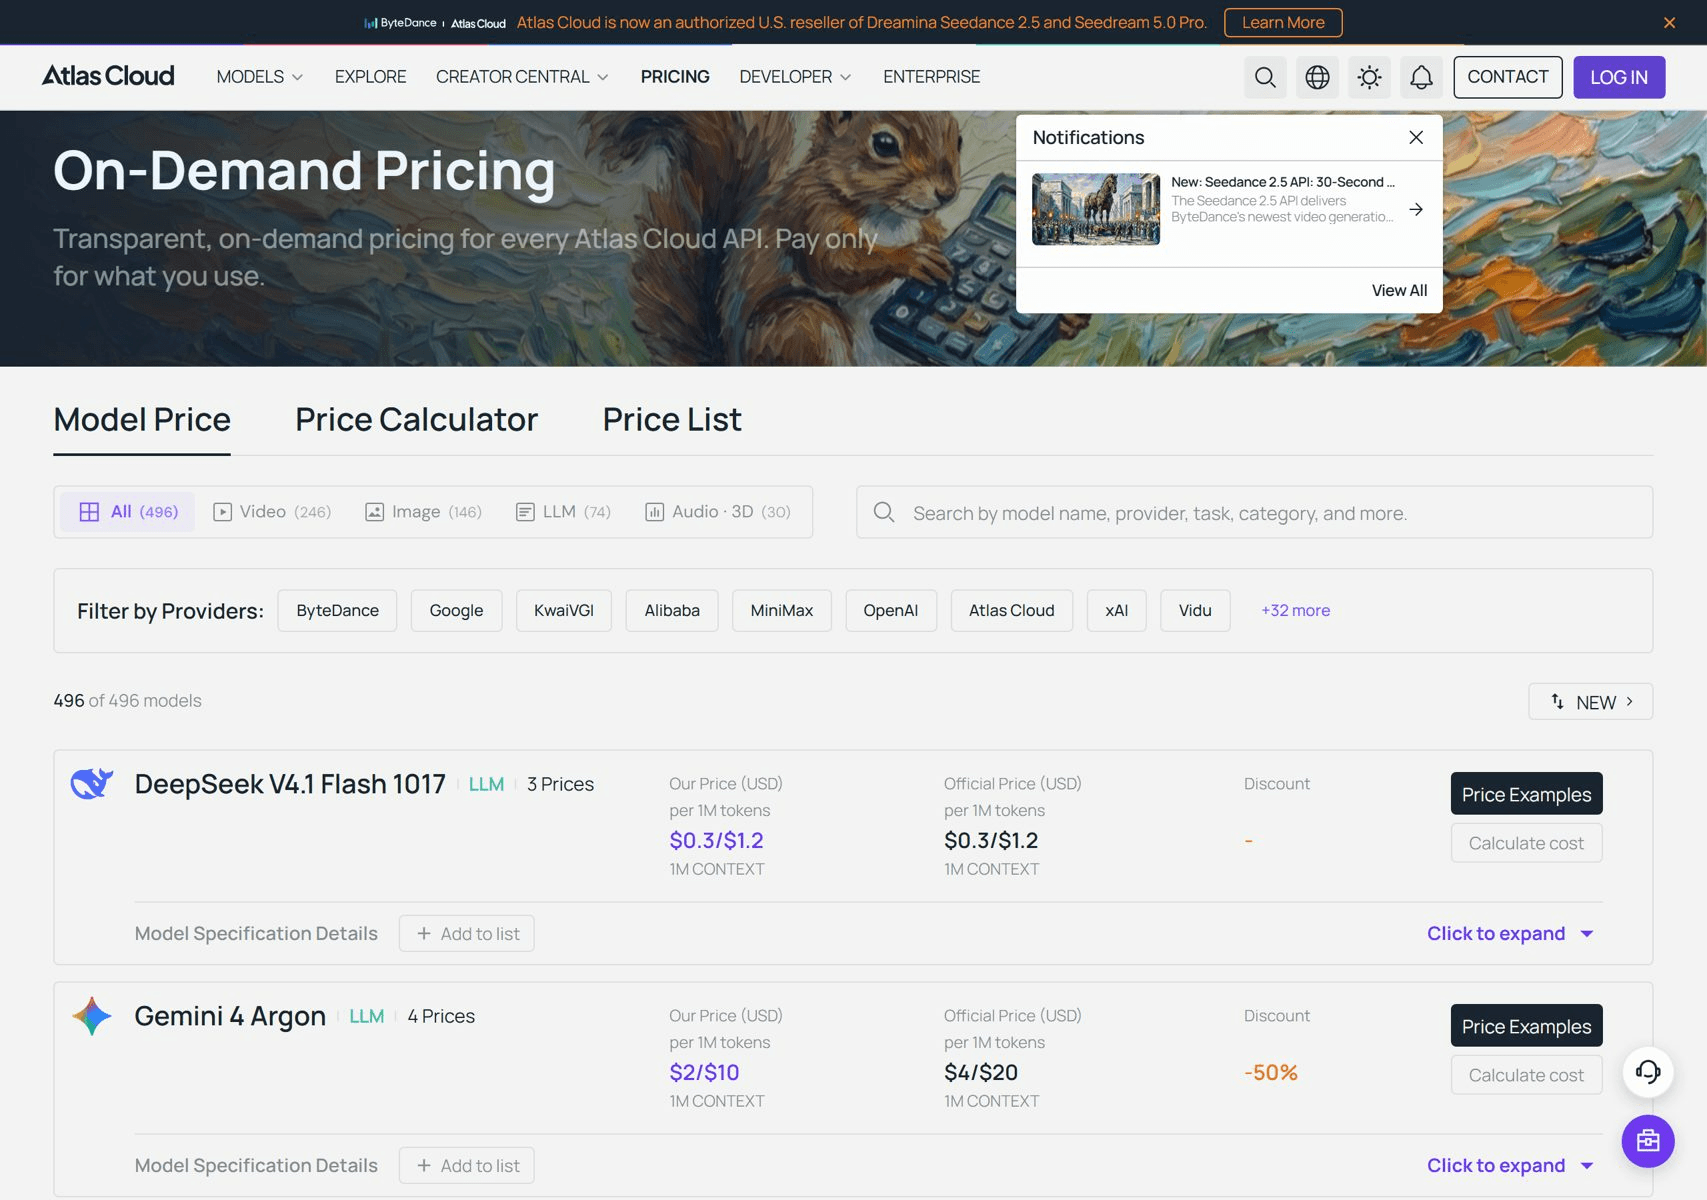
Wpis identyfikuje opcję zarządzanego API; nie jest to benchmark obsługi.
Aby podjąć uczciwą decyzję o wdrożeniu, odtwórz te same żądania biznesowe względem usługi samodzielnie hostowanej i zarządzanego endpointu. Porównaj koszt na ukończone zadanie, rozkład opóźnień, niezawodność i czas pracy personelu potrzebny do utrzymania każdej opcji. Jeśli Twoim głównym celem jest optymalizacja przepustowości wnioskowania DeepSeek V4.1 Flash, zachowaj to samo obciążenie i kryteria sukcesu dla obu ścieżek.
Najczęściej zadawane pytania
Jaka jest różnica między przepustowością a tokenami na sekundę na użytkownika?
Zagregowana przepustowość liczy generację we wszystkich aktywnych żądaniach. Tokeny/s na użytkownika mierzą szybkość dekodowania jednego żądania. Grupowanie może zwiększyć pierwszą, zmniejszając drugą, więc w usługach interaktywnych podawaj obie.
Czy zwiększanie współbieżności zawsze poprawia przepustowość?
Nie. Zagregowana generacja może rosnąć, dopóki obliczenia lub pamięć nie ulegną wysyceniu, a potem się wypłaszczyć. Kolejkowanie i opóźnienie ogona mogą nadal się pogarszać po tym punkcie. Przestań zwiększać współbieżność, gdy cel usługowy nie jest spełniony.
Czy liczby benchmarków vLLM i SGLang można porównywać bezpośrednio?
Tylko jeśli wersja modelu, sprzęt, długości promptów i wyjść, współbieżność, stan rozgrzania, granica pomiaru i ograniczenie opóźnienia są zgodne. Opublikowane raporty używają różnych konfiguracji, więc pokazują ścieżki optymalizacji, a nie bezpośredniego zwycięzcę środowiska uruchomieniowego.
Kiedy używać zarządzanego API zamiast samodzielnego hostingu?
Używaj zarządzanego API, gdy szybkość integracji i mniejszy nakład pracy na infrastrukturę liczą się bardziej niż posiadanie stosu obsługi. Hostuj samodzielnie, gdy wykorzystanie, wiedza operacyjna, kontrola i zmierzony przypadek całkowitego kosztu uzasadniają uruchamianie GPU.





