Okno kontekstowe o pojemności miliona tokenów mówi, ile tekstu model może przyjąć, a nie jak niezawodnie zinterpretuje każdą klauzulę. Dla dokładności analizy długich dokumentów DeepSeek V4.1 Flash publiczne dowody są przydatne, ale niepełne: karta modelu DeepSeek podaje 45.2 exact match na LongBench-V2 dla modelu bazowego V4.1 Flash w konfiguracji 1-shot, podczas gdy API przeszło od tego czasu na nowszą kompilację 1017. Ten benchmark to sygnał o jednej konfiguracji ewaluacji, a nie wskaźnik zdawalności dla Twojej umowy, raportu rocznego czy archiwum badawczego.
Praktyczna odpowiedź to użycie Flash do szybkiego wyszukiwania i syntezy w pierwszym przebiegu, a następnie wymaganie dowodów na poziomie stron i przeglądu przez człowieka przy decyzjach, które mają znaczenie. Żadne cytowane tu publiczne źródło nie dostarcza odtwarzalnej ewaluacji bieżącej kompilacji dla pięciu zadań dokumentowych poniżej. Plan testów to gotowy do uruchomienia protokół, a nie twierdzenie, że te przebiegi już się odbyły.
Najważniejsze wnioski
- Rodzina modeli obsługuje do 1M tokenów, ale limit kontekstu nie gwarantuje dokładności.
- Opublikowany wynik 45.2 na LongBench-V2 dotyczy modelu bazowego i konfiguracji benchmarku 1-shot.
- API DeepSeek obsługuje teraz V4.1-Flash-1017; jego informacje o wydaniu nie publikują nowego wyniku dla długich dokumentów.
- Proś o lokalizacje dowodów, sprawdzaj je w źródle i mierz błędy na własnych dokumentach.
Co oznacza okno 1M tokenów dla analizy dokumentów
Karta modelu DeepSeek opisuje V4.1 Flash jako obsługujący konteksty do miliona tokenów. Dokumentacja API obecnie wskazuje model obsługiwany jako DeepSeek-V4.1-Flash-1017 i podaje długość kontekstu 1M. To specyfikacje pojemności. Nie ustalają, jak często model znajduje przypis, rozdziela dwie wersje dokumentu czy przyznaje, że żądany fakt jest nieobecny. (karta modelu DeepSeek)
Token to nie strona. Liczba stron zmienia się w zależności od tabel, przypisów, układu, języka i jakości ekstrakcji. Zeskanowany PDF może wymagać OCR; tabela może stracić etykiety wierszy podczas konwersji do tekstu; nagłówki i powtarzające się elementy stron mogą zużywać kontekst, nie pomagając w odpowiedzi. Podpowiedź i żądana odpowiedź również zużywają tokeny. Nominalny limit miliona tokenów nie oznacza więc, że każdy plik o rozmiarze miliona tokenów dotrze w nienaruszonym stanie przez każdy interfejs czatu lub klienta API.
Przed testem zapisz dokładny identyfikator modelu, klienta i metodę wprowadzania. Sprawdź, czy wysłano pełny wyodrębniony tekst, czy dostawca go obciął i czy żądanie trafiło do oczekiwanej wersji modelu. Bieżące API DeepSeek używa deepseek-flash dla najnowszej kompilacji Flash. Jeśli Twoja brama lub SDK używa innego aliasu, zapisz ten alias i zweryfikuj jego routing. Zespoły konfigurujące powtarzalne wywołania hostowane mogą zacząć od platformy modeli Atlas Cloud, a następnie otworzyć wpis API DeepSeek V4.1 Flash.
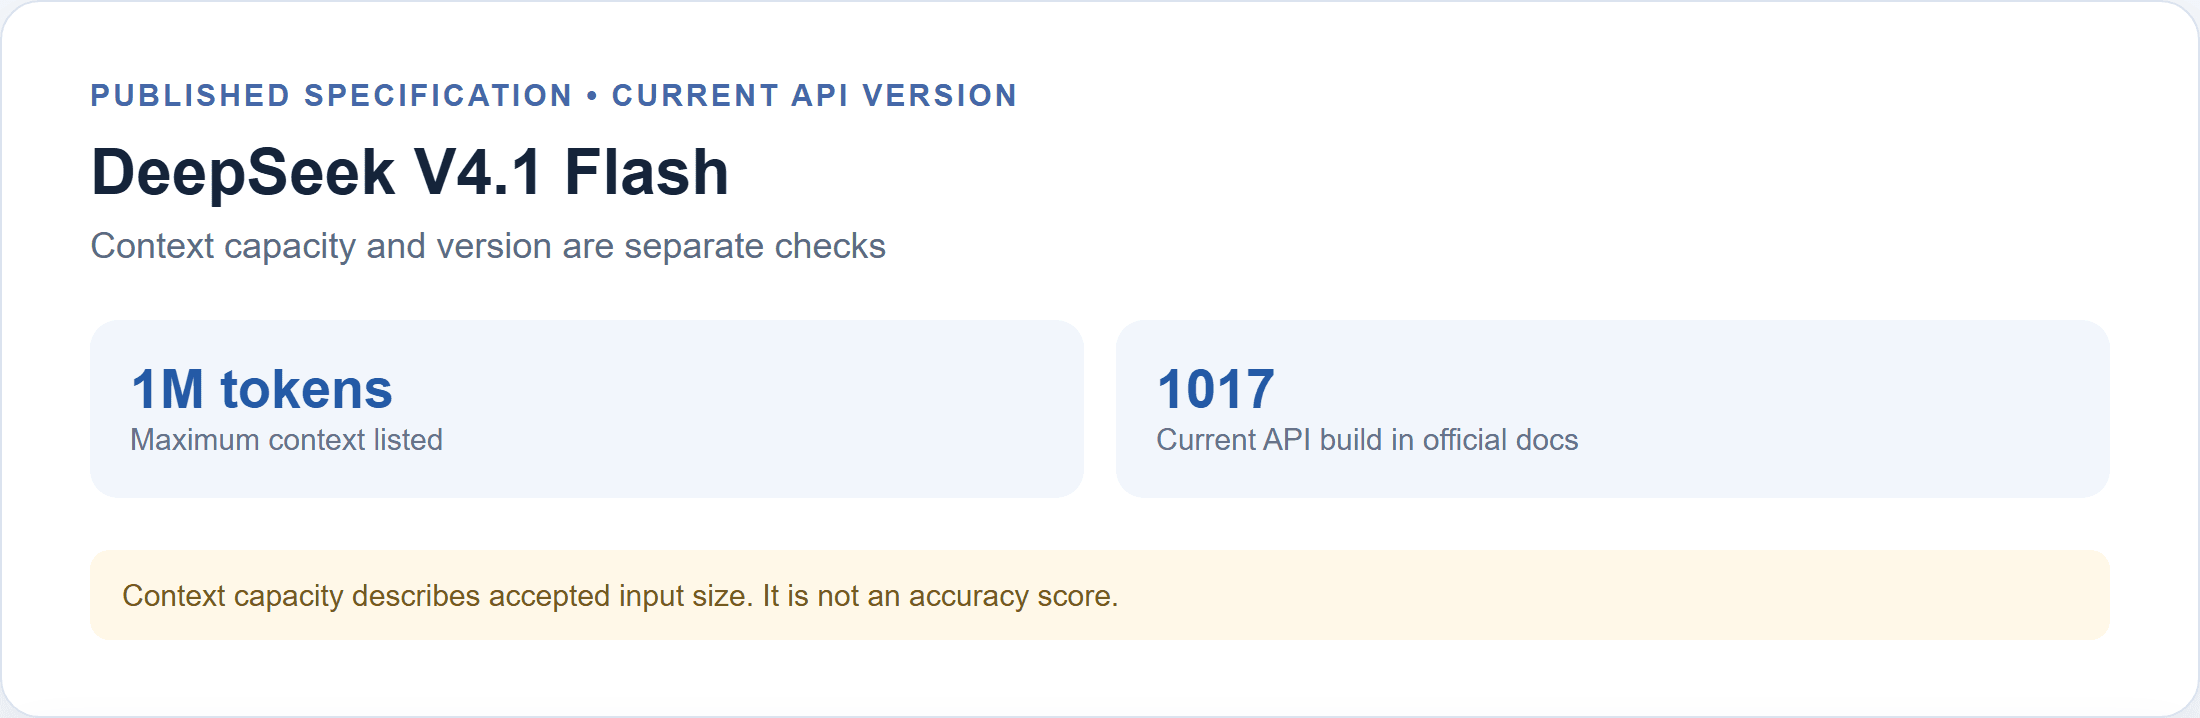
Opublikowana specyfikacja podaje maksymalny kontekst 1M; bieżąca dokumentacja API wskazuje kompilację 1017.
Udane przesłanie lub żądanie pokazuje jedynie, że system przyjął dane wejściowe. Aby ustalić, że istotny szczegół wpłynął na odpowiedź, poproś o dokładną lokalizację, pobierz ten fragment i potwierdź, że otaczający tekst popiera twierdzenie.
Co pokazuje, a czego nie pokazuje wynik LongBench-V2
Wiersz LongBench-V2 w karcie modelu podaje wyniki exact-match w konfiguracji 1-shot. Jego tabela określa wyniki jako ewaluacje modelu bazowego i stwierdza, że wszystkie modele bazowe korzystają z tego samego wewnętrznego frameworku ewaluacji. Stwierdza też, że wyniki w granicach 0,3 są uznawane za równoważne. Wartości są następujące:
| Model bazowy w karcie modelu | LongBench-V2 (EM) | Liczba przykładów |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
Różnica 0,5 punktu między V4-Flash-Base a V4.1-Flash-Base jest większa niż podany w karcie przedział równoważności 0,3, ale pozostaje wąskim porównaniem benchmarkowym. Wartość 45.2 to nie „45,2% dokładności na długich plikach PDF”. To wynik exact-match dla konkretnego modelu bazowego, zestawu benchmarkowego, konfiguracji podpowiedzi i ewaluatora. Nie ocenia bezpośrednio hostowanego modelu instruct/API odpowiadającego na Twoje pytania z inną podpowiedzią.
LongBench-V2 zawiera 503 pytania wielokrotnego wyboru w sześciu kategoriach, w tym odpowiadanie na pytania w obrębie jednego dokumentu i wielu dokumentów, długi dialog, repozytoria kodu i dane strukturalne. Jego konteksty obejmują od 8000 do 2 milionów słów. Autorzy benchmarku podają średnią dokładność 53.7% dla ekspertów w limicie 15 minut i 50.1% dla najlepszego modelu bezpośrednio odpowiadającego w ich raportowanej ewaluacji. Jego szeroki zakres czyni go użytecznym testem obciążeniowym, ale zagregowana liczba nie pozwala zdiagnozować, która operacja na dokumencie jest mocna, a która słaba. (praca LongBench-V2)
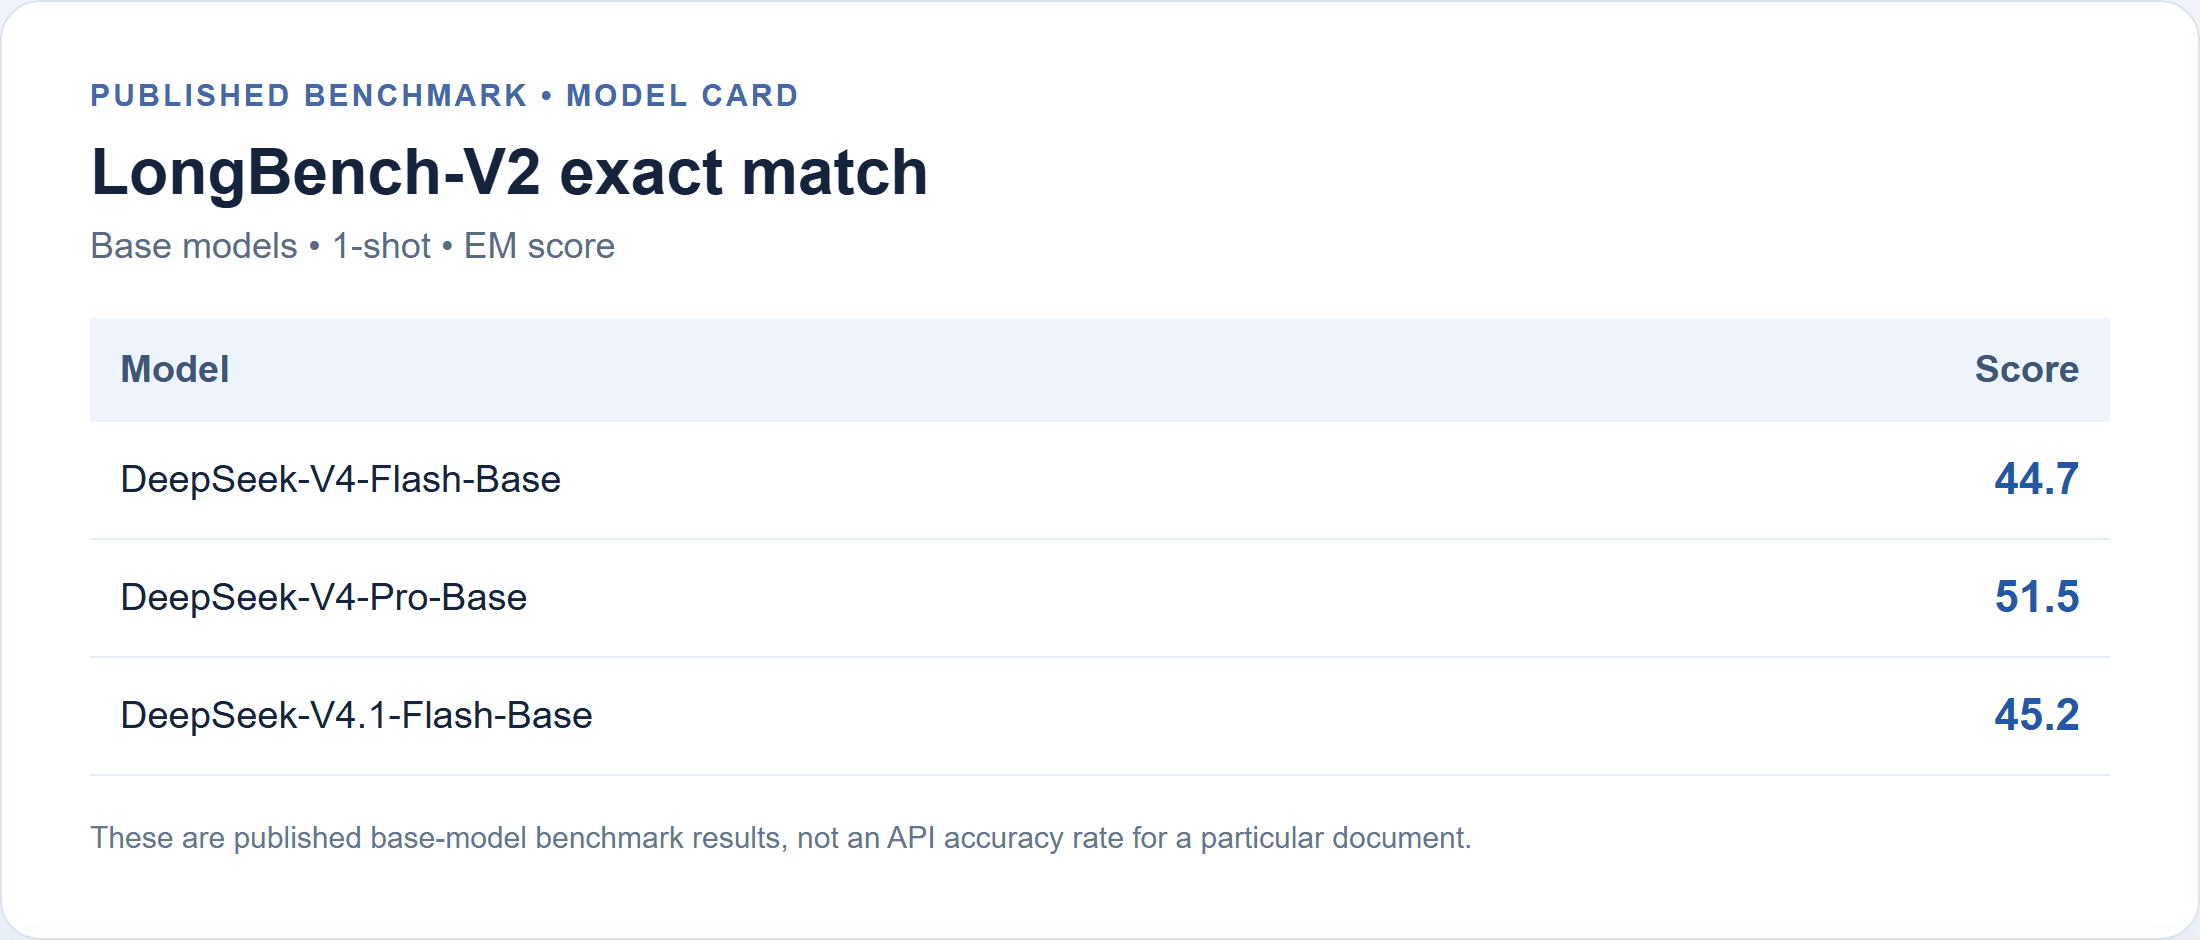
Opublikowany wiersz dotyczy modelu bazowego i wyniku 1-shot. Nie jest zmierzonym wskaźnikiem zdawalności API.
Jest jedno zastrzeżenie dotyczące wersji. Informacje o wydaniu DeepSeek z 17 października mówią, że API i aplikacja webowa zostały zaktualizowane do V4.1-Flash-1017, a nazwa modelu w API pozostaje deepseek-flash. Notatki wymieniają zaktualizowane benchmarki agentowe i rozumowania, ale nie podają nowego wyniku LongBench-V2. Zatem 45.2 pozostaje użytecznym opublikowanym punktem odniesienia dla modelu bazowego V4.1 Flash, podczas gdy dokładność bieżącej kompilacji API w pytaniach o długie dokumenty pozostaje nieokreślona ilościowo w tych źródłach. Nie przenoś niezwiązanych zysków benchmarkowych na QA dokumentów. (aktualizacja DeepSeek V4.1-Flash-1017)
Jak przeprowadzić rzetelny test dokładności na długich dokumentach
Przydatna ewaluacja wymaga stałego źródła, klucza odpowiedzi i reguł punktowania. Zacznij od publicznego raportu rocznego lub raportu technicznego, którego wersję i strukturę stron można udostępnić. Zapisz PDF i wyodrębniony tekst, zanotuj URL źródła i datę pobrania oraz odnotuj, czy użyto natywnej ekstrakcji tekstu czy OCR. Unikaj wybierania dokumentu tylko dlatego, że wiesz, iż model radzi sobie z nim dobrze.
Przed wysłaniem podpowiedzi do modelu samodzielnie napisz klucz odpowiedzi na podstawie źródła. Dla każdego pytania zapisz oczekiwaną odpowiedź oraz dokładną stronę lub sekcję. To zapobiega temu, by przekonująca odpowiedź stała się standardem oceniania. Formułuj pytania na tyle konkretnie, by dały się ocenić, zachowując przy tym niejednoznaczność, z jaką faktycznie spotkałby się czytelnik.
Dla każdego przebiegu używaj tego samego dokumentu, zestawu pytań, identyfikatora modelu, podpowiedzi, ustawienia rozumowania i formatu wyjścia. Jeśli API udostępnia kontrolki temperatury lub rozumowania, zapisz je. Uruchom zestaw więcej niż raz, jeśli chcesz oszacować zmienność; jeden przebieg to próbka, a nie stabilny wskaźnik. Nie naprawiaj po cichu wyniku przed jego oceną.
Zwięzły zestaw może objąć pięć różnych okazji do błędu:
| Zadanie | Przykładowa forma pytania | Co weryfikować |
|---|---|---|
| Wyszukanie pojedynczego punktu | „Jaką datę podaje raport dla zmienionej polityki?” | Dokładna wartość i cytowana strona |
| Powiązanie między sekcjami | „Jak ryzyko w sekcji 2 wiąże się z kontrolą w sekcji 7?” | Oba fragmenty oraz to, czy powiązanie jest podane, czy wywnioskowane |
| Obsługa wyjątków | „Kto jest wyłączony z podanego zakresu ochrony?” | Przypis, zakres i kwalifikatory |
| Konflikt wersji | „Która wartość obowiązuje po korekcie i co zastąpiła?” | Daty, etykiety wersji i obie lokalizacje |
| Brakująca informacja | „Jaki okres przechowywania raport określa dla kopii dostawców?” | Przyznanie, jeśli dokument nic nie mówi |
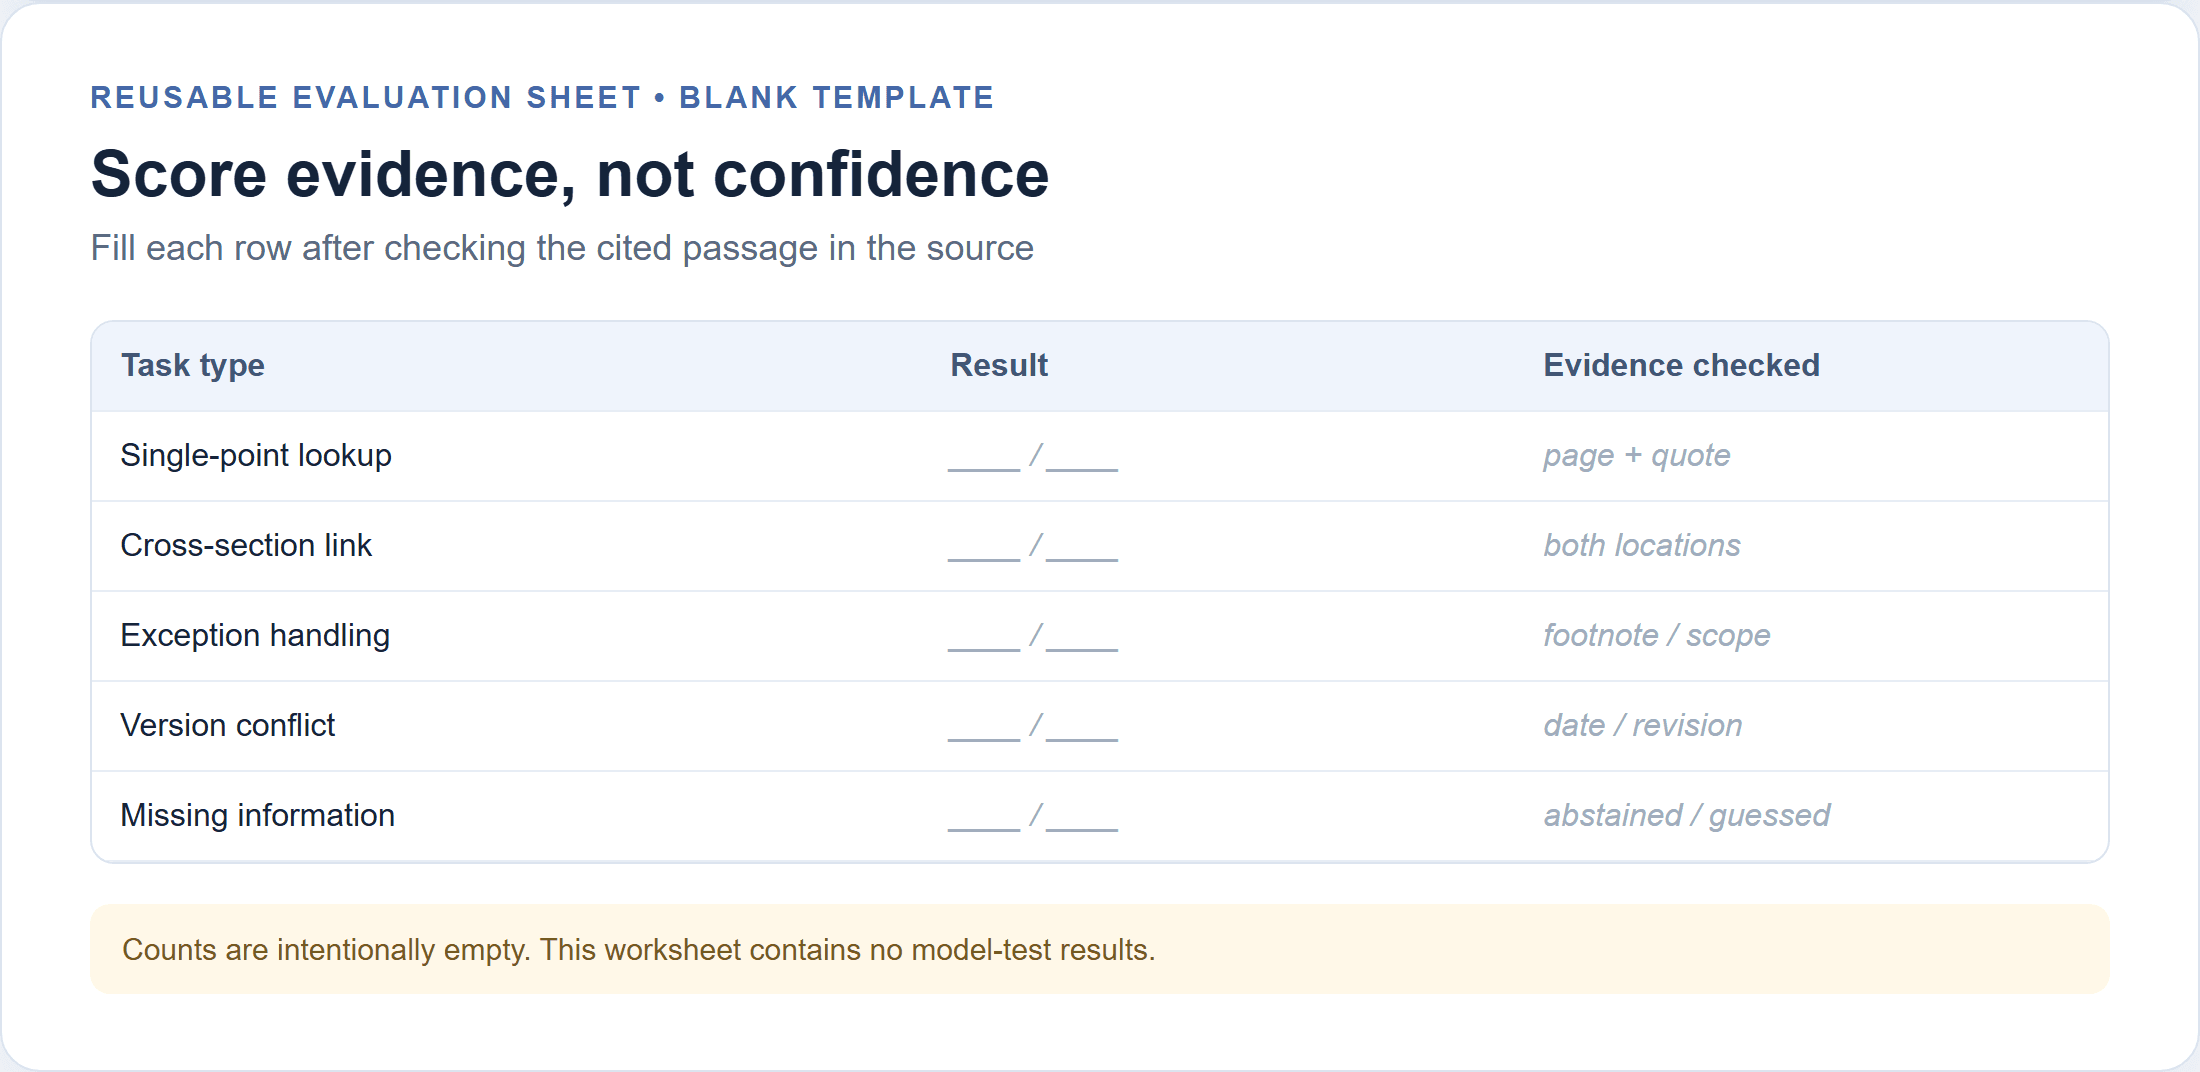
To pusty arkusz punktowania, a nie tabela wyników. Wypełniaj go dopiero po sprawdzeniu każdej odpowiedzi względem dokumentu źródłowego.
Oceniaj każdą odpowiedź jako poprawną, częściową, błędną, niepopartą lub prawidłowo wstrzymaną. Licz twierdzenia niepoparte oddzielnie od błędnych odpowiedzi, ponieważ odpowiedź może podać właściwą odpowiedź główną i wymyślić szczegół. Sprawdź, czy każde cytowanie wskazuje fragment, który popiera twierdzenie. Podawaj liczbę pytań i liczby w kategoriach razem. Ogólny odsetek ukrywa, czy model pominął przypisy, czy miał trudność tylko wtedy, gdy informacje były rozproszone po sekcjach.
Zachowaj dokładny plik źródłowy, ekstrakcję, podpowiedzi, surowe odpowiedzi i arkusz punktowania. Publikuj tylko materiał, do którego masz pozwolenie na udostępnienie, i zredaguj poufne nazwy lub dane konta. Recenzent powinien móc prześledzić każdą ocenioną odpowiedź od wyniku modelu do strony w zapisanym źródle.
Gdzie odpowiedzi na długie dokumenty zwykle zawodzą
Bez przebiegu na bieżącej kompilacji względem określonego dokumentu błędem byłoby twierdzić, że V4.1 Flash wykazał konkretny wskaźnik błędów lub wzorzec awarii. Poniższe kategorie to rzeczy do sprawdzenia, a nie zmierzone ustalenia o tym modelu.
Zacznij od utraty zakresu. Akapit główny może podawać regułę, podczas gdy przypis ogranicza ją do regionu, zakresu dat lub klasy klientów. Poproś jawnie o wyjątek i sprawdź, czy cytowany fragment go zawiera. Cytat z samego akapitu głównego może nie wystarczyć.
Następnie sprawdź zamieszanie z wersjami. Raporty mogą powtarzać podobne wartości w wersji roboczej i w sekcji zmienionej. Poproś model o podanie daty lub wersji przypisanej do każdej wartości, zamiast prosić tylko o „bieżącą liczbę”. Jeśli wybierze jedną bez słowa, oceń odpowiedź jako niekompletną, nawet jeśli przypadkowo wybierze poprawnie.
Pytania międzysekcyjne zachęcają do wnioskowania. Model może połączyć dwa trafne fakty w wyjaśnienie przyczynowe, którego dokument wcale nie zawiera. Wymagaj, by oznaczał twierdzenia bezpośrednie oddzielnie od wniosków. Następnie porównaj wniosek z dowodami i zdecyduj, czy jest rozsądny dla danego zadania.
Na koniec przetestuj wstrzymanie się od odpowiedzi. Umieść pytanie, na które nie ma odpowiedzi. Pewna siebie zgadywanka to porażka, nawet jeśli brzmi wiarygodnie. W przypadku umów, zgodności, materiału klinicznego lub finansowej analizy o istotnych skutkach poproś wykwalifikowaną osobę o sprawdzenie oryginalnego tekstu przed wykorzystaniem wniosku.
Proces weryfikacji dla bezpieczniejszych odpowiedzi
Ta podpowiedź czyni odpowiedzi łatwiejszymi do audytu. Nie może zagwarantować poprawności ani zastąpić przeglądu źródła. Używaj jej z ekstrakcją, która zachowuje etykiety stron, a następnie zadawaj konkretne pytania, zamiast prosić o ogólne streszczenie ogromnego pliku.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
W przypadku długiego raportu dziel pracę według zadania, a nie automatycznie według dowolnej liczby stron. Najpierw poproś o mapę źródła: tytuły sekcji, daty, zdefiniowane terminy i istotne tabele. Następnie zapytaj o konkretny temat i poproś o fragmenty go popierające. W przypadku wniosku międzysekcyjnego dostarcz lub pobierz oba fragmenty w tej samej turze i poproś model o wyjaśnienie powiązania, oznaczając wszelkie wnioskowanie.
Użyj pętli weryfikacji przez człowieka:
- Sprawdź cytowaną stronę i cytat w oryginalnym pliku.
- Potwierdź, że cytat obejmuje sąsiednie wyjątki i nagłówki tabel.
- Oznacz każde twierdzenie jako bezpośrednie, wywnioskowane, niepoparte lub zaprzeczone.
- Popraw podpowiedź lub podziel zadanie, jeśli ekstrakcja pominęła ważną strukturę.
- Zapisz surowe żądanie i odpowiedź, aby recenzent mógł odtworzyć decyzję.
Gdy korzystasz z hostowanego endpointu, uwzględnij zużycie tokenów w dzienniku przebiegu. Strona cennika modeli Atlas Cloud obecnie podaje DeepSeek V4.1 Flash w cenie $0.30 za 1M tokenów wejściowych, $1.20 za 1M tokenów wyjściowych i $0.03 za 1M tokenów odczytu z pamięci podręcznej, bez podanej zniżki. Sprawdź bieżącą ofertę przed planowaniem budżetu. Ta referencja cenowa dotyczy Atlas Cloud, a nie uniwersalnej ceny API DeepSeek.
Przy tych podanych stawkach 100 000 niebuforowanych tokenów wejściowych i 3000 tokenów wyjściowych kosztuje około $0.033: $0.030 za wejście plus $0.0036 za wyjście.
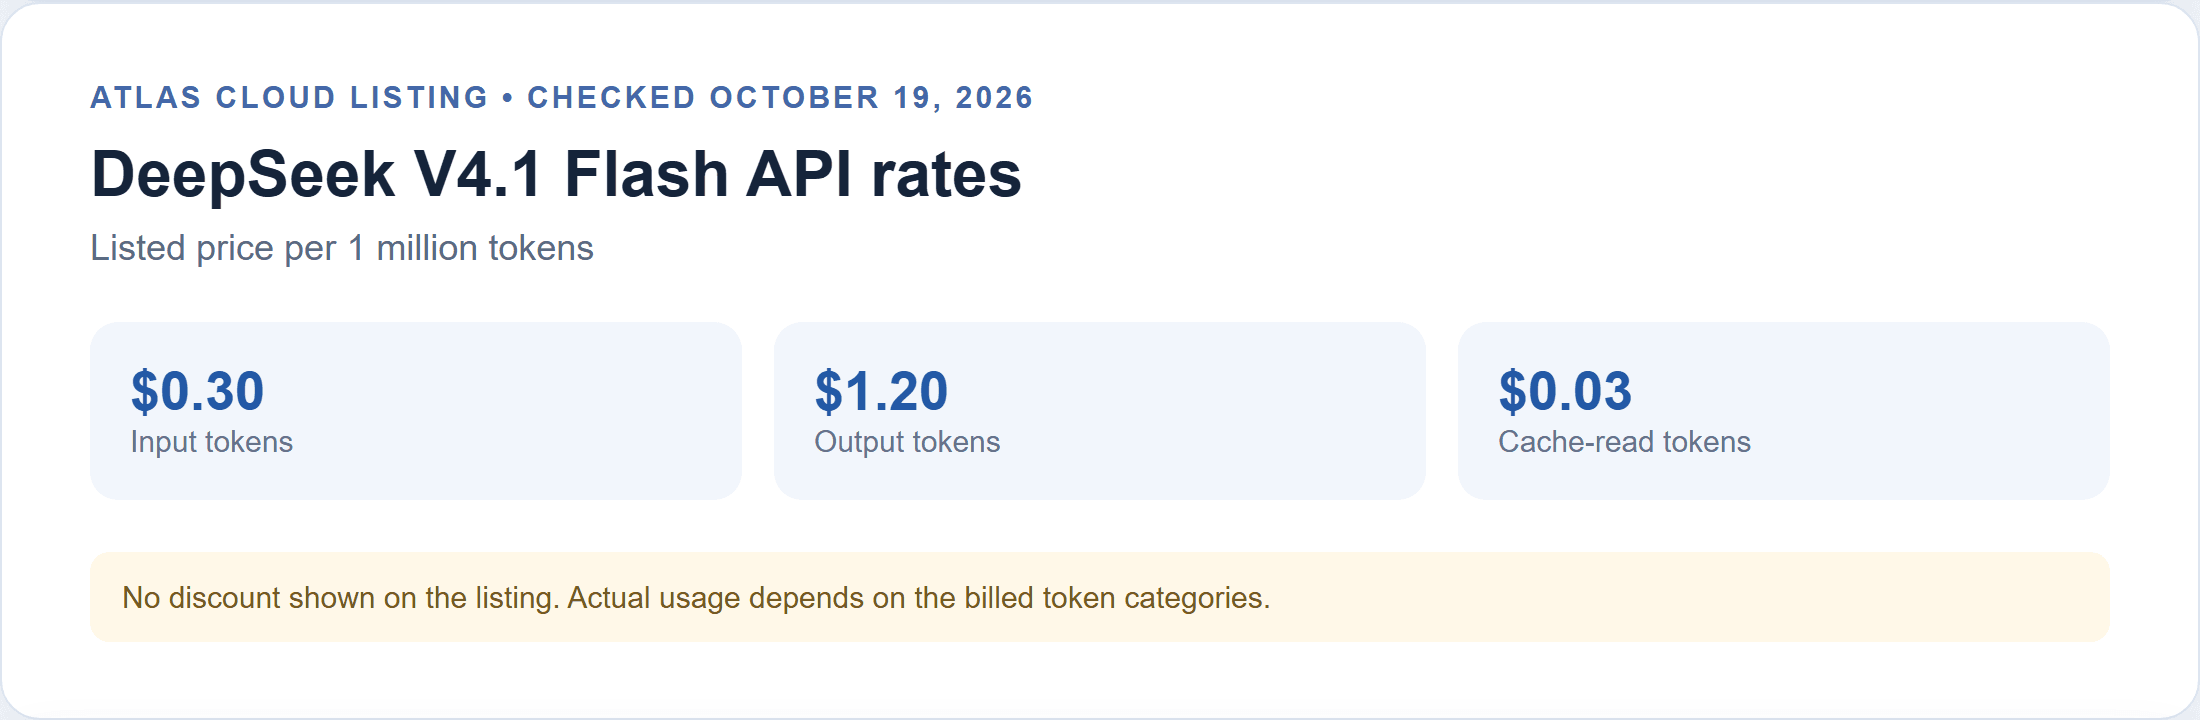
Ceny Atlas Cloud sprawdzone 19 października 2026; oferta nie wykazuje zniżki. Wejście o rozmiarze 1M tokenów i odpowiedź o rozmiarze 20 000 tokenów kosztowałyby około $0.324 przy tych samych stawkach, przed uwzględnieniem pamięci podręcznej lub innych pozycji rozliczeniowych. To przykłady arytmetyczne, a nie zmierzone rachunki za test dokumentów. Rzeczywiste wejście obejmuje podpowiedź i wyodrębniony tekst; powtarzane wywołania zwiększają zużycie. Używaj zwróconych przez dostawcę liczb tokenów, zamiast szacować na podstawie liczby stron.
Kiedy używać DeepSeek V4.1 Flash do długich dokumentów
Flash to rozsądny pierwszy przebieg, gdy musisz zlokalizować definicje, zebrać daty, utworzyć mapę sekcji lub przygotować szkic streszczenia, który sprawdzi człowiek. Te zadania mają widoczne ścieżki dowodowe i łatwo je powtórzyć z węższymi pytaniami. W przypadku pracy cyklicznej trzymaj pytania ze znanymi odpowiedziami i uruchamiaj je ponownie, gdy zmieni się wersja modelu, potok ekstrakcji lub podpowiedź.
Dodaj kontrole, gdy pytanie łączy odległe sekcje, zależy od przypisu lub porównuje wersje. Używaj cytowań jako pomocy nawigacyjnych, a nie dowodu samego w sobie. Jeśli odpowiedź wpłynie na zobowiązanie umowne, pozycję zgodności, ujawnienie finansowe lub inną decyzję o dużym wpływie, poproś wykwalifikowanego recenzenta o zweryfikowanie każdego istotnego twierdzenia w źródle.
Użyteczne pytanie brzmi, czy ten model, na Twojej wersji dokumentu i dokładnym przepływie pracy, zwraca odpowiedzi z dowodami, które przetrwają sprawdzenie. To jest test, który może ustalić dokładność analizy długich dokumentów DeepSeek V4.1 Flash dla Twojego własnego przypadku użycia.
Często zadawane pytania
Czy okno kontekstowe o pojemności 1M tokenów oznacza, że model może dokładnie analizować dokument o rozmiarze 1M tokenów?
Nie. Opisuje obsługiwaną pojemność kontekstu. Rzeczywiste żądanie obejmuje również instrukcje i budżet wyjścia, a ekstrakcja, limity interfejsu i trudność pytania wpływają na to, czy użyteczne dowody są dostępne i poprawnie interpretowane.
Czy LongBench-V2 to to samo co dokładność odpowiadania na pytania o dokumenty?
Nie. Obejmuje kilka kategorii zadań długiego kontekstu i podaje wydajność w konkretnej konfiguracji. To sygnał porównawczy, a nie gwarancja dla konkretnego PDF, kompilacji API, podpowiedzi czy dziedziny.
Czy powinienem używać jednej podpowiedzi, czy dzielić długi dokument na sekcje?
Używaj mapy źródła i konkretnych pytań, gdy struktura ma znaczenie. Trzymaj fragmenty, które trzeba porównać, dostępne razem na etapie syntezy, i zachowuj etykiety stron, aby móc zweryfikować odpowiedź.
Jak weryfikować cytowania z podsumowania wygenerowanego przez AI?
Otwórz każdą cytowaną stronę w oryginalnym pliku, sprawdź cytat i otaczający tekst oraz potwierdź, że fragment popiera konkretne twierdzenie. Weryfikuj nagłówki tabel i przypisy, a także cytowane zdanie.
Jak tokeny wejściowe i wyjściowe wpływają na koszt?
Tokeny wejściowe obejmują dokument, instrukcje i pytanie. Tokeny wyjściowe obejmują odpowiedź. Dłuższe podpowiedzi, wiele wywołań i powtarzane fragmenty zwiększają zużycie; do szacunków używaj rozliczanych liczb tokenów i bieżącej tabeli cen dostawcy.


