

Programista widzi „1 mln tokenów” i przygotowuje się do wysłania całego repozytorium, jego historii zgłoszeń i długiego raportu projektowego w jednym żądaniu. Kluczowy szczegół okna kontekstowego 1 mln tokenów Gemini 4 Argon polega na tym, że 1 048 576 tokenów jest współdzielonych przez dane wejściowe, myślenie i dane wyjściowe. To nie jest milion tokenów wejściowych plus kolejny milion na odpowiedź. Google podaje domyślny limit synchronicznych danych wyjściowych wynoszący 65 536 tokenów, a długie dekodowanie może wydłużyć generowanie do pozostałej współdzielonej pojemności. Specyfikacja modelu Google podaje limity; ten przewodnik zamienia je na budżet oraz decyzję dotyczącą długiego kontekstu, wyszukiwania i dzielenia na fragmenty.
Najważniejsze wnioski
- Kontekst 1 048 576 tokenów to łączny budżet danych wejściowych, myślenia i danych wyjściowych.
- Domyślne synchroniczne dane wyjściowe są ograniczone do 65 536 tokenów; długie dekodowanie nie dodaje więcej kontekstu.
- Używaj długiego kontekstu, gdy znaczenie mają relacje w znanym zestawie źródeł; używaj wyszukiwania lub dzielenia na fragmenty, gdy nie mają.
Co oznacza okno kontekstowe 1 mln tokenów Gemini 4 Argon?
Budżet 1 048 576 tokenów jest współdzielony
Okno kontekstowe to limit tokenów dostępny dla żądania. W przypadku Argon Google dokumentuje łączny limit 1 048 576. Monit, załączony materiał źródłowy, tokeny myślenia i wygenerowana odpowiedź korzystają z tego przydziału. Opisuje on pojemność, a nie obietnicę, że każdy szczegół będzie równie łatwy do odnalezienia lub przemyślenia.
Jeśli żądanie zawiera 900 000 tokenów źródłowych, na myślenie i dane wyjściowe pozostaje co najwyżej 148 576 tokenów, przed ograniczeniami specyficznymi dla interfejsu. Aplikacja, która zakłada, że może następnie zażądać odpowiedzi o długości 200 000 tokenów, przekroczyła ten sam budżet.
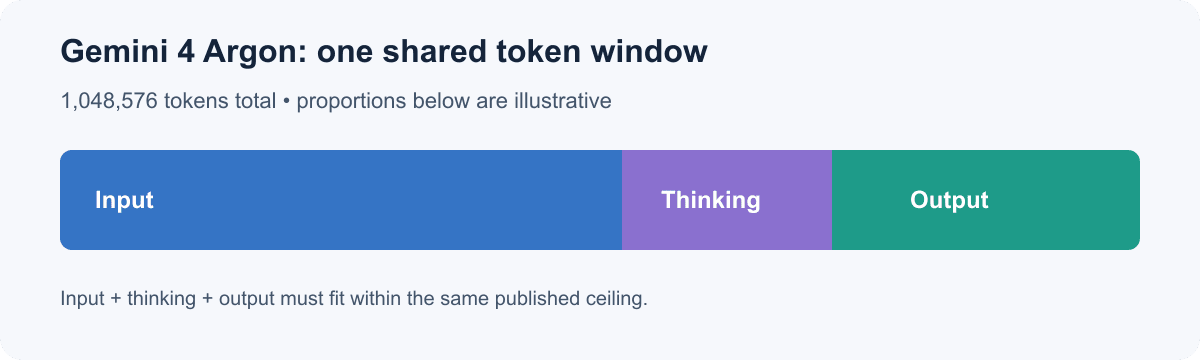
Opublikowane okno to jeden współdzielony pułap. Rozmiary segmentów są koncepcyjne, a nie stałym przydziałem.
Dane wejściowe, myślenie i dane wyjściowe korzystają z jednego okna
Przydatne równanie planistyczne to:
input tokens + thinking tokens + output tokens <= 1,048,576
To kontrola budżetu, a nie twierdzenie, że programiści mogą ustawić dokładną liczbę tokenów myślenia dla każdego wywołania. Google podaje ustawienia myślenia niski, średni i wysoki; wewnętrzne zużycie może się różnić w zależności od zadania i ustawień. Zarezerwuj miejsce na rozumowanie, zamiast traktować teoretyczną resztę jako gwarantowaną pojemność odpowiedzi.
Argon obsługuje dane wejściowe tekstowe, obrazowe, wideo, audio i PDF, a zwraca tekst. Rozliczanie multimediów nie jest równoważne ze zwykłym tekstem, więc liczba plików lub stron nie pozwala wiarygodnie przewidzieć całkowitej liczby tokenów. Sprawdź metadane użycia z reprezentatywnego żądania.
Okno kontekstowe a limit danych wyjściowych: kluczowa różnica
Domyślny limit danych wyjściowych
Strona modelu podaje maksymalne dane wyjściowe na poziomie 65 536 tokenów dla domyślnej generacji synchronicznej, czyli około jednej szesnastej całego okna. Żądanie może mieścić się w ogólnym limicie kontekstu i nadal przekraczać aktywny limit danych wyjściowych.
W wielu zastosowaniach ten domyślny limit jest wystarczający. Przegląd repozytorium lub synteza dokumentów zwykle wymagają skupionej odpowiedzi, a nie tak długiej jak zestaw źródeł. Ograniczone dane wyjściowe łatwiej przejrzeć, zapisać i przekazać do kolejnego kroku.
Co zmienia długie dekodowanie
Długie dekodowanie obsługuje znacznie dłuższe generowanie, do 1 048 576 tokenów zgodnie ze specyfikacją modelu. Nie rozszerza całkowitego okna. Jeśli monit zajmuje już większość okna, na myślenie i dane wyjściowe pozostaje mniej pojemności. Znaczenie mają też ścieżka API, SDK, ustawienia żądania i obsługa odpowiedzi, więc przed poleganiem na długiej odpowiedzi w środowisku produkcyjnym sprawdź aktualne wytyczne dotyczące integracji.
Używaj długiego dekodowania tylko wtedy, gdy rezultat naprawdę wymaga obszernego wygenerowanego materiału, np. dużej transformacji strukturalnej zwracanej w jednej operacji. Jeśli odpowiedź można podzielić na zweryfikowane sekcje, generowanie etapowe może ułatwić wykrywanie i odzyskiwanie niekompletnych wyników.
Jak zaplanować budżet tokenów danych wejściowych, myślenia i danych wyjściowych
Zacznij od rezultatu, a następnie oszacuj tokeny źródłowe, korzystając z dostępnej metody zliczania dla wybranego modelu, jeśli jest dostępna. Uwzględnij też instrukcje, wyniki narzędzi, tekst schematu i historię rozmowy. Zarezerwuj margines na myślenie i błąd oszacowania, zamiast wydawać teoretyczną resztę.
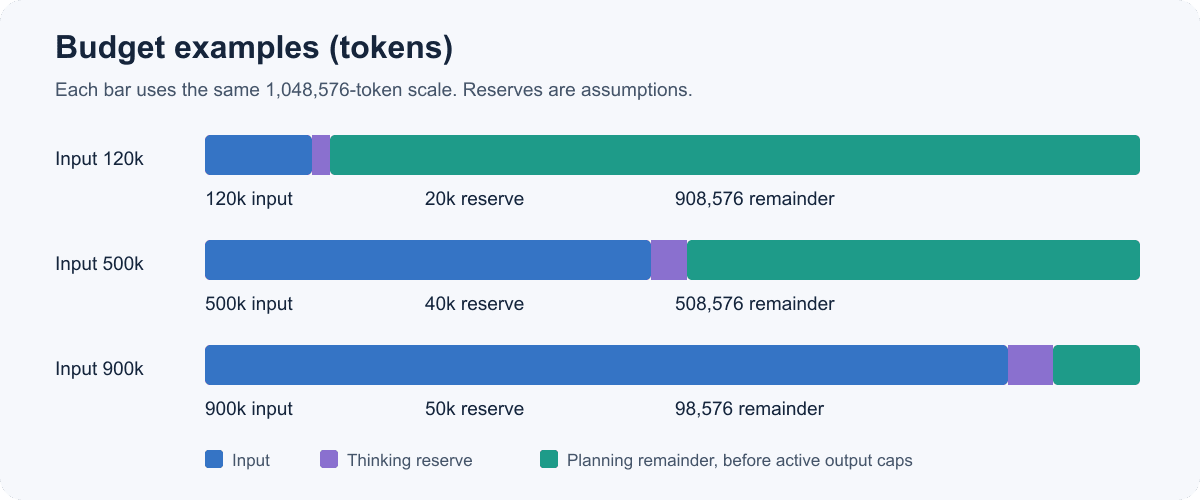
Poniższe wartości to przykłady arytmetyczne, a nie stałe zużycie rozumowania. „Reszta planistyczna” to suma po odjęciu założonych danych wejściowych i zarezerwowanego przydziału na myślenie. Nadal obowiązują rzeczywiste limity usługi.
| Założone dane wejściowe | Rezerwa na myślenie | Reszta planistyczna na dane wyjściowe | Przykład |
|---|---|---|---|
| 120 000 | 20 000 | 908 576 | Kilka podręczników, zwięzła synteza |
| 500 000 | 40 000 | 508 576 | Przegląd bazy kodu z odwołaniami do plików |
| 900 000 | 50 000 | 98 576 | Porównanie archiwum z ograniczoną odpowiedzią |
Przykładowe obliczenia na podstawie pułapu 1 048 576 tokenów; rezerwy to założenia planistyczne.
Użyj tej listy kontrolnej planowania żądania:
- Dane wejściowe: szacowana liczba tokenów źródłowych i monitu.
- Myślenie: zarezerwuj pojemność na podstawie złożoności zadania i obsługiwanych ustawień.
- Dane wyjściowe: wybierz limit odpowiedni dla rezultatu.
- Sprawdzenie: zsumuj trzy wartości i zostaw miejsce na błąd oszacowania.
- Ścieżka: potwierdź, że wybrany punkt końcowy lub SDK obsługuje długość danych wyjściowych i zachowanie przy kontynuacji.
W przypadku przeglądu bazy kodu o rozmiarze 500 000 tokenów zespół może zarezerwować 40 000 tokenów na myślenie i obrać za cel odpowiedź o długości 25 000 tokenów. Ten plan zużywa na papierze 565 000 tokenów i pozostawia zapas na niedokładne szacunki lub dodatkowe instrukcje. Zespół powinien nadal zweryfikować rzeczywiste użycie i skonfigurowane limity generowania. Rezerwa to narzędzie planistyczne, a nie przewidywanie prywatnego rozumowania.
Przed uruchomieniem wsadowym pobierz próbki więcej niż jednego typu żądania. Krótka strona dokumentacji, moduł obfitujący w kod i PDF z tabelami mogą dawać różne liczby tokenów, nawet gdy ich rozmiary plików wyglądają podobnie. Zliczaj reprezentatywne dane wejściowe, a następnie porównuj szacunki z użyciem zwracanym przez API. Jeśli rzeczywiste raportowanie myślenia lub danych wyjściowych modelu różni się od twoich założeń, zaktualizuj rezerwę i limit przed zwiększeniem rozmiaru partii. Ten niewielki krok kalibracyjny pomaga utrzymać przepływ pracy z długim kontekstem w ramach budżetu tokenów.
Co zmieści się w milionie tokenów?
Dokumenty, kod i materiał multimodalny
Milion tokenów może sprawić, że analiza jednoprzebiegowa będzie realna dla zestawu podręczników, kilku umów, dużego drzewa źródeł lub długiego transkryptu z notatkami. Google używało przybliżonych ilustracji, takich jak około 1500 stron tekstu lub 30 000 linii kodu. Traktuj je jako przykłady skali, a nie gwarancje. Układ, gęstość kodu, język, formatowanie i tokenizacja wpływają na liczbę.
W przypadku pracy z repozytorium uwzględnij w szacunkach pliki kompilacji, wygenerowany kod, komentarze, metadane zależności, testy i istotny kontekst zgłoszeń. Następnie zapytaj, czy zadanie wymaga wszystkiego. Przegląd architektury między modułami może skorzystać z szerokiego zestawu źródeł; pytanie o jeden komunikat błędu prawdopodobnie nie.
Multimodalne dane wejściowe również komplikują szacunki. Czas trwania wideo, próbkowanie klatek, audio, rozdzielczość i sposób obsługi przez API mogą wpływać na użycie oraz materiał dowodowy widziany przez model. W przypadku wąskiego pytania uwzględnij tylko istotne multimedia i sprawdź użycie z reprezentatywnego żądania przed skalowaniem.
Liczba tokenów to nie liczba stron
Token to jednostka przetwarzania modelu, a nie słowo, znak, strona czy wiersz. Identyfikatory, tabele, kod źródłowy i tekst w językach innych niż angielski mogą tokenizować się inaczej niż zwykła proza. Oszacowanie liczby stron nie powie ci, czy twoja konkretna kolekcja się zmieści.
Pojemność to także coś innego niż jakość. Zmieszczenie zestawu źródeł nie dowodzi, że model znajdzie każdy ukryty wyjątek, zachowa każdą zależność lub poprawnie rozstrzygnie sprzeczne fragmenty. Specyfikacja ustanawia limit, a nie wyczerpujące przywołanie czy ocenę dokładności dla konkretnego zadania. W przypadku wniosków o istotnych konsekwencjach poproś o lokalizacje źródeł i zweryfikuj ważne twierdzenia na podstawie oryginałów.
Kiedy okno 1 mln pomaga, a kiedy nie
Długi kontekst jest najbardziej przydatny, gdy odpowiedź zależy od relacji rozproszonych w materiale, którego proste zapytanie może nie wyszukać. Jest mniej przekonujący w przypadku powtarzanych wąskich pytań w zmieniającym się korpusie, gdzie wyszukiwanie może wybrać mniejszy zestaw dowodów. To kompromisy w przepływie pracy, a nie uniwersalny ranking dokładności.
| Podejście | Rozważ je, gdy | Kompromis |
|---|---|---|
| Żądanie z długim kontekstem | Jednorazowa analiza wymaga relacji w znanym zestawie źródeł | Duże dane wejściowe mogą zwiększyć koszt i opóźnienie; zweryfikuj pokrycie |
| Wyszukiwanie | Użytkownicy zadają powtarzane pytania w zmieniającym się korpusie | Indeksowanie i wyszukiwanie decydują, które dowody trafiają do modelu |
| Dzielenie na fragmenty | Dokumenty można przetwarzać jako niezależne jednostki lub etapy | Relacje między fragmentami wymagają uzgodnienia |
| Hybrydowe | Potrzebujesz szerokiej orientacji, a następnie skupionych kontroli dowodów | Więcej orkiestracji i obsługi stanu |
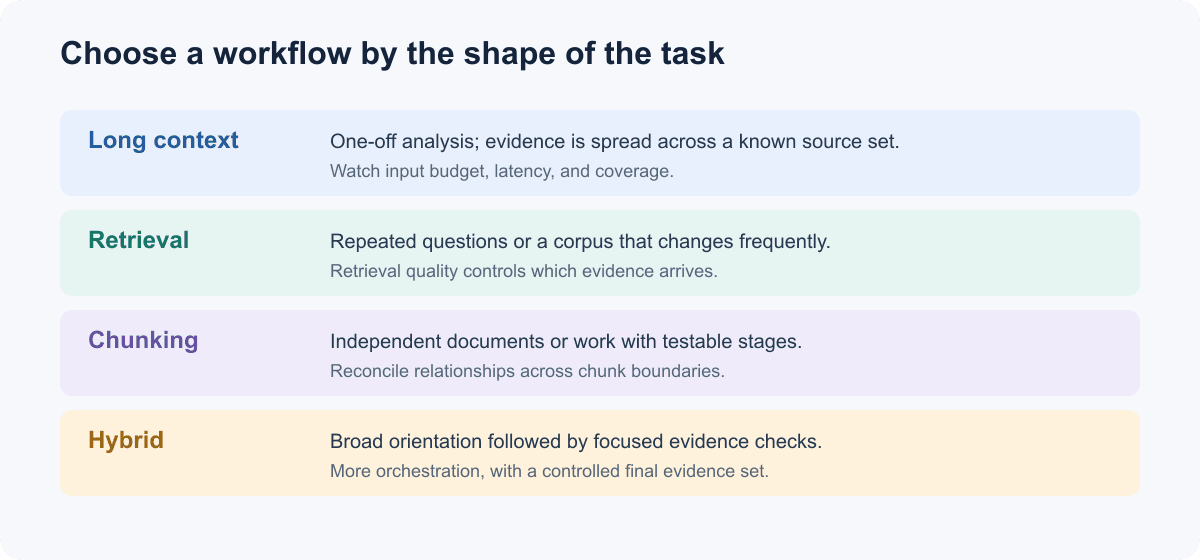 Wybierz na podstawie kształtu zadania i wzorca zapytań, a następnie zweryfikuj na reprezentatywnych danych wejściowych.
Rozważ długi kontekst do porównywania polityk, których klauzule wzajemnie na siebie wpływają, przeglądania zmiany w wielu modułach oprogramowania lub syntezy dokumentów, w których szczegół w jednym źródle zmienia interpretację innego. Wyszukiwanie pasuje do powtarzanych pytań do pomocy technicznej w rosnącej bazie wiedzy. Dzielenie na fragmenty działa, gdy jednostki źródłowe są niezależne lub każdy etap ma testowalny wynik. Hybrydowy przepływ pracy może najpierw zmapować kolekcję, a następnie wyszukać i zweryfikować fragmenty do finalnej odpowiedzi.
Oceniaj opcje na tych samych reprezentatywnych pytaniach. Śledź, czy uwzględniono wymagane dowody, czy cytaty wskazują właściwe fragmenty, użycie tokenów, czas odpowiedzi i wysiłek związany z odzyskiwaniem po niekompletnej odpowiedzi. Daje to zespołowi dowody dla jego obciążenia zamiast zakładania, że większe okno automatycznie je poprawia.
Korzystanie z Gemini 4 Argon do zadań z długim kontekstem
Potwierdź identyfikator modelu i ścieżkę żądania
Google podaje identyfikator modelu Gemini API jako `gemini-4-argon`. Potwierdź, że jest włączony dla twojego konta i że dokładny interfejs API obsługuje potrzebne funkcje. Ta sama nazwa modelu nie gwarantuje, że każdy serwer proxy, SDK, konsola lub klient udostępnia identyczne limity albo zachowanie długiego dekodowania.
Przed wdrożeniem produkcyjnym zweryfikuj:
- Identyfikator modelu i dostępność dla twojego konta lub regionu.
- Limit synchronicznych danych wyjściowych oraz sposób żądania lub zwracania długiego dekodowania.
- Czy SDK obsługuje kontynuację i jak raportuje częściowe lub nieudane odpowiedzi.
- Obsługiwane ustawienia myślenia, narzędzia, buforowanie i modalności dla wybranego API.
- Rzeczywiste pola użycia danych wejściowych i wyjściowych w żądaniu.
Przewodnik Google po długim kontekście opisuje ujednolicony budżet. Jego wytyczne dotyczące SDK i API mogą się zmieniać, więc przypnij obsługiwaną wersję SDK, sprawdź aktualny przykład i przetestuj integracyjnie ten sam transport oraz obsługę odpowiedzi planowane dla środowiska produkcyjnego. Nie kopiuj nazw parametrów ze starszej integracji modelu bez sprawdzenia, czy nadal mają zastosowanie.
Uczyń kontrakt danych wyjściowych mniejszym niż zestaw źródeł
Nadaj modelowi ograniczone zadanie i kształt odpowiedzi. W przypadku audytu repozytorium poproś o ustalenia pogrupowane według wagi, ze ścieżkami plików i odwołaniami do wierszy, i określ, czy uwzględnić hipotezy, czy tylko potwierdzone defekty. W przypadku porównania umów nazwij klauzule i poproś o identyfikatory sekcji lub krótkie fragmenty uzasadniające. To łatwiej przejrzeć niż „przeanalizuj wszystko”. W przypadku dużych odpowiedzi zaplanuj kontynuację i częściowe ukończenie. Utrwal identyfikatory i fragmenty odpowiedzi, gdy SDK je udostępnia, zweryfikuj dane wyjściowe strukturalne przed dalszym użyciem i ponów próbę tylko dla nieudanej części, gdy to możliwe. To zabezpieczenia, które należy wdrożyć i zweryfikować, a nie twierdzenie, że każde SDK obsługuje przerwy identycznie.
Ceny i dostęp: co zweryfikować przed uruchomieniem
Ogłoszenie Google obecnie podaje stawki wprowadzające w wysokości 2 USD za milion tokenów wejściowych i 10 USD za milion tokenów wyjściowych do 30 listopada 2026 r., a następnie podane stawki 4 USD i 20 USD za milion. To informacja wrażliwa czasowo: ponownie sprawdź oficjalne ogłoszenie Gemini 4 Argon przed publikacją lub prognozowaniem wydatków. Szacuj dane wejściowe i wyjściowe osobno, ponieważ obciążenia z dużą liczbą monitów i z dużą generacją mają różne profile kosztów.
Dostępność Argon przez Atlas Cloud nie została potwierdzona na stronach katalogu sprawdzonych na potrzeby tego artykułu. Katalog modeli Atlas Gemini pokazuje modele Gemini i szczegóły dostępu obecnie tam wymienione; nie potwierdza to, że Argon jest dostępny. Potwierdź stronę szczegółów, protokół i cenę dla konkretnego modelu przed kierowaniem żądań lub porównywaniem kosztów.
Zacznij od reprezentatywnego żądania i zapisz wersje modelu i SDK, użycie tokenów, opóźnienie, błędy oraz kontrole jakości specyficzne dla zadania. Wróć do budżetu i wyboru wyszukiwania, gdy zestawy źródeł lub wzorce zapytań się zmienią. Okno kontekstowe 1 mln tokenów Gemini 4 Argon jest przydatne, gdy jego szerokość rozwiązuje rzeczywisty problem między źródłami, a żądanie ma jasny budżet i plan weryfikacji.
Często zadawane pytania
Czy okno 1 mln Gemini 4 Argon jest współdzielone przez dane wejściowe i wyjściowe?
Tak. Google definiuje jedno okno 1 048 576 tokenów współdzielone przez dane wejściowe, myślenie i dane wyjściowe. Ilość pozostająca na odpowiedź zależy od żądania i obowiązujących limitów interfejsu.
Jaki jest domyślny limit danych wyjściowych Gemini 4 Argon?
Specyfikacja podaje 65 536 tokenów dla domyślnych synchronicznych danych wyjściowych. Długie dekodowanie może obsługiwać większe generowanie, z zastrzeżeniem pozostałej współdzielonej pojemności i ścieżki API.
Czy Gemini 4 Argon może wygenerować 1 mln tokenów w jednej odpowiedzi?
Strona modelu podaje długie dekodowanie do 1 048 576 tokenów wyjściowych, ale jest to maksymalna możliwość, a nie gwarancja, że żądanie zawierające dane wejściowe zwróci także milion tokenów. Dane wejściowe i myślenie zajmują to samo całkowite okno.
Czy okno kontekstowe 1 mln oznacza, że każdy szczegół zostanie dokładnie przywołany?
Nie. Opisuje maksymalny budżet tokenów, a nie doskonałe wyszukiwanie lub rozumowanie. Wymagaj odwołań do dowodów i testuj znane przypadki brzegowe z własnego materiału.
Czy Gemini 4 Argon jest obecnie dostępny przez Atlas Cloud?
Nie udało mi się potwierdzić pozycji modelu Argon ani strony szczegółów w katalogu Atlas Cloud sprawdzonym na potrzeby tego artykułu. Sprawdź aktualny katalog przed założeniem obsługi; powyższy link do katalogu Gemini sam nie potwierdza dostępności Argon.


