

Przesłany materiał wideo może zawierać potrzebną odpowiedź, a mimo to zostać błędnie odczytany. Gemini 4 Argon może przyjmować tekst, obrazy, wideo, audio i pliki PDF jako dane wejściowe, a następnie zwracać tekst, który analizuje lub łączy szczegóły między nimi. Możliwości multimodalne Gemini 4 Argon są najbardziej przydatne, gdy Twoim zadaniem jest analiza istniejącego materiału, a nie tworzenie nowych mediów. Jego ujednolicony limit kontekstu wynosi 1 048 576 tokenów, ale jest to limit pojemności, a nie gwarancja dokładności. Poniżej znajduje się przewodnik zadanie po zadaniu: co potrafi analizować, jak weryfikować odpowiedź i gdzie obecnie mieszczą się API oraz Atlas Cloud.
Najważniejsze wnioski
- Argon przyjmuje tekst, obrazy, wideo, audio i pliki PDF jako dane wejściowe; jego udokumentowane wyjście to tekst.
- Kontekst 1 048 576 tokenów jest współdzielony przez dane wejściowe i wyjściowe. Domyślne wyjście synchroniczne jest ograniczone do 65 536 tokenów.
- Generowanie obrazów, generowanie audio i Live API nie są obsługiwane przez model Argon.
- Weryfikuj twierdzenia na podstawie numerów stron, znaczników czasu lub widocznych dowodów, zanim użyjesz ich w przepływie pracy.
Co oznacza „multimodalny” w przypadku Gemini 4 Argon
W przypadku Gemini API multimodalność oznacza, że Argon może otrzymywać w żądaniu różne rodzaje materiału źródłowego i wnioskować na jego podstawie wraz z instrukcjami tekstowymi. Aktualna strona modelu Gemini API wymienia tekst, obrazy, wideo, audio i pliki PDF jako dane wejściowe, a tekst jako dane wyjściowe. Wymienia też ustrukturyzowane dane wyjściowe, wywoływanie funkcji, wykonywanie kodu, wyszukiwanie plików i grounding w wyszukiwaniu wśród obsługiwanych możliwości. Te narzędzia mogą kształtować przepływ pracy, ale nie zmieniają modalności wyjściowej na obraz, ścieżkę audio lub strumień rozmowy na żywo. (Google AI for Developers, październik 2026)
Liczby dotyczące tokenów wymagają uważnej interpretacji. Google podaje ujednolicone okno kontekstowe o rozmiarze 1 048 576 tokenów dla połączonych danych wejściowych i wyjściowych. Zwykłe żądanie synchroniczne ma maksymalne wyjście 65 536 tokenów; długie dekodowanie może osiągnąć do 1 048 576 w ramach udokumentowanego przepływu kontynuacji w tle. Jeśli prompt i załączona treść zajmują większość współdzielonego okna, pozostaje mniej miejsca na wnioskowanie i tekst odpowiedzi. Nagłówek „kontekst 1M” nie oznacza, że każde żądanie o rozmiarze miliona tokenów zmieści się w jednej zwykłej odpowiedzi.
| Materiał, który dostarczasz | Udokumentowane dane wejściowe? | Wynik Argon | Przydatne pierwsze zadanie | Dowody do sprawdzenia |
|---|---|---|---|---|
| Tekst i PDF | Tak | Tekst | Podsumuj raport lub porównaj twierdzenia między sekcjami | Strona, nagłówek, wiersz tabeli lub cytowany fragment |
| Obraz | Tak | Tekst | Odczytaj wykres, zidentyfikuj obiekty lub porównaj dwa obrazy | Etykiety, wartości, lokalizacje i kadr obrazu |
| Wideo | Tak | Tekst | Opisz kolejność zdarzeń lub znajdź moment w klipie | Znacznik czasu i rzeczywista klatka |
| Audio | Tak | Tekst | Odpowiedz na pytania dotyczące przesłanego nagrania | Segment audio, transkrypcja, mówca lub dźwięk |
| Generowane media | Brak wymienionego generowania obrazów/audio | Tekst | Zwróć pisemną analizę lub wynik strukturalny | Schemat i potwierdzenie w źródle |
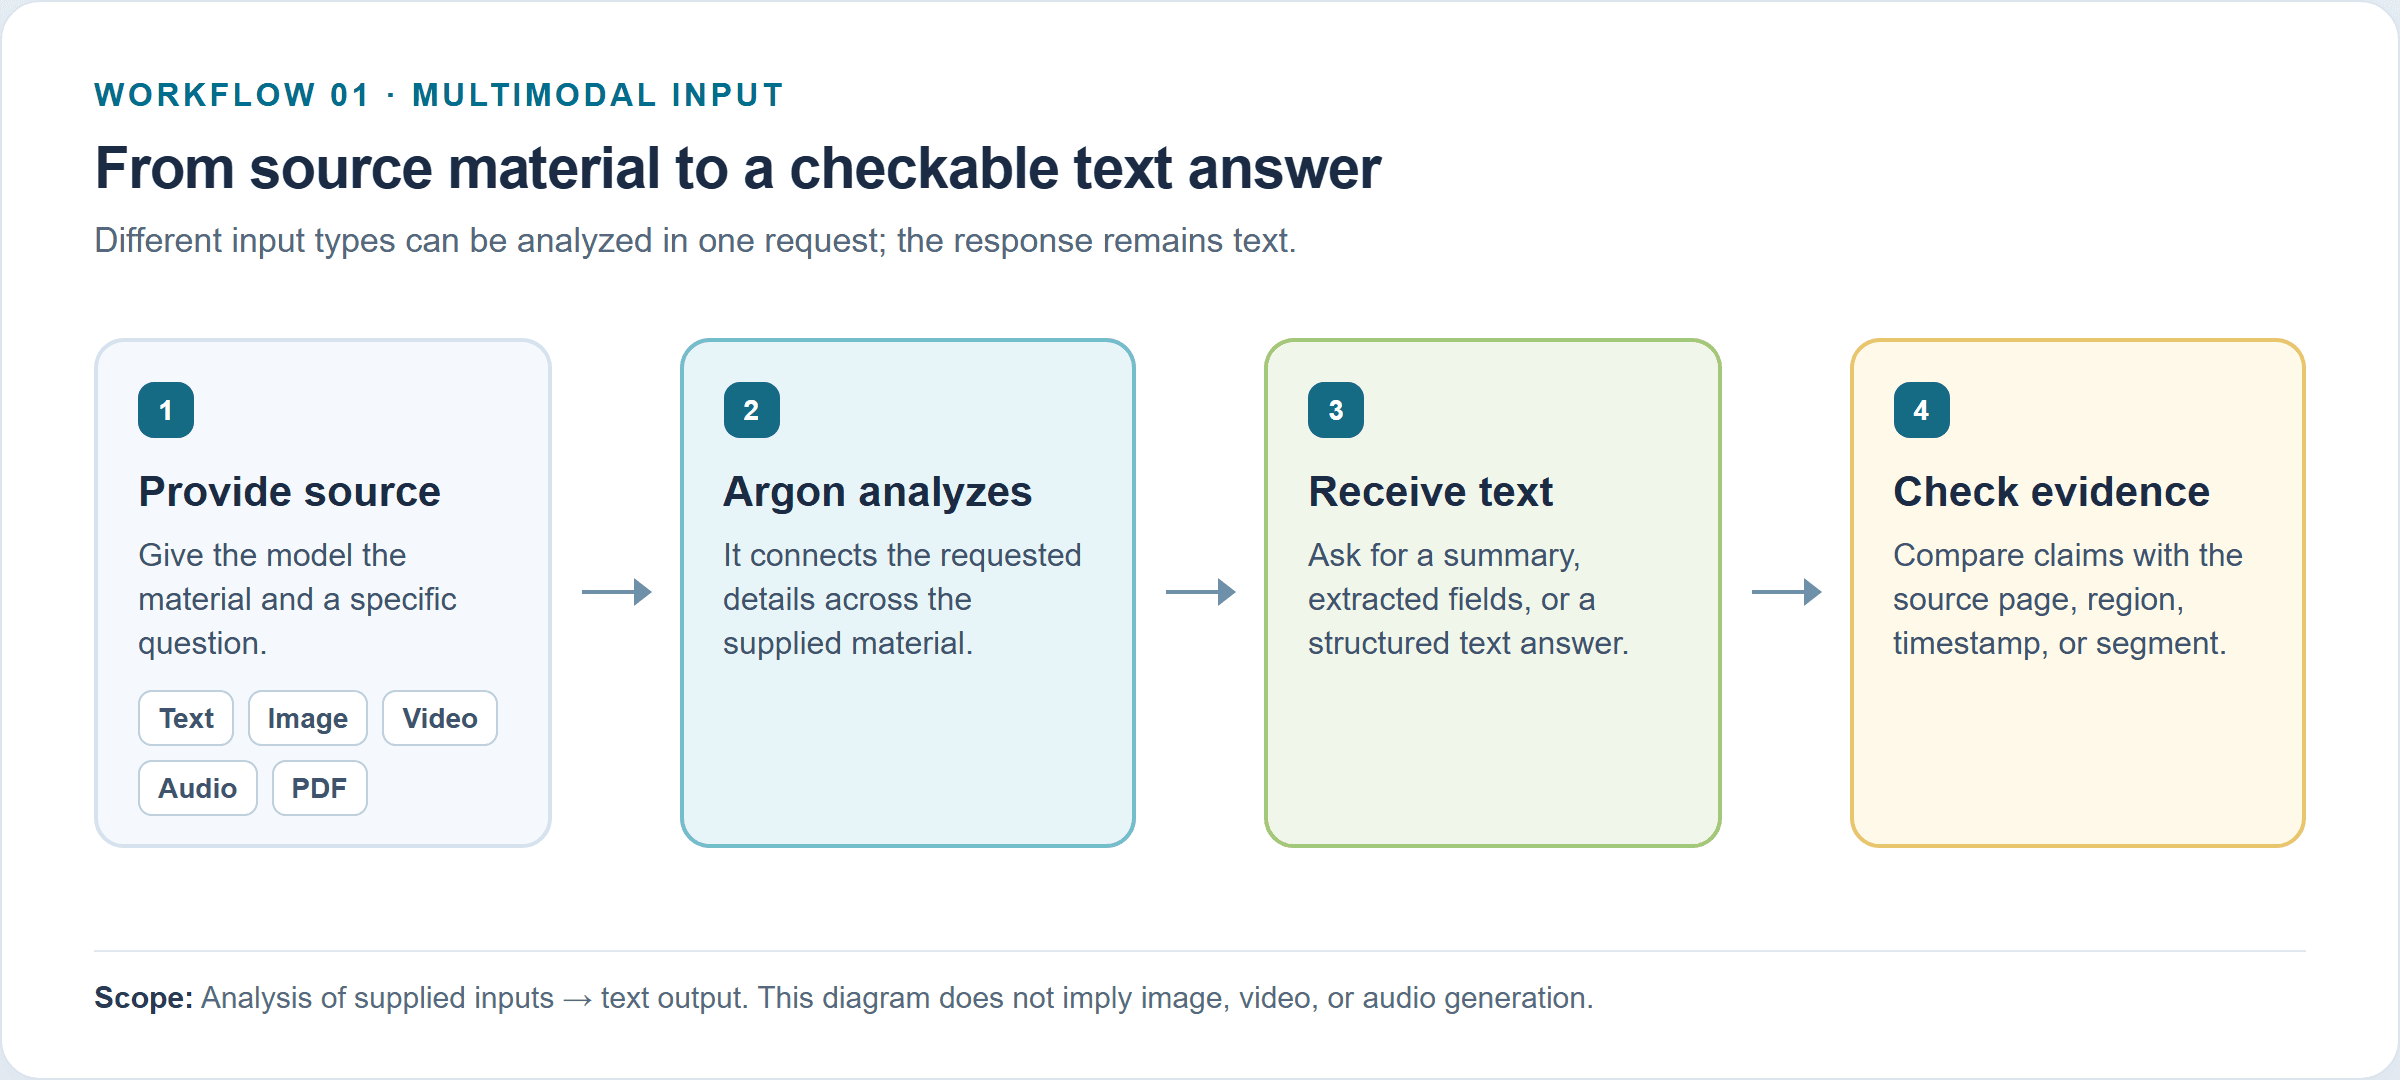 Ilustracja przepływu pracy: dostarczony tekst, obraz, wideo, audio lub PDF jest analizowany do odpowiedzi tekstowej, a następnie sprawdzany na podstawie dowodów źródłowych.
Aplikacja Gemini może oferować funkcje, które komponują lub tworzą media za pomocą innych modeli i narzędzi. Nie zakładaj, że te funkcje na poziomie aplikacji są możliwościami samego modelu API gemini-4-argon. Przy podejmowaniu decyzji implementacyjnej korzystaj z tabeli możliwości API i dokładnego identyfikatora modelu, a nie z etykiety rodziny produktów.
Co Gemini 4 Argon potrafi analizować w obrazach, wideo, audio i plikach PDF
Najlepszym sposobem ustalenia, czy Argon się nadaje, jest nazwanie dowodów potrzebnych w Twoim zadaniu. „Zrozumieć wideo” jest zbyt ogólne. „Znajdź każdy moment, w którym operator umieszcza część w tacce, i podaj znacznik czasu” da się przetestować.
Obrazy: analizowanie, porównywanie i wydobywanie informacji wizualnych
Żądanie dotyczące obrazu może poprosić Argon o opis sceny, porównanie dwóch dostarczonych obrazów, wyodrębnienie widocznego tekstu, interpretację wykresu lub zwrócenie ustaleń wizualnych w formacie strukturalnym. To zadania analityczne: wynikiem jest tekst lub tekst strukturalny. Mogą pomóc zespołowi wsparcia w klasyfikacji zdjęć produktów, badaczowi w przeglądaniu rycin lub operatorowi w wyodrębnianiu etykiet ze zbioru obrazów.
Niezależne testy dają przydatny punkt odniesienia, pod warunkiem że potraktujesz je jako jeden układ benchmarku, a nie prognozę dla własnych obrazów. Raport Vision Evals firmy Roboflow z października 2026 r. umieszcza Argon wśród najlepszych modeli w testowanych zadaniach wykrywania obiektów, OCR i rozumowania wizualnego. W swojej ocenie OCR oddziela dokładną transkrypcję i powiązane podzadania, a w artykule wskazuje słabe punkty, takie jak mały lub rozmyty tekst i trudniejsze odczyty wizualne. Jego konfiguracja, wybrane obrazy, prompty i punktacja określają te wyniki; nie ustalają ogólnego wskaźnika sukcesu dla każdego skanu lub wykresu. (Roboflow, październik 2026)
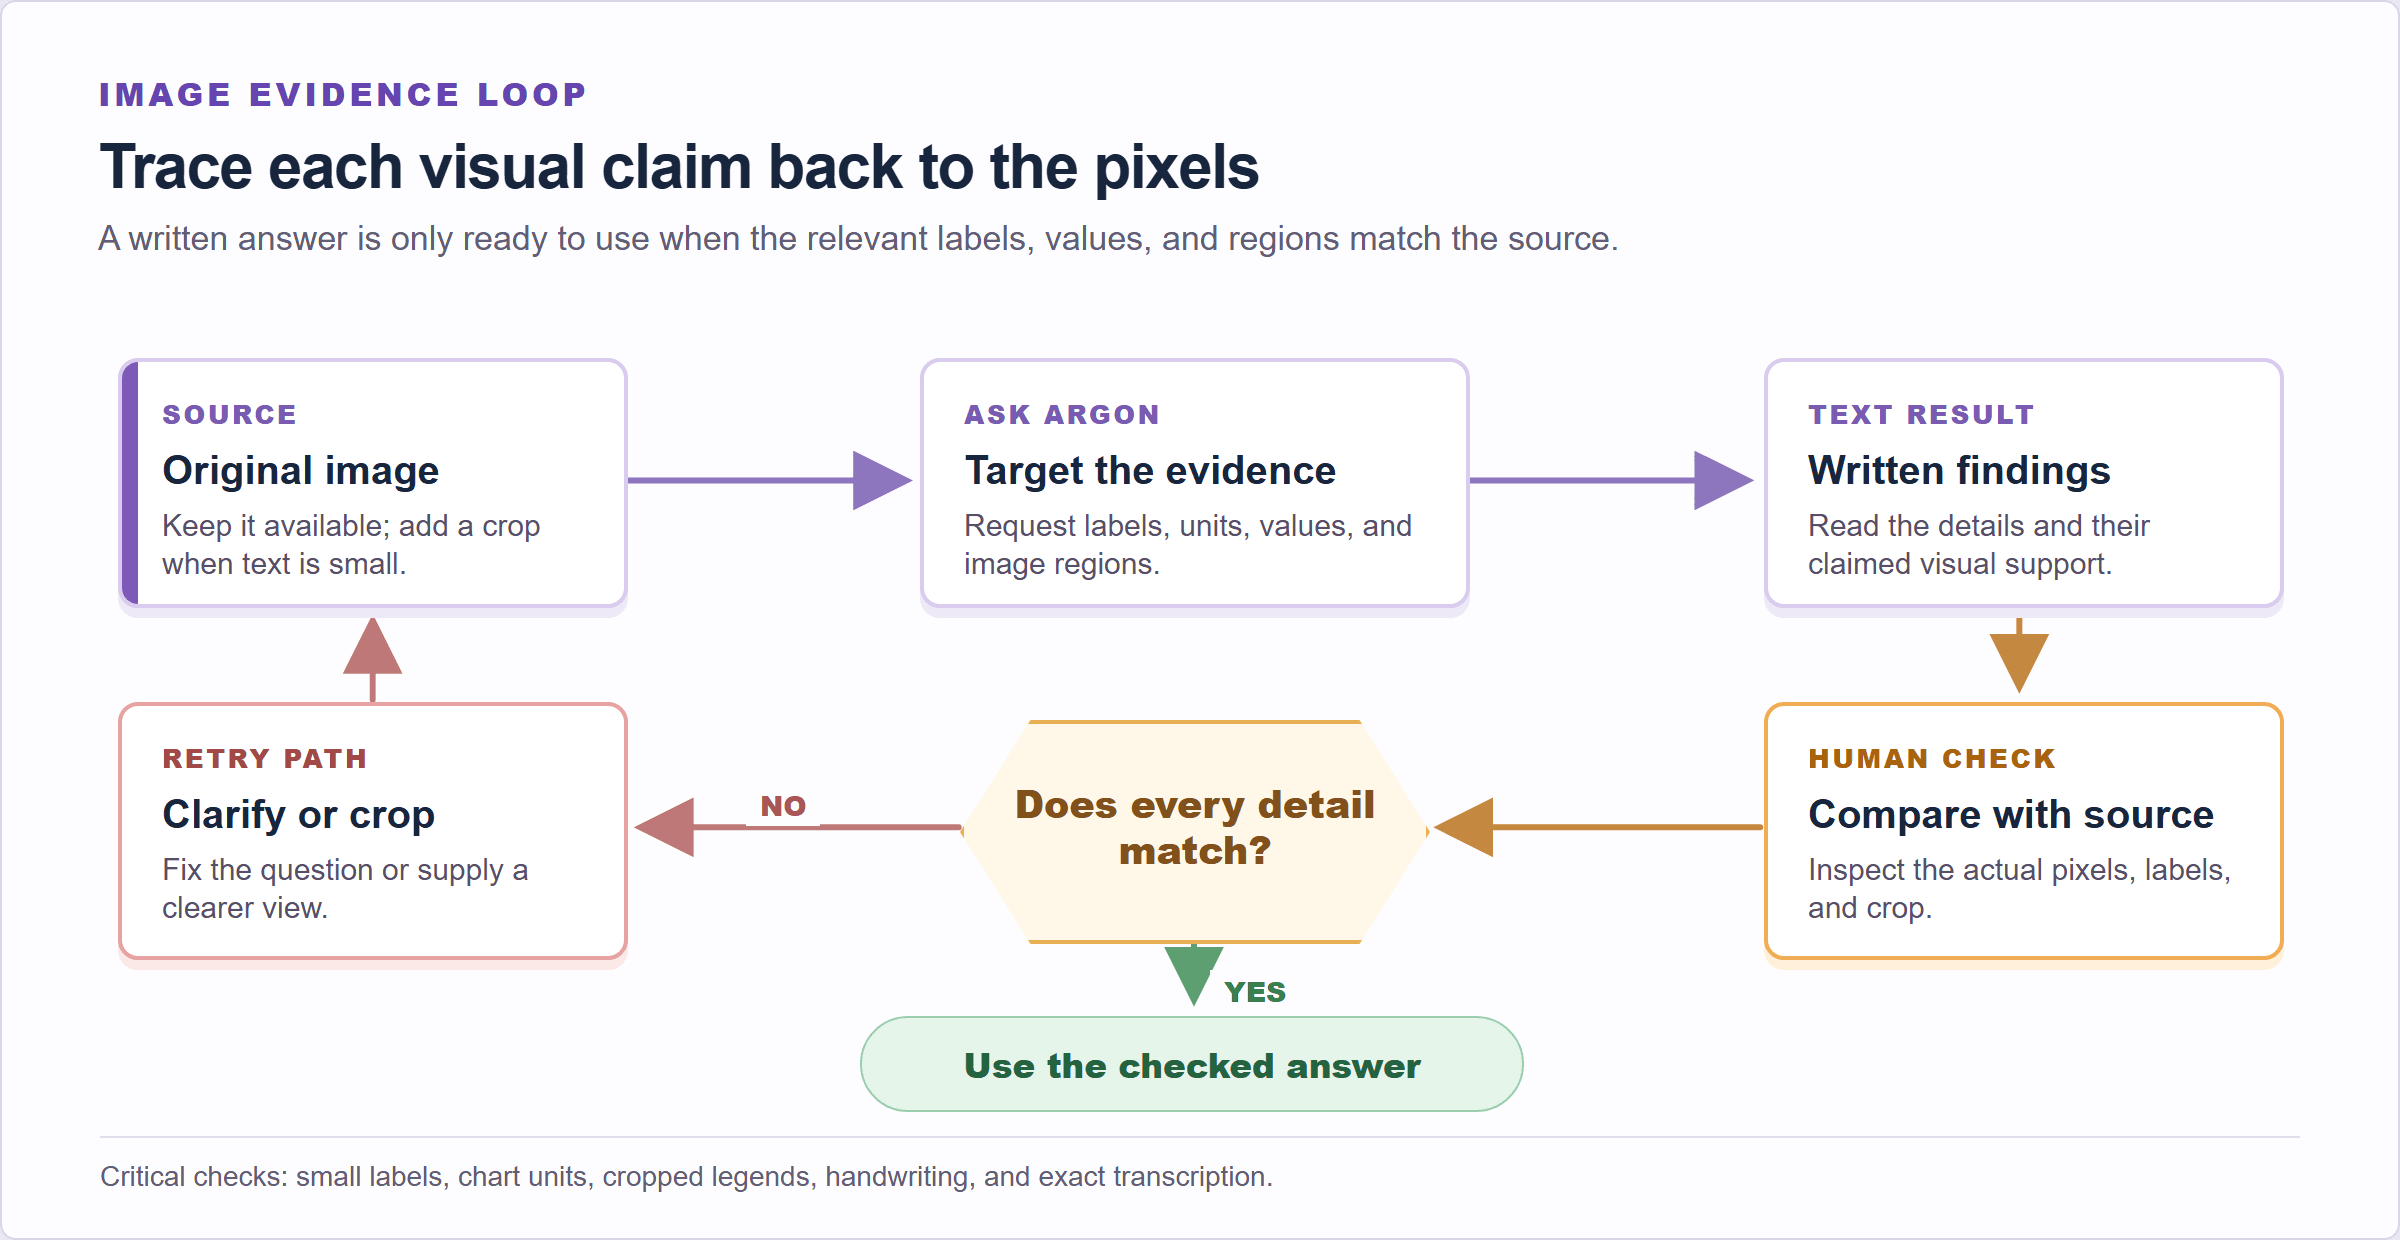 Ilustracja przepływu pracy: poproś o szczegóły obrazu i obszary je potwierdzające, a następnie zweryfikuj każde twierdzenie na podstawie oryginalnego obrazu.
W przypadku wykresu poproś o tytuł, osie, jednostki, istotne wartości oraz obszar obrazu potwierdzający każdą wartość. Następnie porównaj te szczegóły ze źródłem. Małe etykiety, zrzuty ekranu o niskiej rozdzielczości, pismo odręczne, nakładające się oznaczenia lub przycięta legenda wymagają ręcznego przeglądu. Jeśli dokładna transkrypcja ma znaczenie, dołącz wyraźny przycięty fragment i zachowaj oryginał, aby recenzent mógł sprawdzić każdy znak.
Wideo: wnioskowanie o zdarzeniach w czasie
Wideo dodaje kolejność i czas. Argon może odpowiadać na pytania o działania, zmiany i zdarzenia w kolejnych klatkach. API obsługuje agentowe rozumienie wideo, opcję, która może dynamicznie analizować os czasu; jego udokumentowany tryb domyślny jest statyczny. Sprawdź przewodnik po wideo i ustawienia żądań, aby poznać tryb, którego faktycznie używa Twoja integracja.
Przydatne pytanie produkcyjne może brzmieć: „O której technik usuwa filtr i co dzieje się bezpośrednio przed i po?” Wymagaj znaczników czasu, a następnie sprawdź te momenty. Płynny opis bez dowodów dopasowanych czasowo nie wystarcza do przeglądu incydentów, kontroli jakości ani danych treningowych.
Zespół robotyki Google opisuje przepływ pracy Argon, który analizuje 136-sekundowe nagranie z góry przedstawiające dwuramiennego robota składającego papier w origami lisa. System tworzy hierarchię adnotacji dopasowanych czasowo, od ogólnego zadania po podzadania i działania na poziomie kontaktu, z etykietami kontroli jakości wokół ponownych prób. To konkretny przykład wyniku analizy wideo będącego etykietami i strukturą powiązaną z nagraniem. Artykuł jest przykładem badawczym, a nie gwarancją, że zwykłe wywołanie API odtworzy pipeline robotyczny. (Google Developers Blog, październik 2026)
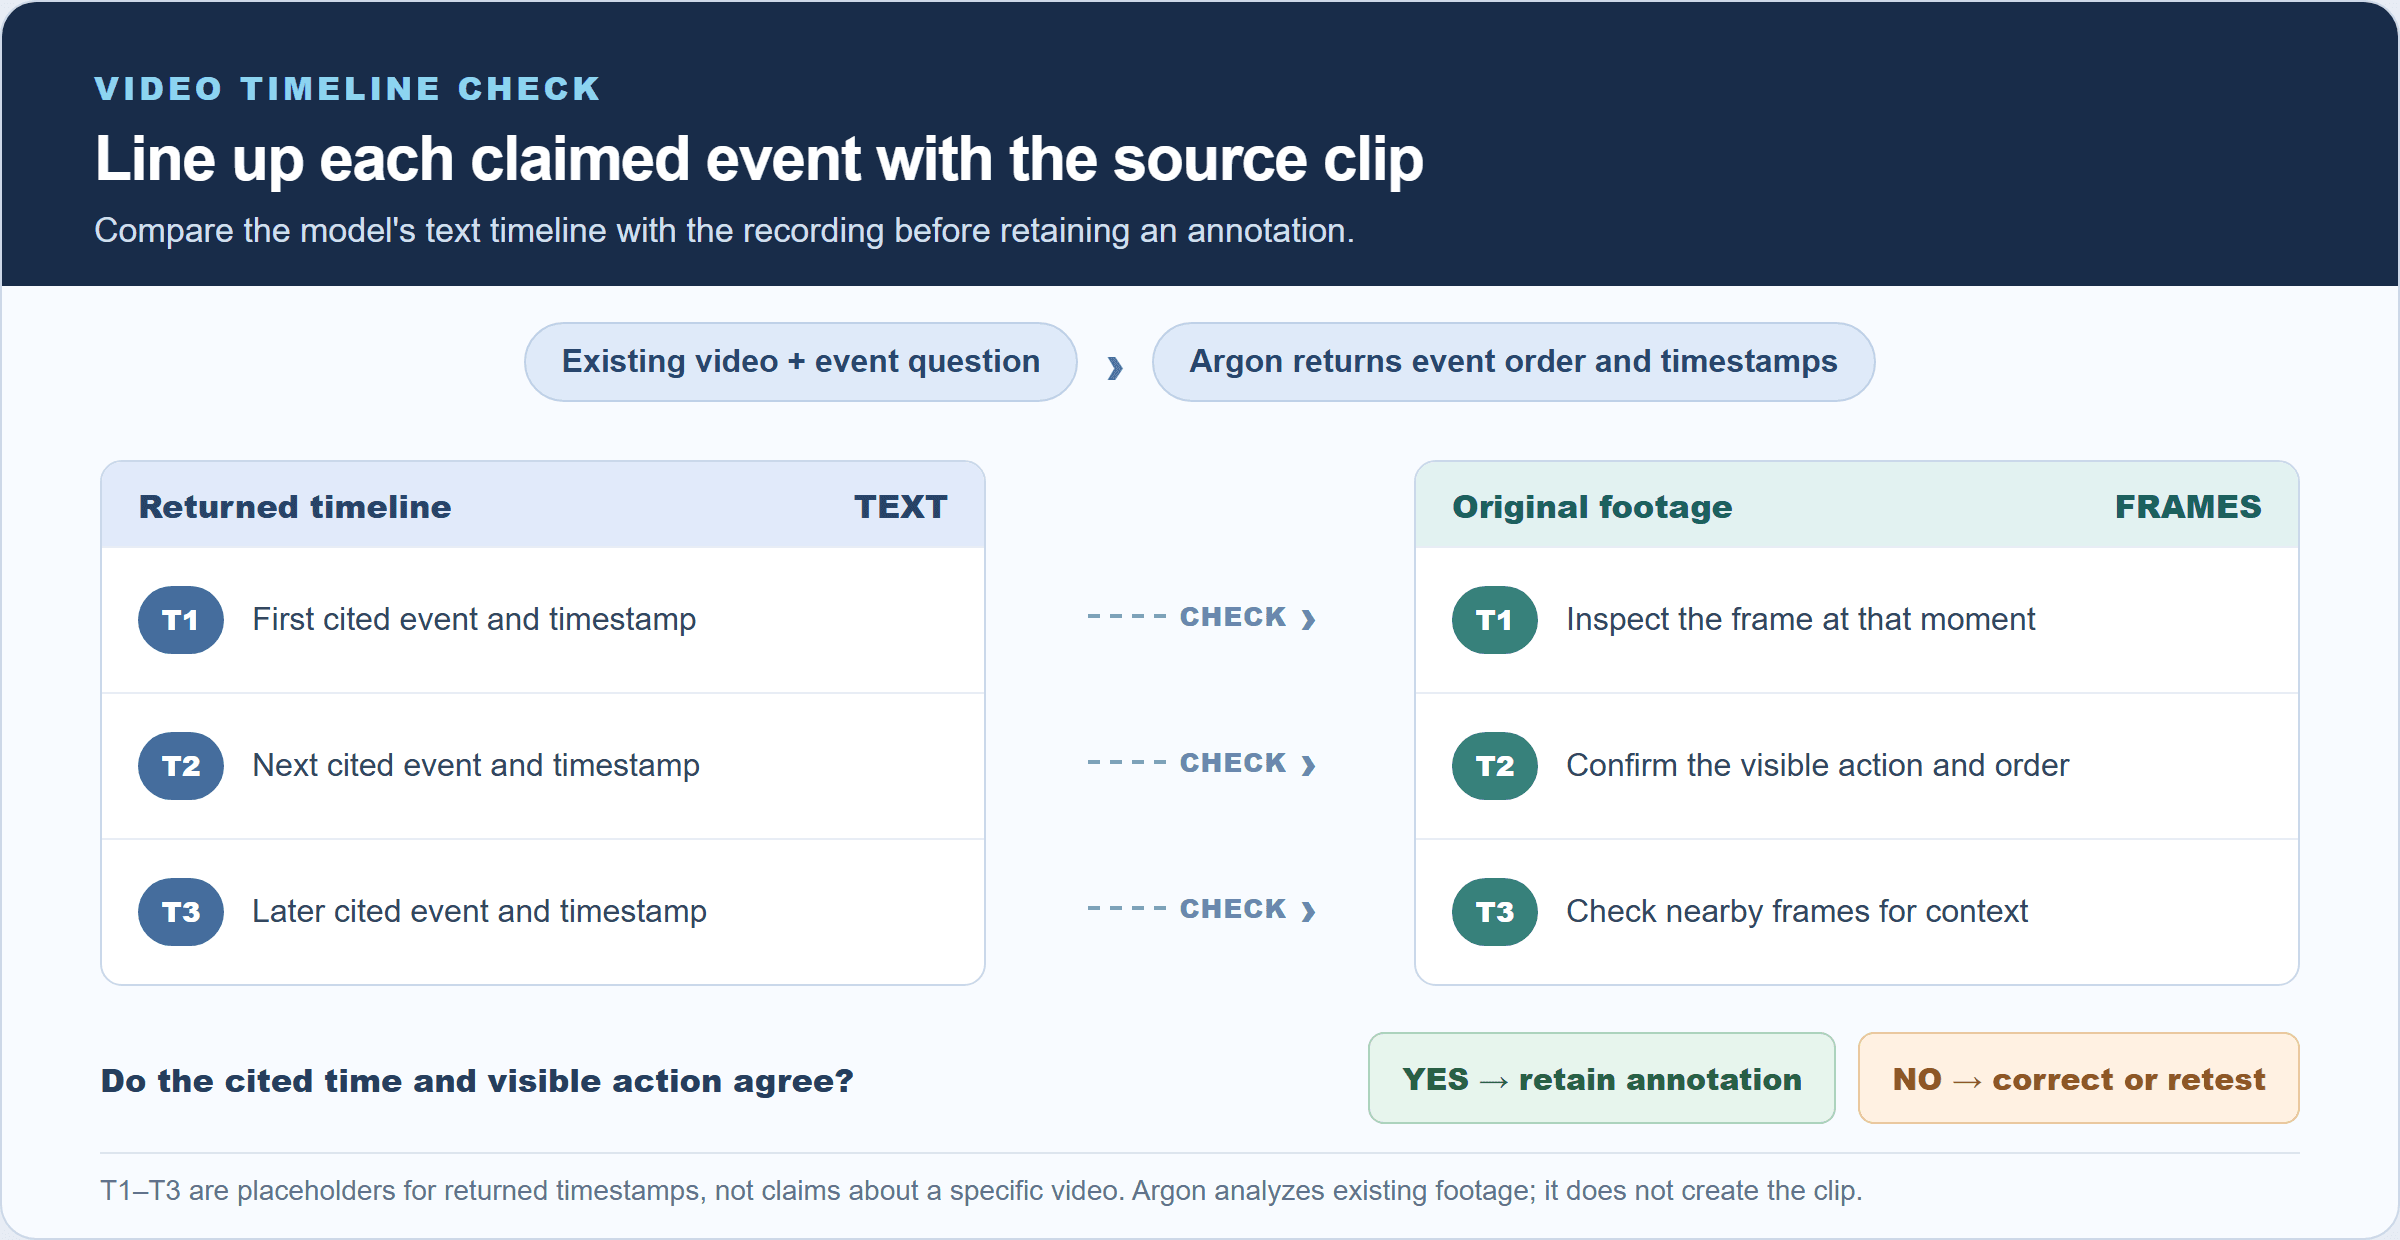 Ilustracja przepływu pracy: poproś o kolejność zdarzeń i znaczniki czasu, a następnie zweryfikuj każdy wskazany moment na podstawie oryginalnego nagrania.
Ruch łatwo błędnie odczytać, gdy kamera się porusza, ręce zasłaniają obiekt lub dwie czynności następują blisko siebie. Wyrywkowo sprawdź zwrócone znaczniki czasu na podstawie oryginalnego nagrania. Jeśli odpowiedź wpływa na bezpieczeństwo lub decyzję zaliczenia/niezaliczenia, zleć osobie lub dedykowanemu systemowi wizyjnemu weryfikację krytycznych klatek.
Audio: analiza dostarczonych nagrań
Dane wejściowe audio pozwalają zadawać pytania oparte na nagraniu, takie jak: co powiedziano, który dźwięk wystąpił pierwszy lub czy pojawia się określone wyrażenie. Przed projektowaniem integracji sprawdź aktualną dokumentację wejścia audio pod kątem obsługiwanych formatów, ograniczeń czasu trwania i próbkowania oraz dokładnej struktury żądania. Samo „obsługiwane wejście audio” nie określa każdego zachowania transkrypcji ani nie gwarantuje, że załącznik rzeczywiście przeszedł przez Twój klient.
Zbuduj niewielki zestaw testowy ze znanymi odpowiedziami na podstawie nagrań, które masz prawo przetwarzać. Uwzględnij czystą mowę, nakładających się mówców, szum tła, ciszę i dźwięki inne niż mowa, jeśli występują w środowisku produkcyjnym. Poproś o znaczniki czasu lub krótki cytat dowodowy, jeśli interfejs to obsługuje. Zweryfikuj, że załącznik dotarł do modelu, a następnie porównaj wynik z nagraniem. Pozwala to wychwycić zarówno błędy modelu, jak i błędy integracji, takie jak pominięte części pliku lub nieobsługiwane kodowanie.
Pliki PDF i dokumenty mieszane: łączenie szczegółów między źródłami
Obsługa PDF jest cenna, gdy pytanie obejmuje prozę, tabele i ryciny. Recenzent może zapytać, czy streszczenie raportu jest zgodne z tabelą w dalszej części dokumentu, albo wyodrębnić twierdzenie i potwierdzającą je rycinę. W celu porównania można dostarczyć wiele dokumentów, z zastrzeżeniem limitów tokenów i plików w żądaniu.
Przy każdym twierdzeniu poproś o lokalizację źródła. Odwołania do stron są przydatne, ale zweryfikuj je, ponieważ numeracja stron PDF może różnić się od nadrukowanej etykiety strony. W przypadku tabeli poproś o etykietę wiersza i nagłówek kolumny oraz wartość. W przypadku diagramu poproś model o nazwanie użytego elementu wizualnego. Jeśli PDF jest zeskanowany, obrócony, wyblakły lub gęsto złożony, przetestuj reprezentatywne strony, zamiast zakładać, że wszystkie strony zostały przeanalizowane równie dobrze.
Zwięzły schemat wyjściowy może ułatwić przegląd: twierdzenie, lokalizacja źródła, fragment potwierdzający lub szczegół wizualny oraz pewność albo „nie znaleziono”. Ustrukturyzowane dane wyjściowe mogą wymusić kształt, ale prawidłowy obiekt JSON nadal może zawierać błędny odczyt. Walidacja formatu i walidacja faktów to oddzielne kontrole.
Jak testować rozumienie multimodalne Gemini 4 Argon
Przed podłączeniem modelu do dużego wsadu przeprowadź krótką ocenę. Wybierz źródło, w którym człowiek może ustalić poprawną odpowiedź, i zdefiniuj, co uznaje się za poprawny wynik. Chodzi o przetestowanie całej ścieżki od wyboru pliku po odpowiedź modelu, a nie tylko sprawdzenie, czy odpowiedź brzmi wiarygodnie.
- Wybierz jeden publiczny raport z wykresem lub krótkie wideo z wyraźnie identyfikowalnymi zdarzeniami. Zachowaj klucz odpowiedzi sprawdzony przez człowieka.
- Poproś model, aby korzystał wyłącznie z załączonego materiału i do każdego twierdzenia dołączył lokalizację.
- Porównaj każde twierdzenie ze źródłem. Zapisz pominięcia, błędne odczyty, nieuzasadnione wnioski i lokalizacje, które nie prowadzą do dowodów.
- Powtórz z kilkoma przykładami przypominającymi Twoje rzeczywiste pliki, w tym z trudnymi przypadkami.
- Ustal próg zaliczenia na podstawie kosztu błędu. Kieruj niepewne lub o dużym wpływie wyniki do przeglądu przez człowieka.
Możesz dostosować ten prompt:
Analizuj wyłącznie załączony materiał. Odpowiedz na poniższe pytania w tabeli. Dla każdego twierdzenia podaj numer strony, znacznik czasu lub widoczny dowód, który je potwierdza. Jeśli materiał nie zawiera odpowiedzi, napisz „nie znaleziono”. Nie wyciągaj wniosków o brakujących faktach.
W przypadku obrazu zastąp „numer strony, znacznik czasu” frazą „obszar obrazu i widoczna etykieta”. W przypadku PDF poproś o stronę oraz nazwę tabeli lub sekcji. W przypadku audio poproś o znacznik czasu oraz słowa lub dźwięk potwierdzający odpowiedź. Te drobne zmiany ułatwiają audyt wyniku.
Śledź błędy według typu, zamiast używać jednego ogólnego wskaźnika dokładności. Błędna cyfra na wykresie, pominięte zdarzenie i odwołanie do niewłaściwej strony mają różne konsekwencje. Ta rama oceny zamienia imponującą listę możliwości w powtarzalną decyzję o tym, czy model jest niezawodny dla Twoich plików.
Ograniczenia Gemini 4 Argon: czego nie oznacza obsługa multimodalna
Obsługa danych wejściowych nie oznacza odpowiadającej jej obsługi danych wyjściowych. API obecnie wymienia generowanie obrazów, generowanie audio i Live API jako nieobsługiwane przez Argon. Jeśli zadaniem jest tworzenie nowego obrazu, ścieżki dźwiękowej lub interakcji głosowej w czasie rzeczywistym, wybierz model lub narzędzie, które wyraźnie wymienia taki wynik. Nadal możesz użyć Argon do analizy promptu, materiału źródłowego lub wygenerowanego wyniku.
Okno miliona tokenów również nie gwarantuje pełnego przywołania. Jest współdzielone między żądaniem a odpowiedzią, a długie dane wejściowe mogą zwiększać opóźnienie i koszt. Model może przeoczyć szczegół, wywnioskować nieobecną informację lub zwrócić niepoprawny znacznik czasu, brzmiąc przy tym pewnie. Długie dekodowanie to ścieżka wykonywania API z dodatkowymi wymaganiami, a nie domyślne zachowanie każdego klienta.
Benchmarki są dowodami kierunkowymi. Roboflow podaje wyniki z określonych zestawów danych zadaniowych i ustawień oceny, a karta modelu Google podsumowuje szerszy zestaw wewnętrznych i publicznych ocen. Żadne z nich nie zastępuje testu wykorzystującego jakość Twojej kamery, układy dokumentów, słownictwo, języki i tolerancję błędów. Wysoki wynik w jednej kategorii nie może dowodzić niezawodnego działania w innym zadaniu.
Korzystaj z recenzenta, gdy odpowiedź wpływa na decyzję finansową, prawną, dotyczącą bezpieczeństwa, medyczną lub zatrudnieniową. Przechowuj oryginalne dane wejściowe i zwrócone dowody razem, aby człowiek mógł zaudytować wniosek. W przypadku powtarzalnych przepływów pracy rejestruj wersję modelu, prompt, istotne ustawienia, identyfikator źródła i wynik przeglądu. Taki zapis pomaga odróżnić zmianę modelu od problemu z plikiem lub integracją.
| Zadanie | Dobry pierwszy test | Sprawdź dokładnie |
|---|---|---|
| Odczyt wykresu | Poproś o oznaczone wartości z jednostkami osi | Małe czcionki, gęste legendy, przybliżone odczyty wizualne |
| OCR | Użyj czystego przyciętego fragmentu ze znaną transkrypcją | Rozmycie, pismo odręczne, obrót, mieszane pisma |
| Zdarzenia wideo | Poproś o działania ze znacznikami czasu w kolejności | Zasłonięcia, szybkie cięcia, wywnioskowane przyczyny |
| Pytania i odpowiedzi audio | Zadaj znane pytanie o krótkie nagranie | Szum, wielu mówców, obsługa załączników |
| Porównywanie PDF | Poproś o twierdzenie, stronę i fragment potwierdzający | Zeskanowane strony, niezgodna numeracja stron, wnioskowanie między stronami |
Dostęp, ceny i gdzie pasuje Atlas Cloud
Publiczny identyfikator modelu API to gemini-4-argon; Google obecnie wymienia Gemini API i AI Studio jako ścieżki dostępu. Aktualne ogłoszenie Google podaje stawkę wprowadzającą $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych do 30 listopada 2026 r., a następnie odpowiednio $4 i $20. Dane wejściowe z pamięci podręcznej mają osobne warunki, więc nie szacuj ich jak zwykłych danych wejściowych. (Google, październik 2026)
Aktualna lista All Models Atlas Cloud nie pokazywała Gemini 4 Argon w momencie sprawdzania do tego artykułu. Oznacza to, że nie ma tu zweryfikowanej strony modelu Atlas Argon ani ceny Atlas do zacytowania. Nie traktuj ogólnej listy platformy jako dowodu dostępności. Jeśli Twój zespół porównuje dostawców lub buduje szerszy przepływ pracy z modelami, Atlas Cloud może być miejscem do przeglądania innych wymienionych modeli, ale przed planowaniem w oparciu o dowolnego dostawcę potwierdź dokładną stronę modelu i obsługiwane operacje.
Sprawdzenie źródła wpływa też na rekomendację: użyj oficjalnej ścieżki Google, aby przetestować Argon już dziś, a Atlas Cloud traktuj jako osobną opcję odkrywania modeli, które są faktycznie wymienione. Nie ma tu twierdzenia, że Argon jest hostowany w Atlas Cloud.
Czy Gemini 4 Argon pasuje do Twojego zadania?
Umieść Argon na krótkiej liście, gdy zadanie wymaga wnioskowania na podstawie mieszanego materiału, wydobywania szczegółów wizualnych, śledzenia zdarzeń w wideo lub przeglądu długiego raportu. Jego duży współdzielony kontekst i wyjście tekstowe mogą pomóc skonsolidować dowody w tabelę lub wynik strukturalny. Następnym krokiem jest niewielka ocena możliwa do sprawdzenia przez człowieka, wykorzystująca Twoje własne reprezentatywne dane wejściowe.
Wybierz inny model lub narzędzie, gdy wymaganym rezultatem jest wygenerowany obraz, wygenerowane audio lub rozmowa audio/wideo na żywo. W przypadku OCR lub decyzji operacyjnych porównaj jego wyniki z dedykowaną alternatywą, jeśli dokładność, szybkość lub przewidywalny koszt mają większe znaczenie niż szerokie wnioskowanie.
Jeśli ocena przejdzie Twój próg dla konkretnego zadania, przeprowadź pilotaż z rejestrowaniem i przeglądem przez człowieka przed zwiększeniem wolumenu. Jeśli nie przejdzie, sklasyfikuj błędy i zdecyduj, czy właściwym rozwiązaniem są wyraźniejsze dane wejściowe, zmieniony prompt, inny model czy oddzielny system OCR/transkrypcji. Przydatne pytanie brzmi, czy możliwości multimodalne Gemini 4 Argon mieszczą się w Twoim budżecie błędów.
Często zadawane pytania
Czy Gemini 4 Argon potrafi analizować wideo i audio?
Tak. Jego API wymienia zarówno wideo, jak i audio jako obsługiwane dane wejściowe. Rozumienie wideo może zwracać opisy lub analizę ze znacznikami czasu; audio można dostarczyć na potrzeby pytań opartych na dźwięku. Sprawdź aktualną dokumentację formatów plików i żądań, a następnie zweryfikuj odpowiedź na podstawie oryginalnego medium.
Czy Gemini 4 Argon generuje obrazy lub audio?
Nie. Aktualna tabela możliwości API oznacza generowanie obrazów i generowanie audio jako nieobsługiwane przez ten model. Jego udokumentowaną modalnością wyjściową jest tekst, nawet gdy dane wejściowe zawierają obrazy, audio lub wideo.
Co oznacza okno kontekstowe 1 mln tokenów w Gemini 4 Argon?
Limit 1 048 576 tokenów jest współdzielony przez dane wejściowe i wyjściowe. Domyślne wyjście synchroniczne jest ograniczone do 65 536 tokenów. Google dokumentuje oddzielny przepływ długiego dekodowania dla większych wyjść, aż do współdzielonego limitu, z wykonywaniem w tle i krokami kontynuacji.
Ile kosztuje dostęp do API Gemini 4 Argon?
Na dzień 16 października 2026 r. Google podaje $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych do 30 listopada 2026 r. Podane późniejsze stawki to $4 i $20. Przed oszacowaniem projektu sprawdź aktualne ceny i warunki dotyczące tokenów z pamięci podręcznej.


