Scena z dwiema osobami staje się przekonująca, gdy widzisz i słyszysz, do kogo należy każda kwestia. Aby dialog wielu mówców w Gemini Omni 1.2 Flash był łatwy do śledzenia, nadaj każdej postaci stałą tożsamość wizualną i głosową, pisz krótkie kwestie w kolejności wypowiedzi i oceń gotowe wideo oczami oraz uszami. Aktualizacja Google z listopada 2026 r. obsługuje bardziej naturalną mowę wielu mówców i klipy do 15 sekund, ale prompt nie gwarantuje poprawnego przypisania mówców przy pierwszym renderze. Zacznij od prostej wymiany zdań między dwiema osobami, a trzecią kwestię lub odgłosy ulicy dodaj dopiero wtedy, gdy potrafisz ocenić podstawowe przekazanie głosu.
Najważniejsze wnioski
- Gemini Omni 1.2 Flash generuje wideo z natywnym dźwiękiem, w tym dialogiem; różni się od modeli Gemini text-to-speech przeznaczonych wyłącznie do audio.
- Używaj nazwanych mówców, dokładnych cytowanych kwestii, wyraźnych pozycji i milczącego słuchacza przy każdej turze.
- Zostaw miejsce na pauzy w limicie 15 sekund, a następnie sprawdź każdą kwestię względem klipu.
- Wyceniaj render na podstawie wybranej długości i rozdzielczości, a nie najniższej reklamowanej stawki platformy.
Co oznacza dialog wielu mówców w Gemini Omni 1.2 Flash?
Model tworzy krótką scenę, w której osoby mogą mówić w ramach wygenerowanego dźwięku i wideo. Praktyczny test polega na tym, czy widz potrafi rozpoznać, kto wypowiada każdą kwestię, bez czytania transkrypcji. Słowa, głos, widoczna osoba i ruch ust muszą się zgadzać jednocześnie. Klip może wyglądać przekonująco przy wyciszonym dźwięku, a mimo to nie przejść tego testu.
Google ogłosiło Gemini Omni 1.2 Flash 5 listopada 2026 r., z możliwością generowania lub edycji do 15 sekund wideo. Opisuje płynniejszy dialog, wyraźniejszą synchronizację ust i odrębne warunkowanie wielu mówców. To twierdzenia o możliwościach, a nie obietnica, że każdy scenariusz zostanie zrealizowany dokładnie tak, jak został napisany (ogłoszenie Google z listopada 2026 r.).
Opublikowana demonstracja Google pokazuje ogłoszoną możliwość. To materiał odrębny od trzech dostarczonych przypadków wideo poniżej.
Co się zmieniło względem Gemini Omni 1.1 Flash?
Oficjalne porównanie daje wersji 1.2 wyższy limit: 15 sekund zamiast 10. Wymienia też ulepszenia w mowie, synchronizacji ust, podążaniu za referencjami i edycji konwersacyjnej. Dodatkowe 5 sekund sprawia, że scenariusz wymiany złożonej z trzech tur staje się bardziej realny, ale dłuższy czas trwania nie tworzy więcej czasu na mówienie, jeśli reżyser prosi także o pauzy, reakcje fizyczne i zmiany scen.
Najbezpieczniejsza interpretacja jest kierunkowa. Lepsze warunkowanie może ułatwiać reżyserowanie dialogu, ale każdy dostarczony klip nadal wymaga kontroli. Twórca może wykorzystać limit 15 sekund do ustalenia celu scenariusza. Producent obiecujący dokładny tekst prawny lub precyzyjne dopasowanie głosu powinien traktować wygenerowany materiał jako wersję roboczą, dopóki nie przejdzie ona przeglądu.
Dialog wideo a text-to-speech dla wielu mówców
Modele Gemini text-to-speech przyjmują tekst i zwracają dźwięk. Ich ustawienia mówców i wybór głosu należą do tego procesu audio, który Google dokumentuje osobno (dokumentacja Gemini text-to-speech Google, dostęp: listopad 2026 r.). Ścieżka text-to-video Gemini Omni 1.2 Flash przyjmuje prompt sceny i tworzy wideo z natywnym dźwiękiem. Przykład speech_config dla text-to-speech nie jest elementem sterowania wideo Gemini Omni 1.2 Flash. Te przykłady opisują charakter głosu w tekście; nie twierdzą, że przesyłają, klonują lub wybierają nagrany głos. Jeśli brief wymaga głosu konkretnego aktora, zweryfikuj dostęp i zgodę osobno przed planowaniem ujęcia.
Jeśli efektem ma być rozmowa podcastowa lub zatwierdzony voiceover, użyj text-to-speech i zmontuj obraz wokół tego audio. Jeśli chodzi o dwie osoby widocznie mówiące w wygenerowanej scenie, użyj wideo Gemini Omni 1.2 Flash i sprawdź dopasowanie w rzeczywistym wyniku.
Gdzie można to uruchomić i ile będzie kosztować klip?
Wybierz ścieżkę text-to-video
Google wymienia Gemini Omni 1.2 Flash w swoich produktach kreatywnych i deweloperskich. Aby test był powtarzalny, użyj jednej ścieżki: Atlas Cloud oferuje ten model, a jego playground Gemini Omni 1.2 Flash Text-to-Video to miejsce, w którym można wkleić poniższe prompty. Identyfikator ścieżki to google/gemini-omni-1.2-flash/text-to-video. Poniższe prompty używają wyłącznie tekstu, bez referencji obrazu, ruchu ani głosu.
Prompty żądają 12 sekund w 16:9 dla biura, 15 sekund w 16:9 dla kawiarni i 12 sekund w 16:9 dla wywiadu ulicznego. Trzy dostarczone pliki mają 720p. Potwierdź bieżące ustawienia i wybrane wartości przed naciśnięciem Uruchom. Ustawienie reklamowane na stronie produktu nie jest dowodem, że dany przebieg testowy je przyjął. Zapisz wybrane wartości i wycenę przy każdym wyniku. Dzięki temu każdy render staje się użytecznym dowodem: przy przeglądaniu wyniku możesz porównać prompt z wybraną rozdzielczością i ścieżką. Ten przewodnik określa ścieżkę text-to-video, więc wynik ze ścieżki image-to-video lub reference-to-video należy oznaczyć osobno.
Dostarczone pliki wideo nie zawierają zrzutu ukończonego playgroundu, wybranych ustawień ani wyceny sprzed wysłania. Ich ścieżka i konfiguracja pozostają zatem niezweryfikowane.
| Ścieżka | Dane wejściowe w tym przewodniku | Najlepsze zastosowanie | Gdzie zweryfikować koszt |
|---|---|---|---|
| Produkty kreatywne Google | Prompt sceny; ustawienia różnią się w zależności od produktu | Ręczne tworzenie w edytorze Google | Bieżący plan lub ekran kredytów |
| Google API | Żądanie wideo dla deweloperów | Integracja aplikacji | Cena Google za dokładną rozdzielczość |
| Atlas Cloud text-to-video | Prompt, czas trwania, proporcje, rozdzielczość | Powtarzanie tych testów wyłącznie tekstowych w jednym playgroundzie | Wycena wybranej konfiguracji przed wysłaniem |
Sprawdź cenę przed renderowaniem
Google podaje $0.07 za wygenerowaną sekundę dla 720p przez swoje API, czyli 30% mniej niż Gemini Omni 1.1 Flash. Przy tej stawce 12 sekund w 720p kosztuje $0.84 przed innymi płatnymi operacjami. To wyliczenie nie jest wyceną Atlas Cloud dla dostarczonych plików; ich ścieżka i rozliczenia są niezweryfikowane. Kredyty w Flow lub innym edytorze podlegają własnym zasadom tego produktu.
Atlas Cloud podaje niższą stawkę początkową za sekundę w swoim katalogu modeli, ale minimum może dotyczyć innej rozdzielczości lub konfiguracji. Odczytaj bieżącą wycenę po wybraniu czasu trwania i rozdzielczości. Wersja robocza 360p może pomóc w eksplorowaniu promptu; to osobne generowanie, a nie podgląd późniejszego renderu 1080p klatka po klatce.
Zmieść dwa głosy w 15-sekundowej scenie
Nadaj każdemu mówcy tożsamość wizualną i głosową
Pisz opisy, które recenzent może zweryfikować. „Speaker A jest po lewej w granatowej koszuli” jest jaśniejsze niż „pierwszy współpracownik”. Dodaj słyszalną różnicę, np. średni ton kontra niższy. Utrzymuj spójność nazw, ubrań, pozycji i głosów w całym promptcie. Takie punkty odniesienia ułatwiają zauważenie zamienionej kwestii.
Tożsamość wizualna ma znaczenie, bo sam dźwięk może zmylić recenzenta. Jeśli głosy się różnią, ale porusza się niewłaściwe usta, klip ma problem z synchronizacją ust. Jeśli porusza się właściwe usta, ale głos A zmienia się przy drugiej kwestii A, występuje dryf głosu. Przykład z kawiarni przywraca A po B, aby recenzent mógł sprawdzić, czy głos A pozostaje spójny.
Zaplanuj czas na mowę i reakcję
Przeczytaj scenariusz na głos w docelowym tempie. Uwzględnij naturalną pauzę przy każdym przekazaniu głosu, a następnie zostaw miejsce na reakcję słuchacza i na ujęcie otwierające, które pokaże obie twarze. Poprawiony scenariusz biurowy ma 5 tur w 12 sekundach. Kawiarnia ma 8 krótkich tur w 15 sekundach, co czyni ją najbardziej wymagającym testem czasu tutaj. To przykładowe scenariusze, a nie uniwersalny próg słów na sekundę ani obietnica dotycząca wyniku.
| Budżet sceny | Sekwencja mówiona | Czas potrzebny poza słowami |
|---|---|---|
| 12-sekundowe biuro | A-B-A-B-A | Pokazać obie osoby i zmieścić 4 przekazania głosu |
| 15-sekundowa kawiarnia | Osiem naprzemiennych tur | Siedem przekazań głosu z niewielkim zapasem czasu |
| 12-sekundowa ulica | A-B-A-B-A | Cztery przekazania głosu ponad odgłosami ulicy |
Długa kwestia sprzyja pośpiechowi lub pominięciu końcówki. Jeśli wersja robocza zajmuje prawie wszystkie 15 sekund przy czytaniu na głos, skróć ją przed generowaniem. Jeśli scenariusz wymaga więcej dialogu, zaplanuj osobne ujęcia i zweryfikuj ciągłość jako kolejne zadanie produkcyjne. Przy pierwszej próbie utrzymuj widoczne twarze podczas wypowiadanych kwestii. Szybkie cięcia i zasłonięte usta utrudniają ocenę przypisania mówców. Zrób próbne czytanie na czas z dwiema osobami, jeśli kolejność kwestii ma znaczenie. Niech jedna osoba czyta A, druga B, a trzecia notuje, gdzie kończy się każde zdanie. Jeśli ostatnie słowo wypada na granicy klipu, usuń fragment zdania lub moment reakcji przed renderowaniem. Krótszy scenariusz łatwiej audytować, ponieważ recenzent może odtworzyć całą wymianę bez zgadywania, czy kwestia miała być kontynuowana poza ekranem.
Jak pisać prompty do Gemini Omni 1.2 Flash dla 2 mówców
Użyteczny prompt czyta się jak zwięzły brief zdjęciowy: sceneria i kamera, tożsamości, dokładny dialog, a następnie dźwięk i zasady wykluczeń. Ta kolejność daje też recenzentowi listę kontrolną. To metoda pisania promptów, a nie udokumentowana gwarancja kontroli. Utrzymuj identyczne etykiety postaci od akapitu o tożsamości przez blok dialogu. Unikaj nazywania tej samej osoby jednocześnie A i „klientem” w instrukcjach dotyczących późniejszej tury, chyba że przypisanie jest już jednoznaczne. Czytelnik powinien móc narysować dwie kolumny, po jednej dla każdej osoby, i umieścić każdą żądaną akcję oraz kwestię mówioną dokładnie w jednej kolumnie.
Używaj jawnych etykiet mówców i cytowanych kwestii
Używaj jednej linii na turę z Speaker A: lub Speaker B: i cytowanymi słowami. Określ, kto milczy. Prośba o „dyskusję o gotowości do premiery” pozwala na improwizację. Dokładny scenariusz pozwala od razu oznaczyć brakujące lub przepisane słowo.
Oto pierwszy prompt do skopiowania. Utrzymuje obie dorosłe osoby w jednym ciągłym ujęciu, aby widz mógł sprawdzić usta każdej z nich.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Dostarczony 12-sekundowy render biurowy 720p. Obie osoby pozostają widoczne; pięć wypowiedzianych kwestii i synchronizacja ust nadal wymagają przeglądu słuchowego.
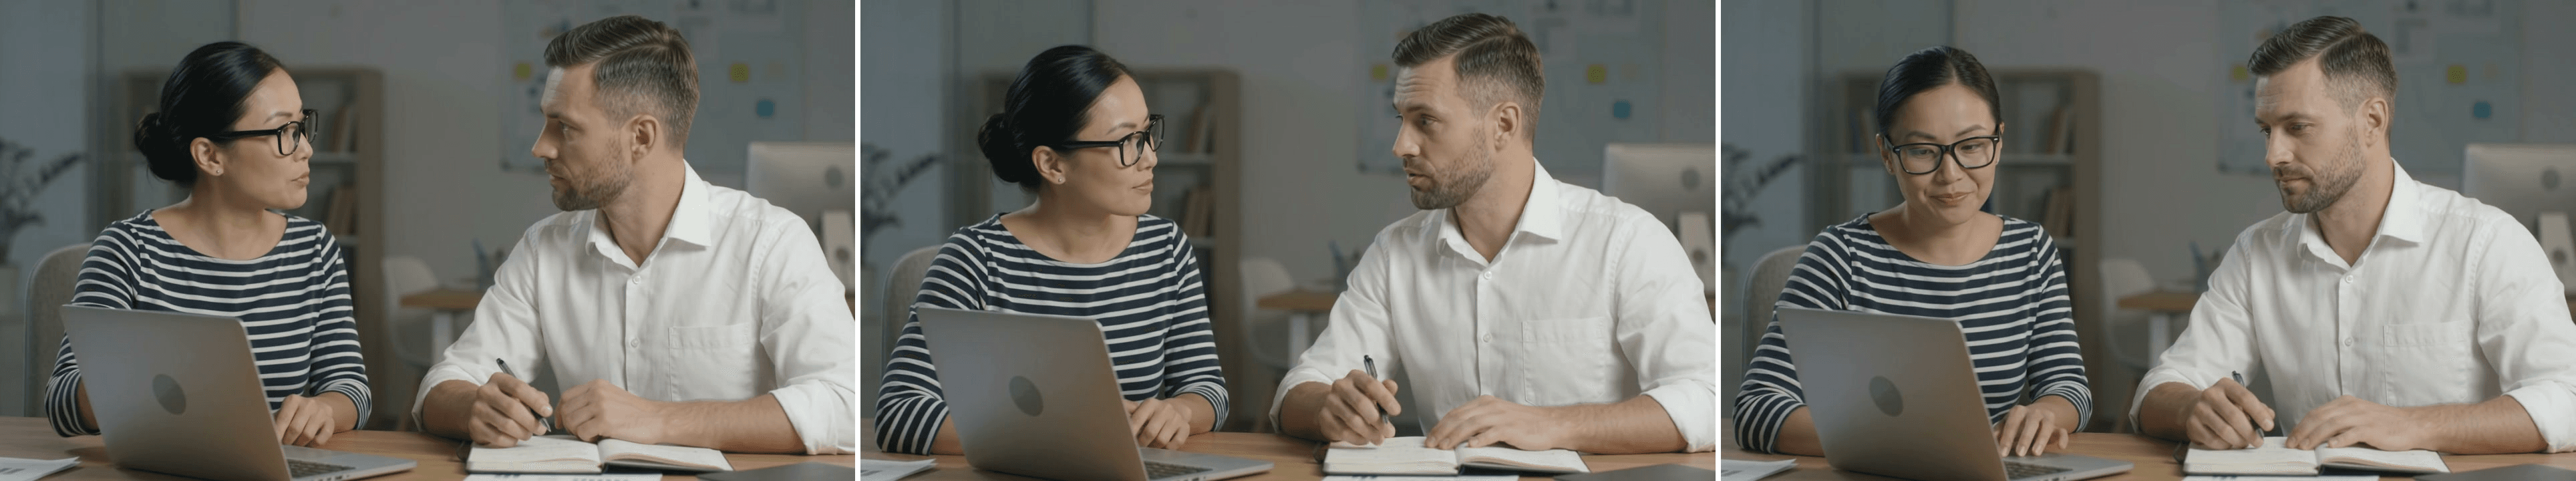 Klatki przypadku A, od lewej do prawej (około 0:02, 0:05, 0:10): kobieta zwraca się do współpracownika; on zdaje się odpowiadać, a oboje pozostają w kadrze; wracają uwagą do laptopa i notatnika.
Kontroluj kamerę, nie tracąc mówcy
Cielące ujęcie średnie z dwiema osobami jest wyborem diagnostycznym. Obie twarze pozostają w kadrze, więc pominięte przekazanie głosu nie może ukryć się za montażem. Model może jednak zmieniać kadrowanie, dlatego końcowy plik wymaga kontroli.
Gdy przekazanie głosu działa zgodnie z twoim celem, wypróbuj umiarkowany ruch, który zachowuje obie twarze. Prompt uliczny prosi o taki ruch w kadrze 16:9, który utrzymuje obie twarze widoczne, co ułatwia ocenę ruchu ust. To powód, by najpierw ustalić punkt odniesienia w biurze.
Utrzymuj dźwięk tła poniżej dialogu
Nazwij tło dźwiękowe i jego priorytet. Cichy szum pomieszczenia sprawia, że w klipie biurowym niewiele konkuruje z mową. Delikatny dźwięk kawiarni dodaje kontekstu, a kwestie pozostają testowalne. Prompt uliczny prosi o kroki i odległe dźwięki poniżej obu głosów, bez mowy przechodniów.
Instrukcje negatywne mogą ograniczać niepożądane audio, ale pozostają prośbami. Nasłuchuj trzeciego głosu, narracji, muzyki i dźwięków brandingowych. Sprawdź też obraz pod kątem napisów i logo.
3 sceny dialogowe, które pokazują, kto mówi kiedy
Trzy dostarczone pliki wideo pokazują zamierzone sceny: biurową, kawiarnianą i uliczną. Ich zawartość wizualną można tu obejrzeć, ale pliki nie ustalają, która ścieżka lub ustawienia je wygenerowały. Poniższe prompty to powtarzalne żądania, a nie twierdzenie, że wynik wypowiedział każde słowo poprawnie. Biuro sprawdza 5 tur, kawiarnia testuje 8 szybkich tur, a ulica dodaje dźwięk otoczenia.
| Przypadek | Żądanie promptu | Dostarczony plik | Główna kontrola |
|---|---|---|---|
| A: przekazanie głosu w biurze | 12 s, 16:9, 5 tur | 12 s, 16:9, 720p | Pięć kwestii, właściwe usta |
| B: wymiana w kawiarni | 15 s, 16:9, 8 tur | 15 s, 16:9, 720p | Osiem kwestii, stabilne głosy |
| C: wywiad uliczny | 12 s, 16:9, 5 tur | 12 s, 16:9, 720p | Słyszalność na ulicy i tury mówców |
Pięcioturowe przekazanie głosu w biurze
Użyj pełnego promptu i wideo powyżej. Obaj współpracownicy pozostają w tym samym ujęciu, więc każda z pięciu żądanych tur ma widoczną osobę do sprawdzenia. Zapisz każdą słyszalną kwestię względem tekstu i sprawdź aktywne usta. Dostarczony plik ustala scenę i czas trwania, ale jego słowa i synchronizacja ust nie zostały niezależnie zweryfikowane.
Wyraźne przekazanie głosu w jednym klipie pozwoliłoby wyciągnąć wniosek tylko o tym klipie, a nie o ogólnym wskaźniku sukcesu modelu. Zachowaj pierwszy wynik, aby każdą poprawkę można było porównać z oryginałem.
Wymiana w kawiarni w ośmiu turach
Poproś o 15 sekund w 16:9. Osiem krótkich tur poddaje próbie powtarzalne przypisanie głosu i timing. Porównaj pierwszą i ostatnią kwestię każdej osoby, a następnie sprawdź, czy jakakolwiek kwestia się nakłada lub znika. Dostarczony plik ma 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Plenerowa sesja Q&A
Poproś o 12 sekund w 16:9. Dodaje to łagodny ruch kamery i dźwięk otoczenia. Dostarczony plik ma 16:9 przy 720p i można go sprawdzić pod kątem pięciu tur mówców oraz słyszalności na ulicy.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Odtwarzanie łączone: 0:00–0:15 to przypadek B, wymiana w kawiarni; 0:15–0:27 to przypadek C, wywiad uliczny. Oba źródłowe klipy są dołączone w całości.
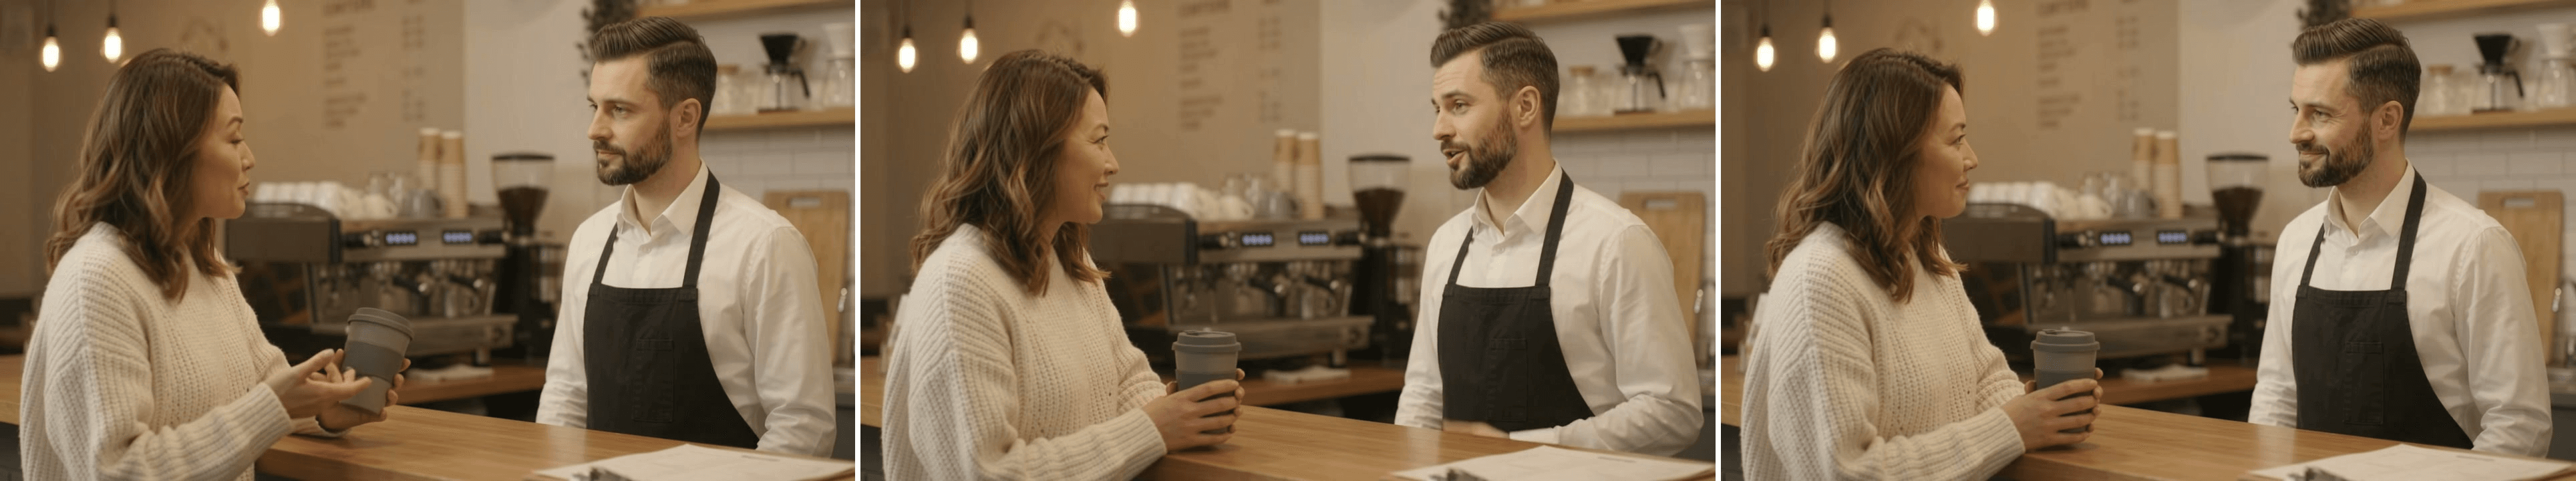 Klatki przypadku B, od lewej do prawej (około 0:02, 0:08, 0:13 połączonego wideo): klientka pokazuje swój kubek; pracownik kawiarni zdaje się odpowiadać; na koniec patrzą na siebie.
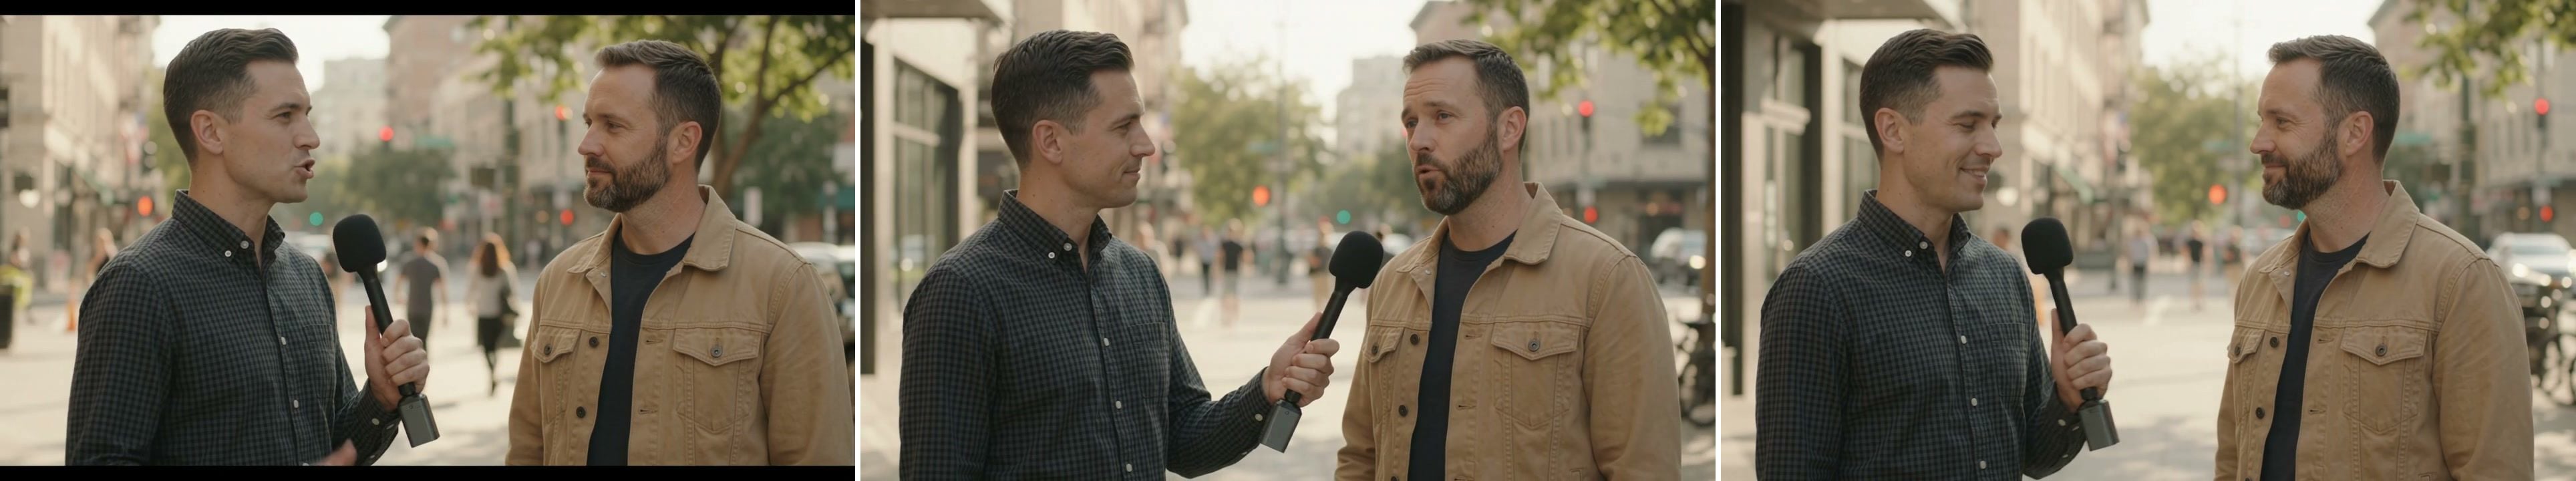
Klatki przypadku C, od lewej do prawej (około 0:16, 0:19, 0:26 połączonego wideo): ankieter trzyma mikrofon; obraca go w stronę rozmówcy; na końcu obaj patrzą na siebie.
Sprawdź kolejność mówców, synchronizację ust i dryf głosu przed publikacją
Przejrzyj klip kwestia po kwestii
Pobierz wideo. Odtwórz je raz bez czytania scenariusza, aby znaleźć oczywiste niejasności, a potem odtwórz ponownie z promptem obok. Zatrzymaj przy każdej turze i zapisz, co słyszysz. Sprawdź oba usta i zanotuj mowę poza zaplanowanymi turami. Aby przegląd był powtarzalny, zapisz czas początku i końca każdej słyszalnej kwestii, oczekiwanego mówcę, usłyszany głos oraz widoczne usta, które się poruszały. Wpisz „niejasne”, jeśli twarz jest zasłonięta lub dźwięk maskuje słowo. Nie zamieniaj niejasnego pola na zaliczenie tylko dlatego, że reszta sceny wygląda przekonująco. Drugi słuchacz, który nie widział promptu, może wskazać, kto jego zdaniem mówi; porównaj ten osąd ze scenariuszem, zanim zdecydujesz, czy widz publiczny zrozumie scenę.
Sprawdź 4 rzeczy przy każdej kwestii:
- Słowa: Czy cytowane słowa zostały wypowiedziane w kolejności, bez pominiętej końcówki lub dodanego zdania?
- Właściciel głosu: Czy nazwana osoba brzmiała jak mówiący, zwłaszcza gdy A wrócił?
- Widoczny timing: Czy usta tej osoby poruszały się, podczas gdy słuchacz milczał?
- Inna zawartość: Czy klip dodał narratora, przechodnia, napisy, logo lub muzykę?
Oś czasu zapewnienia jakości ze znacznikami czasu pozostaje otwarta, dopóki audio i ruchy ust nie zostaną sprawdzone kwestia po kwestii.
Zmieniaj jedno ograniczenie naraz
Jeśli ostatnia kwestia znika, skróć scenariusz lub wydłuż czas w ramach limitu 15 sekund. Jeśli mówi niewłaściwa postać, powtórz pozycję wizualną i określ, że słuchacz milczy. Jeśli tło dźwiękowe zagłusza słowo, zmniejsz je lub usuń. Jeśli cięcie zasłania aktywne usta, wróć do ciągłego ujęcia z dwiema osobami. Zmieniaj jeden czynnik przy każdej próbie, aby następny wynik odpowiadał na jasne pytanie.
Żadna z tych zmian nie gwarantuje poprawki. Jeśli render wymaga korekty, zapisz jego plik, ustawienia i problem, który chcesz rozwiązać. Producent może wtedy zdecydować, czy kolejny render jest wart kosztu, czy potrzebną precyzję zapewnią nagrane głosy i ręczny montaż. W przypadku krótkiej, widocznie wypowiadanej wymiany zdań zacznij od promptu biurowego i zaakceptuj klip dopiero po sprawdzeniu kwestia po kwestii. To standard dla dialogu wielu mówców w Gemini Omni 1.2 Flash.
Często zadawane pytania
Czy Gemini Omni 1.2 Flash potrafi zachować te same głosy w osobnych klipach?
Utrzymanie rozpoznawalności głosu w jednym wygenerowanym klipie to węższe wymaganie niż zachowanie go w osobnych generowaniach. Te przykłady wyłącznie tekstowe testują pierwszy przypadek. Nie obiecuj na ich podstawie tożsamości głosu między klipami. Kampania wymagająca jednego powracającego mówcy powinna przeprowadzić osobny test ciągłości.
Czy Gemini Omni 1.2 Flash potrafi generować dialog w językach innych niż angielski?
Model może generować inne języki, ale te prompty są po angielsku. Sprawdź język docelowy słowo po słowie z płynnie mówiącym słuchaczem, w tym nazwy, liczby i zlokalizowane twierdzenia. Udany test językowy innego twórcy jest dowodem dla tego testu, a nie gwarancją dla twojego scenariusza.
Jak utrzymać przypisanie każdej kwestii do właściwego mówcy?
Nadaj każdej osobie pozycję wizualną i głos, oznacz każdą cytowaną kwestię i określ, kto milczy podczas tury drugiej osoby. Przejrzyj wygenerowane wideo kwestia po kwestii. Jeśli render nie spełnia briefu, skróć wymianę lub użyj kontrolowanego procesu audio, aby uzyskać dokładne wykonanie.
Ile tur dialogu zmieści się w 15-sekundowym klipie Gemini Omni 1.2 Flash?
Prompt kawiarniany żąda ośmiu krótkich tur w 15 sekundach, a prompty biurowy i uliczny żądają pięciu tur w 12 sekundach. To przykłady scenariuszy, a nie gwarantowane limity. Przeczytaj kwestie na głos, uwzględnij pauzy i skróć je, jeśli ostatnia tura dochodzi do końca klipu.
Czy Gemini Omni 1.2 Flash potrzebuje obrazu referencyjnego do dialogu dwóch mówców?
W tych trzech promptach text-to-video nie użyto obrazu referencyjnego. Opisują one pozycję, ubranie i głos każdego mówcy w tekście. Jeśli projekt wymaga konkretnej twarzy lub stylu wizualnego, przetestuj ścieżkę akceptującą referencje i sprawdź jej wynik osobno.


