Załóżmy, że przesyłasz białą filiżankę, bar kawowy i ziarna kawy, ale wideo pokazuje inną filiżankę w ogólnym pomieszczeniu. Aby dobrze wykorzystać Gemini Omni 1.2 Flash multiple reference images, wybierz Reference-to-Video, przypisz każdemu obrazowi jedno odrębne zadanie i opisz te zadania w kolejności przesyłania. Zacznij od krótkiego ujęcia, a następnie sprawdź początek, środek, koniec oraz ruch między nimi. Referencja steruje generowaniem; nie gwarantuje kopii co do piksela.
Protokół testowy używa tego samego ujęcia filiżanki dwukrotnie: najpierw tylko z obrazem filiżanki, potem z filiżanką, kawiarnią i ziarnami. Drugi przykład używa zdjęć zewnętrza i wnętrza Panteonu do przetestowania ruchomego punktu widzenia. Porównanie oddziela to, o co prosi prompt, od tego, co faktycznie pokazuje wynik, więc możesz zdecydować, czy kolejna referencja pomogła, czy dodała konfliktu.
Najważniejsze wnioski
- Wybierz Reference-to-Video, gdy obrazy mają kierować treścią bez narzucania klatki początkowej.
- Przypisz każdemu przesłanemu obrazowi rolę i nazwij go według kolejności przesyłania w prompcie.
- Porównaj krótki wynik bazowy z 1 obrazem z przebiegiem z 3 obrazami, zanim zwiększysz złożoność.
- Sprawdź tożsamość, scenerię, rekwizyty i ruch w całym klipie, nie tylko w pierwszej klatce.
Co kontrolują liczne obrazy referencyjne w Gemini Omni 1.2 Flash
Zestaw wielu obrazów referencyjnych może opisywać kilka części jednego ujęcia. Jedno zdjęcie może identyfikować produkt, inne może dostarczać lokalizację, a trzecie może identyfikować rekwizyt. Możesz też użyć obrazów dla postaci lub stylu wizualnego. Te role są przydatne tylko wtedy, gdy prompt mówi, które widoczne cechy należą do którego obrazu. „Użyj wszystkich obrazów” pozostawia modelowi decyzję, czy druga filiżanka na zdjęciu kawiarni to drugi produkt, czy tło.
W teście filiżanki obraz 1 definiuje białą ceramiczną filiżankę i uchwyt. Obraz 2 dostarcza blat baru espresso i ciepłe wnętrze. Obraz 3 dostarcza widoczne ziarna obok filiżanki. Nie prosimy modelu o przeniesienie białego tła ze zdjęcia ziaren ani każdego przedmiotu na blacie kawiarni. To wykluczenie ma znaczenie: zdjęcie referencyjne często zawiera więcej informacji wizualnej, niż wynosi zadanie, które ma wykonać.
Zestaw referencyjny nie może usunąć każdej niejednoznaczności. Dłoń może zasłaniać uchwyt. Ruch kamery może odsłonić bok filiżanki, którego źródłowe zdjęcie nigdy nie pokazuje. Oświetlenie i kąty kamery mogą się różnić między trzema zdjęciami źródłowymi. Traktuj prompt jako hierarchię priorytetów, w której kształt filiżanki jest ważniejszy niż dokładne dopasowanie do mebli w tle. W swoim ogłoszeniu z listopada 2026 Google opisuje mocniejsze podążanie za referencjami w Gemini Omni 1.2 Flash, zauważając jednocześnie, że szybka akcja i złożona fizyka pozostają obszarami do poprawy.
Przed przesłaniem napisz jedno zdanie dla każdego źródła: „Ten obraz definiuje X; zignoruj Y”. Jeśli nie możesz tego zrobić bez przypisania dwóm obrazom tego samego zadania, uprość zestaw. Następnie wybierz tryb wejścia pasujący do celu.
Reference-to-Video czy pierwsza i ostatnia klatka?
Reference-to-Video to właściwy tryb, gdy obrazy mają wpływać na nowe ruchome ujęcie. Jeśli potrzebujesz dokładnego obrazu początkowego, użyj zamiast tego przepływu pracy z pierwszą klatką lub Image-to-Video. Jeśli potrzebujesz dwóch określonych punktów końcowych, użyj przepływu pracy z pierwszą i ostatnią klatką, jeśli jest dostępny. To samo przesłane zdjęcie może odgrywać zupełnie inną rolę w zależności od wybranego trybu, a zdanie w prompcie nie zawsze może zastąpić kontrakt wejściowy trybu.
| Tryb | Co kontroluje dane wejściowe | Oczekiwany początek | Najlepsze zastosowanie |
|---|---|---|---|
| Reference-to-Video | Wskazówki dotyczące podmiotu, sceny, rekwizytu lub stylu | Wygenerowany widok kierowany przez referencje | Połączenie filiżanki, kawiarni i ziaren w jednym ujęciu |
| Image-to-Video / pierwsza klatka | Początkowy stan wizualny | Ściśle powiązany z dostarczonym pierwszym obrazem | Animowanie konkretnego nieruchomego obrazu |
| Pierwsza i ostatnia klatka | Początkowy i końcowy stan wizualny | Zaczyna się od określonego pierwszego obrazu | Zaplanowanie przejścia między stałymi punktami końcowymi |
Dokumentacja obrazów referencyjnych Google Cloud, do której dostęp uzyskano w listopadzie 2026, opisuje obrazy referencyjne jako dodatkowe wskazówki do generowania. Różnica jest praktyczna: jeśli pierwsze przesłane zdjęcie pojawia się prawie bez zmian jako klatka 1, a chciałeś nowo skomponowanego otwarcia, sprawdź tryb i slot obrazu, zanim przepiszesz prompt kreatywny.
Biała filiżanka na zwykłym tle źródłowym może w trybie Reference-to-Video rozsądnie stać się filiżanką na blacie kawiarni. Na tym polega tutaj eksperyment. W przypadku Panteonu zdjęcia zewnętrza i kopuły pokierują dwiema scenami, ale nie są narzuconymi pierwszą i ostatnią klatką. Ich zadaniem jest uczynienie elementów architektonicznych rozpoznawalnymi podczas ciągłego ruchu.
Zbuduj zestaw referencji, który model potrafi odczytać
Wybierz wyraźną referencję główną, zanim zaczniesz zbierać obrazy uzupełniające. Filiżanka powinna być wystarczająco duża, aby ocenić jej krawędź, korpus i uchwyt. Na zatwierdzonym zdjęciu źródłowym filiżanka jest mała i wygląda na bladokremową, mimo że nazwa pliku określa ją jako białą. To czyni to dane wejściowe użytecznym testem obciążeniowym, ale utrata szczegółów uchwytu może zaczynać się już w źródle. Maleńka filiżanka na zajętym zdjęciu kawiarni to słaba referencja produktu, ponieważ model ma niewiele konkretnych informacji o kształcie do zachowania. Uzupełniający obraz kawiarni ma inne zadanie: powinien uczynić otoczenie czytelnym, zwłaszcza blat i sprzęt do espresso. Obraz ziaren powinien identyfikować rekwizyt, a nie dostarczać konkurencyjnej kompozycji.
Utrzymuj stałą kolejność przesyłania. Poniższy prompt mówi „pierwszy”, „drugi” i „trzeci”; te słowa pomagają tylko wtedy, gdy kolejność plików się zgadza. Jeśli podczas ponownej próby zastąpisz jedno źródło, sprawdź interfejs ponownie przed uruchomieniem. Gdy wiele zdjęć pokazuje podobne filiżanki, usuń dodatkową filiżankę lub wyraźnie ją wyklucz. W przeciwnym razie model może połączyć uchwyty, proporcje lub kolory z obu. W przypadku produktu o złożonym opakowaniu kilka widoków tego samego obiektu może być cenniejsze niż osobna referencja stylu.
| Przesłanie | Docelowy szczegół | Nie dziedzicz |
|---|---|---|
| 1: biała filiżanka | Korpus filiżanki, krawędź i uchwyt | Tło zdjęcia źródłowego |
| 2: rzymski bar kawowy | Blat, sprzęt, atmosfera wnętrza | Inne filiżanki lub osoby jako referencje produktu |
| 3: ziarna kawy | Rozpoznawalne ziarna obok filiżanki | Białe tło ze zdjęcia ziaren |
Te trzy zdjęcia pochodzą z Wikimedia Commons: zdjęcia białej ceramicznej filiżanki i rzymskiego baru kawowego są oznaczone jako CC0, a zdjęcie ziaren kawy jest oznaczone jako domena publiczna. Ich podany status ponownego wykorzystania ułatwia prześledzenie demonstracji; nie czyni wygenerowanego wyniku zweryfikowanym zdjęciem prawdziwego produktu.
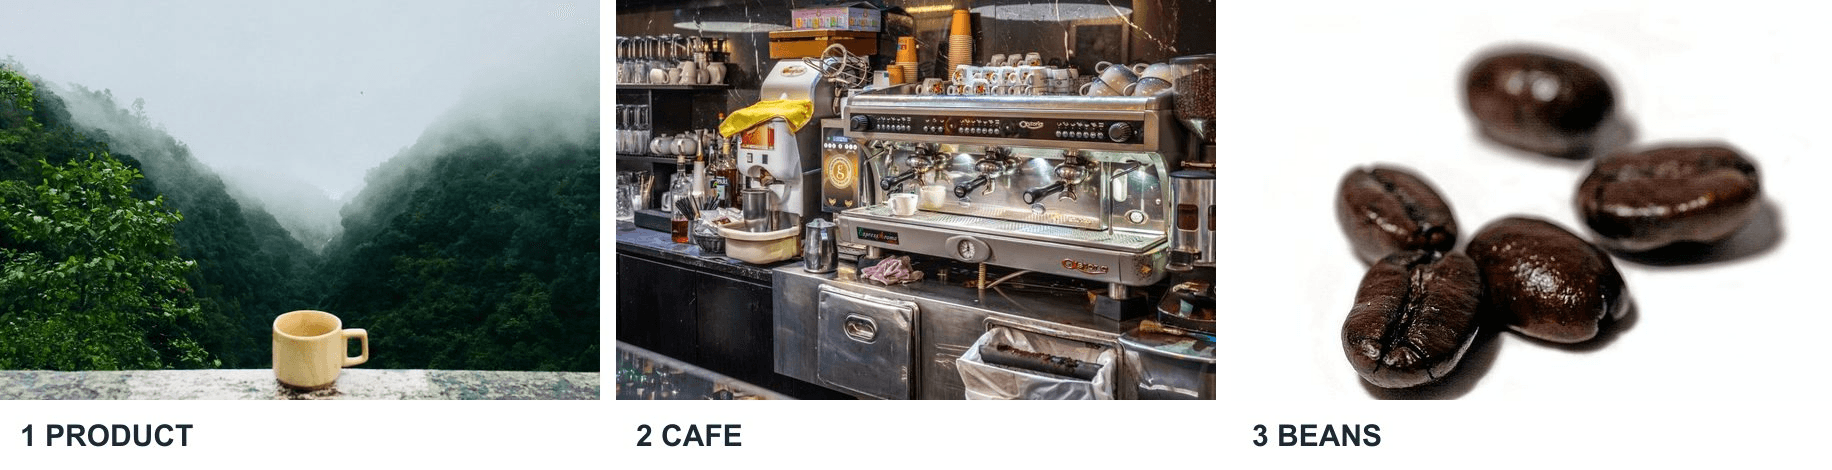
Trzy zdjęcia źródłowe rozdzielają produkt, scenerię i rekwizyt przed wygenerowaniem jakiegokolwiek wideo.
Gotowy do skopiowania przepływ pracy: 1 filiżanka, 3 referencje, 1 ruchome ujęcie
Pobierz zdjęcia źródłowe w pełnym rozmiarze i zanotuj stronę każdego pliku Commons. W środowisku Reference-to-Video Gemini Omni 1.2 Flash wybierz model Reference-to-Video, a nie wariant Image-to-Video. Prześlij samą filiżankę dla przebiegu A1. Ustaw 8 sekund, 16:9, 1080p i domyślny tryb thinking. Sprawdź, czy przesłany plik pojawia się w polu obrazów referencyjnych. Wklej ten prompt dokładnie:
plaintext1Create an eight-second product video featuring the white ceramic cup in the first reference image. Preserve its recognizable cup shape and handle. Begin with the cup resting still on a counter. The camera itself physically travels in a smooth semicircular arc around the stationary cup, so the counter and café background shift with clear parallax while the cup keeps the same orientation relative to the counter. Do not spin or rotate the cup, and do not place it on a turntable. After the camera arc, raise the camera to a slightly elevated viewpoint as a hand briefly lifts the cup and sets it back down without twisting it. Natural café ambience, no dialogue, no logos or added text. Use the uploaded image as a product reference, not as a literal opening frame.
Uruchom A1 i obejrzyj cały wynik. Pierwsze przesłanie to punkt odniesienia, więc zanotuj kształt filiżanki oraz to, czy występują zarówno orbita, jak i podniesiony widok. Nie karz A1 za pominięcie konkretnej kawiarni lub ziaren: żadne z nich nie zostało dostarczone jako referencja. Zapisz ten wynik osobno przed zmianą formularza.
Dla przebiegu A2 użyj tego samego modelu i ustawień. Prześlij filiżankę, bar kawowy i ziarna w tej kolejności. Potwierdź, że wszystkie trzy miniatury pojawiają się w polu referencji, a następnie wklej:
plaintext1Create an eight-second product video. The first reference image defines the white ceramic cup: preserve its recognizable shape and handle. The second reference image defines the espresso bar counter and its warm indoor atmosphere, but do not copy any other cup from that image. The third reference image defines the coffee beans placed beside the cup, not the background. Begin with the cup and beans on the counter. Move the camera in a smooth semicircle around the cup, then change to a slightly elevated viewpoint as a hand lifts the cup and sets it down. Keep the same cup and counter through the whole shot. Natural café ambience, no dialogue, no logos or added text. Use all three images as references rather than literal opening frames.
Uruchom A2 i poczekaj na ukończony wynik. Przejrzyj wygenerowany plik, nie tylko miniaturę podglądu. Dwa gotowe klipy poniżej pokazują, które szczegóły przetrwały ruch kamery i działanie dłoni.
Co zmienia się wraz z drugim i trzecim obrazem?
Porównaj klipy przy tym samym rozmiarze wyświetlania. Odtwórz każdy od początku do końca, a następnie zatrzymaj w pobliżu początku, środka i końca. W przypadku tożsamości filiżanki sprawdź profil krawędzi, stronę uchwytu i proporcje korpusu, zwłaszcza po podniesieniu jej przez dłoń. W przypadku otoczenia szukaj blatu i wskazówek baru espresso, a nie ogólnego brązowego pomieszczenia. W przypadku ziaren sprawdź, czy są odrębnymi rekwizytami obok filiżanki, a nie niewyraźną teksturą.
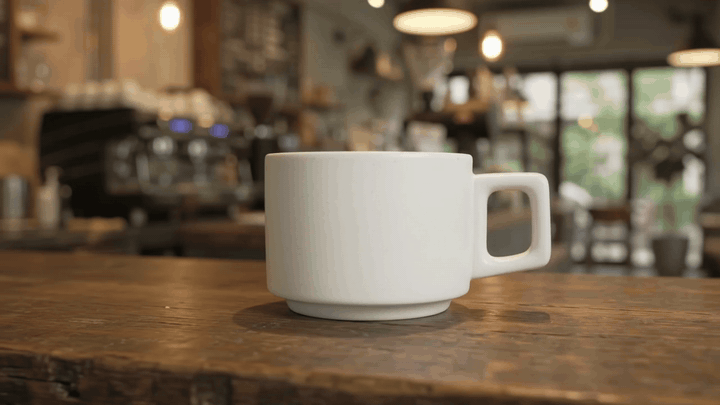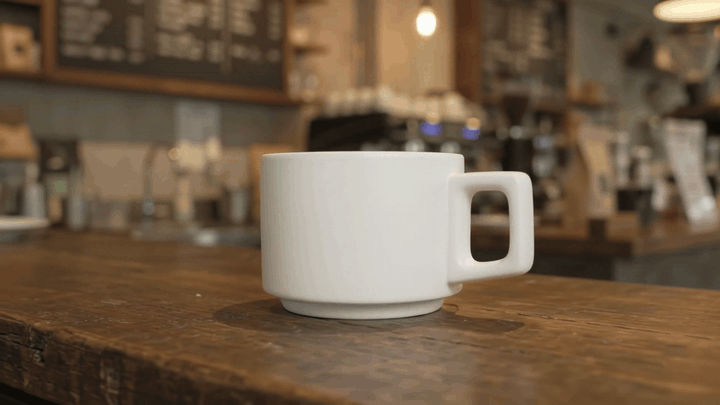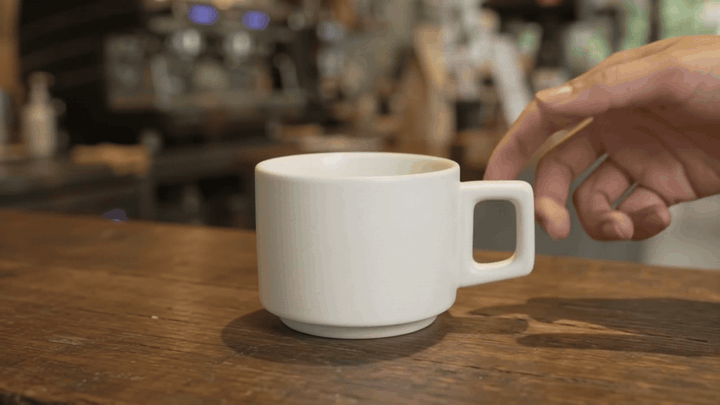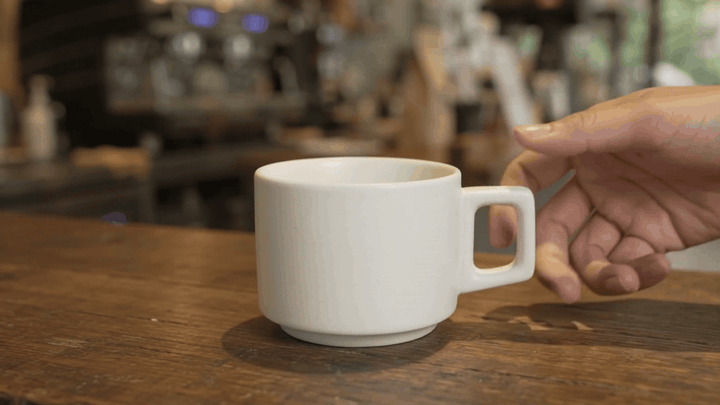
A1 zachowuje białą filiżankę i widoczny uchwyt podczas podnoszenia dłonią. Przesunięcie kamery jest umiarkowane, a nie wyraźną półkolistą orbitą.
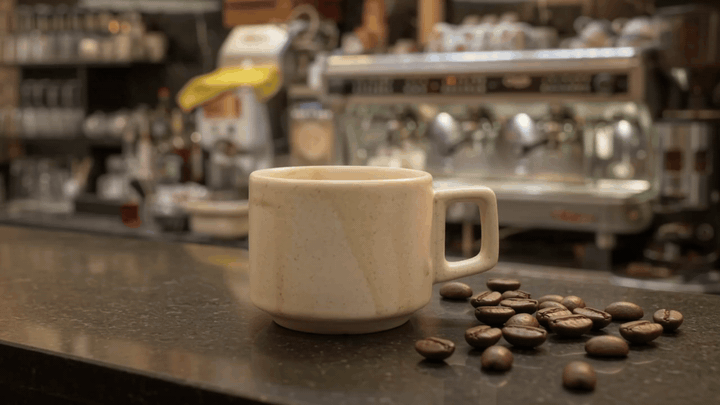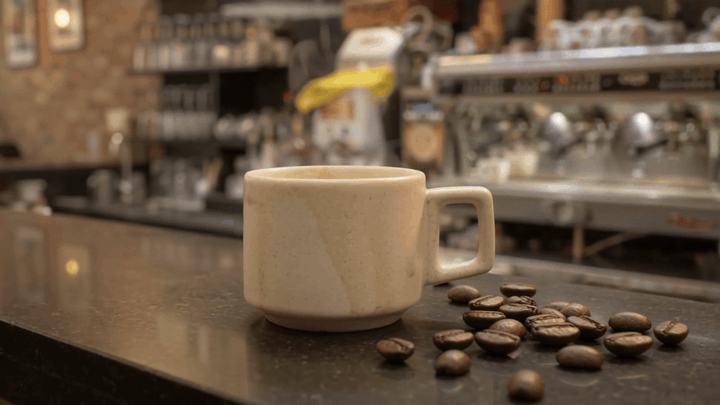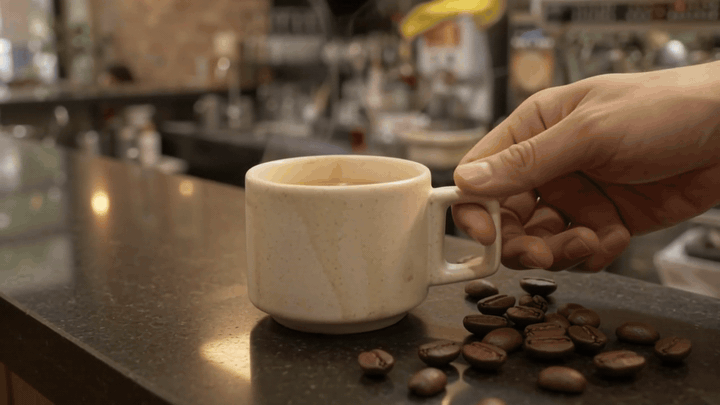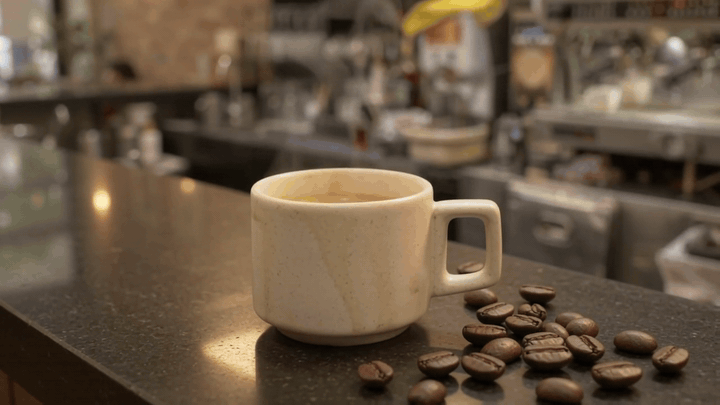
A2 dodaje widoczne ziarna kawy i bardziej konkretną scenerię baru espresso. Filiżanka wygląda na kremową i mniej regularną kształtem niż filiżanka w A1.
| Sprawdzenie | A1: 1 obraz | A2: 3 obrazy | Na co patrzeć |
|---|---|---|---|
| Kształt i uchwyt filiżanki | Biały korpus i uchwyt pozostają widoczne | Uchwyt pozostaje widoczny; korpus wygląda na kremowy i mniej regularny | Ten sam rozpoznawalny obiekt po ruchu kamery |
| Blat kawiarni | Ogólna sceneria kawiarni | Ekspres do espresso i blat są wyraźne | Otoczenie przypomina źródło blatu |
| Ziarna kawy | Niepokazane | Widoczne obok filiżanki | Wyraźne ziarna obok filiżanki |
| Ruch | Dłoń podnosi filiżankę; przesunięcie kamery jest umiarkowane | Dłoń podnosi filiżankę; punkt widzenia zmienia się umiarkowanie | Orbita, podniesiony widok, podniesienie i odstawienie |
Dodane referencje sprawiają, że blat i ziarna są łatwiejsze do zidentyfikowania, ale kolor i kształt filiżanki się zmieniają. Żaden klip nie realizuje wyraźnie żądanego półkolistego ruchu kamery. To pojedyncze wyniki, więc są przykładami diagnostycznymi, a nie statystyką wydajności. Jeśli tożsamość filiżanki ma największe znaczenie, następny test powinien wzmocnić referencję filiżanki lub uprościć działanie dłoni, zachowując stałe pozostałe ustawienia.
Test architektury z dwoma obrazami
Test filiżanki pyta, czy kilka rodzajów szczegółów współistnieje w jednym ujęciu produktowym. Dwa zdjęcia Panteonu zadają inne pytanie: czy referencje zewnętrza i wnętrza mogą kierować spójnym ruchomym punktem widzenia? Pierwszy obraz Commons pokazuje fasadę zewnętrzną; drugi pokazuje wewnętrzną kopułę i okulus. Strony plików Wikimedia Commons zarówno dla zdjęcia zewnętrza, jak i kopuły oznaczają je jako CC0.
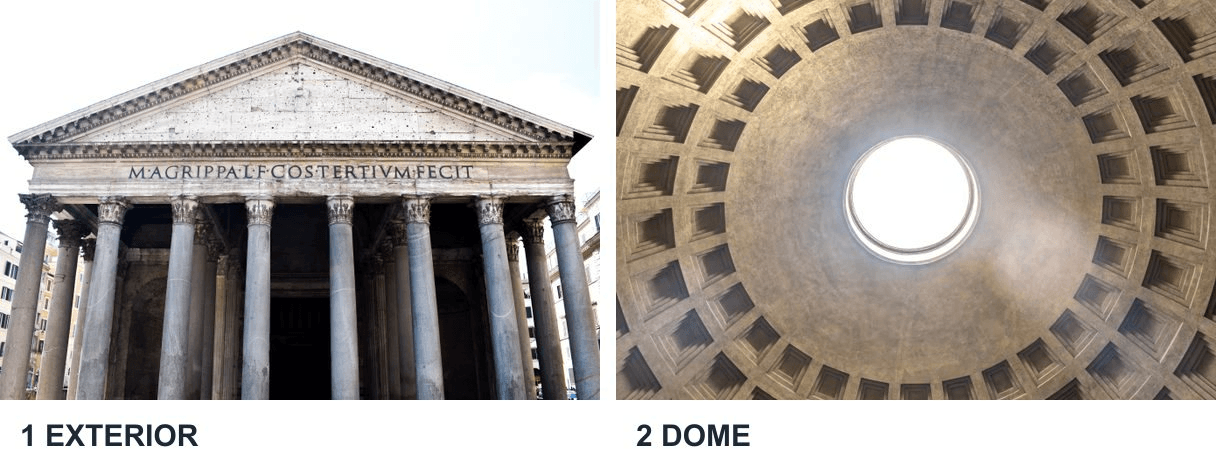 Zdjęcia zewnętrza i kopuły dostarczają osobnych wskazówek sceny dla generowanego przejścia do budynku.
Prześlij najpierw zewnętrze, potem wnętrze, w tym samym modelu Reference-to-Video. Ustaw 12 sekund, 16:9, 1080p i domyślny tryb thinking. Użyj poniższego promptu:
plaintext1Create a twelve-second architectural concept video guided by the two reference photographs of the Pantheon in Rome. The first image defines the exterior facade and entrance; the second defines the interior dome and oculus. Begin from a human-height viewpoint outside, move steadily toward and through the entrance, then tilt upward inside to reveal the dome and oculus. Use a continuous moving viewpoint with clear parallax and no sudden teleporting or isolated zoom. Keep the building recognizable while treating the result as a generated visualization, not documentary footage. Natural footsteps and room ambience, no dialogue, no titles or labels. Both images are scene references, not mandatory first and last frames.
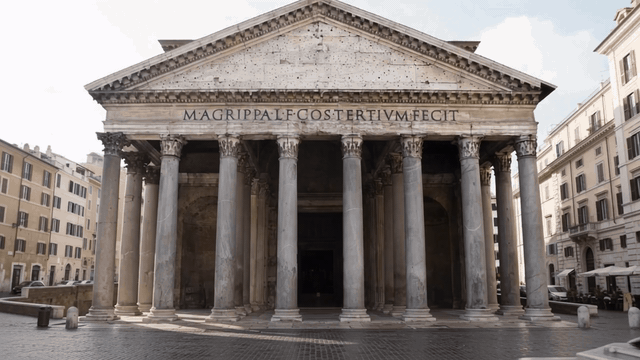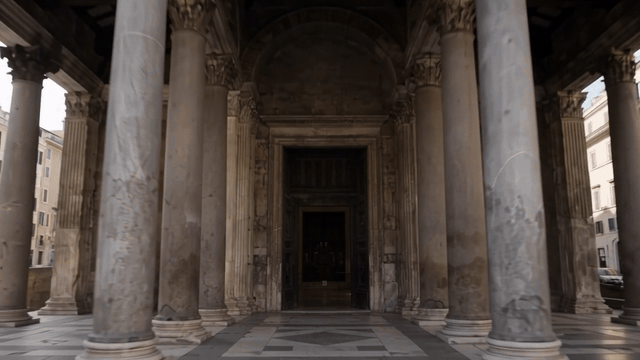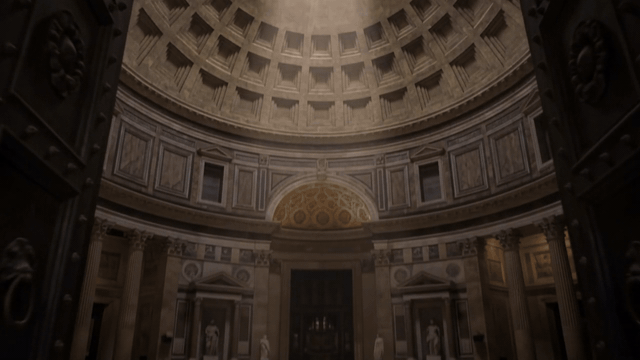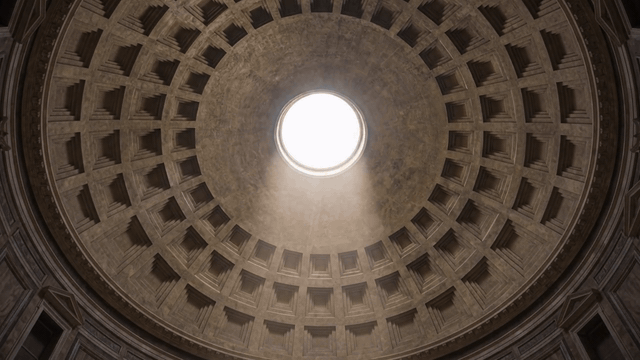
Wygenerowane przejście przechodzi od fasady przez portyk do widoku kopuły i okulusa.
Oceń klip po widocznych cechach i jakości przejścia, a nie po dokładności geograficznej. Fasada, portyk i kopuła są rozpoznawalne, a punkt widzenia przesuwa się w stronę wejścia, po czym patrzy w górę wewnątrz. Wynik jest wizualizacją AI opartą na zdjęciach, a nie materiałem dokumentalnym ani wiarygodnym pomiarem architektonicznym. Ustawienie pierwszej i ostatniej klatki odpowiedziałoby na inne pytanie: jak połączyć dwa narzucone obrazy jako punkty końcowe.
Trzy role referencyjne w jednym 15-sekundowym ujęciu
Porównanie filiżanek testuje produkt, miejsce i rekwizyt. To dodatkowe ujęcie daje trzem referencjom bardziej wymagające role: poruszające się zwierzę, kolorowe środowisko i ruchomą grupę, która wchodzi później. Pytanie brzmi, czy wszystkie trzy pozostają czytelne, gdy kamera podąża za akcją, zamiast pojawiać się tylko w pojedynczych klatkach.
Obraz 1 to zdjęcie zielonego żółwia morskiego z Wikimedia Commons dla szerokiego pancerza, głowy i płetw żółwia. Obraz 2 to zdjęcie rafy koralowej z Wikimedia Commons dla różowych i kremowych kształtów koralowców oraz czystej wody. Obraz 3 to zdjęcie ławicy ryb o żółtych ogonach z Wikimedia Commons dla ciał ryb i ruchu grupowego. Każda strona pliku oznacza swoje zdjęcie jako domena publiczna. Źródła pochodzą z różnych miejsc, więc wygenerowana scena jest konceptem wizualnym, a nie zapisem jednej prawdziwej rafy.
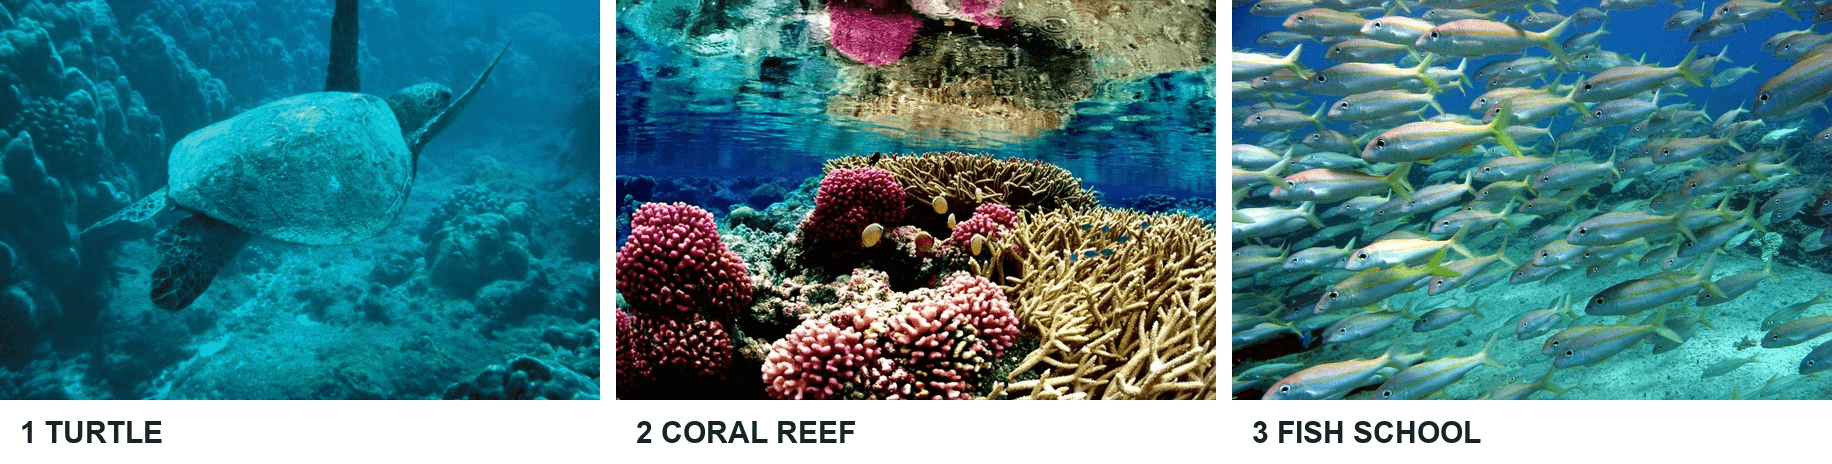 Trzy przesłane pliki dają modelowi podmiot, scenerię i grupę, która powinna wejść do ujęcia później.
Prześlij je w tej kolejności w Reference-to-Video. Wybierz 15 sekund, 16:9, 1080p i domyślny tryb thinking. Użyj tego promptu:
plaintext1Create a 15-second, single continuous underwater concept film using the three uploaded photographs as references in their exact upload order. The first image defines one green sea turtle: preserve its broad mottled oval shell, head, and four flippers, but ignore that photo's background. The second image defines the setting: vivid pink and cream branching corals, rounded coral heads, clear turquoise water, and rippling sunlight; it is not a mandatory first frame. The third image defines a dense school of slender silver fish with yellow tails; use the fish as moving animals, not as a background texture or a copy of their original seabed. In the opening five seconds, the turtle swims forward above the colorful reef with visible flipper strokes while the camera tracks alongside it. In the middle five seconds, the yellow-tailed fish school sweeps across the frame and curves around the turtle as the camera rises to a three-quarter overhead view. In the final five seconds, the camera widens and arcs to show the same turtle, reef, and fish school together in one coherent underwater space. Keep the turtle's shell pattern and the fish appearance consistent throughout. Show real subject movement, water particles, soft sunbeams, and clear parallax. Smooth camera movement, no cuts, no teleporting, no spinning turtle, no additional turtles, no text, logos, or narration. This is a generated visualization, not documentary footage.
Wygenerowany 15-sekundowy klip zaczyna się od żółwia nad koralowcami, a następnie wprowadza ławicę żółtych ogonów do tej samej ruchomej sceny.
Plamisty pancerz i płetwy żółwia pozostają rozpoznawalne od początku do końca. Różowy koralowiec jest najwyraźniejszy w pobliżu początku; srebrne ryby z żółtymi ogonami wchodzą około połowy i później dzielą kadr z żółwiem. Kamera podąża i poszerza ujęcie, choć żądany widok z góry nie jest wyraźnie ustanowiony. Ten pojedynczy wynik pokazuje trzy role referencyjne działające razem, a jednocześnie pokazuje, gdzie instrukcja kamery w prompcie została tylko częściowo wykonana.
Napraw dryf referencji bez restartowania całego pomysłu
Gdy filiżanka zmienia kształt, zidentyfikuj dokładną klatkę, w której to następuje. Jeśli uchwyt znika tylko wtedy, gdy zasłania go dłoń, może to być zasłonięcie. Jeśli wraca po niewłaściwej stronie lub profil krawędzi zmienia się po odstawieniu filiżanki, tożsamość produktu uległa dryfowi. Powiększ filiżankę i zwiększ jej wyrazistość w referencji, uprość podnoszenie lub określ punkt widzenia, który pozostawia uchwyt widoczny. Zachowaj poprzedni wynik, aby móc stwierdzić, czy zmiana pomogła.
Jeśli sceneria przeskakuje między kawiarniami, sprawdź zestaw źródłowy pod kątem sprzecznych pomieszczeń, oświetlenia lub podobnych obiektów. Zastąp słaby obraz sceny lub usuń referencję, która dostarcza niepożądanych mebli. W prompcie określ, który obraz odpowiada za blat i które elementy wizualne zignorować. Dłuższa lista instrukcji negatywnych może tworzyć więcej niejednoznaczności; jedno precyzyjne stwierdzenie roli jest zwykle łatwiejsze do przetestowania.
Jeśli ostatnie sekundy tracą szczegóły, skróć akcję, zamiast dodawać więcej rzeczowników. Poproś o jedną ciągłą orbitę i niewielkie podniesienie, zanim spróbujesz dłuższej sekwencji z kilkoma przejściami. W informacji o premierze Google napisano, że model obsługuje edycję uzupełniającą, ale nie zakładaj, że edycja zachowa każdy nietknięty szczegół. Sprawdź edycję tymi samymi kontrolami początku, środka i końca.
Zmieniaj jedną zmienną na próbę: wybór referencji, brzmienie promptu, czas trwania lub zadanie kamery. Prowadź dziennik dokładnych plików i ustawień. To zamienia rozczarowujący wynik w wykonalną diagnozę i zapobiega pomyleniu szczęśliwej klatki z konsekwentną kontrolą.
Limity, koszt i gdzie to wypróbować
Google ogłosiło Gemini Omni 1.2 Flash 5 listopada 2026, z natywnymi klipami do 15 sekund. Strona modelu Atlas Cloud Reference-to-Video obecnie wymienia 1–10 obrazów referencyjnych, wybory czasu trwania 3–15 sekund, proporcje 16:9 lub 9:16 oraz opcje wyjścia 360p, 720p, 1080p i 4K. Opcje 1080p i 4K są powiększane z natywnie generowanych klatek. Limity danych wejściowych mogą się różnić w zależności od ścieżki dostępu, więc sprawdź pole w używanym interfejsie. Ten przewodnik potrzebuje tylko 1, 2 lub 3 obrazów.
W przypadku dokładnych przykładów użyj strony modelu podlinkowanej w przepływie pracy i sprawdź jej aktualną wycenę przed każdym uruchomieniem. Publiczny katalog modeli Atlas Cloud zapewnia drugie miejsce do sprawdzenia dostępności i aktualnych cen. Stawka nagłówkowa za sekundę może nie opisywać każdej rozdzielczości lub warunku konta, więc planuj budżet na podstawie faktycznie wybranych ustawień, zamiast kopiować cenę premierową do planu produkcyjnego.
Praktycznym następnym krokiem dla Gemini Omni 1.2 Flash multiple reference images jest uruchomienie najpierw testu bazowego filiżanki. Zapisz jego dokładny prompt i wynik. Dodaj kawiarnię i ziarna dopiero wtedy, gdy potrafisz wskazać, którego szczegółu brakuje w teście bazowym, a następnie oceń pełny klip ruchu według czterech powyższych kontroli.
Często zadawane pytania
Czy mogę łączyć referencje obrazowe z klipem referencyjnym ruchu?
Google opisuje wsparcie dla krótkich referencji ruchu, ale to inna mieszanka danych wejściowych niż testy ze statycznymi zdjęciami tutaj. Sprawdź limity i zasady czasu trwania konkretnego punktu wejścia przed ich łączeniem. Utrzymuj role obrazów jako jawne, nawet gdy ruch jest dostarczany osobno.
Czy model skopiuje moje zdjęcia referencyjne dokładnie?
Nie. Referencje kierują tożsamością, scenerią, rekwizytami lub stylem. Wygenerowana klatka może zmienić kąt kamery, oświetlenie, ukryte powierzchnie lub drobne szczegóły. Jeśli potrzebujesz dokładnej klatki początkowej, wybierz przepływ pracy z pierwszą klatką i nadal sprawdź resztę klipu.
Czy mogę używać cudzych zdjęć lub zasobów markowych?
Używaj materiałów, do których masz pozwolenie, i sprawdź ich licencję pod kątem zamierzonej publikacji. Strony plików źródłowych zdjęć w Wikimedia Commons podają warunki ponownego wykorzystania. Sprawdź każdą obowiązującą licencję przed publikacją. Ten status źródła nie przyznaje praw do niepowiązanych logotypów, osób lub zasobów, które możesz dodać później.


