Szybka odpowiedź
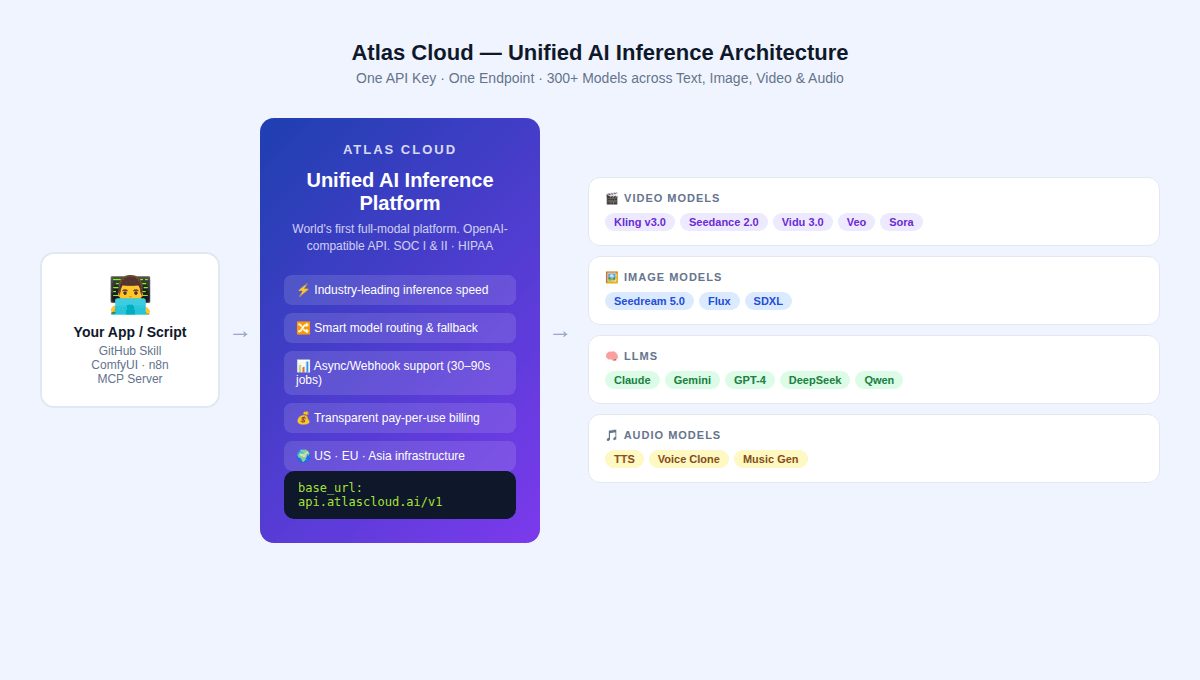
Skill generatora wideo AI na GitHub łączy Twój kod z modelami AI do generowania wideo. W 2026 roku wybór między open-source (bezpłatny, samodzielnie hostowany) a płatnymi API (w chmurze, natychmiastowe) zależy od czterech zmiennych: dostępności VRAM, wymagań dotyczących prywatności danych, wymaganego pułapu jakości i miesięcznej liczby generowanych filmów. W przypadku przepływów produkcyjnych na dużą skalę, które wymagają wielu modeli SOTA, Atlas Cloud (atlascloud.ai) zapewnia dostęp do ponad 300 modeli – w tym Kling v3.0, Seedance 2.0, Vidu 3.0, Veo i Sora – za pomocą jednego klucza API i przejrzystego modelu płatności za użycie.
Chcesz bezpośrednio porównać modele wideo stojące za tymi narzędziami? Porównanie modeli Atlas Cloud zestawia modele obrazu i wideo obok siebie na podstawie jednego promptu – z ceną widoczną przed wygenerowaniem.
-
Czym jest umiejętność generatora wideo AI? {#what-is-a-skill}
W kontekście repozytoriów GitHub, umiejętność generatora wideo AI (AI Video Generator Skill) to wielokrotnego użytku moduł, nakładka lub warstwa integracyjna, która łączy aplikację z backendem do generowania wideo AI – czy to samodzielnie hostowanym modelem open-source, czy API w chmurze.
Pomyśl o tym jako o abstrakcji między logiką aplikacji a rzeczywistym silnikiem wnioskowania. Umiejętność może być:
- Klasą Pythona opakowującą potok modelu
Wan 2.2do generowania tekstu na wideo - Niestandardowym węzłem ComfyUI łączącym się z API Atlas Cloud do generowania w modelu Kling v3.0
- Węzłem przepływu pracy n8n, który wywołuje Seedance 2.0 przez REST i zwraca adres URL wideo
- Narzędziem LangChain lub umiejętnością MCP Server, która na żądanie wywołuje punkt końcowy generowania wideo
Kluczowe pytanie, przed którym staje każdy programista budujący taką umiejętność: czy backend powinien być wagami open-source działającymi lokalnie, czy płatnym API w chmurze?
Prawdziwe dane z 2026 roku. Nie teoria.
-
GitHub open source w 2026 roku {#open-source-landscape}
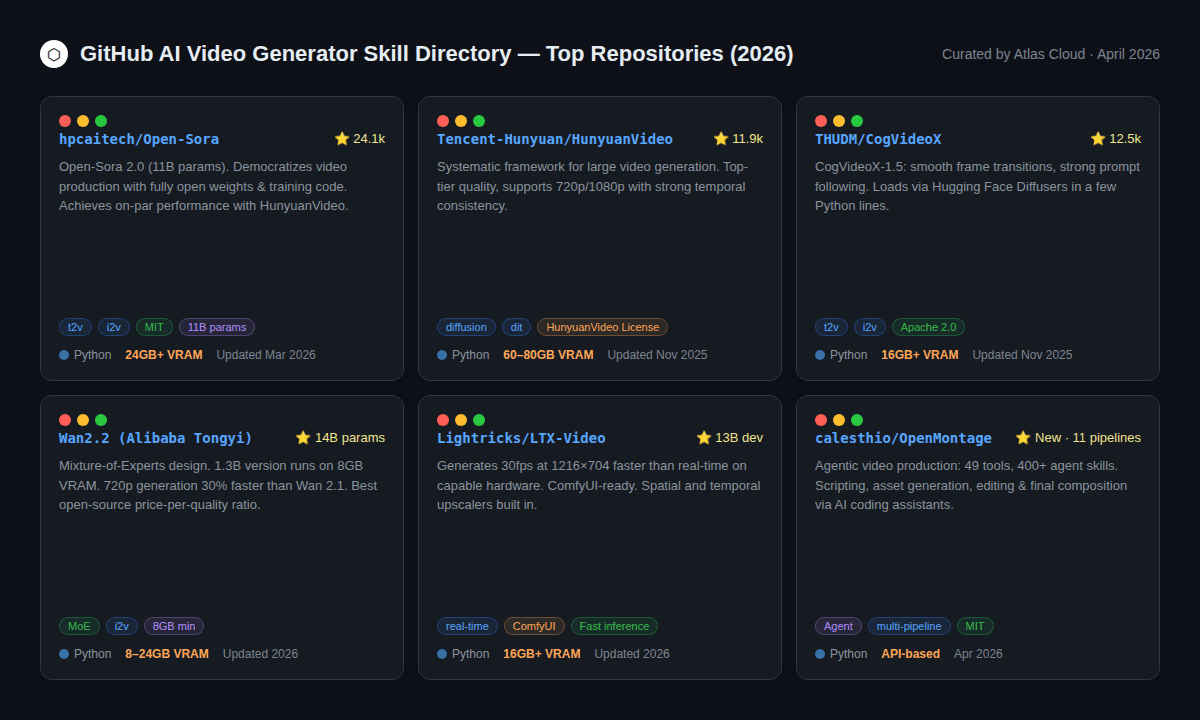
Ek system generowania wideo typu open-source znacznie dojrzał. Niektóre repozytoria są teraz prawdziwymi alternatywami dla płatnych API – przynajmniej w przypadku określonych zadań.
Poziom 1: Modele open-source klasy produkcyjnej
HunyuanVideo (Tencent, 11,9k ⭐) – Jeden z lepszych generatorów wideo open-source. Obsługuje 720p i 1080p. Głównym ograniczeniem są wymagania sprzętowe: 60–80 GB VRAM dla pełnego modelu, co czyni go dostępnym tylko dla zespołów z dostępem do korporacyjnych GPU. Licencja społecznościowa pozwala na użycie komercyjne z podaniem autora.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) Wydany na licencji Apache 2.0, jest to jeden z najbardziej przyjaznych programistom otwartych modeli. Ładuje się natywnie przez Hugging Face Diffusers w kilku linijkach Pythona. Przejścia między klatkami są płynne, a podążanie za promptem jest silne. Wymaga minimum 16 GB VRAM. Dobry wybór, jeśli Twój zespół już korzysta z Hugging Face.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) Najbardziej oznaczony gwiazdkami projekt generowania wideo open-source na GitHub. Wersja 2.0 (11 miliardów parametrów) osiąga wydajność porównywalną z HunyuanVideo w testach porównawczych VBench, a koszt trenowania wyniósł około 200 000 dolarów – niezwykła kwota jak na model tej klasy. Tekst na wideo, obraz na wideo i generowanie o nieskończonej długości.
Poziom 2: Lżejsze opcje open-source (niższe VRAM)
Wan 2.2 (Alibaba Tongyi) Historia dostępności jest tu przekonująca: wariant 1,3B działa na 8 GB VRAM, a wariant 14B na 24 GB. Architektura MoE (Mixture-of-Experts) zapewnia lepsze szczegóły przy niższym koszcie obliczeniowym, a wersja 2.2 jest o 30% szybsza w 720p niż poprzedniczka. Dla programistów korzystających z pojedynczego, konsumenckiego GPU, Wan 2.2 jest najlepszą opcją open-source.
LTX-Video (Lightricks) Zaprojektowany przede wszystkim z myślą o szybkości. Generuje 30 klatek na sekundę w rozdzielczości 1216×704 szybciej niż w czasie rzeczywistym na wydajnym sprzęcie. Integracja z ComfyUI jest dojrzała, a skaler przestrzenny i czasowy są wbudowane.
Poziom 3: Potoki agentowe
OpenMontage (calesthio, nowy, kwiecień 2026) Prawdziwie nowatorska kategoria: agentowy system produkcji wideo z 11 potokami, 49 narzędziami i ponad 400 umiejętnościami agentów. Działa z asystentami kodowania AI, takimi jak Claude Code, Cursor i Copilot. Obsługuje cały potok – badania, scenariusz, zasoby, montaż – od początku do końca bez ręcznych kroków. Stworzony dla zespołów łączących wiele narzędzi AI w jeden przepływ pracy.
-
Katalog płatnych API: Modele SOTA dostępne teraz {#paid-api-directory}
Krajobraz płatnych API w 2026 roku definiują trzy główne rodziny modeli, każda z odrębnym podejściem technicznym. Wszystkie trzy są dostępne przez ujednolicone API Atlas Cloud.
Kling v3.0 (Kuaishou)
Wydany 5 lutego 2026 roku. Zbudowany na architekturze Multi-modal Visual Language – tekst, obrazy, dźwięk i wideo obsługiwane w jednym systemie.
Co faktycznie robi lepiej niż konkurencja:
- Złożony ruch ludzki – bieganie, taniec, sztuki walki – bez deformacji „makaronowych kończyn”, która nęka inne modele
- Wielojęzyczna, natywna generacja dźwięku (5 języków, w tym zsynchronizowany ruch warg)
- Pędzel ruchu (Motion Brush): narzędzie pozwalające programistom (lub użytkownikom końcowym) malować ścieżki ruchu bezpośrednio na obrazach źródłowych – funkcja, która obecnie nie ma odpowiednika w konkurencyjnych modelach
- Wiązanie elementów (Element Binding) dla spójnego śledzenia postaci i obiektów w różnych ujęciach
Gdzie odstaje: Szybkość renderowania jest wolniejsza niż u niektórych konkurentów w warstwie Pro. Przejścia w narzędziu storyboardu są według niezależnych recenzentów „toporne”.
Najlepsze do: Krótkich form wideo na TikToku i Reels, filmów produktowych e-commerce, wszystkiego, co wymaga dużej liczby filmów z postaciami, które pozostają spójne.
Seedance 2.0 (ByteDance)
Wydany 8 lutego 2026 roku, Seedance 2.0 reprezentuje zmianę paradygmatu w sposobie promowania wideo AI – od promowania wyłącznie tekstem do prawdziwej kontroli w stylu reżyserskim opartej na referencjach.
Główna innowacja techniczna: Seedance 2.0 akceptuje jednocześnie cztery rodzaje danych wejściowych – tekst, obraz, wideo i dźwięk. Jego system „Universal Reference” pozwala programiście podać referencyjne wideo tańczącej osoby, a model odtworzy ruch kamery, działania postaci i kompozycję w wygenerowanym materiale. Rozwiązuje to problem spójności postaci w sposób, którego czyste modele tekst-na-wideo nie są w stanie osiągnąć.
Niezależne testy potwierdzają, że model doskonale radzi sobie z:
- Wieloujęciowym opowiadaniem historii ze spójną tożsamością postaci między cięciami
- Zsynchronizowaną generacją dźwięku i wideo (architektura dwugałęziowa generuje dźwięk i wideo jednocześnie)
- Precyzyjnym odtwarzaniem kompozycji i oświetlenia z zasobów referencyjnych
Uwaga dotycząca dostępności: Od kwietnia 2026 roku międzynarodowy dostęp do API Seedance 2.0 jest możliwy za pośrednictwem platform takich jak Atlas Cloud. Bezpośredni dostęp do API BytePlus dla międzynarodowych programistów miał niespójności w dostępności – przed budowaniem zależności od bezpośrednich punktów końcowych ByteDance potwierdź aktualny status.
Najlepsze do: Teledysków, precyzyjnej animacji postaci, reklam produktowych, gdzie ruch musi być dokładny, agencji pracujących z przepływami pracy storyboard-na-wideo.
Vidu 3.0 (Shengshu AI / Tsinghua)
Zbudowany na oryginalnej architekturze U-ViT łączącej technologie dyfuzji i transformera, Vidu koncentruje się na obszarach, w których większość wideo AI wciąż ma problemy: spójności środowiska i kinowej konsekwencji.
Charakterystyczne cechy:
- Uniwersalny system referencyjny do spójnego oświetlenia w sekwencjach wieloujęciowych
- Inteligentna generacja muzyki w tle, która automatycznie dostosowuje się do nastroju sceny
- Generowanie długich form z silną spójnością czasową (kluczowe w sekwencjach dłuższych niż 5 sekund)
Najlepsze przypadki użycia: Profesjonalne przepływy pracy w filmie, projektowanie animacji, kreatywna reklama wymagająca kinowej jakości.
Sora 2 (OpenAI)
Sora 2 pozostaje punktem odniesienia dla dokładności symulacji fizyki. Rozbij szkło w prompcie Sory 2, a wzór pęknięcia, fizyka płynów i odbicia zachowują się jak w rzeczywistości – większość konkurentów wciąż nie może dorównać temu poziomowi spójności.
Najlepsze do: Efektów wizualnych (VFX), wizualizacji architektonicznych, materiału uzupełniającego (B-roll) do filmów dokumentalnych – wszędzie tam, gdzie fizyczna dokładność jest ważniejsza niż oszczędność pieniędzy.
Cennik: Sora 2 generuje najwyższy rachunek w tej kategorii. Płacisz za moc obliczeniową.
-
Koszty wnioskowania: Prawdziwe liczby {#inference-costs}
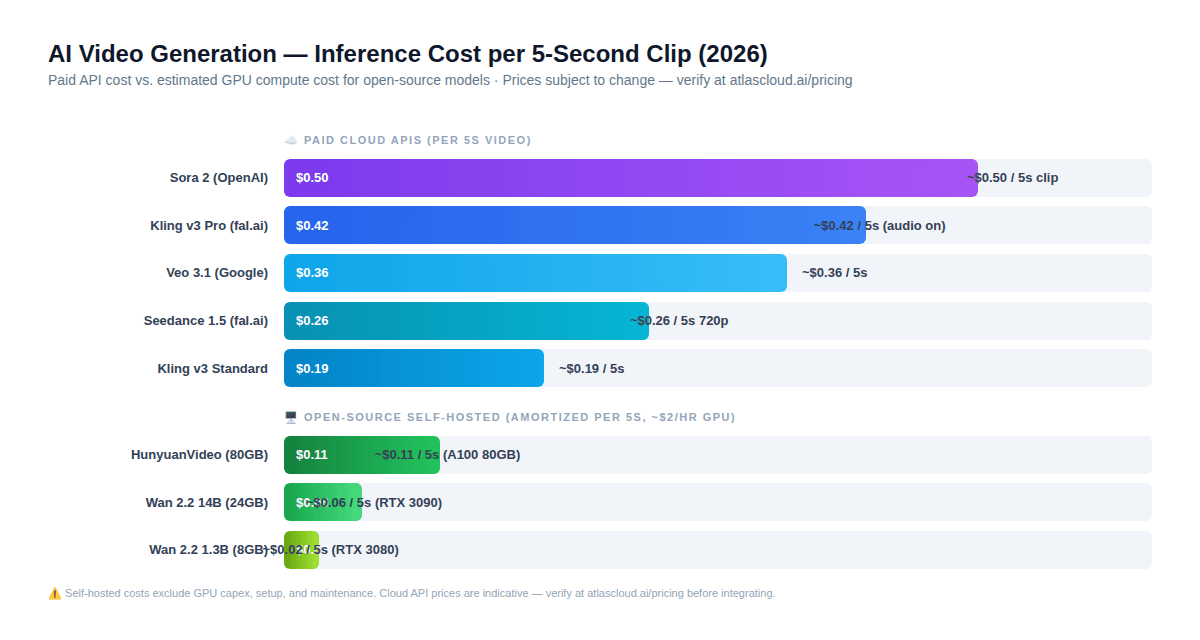
Ta sekcja zawiera najważniejsze, sprzeczne z intuicją odkrycie w całym przewodniku – takie, które zmienia domyślną intuicję większości programistów dotyczącą open-source w porównaniu z płatnymi API.
Ukryty koszt modeli hostowanych samodzielnie
Większość programistów zakłada: „Open-source = darmowe = zawsze tańsze”.
To założenie jest błędne w przypadku większości rozmiarów zespołów.
Oto jak wygląda rzeczywista matematyka dla 5-sekundowego klipu wideo w 2026 roku:
Samodzielnie hostowany open-source (zamortyzowany koszt GPU ~2 USD/godz.):
- Wan 2.2 1.3B (RTX 3080): ~0,02 USD za 5-sekundowy klip
- Wan 2.2 14B (RTX 3090): ~0,06 USD za 5-sekundowy klip
- HunyuanVideo (A100 80GB): ~0,11 USD za 5-sekundowy klip
Płatne API w chmurze (ceny orientacyjne – sprawdź na atlascloud.ai/pricing):
- Kling v3 Standard: ~0,19 USD za 5-sekundowy klip
- Seedance 1.5 720p z dźwiękiem: ~0,26 USD za 5-sekundowy klip
- Kling v3 Pro z dźwiękiem: ~0,42 USD za 5-sekundowy klip
- Sora 2: ~0,50 USD za 5-sekundowy klip
Liczby dla samodzielnego hostowania wyglądają zachęcająco w izolacji. Problem polega na tym, że nie uwzględniają one:
- 1. Sprzętu GPU – A100 80GB kosztuje 10–15 tys. USD. Przy 1000 filmów miesięcznie (~0,11 USD za sztukę) potrzebujesz ponad 9000 miesięcy, aby wyjść na zero na samym sprzęcie.
- Czasu konfiguracji – Konfiguracja CUDA, pobieranie wag modelu, zarządzanie VRAM i debugowanie to 20–40 godzin inżynieryjnych wstępnego ustawienia.
- Bieżącego utrzymania – Aktualizacje modeli, konflikty zależności i niezawodność infrastruktury to ciągłe koszty czasowe.
- Kosztu alternatywnego – Czas spędzony na infrastrukturze wnioskowania to czas nie poświęcony na produkt.
Praktyczny warunek graniczny:
Samodzielne hostowanie opłaca się tylko wtedy, gdy: (a) masz już GPU działające przy innych obciążeniach, (b) generujesz ponad 5000 filmów miesięcznie lub (c) przepisy zmuszają Cię do pozostania w środowisku lokalnym.
Poniżej tego progu płatne API – zwłaszcza ujednolicone platformy, takie jak Atlas Cloud – są tańsze, gdy całkowity koszt posiadania (TCO) jest obliczany uczciwie.
-
Ograniczenia szybkości i opóźnienia API – z czym faktycznie spotykają się programiści {#rate-limiting}
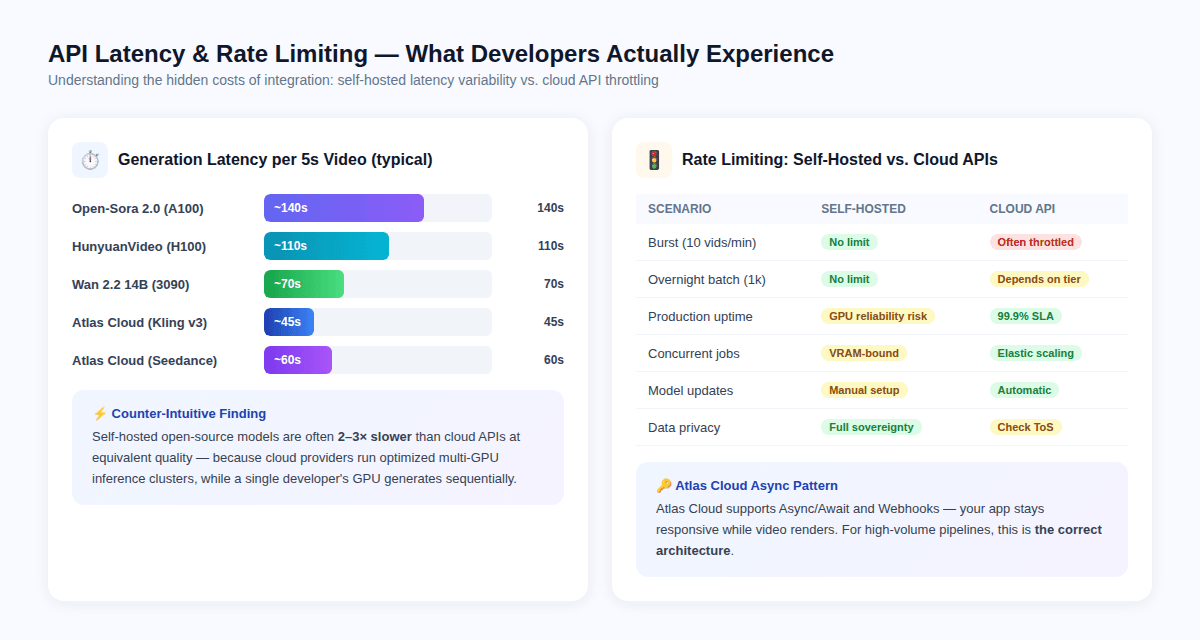
Paradoks opóźnień
Wbrew intuicji, API w chmurze są często szybsze na film niż modele hostowane samodzielnie – nie dlatego, że modele się różnią, ale dlatego, że dostawcy chmury uruchamiają zoptymalizowane klastry wnioskowania z wieloma GPU i sprzętowym przetwarzaniem wsadowym, podczas gdy pojedynczy programistyczny GPU generuje klatki sekwencyjnie.
Typowe opóźnienie dla 5-sekundowego klipu:
- Open-Sora 2.0 na A100: ~140 sekund
- HunyuanVideo na H100: ~110 sekund
- Wan 2.2 14B na RTX 3090: ~70 sekund
- Atlas Cloud / Kling v3: ~45 sekund
- Atlas Cloud / Seedance 2.0: ~60 sekund
Oznacza to, że zbudowanie umiejętności GitHub wokół modelu hostowanego samodzielnie może skutkować dłuższym czasem oczekiwania dla użytkownika końcowego, nawet jeśli koszt na film jest niższy.
Ograniczenia szybkości: Rzeczywistość produkcyjna
Modele hostowane samodzielnie nie mają ograniczeń szybkości narzuconych przez API – są ograniczone wyłącznie przez VRAM GPU i limity termiczne.
Płatne API egzekwują limity szybkości, które różnią się w zależności od poziomu cenowego. Istotne implikacje inżynieryjne:
- Żądania wsadowe (10+ filmów na minutę) spowodują ograniczenie przepustowości na większości poziomów płatnych API
- Zadania wsadowe na noc (1000+ filmów) wymagają starannego projektowania asynchronicznego, aby uniknąć przekroczenia czasu
- Równoczesne żądania na modelach hostowanych samodzielnie są ograniczone przez VRAM – uruchomienie 2 równoczesnych wnioskowań modelu 14B na jednej karcie 24 GB jest zazwyczaj niemożliwe
Atlas Cloud** rozwiązuje problem ograniczania szybkości** dzięki architekturze asynchronicznej/webhook: Twoja aplikacja przesyła zadanie generowania, otrzymuje identyfikator zadania i jest powiadamiana przez webhook po zakończeniu renderowania. Ten wzorzec zapobiega zawieszaniu się aplikacji podczas renderowania wideo i odpowiednio skaluje się dla obciążeń wsadowych.
Prawidłowa architektura dla produkcji
plaintext1# Wzorzec asynchroniczny Atlas Cloud – gotowy do produkcji 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Prześlij zadanie generowania 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Product showcase reel, smooth motion, 9:16 aspect ratio", 14 size="1080x1920", 15 n=1 16) 17 18# Obsłuż odpowiedź asynchroniczną 19video_url = response.data[0].url 20print(f"Video generated: {video_url}")
W przypadku przepływów pracy obraz-na-wideo (i2v) należy pamiętać, że niektóre modele – w tym niektóre warianty Kling i2v – nie akceptują oddzielnego parametru proporcji obrazu do generowania obraz-na-wideo; rozdzielczość wyjściowa jest zgodna z wymiarami obrazu wejściowego. Twórz generowanie obrazu nadrzędnego z prawidłowym docelowym współczynnikiem proporcji.
-
Hostowanie lokalne a API w chmurze: Macierz kompromisów {#local-vs-cloud}
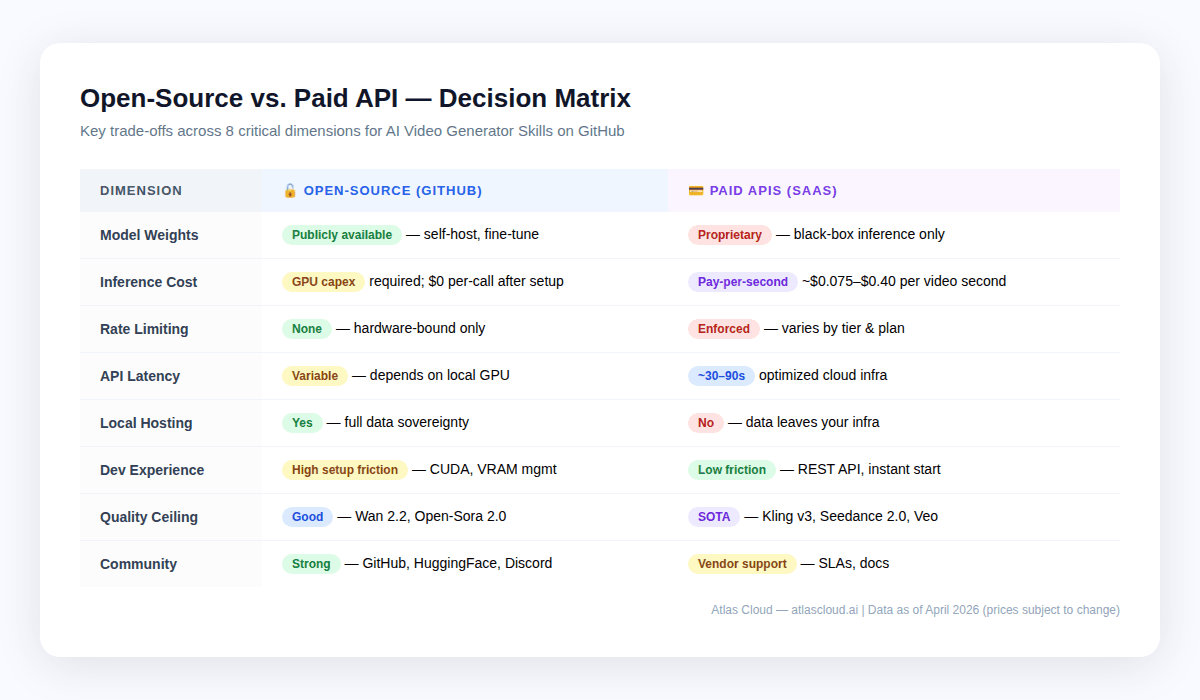
To nie jest wybór „albo-albo”. Większość potoków produkcyjnych miesza oba: open-source do prototypowania i tanich przebiegów masowych, API w chmurze do finalnych renderów i najwyższej jakości.
Kiedy lokalne ma sens
- Ograniczenia zgodności – HIPAA, RODO (GDPR) lub cokolwiek własnościowego, co nie może opuścić Twoich serwerów. Samodzielne hostowanie jest jedyną opcją. Atlas Cloud jest zgodny z HIPAA oraz certyfikowany SOC I i II, co spełnia większość potrzeb korporacyjnych, ale regulowane firmy powinny dwukrotnie sprawdzić swoje specyficzne wymagania.
- Bardzo duża ilość przy akceptowalnej jakości – zespoły generujące 10 000+ filmów miesięcznie na poziomie jakości Wan 2.2 mogą stwierdzić, że koszty wynajmu GPU są niższe niż opłaty API przy tej skali.
- Badania i dostrajanie – otwarte wagi modeli umożliwiają dostrajanie na własnych zestawach danych. Żadne API w chmurze nie oferuje obecnie niestandardowego trenowania modeli.
- Konfiguracje odizolowane (air-gapped) – wdrożenia brzegowe bez łączności lub w zamkniętych sieciach.
Kiedy API w chmurze wygrywają
- Czas wejścia na rynek – integracja z Atlas Cloud zajmuje godziny, nie tygodnie
- Najwyższa jakość – liderzy open-source, tacy jak Wan 2.2 i Open-Sora 2.0, wciąż ustępują modelom własnościowym, takim jak Kling v3 i Seedance 2.0, zwłaszcza w zakresie ruchu ludzkiego, utrzymania spójności ujęć i natywnego dźwięku
- Nierównomierne obciążenia – API w chmurze skalują się w górę i w dół; Twoje własne GPU nie
- Niższa ilość – poniżej ~5000 filmów miesięcznie API w chmurze zwykle wygrywają pod względem całkowitego kosztu
- Elastyczność wielu modeli – katalog ponad 300 modeli Atlas Cloud oznacza, że możesz przełączać się z Kling na Seedance na Veo w ramach jednej integracji
-
Rozwój kierowany przez społeczność a rozwój kierowany przez dostawcę {#community-vs-vendor}
Łatwo to zignorować przy porównywaniu API, ale ma to znaczenie, jeśli budujesz umiejętności GitHub.
Kierowany przez społeczność (open-source):
- Każdy może zgłaszać poprawki błędów i proponować funkcje – i mogą one zostać wdrożone
- Dokumentacja jest często doskonała, ponieważ społeczność użytkowników wnosi przykłady
- Zmiany przełomowe w API modeli zachodzą powoli, z publicznymi okresami wypowiedzenia
- Społeczności ComfyUI i Hugging Face Diffusers mają głębokie biblioteki gotowych przepływów pracy, adapterów LoRA i dostrojonych punktów kontrolnych (checkpoints)
- Artykuły badawcze są publikowane z otwartym, powtarzalnym kodem
Rozwój kierowany przez dostawcę (płatne API):
- Stabilność API jest regulowana komercyjnymi umowami SLA – zmiany przełomowe zdarzają się rzadziej, ale się zdarzają
- Nowe wydania modeli (np. Kling 3.0 w lutym 2026, trzy dni przed Seedance 2.0) pojawiają się w tempie konkurencyjnym i często bez wcześniejszego powiadomienia
- Ulepszenia modeli są wdrażane po stronie serwera, bez konieczności podejmowania działań przez programistę
- Dokumentacja techniczna jest profesjonalnie utrzymywana
Praktyczna implikacja dla autorów umiejętności GitHub: jeśli piszesz umiejętność, która ma pozostać stabilna i wymagać mało konserwacji, API w chmurze ze stabilnymi kontraktami punktów końcowych jest łatwiejsze w utrzymaniu niż umiejętność związana z konkretną wersją modelu open-source. Z drugiej strony, jeśli Twoja umiejętność ma zapewnić programistom dostęp do najnowszych modeli badawczych bez kosztów API, ekosystem open-source jest miejscem, gdzie taka praca ma miejsce.
-
Studium przypadku: Agencja mediów społecznościowych (500 filmów/miesiąc) {#case-study-1}
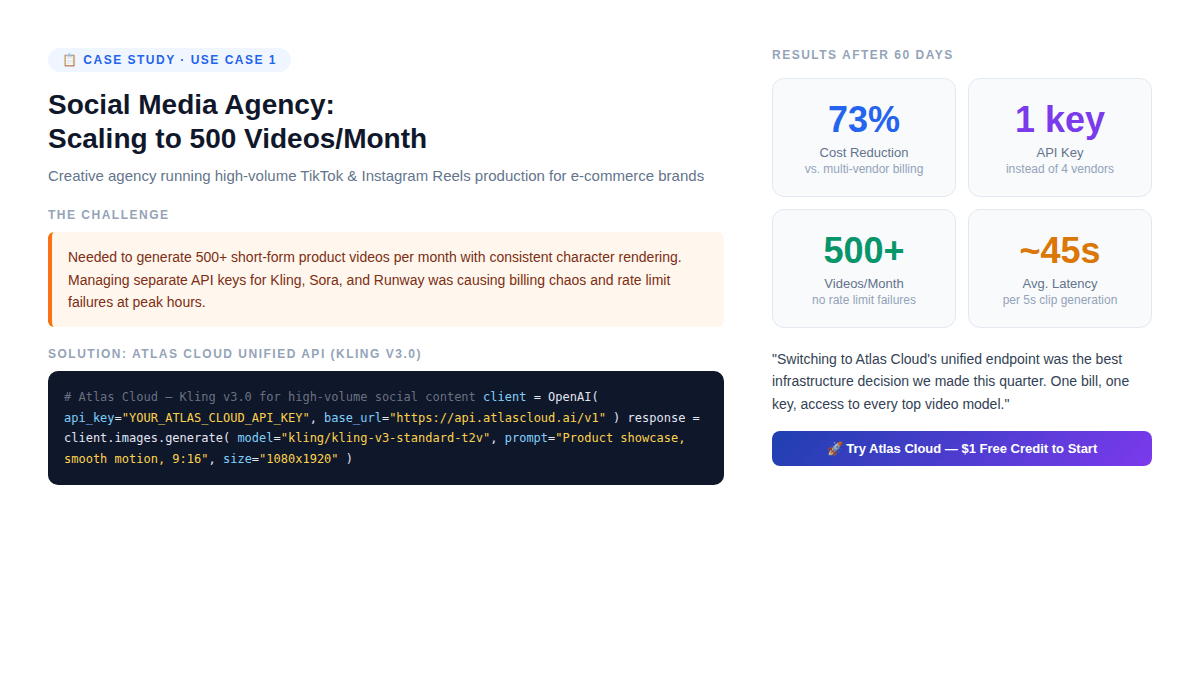
Konfiguracja: Kreatywna agencja robiąca krótkie filmy produktowe dla 20 klientów e-commerce. Potrzebują 500 filmów miesięcznie, postaci, które wyglądają tak samo we wszystkich klipach, pionowo 9:16, 5–10 sekund każdy, przetwarzane wsadowo poza godzinami szczytu.
Początkowa architektura (przed Atlas Cloud):
- Osobne klucze API dla Kling, RunwayML i Pika
- Trzy pulpity do rozliczeń, trzy pule ograniczeń szybkości
- Ręczny wybór modelu dla każdego klienta
- Awarie z powodu ograniczeń szybkości w godzinach szczytu powodujące opóźnienia w dostawie
Problem, który to stworzył: Kiedy Kling wydał v3.0, agencja musiała ponownie zintegrować nowy SDK, zaktualizować rozliczenia i przetestować kompatybilność – trzy razy dla trzech dostawców.
Rozwiązanie: Ujednolicone API Atlas Cloud z Kling v3.0 Standard
plaintext1# Atlas Cloud — Potok wideo dla mediów społecznościowych 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smooth motion, cinematic lighting, 9:16 vertical format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Wyniki po 60 dniach:
- 73% redukcji kosztu na film (pojedynczy rachunek, bez narzutów na dostawcę)
- Zero awarii z powodu ograniczeń szybkości (elastyczna infrastruktura Atlas Cloud wchłonęła szczyty obciążenia)
- Przełączanie modelu z Kling na Seedance dla konkretnych klientów zajmowało < 2 minuty (zmiana jednego parametru)
- Bonus 20% od pierwszego depozytu skutecznie zrównoważył koszty produkcji w pierwszym miesiącu
Nieoczywiste odkrycie: Agencja nie zmniejszyła liczby dostawców, ponieważ Kling stał się lepszy. Zmniejszyła ją, ponieważ zarządzanie wieloma relacjami z dostawcami przy 500 filmach miesięcznie ma niebagatelny koszt operacyjny, który nie pojawia się w cenach poszczególnych API.
-
Studium przypadku: Niezależny programista budujący SaaS wideo {#case-study-2}
Konfiguracja: Samotny programista budujący narzędzie „tekst na demo produktu” dla startupów na wczesnym etapie. Potrzebuje wielu stylów – kinowego, animowanego, aktorskiego. Musi szybko zweryfikować i utrzymać koszty infrastruktury poniżej 200 USD miesięcznie, jednocześnie sprawdzając, czy ktokolwiek w ogóle tego chce.
Decyzja architektoniczna:
Programista początkowo rozważał samodzielne hostowanie Wan 2.2 na wynajętej instancji A100 (~2 USD/godz.). Przy 100 testowych filmach podczas walidacji szacowany koszt wyniósł ~6 USD czasu GPU. Wydawało się to tańsze niż Atlas Cloud.
Czego zabrakło w kalkulacji:
- Skonfigurowanie potoku Wan 2.2 zajęło 3 dni (zależności CUDA, zarządzanie VRAM, konfiguracja serwera)
- Luka jakościowa Wan 2.2 w porównaniu z Kling v3 oznaczała, że SaaS nie mógł żądać zamierzonej ceny
- Zarządzanie czasem pracy serwera dodało ~2 godziny tygodniowo bieżącego utrzymania
Zmieniona architektura z Atlas Cloud:
plaintext1# Elastyczne kierowanie modelami — przełączanie na podstawie poziomu użytkownika 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Niższy koszt 4 "pro": "kling/kling-v3-professional-t2v", # Wyższa jakość 5 "enterprise": "bytedance/seedance-2.0" # Maksymalna kontrola 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Wynik: Programista uruchomił produkt w 4 dni zamiast 3 tygodni. Użycie Seedance 2.0 w warstwie premium uzasadniało 3-krotną premię cenową w stosunku do warstwy darmowej, a struktura warstwowa została zbudowana z jednym kluczem Atlas Cloud – a nie trzema oddzielnymi integracjami z dostawcami.
-
Przewaga Atlas Cloud: Dlaczego „jedno API” jest właściwą architekturą {#atlas-cloud-advantage}
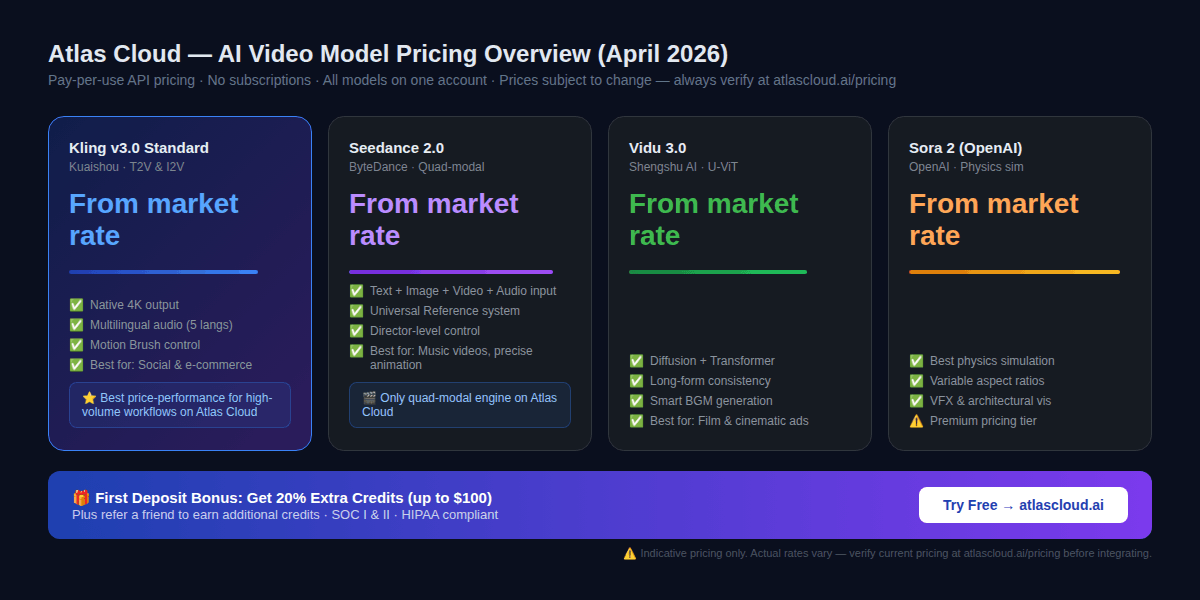
Atlas Cloud jest pozycjonowany jako pierwsza na świecie pełnomodalna platforma wnioskowania AI – ujednolicone API obsługujące ponad 300 modeli w zakresie generowania tekstu, obrazu, wideo i dźwięku.
Dla autorów umiejętności generatora wideo AI na GitHub, konkretne zalety to:
-
API kompatybilne z OpenAI (zamiennik typu drop-in)
Atlas Cloud używa punktu końcowego kompatybilnego z OpenAI. Jeśli Twoja umiejętność już integruje się z SDK OpenAI, przejście na Atlas Cloud do generowania wideo wymaga zmiany dwóch linii: api_key i base_url. Żaden nowy SDK, żaden nowy system uwierzytelniania.
-
Pojedyncze rozliczenie dla przepływów pracy z wieloma modelami
Produkcyjne przepływy pracy wideo rzadko używają jednego modelu. Typowy potok może używać:
- Seedream 5.0 do generowania obrazu (klatki początkowe)
- Kling v3.0 do konwersji obrazu na wideo
- LLM (Claude, GPT-4 lub DeepSeek) do optymalizacji promptów
- Modelu TTS do narracji lektora
Przy oddzielnych kontach dostawców to cztery relacje rozliczeniowe, cztery pule ograniczeń szybkości i cztery punkty integracji. Z Atlas Cloud to jeden klucz API i jedna faktura.
-
Przejrzystość cen na poziomie modelu
Atlas Cloud publikuje ceny dla poszczególnych modeli bez ukrytych opłat obliczeniowych. Model biznesowy jest prosty: płacisz za to, co generujesz. Nowi programiści otrzymują 20% bonusu od pierwszego depozytu (do 100 USD), a program poleceń zapewnia dodatkowe kredyty. Zawsze sprawdzaj aktualne ceny na atlascloud.ai/pricing przed budowaniem prognoz finansowych.
-
Zgodność z przepisami
Dla korporacyjnych umiejętności GitHub wdrażanych w regulowanych środowiskach: Atlas Cloud posiada certyfikację SOC I i II oraz jest zgodny z HIPAA, z infrastrukturą w regionach USA, UE i Azji. Obejmuje to większość wymagań dotyczących rezydencji danych w przedsiębiorstwach.
-
Integracja z ComfyUI, n8n i MCP Server
Atlas Cloud integruje się natywnie z narzędziami najczęściej używanymi do budowania umiejętności generowania wideo na GitHub:
- ComfyUI – niestandardowe węzły do wizualnego tworzenia przepływów pracy
- n8n – automatyzacja przepływów pracy z krokami generowania wideo Atlas Cloud
- MCP Server – integracja protokołu Model Context Protocol dla frameworków agentów AI
-
Którego stosu faktycznie powinieneś użyć? {#decision-guide}
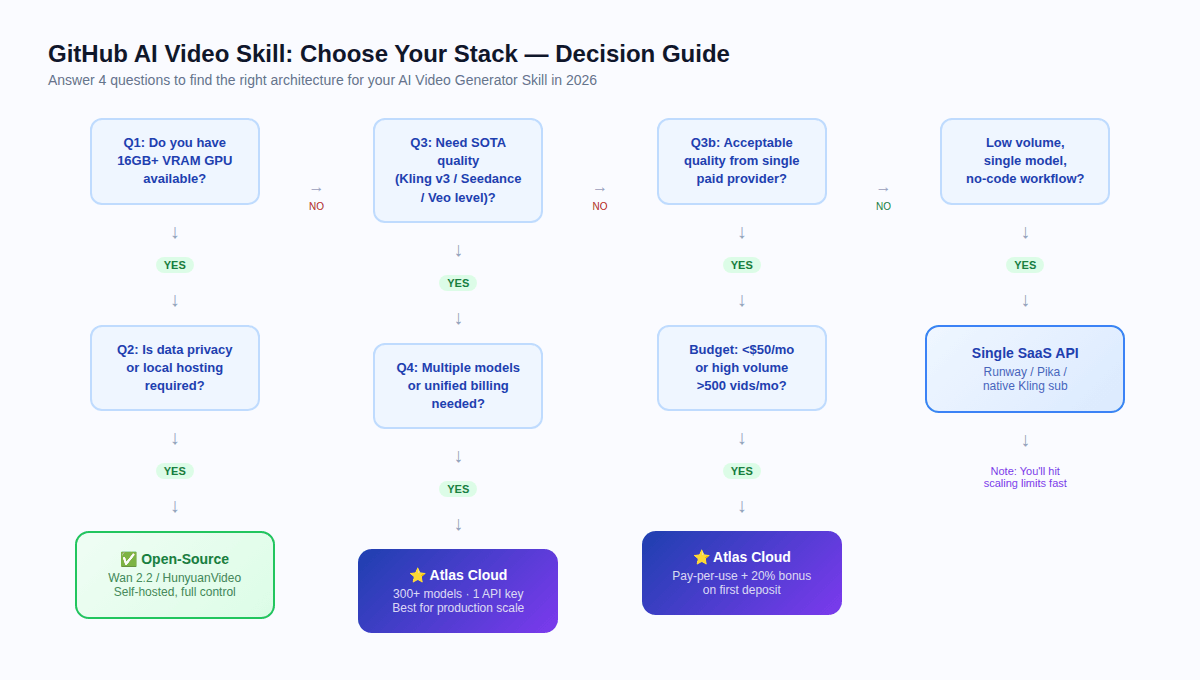
Przejdź przez te cztery pytania:
P1: Czy masz dostępny GPU z 16 GB+ VRAM?
Jeśli nie → całkowicie pomiń samodzielne hostowanie. API w chmurze to Twoja jedyna praktyczna ścieżka.
P2: Czy prywatność danych lub lokalne hostowanie jest wymagane przez przepisy?
Jeśli tak + dostępne GPU → rozważ open-source (Wan 2.2 lub HunyuanVideo w zależności od VRAM).
Jeśli tak + brak GPU → użyj Atlas Cloud (zgodny z HIPAA, certyfikowany SOC) i sprawdź swoje specyficzne wymagania regulacyjne.
P3: Czy wymagasz jakości SOTA (poziom Kling v3, Seedance 2.0, Veo)?
Jeśli tak → wymagane API w chmurze. Modele open-source mają znaczącą lukę jakościową w porównaniu z najlepszymi modelami własnościowymi w 2026 roku.
Jeśli akceptowalna jakość na poziomie open-source → samodzielne hostowanie Wan 2.2 może działać.
P4: Czy potrzebujesz wielu modeli lub ujednoliconego rozliczania?
Jeśli tak → Atlas Cloud. Zarządzanie trzema kontami dostawców na dużą skalę ma ukryty koszt operacyjny, który staje się widoczny dopiero przy wolumenie produkcyjnym.
Podsumowanie zaleceń według przypadku użycia
| Przypadek użycia | Zalecany stos technologiczny |
| Badania / prototypowanie | Open-source (Wan 2.2, CogVideoX) |
| Agencja mediów społecznościowych, 500+/mies. | Atlas Cloud + Kling v3.0 |
| Teledysk / animacja postaci | Atlas Cloud + Seedance 2.0 |
| Efekty wizualne / symulacja fizyki | Atlas Cloud + Sora 2 |
| Suwerenność danych / offline | Samodzielne hostowanie (HunyuanVideo, Open-Sora 2.0) |
| SaaS z warstwową jakością modeli | Atlas Cloud (jeden klucz, wiele modeli) |
| Wsadowe przetwarzanie open-source o dużej objętości | Samodzielne hostowanie Wan 2.2 (próg 10 000+/mies.) |
-
FAQ {#faq}
P: Czym jest umiejętność generatora wideo AI (AI Video Generator Skill)?
Wielokrotnego użytku moduł kodu lub warstwa integracyjna, która łączy aplikację z backendem do generowania wideo AI – albo wagami open-source, albo API w chmurze. Typowe formy: klasa Pythona, węzeł ComfyUI, przepływ pracy n8n, narzędzie MCP Server.
P: Jaka jest minimalna ilość VRAM do samodzielnego hostowania modelu wideo open-source?
8 GB VRAM dla Wan 2.2 1.3B (akceptowalna jakość dla krótkich klipów). 16 GB dla CogVideoX-1.5 lub Open-Sora (lepsza jakość). 24 GB+ dla Wan 2.2 14B. 60–80 GB dla HunyuanVideo lub pełnego modelu Open-Sora 2.0.
P: Czy generowanie wideo AI open-source jest faktycznie darmowe?
Wagi modeli są darmowe. Wnioskowanie nie jest darmowe – wymaga mocy obliczeniowej GPU. Przy niskim wolumenie (<5000 filmów miesięcznie) API w chmurze, takie jak Atlas Cloud, są zazwyczaj tańsze, gdy uwzględni się całkowity koszt posiadania.
P: Czy mogę używać Atlas Cloud do przepływów pracy obraz-na-wideo (i2v)?
Tak. Atlas Cloud obsługuje warianty i2v dla Kling, Seedance i Vidu. Uwaga: w przypadku modeli i2v niektóre warianty nie akceptują oddzielnego parametru proporcji obrazu – rozdzielczość wyjściowa jest zgodna z wymiarami obrazu wejściowego.
P: Jak Atlas Cloud radzi sobie z ograniczeniami szybkości?
Atlas Cloud obsługuje wzorce asynchroniczne/webhook. Zadania generowania wideo są przesyłane jako zadania; Twoja aplikacja otrzymuje identyfikator zadania i jest powiadamiana po zakończeniu renderowania. Zapobiega to blokowaniu na dużą skalę.
P: Jaki jest najlepszy model do zachowania spójności postaci w różnych ujęciach?
System Universal Reference modelu Seedance 2.0 jest najbardziej zaawansowanym rozwiązaniem w 2026 roku. Pozwala on podać referencyjne filmy, obrazy i dźwięk, aby utrzymać spójny wygląd i ruch postaci w wygenerowanych klipach.
P: Czy Atlas Cloud obsługuje ComfyUI?
Tak. Atlas Cloud ma natywną integrację z ComfyUI, a także węzły n8n i kompatybilność z MCP Server.
P: Jak modele wideo open-source radzą sobie z proporcjami obrazu?
Różnie w zależności od modelu. Open-Sora obsługuje 16:9, 9:16, 1:1 i 2.39:1 za pomocą flagi --aspect_ratio. Wan 2.2 i LTX-Video obsługują wiele proporcji. W przypadku przepływów pracy i2v większość modeli podąża za proporcjami obrazu wejściowego, niezależnie od określonych parametrów.
Podsumowanie
Krajobraz 2026 dzieli się na dwa obozy, każdy ze swoim słodkim punktem:
Open-source ma sens, jeśli masz wolne GPU, generujesz 10K+ filmów miesięcznie, dane nie mogą opuścić Twoich serwerów lub potrzebujesz dostroić model na własnym, zastrzeżonym materiale.
Płatne API są lepszym wyborem, jeśli potrzebujesz najlepszej dostępnej jakości, szybkość ma znaczenie bardziej niż koszt, generujesz poniżej 5K filmów miesięcznie lub chcesz mieszać wiele modeli bez żonglowania umowami z dostawcami.
Atlas Cloud** łączy te dwa światy:** jako ujednolicona platforma zapewniająca dostęp do 300+ modeli – w tym najlepszych modeli open-source przez hostowane wnioskowanie i każdego większego modelu własnościowego – za pomocą jednego klucza API kompatybilnego z OpenAI. Dla większości programistów budujących produkcyjne umiejętności generatora wideo AI na GitHub w 2026 roku jest to ścieżka o najmniejszym tarciu od prototypu do produkcji.
Informacje o cenach w tym artykule mają charakter orientacyjny i mogą ulec zmianie. Zawsze weryfikuj aktualne stawki na atlascloud.ai/pricing przed budowaniem prognoz finansowych. Dostępność modeli może się różnić w zależności od regionu.
Atlas Cloud: atlascloud.ai – Certyfikowany SOC I i II · Zgodny z HIPAA · Infrastruktura w USA, UE i Azji


