Klient Enterprise pyta, czy plan roczny można zwrócić po odnowieniu. Two asystent przeszukuje ogromny zbiór dokumentów i udziela zdecydowanego „tak". Podaje nawet cytat z polityki. Haczyk: wybrał wersję 4.1, zarchiwizowaną politykę, podczas gdy podpisany aneks i wersja 4.2 mówią coś innego.
Dlatego gpt-6 astra knowledge base best practices zaczynają się od dowodu. Nadaj modelowi hierarchię autorytetów, pobieraj wyłącznie autoryzowane, aktualne dowody i spraw, aby każde istotne twierdzenie wskazywało dokument, wersję i sekcję. Jeśli dowody się wykluczają lub się kończą, odpowiedź musi się zatrzymać.
GPT-6 Astra może działać w ramach File Search i okna kontekstowego o rozmiarze 1 050 000 tokenów, z maksymalnym wyjściem 128 000 tokenów. Pojemność pomaga w analizie. Nie rozstrzyga jednak, która polityka jest aktualna, który użytkownik może ją zobaczyć ani czy cytat rzeczywiście potwierdza pobliskie twierdzenie. ( Strona modelu OpenAI GPT-6 Astra, wrzesień 2026 )
Animowany przepływ pracy bazy wiedzy z priorytetem autorytetu
8-sekundowa wygenerowana wizualizacja przepływu pracy: podpisane nadpisanie i aktualna polityka pozostają w tacce dowodowej, podczas gdy zarchiwizowany plik jest widocznie odsuwany na bok. Ilustruje to zarządzanie źródłami, a nie rzeczywisty interfejs produktu ani dokument źródłowy.
Najważniejsze wnioski
- Zatwierdź autorytet źródła przed przesłaniem.
- Mierz osobno trafność wyszukiwania i wierność odpowiedzi.
- Filtruj według dostępu, statusu, daty i regionu przed wyszukiwaniem.
- Traktuj długi kontekst jako narzędzie analizy, a nie domyślny prompt.
- Eskaluj konflikty i brakujące dowody do ludzi.
Dlaczego bazy wiedzy GPT-6 Astra zawodzą przy 1 mln tokenów
Większość porażek zaczyna się przed udzieleniem odpowiedzi. Eksport z Dysku traktuje podpisany aneks, aktualną politykę, stare FAQ i wersję roboczą jako równie przeszukiwalną prozę. Zdolny model potrafi bardzo szybko zamienić ten chaotyczny zbiór w przekonujący akapit.
Cztery kontrole wychwytują typowe tryby awarii:
- Dryf autorytetu: nowsza polityka lub aneks klienta przegrywa z popularnym starym FAQ.
- Teatr cytowania: odpowiedź zawiera link do źródła, ale cytowany fragment nie potwierdza twierdzenia.
- Niekontrolowane eksperymenty: rozmiar fragmentu, top-k i budżet kontekstu zmieniają się jednocześnie, więc nikt nie wie, co przyniosło poprawę.
- Dryf dostępu: wyjątki regionalne, zastrzeżone wersje robocze lub prywatne notatki stają się dostępne dla niewłaściwego odbiorcy.
Praktycy legal-RAG, którzy omawiają ewaluację, mają zwyczaj oddzielać pytanie „czy wyszukiwanie znalazło wymagane źródło?" od pytania „czy odpowiedź zastosowała to źródło wiernie?". To rozdzielenie należy do każdej bramki wydania, także w wewnętrznym bocie wsparcia. ( dyskusja o bazie wiedzy legal w r/Rag, wrzesień 2026 )
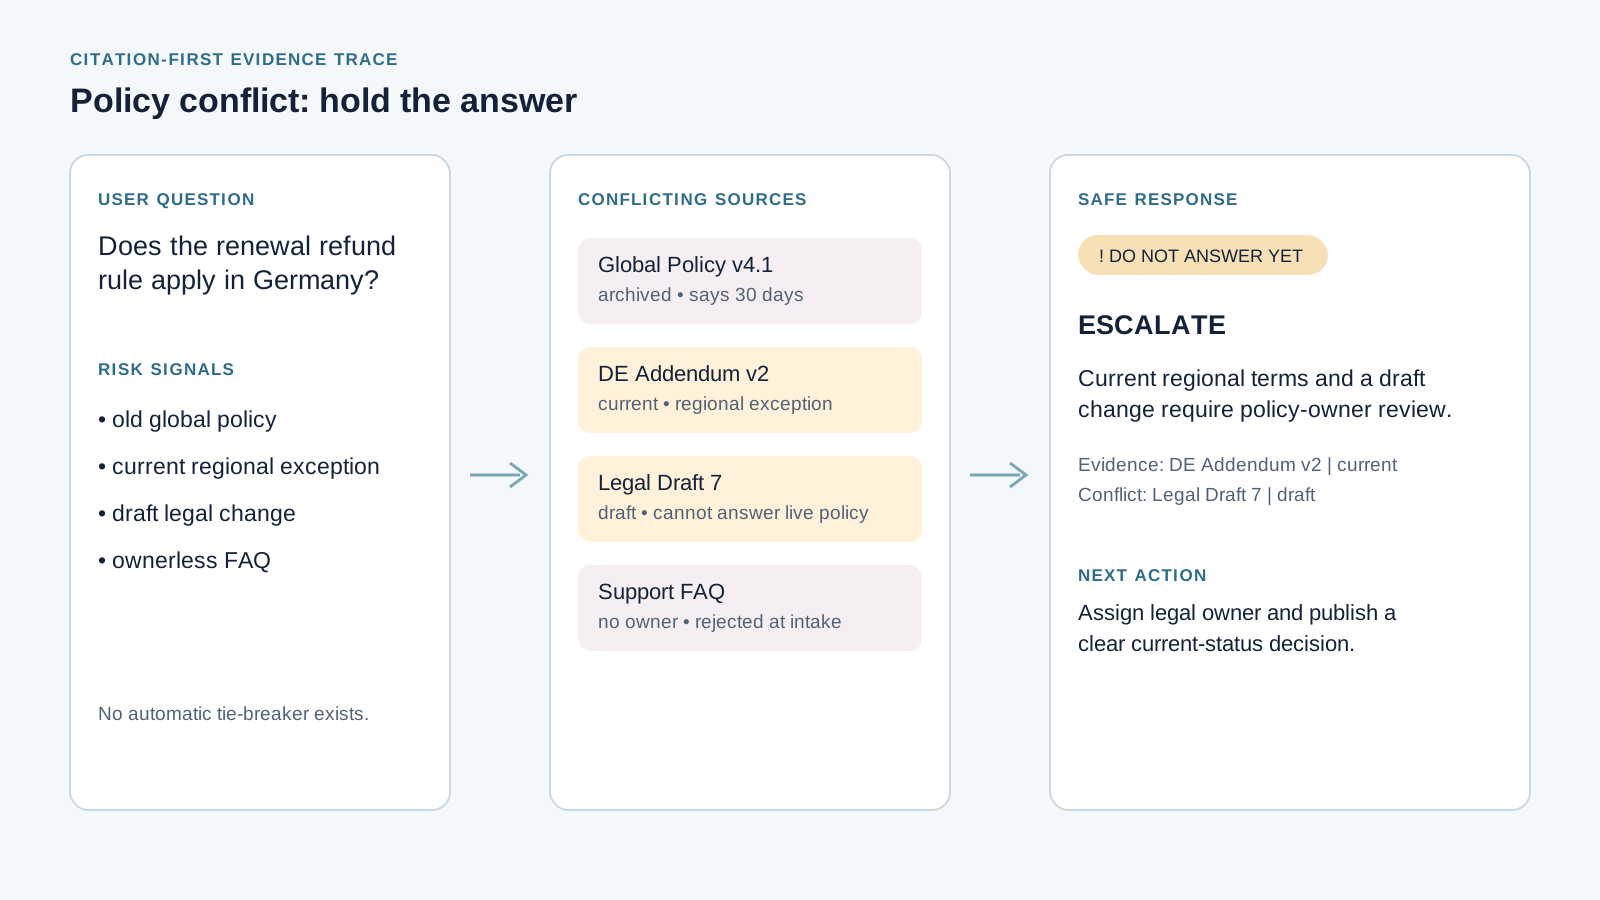
Ślad dowodowy konfliktu wersji bazy wiedzy z wynikiem wstrzymania się
Konflikt jest użytecznym wynikiem. Ten przypadek pokazuje, dlaczego system powinien zwracać „jeszcze nie odpowiadaj", zamiast po cichu wybierać między wersją roboczą, wyjątkiem regionalnym, starą polityką i plikiem bez właściciela.
Przepływ pracy, modele i koszt bazy wiedzy GPT-6 Astra
W pilotażu użyj jednej karty przeglądarki: zinwentaryzuj źródła, zatwierdź manifest autorytetów, znormalizuj pliki i metadane, pobierz niewielki zbiór dowodów, a następnie odpowiedz i oceń. Celem operacyjnym jest ścieżka dowodowa podlegająca przeglądowi, a nie sprytne demo czatu.
Dla zespołów porównujących resztę swojego stosu Atlas Cloud zapewnia miejsce do przeglądu aktualnych opcji modeli. Nie zakładaj, że katalog wymienia GPT-6 Astra, dopóki nie sprawdzisz tego w dniu publikacji.
| Warstwa | Rozwiązywany problem | Czego nie rozwiąże sama | Zasada pilotażu |
|---|---|---|---|
| Długi kontekst | Odczyt dużego pakietu analitycznego | Autorytet, uprawnienia, poparcie cytatem | Używaj do wyjątków i analizy |
| File Search | Pobranie niewielkiego zbioru źródeł | Zarządzanie wersjami | Filtruj przed wyszukiwaniem |
| Niestandardowe wyszukiwanie | Strojenie indeksowania i rankingu | Wierność odpowiedzi | Utrzymuj stały budżet kontekstu w testach |
| Eskalacja do człowieka | Rozstrzyganie konfliktów i spraw o dużym wpływie | Rutynowa skala | Zdefiniuj właściciela i czas odpowiedzi |
| Model lub narzędzie | Zadanie | Zalecane ustawienie | Publikowana cena do planowania |
|---|---|---|---|
| GPT-6 Astra | ocena konfliktów, synteza, ewaluacja | reasoning.effort: high | 10 USD/MTok wejście, 50 USD/MTok wyjście |
| OpenAI File Search | wyszukiwanie autoryzowanych dokumentów | filtry metadanych i cytaty | zweryfikuj opłaty za narzędzia przed uruchomieniem |
| Trasa modelu rutynowego | tagi i klasyfikacja niskiego ryzyka | najpierw test porównawczy | nie zakoduj na sztywno ceny |
| Katalog modeli Atlas Cloud | późniejsza eksploracja modeli | użyj bieżącego katalogu | Nie zakłada się dostępności Astry |
Zacznij od 20 do 50 pytań o wysokiej wartości i celowo niewygodnego zbioru dokumentów. Uwzględnij zastąpioną politykę, brakujący aneks, wyjątek regionalny i co najmniej jedno pytanie, które musi pozostać bez odpowiedzi.
Krok 1: Utwórz manifest autorytetów
Zanim cokolwiek prześlesz, zamień inwentarz w zatwierdzoną warstwę decyzyjną. Właściciel będący człowiekiem powinien zatwierdzić zwrócony JSON, zanim stanie się KB_MANIFEST.md. To pierwsza bariera ochronna przed bezbłędną odpowiedzią zbudowaną na wycofanym tekście.
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
Ustawienia: model gpt-6-astra; Responses API; reasoning.effort: high; ustrukturyzowane wyjście JSON. Do wstępnego przeglądu dostarcz tylko tytuł, właściciela, datę wejścia w życie, region, status i poziom dostępu.
Ukończone, gdy: każdy plik ma właściciela, datę, status i rangę, a Refund Policy v4.1 jest oznaczona jako zastąpiona przez v4.2.
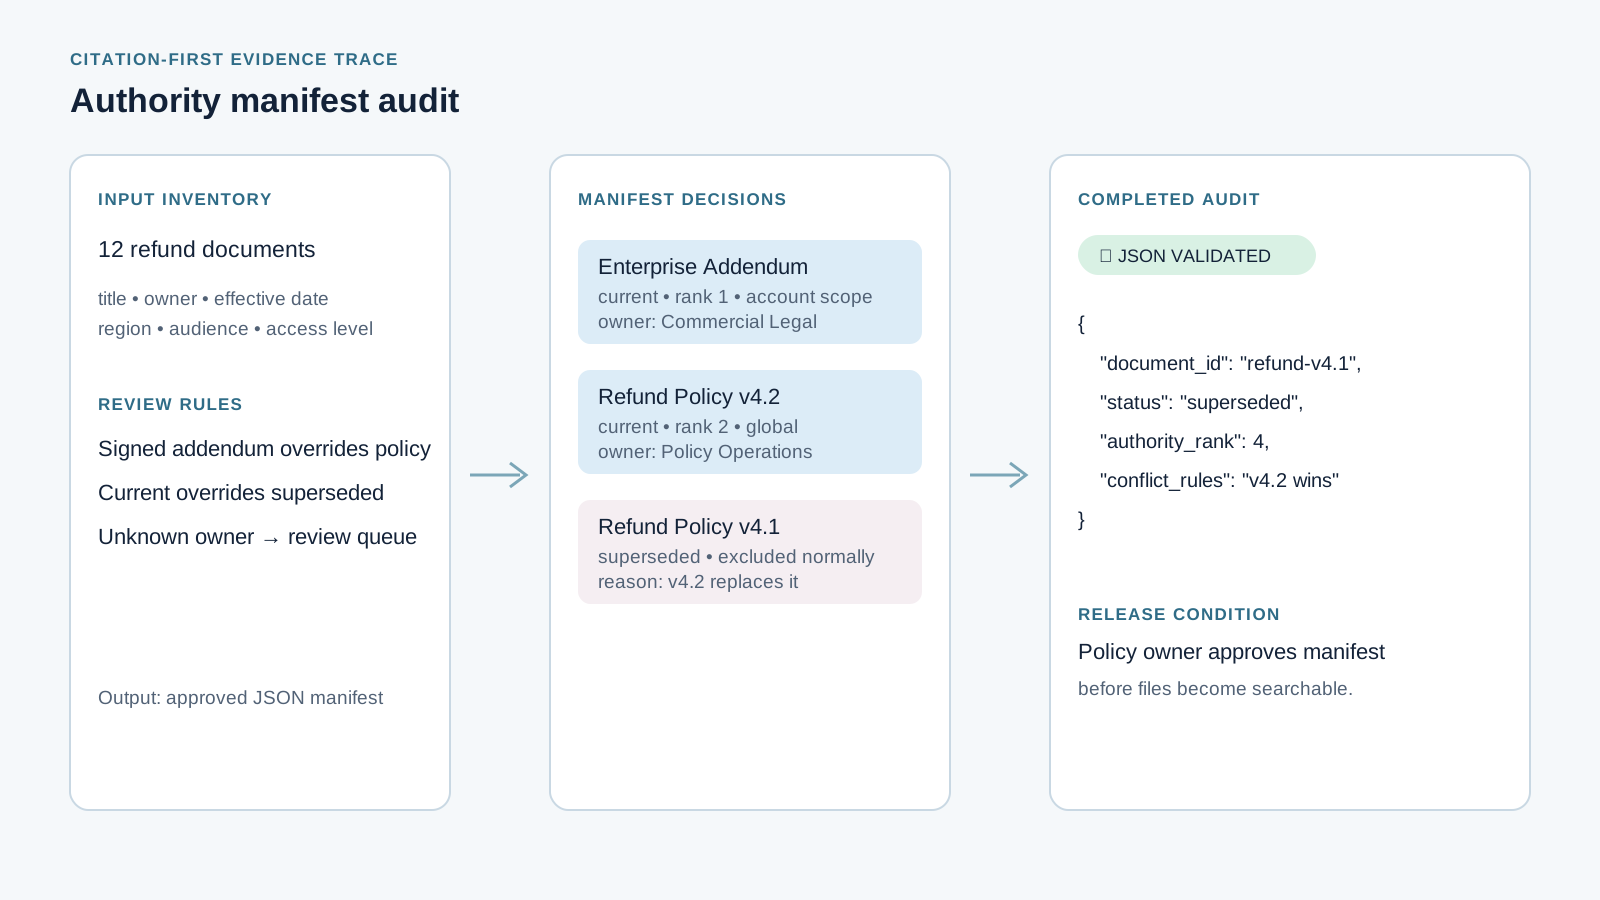
Audyt manifestu autorytetów z ukończonymi decyzjami JSON
Ukończony audyt manifestu autorytetów dla pilotażu zwrotów. Strona audytu odnotowuje zastąpioną wersję v4.1 i regułę nadpisania Enterprise.
Krok 2: Przygotuj bazę wiedzy GPT-6 Astra do wyszukiwania
Znormalizuj zatwierdzone źródła. Zachowaj nagłówki, warunki, znaczniki stron i dane o wersji. Usuń zduplikowane stopki, nawigację i pozostałości OCR. Nie przesyłaj dokumentu, który nie ma właściciela ani daty wejścia w życie.
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
Ustawienia: dołącz document_id, version, effective_date, status, region, audience i authority_rank jako metadane. Testy wyszukiwania rozpoczynaj od około 2000 tokenów łącznego pobranego kontekstu. Zmieniaj jedną zmienną naraz: strategię dzielenia na fragmenty albo liczbę wyników wyszukiwania, nigdy obie jednocześnie.
Ukończone, gdy: materiały zarchiwizowane są wyłączone z normalnych zapytań, a pliki bez znanego właściciela trafiają do kolejki przeglądu.
Kolejny przypadek ruchu uwidacznia decyzję sortowania: dwa zatwierdzone foldery źródeł pozostają razem w tacce autorytetów, podczas gdy niejednoznaczna wersja robocza przechodzi do osobnej ścieżki przeglądu. To ilustracyjna wizualizacja przepływu pracy, a nie rzeczywista odpowiedź GPT-6 ani interfejs produktu.
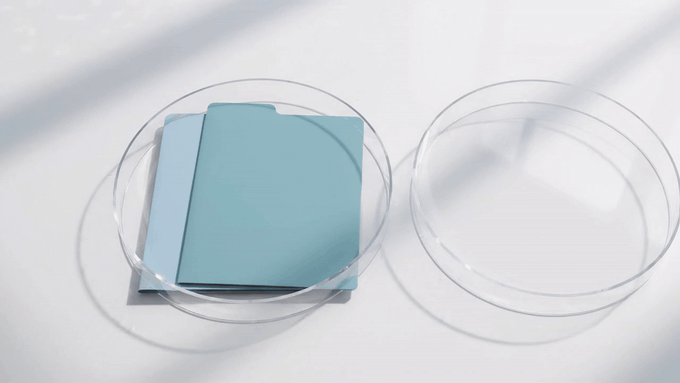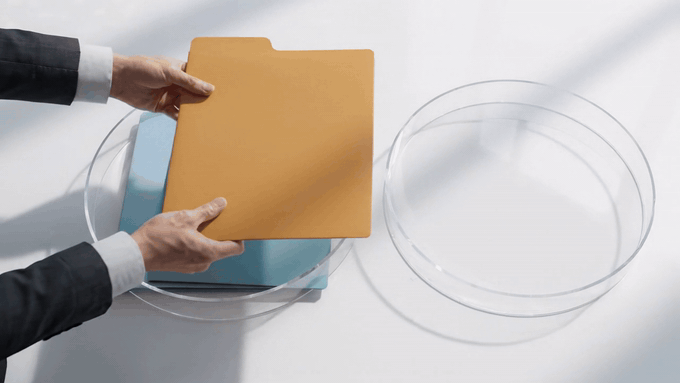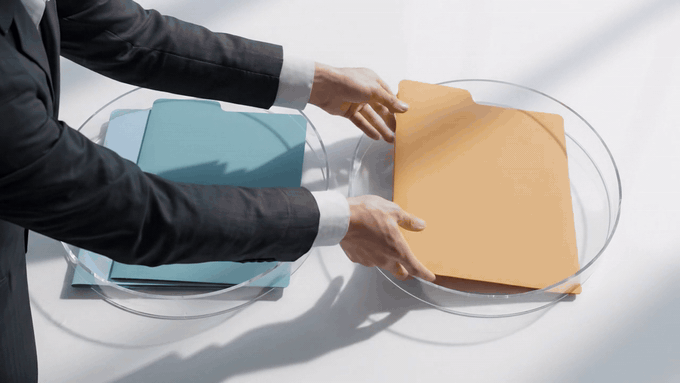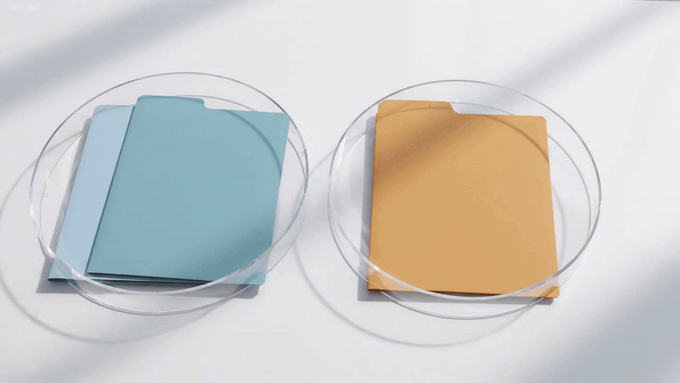
Animowane przekazanie dowodów do przeglądu przez człowieka
8-sekundowa wygenerowana wizualizacja przepływu pracy: zatwierdzone foldery źródeł pozostają razem, a nierozwiązany folder jest kierowany do przeglądu przez człowieka.
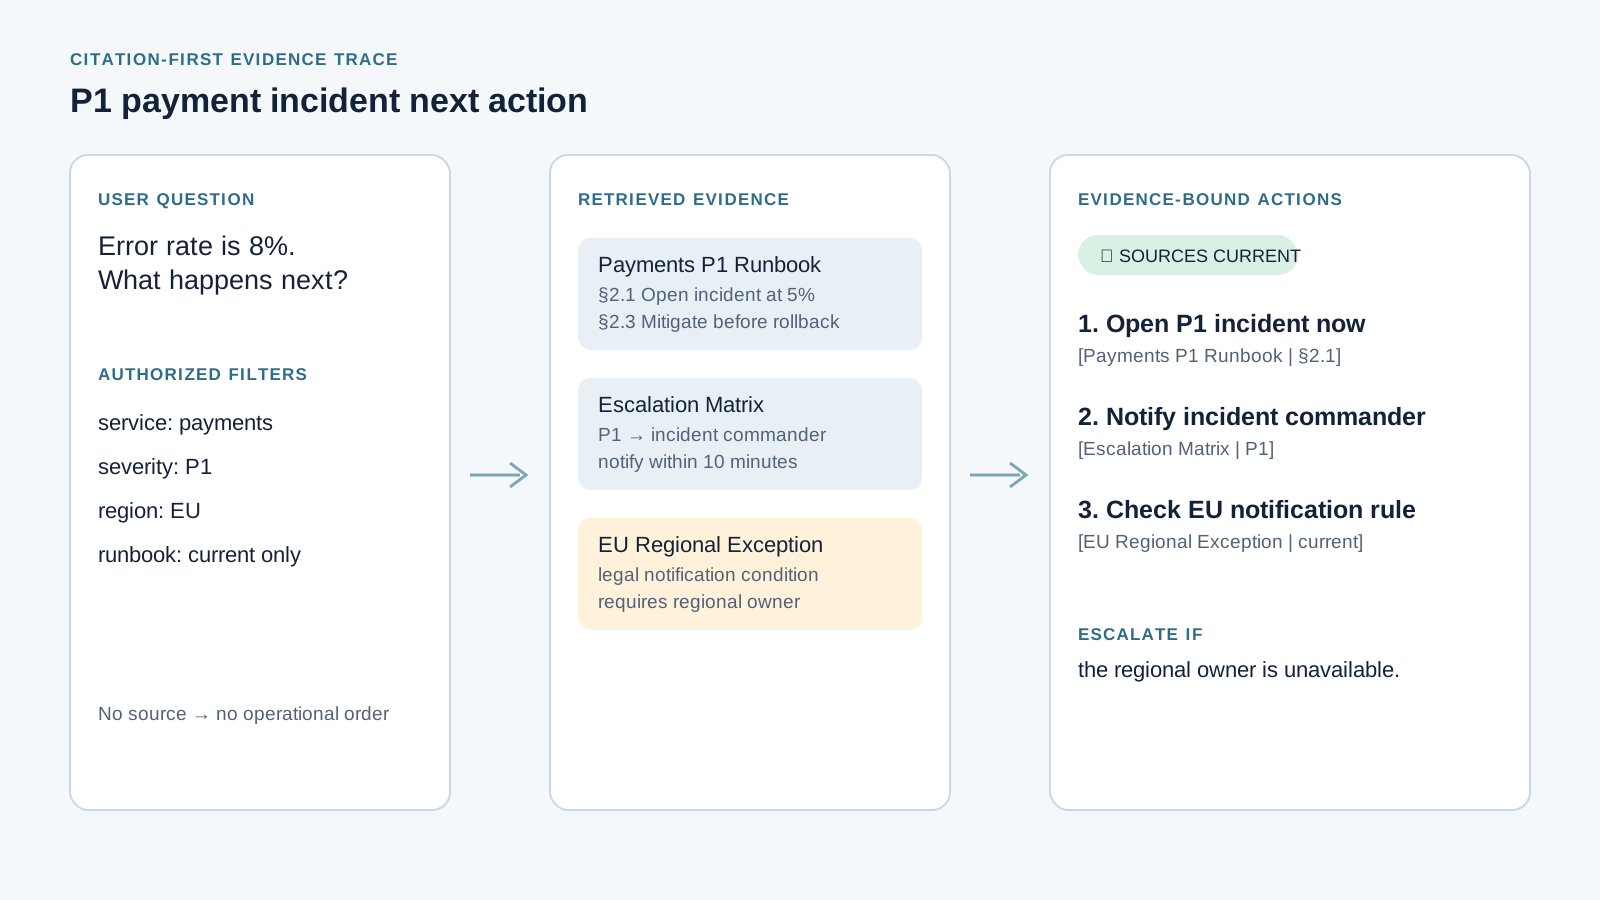
Ślad dowodowy incydentu płatniczego P1 z warunkiem eskalacji
Przypadek 2. Pytanie o błąd płatności przyciąga runbook dyżurny, macierz eskalacji i wyjątek regionalny. Odpowiedź wskazuje wyzwalacz dowódcy incydentu, zamiast improwizować plan odzyskiwania.
Krok 3: Poproś o odpowiedź opartą na dowodach
Powiąż generowanie odpowiedzi z pobranymi, autoryzowanymi dowodami. Model powinien oddzielać fakty, założenia i kolejne działania, aby recenzenci widzieli, gdzie system przestaje wiedzieć.
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
Ustawienia: użyj reasoning.effort: high i File Search. Przed wyszukiwaniem zastosuj filtry dla bieżącego statusu, uprawnień użytkownika, regionu i odbiorcy. Wywoływanie narzędzi należy do Responses API; aktualne wytyczne OpenAI zalecają też jasne warunki sukcesu i granice narzędzi dla przepływów pracy Astry. ( Wytyczne OpenAI dotyczące modeli, wrzesień 2026 )
Ukończone, gdy: odpowiedź cytuje aktualną politykę ogólną i podpisany aneks Enterprise, nigdy nie używa zarchiwizowanej wersji v4.1 jako reguły i zwraca INSUFFICIENT_EVIDENCE, jeśli aneks jest nieobecny.
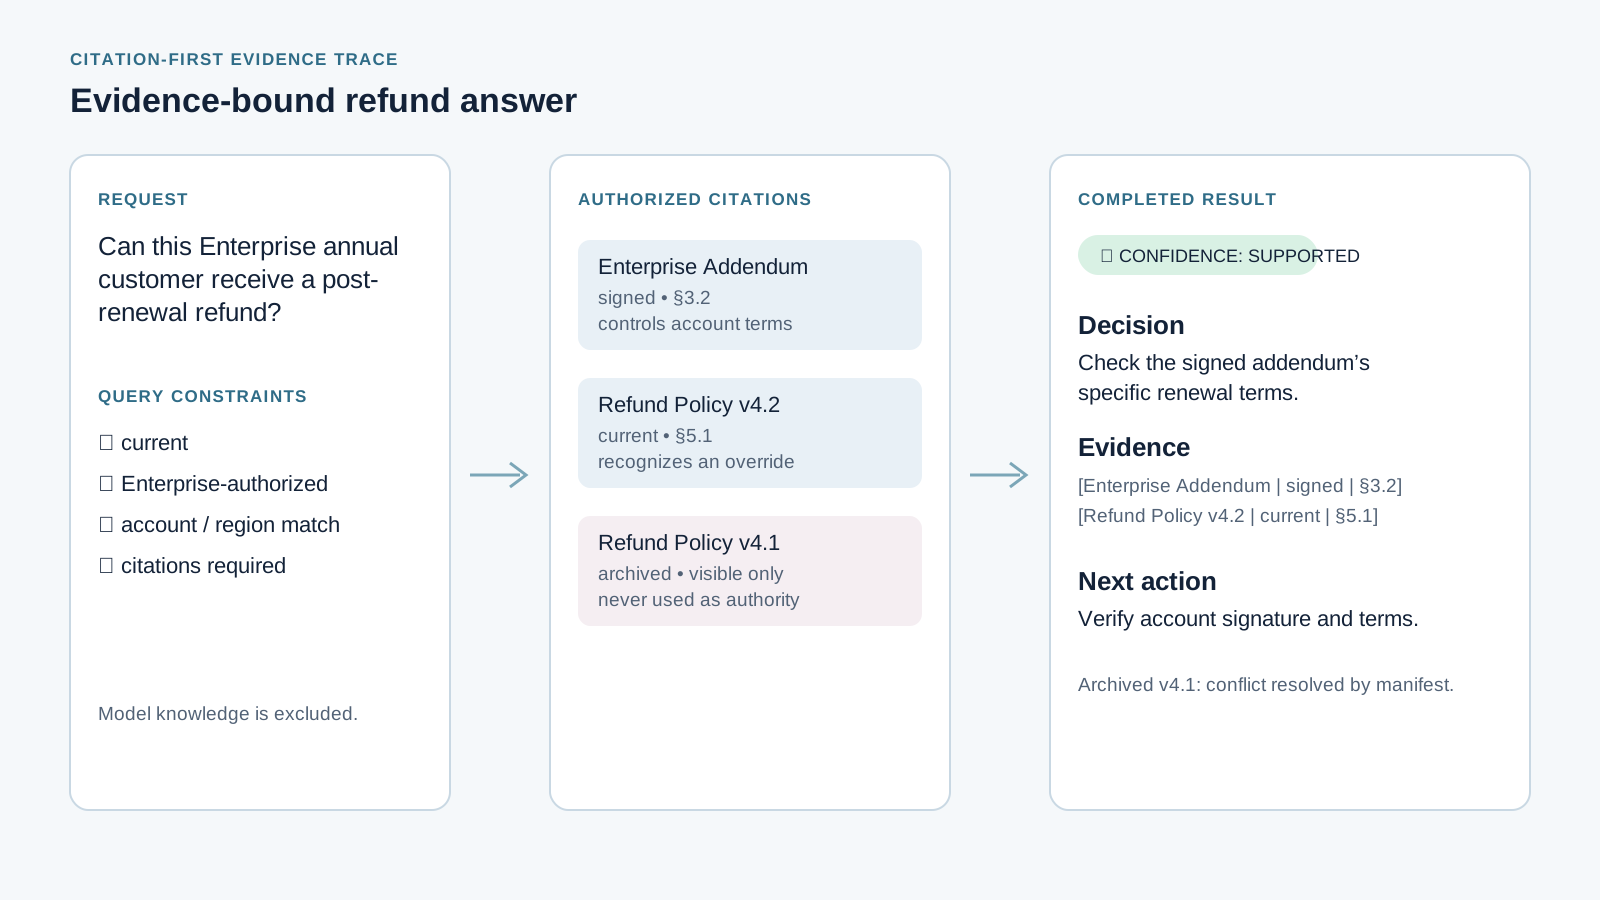
Odpowiedź o zwrocie oparta na dowodach z cytatami aktualnej polityki
Wynik główny ukończony: decyzja jest poparta wersją v4.2 i podpisanym aneksem, podczas gdy zarchiwizowany dokument pozostaje widoczny tylko jako rozwiązany konflikt.
Krok 4: Oceniaj wyszukiwanie i wierność osobno
Odpowiedź może cytować dokument i mimo to zastosować niewłaściwą klauzulę. Oceniaj osobno kompletność wyszukiwania i wierność twierdzeń. Daje to decyzję o wydaniu, której właściciel produktu, wsparcia lub działu prawnego może bronić.
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
Ustawienia: utwórz złoty zestaw 20 pytań, po 4 pytania dla przypadków prostych, typowych, sprzecznych, bez odpowiedzi i wysokiego ryzyka. Utrzymuj wysokie rozumowanie dla pytań wysokiego ryzyka i sprzecznych. Niższy wysiłek testuj porównawczo tylko dla pracy niskiego ryzyka, po przejściu testu bazowego.
Ukończone, gdy: zestaw zawiera zarówno porażkę typu pobrano-właściwy-dokument / zastosowano-niewłaściwą-klauzulę, jak i prawidłowe wstrzymanie się od odpowiedzi. Recenzenci będący ludźmi sprawdzają próbki każdej popartej odpowiedzi wysokiego ryzyka.
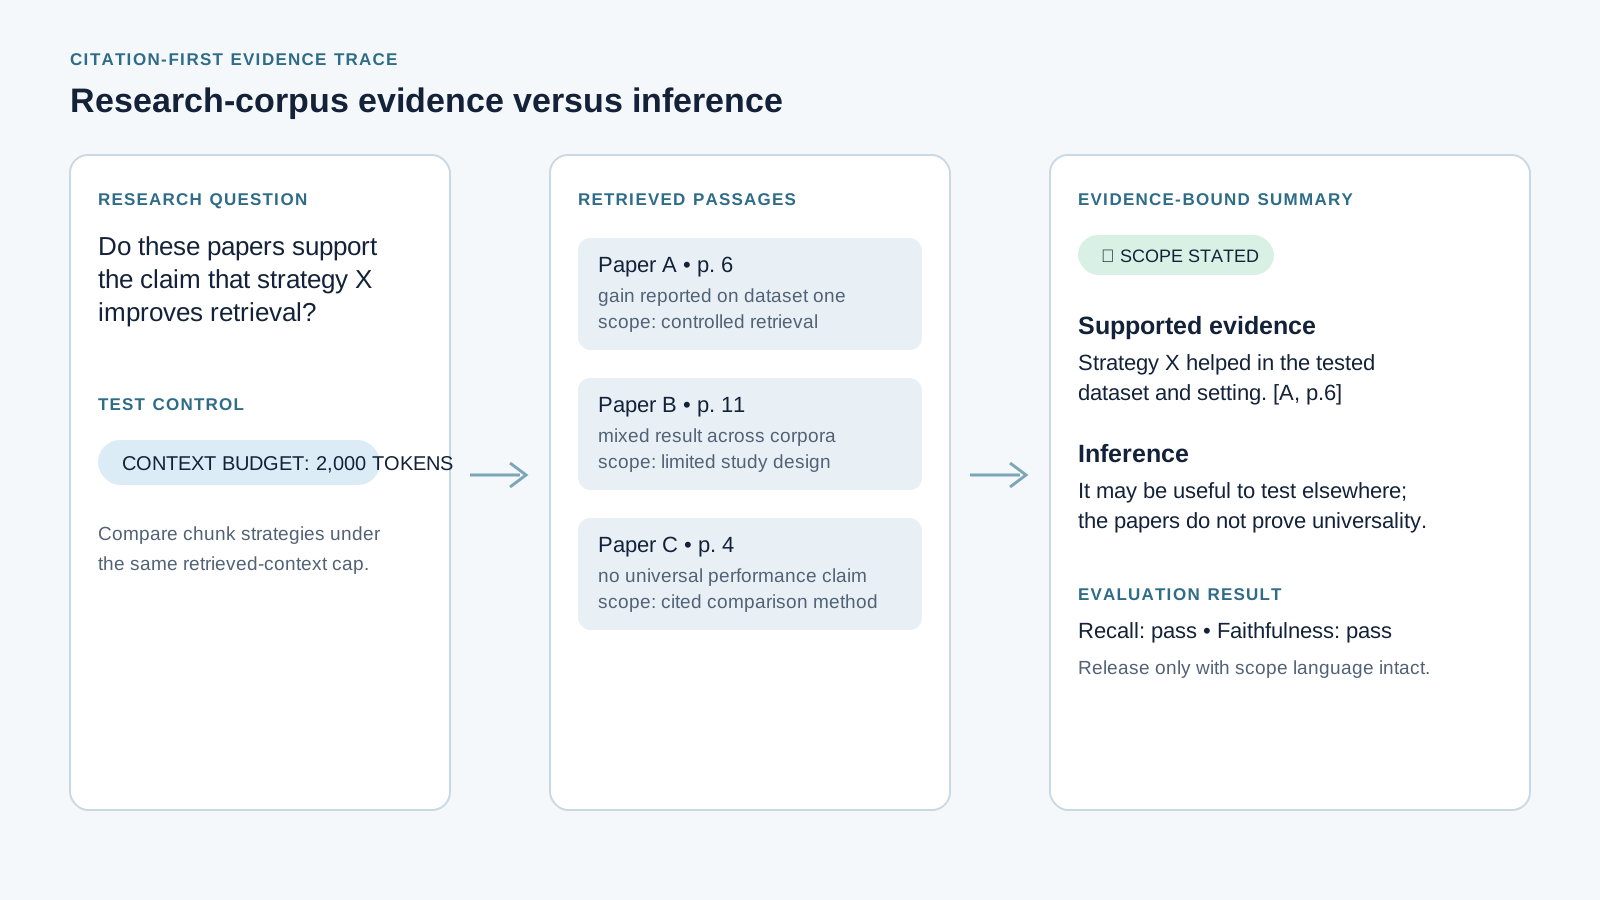
Ślad dowodowy korpusu badawczego porównujący poparcie i wnioskowanie w budżecie 2000 tokenów
Przypadek 3. Odpowiedź z korpusu badawczego oddziela to, co trzy artykuły wyraźnie potwierdzają, od wnioskowania. Porównanie wyszukiwania utrzymuje budżet kontekstu na poziomie 2000 tokenów.
Skaluj bazę wiedzy GPT-6 Astra bez utraty dowodu
Wzorce pilotażu zmieniają się w zależności od dziedziny. Zachowaj ślad dowodowy, ale dopasuj źródło autorytetu i granicę odmowy do konkretnej pracy.
| Pilotaż | Źródło autorytetu | Wymagane metadane | Odmów lub eskaluj, gdy | Bramka wydania przez człowieka |
|---|---|---|---|---|
| Polityka zwrotów Enterprise | podpisany aneks, aktualna polityka | konto, region, data wejścia w życie, status | brakuje aneksu lub aktualne źródła się wykluczają | wsparcie i właściciel polityki |
| Runbook incydentu P1 | aktualny runbook i macierz eskalacji | usługa, waga, właściciel, ostatni trening | działanie nie ma właściciela ani aktualnego runbooka | dowódca incydentu |
| Korpus badawczy | cytowane fragmenty artykułów | DOI, strona, data publikacji, metoda | wniosek wykracza poza dowody | recenzent merytoryczny |
W przypadku kodu i wewnętrznych bibliotek reguł nadaj AGENTS.md, decyzjom architektonicznym, aktualnym procedurom wdrażania i wycofanym skryptom wyraźne rangi. W badaniach zwracaj „dowód" i „wnioskowanie" jako osobne pola. W obsłudze klienta filtry dla produktu, regionu i daty wejścia w życie wykonują większość pracy nad niezawodnością.
Lista kontrolna kosztów i routingu. Odpowiedź wysokiego ryzyka z 20 tys. tokenów wejściowych i 2 tys. tokenów wyjściowych kosztuje około 0,30 USD w tokenach tekstowych GPT-6 Astra: 20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000. To wyklucza File Search i inne opłaty za narzędzia, które należy zweryfikować w bieżącej konsoli przed uruchomieniem. Wejścia powyżej 272 tys. tokenów mają wyższą cenę modelu, więc prompt o rozmiarze 1 mln tokenów nie powinien być rutynową ścieżką.
| Ryzyko zadania | Wysiłek rozumowania | Reguła dowodowa | Przegląd przez człowieka |
|---|---|---|---|
| Tagi i routing | test porównawczy przed obniżeniem | tylko metadane | próbkowany |
| Standardowe wsparcie | średni lub wysoki po testach | aktualne cytowane źródło | kolejka wyjątków |
| Konflikt, polityka lub incydent | wysoki | każde twierdzenie powiązane ze źródłem | wymagany |
| Prawo, medycyna, finanse, HR, prywatność | wysoki | wstrzymaj się, gdy niekompletne | wymagany przed działaniem |
Kontrolę kosztów zacznij od początku: usuń przestarzałe pliki i pliki bez właściciela, filtruj metadane przed wyszukiwaniem, testuj najpierw pytania o wysokiej wartości i zachowuj manifest, pobrane fragmenty, wersję modelu oraz decyzję o wydaniu. Zespoły, które potrzebują późniejszej trasy wielu modeli, mogą przejrzeć aktualną dokumentację LLM API razem z własnymi wynikami pilotażu.
W przypadku treści regulowanych, prywatnych, kadrowych, zdrowotnych, finansowych lub dotyczących incydentów produkcyjnych zastosuj filtrowanie dostępu przed wyszukiwaniem, potwierdź warunki przetwarzania i przechowywania danych, utrzymuj ścieżkę wycofania i kieruj niekompletne dowody do odpowiedzialnego człowieka. Płynna odpowiedź nigdy nie jest ostateczną poradą w takich kontekstach.
Często zadawane pytania
Czy okno kontekstowe o rozmiarze 1 mln tokenów eliminuje potrzebę RAG?
Nie. Może pomóc analitykowi odczytać większy pakiet, ale nie ustala autorytetu dokumentu, dostępu użytkownika, aktualności, precyzji cytowania ani testu wydania. Używaj wyszukiwania do rutynowego wyboru dowodów, a szeroki kontekst zarezerwuj do analizy wyjątków.
Co nigdy nie powinno trafić do bazy wiedzy GPT-6 Astra?
Nie wprowadzaj plików bez właściciela, polityk bez daty, wersji roboczych bez wyraźnego przepływu pracy dla wersji roboczych, treści, których osoba pytająca nie jest uprawniona widzieć, ani materiałów zarchiwizowanych bez reguły użycia historycznego. Umieść takie pliki w przeglądzie lub zarchiwizuj je poza normalnym wyszukiwaniem.
Jak należy postąpić z dwoma aktualnymi dokumentami, które się nie zgadzają?
Zwróć ESCALATE, nazwij konflikt, zachowaj oba cytaty i przypisz właściciela. Model nie powinien po cichu wymyślać rozstrzygnięcia. Manifest potrzebuje udokumentowanej reguły przed następnym wydaniem.
Jaki jest najlepszy rozmiar fragmentu dla bazy wiedzy GPT-6 Astra?
Nie ma uniwersalnej liczby. Zachowaj istotne nagłówki i warunki polityk, a następnie porównaj strategie przy tym samym budżecie kontekstu. Stałe top-k może ukryć znacznie większy budżet pobranych tokenów i sprawić, że eksperyment wygląda lepiej, niż jest w rzeczywistości.
Jak udowodnić, że odpowiedź jest oparta na właściwym źródle?
Przechowuj oczekiwane źródło dla każdego złotego pytania, pobrane fragmenty, końcowe twierdzenia atomowe oraz ocenę recenzenta dla kompletności, precyzji cytowania, wierności, obsługi konfliktów i wstrzymania się. W przypadku odpowiedzi wysokiego ryzyka brakujący link do poparcia oznacza porażkę.
Ile kosztuje baza wiedzy GPT-6 Astra?
Użyj wzoru na tokeny, a następnie dodaj bieżące opłaty za File Search i narzędzia. W powyższym przykładzie 20 tys. wejścia plus 2 tys. wyjścia to około 0,30 USD w tokenach modelu. Praktyczna oszczędność polega na trzymaniu przestarzałych materiałów poza systemem i używaniu wysokiego rozumowania tam, gdzie dowody mają znaczenie. To trwała wersja gpt-6 astra knowledge base best practices.


