Limity szybkości GPT Image 2.5 wahają się obecnie od 5 do 250 obrazów na minutę w płatnych poziomach API wymienionych na stronach modeli Flare i Sunburst firmy OpenAI. Obie strony zawierają również limity tokenów. Przed zaplanowaniem pracy sprawdź rzeczywistą konfigurację swojego konta: limity wykorzystania ChatGPT, limity API OpenAI oraz ograniczenia punktów końcowych Atlas Cloud wymagają osobnej weryfikacji.
Niezręczny moment pojawia się, gdy kampania jest prawie gotowa, a wciąż brakuje ostatnich kilku obrazków. Ponowne kliknięcie Generate może pozostawić cię z oryginalnym zadaniem, zduplikowanym zadaniem i bez jasnego pojęcia, które z nich skończy się pierwsze.
Ten przewodnik łączy opublikowane limity z praktycznym planem dostarczania. Znajdziesz w nim tabelę diagnostyczną, procedurę kolejki, przykładowe obliczenie dla 100 obrazów oraz kontrolowaną metodę sprawdzania, czy pomyślnie wygenerowany obraz faktycznie spełnia założenia briefu. Praktycznym celem jest folder z zaakceptowanymi materiałami przed twoim terminem.
Dokumentacja sprawdzona 16 września 2026 r. Wydajność specyficzna dla konta i dokładnie skonfigurowane koszty wymagają osobnej weryfikacji.
Status redakcyjny: brama dostępu do środowiska testowego uniemożliwiła zaplanowane sześć generacji. Artykuł zawiera odtwarzalny protokół i oficjalne dowody źródłowe, ale trzy porównania wyników oraz zrzut ukończonego przebiegu pozostają niedostępne.
Najważniejsze wnioski
- Określ swoją ścieżkę dostępu, zanim zastosujesz jakikolwiek limit.
- Sprawdź konto, projekt, model i wszelkie współdzielone limity.
- Zdiagnozuj błąd, zanim zdecydujesz, czy ponowić próbę.
- Zaplanuj budżet na zaakceptowane obrazy, w tym na kontrolę i poprawki.
Limity szybkości GPT Image 2.5 zależą od Twojej ścieżki dostępu
Zacznij od miejsca, w którym nacisnąłeś Generate. Subskrypcja ChatGPT, projekt API OpenAI i konto Atlas Cloud to różne ścieżki dostępu. Zrzut ekranu z jednej z nich nie określa limitu obowiązującego na innej.
W ChatGPT sprawdź aktualny plan, dostęp do funkcji obrazów i komunikat wyświetlany po zatrzymaniu generowania. Płatna subskrypcja nie gwarantuje nielimitowanego przydziału. Unikaj planowania dnia pracy wokół dziennej liczby obrazów skopiowanej z cudzego konta.
Dyskusja po wydaniu obejmuje pytania użytkowników, czy Plus nadal ma dzienny limit obrazów. To pokazuje, że czytelnicy mają obawy; liczby w tych pytaniach nie stanowią polityki. (Dyskusja po wydaniu na Reddicie, wrzesień 2026 r.)
W przypadku API zanotuj organizację, projekt i dokładny identyfikator modelu używany przez twoją aplikację. W przypadku Atlas określ wybrany punkt końcowy i konto, na którym działa. Następnie zaklasyfikuj widoczny sygnał do typu limitu.
| Rodzaj limitu | Widoczny sygnał | Następna kontrola |
|---|---|---|
| Limit wykorzystania produktu | ChatGPT informuje, że tworzenie obrazów jest chwilowo niedostępne | Przeczytaj bieżący komunikat konta i ewentualny czas resetu |
| Obrazy na minutę, IPM | Ograniczenie szybkości obrazów podczas powtarzanych zgłoszeń | Potwierdź limit obrazów dla tej ścieżki i modelu |
| Tokeny na minutę, TPM | Błąd lub panel konta wskazuje limit tokenów | Sprawdź odpowiedni limit tokenów |
| Praca współbieżna | Zadania czekają, podczas gdy inne zadania pozostają aktywne | Policz pracę w toku i zweryfikuj politykę współbieżności |
| Limit salda lub rozliczeń | Ostrzeżenie rozliczeniowe lub błąd limitu | Sprawdź środki, status rozliczeń i ograniczenia wydatków |
| Dostęp do modelu | Odpowiedź o braku uprawnień lub niedostępności modelu | Potwierdź uprawnienia konta i dokładny punkt końcowy |
Zachowaj tę rozróżnienie w widocznym miejscu na liście zadań zespołu. Marketer mówiący „trafiłem na limit” powinien zapisać ścieżkę i komunikat, zanim inny kolega rozpocznie rozwiązywanie problemów.
Określ również, kto jeszcze korzysta z zasobów tego samego konta. Drugie stanowisko robocze nie musi oznaczać dodatkowej przepustowości. Zapytaj właściciela konta, czy strona internetowa, narzędzie wewnętrzne i nocne zadania korzystają z tej samej puli.
Wpis „Free: nieobsługiwane” w tabeli API dotyczy tego poziomu API. Nie określa on, czy darmowy produkt ChatGPT może generować obrazy.
Limity szybkości GPT Image 2.5 w poszczególnych poziomach API
Oficjalne strony modeli publikują obecnie poniższą tabelę dla obu wariantów. Są to publiczne wartości poziomów wykorzystania, sprawdzone 16 września 2026 r., a nie gwarancja, że każde konto ma dokładnie taką konfigurację.
| Poziom wykorzystania API OpenAI | TPM | IPM |
|---|---|---|
| Free | Nieobsługiwane | Nieobsługiwane |
| Poziom 1 | 100 000 | 5 |
| Poziom 2 | 250 000 | 20 |
| Poziom 3 | 800 000 | 50 |
| Poziom 4 | 3 000 000 | 150 |
| Poziom 5 | 8 000 000 | 250 |
Źródła: (strona modelu OpenAI Flare, sprawdzona we wrześniu 2026) i (strona modelu OpenAI Sunburst, sprawdzona we wrześniu 2026).
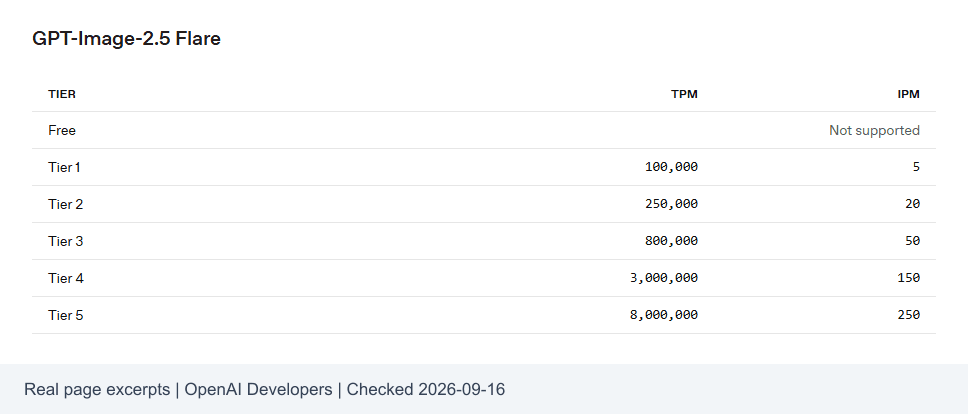 Oficjalna strona modelu OpenAI pokazująca limity szybkości GPT Image 2.5 według poziomów wykorzystania
Oficjalny dowód ze strony modelu. Data sprawdzenia: 16 września 2026 r.
IPM liczy obrazy, a RPM liczy żądania. Zachowaj to rozróżnienie w arkuszu planowania. Przy jednym obrazie na udane żądanie te dwie liczby mogą się pokrywać w prostym oszacowaniu. Wiele wyników, ponowne próby lub inne zachowania punktu końcowego mogą tę zależność złamać.
Potraktuj tabelę jako punkt wyjścia do rozmowy o przepustowości. Zapisz opublikowany poziom, a następnie porównaj go z limitami widocznymi dla konta faktycznie wykonującego pracę. Jeśli się różnią, zbadaj sprawę, zanim zobowiążesz się do terminu.
Zgodne tabele nie oznaczają, że Flare i Sunburst kończą zadanie w tym samym czasie. Nie dowodzą też, że przełączanie się między wariantami sumuje ich limity. Potwierdź wszelkie współdzielone limity w konfiguracji konta.
Zespół przygotowujący piątkową kampanię może zamienić to w krótką wstępną weryfikację: określ ścieżkę produkcyjną, zweryfikuj aktualny limit, sprawdź inne zaplanowane obciążenia i przypisz jedną osobę do pilnowania kolejki. Zapisz datę sprawdzenia, aby stary zrzut ekranu nie stał się stałym założeniem operacyjnym.
Nie mnoż limitu minutowego przez liczbę minut w dniu i nie obiecuj takiej liczby ukończonych obrazów. Takie obliczenie pomija czas bezczynności, opóźnienie generowania, inne ograniczenia i odrzucone wyniki.
Zdiagnozuj limity szybkości GPT Image 2.5 przed ponowieniem próby
Zapisz treść błędu, kod statusu HTTP, znacznik czasu i dostępny identyfikator żądania, zanim cokolwiek zmienisz. Sam zrzut ekranu z napisem „429” pozostawia zbyt wiele niewiadomych.
Dokumentacja OpenAI opisuje limity organizacji i projektu, współdzielone pule modeli, nagłówki odpowiedzi i obsługę błędów tymczasowych. Zaleca czekanie co najmniej tak długo, jak wskazuje Retry-After, dodanie jitteru i unikanie szybkich powtarzanych błędów, które mogą zużywać limit minutowy. (Limity szybkości OpenAI, sprawdzone we wrześniu 2026 r.)
Poniższa procedura diagnostyczna jest propozycją projektową aplikacji. Etykiety błędów i mechanizmy odzyskiwania należy odwzorować na platformie, z której faktycznie korzystasz.
| Widoczna sytuacja | Sprawdź najpierw | Działanie |
|---|---|---|
| Tymczasowy błąd 429 | Treść błędu oraz ewentualna informacja o oczekiwaniu lub resecie | Wstrzymaj dotkniętą kolejkę, następnie zmniejsz tempo zgłoszeń |
OpenAI insufficient_quota | Saldo, stan rozliczeń i uprawnienia konta | Rozwiąż problem z kontem; zatrzymaj automatyczne ponowne próby |
| Przekroczenie czasu po zgłoszeniu | Oryginalny zapis żądania, identyfikator zadania, jeśli dostępny, historia | Uzgodnij oryginalne zadanie przed ponownym wysłaniem |
| Długa kolejka | Status oczekiwania i liczba aktywnych zadań | Czekaj, dopóki zadanie pozostaje ważne; opóźnienia sprawdzaj osobno |
| Odrzucenie z powodu parametrów lub treści | Konkretny powód walidacji lub odrzucenia | Popraw żądanie; nie traktuj tego jako błędu limitu szybkości |
Kod OpenAI w tabeli jest przykładem diagnostycznym specyficznym dla OpenAI. Nie jest to obietnica, że Atlas zwróci ten sam obiekt błędu lub obsłuży te same nagłówki.
W przypadku przekroczenia czasu oddziel to, co wiesz, od tego, czego się domyślasz. „Mój klient przestał czekać” nie dowodzi, czy serwer przyjął zadanie. Oznacz lokalny zapis jako niepewny i sprawdź oryginalną operację za pomocą mechanizmu statusu lub historii, jaki zapewnia dana ścieżka.
Jeśli nie istnieje żaden mechanizm uzgadniania, przekaż tę niepewność operatorowi. Ślepe ponowne wysłanie może utworzyć kolejne płatne zadanie. Zapisz to ryzyko, zanim ktoś zdecyduje się na ponowną próbę.
W przypadku czasu resetu korzystaj z odpowiedzi lub komunikatu konta dotyczącego limitu, który został przekroczony. Unikaj zakładania, że każde ograniczenie resetuje się o północy lub dokładnie 60 sekund po błędzie.
Zachowaj dowody po odzyskaniu sprawności. Niewielki zapis incydentu zawierający ścieżkę, oryginalny błąd, czas oczekiwania i końcowy wynik pomoże następnemu operatorowi odróżnić problem z kontem od skoku ruchu.
Obsługa limitów szybkości GPT Image 2.5 za pomocą kolejki
Kolejka daje twojemu zespołowi jedno miejsce do decydowania, co zostanie uruchomione następnie. W przypadku małej kampanii może wystarczyć arkusz kalkulacyjny i jeden operator. Aplikacja może wdrożyć te same decyzje w trwałym magazynie zadań.
Skorzystaj z tej sześcioetapowej procedury SOP:
- Przypisz stabilny identyfikator biznesowy. Zapisz wersję prompta, oczekiwany wynik, model, wymiary, jakość i termin. Zmieniony brief otrzymuje nową wersję.
- Sprawdź istniejącą pracę. Zwróć zapisany wynik dla ukończonego zadania. Pozostaw aktywne lub niepewne zadanie w uzgodnieniu, zamiast tworzyć kolejne zgłoszenie.
- Kontroluj tempo i współbieżność osobno. Wpuszczaj pracę tylko wtedy, gdy dostępny jest lokalny budżet szybkości i wolny slot. Ponowne próby korzystają z tych samych mechanizmów przyjmowania.
- Respektuj wskazówkę serwera dotyczącą oczekiwania. W przypadku potwierdzonego błędu, który można ponowić, czekaj co najmniej przez wskazany czas i dodaj odrobinę losowości.
- W przeciwnym razie stosuj ograniczony backoff. Zwiększaj opóźnienia między próbami, dodawaj jitter i ogranicz maksymalne opóźnienie. Miej na uwadze ogólny termin zadania.
- Zatrzymaj się świadomie. Gdy budżet ponownych prób lub termin się wyczerpie, zapisz ostatnie dowody i przekaż zadanie do przeglądu.
Ten neutralny względem platformy pseudokod ilustruje decyzje dotyczące planowania. Nie jest to SDK Atlas ani kontrakt punktu końcowego.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
Atomowe przejęcie ma znaczenie, gdy dwóch pracowników widzi ten sam wiersz w kolejce. Obaj nie mogą niezależnie stwierdzić, że zadanie można swobodnie wysłać. Utrwal stan zgłoszenia, zanim pracownik zniknie lub uruchomi się ponownie.
Deduplikacja na poziomie aplikacji nadal pozostawia trudny moment: usługa może zaakceptować żądanie tuż przed tym, zanim klient straci odpowiedź. Natywna idempotentność punktu końcowego może rozwiązać niektóre ryzyka podwójnych zgłoszeń, jeśli jest udokumentowana. Sam lokalny identyfikator biznesowy nie gwarantuje wykonania dokładnie raz, a ten przewodnik nie zakłada, że Atlas akceptuje konkretny nagłówek idempotentności.
Priorytetyzuj według potrzeb dostarczenia. Dokończ brakujący obraz zatwierdzonej kampanii, zanim wpuścisz opcjonalne warianty. Prowadź krótką notatkę operatora wyjaśniającą, dlaczego praca została zatrzymana, aby kolega mógł wznowić bez zgadywania.
Zaplanuj 100 obrazów w kontekście limitów szybkości GPT Image 2.5
Stosuj dwa liczniki: wygenerowane wyniki i zaakceptowane elementy dostarczane. Drugi licznik mówi właścicielowi kampanii, czy praca jest gotowa.
Rozważ hipotetyczny przykład planowania z jednym wynikiem na zadanie. Załóż efektywny limit 5 IPM, średni czas zajęcia slotu 60 sekund i maksymalnie 2 równoczesne zadania. Te dane wejściowe są poglądowe, a nie pomiarami z Atlas ani OpenAI.
| Dane wejściowe lub obliczenia planistyczne | Wartość hipotetyczna | Interpretacja |
|---|---|---|
| Wymagana liczba zaakceptowanych obrazów | 100 | Rzeczywisty cel dostarczenia |
| Efektywny limit obrazów | 5 IPM | Założona przepustowość konta |
| Limit obrazów potrzebny do 100 wyników | 100 ÷ 5 = 20 minut | Wymóg pojemności limitu, a nie obietnica ukończenia |
| Równoczesne zadania | 2 | Założony sufit liczby zadań w toku |
| Średni czas zajęcia slotu | 60 sekund | Od zgłoszenia do ukończenia |
| Przepustowość po stronie współbieżności | 2 × 60 ÷ 60 = 2 obrazy/minutę | Niższa niż limit obrazów |
| Założony wskaźnik akceptacji | 80% | Uproszczone oszacowanie do planowania |
| Limit generowania dla 100 zaakceptowanych obrazów | 100 ÷ 0,8 = 125 wyników | Obejmuje przybliżony budżet na poprawki |
| Czas przepustowości przy 2 wynikach/minutę | 125 ÷ 2 = 62,5 minuty | Wyłącza dodatkową kontrolę i przekazywanie prac |
Przydatne przybliżenie to:
plaintext1sustainable images/minute ≈ minimum of: 2 image allowance 3 request allowance × images per request 4 token allowance ÷ applicable tokens per image 5 concurrency × 60 ÷ average occupancy seconds
Używaj porównywalnych jednostek i rzeczywistych pomiarów konta. Jeśli zużycie tokenów jest niedostępne, pozostaw ten składnik nierozwiązany, zamiast szacować go na podstawie liczby słów w prompcie. Ten wzór opisuje model planowania, a nie implementację dostawcy.
Oszacowanie 125 wyników zakłada stałe prawdopodobieństwo akceptacji między próbami. Rzeczywiste poprawki mogą być skorelowane: prompt, który wielokrotnie błędnie liczy obiekty, może nieustannie zawieść, dopóki ktoś go nie zmieni. Przejrzyj powtarzające się defekty, zanim dokupisz kolejne próby.
Różne prace wymagają różnych kryteriów akceptacji:
- Cotygodniowe ilustracje do treści: temat musi odpowiadać artykułowi, a kadr musi działać w rozmiarze publikacji.
- Materiały koncepcyjne produktu: obraz musi zachować wymagany kształt i rozmieszczenie. Obraz koncepcyjny nie zastąpi zweryfikowanej fotografii produktu.
- Ilustracje edukacyjne lub przepisy: liczby, obiekty i szczegóły sekwencji muszą zgadzać się z wyjaśnieniem. Dodatkowy składnik może wprowadzić czytelników w błąd.
Dodaj czas pobierania, kontroli, poprawek i przekazania do harmonogramu. Jeśli jedna osoba sprawdza każdy materiał, zmierz także tempo tej osoby.
Przed terminem oddziel obrazy niezbędne od opcjonalnych wariantów. Śledź oddzielnie pozycje gotowe, odrzucone, aktywne i niepewne. Folder zawierający 100 plików może wciąż być o kilka zaakceptowanych elementów krótszy.
Ogranicz poprawki, zanim podniesiesz swoje limity
Zdefiniuj kryterium zaliczenia przed naciśnięciem Generate. To sprawia, że decyzja jest powtarzalna i zapobiega prześlizgnięciu się przekonująco wyglądającego obrazu z błędną liczbą lub nieprzydatnym tekstem.
Przedstawiony tu kontrolowany protokół korzysta z GPT Image 2.5 Flare Text-to-Image, jednego PNG na zadanie, w 2048x1152. Dla każdego briefu uruchom najpierw max, potem high, zachowując wszystkie inne dostępne ustawienia bez zmian. Zachowaj oryginały i sprawdź oba w tym samym rozmiarze wyświetlania.
Status dowodów: Poniższe sześć wyników Flare zostało wygenerowanych dla trzech briefów w rozdzielczości 2048x1152. Każda para zawiera jeden wynik MAX i jeden HIGH. Te przykłady wspierają opisane tutaj kroki kontroli, ale sześć wyników nie stanowi podstawy do szerokiego rankingu jakości ani twierdzenia o wskaźniku akceptacji.
A. Liczba obiektów i kompozycja
Skopiuj ten prompt bez zmian:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Policz każdy pomidor, sprawdź dwa rzędy i obejrzyj wszystkie cztery krawędzie deski. Następnie poszukaj zabronionych obiektów. Zaakceptuj kadr tylko wtedy, gdy cały brief jest spełniony. Prawidłowa liczba pomidorów przy przyciętej desce wciąż wymaga decyzji o naprawie lub ponownym generowaniu.
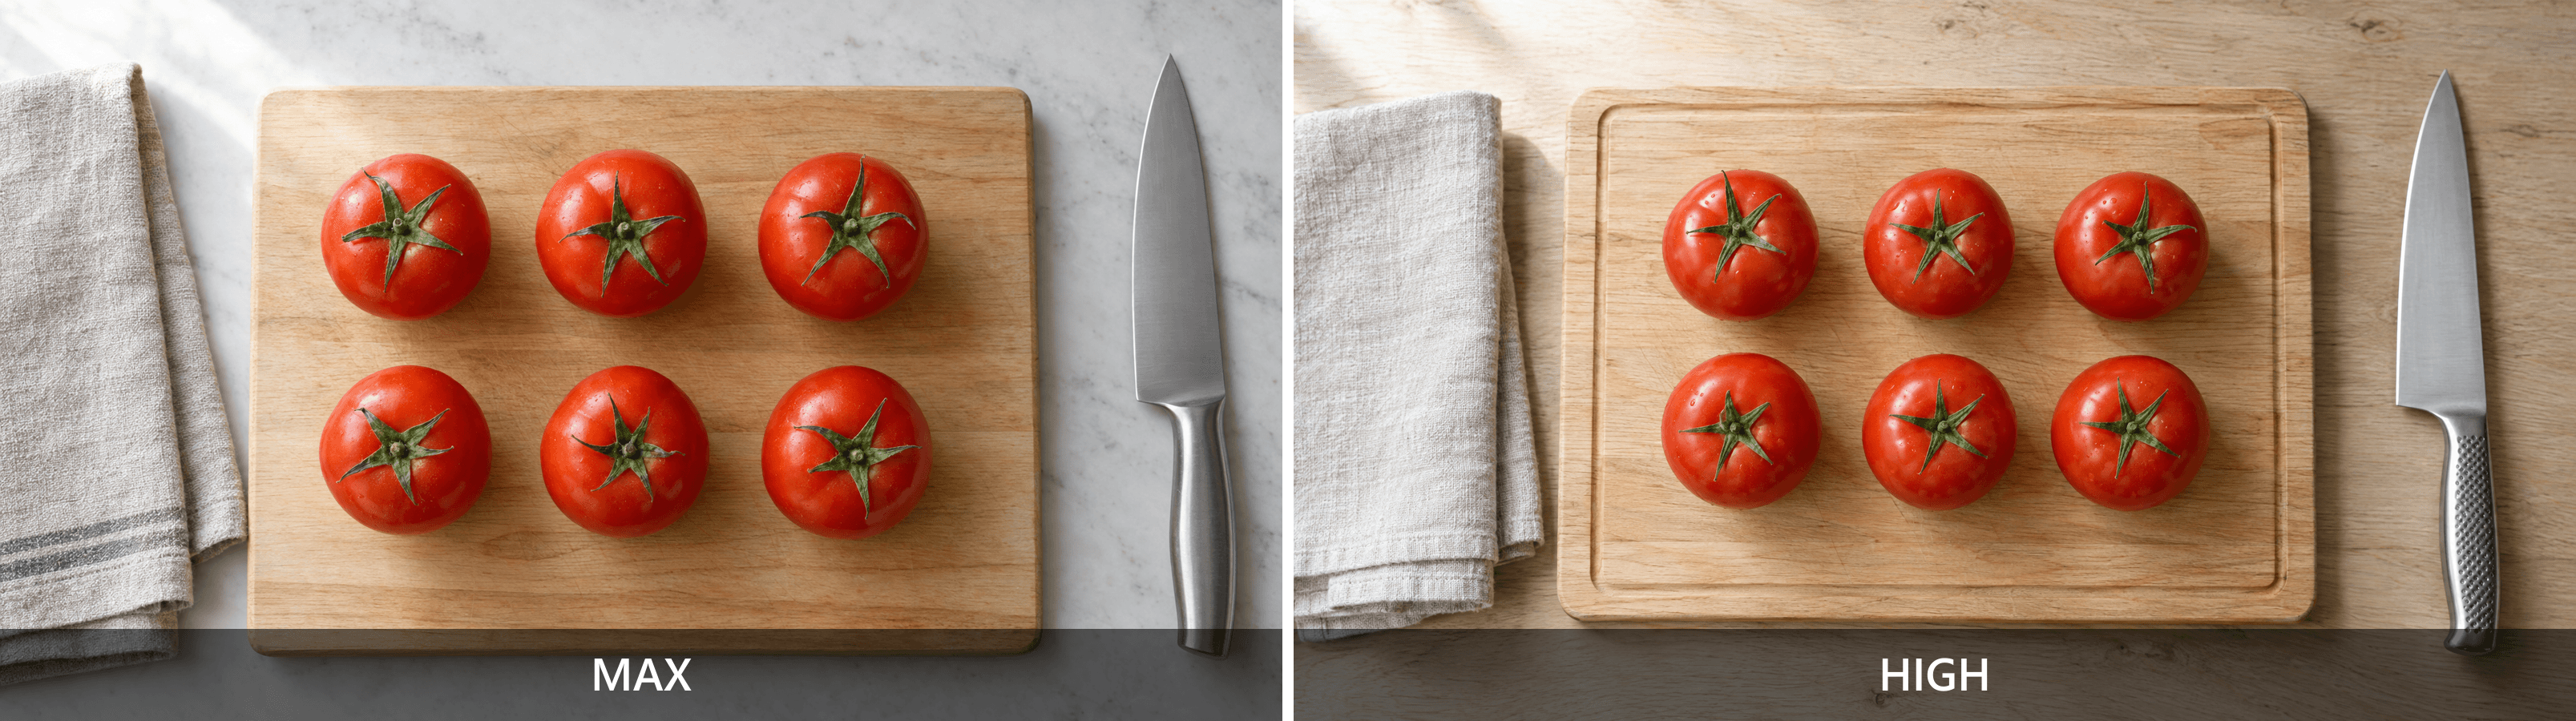 Wyniki High i max Flare do sprawdzenia liczby sześciu pomidorów i pełnej deski
Po lewej: MAX. Po prawej: HIGH. Oba wyniki pokazują sześć pomidorów w dwóch rzędach; przed zatwierdzeniem któregokolwiek wyniku sprawdź całą deskę, nóż, ręcznik i wszelkie zabronione obiekty.
B. Miejsce na nagłówek
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
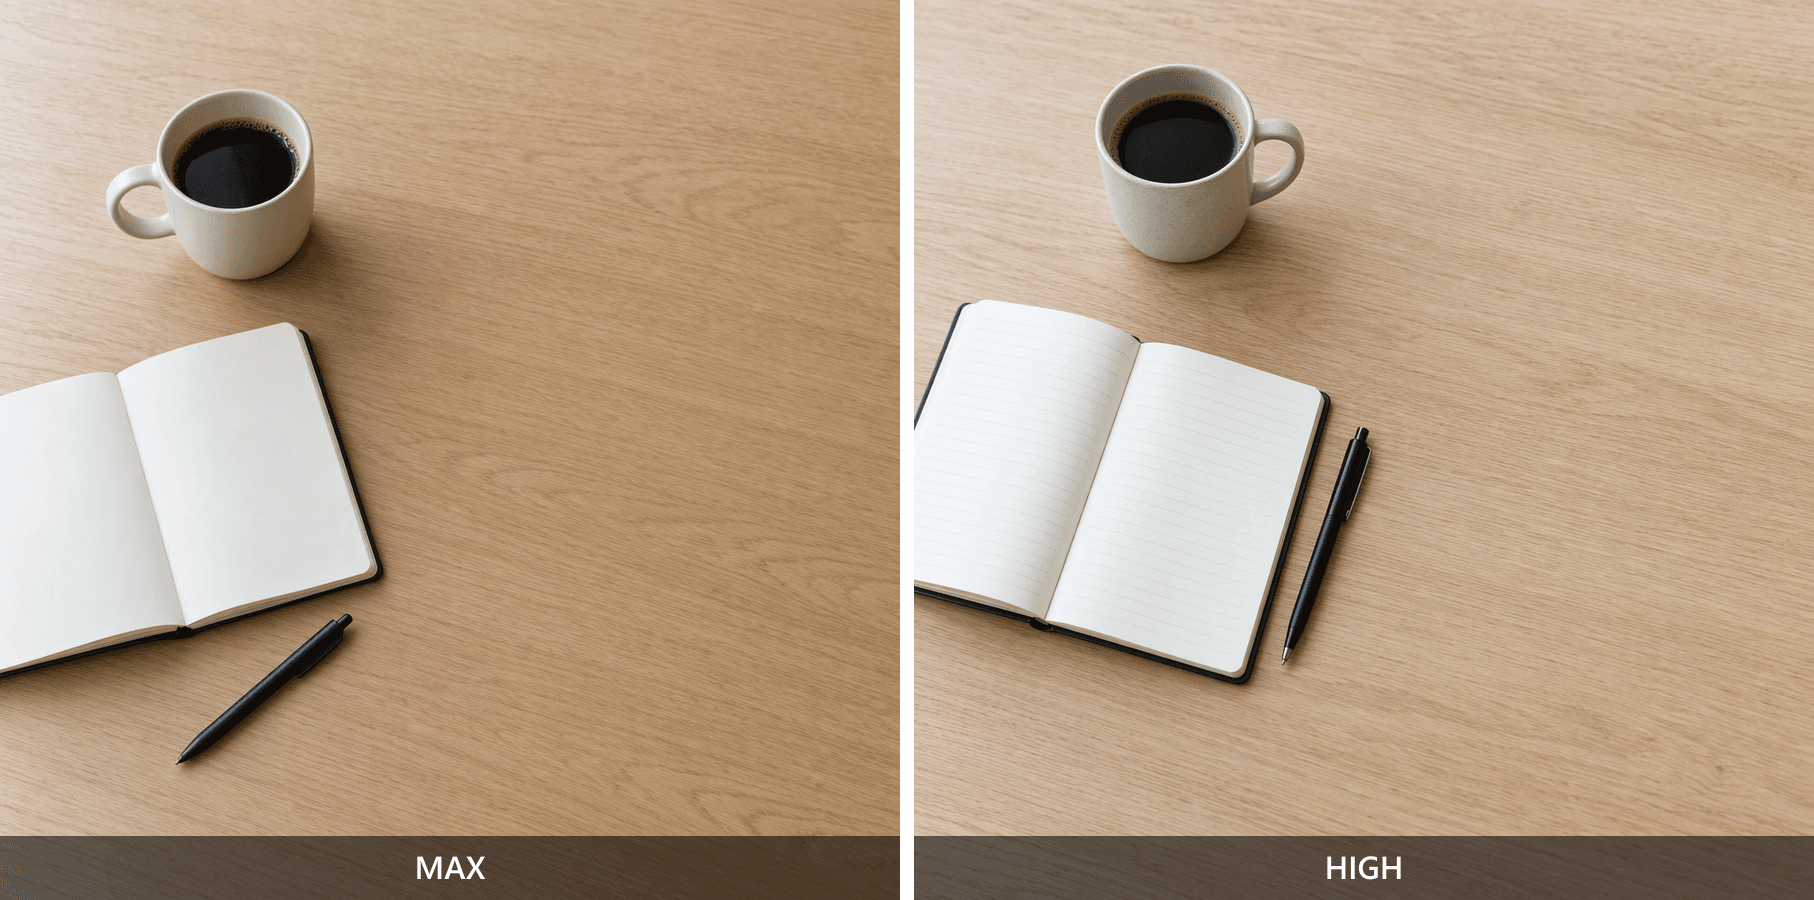
Przy szerokości 2048 pikseli skrajne prawe 45% zaczyna się w przybliżeniu na x = 1126. Sprawdź ten obszar na oryginale. Następnie umieść prawdziwy nagłówek w lokalnym podglądzie układu, aby ocenić czytelność. Linia pomocnicza jest adnotacją po produkcji, a nie częścią wygenerowanej sceny.
 Wyniki High i max dla biura domowego z zaznaczonym obszarem na nagłówek po prawej stronie
Po lewej: MAX. Po prawej: HIGH. Oba wyniki zachowują użyteczny obszar biurka po prawej stronie na nagłówek; oceń ten pusty obszar w docelowym rozmiarze wyświetlania.
C. Dokładny krótki tekst
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
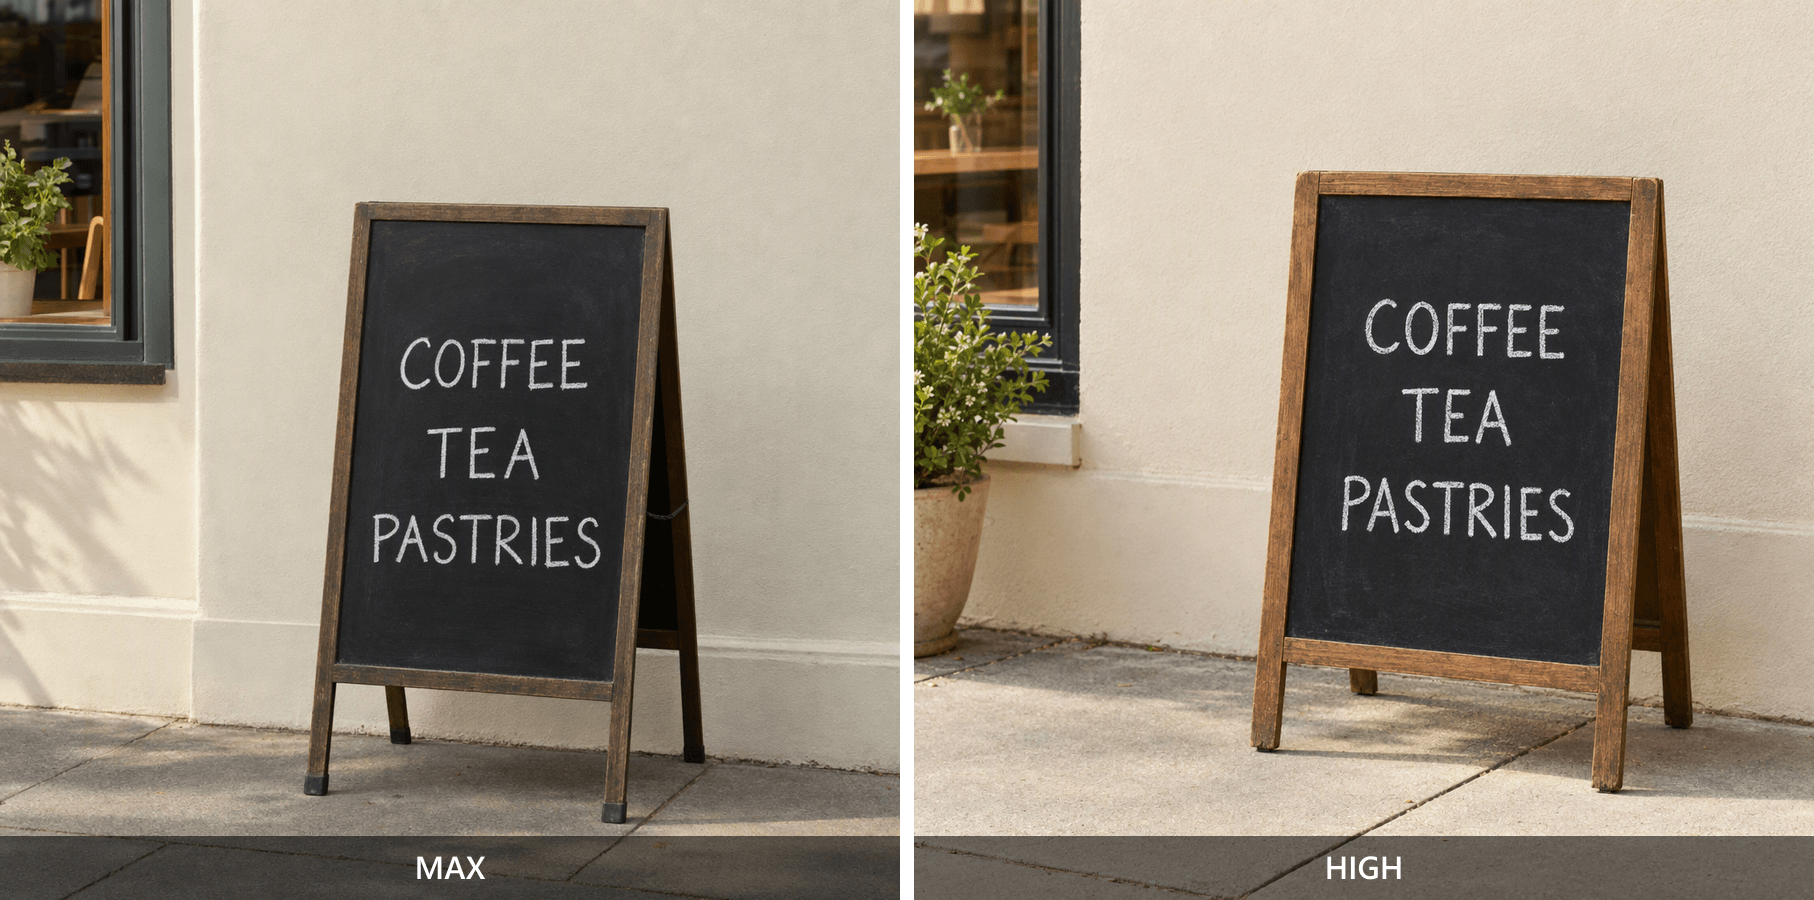
Przeczytaj każdą literę w oryginale i w podglądzie o rozmiarze publikacji. Sprawdź tło pod kątem dodatkowych czytelnych napisów. To wygenerowana przez AI scena testowa, a nie fotografia dokumentująca prawdziwą kawiarnię. Zachowaj literówki w dowodach, zamiast je usuwać retuszem.
Wygenerowane przez AI tablice kredowe w kawiarni w trybach High i max do sprawdzenia napisów COFFEE, TEA i PASTRIES
Po lewej: MAX. Po prawej: HIGH. Przeczytaj każdą linię w rozmiarze publikacji i sprawdź tło pod kątem dodatkowego czytelnego tekstu przed zatwierdzeniem wyniku.
Sześć wyników może zademonstrować proces kontroli. Nie może ustalić wskaźnika sukcesu platformy, przepustowości produkcyjnej ani górnego limitu szybkości. Pojedyncza para również nie pozwala oddzielić wpływu ustawień jakości od zmienności generowania.
Oceniaj ustawienie na podstawie zaakceptowanego materiału i zarejestrowanego kosztu. Bez dokładnych opłat wniosek o koszcie high w porównaniu z max pozostaje niezmierzony. Jeśli oba przechodzą, zanotuj to; jeśli żaden nie przechodzi, popraw brief, zanim powtórzysz tę samą porażkę.
Oceń Atlas Cloud pod kątem swojego przepływu pracy z obrazami
Użyj tego samego reprezentatywnego zadania do oceny ścieżki dostępu. Dzięki temu ocena jest powiązana z pracą, którą twój zespół ma dostarczyć.
Wybrana strona GPT Image 2.5 Flare Text-to-Image jest punktem końcowym tego protokołu. Otwórz ją, potwierdź nazwę modelu, wklej jeden z powyższych kompletnych promptów i wybierz żądany rozmiar oraz jakość.
Sprawdź, co formularz faktycznie zapamiętuje po opuszczeniu każdego pola. Wpisana szerokość, która wraca do poprzedniej wartości przed wysłaniem, nie tworzy testu o rozdzielczości 2048. Zapisz zatwierdzone ustawienia, uruchom jedno zadanie, poczekaj na stan końcowy i pobierz rzeczywisty wynik.
Zapisz identyfikator zadania, jeśli jest widoczny, czas zgłoszenia, czas ukończenia i plik wynikowy razem. W przypadku porównania utwórz osobne zadanie i zmień tylko jakość. Nie wyciągaj wniosków o nowym wyniku na podstawie przykładowych grafik już wyświetlonych na stronie modelu.
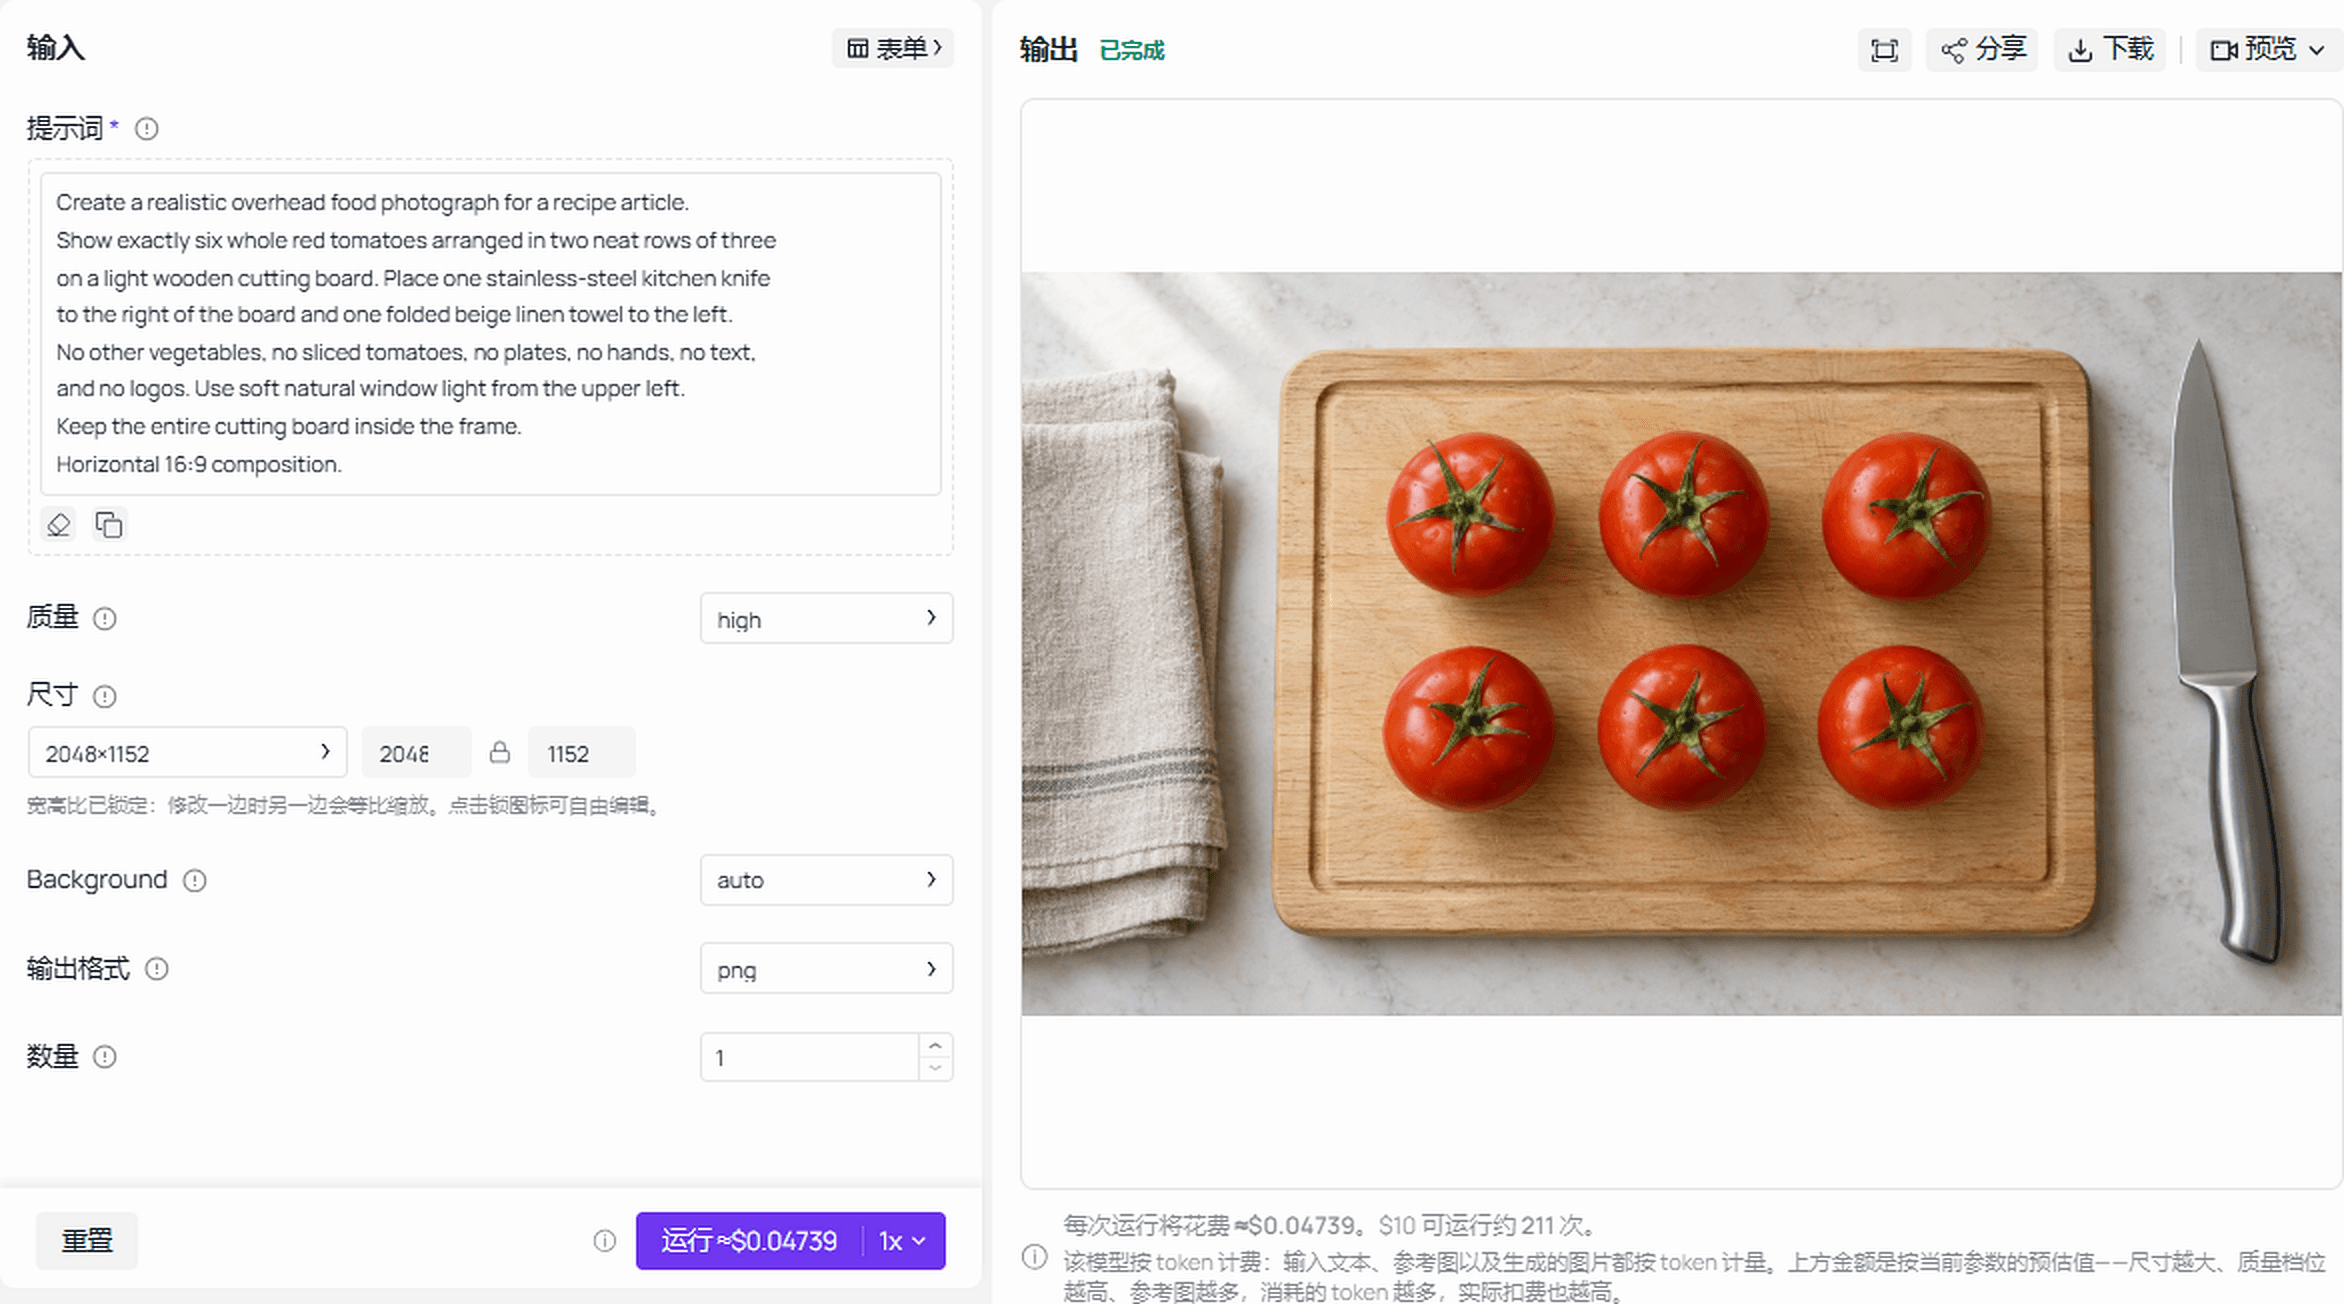 Ukończone uruchomienie Flare pokazujące brief z pomidorami, aktywne ustawienia i wygenerowany wynik
Ukończone uruchomienie Flare: ekran pokazuje brief z pomidorami, jakość HIGH, rozmiar 2048x1152, wynik PNG i zwrócony obraz z sześcioma pomidorami.
Oceń ścieżkę według pięciu pól:
- Model i punkt końcowy: potwierdź, że chodzi o Flare Text-to-Image, a nie o punkt końcowy edycji ani inny wariant.
- Limity i współbieżność: uzyskaj obowiązujące limity konta oraz informację, czy obciążenia je współdzielą.
- Odzyskiwanie zadań: zweryfikuj, w jaki sposób konto udostępnia aktywne prace, błędy końcowe i wyniki po przekroczeniu czasu.
- Skonfigurowany koszt: sprawdź jednostkę, wybrane wymiary, jakość oraz ewentualne warunki rabatowe.
- Akceptacja i poprawki: zachowaj oryginalny wynik i krótki powód odrzucenia każdego materiału.
Skorzystaj z bieżącego katalogu modeli jako punktu wyjścia do sprawdzenia cen, a następnie przejrzyj wybraną konfigurację. Zaokrąglona cena początkowa nie określa opłaty za 2048x1152 + max.
Współbieżność konta Atlas, przepustowość produkcyjna, współdzielone limity i rozliczenia nieudanych zadań nie zostały niezależnie potwierdzone dla tego artykułu. Potwierdź je po stronie konta. Czasy zadań w środowisku testowym również nie mogą określić wydajności produkcyjnego API.
Uruchom jeden reprezentatywny prompt, sprawdź wynik i zweryfikuj limity konta, zanim zwiększysz skalę.
FAQ — limity szybkości GPT Image 2.5
Ile obrazów GPT Image 2.5 mogę wygenerować na minutę?
Płatne poziomy API wymienione na stronach modeli OpenAI podają od 5 do 250 IPM. Do planowania operacyjnego używaj aktualnych ustawień swojego konta, w tym limitów tokenów i wszelkich innych obowiązujących ograniczeń. Opublikowany limit obrazów nie gwarantuje, że każdy obraz zostanie ukończony lub przejdzie kontrolę w tej minucie.
Czy ChatGPT Plus ma stały dzienny limit obrazów?
Ten artykuł nie ustala uniwersalnego stałego dziennego limitu dla Plus. Sprawdź aktualny komunikat o generowaniu obrazów i informacje o planie na swoim koncie. Zgłoszenia użytkowników mogą pomóc zidentyfikować pytanie warte zbadania, ale liczba z sesji innej osoby nie może bezpiecznie stać się dziennym budżetem produkcyjnym twojego zespołu.
Czy Flare i Sunburst mają takie same limity szybkości?
Ich oficjalne strony modeli wyświetlały zgodne tabele poziomów po sprawdzeniu 16 września 2026 r. Nie oznacza to identycznych czasów generowania ani oddzielnych pul przepustowości. Przed zaplanowaniem podzielonego obciążenia potwierdź limity i zasady współdzielenia obowiązujące dla obu wariantów na twoim koncie.
Dlaczego otrzymuję błąd 429, skoro wciąż mam środki?
Saldo odpowiada na pytanie, czy środki pozostały; nie odpowiada na to, czy bieżące żądanie mieści się w limicie szybkości. Przeczytaj treść błędu i ewentualną wskazówkę dotyczącą oczekiwania. Jeśli błąd wskazuje problem z kontem lub limitem, rozwiąż ten problem, zamiast zakładać, że powtarzane opóźnione zgłoszenia go rozwiążą.
Kiedy resetują się limity szybkości GPT Image 2.5?
Korzystaj z odpowiednich nagłówków odpowiedzi lub powiadomień konta. Różne ograniczenia mogą mieć różne okna czasowe i nie ustalono tutaj jednego czasu resetu dla wszystkich ścieżek. Postępuj zgodnie z podanym minimalnym czasem oczekiwania, zmniejsz tempo kolejki i zachowaj oryginalny stan zadania, decydując, czy ponowna próba jest właściwa.
Czy korzystanie z Atlas Cloud usuwa limity szybkości GPT Image 2.5?
Nie. Oceń Atlas jako opcję dostępu z własnym zachowaniem punktu końcowego i ograniczeniami konta. Potwierdź te szczegóły przed zwiększeniem wolumenu. Praktyczny plan zarządzania limitami szybkości GPT Image 2.5 łączy zweryfikowaną przepustowość, kontrolowane zgłoszenia, odzyskiwanie zadań i kontrole akceptacji ograniczające zbędne poprawki.


