how i become a millionaire in 30 days – ten klip to żart o pytaniu chatbota o cudowny skrót i otrzymaniu najmniej magicznej możliwej odpowiedzi: „Znajdź pracę”. Zranione spojrzenie postaci, gorączkowe pisanie i druga próba to prawdziwa historia. Poniżej znajdują się dwa przykłady online, które pokazują, jak ta sama konfiguracja działa z człowiekiem i ze zwierzakiem. Następnie tworzymy nową, dłuższą wersję z oryginalną postacią, nowym otoczeniem, czytelnym dialogiem i reakcją, która trwa wystarczająco długo, by zapadła w pamięć.
Najważniejsze wnioski
- Rozpoznawalna sekwencja to pełne nadziei pytanie, bezpośrednia odpowiedź, urażona pauza i kolejna próba.
- Wersje online z człowiekiem i ze zwierzakiem zmieniają wykonawcę, zachowując timing żartu.
- Nasza oryginalna 26-sekundowa wersja na placu zabaw wykorzystuje dziecko jako wykonawcę i dodaje czytelny dialog w montażu, zamiast prosić model wideo o narysowanie interfejsu telefonu.
- Traktuj „Znajdź pracę” jako scenową puentę, a nie dowód na to, co odpowiedziałby chatbot, ani prawdziwy plan wzbogacenia się.
Co dzieje się w wersjach online?
Pierwszy przykład online utrzymuje żart blisko codziennej rozmowy telefonicznej. Osoba podnosi telefon z pełną pewnością siebie, spogląda w dół po odpowiedź i nagle traci tę pewność. Zwróć uwagę na zmianę postawy. Konfiguracja jest wypowiadana w stronę telefonu, ale puenta rozgrywa się na zewnątrz, w stronę widza. Reakcja sprawia, że krótka kwestia staje się pamiętna.
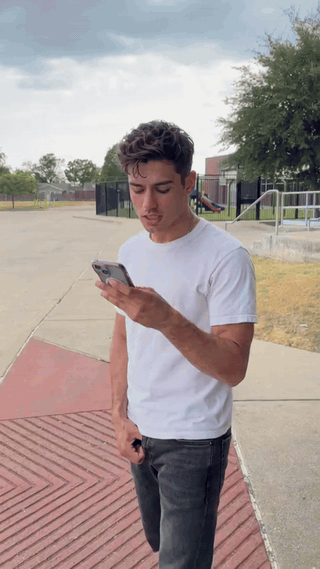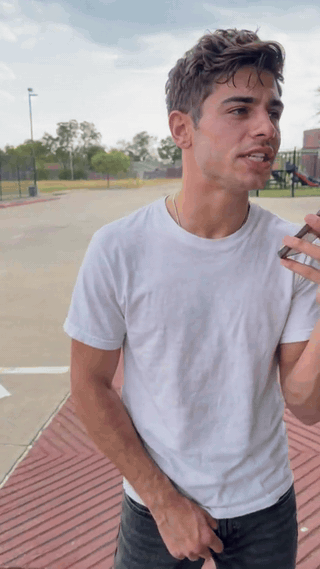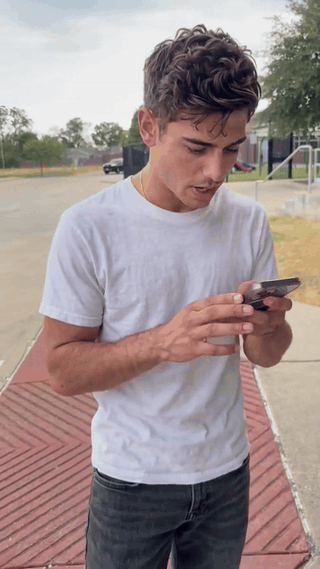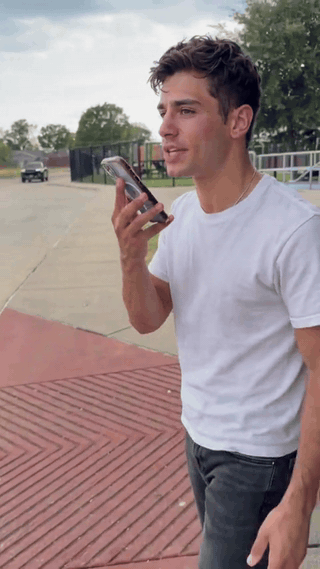
Przykład online, wersja z człowiekiem. Kluczowym wizualnym momentem jest przejście od pełnego nadziei sposobu mówienia do widocznej niedowierzającej reakcji.
Drugi przykład online obsadza w tej samej roli zwierzaka. Jego wyprostowana postawa i rekwizyt w postaci telefonu sprawiają, że ambicja wydaje się absurdalna, zanim nadejdzie odpowiedź. Obrót głowy i długie spojrzenie w kamerę robią to, co ludzki aktor zrobiłby brwiami i wymruczanym protestem. To więcej niż zmiana kostiumu: mowa ciała zwierzęcia zmienia odczucie puenty, podczas gdy pytanie i odpowiedź pozostają rozpoznawalne.
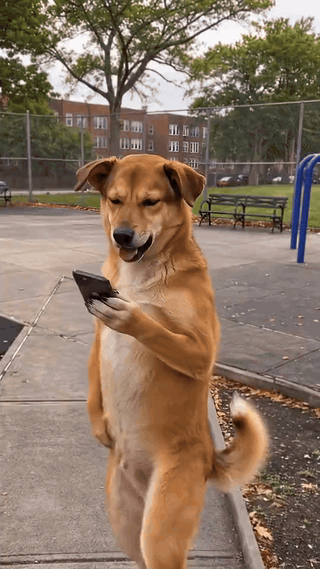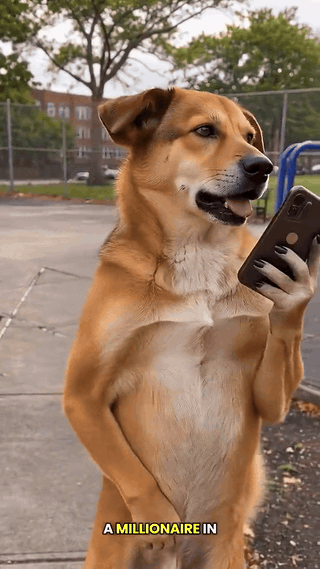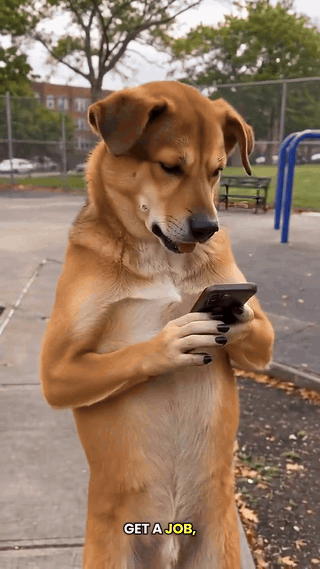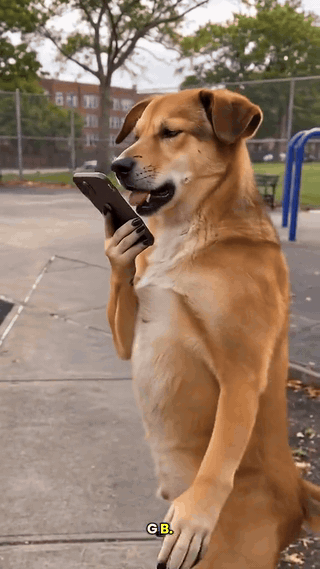
Przykład online, wersja ze zwierzakiem. Występ opiera się na wyprostowanej postawie, czytelnym geście z telefonem i opóźnionym urażonym spojrzeniu.
To przykłady krążącego formatu wideo, a nie nagrania, które ustalają konkretną odpowiedź chatbota. Szkic komediowy może zainscenizować wymianę zdań; przeróbka AI może wygenerować wykonawcę. Wyrażenie „how I become” jest tu zachowane, ponieważ jest częścią wyszukiwanej linii memu, chociaż „how do I become” to zwykły angielski. Żadne z tych wyrażeń nie czyni wideo poradą finansową.
Cztery uderzenia, które czynią go rozpoznawalnym
| Uderzenie | Co widzą widzowie | Dlaczego to ma znaczenie |
|---|---|---|
| Pytanie | Telefon zostaje podniesiony, jakby mógł zdradzić sekret | Pewność siebie postaci buduje wygórowane oczekiwania. |
| Odpowiedź | „Znajdź pracę” pojawia się lub jest czytana na głos | Odpowiedź jest celowo prosta i krótka. |
| Reakcja | Postać zastyga, patrzy w górę lub wpatruje się w kamerę | Pauza pozwala publiczności odkryć zniewagę razem z postacią. |
| Kolejne pytanie | Szybkie pisanie lub kolejna wiadomość głosowa | Postać odrzuca zwykłą odpowiedź i przedłuża żart. |
Kolejność ma większe znaczenie niż dokładna długość ujęcia. Jeśli odpowiedź pojawi się, zanim widz zrozumie pytanie, nie ma kontrastu. Jeśli reakcja zostanie natychmiast ucięta, puenta nie ma miejsca na oddech. Jeśli postać po prostu odejdzie, klip traci uparte drugie podejście, które czyni ten format specyficznym.
Jak stworzyć własną wersję?
Zacznij od struktury żartu, a następnie zmień występ, scenerię i zakończenie. Odtwarzanie cudzego materiału ujęcie po ujęciu sprawia, że wynik jest trudniejszy do odróżnienia i daje mniejszą kontrolę nad dialogiem. W naszej demonstracji umieszczamy jedno fikcyjne dziecko na nasłonecznionym placu zabaw. Dziecko prosi o skrót do milionera z promiennym optymizmem, po czym spotyka się z bezpośrednią odpowiedzią „Znajdź pracę”. Ta rada jest celowo absurdalna dla dziecka; zmiana od zachwytu do niedowierzania niesie żart. Ekran telefonu jest zwrócony do dziecka, więc model nigdy nie musi wymyślać przycisków aplikacji ani czytelnych wiadomości.
Przydatnym ograniczeniem projektowym jest oddzielenie występu od tekstu. Model wideo może animować osobę podnoszącą telefon, czytającą, wzdrygającą się i piszącą. Jest mniej niezawodny w renderowaniu dokładnego tekstu czatu na ruchomym telefonie. Dlatego najpierw generujemy aktorstwo, a następnie dodajemy czyste podpisy redakcyjne. Podpisy przekazują scenariuszowe kwestie żartu; nie są prezentowane jako zrzut ekranu prawdziwej sesji ChatGPT.
1. Zbuduj spójną pierwszą klatkę
Użyj obrazu w orientacji poziomej 16:9 z widoczną twarzą dziecka, obiema dłońmi i telefonem. Kompozycja od pasa w górę pozostawia miejsce na zmianę wyrazu twarzy bez utraty kolorowej zjeżdżalni i huśtawek za dzieckiem. Zostaw trochę niezagospodarowanej przestrzeni na podpisy. Pierwsza klatka powinna wyglądać na pełną nadziei, a nie już zszokowaną.
W tym artykule pierwsza klatka jest generowana za pomocą Seedream v5.0 Pro na Atlas Cloud. Prompt jest celowo konkretny:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
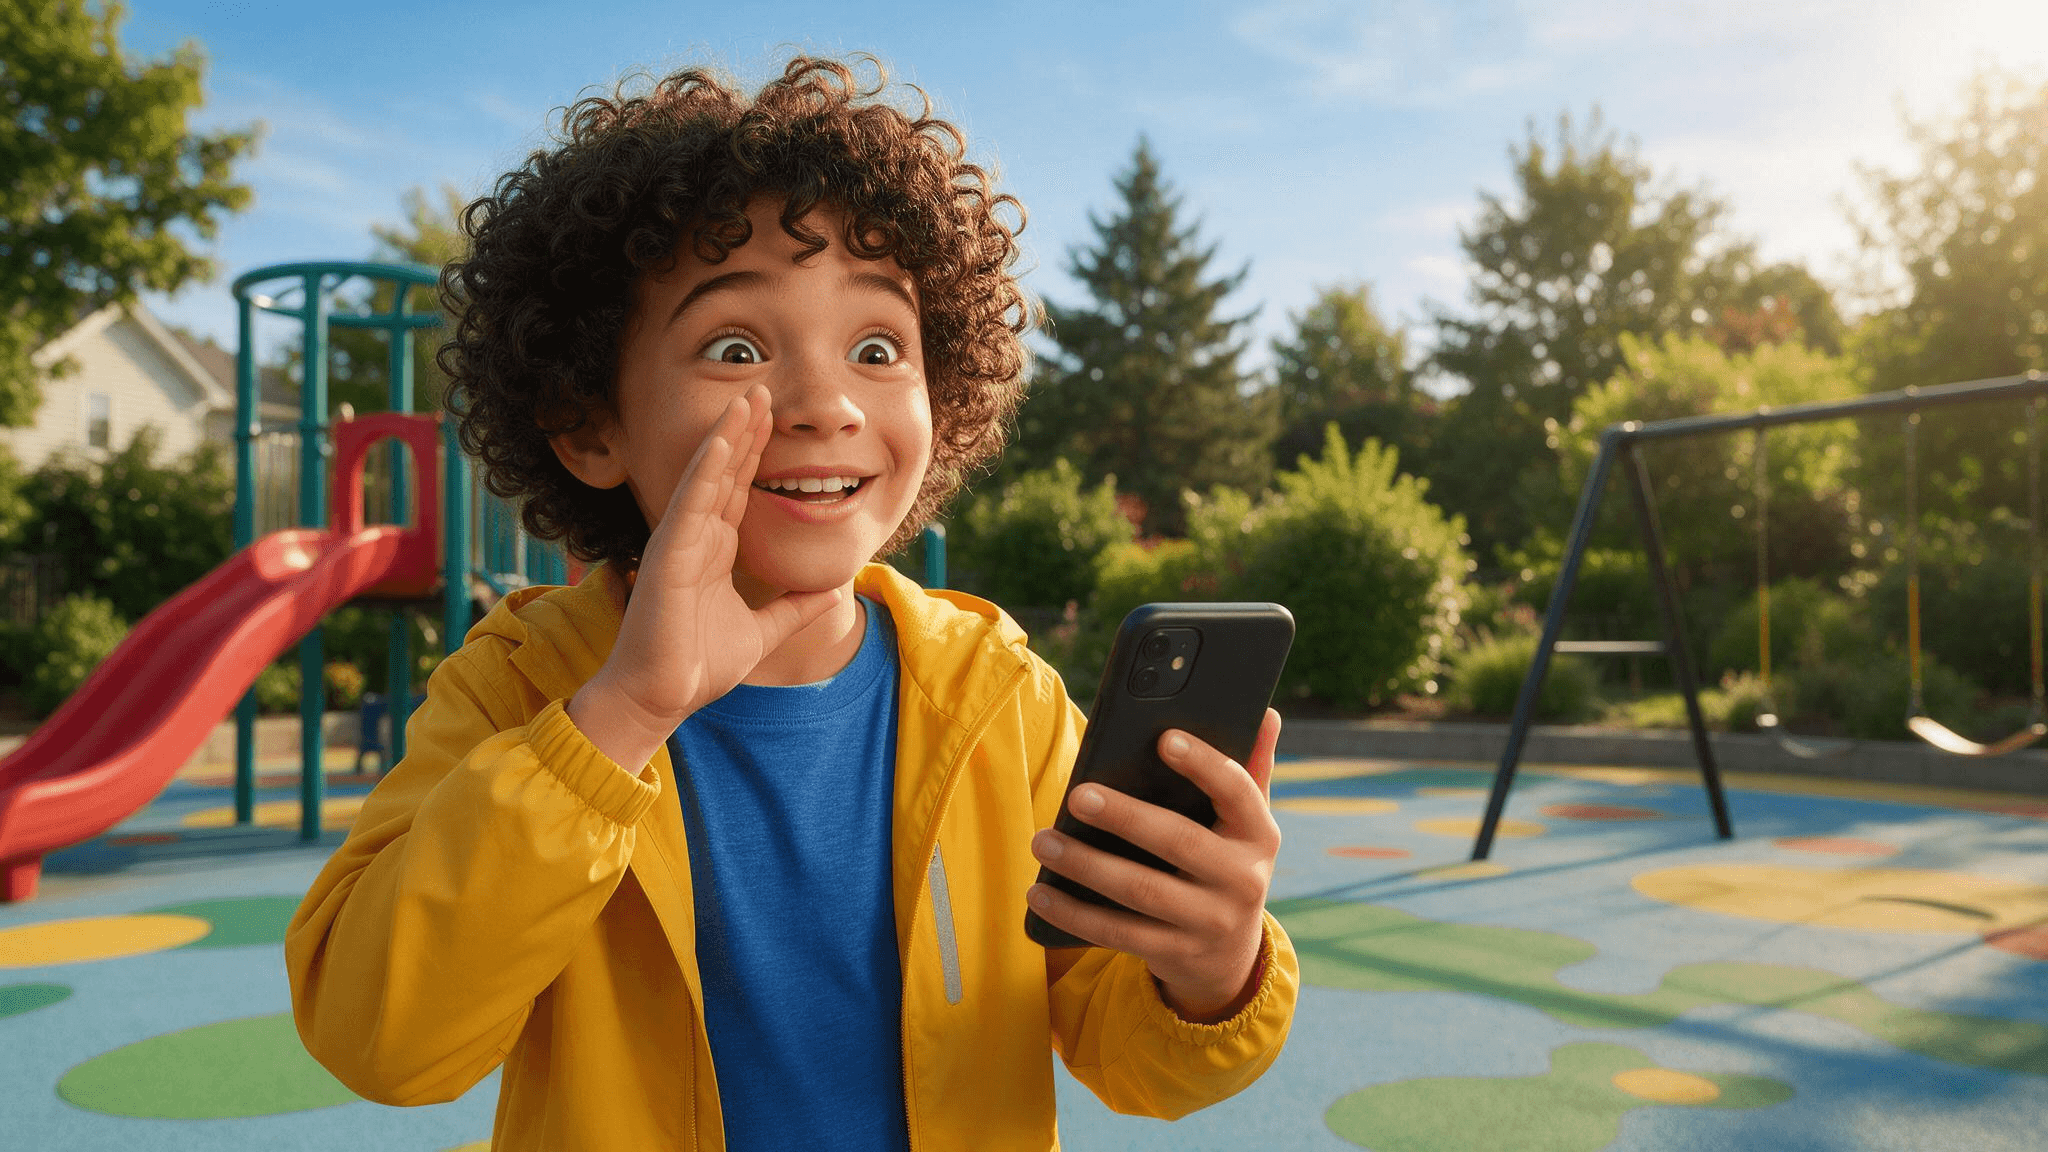
Nasza wygenerowana klatka początkowa. Szeroki uśmiech dziecka i uniesione brwi ustanawiają pełne nadziei otwarcie; zjeżdżalnia i huśtawki sprawiają, że nowe otoczenie jest jednoznaczne.
2. Animuj pełną reakcję, a nie ruchomy portret
Użyj pierwszej klatki jako wejściowego obrazu dla Seedance 2.5 Image-to-Video na Atlas Cloud. Ustawiamy cel na 26 sekund, orientacja pozioma 16:9, z dźwiękiem. Prompt wymaga sekwencji wyraźnych reakcji twarzy. Nie prosi modelu o wyświetlanie dymków czatu ani literowanie puenty, ponieważ te dokładne słowa są dodawane w montażu.
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
Dostarczony klip sprawia, że zmiana emocjonalna jest łatwa do śledzenia: dziecko zaczyna z uśmiechem, otwiera usta ze zdziwienia na pierwszą odpowiedź, marszczy brwi, pisze kolejne pytanie i w końcu wzrusza ramionami z irytacją. Dodatkowe zdjęcie poniżej wyodrębnia moment, w którym zwykła odpowiedź obala plan milionera dziecka.
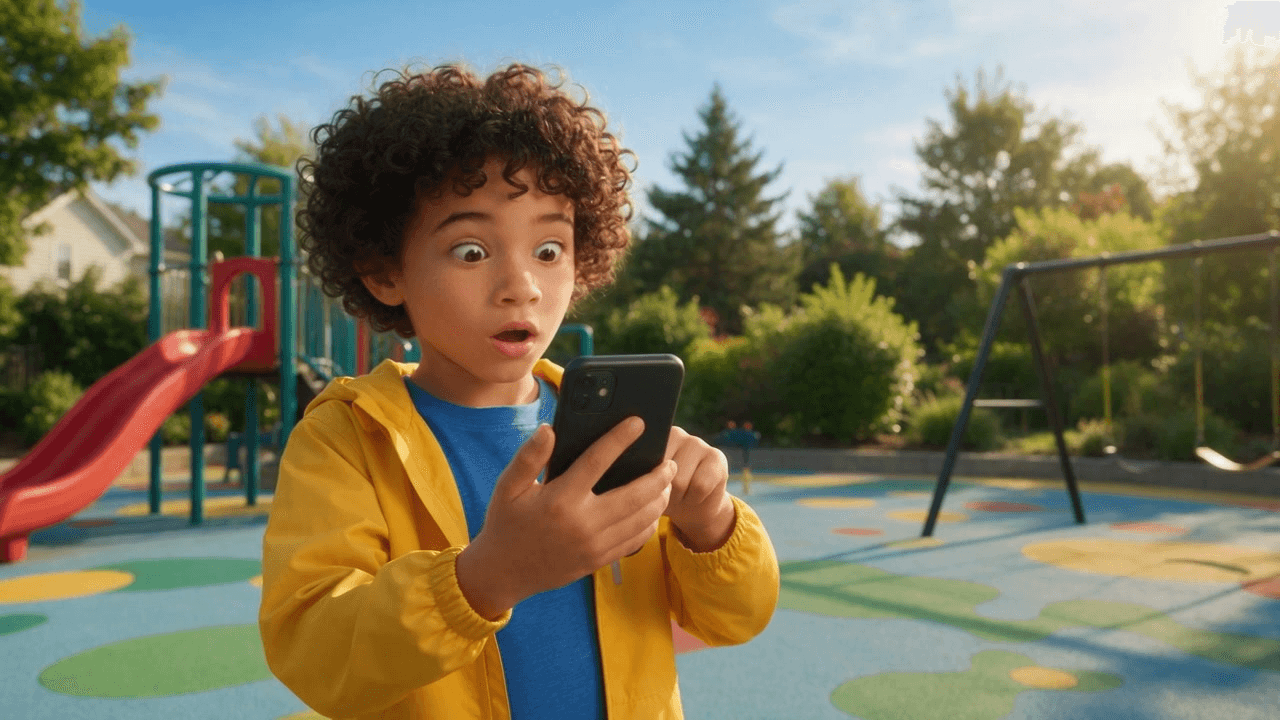
Klatka z około 6 sekundy wygenerowanego wideo. W porównaniu z pełnym nadziei pierwszym obrazem, szeroko otwarte oczy i usta natychmiast ukazują efekt puenty.
3. Dodaj dokładny dialog i utrzymaj żart czytelnym bez dźwięku
Krótki scenariusz wystarczy. Umieść pytanie na ekranie, gdy dziecko zwraca się do telefonu, wprowadź „Znajdź pracę” tylko wtedy, gdy dziecko czyta odpowiedź, i zostaw pauzę przed protestem. W kontynuacji użyj nowego pytania, zamiast powtarzać słowo w słowo otwarcie. Napisy powinny znajdować się w spójnym bezpiecznym obszarze, z silnym kontrastem, i nigdy nie powinny zasłaniać twarzy ani dłoni.
| Moment w naszym 26-sekundowym montażu | Podpis redakcyjny | Wskazówka aktorska |
|---|---|---|
| Otwarcie | „Jak zostaję milionerem w 30 dni?” | Jasne, pewne wypowiedzenie do telefonu. |
| Odpowiedź | „Znajdź pracę.” | Oczy opadają na ekran; uśmiech znika. |
| Reakcja | „Serio?” | Zaskoczenie ustępuje marszczeniu brwi przed pisaniem. |
| Druga próba | „Dobra, ale co jeśli pominę ten etap?” | Telefon wraca do góry; ton staje się błagalny. |
Trzymaj tekst na tyle krótki, by można go było przeczytać jednym spojrzeniem. Nie fabrykuj realistycznego zrzutu ekranu czatu, aby udowodnić, że kwestia została wygenerowana przez aplikację. Starannie zaprojektowany podpis w uczciwy sposób przekazuje scenariuszową wymianę i utrzymuje klip 16:9 zrozumiałym przy wyłączonym dźwięku. Oryginalny dźwięk pozostaje z wideo; cztery wyświetlone linie to podpisy redakcyjne.
4. Eksportuj, sprawdź i oznacz
Wyeksportuj jeden ciągły plik MP4, zamiast ciąć źródłowy klip na kilka osadzeń w artykule. Sprawdź jego rzeczywisty czas trwania po eksporcie. Żądane 26 sekund ma znaczenie tylko wtedy, gdy plik jest naprawdę dłuższy niż 20 sekund, a dodatkowy czas zawiera istotną akcję. W tym artykule ostateczny oryginalny przykład jest osadzony poniżej z klatką plakatu, aby czytelnicy mogli zobaczyć ukończoną sekwencję na miejscu.
Nasz oryginalny przykład: dziecko na placu zabaw pyta, otrzymuje bezpośrednią odpowiedź, wpatruje się z niedowierzaniem, pisze i próbuje ponownie w jednym 26-sekundowym wideo w orientacji poziomej. Napisy są dodatkami redakcyjnymi do wygenerowanego występu.
Przed opublikowaniem realistycznej sceny wygenerowanej przez AI użyj etykiety treści AI danej platformy, tam gdzie ma to zastosowanie. Wytyczne TikToka dotyczące treści generowanych przez AI wyjaśniają narzędzia do oznaczania i wymagania dla realistycznych mediów AI. Wytyczne YouTube dotyczące zmienionych lub syntetycznych treści opisują ujawnianie podczas przesyłania. Użyj własnego wizerunku, fikcyjnej postaci lub uczestnika, który zgodził się wystąpić. Dwa powyższe przykłady GIF online służą do analizy; opublikowanie przeróbki wymaga własnego materiału, dźwięku i pozwoleń.
Co sprawia, że puenta trafia w dłuższym montażu?
26-sekundowa wersja potrzebuje więcej niż dwóch kopii 13-sekundowego memu. Dajemy dziecku widoczną zmianę strategii. Początkowo telefon jest traktowany jak maszyna do skrótów. Po odpowiedzi dziecko nie tylko powtarza żądanie: marszczy brwi, pisze, przeformułowuje je i próbuje negocjować z odpowiedzią. Ta zmiana zamienia ostatnie uderzenie w nowy żart, a nie w wypełniacz.
Czytelność przy wyłączonym dźwięku również zmienia montaż. W kanale widzowie mogą spotkać klip wyciszony. Podpisy muszą ujawniać pytanie i odpowiedź w odpowiednich momentach, podczas gdy ruch aktora dostarcza emocji. Opóźniony podpis „Serio?” nie powinien pojawić się podczas pierwszej oszołomionej klatki; najpierw pojawia się ciche spojrzenie. Ta maleńka pauza to moment, w którym widz czyta twarz.
Na koniec, utrzymuj konfigurację zgodną z prawdą. Wideo to inscenizowana scena komediowa, a kwestia to scenariuszowy gag. Nie pokazuje prawdziwej sesji chatbota ani nie obiecuje, że ktokolwiek może stać się bogaty w 30 dni. Następnym użytecznym działaniem jest wybranie oryginalnego wykonawcy i scenerii, rozrysowanie czterech uderzeń i sprawdzenie, czy ktoś zrozumie twoją wersję roboczą przy wyłączonym dźwięku. Jeśli potrafi zidentyfikować zarówno pytanie, jak i urażoną drugą próbę, format działa.
Często zadawane pytania
Czy chatbot naprawdę odpowiedział „Znajdź pracę”?
To wyrażenie jest puentą w formacie komediowym. Wideo, które je pokazuje, nie jest dowodem na prawdziwą wymianę z chatbotem ani na odpowiedź, którą zawsze otrzymasz.
Czy mogę zrobić mem ze zwierzakiem lub znajomym?
Tak, jeśli masz odpowiednie zdjęcie i zgodę jakiejkolwiek pokazanej osoby. Wersja ze zwierzakiem wymaga wyraźnych oczu, pyska i oznaczeń na sierści. Wersja ze znajomym wymaga wyraźnej twarzy i jego zgody na przedstawienie go wypowiadającego te kwestie.
Dlaczego używać modelu wideo, a następnie dodawać podpisy osobno?
Model obsługuje ruch i aktorstwo; redaktor obsługuje dokładny tekst. Rozdzielenie tych zadań pozwala uniknąć zniekształconych ekranów telefonu i daje kontrolę nad timingiem puenty.
Czy oryginalny przykład tutaj przekracza 20 sekund?
Tak. Dostarczony plik MP4 jest weryfikowany po eksporcie, zamiast polegać wyłącznie na czasie trwania wybranym w generatorze. Dodatkowy czas jest wykorzystywany na drugą próbę i końcową reakcję.


