Jedna osoba siedzi na skraju drewnianego pomostu i patrzy na spokojną wodę. Druga osoba stoi w przyboju w miętowozielonej sukience, wskazuje prosto w obiektyw kamery, śpiewając, a potem siada obok pierwszej na mokrym piasku o zachodzie słońca. Dwadzieścia osiem sekund później klip się zapętla, a dwie twarze na ekranie należą do pary, która nigdy nie postawiła stopy na tej plaży. To trend raindance ai, który od końca września 2026 roku zamienia pary portretów z galerii zdjęć w nadwodny duet z hitu Dave'a i Tems na TikToku i Instagram Reels.
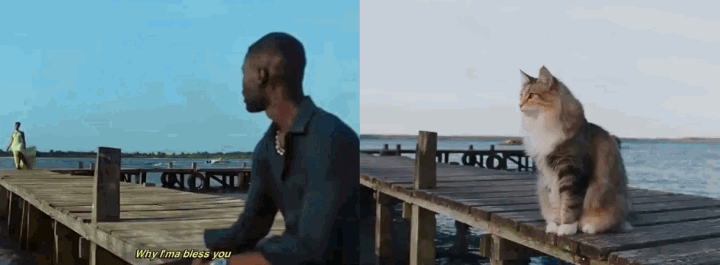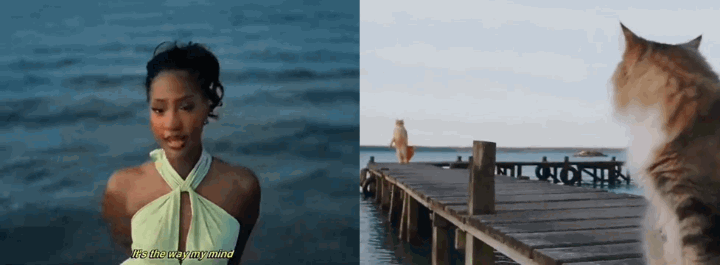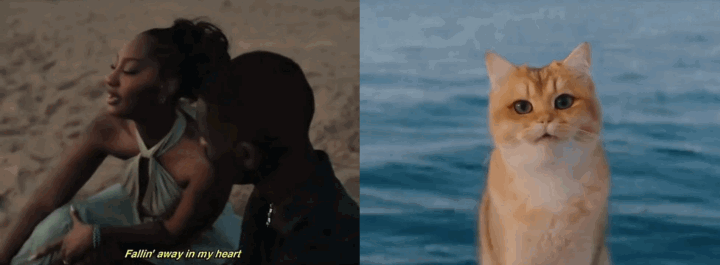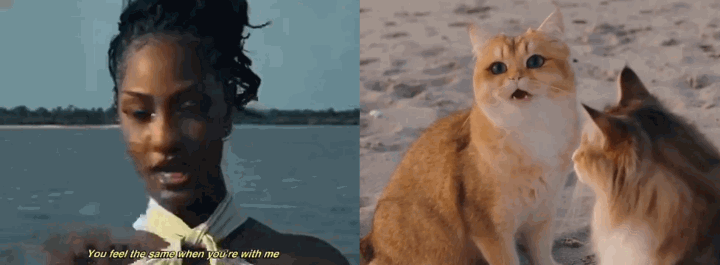
Dwa osobne zdjęcia (mogą być ze zwierzętami) przeniesione w scenę oczekiwania na pomoście, zbliżenia nad morzem i plaży o zachodzie słońca.
Do udziału w tym trendzie nie potrzebujesz sprzętu do nagrywania ani edytorów osi czasu. Kling 4.0 przyjmuje dwa portrety od pasa w górę oraz klip referencyjny, a następnie utrwala tożsamość obu osób w każdym oryginalnym ujęciu od pomostu do plaży. Jeśli wolisz podejście oparte wyłącznie na promptach, MiniMax H3 generuje oryginalne spotkanie o zachodzie słońca lub w deszczu z samych dwóch zdjęć.
Czym jest trend Raindance AI?
Dwa zdjęcia, złota godzina i ścieżka dźwiękowa Dave'a & Tems. Oto cała formuła stojąca za viralowym trendem Raindance. Generator tnie między dwoma ujęciami solowymi — jedna osoba czeka na pomoście, druga śpiewa prosto do kamery — po czym umieszcza je obok siebie na piasku. Bez nagrywania. Każdy, kto ma dwa zdjęcia portretowe, może natychmiast połączyć partnerów w związku na odległość lub zestawić dwoje przyjaciół w tej samej scenie.
| Element | Szczegóły |
| Oryginalny utwór | „Raindance" Dave'a z gościnnym udziałem Tems, wydany 23 października 2025 (The Boy Who Played the Harp) |
| Materiał źródłowy | Oficjalny teledysk w reżyserii Nathana Jamesa Tetteya, nakręcony w Lagos i opublikowany 9 stycznia 2026 |
| Pojawienie się trendu AI | Pierwsze publiczne prompty do podmiany twarzy udostępniono 30 września 2026; klipy szablonowe rozprzestrzeniły się na TikToku i Reels na początku października 2026 |
| Rola 1 (Partner z pomostu) | Zaczyna siedząc na drewnianym pomoście w ciemnozielonej koszuli; pojawia się w początkowych ujęciach na pomoście i w finałowym dwuosobowym ujęciu na plaży |
| Rola 2 (Śpiewająca nad morzem) | Pojawia się na dalekim końcu pomostu w miętowozielonej sukience, śpiewa w zbliżeniach nad oceanem, wskazuje w obiektyw i dołącza do Roli 1 na piasku |
| Inne nazwy w wyszukiwaniu | Trend pary Raindance, teledysk AI Dave'a i Tems, filtr dwuzdjęciowy Raindance |
Ujęcia od pomostu do plaży, krok po kroku
Niezależnie od tego, czy przytniesz 15-sekundowy klip referencyjny, czy wygenerujesz całą 28-sekundową sekwencję, obraz podąża za trzema powtarzającymi się momentami z oryginalnego montażu nad wodą.
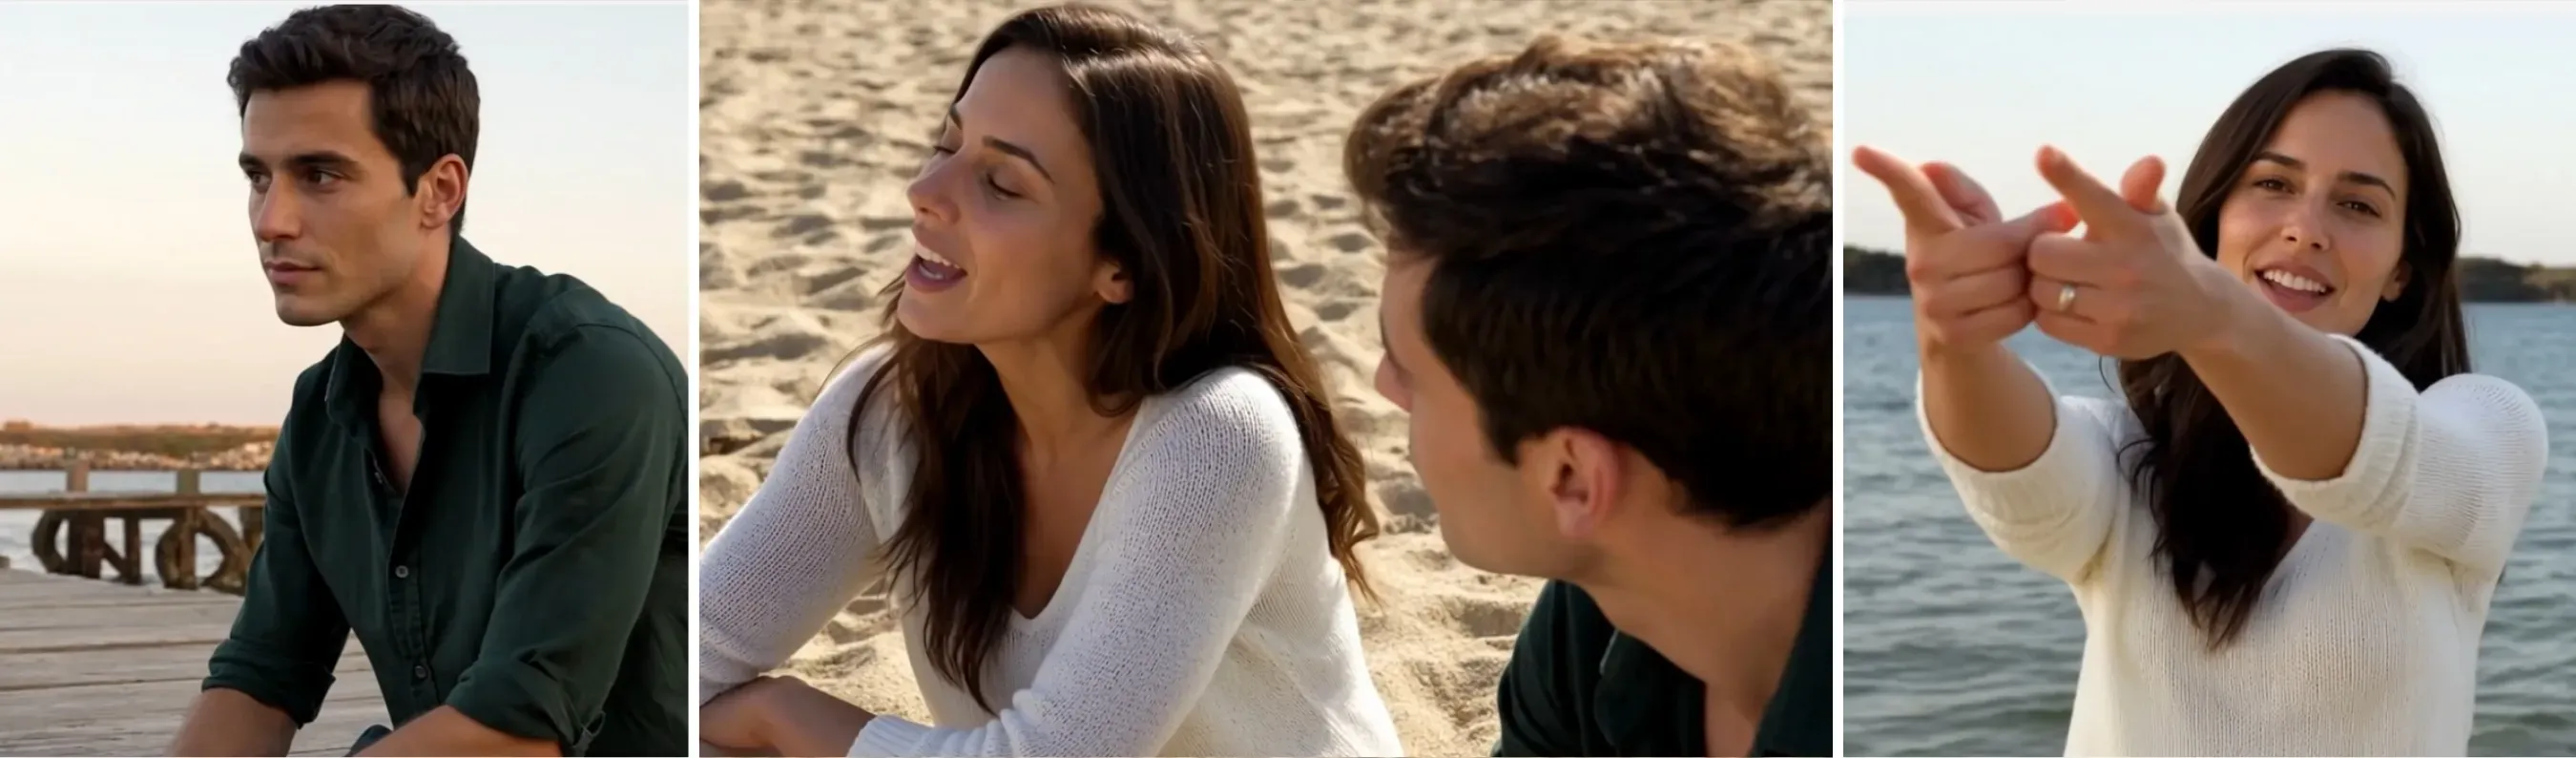
Charakterystyczna sekwencja: oczekiwanie na pomoście, wspólne siedzenie i wskazywanie w obiektyw nad morzem.
- Oczekiwanie na pomoście. Osoba 1 siedzi przy skraju zniszczonego drewnianego pomostu nad spokojną wodą i patrzy wzdłuż desek, gdy w oddali pojawia się druga postać.
- Zbliżenie nad oceanem. Montaż przecina do przyboju w złotej godzinie. Osoba 2 stoi przed falami ze skrzyżowanymi lub swobodnie opuszczonymi rękami, cicho śpiewając do kamery.
- Wskazanie w obiektyw. Osoba 2 wyciąga jedną dłoń prosto w kierunku obiektywu kamery na beat wokalny, utrzymując kontakt wzrokowy w ciasnym kadrze od pasa w górę. To właśnie ta klatka jest najczęściej używana przez twórców jako obraz okładki na TikToku.
Które generatory AI faktycznie tworzą wideo Raindance?
Cztery narzędzia internetowe umieszczają obecnie nazwę trendu na dedykowanej stronie docelowej. Cztery z nich wykorzystują modele generatywnego wideo do tworzenia klipu ze zdjęć, a dwa z nich podają dokładny model bazowy, na którym działają. Poniższe specyfikacje pochodzą z publicznych stron każdego produktu z 29 października 2026.
| Narzędzie | Potrzebne zdjęcia | Długość wyjściowa, klatka i rozdzielczość | Ceny i uwagi dotyczące dźwięku |
| Starrd Szablon Raindance | 1 lub 2 zdjęcia (osoby lub zwierzęta) | 28 sekund (12 ujęć), panoramiczny 16:9, 480p | 250 kredytów (około $12.50); zawiera zsynchronizowaną piosenkę |
| Buble Generator wideo Raindance AI | 2 zdjęcia | 15 lub 30 sekund; stałe 4:3 | 750 kredytów (15 s) lub 151 kredytów (30 s) |
| Airaindance RainDance AI | 2 zdjęcia (osoba lub zwierzę) | darmowe 2-sekundowe ujęcie was obojga na plaży w podglądzie 480p; 28 s, stałe 4:3 | 50 kredytów w 480p Standard; 100 kredytów lub w 720p HD; eksportuje cichy plik MP4 |
| MakeMemev Raindance AI | 2 zdjęcia | 10-sekundowy klip z pomostem, morzem i plażą o zachodzie słońca, bez znaku wodnego, 4:3 | Cena od $4.99 za wideo z dołączonym dźwiękiem trendu |
Kluczowy wniosek tkwi w trzeciej kolumnie. Wieloujęciowy remake teledysku Starrd działa na Kling 4.0, a oryginalne spotkanie na pomoście Buble działa na MiniMax H3. Ponieważ oba modele bazowe są hostowane bezpośrednio na Atlas Cloud, nie musisz płacić od $9.99 do $12.99 za klip 480p lub 720p zablokowany w stałej klatce 4:3. Możesz samodzielnie otworzyć model bazowy, ustawić proporcje na pionowe 9:16 dla TikToka i Reels, renderować do 1080p i kontrolować w prompcie, co obie osoby mają na sobie.
Jak przygotować dwa zdjęcia, aby twarze się nie zlewały
Modele wideo z wieloma postaciami odczytują miejsca referencyjne po indeksie. Zanim otworzysz generator, przygotuj dwa portrety według czterech zasad, aby model utrzymał obie twarze odrębne w każdym ujęciu.
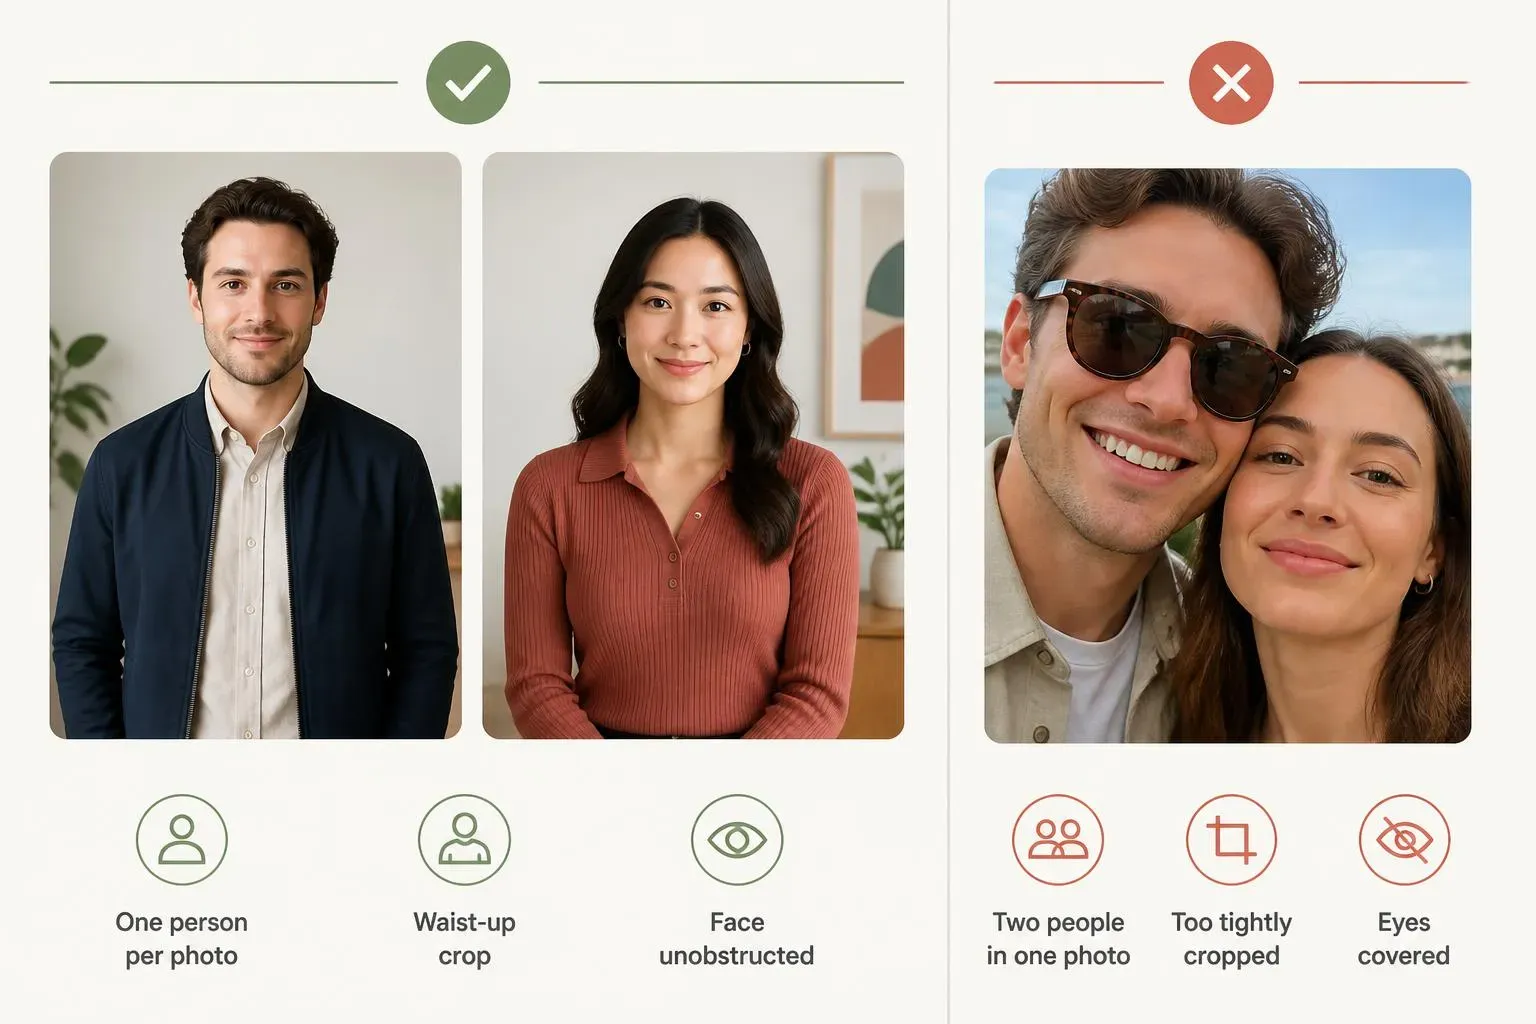
Osobne portrety od pasa w górę utrzymują role i stroje odrębne we wszystkich trzech ujęciach.
- Umieść jedną osobę w każdym pliku graficznym. Przesłanie selfie pary do jednego miejsca referencyjnego zmusza enkoder wizyjny do zgadywania, która twarz należy do której postaci, co prowadzi do zlania się rysów w końcowym ujęciu na plaży. Wytnij każdą osobę do osobnego pliku JPG lub PNG poniżej 10 MB.
- Użyj kadru od pasa w górę lub do trzech czwartych. Ciasny kadr w stylu paszportowym od brody do czoła nie daje modelowi żadnych danych o ubraniu, zmuszając go do wymyślenia koszul lub zapożyczenia strojów Dave'a i Tems z wideo referencyjnego. Zdjęcie od pasa w górę utrwala bluzkę i kurtkę Twojej postaci w całym ujęciu.
- Dopasuj skalę twarzy w obu plikach. Zdjęcia mogą pochodzić z zupełnie różnych miejsc, na przykład z biura i z ulicy. Liczy się proporcja: wybierz dwa zdjęcia, na których obie głowy zajmują podobną część kadru, aby model wyrenderował obie osoby w naturalnych względnych wzrostach, gdy siedzą obok siebie.
- Nie zasłaniaj oczu i ust. Rola 2 śpiewa do obiektywu i wskazuje w kamerę. Okulary przeciwsłoneczne, ręce oparte na brodzie lub mocne filtry upiększające psują ruch ust i powodują migotanie twarzy w zbliżeniach.
Jak stworzyć wideo Raindance AI na Atlas Cloud
Atlas Cloud hostuje oba modele bazowe, które napędzają płatne szablony firm trzecich, w tym Kling 4.0 i MiniMax H3. Wybierz Metodę 1, jeśli masz klip referencyjny oryginalnego wideo nad wodą i chcesz skopiować jego cięcia kamery. Wybierz Metodę 2, jeśli masz tylko dwa zdjęcia i chcesz wygenerować ciągłe spotkanie na pomoście od zera.
Metoda 1 Odtwórz ujęcia od pomostu do plaży z Kling 4.0
Kling 4.0 przyjmuje do 10 obrazów referencyjnych, 5 filmów referencyjnych, 7 osób i 3 głosy w jednym żądaniu oraz renderuje do 30 sekund natywnego wideo 1080p. Każdy przesłany plik wiążesz w prompcie za pomocą @-syntax w dokładnej kolejności przesłania (@Image1, @Image2 i @Video1).
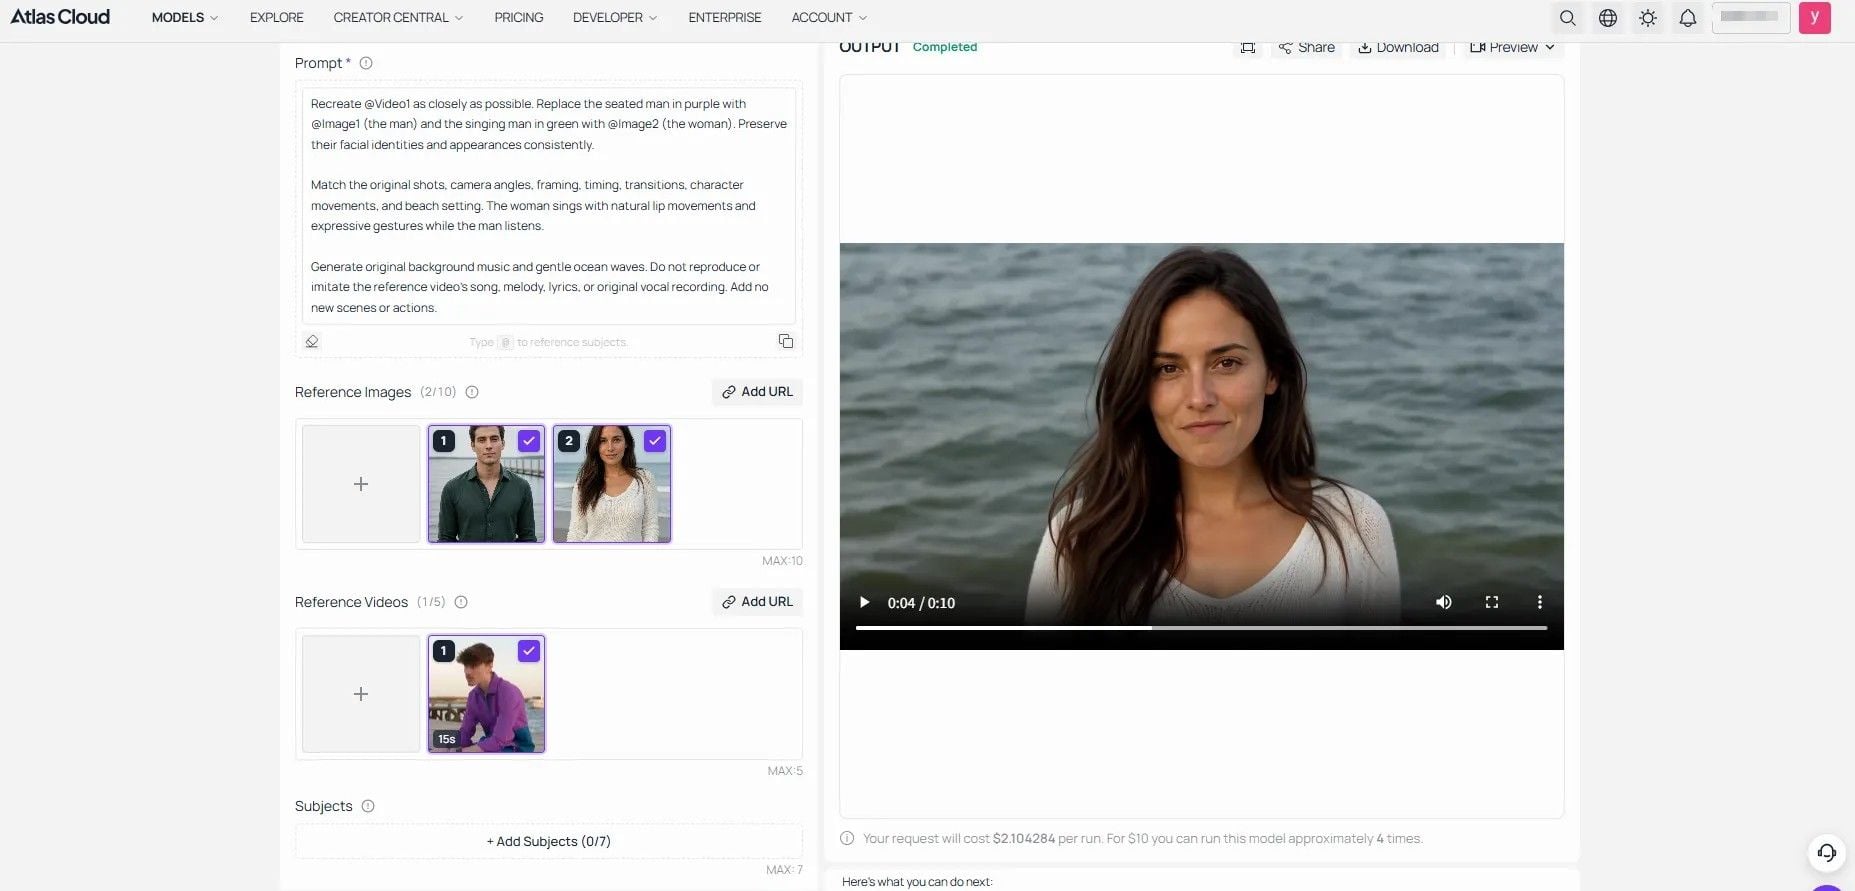
Prześlij partnera z pomostu jako @Image1, śpiewającą osobę jako @Image2, a klip referencyjny jako @Video1 w Kling video 4.0.
- Otwórz plac zabaw Kling video 4.0 na Atlas Cloud.
- W sekcji Reference Images prześlij najpierw zdjęcie Partnera z pomostu (
@Image1), a jako drugie zdjęcie Śpiewającej nad morzem (@Image2). - W sekcji Reference Videos prześlij 10–15-sekundowy klip (
@Video1) obejmujący oczekiwanie na pomoście, zbliżenie nad oceanem i siedzenie na plaży o zachodzie słońca. - Wklej poniższy prompt do pola Prompt, zastępując opisy ubioru tym, co Twoje dwie postacie mają na sobie na zdjęciach:
plaintext1Recreate @Video1 as closely as possible. Replace the seated man in purple with @Image1 (the man) and the singing man in green with @Image2 (the woman). Preserve their facial identities and appearances consistently. 2Match the original shots, camera angles, framing, timing, transitions, character movements, and beach setting. The woman sings with natural lip movements and expressive gestures while the man listens. 3Generate original background music and gentle ocean waves. Do not reproduce or imitate the reference video's song, melody, lyrics, or original vocal recording. Add no new scenes or actions.
- Ustaw Czas trwania zgodnie z długością klipu referencyjnego (na przykład 10 sekund).
- Ustaw Proporcje na
9:16dla pełnoekranowego posta na TikToku lub Reels albo wybierz 16:9 dla wideo panoramicznego. Wybierz Auto, aby Kling sam określił proporcje na podstawie wideo referencyjnego. - Użyj 720p do pierwszych testów, aby sprawdzić spójność postaci, stroje i przejścia między ujęciami, a następnie kliknij Uruchom.
Metoda 2 Wygeneruj oryginalny duet na pomoście z MiniMax H3
Jeśli nie chcesz przycinać ani przesyłać wideo referencyjnego, przełącz się na MiniMax H3 Reference-to-Video. Model przyjmuje do 9 obrazów w tablicy refers, renderuje klipy od 5 do 15 sekund do rozdzielczości 2K i generuje pasującą ścieżkę dźwiękową tła wraz z wideo.
- Otwórz MiniMax H3 Reference-to-Video w Atlas Cloud Video Generator.
- Dodaj swoje dwa portrety do listy referencyjnej: najpierw siedzącego partnera, a potem nadchodzącą śpiewającą osobę.
- Wklej poniższy prompt sceny. Możesz swobodnie dostosować scenerię i atmosferę do nastroju, jaki chcesz uzyskać — nie ograniczaj się do deszczowego pomostu ani śpiewającego duetu.
- Ustaw Proporcje wyraźnie na
9:16lub4:3. Domyślne ustawienie toadaptive, które wybiera klatkę wyjściową na podstawie wymiarów przesłanego portretu, o ile nie nadpiszesz tego ustawienia. - Wybierz
10lub15sekund dla Czasu trwania i768Plub2Kdla Rozdzielczości, a następnie kliknij Uruchom.
Bez wideo referencyjnego osiągnięcie odtworzenia 1:1 jest dość trudne; możesz jednak użyć oryginalnego wideo jako referencji, wnosząc jednocześnie własne pomysły twórcze:
Metoda 3 Uruchom przepływ dwuzdjęciowy przez API
Jeśli budujesz aplikację do wideo społecznościowych lub uruchamiasz generowanie wsadowe, oba modele znajdują się za tym samym punktem końcowym /api/v1/model/generateVideo na Atlas Cloud.
Krok 1: Utwórz klucz API. Otwórz Ustawienia w konsoli Atlas Cloud, kliknij Utwórz klucz API i bezpiecznie zapisz token.
Krok 2: Wyślij żądanie generowania. Poniższy przykład curl uruchamia dwuzdjęciowy przepływ Kling 4.0 z Metody 1:
plaintext1# Step 1: Start video generation 2generate_url = "https://api.atlascloud.ai/api/v1/model/generateVideo" 3headers = { 4 "Content-Type": "application/json", 5 "Authorization": "Bearer $ATLASCLOUD_API_KEY" 6} 7 8 data = { 9 "model": "kwaivgi/kling-v4.0/reference-to-video", 10 "reference_images": [ 11 "image1 url", 12 "image2 url" 13 ], 14 "reference_videos": [ 15 "your reference video" 16 ], 17 "duration": 3-30, 18 "resolution": "720p/1080p", 19 "ratio": "9:16"/"16:9"/"1:1"/"21:9", 20 "prompt": "your prompt" 21 }'
Krok 3: Odpytuj o gotowy plik MP4. Odpowiedź POST zwraca prediction_id. Odpytuj punkt końcowy predykcji, aż status przyjmie wartość completed, a adres URL wideo pojawi się w tablicy wyjściowej:
plaintext1poll_url = f"https://api.atlascloud.ai/api/v1/model/prediction/{prediction_id}"
Aby przełączyć to samo wywołanie API na MiniMax H3, zmień ciąg model na "minimax/h3/reference-to-video" i przekaż adresy URL obrazów w tablicy refers.
Dlaczego Twoje wideo Raindance AI wygląda źle
Większość defektów wizualnych wynika z tego, jak przycięto lub ułożono dwa zdjęcia. Skorzystaj z poniższej tabeli, aby ustalić przyczynę i naprawić klip jednym przebiegiem.
| Co widzisz | Co zwykle to powoduje | Co zmienić |
| W zbliżeniu nad oceanem śpiewa niewłaściwa osoba | @Image1 i @Image2 przesłano w odwrotnej kolejności niż role wymienione w prompcie | Zamień dwa miejsca przesyłania obrazów, aby partner z pomostu był pierwszy, a śpiewająca nad morzem druga |
| Obie osoby mają zlewającą się twarz na plaży | Obie osoby przesłano w jednym zdjęciu pary albo jedno zdjęcie miało znacznie niższą rozdzielczość | Rozdziel osoby na dwa osobne pliki graficzne, w których obie twarze mają podobną ostrość i rozmiar w kadrze |
| Śpiewająca osoba ma na sobie miętową sukienkę Tems lub koszulę Dave'a | Prompt nie określał ubioru, więc model skopiował garderobę z @Video1 | Opisz kolor koszuli lub kurtki każdej osoby w prompcie i zakończ zdaniem Do not copy the outfits of the performers in @Video1 |
| Twarze zniekształcają się przy cięciu z pomostu nad morze | Prompt opisywał ciągły ruch przez twarde cięcie kamery w wideo referencyjnym | Dodaj wyraźne znaczniki etapów (In shot 1... In shot 2... In shot 3...), aby model traktował każde cięcie jako czysty reset sceny |
| Osoby pojawiają się z bosymi stopami lub niedopasowanymi spodniami | Zdjęcia wejściowe zostały mocno przycięte na wysokości klatki piersiowej | Prześlij portrety do trzech czwartych lub nazwij ubranie dolnej części ciała (granatowe spodnie i białe sneakersy) w prompcie |
| Dłoń wskazująca w obiektyw jest rozmyta lub ma dodatkowe palce | Szybkie skrócenie perspektywy w kierunku kamery w szkicu o niskiej rozdzielczości | Dodaj do promptu: points one clear five-finger hand steadily toward the camera lens, i uruchom końcowy przebieg w 1080p |
Przepływ Raindance wymaga dwóch czystych portretów od pasa w górę i właściwego potoku modeli. Kling 4.0 przenosi ujęcia pomostu, oceanu i zachodu słońca bezpośrednio z klipu referencyjnego na Twoje zdjęcia. MiniMax H3 generuje całe nadmorskie spotkanie, korzystając wyłącznie z dwóch portretów. Trzymaj każdą osobę w osobnym pliku graficznym, przypnij ich stroje w prompcie i zsynchronizuj oficjalny utwór przy przesyłaniu.
Najczęściej zadawane pytania
Czy wideo AI zawiera oficjalny utwór Raindance Dave'a i Tems?
Kling 4.0 i MiniMax H3 generują własny zsynchronizowany dźwięk albo przenoszą dźwięk z przesłanego klipu referencyjnego. Nawet jeśli Twój klip referencyjny zawiera muzykę, najlepszym rozwiązaniem dla TikToka i Instagram Reels jest wyciszenie wyeksportowanego pliku MP4 przy przesyłaniu i wybranie oficjalnego utworu „Raindance" Dave'a z gościnnym udziałem Tems w aplikacji. Wybór rodzimego dźwięku platformy indeksuje Twoje wideo na stronie trendu i zapobiega wyciszeniu z powodu praw autorskich.
Czy dwa zdjęcia mogą pochodzić z różnych miejsc lub zawierać zwierzęta?
Tak. Oba modele budują nadmorską scenę na podstawie promptu lub wideo referencyjnego, więc Twoje dwa portrety nie muszą mieć pasujących teł. Możesz też przesłać wyraźne zdjęcie psa, kota lub postaci animowanej przodem do kamery do dowolnego miejsca.
Ile kosztuje wideo Raindance AI na Atlas Cloud?
Sprawdź przycisk Uruchom, aby poznać dokładną cenę przed generowaniem. MiniMax H3 zaczyna się od $0.038/s, ~$0.8–1.3 za 10-sekundowy klip 768p/2K. Kling 4.0 to $0.11/s, ~$1.4–2.1 za 10-sekundowy klip 720p/1080p.
Czy muszę oznaczać wideo Raindance AI jako AI na TikToku?
Tak, gdy wideo wykorzystuje zdjęcia prawdziwych osób. Polityka TikToka dotycząca treści generowanych przez AI wymaga, aby twórcy stosowali przełącznik ujawniania AIGC lub etykietę w opisie, gdy post pokazuje realistyczne wideo prawdziwych osób wykonujących czynności, których nigdy nie nagrały. Zawsze uzyskaj zgodę przed przesłaniem zdjęcia innej osoby do generatora.





