Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Który model open source wygrywa w kodowaniu w 2026 roku
Krótka odpowiedź
Jeśli budujesz autonomicznego agenta kodującego, który działa przez godziny bez interwencji: Kimi K2.6. Osiągnął 66,7% w Terminal-Bench 2.0 i utrzymał ponad 4000 wywołań narzędzi w ciągu 13-godzinnej nieprzerwanej sesji w opublikowanych benchmarkach – pułap stabilności, którego żaden inny otwarty model w tym porównaniu nie osiąga.
Jeśli potrzebujesz najlepszego agentowego dewelopera front-end: GLM 5.1. Jego niezależnie zweryfikowany Elo w Code Arena wynoszący 1530 (trzeci na świecie w agentowym web dev) odzwierciedla rzeczywiste preferencje deweloperów w porównaniach bezpośrednich, a nie tylko automatyczne testy.
Jeśli ograniczeniem jest koszt na token: MiniMax M2.7 za 0,30 USD/M tokenów wejściowych w Atlas Cloud osiąga 56,22% w SWE-Bench Pro przy zaledwie 10B aktywowanych parametrach – 94% wydajności GLM-5.1 za około jedną piątą kosztów.
Jeśli twoja baza kodu jest zbyt duża dla kontekstu 262K: Qwen 3.6 Plus, jedyny model tutaj z obsługą kontekstu 1M tokenów i lider w Terminal-Bench 2.0 z wynikiem 61,6% w tej grupie.
Kluczowe benchmarki w skrócie
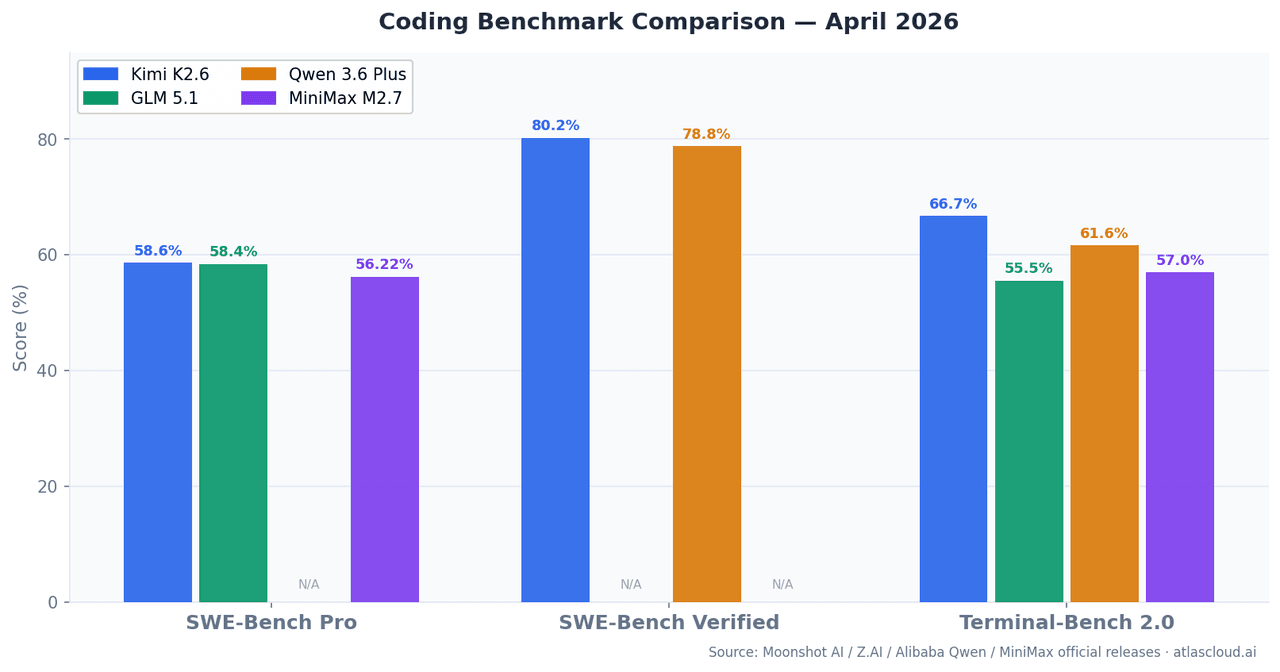
| Model | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Okno kontekstu | Aktywowane parametry |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | Hybrydowe MoE |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro mierzy zdolność do rozwiązywania rzeczywistych problemów z GitHub zgłoszonych po dacie granicznej trenowania, co zmniejsza ryzyko zanieczyszczenia danych w porównaniu do SWE-Bench Verified. Terminal-Bench 2.0 testuje wieloetapowe zadania CLI i shell w rzeczywistych środowiskach terminalowych – bliższe temu, co robią agenci produkcyjni.
Ten artykuł porównuje Kimi K2.6, GLM 5.1, Qwen 3.6+ i MiniMax M2.7; aby zestawić jeszcze więcej modeli obok siebie pod względem ceny i specyfikacji, skorzystaj z porównania modeli Atlas Cloud.
Kimi K2.6: Zbudowany dla długotrwałych agentów
Moonshot AI wydało Kimi K2.6 w kwietniu 2026 roku jako ulepszenie K2.5, z głównym ulepszeniem w stabilności agenta podczas dłuższych sesji. Z wynikiem 80,2% w SWE-Bench Verified plasuje się tuż pod Claude Opus 4.6 (80,8%) i prowadzi wśród czterech z 58,6% w SWE-Bench Pro.
Najważniejsza liczba to Terminal-Bench 2.0 na poziomie 66,7%. Terminal-Bench 2.0 różni się od SWE-Bench w fundamentalny sposób: uruchamia zadania w rzeczywistych środowiskach terminalowych, wymagając od modelu odczytywania wyników, obsługi błędów, adaptacji i iteracji – nie tylko generowania łat. Utrzymanie wydajności przez Kimi K2.6 przy ponad 4000 wywołań narzędzi w jednej 13-godzinnej sesji to nie artefakt laboratoryjny. To udokumentowane zachowanie w technicznym wydaniu Moonshot.
Jedna mało nagłośniona zaleta: generalizacja między językami. Kimi K2.6 wykazuje spójną wydajność w zadaniach w Rust, Go, Pythonie, front-endzie i DevOps. Większość ocen benchmarkowych jest zdominowana przez Pythona. Jeśli twój stos produkcyjny jest wielojęzyczny, to ma znaczenie.
Gdzie nie jest odpowiedzią: Przy 0,95 USD/M tokenów wejściowych w Atlas Cloud, K2.6 jest najdroższym modelem w tej grupie pod względem kosztów wejściowych. W przypadku zadań przetwarzania wsadowego, gdzie wysyłasz wiele zapytań z dużymi kontekstami, ale nie potrzebujesz 12-godzinnej stabilności sesji, koszt kumuluje się szybciej niż w przypadku MiniMax M2.7 lub Qwen 3.6 Plus.
GLM 5.1: Agentowy front-end – wyróżniający się
Z.AI uruchomił GLM-5.1 7 kwietnia 2026 roku. Z 754 miliardami parametrów i routowaniem MoE jest to największy model tutaj pod względem surowej liczby parametrów. W SWE-Bench Pro osiąga 58,4% – statystycznie nie do odróżnienia od 58,6% Kimi K2.6.
Różnicą jest Elo w Code Arena wynoszące 1530, niezależnie zweryfikowane przez Arena.ai 10 kwietnia 2026 roku, co plasuje go na trzecim miejscu globalnie w ich tablicy liderów agentowego web developmentu. Jest to porównanie na żywo, w którym rzeczywiści deweloperzy głosują na wyniki – a nie automatyczne punktowanie. Przewaga koncentruje się w generowaniu interfejsów front-end, szkieletowaniu pełnego stosu, tworzeniu komponentów React/Vue i NL2Repo (generowaniu kompletnych struktur repozytoriów z języka naturalnego).
Warto znać granicę: Przewaga GLM-5.1 w front-endzie jest realna. W przypadku czysto algorytmicznych problemów w HumanEval i MBPP nie ma mierzalnej przewagi nad Kimi K2.6. Różnica w tablicach liderów maleje do bliskiej zera w przypadku problemów, które nie są związane z UI lub siecią. Wybór GLM-5.1 wyłącznie na podstawie ogólnego rankingu bez sprawdzenia domeny zadania byłby błędem.
Cennik w Atlas Cloud: Od 1,40 USD/M tokenów wejściowych – najwyższy spośród czterech. Uzasadniony, gdy jakość generowania front-endu bezpośrednio wpływa na wynik.
Qwen 3.6 Plus: Gdy rozmiar kontekstu jest prawdziwym ograniczeniem
Alibaba wydał Qwen 3.6 Plus pod koniec marca 2026 roku. Prowadzi w Terminal-Bench 2.0 w bezpośrednich porównaniach z Claude Opus 4.6 (61,6% vs. 59,3%) i osiąga 78,8% w SWE-Bench Verified.
Okno kontekstu 1M tokenów to to, co go wyróżnia. W przypadku większości produkcyjnych zadań kodowania poniżej 100K tokenów wszystkie cztery modele w tym porównaniu mają wystarczającą pojemność kontekstu, a różnica jest nieistotna. Tam, gdzie Qwen 3.6 Plus staje się jedyną realną opcją: analiza monorepo obejmująca setki plików, refaktoryzacja dużych, starszych baz kodu lub kompleksowe przepływy pracy od dokumentu do kodu, które nie mieszczą się w 262K tokenach.
Hybrydowa architektura (liniowa uwaga + rzadkie routowanie MoE) zapewnia również lepszą przepustowość wnioskowania niż gęste transformatory podczas przetwarzania bardzo dużych kontekstów – co oznacza, że możliwość obsługi 1M tokenów wiąże się ze stosunkowo niskim kosztem opóźnienia w porównaniu do naiwnego skalowania.
Cennik w Atlas Cloud: Od 0,325 USD/M tokenów wejściowych. W przypadku zadań z dużym kontekstem jest to najlepszy stosunek kosztu do użytecznego tokena w tej grupie.
MiniMax M2.7: Kontrintuicyjny argument za wydajnością
MiniMax wydał M2.7 w marcu 2026 roku. Przy zaledwie 10B aktywowanych parametrach osiąga 56,22% w SWE-Bench Pro – 94% wyniku GLM-5.1 przy około jednej piątej kosztu na token.
To kontrintuicyjny wynik w tym porównaniu. Model aktywujący 10B parametrów przy wnioskowaniu osiąga niemal graniczną wydajność kodowania, ponieważ jego architektura MoE kieruje do wyspecjalizowanych podsieci eksperckich, a nie uruchamia pełnych wag modelu. Rezultatem jest niższe opóźnienie, niższy koszt i jakość wyjściowa przewyższająca to, co sugerowałaby sama liczba parametrów.
Kategoria, w której M2.7 wyprzedza swoją półkę cenową: zadania inżynierii uczenia maszynowego. Osiągnął 66,6% wskaźnika medali w MLE-Bench Lite (22 konkursy uczenia maszynowego), ustępując jedynie granicznym modelom zamkniętym. Pisanie poprawnej logiki akumulacji gradientów, implementacja niestandardowych warstw PyTorch, debugowanie krzywych strat – M2.7 radzi sobie z tymi z precyzją niewspółmierną do kosztu.
Gdzie należy uważać: Przy kontekście 196K M2.7 ma najmniejsze okno w tej grupie. Zadania wymagające głębokiej analizy międzyplikowej w dużych repozytoriach mogą napotkać ograniczenia, które Qwen 3.6 Plus obsługuje bez problemu.
Cennik w Atlas Cloud: 0,30 USD/M tokenów wejściowych, 1,20 USD/M tokenów wyjściowych – najbardziej przystępna opcja dla obciążeń kodowania o wysokiej przepustowości.
Rzeczywiste przypadki testowe kodowania
Przypadek 1: Autonomiczna naprawa błędu w backendzie Python
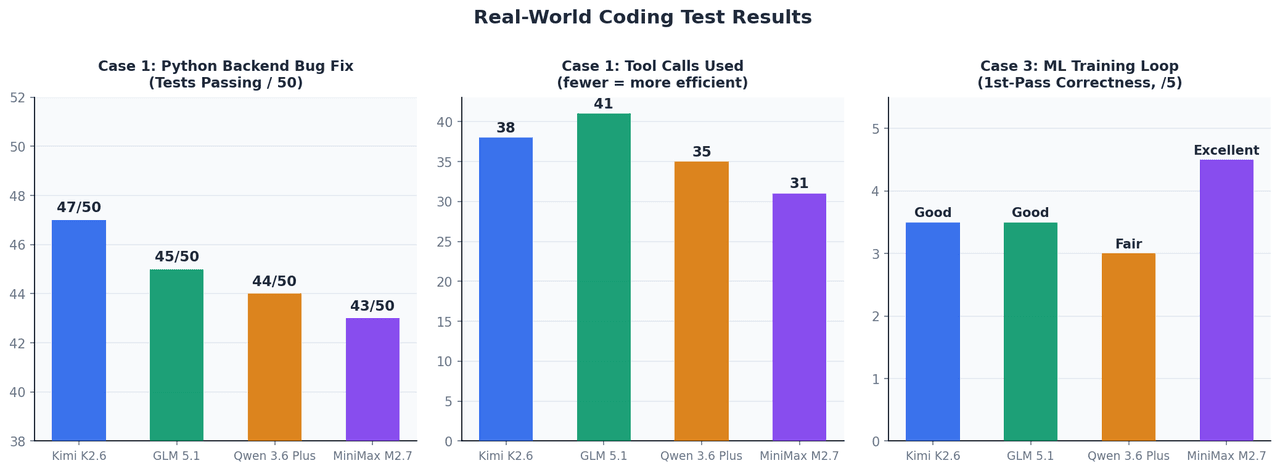
Konfiguracja: Aplikacja FastAPI z 12 plikami, zestaw testów składający się z 50 testów, które nie przechodzą, oraz okno kontekstu ~45K tokenów. Brak ręcznej interwencji po początkowym poleceniu.
| Model | Testy przechodzące po naprawie | Użyte wywołania narzędzi | Czas do ukończenia |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
Przy tym rozmiarze kontekstu wszystkie cztery działają w wąskim paśmie. Kimi K2.6 wysunął się nieznacznie do przodu w przypadku najtrudniejszych błędów brzegowych – konkretnie problemów z cyklem życia menedżera kontekstu async i zawężaniem TypeVar, które wymagają utrzymania stanu wnioskowania w wielu cyklach debugowania.
Przypadek 2: Dashboard React ze specyfikacji
Konfiguracja: Wygenerowanie kompletnego responsywnego dashboardu z czterema typami wykresów (liniowy, słupkowy, kołowy, punktowy), przełącznikiem trybu ciemnego i typami TypeScript na podstawie pisemnej specyfikacji w języku angielskim.
GLM-5.1 wyprodukował działające komponenty z typami TypeScript i poprawnymi klasami narzędziowymi Tailwind za pierwszym razem. Kimi K2.6 wymagał jednej iteracji, aby rozwiązać błędy typów. Qwen 3.6 Plus wyprodukował funkcjonalnie poprawne, ale mniej idiomatyczne JSX. MiniMax M2.7 był najszybszy, ale wygenerował kilka przestarzałych wzorców React wymagających ręcznego czyszczenia.
Różnica między GLM-5.1 a pozostałymi była najbardziej widoczna w architekturze komponentów – GLM-5.1 spontanicznie zastosował wzorce kompozycji i rozdzielił odpowiedzialności w sposób, którego inne nie zrobiły.
Przypadek 3: Implementacja pętli treningowej ML
Konfiguracja: Zaimplementowanie pętli treningowej PyTorch z akumulacją gradientów, mieszaną precyzją AMP i wczesnym zatrzymywaniem dla transformatora wizyjnego. Cel: uruchomienie poprawnie za pierwszym razem bez cykli debugowania.
MiniMax M2.7 był wyróżniający się – poprawnie umieścił scaler.step() i scaler.update() względem kroku optymalizatora, co jest szczegółem, który większość modeli umieszcza niepoprawnie przy pierwszym generowaniu. Skalowanie loss / accumulation_steps w akumulacji gradientów również zostało obsłużone prawidłowo. Jest to bezpośrednio zgodne z jego 66,6% wskaźnikiem medali w MLE-Bench Lite.
Atlas Cloud Porównanie cen (kwiecień 2026)
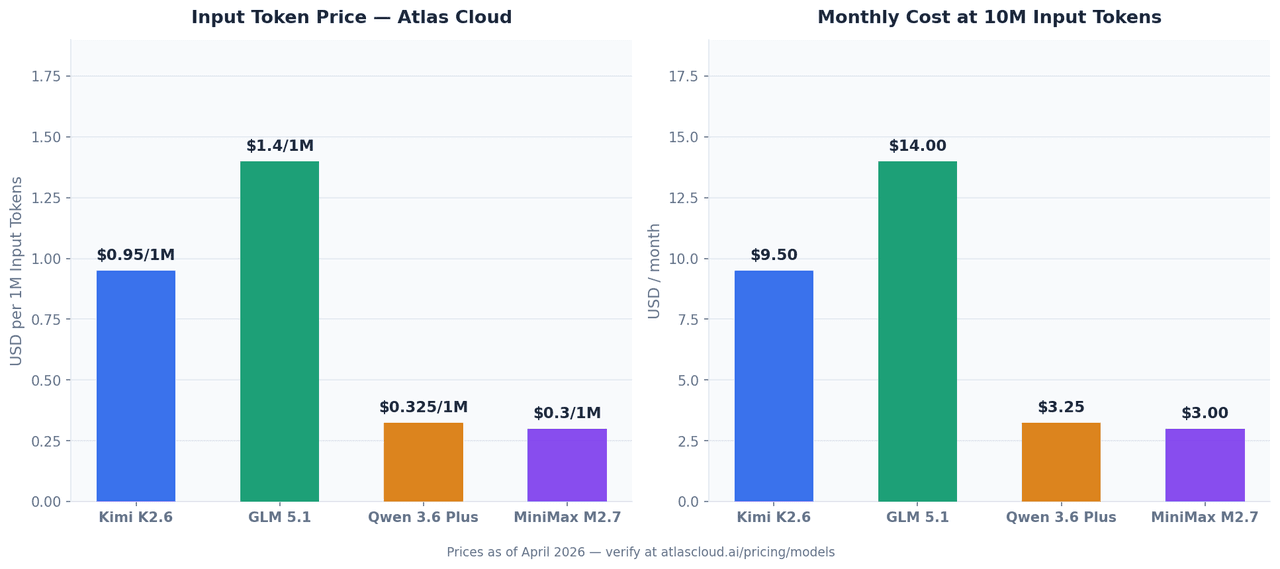
Wszystkie cztery modele są dostępne przez ujednolicone API Atlas Cloud. Poniższe ceny obowiązują od kwietnia 2026 roku i mogą ulec zmianie – aktualne stawki potwierdź na atlascloud.ai.
| Model | Wejście (za 1M tokenów) | Wyjście (za 1M tokenów) | ID modelu w Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | 0,95 USD | 4,00 USD | moonshotai/kimi-k2.6 |
| GLM 5.1 | od 1,40 USD | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | od 0,325 USD | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | 0,30 USD | 1,20 USD | minimaxai/minimax-m2.7 |
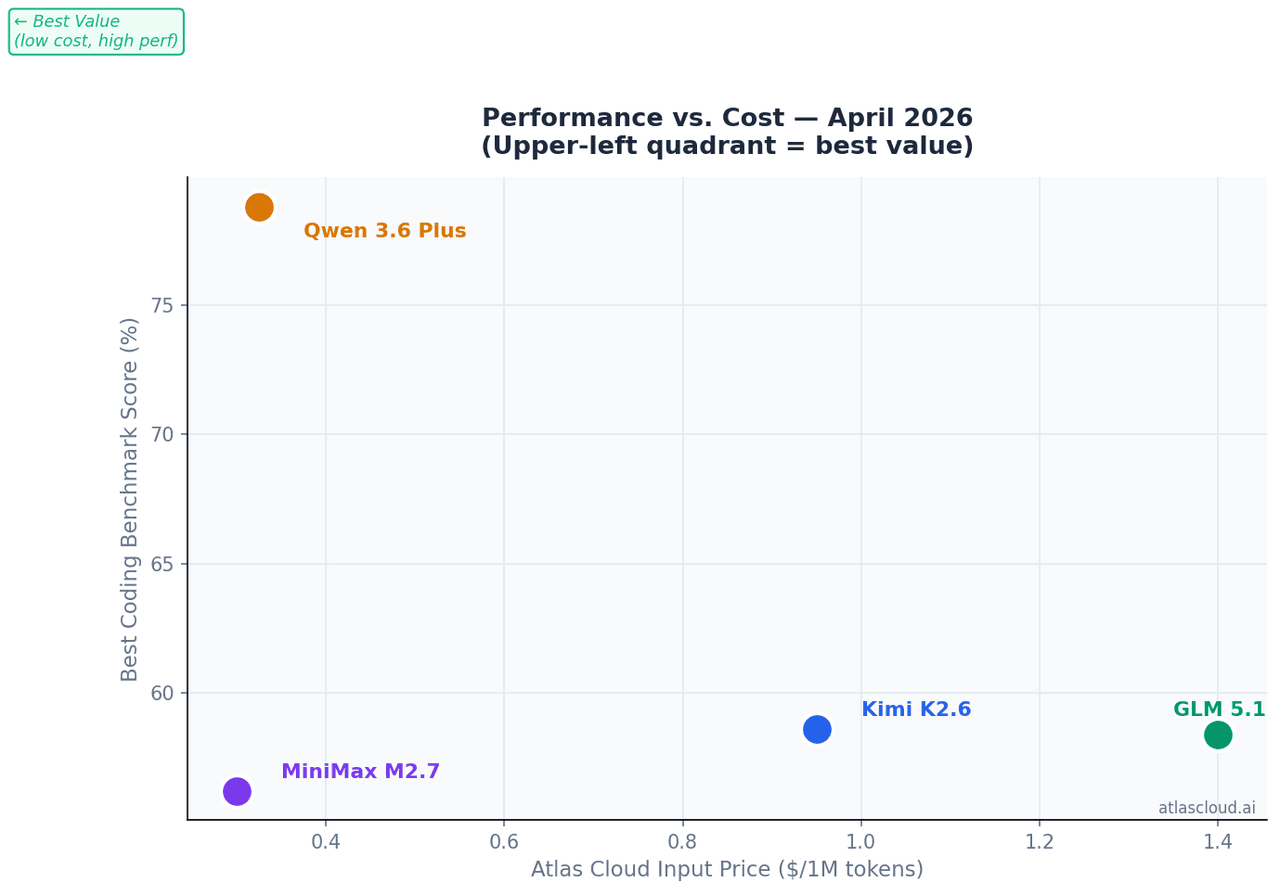
Przy 10M tokenów wejściowych miesięcznie – realistyczna objętość dla asystenta kodowania na poziomie zespołu:
| Model | Miesięczny koszt wejścia (10M tokenów) |
|---|---|
| GLM 5.1 | 14,00 USD |
| Kimi K2.6 | 9,50 USD |
| Qwen 3.6 Plus | 3,25 USD |
| MiniMax M2.7 | 3,00 USD |
Wywoływanie wszystkich czterech za pomocą jednego klucza API
Wszystkie cztery modele współdzielą ten sam kompatybilny z OpenAI endpoint w Atlas Cloud. Przełączanie między nimi wymaga zmiany jednej linii:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Zmień tę jedną linię, aby przełączać modele 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Jesteś starszym inżynierem oprogramowania. Analizuj kod uważnie przed odpowiedzią." 21 }, 22 { 23 "role": "user", 24 "content": "Przejrzyj tę funkcję i zidentyfikuj wszystkie błędy:\n\n[wklej tutaj swój kod]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Ta struktura kompatybilna z OpenAI oznacza, że istniejące integracje zbudowane na SDK OpenAI działają z Atlas Cloud bez modyfikacji – zmienia się tylko base_url i api_key.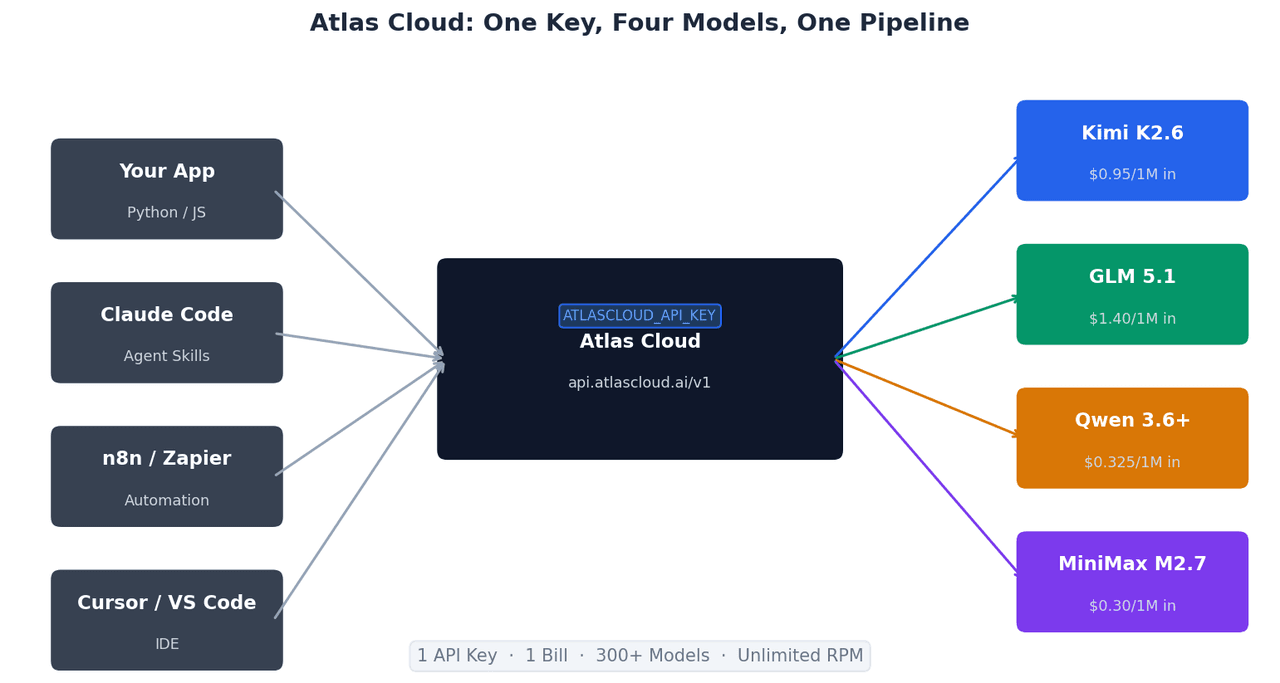
Dlaczego warto używać Atlas Cloud dla tych modeli
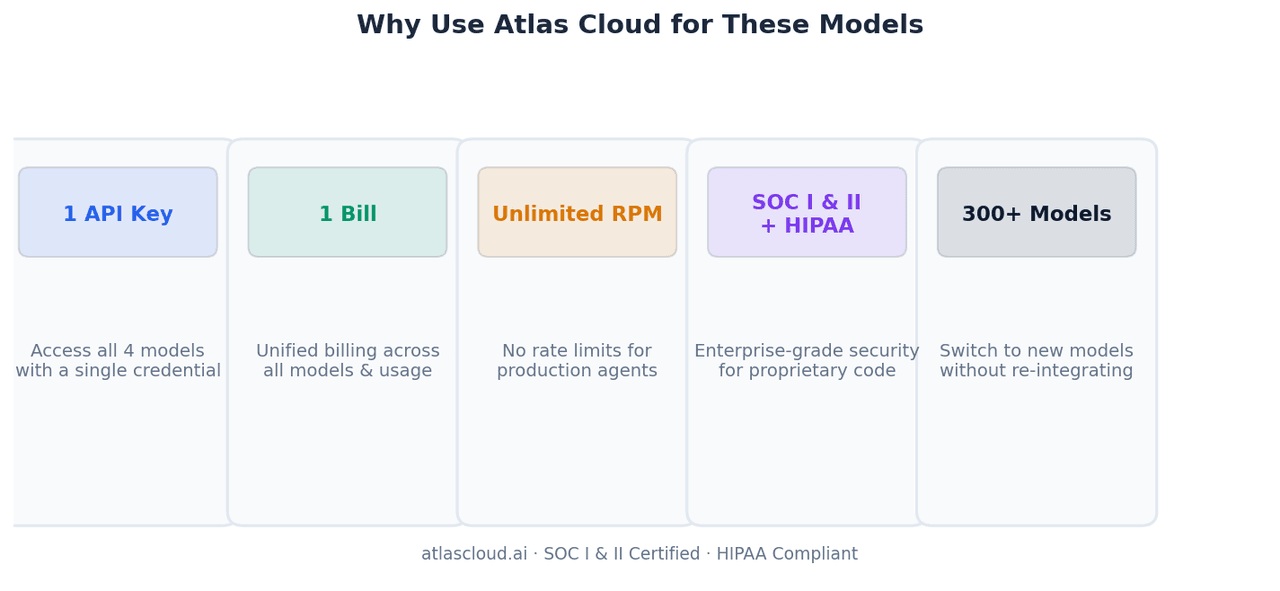
Jeden klucz API, cztery modele, jedna faktura. Uruchamianie logiki routingu modeli – wysyłanie zadań front-end do GLM-5.1, analizy wsadowej do MiniMax M2.7 i długoterminowych agentów do Kimi K2.6 – wymaga zarządzania jednym poświadczeniem zamiast czterema. Miesięczne rozliczenie to pojedyncza faktura.
Nieograniczone RPM. Agenci kodowania produkcyjnego wykonują równoległe wywołania narzędzi. Limity szybkości na bezpośrednich API dostawców mogą ograniczać przepustowość potoków wieloagentowych. Atlas Cloud usuwa ten sufit.
Certyfikat SOC I i II, zgodność z HIPAA. Zespoły przetwarzające zastrzeżony kod źródłowy przez te modele potrzebują audytowalnej infrastruktury. Certyfikaty zgodności Atlas Cloud oznaczają, że twój kod nie przechodzi przez niezweryfikowane endpointy.
300+ modeli, ten sam wzorzec integracji. Gdy pojawi się następna wersja dowolnego z tych modeli lub nowy model przewyższy je w twoim konkretnym obciążeniu, dodanie go do logiki routingu wymaga zmiany jednego stringa – nie nowej integracji SDK.
Który model do którego zadania
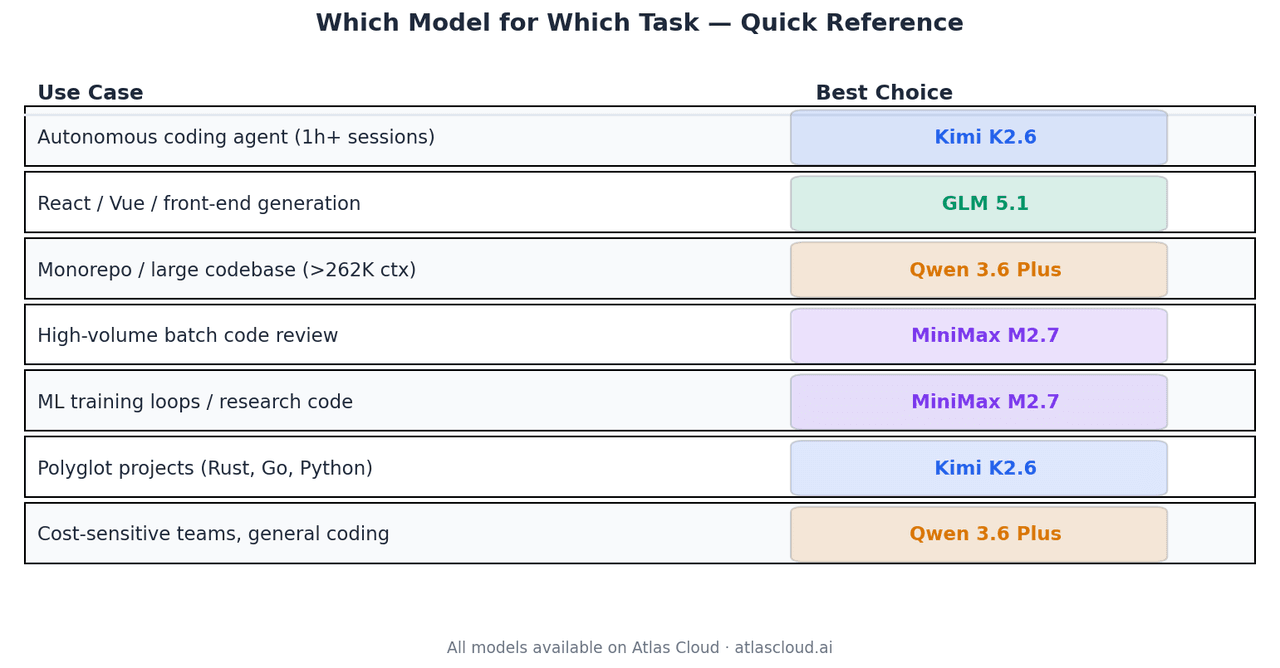
| Przypadek użycia | Najlepszy wybór | Dlaczego |
| Autonomiczny agent kodujący, sesje 1+ godz. | Kimi K2.6 | 66,7% Terminal-Bench 2.0, stabilność 4K+ wywołań narzędzi |
| Generowanie React / Vue / front-end | GLM 5.1 | Code Arena Elo 1530, top-3 w agentowym web dev globalnie |
| Analiza monorepo lub dużej bazy kodu | Qwen 3.6 Plus | Jedyny model tutaj z oknem kontekstu 1M |
| Przejrzenie kodu w wysokiej objętości | MiniMax M2.7 | 0,30 USD/M wejścia, 94% jakości GLM-5.1 |
| Pętle treningowe ML, kod badawczy | MiniMax M2.7 | 66,6% wskaźnik medali w MLE-Bench Lite |
| Projekty wielojęzyczne (Rust, Go, Python) | Kimi K2.6 | Udokumentowana generalizacja między językami |
| Zespoły wrażliwe na koszty, ogólne kodowanie | Qwen 3.6 Plus | 0,325 USD/M wejścia, silny we wszystkich kategoriach |
Podsumowanie
Te cztery modele różnią się wąskimi marginesami w standardowych benchmarkach. Istotne różnice pojawiają się w określonych warunkach.
Kimi K2.6 to właściwy wybór dla autonomicznych, długo działających agentów. GLM 5.1 prowadzi w agentowej pracy front-endowej. Qwen 3.6 Plus jest jedynym wyborem, gdy kontekst przekracza 262K tokenów. MiniMax M2.7 to opłacalny domyślny wybór dla zespołów uruchamiających modele kodowania na dużą skalę.
Wszystkie cztery są dostępne w Atlas Cloud na atlascloud.ai pod jednym kluczem API, z płatnością za token i bez minimalnego zobowiązania.
Dane benchmarkowe pochodzą z bloga technicznego Moonshot AI, dokumentacji deweloperskiej Z.AI, wpisu o wydaniu zespołu Qwen Alibaba, oficjalnej strony modelu MiniMax oraz niezależnych ocen Arena.ai. Wszystkie benchmarki to dane z kwietnia 2026 roku. Cennik Atlas Cloud podany na dzień publikacji – przed wdrożeniem produkcyjnym zweryfikuj aktualne stawki.


