Dwie osoby siedzą naprzeciwko siebie przy stole. Zaczyna się jedna kwestia, a potem poruszają się usta obu osób. Przychodzi ujęcie odwrotne i głos przestaje wydawać się przypisany do twarzy. To właśnie ten błąd, którego twórcy starają się uniknąć, szukając testu synchronizacji ust w dialogu Kling 4.
Ten artykuł zaczyna się od sprawdzenia wersji, a następnie przeprowadza 3 krótkie, powtarzalne testy dialogu na zweryfikowanej rodzinie Kling 3.0: jeden mówca, 2 mówców na zmianę oraz wymiana mieszana angielsko-hiszpańska. Każdy test wykorzystuje natywne audio w momencie generowania; artykuł pokazuje wyniki wizualne jako GIF-y wraz z tą samą 10-punktową kartą oceny. To pojedyncze uruchomienia, a nie uniwersalny benchmark.
Najważniejsze wnioski
- Kuaishou oficjalnie ogłosiło Kling 3.0, a nie osobno określony model dialogowy Kling 4.
- Krótkie, nazwane kwestie wypowiadane na zmianę dają recenzentowi jaśniejszą podstawę do sprawdzenia przypisania mówcy.
- GIF-y ułatwiają szybkie prześledzenie ruchu twarzy i przekazania głosu, ale źródłowy plik MP4 nadal jest potrzebny do weryfikacji synchronizacji dźwięku.
- Traktuj 10-sekundowe uruchomienie jako sprawdzenie scenariusza przed inwestowaniem w bardziej wymagającą wersję produkcyjną.
- Oceniaj milczącego słuchacza równie uważnie jak osobę mówiącą.
Test synchronizacji ust w dialogu Kling 4: najpierw sprawdzenie wersji
W wynikach wyszukiwania fraza „Kling 4” obejmuje obecnie kilka różnych rzeczy: wyjście 4K, Kling 3.0, Kling Video O3, język przedpremierowy i niezweryfikowane nazewnictwo. W momencie tego testu nie udało mi się znaleźć oficjalnej specyfikacji Kuaishou dla wydanego modelu dialogowego „Kling 4”. Nazywanie niezweryfikowanej etykiety gotowym produktem uczyniłoby test mniej przydatnym.
Możliwym do zweryfikowania aktualnym punktem odniesienia jest Kling AI 3.0. Kuaishou ogłosiło rodzinę Video 3.0, Video 3.0 Omni, Image 3.0 i Image 3.0 Omni 5 lutego 2026 r. Ogłoszenie opisuje natywne audio w różnych językach, dialektach i akcentach; sceny dialogowe z kontrolowaną kolejnością mówienia; reżyserię wieloujęciową; oraz długość wideo do 15 sekund (Kuaishou Technology, luty 2026).
Ta deklaracja produktu wyznacza przydatny cel testu. Nie poświadcza jednak każdego wygenerowanego klipu. Natywne audio oznacza, że model może generować dźwięk jako część zadania wideo. Nie gwarantuje, że konkretne usta zamkną się przy każdej spółgłosce, że słuchacz pozostanie nieruchomy ani że cięcie zachowa tożsamość mówcy. Właśnie te szczegóły sprawdza ten test.
Poniższe 3 uruchomienia zachowują wynik wizualny wraz z kartą oceny, aby czytelnik mógł ocenić te same dowody, które posłużyły do sporządzenia notatek.
Co testowaliśmy
Protokół celowo usuwa wymówki. Każda scena używa kadru 16:9, czasu trwania 10 sekund, natywnego audio włączonego lub ustawionego na Auto, jeśli środowisko testowe udostępnia to ustawienie, bez muzyki i bez postprodukcyjnej synchronizacji ust. Każdy widoczny mówca otrzymuje jedną krótką kwestię. GIF-y w artykule zachowują występ wizualny; oceniając synchronizację dźwięku, sprawdź osobno oryginalne pliki MP4.
| Test | Model | Czas trwania | Widoczne postacie | Język | Wypowiadane kwestie | Główny cel oceny |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 sekund | 1 | angielski | 1 | Pierwsza sylaba, dźwięki przy zamkniętych ustach, pauza na końcu |
| 2 | Kling V3.0 Standard T2V | 10 sekund | 2 | angielski | 2 | Prawidłowy mówca i zachowanie cichego słuchacza |
| 3 | Kling V3.0 Pro T2V | 10 sekund | 2 | angielski i hiszpański | 2 | Przekazanie języka, przypisanie i ciągłość twarzy |
Karta oceny przyznaje każdej kategorii 0, 1 lub 2 punkty. 2 oznacza, że zachowanie jest wystarczająco jasne dla zamierzonej 10-sekundowej próbki. 1 oznacza, że jest częściowo przekonujące, ale wymaga ponownego spojrzenia. 0 oznacza, że widz może wyraźnie dostrzec problem. Suma jest zapisem jednego wygenerowanego wyniku dla jednego promptu, a nie twierdzeniem o wszystkich wynikach modelu.
| Kategoria | 0 punktów | 1 punkt | 2 punkty |
|---|---|---|---|
| Zgodność ruchu ust ze słowami | Oczywista niezgodność | Przeważnie nadąża, z widocznymi potknięciami | Synchronizacja przez cały czas wygląda naturalnie |
| Prawidłowe przypisanie mówcy | Zły lub wspólny mówca | Jeden niepewny moment | Każda kwestia należy do nazwanej osoby |
| Zachowanie milczącego słuchacza | Słuchacz mówi lub porusza ustami bezgłośnie | Drobny przypadkowy ruch ust | Słuchacz pozostaje naturalnie uważny |
| Ciągłość wyrazu twarzy | Twarz wyraźnie się psuje lub zmienia | Niewielka niestabilność | Wyraz pozostaje spójny |
| Ciągłość dźwięku przy cięciu | Głos się odłącza lub nagle się zmienia | Przejście jest zauważalne | Cięcie podtrzymuje ten sam rytm dialogu |
Konstrukcja testu odpowiada też na prawdopodobne pytania powiązane z tym wyszukiwaniem: czy Kling 4 zostało wydane, który obecny model potrafi generować dialog, czy 2 osoby mogą mówić na zmianę, jak twórca może zapobiec mówieniu obu postaci, czy dialog mieszany językowo może działać i co powinien obejmować mały budżet testowy?
Test dialogu Kling #1: jeden mówca, jedna krótka kwestia
Jedna osoba wypowiadająca jedną krótką kwestię to punkt odniesienia. Pozwala wyodrębnić najwcześniejsze przydatne kontrole: pierwsze otwarcie ust, zamknięcie przy dźwięku „p” lub „b” oraz zrelaksowany rytm po zakończeniu mowy. Jeśli ten punkt odniesienia wygląda źle, dodanie kolejnej postaci, cięcia kamery lub innego języka tylko utrudni diagnozę.
To uruchomienie wykorzystuje fikcyjną pracownicę biurową o imieniu Maya. Scena zawiera niewielki gest dłoni i bezpośrednie spojrzenie, ale nie ma szybkiego ruchu kamery. Dzięki temu głównym dowodem pozostają usta i głos.
Ustawienia uruchomienia: 16:9, 10 sekund, najwyższa dostępna rozdzielczość środowiska testowego w momencie uruchomienia, natywne audio On lub Auto, bez muzyki w tle. Model: Kling V3.0 Standard Text-to-Video.
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
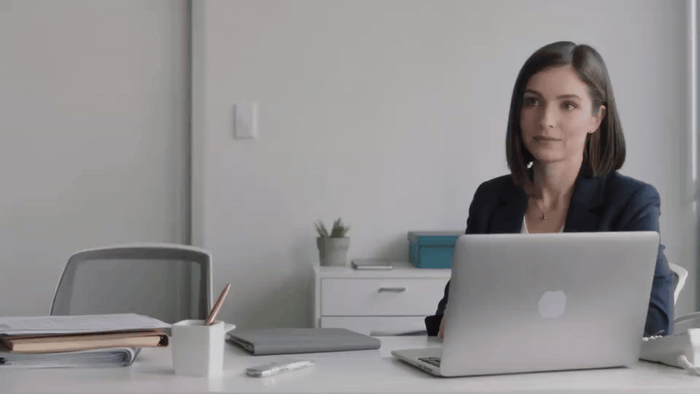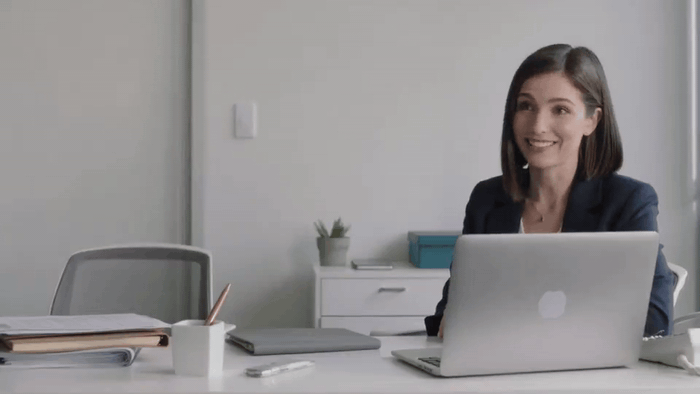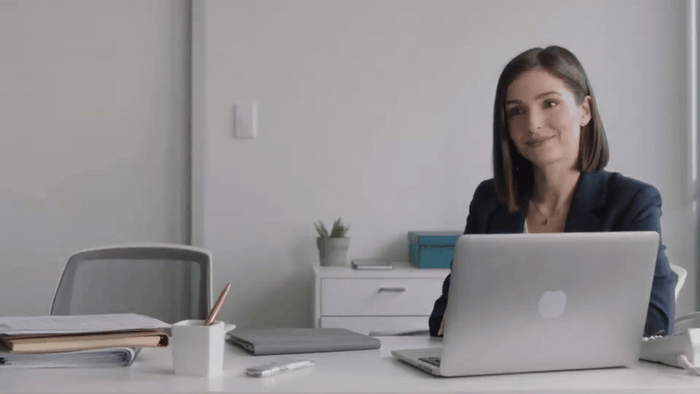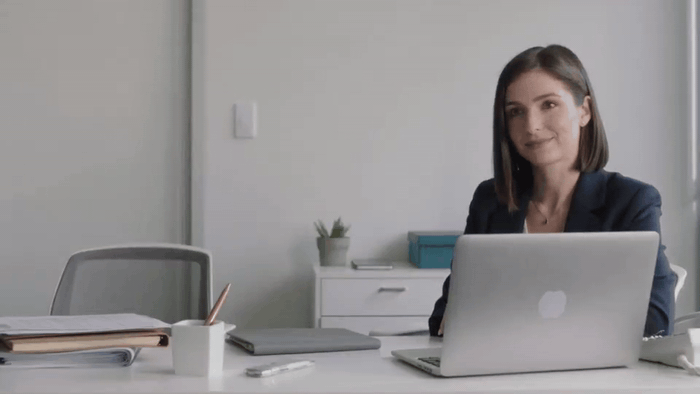
Wynik wizualny testu 1: Maya wypowiada jedną biurową kwestię
Wynik wizualny testu 1. Obserwuj zamknięcie ust Mai przy „Please” i pauzę po kwestii; użyj źródłowego pliku MP4, aby ocenić synchronizację dźwięku.
Status uruchomienia: Wyrenderowano w środowisku testowym Atlas. Wizualny GIF jest osadzony powyżej.
| Wynik wizualny testu 1 | Status | Co pokazuje GIF |
|---|---|---|
| Kadr z jednym mówcą | Wyraźny | Maya jest jedyną widoczną osobą przez całą scenę biurową |
| Ruch ust | Widoczny | Ciasny kadr ułatwia sprawdzenie ruchu mówienia |
| Ciągłość twarzy | Stabilna | Mruganie, poza i oświetlenie pozostają spójne przez cały klip |
| Zachowanie słuchacza i cięcie | Nie dotyczy | Ta bazowa scena nie ma drugiego mówcy ani ujęcia odwrotnego |
| Synchronizacja dźwięku | Sprawdź źródłowy plik MP4 | Osadzony GIF nie ma dźwięku |
Jeśli kwestia traci klarowność, zmień tylko 1 zmienną przy osobno oznaczonym ponownym uruchomieniu. Najpierw skróć wypowiadane zdanie. Po drugie, usuń gest dłoni lub niepotrzebną instrukcję kamery. Unikaj jednoczesnej zmiany postaci, czasu trwania i języka. To zamienia diagnozę w nowy eksperyment.
Test dialogu Kling #2: dwie osoby mówiące na zmianę
Tu generowanie dialogu zasługuje na szczególną uwagę. Wiarygodna scena wymaga 2 osobnych działań: Maya musi mówić, gdy Daniel słucha, a następnie Daniel musi mówić, gdy Maya słucha. Milcząca osoba nie jest pustym miejscem. Jej zamknięte usta, kontakt wzrokowy, niewielka reakcja i stabilna twarz są częścią dowodu.
Prompt używa 3 punktów zakotwiczenia dla każdego mówcy: imienia, pozycji po lewej lub prawej stronie oraz widocznego szczegółu ubioru. Określa też oczekiwane zachowanie słuchacza. To nie są magiczne słowa. Dają modelowi bardziej jednoznaczny kontrakt sceny, a recenzentowi jasne warunki porażki.
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
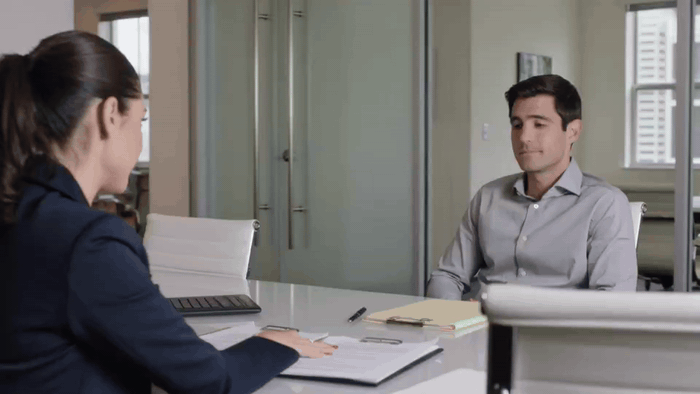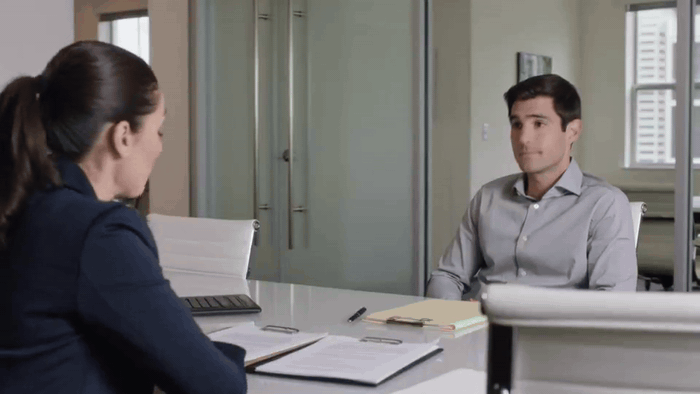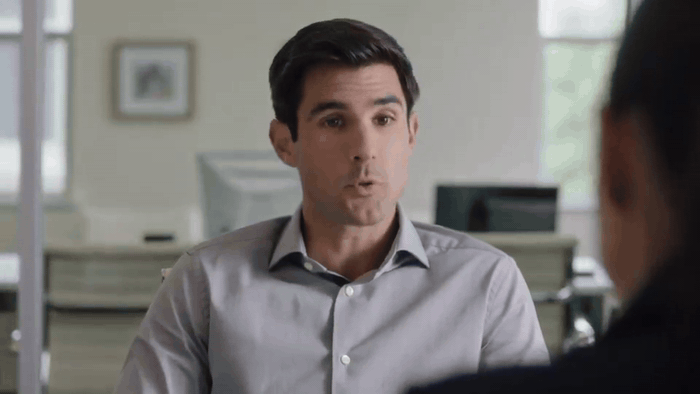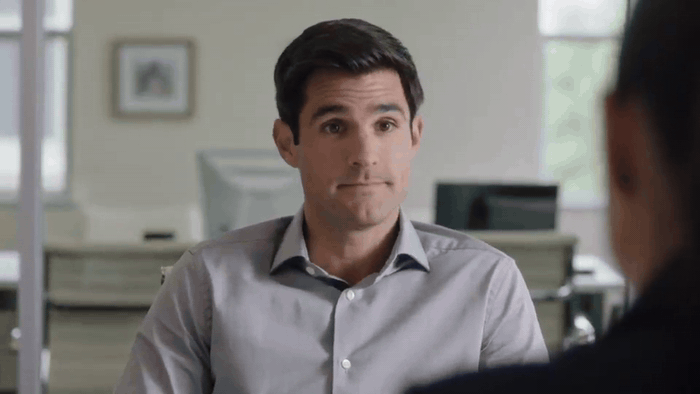
Wynik wizualny testu 2: Maya i Daniel mówią na zmianę w biurowej rozmowie
Wynik wizualny testu 2. Obserwuj usta słuchacza podczas każdej kwestii i przekazanie głosu przy ujęciu odwrotnym; użyj źródłowego pliku MP4, aby ocenić synchronizację dźwięku.
Twórcy regularnie opisują odwrotny problem w dyskusjach społeczności: zadanie synchronizacji ust może stracić synchronizację albo nadać niepożądany ruch ust osobie, która powinna milczeć. To doświadczenie anegdotyczne, a nie specyfikacja produktu, ale to dobry powód, by w każdym uruchomieniu sprawdzać słuchacza (r/KLING, wrzesień 2026).
Status uruchomienia: Wyrenderowano w środowisku testowym Atlas. Wizualny GIF jest osadzony powyżej.
| Wynik wizualny testu 2 | Status | Co pokazuje GIF |
|---|---|---|
| Ustawienie z dwoma mówcami | Wyraźne | Maya i Daniel pojawiają się w tej samej biurowej rozmowie |
| Przekazanie głosu | Widoczne | Scena przechodzi od kwestii Mai do ujęcia odwrotnego na Daniela |
| Zachowanie słuchacza | Możliwe do sprawdzenia | GIF utrzymuje osobę nie mówiącą w kadrze, aby umożliwić kontrolę wizualną |
| Ciągłość twarzy | Stabilna | Twarz Daniela i biurowe otoczenie pozostają spójne w ujęciu odwrotnym |
| Synchronizacja dźwięku | Sprawdź źródłowy plik MP4 | Osadzony GIF nie ma dźwięku |
Praktyczna granica jest skromna: można przetestować 10-sekundową, sekwencyjną wymianę z 2 osobami. Nie należy jej traktować jako gotowego szablonu dla długiej sceny z przerywaniem, reakcjami grupowymi, szybkimi cięciami i kilkoma językami. Zwiększaj trudność o jeden wymiar naraz.
Test dialogu Kling #3: dialog mieszany językowo
Trzecie uruchomienie testuje węższą wersję funkcji opisywanej przez Kuaishou: jedna osoba mówi po angielsku, a druga odpowiada po hiszpańsku. Wartością nie jest nowość. Wymiana mieszana językowo może ujawnić błąd przypisania mówcy, który ukrywa klip w jednym języku, zwłaszcza gdy cięcie i inny wzorzec dźwięku pojawiają się razem.
Odpowiedź po hiszpańsku jest celowo krótka. Każda osoba nadal ma jedną kwestię, kolejność ujęć pozostaje jednoznaczna, a słuchacz ma polecenie milczeć. Poziom Pro jest tu użyty jako osobny, bardziej wymagający test, a nie jako zamiennik jasnego promptu.
Ustawienia uruchomienia: 16:9, 10 sekund, najwyższa dostępna rozdzielczość i jakość w momencie uruchomienia, natywne audio On lub Auto, bez muzyki w tle. Model: Kling V3.0 Pro Text-to-Video.
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
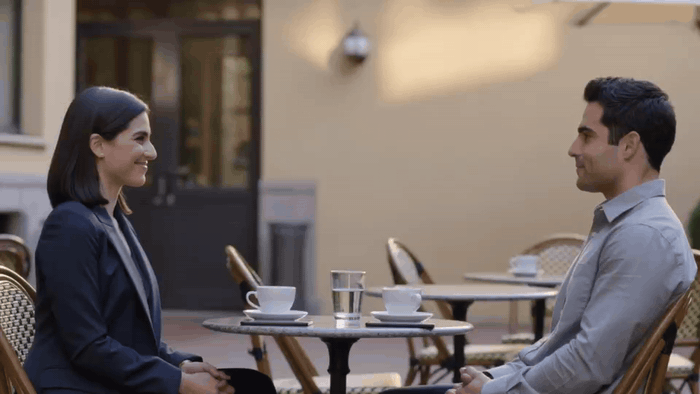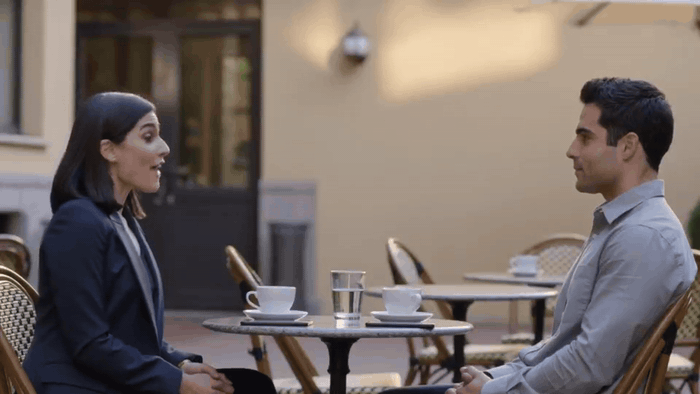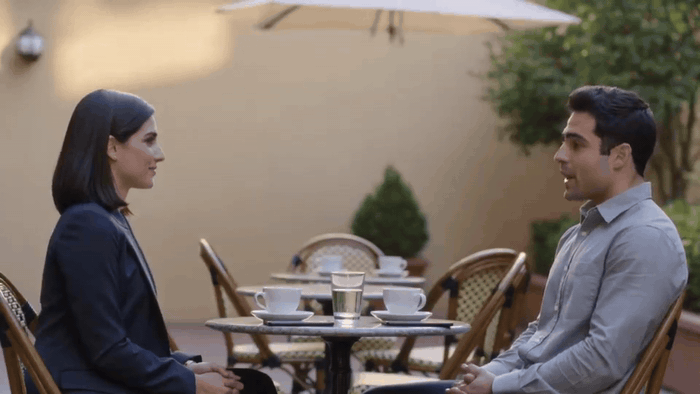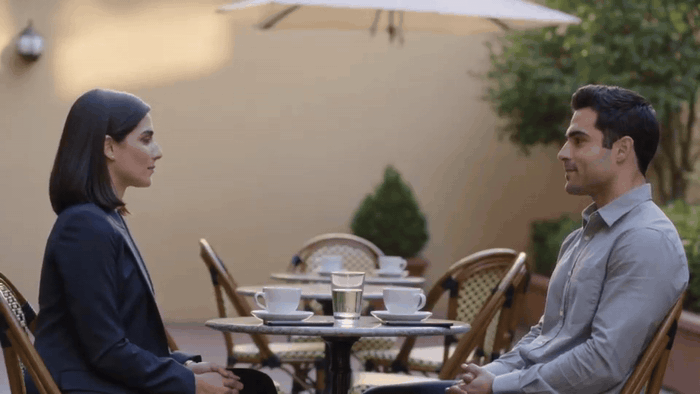
Wynik wizualny testu 3: dwóch mówców wymienia kwestie w kawiarni na zewnątrz
Wynik wizualny testu 3. Obserwuj, która twarz „posiada” każdą kwestię podczas przejścia z angielskiego na hiszpański; użyj źródłowego pliku MP4, aby ocenić synchronizację dźwięku.
Status uruchomienia: Wyrenderowano w środowisku testowym Atlas. Wizualny GIF jest osadzony powyżej.
| Wynik wizualny testu 3 | Status | Co pokazuje GIF |
|---|---|---|
| Ustawienie w kawiarni z dwiema osobami | Wyraźne | Obie osoby pozostają przy stoliku kawiarni na zewnątrz |
| Przekazanie głosu | Widoczne | Kadrowanie zachowuje wymianę między dwiema postaciami |
| Ciągłość twarzy i otoczenia | Stabilna | Ubiór, miejsca siedzące i późnopopołudniowe oświetlenie kawiarni pozostają spójne |
Czystsze wyniki synchronizacji ust w Kling
Te 3 prompty mają wspólną strukturę, która czyni porażkę widoczną, a ponowne uruchomienie wyjaśnialnym. Użyj tej listy kontrolnej, zanim dodasz więcej szlifu.
- W pierwszym teście dialogu utrzymuj nie więcej niż 2 widoczne osoby.
- Daj każdej osobie 1 zdanie na turę.
- Jeśli to możliwe, utrzymuj angielskie kwestie w granicach 8 do 12 słów.
- Oznacz mówcę pozycją, widoczną cechą i imieniem.
- Zaznacz, że druga postać słucha naturalnie z zamkniętymi ustami.
- Ustal scenariusz za pomocą 10-sekundowej próbki, zanim zwiększysz ustawienia szczegółowości lub czas trwania.
- Sprawdzaj synchronizację ust, przypisanie mówcy, zachowanie słuchacza, ciągłość twarzy i cięcie jako osobne kontrole.
- Nie łącz długiego monologu, sceny grupowej, szybkiego cięcia i zmiany języka w pierwszym uruchomieniu.
| Element promptu | Przykład w testach | Co pomaga recenzentowi wyodrębnić |
|---|---|---|
| Pozycja | “Maya ... on the left” | Która osoba powinna mówić |
| Kotwica wyglądu | “navy blazer” | Czy tożsamość utrzymuje się przez cięcie |
| Dokładna kwestia | “Great. I will check it before lunch.” | Oczekiwany dźwięk i synchronizacja ust |
| Instrukcja roli milczącej | “remains silent ... mouth closed” | Niepożądany ruch ust słuchacza |
| Sekwencja ujęć | “Shot 1 ... Shot 2” | Czy dźwięk pozostaje przypisany po cięciu |
To formatowanie nie obiecuje idealnych wyników. Daje małemu zespołowi sposób na utrzymanie razem źródłowego promptu, materiałów i decyzji. Jeśli klip wymaga ponownego uruchomienia, zapisz, czy porażka wystąpiła przy pierwszej sylabie, podczas reakcji słuchacza czy przy cięciu. „Synchronizacja ust wydawała się nie w porządku” jest zbyt niejasne, by ulepszyć scenariusz produkcyjny.
Budżet i wybór modelu
Użyj tańszego obecnego poziomu, aby zweryfikować scenariusz, a następnie zarezerwuj test wyższego poziomu dla wersji, którą możesz faktycznie zaprezentować. Taka jest rola Standard i Pro w tym artykule. Twórca może uruchomić tę samą strukturę promptu w jednym obszarze roboczym modeli Atlas Cloud, zachować zapis testu i dokonać porównania bez przepisywania scenariusza na inny interfejs.
Poniższe liczby to kontekst cenowy, a nie twierdzenie promocyjne. Zostały sprawdzone w katalogu modeli Atlas Cloud i na stronach szczegółów modeli 28 września 2026 r. W momencie przeglądu katalog pokazywał 15% obniżki. Ceny i parametry modeli mogą się zmieniać, więc ponownie sprawdź stronę przed ustaleniem budżetu dla klienta.
| Model do tego testu | Cena na stronie za sekundę, sprawdzona we wrześniu 2026 | Szacowana generacja 10-sekundowa | Najlepsze zastosowanie w tym protokole |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071, wcześniej $0.084 | $0.71 | Weryfikacja struktury promptu dla jednego mówcy i mówienia na zmianę |
| Kling V3.0 Pro T2V | $0.095, wcześniej $0.112 | $0.95 | Uruchom wersję mieszaną językowo lub prezentacyjną |
Łączny podany koszt 3 testów 10-sekundowych wynosi $2.37 przed jakimikolwiek ponownymi uruchomieniami. Traktuj to jako proste oszacowanie planistyczne. Zakłada ono wyświetloną cenę za sekundę, zaakceptowanie żądanego czasu trwania przez działający formularz oraz zgodność obowiązujących cen konta ze stroną publiczną. Rzeczywisty schemat środowiska testowego jest ostatecznym autorytetem w kwestii dostępnych proporcji obrazu, opcji jakości i elementów sterujących natywnym audio.
FAQ dotyczące synchronizacji ust w dialogu Kling
Czy Kling 4 został oficjalnie wydany?
Nie udało mi się zweryfikować oficjalnej specyfikacji Kuaishou dla wydanego modelu dialogowego Kling 4. Oficjalnym wydaniem użytym tutaj jest Kling 3.0. Stron wyszukiwania, które przypisują do Kling „4K” lub przyszłościową etykietę, nie należy traktować jako potwierdzenia istnienia osobnego produktu „Kling 4”.
Jakiego modelu powinienem użyć do testu synchronizacji ust w dialogu Kling dzisiaj?
Do krótkiego sprawdzenia scenariusza użyj zweryfikowanej obecnej ścieżki Kling V3.0 Standard Text-to-Video. Użyj Pro do bardziej wymagającej kontynuacji, takiej jak scena mieszana językowo w tym artykule. Utrzymuj ustawienia wystarczająco stabilne, aby móc stwierdzić, czy wynik zmienił się z powodu promptu, czy poziomu modelu.
Czy Kling potrafi sprawić, że 2 osoby mówią jedna po drugiej?
Kuaishou twierdzi, że Video 3.0 potrafi generować dialog wielu postaci z kontrolowaną treścią i kolejnością mówienia. W praktyce najpierw uruchom krótką próbkę mówienia na zmianę. Nazwij każdego mówcę, zakotwicz jego pozycję i ubiór, podaj kolejność ujęć i wyraźnie poleć słuchaczowi milczeć.
Dlaczego w moim filmie Kling obie postacie poruszają ustami?
Scena może pozostawiać przypisanie mówcy zbyt otwarte albo model może w tym uruchomieniu wytworzyć niepożądany ruch twarzy. Ogranicz test do 2 osób i 1 kwestii każda. Następnie dodaj bezpośrednią instrukcję milczącego słuchacza i sprawdź wynik wraz z jego dźwiękiem. Jeśli problem pozostaje, zgłoś go jako nieudany wynik i uruchom ponownie tylko 1 zmienioną zmienną.
Czy Kling obsługuje dialog angielski i hiszpański w 1 klipie?
Kuaishou wymienia zarówno angielski, jak i hiszpański wśród języków obsługiwanych przez natywne audio Video 3.0. Lista obsługiwanych języków nie jest tym samym co gwarancja dla dowolnego scenariusza dialogowego. Trzeci test synchronizacji ust w dialogu Kling 4 powyżej utrzymuje wymianę krótką, aby można było ocenić przekazanie języka, ruch ust i przypisanie mówcy w tym samym pliku.
Czy do pokazania testu synchronizacji ust powinienem użyć GIF-u czy wideo?
Użyj GIF-u, gdy artykuł potrzebuje lekkiego, łatwego do prześledzenia widoku ruchu twarzy i przekazania głosu. Użyj oryginalnego pliku MP4, gdy oceniasz słowa i synchronizację dźwięku. 3 osadzone tutaj wyniki to GIF-y, a ich źródłowe pliki MP4 pozostają w folderze zasobów artykułu.


