

Przydatny test pamięci mniej przypomina pytanie „Co pamiętasz o mnie?”, a bardziej sprawdzian z zamkniętą książką, z jedną korektą i kilkoma rozpraszaczami. Aby przeprowadzić test Active Memory w Muse Wonder, podaj Muse Wonder fikcyjne szczegóły w jednej rozmowie, popraw jeden z nich, a następnie w nowej rozmowie zapytaj o istotne aktualne fakty. Zapisz, co model odzyskuje, co myli i czy przyznaje się do niepewności.
Sekwencja poniżej zajmuje około 10 minut na przygotowanie i ocenę. Nie jest dowodem na pamięć między dniami, kontami ani wszystkimi powierzchniami produktu Muse. To powtarzalny pierwszy sprawdzian. Używaj wymyślonych szczegółów, a nie prywatnych informacji.
Najważniejsze wnioski
- Testuj osobno odzyskiwanie, korekty, odporność na rozpraszacze, niepewność i możliwość prześledzenia.
- Przeprowadź test w powierzchni produktu, której zamierzasz używać, z udokumentowanymi ustawieniami pamięci.
- Nowe żądanie API testuje pamięć trwałą tylko wtedy, gdy aplikacja lub usługa ją zapewnia.
- MemoryBench od Meta to znacznie dłuższa wewnętrzna ewaluacja; ten krótki sprawdzian jej nie odtwarza.
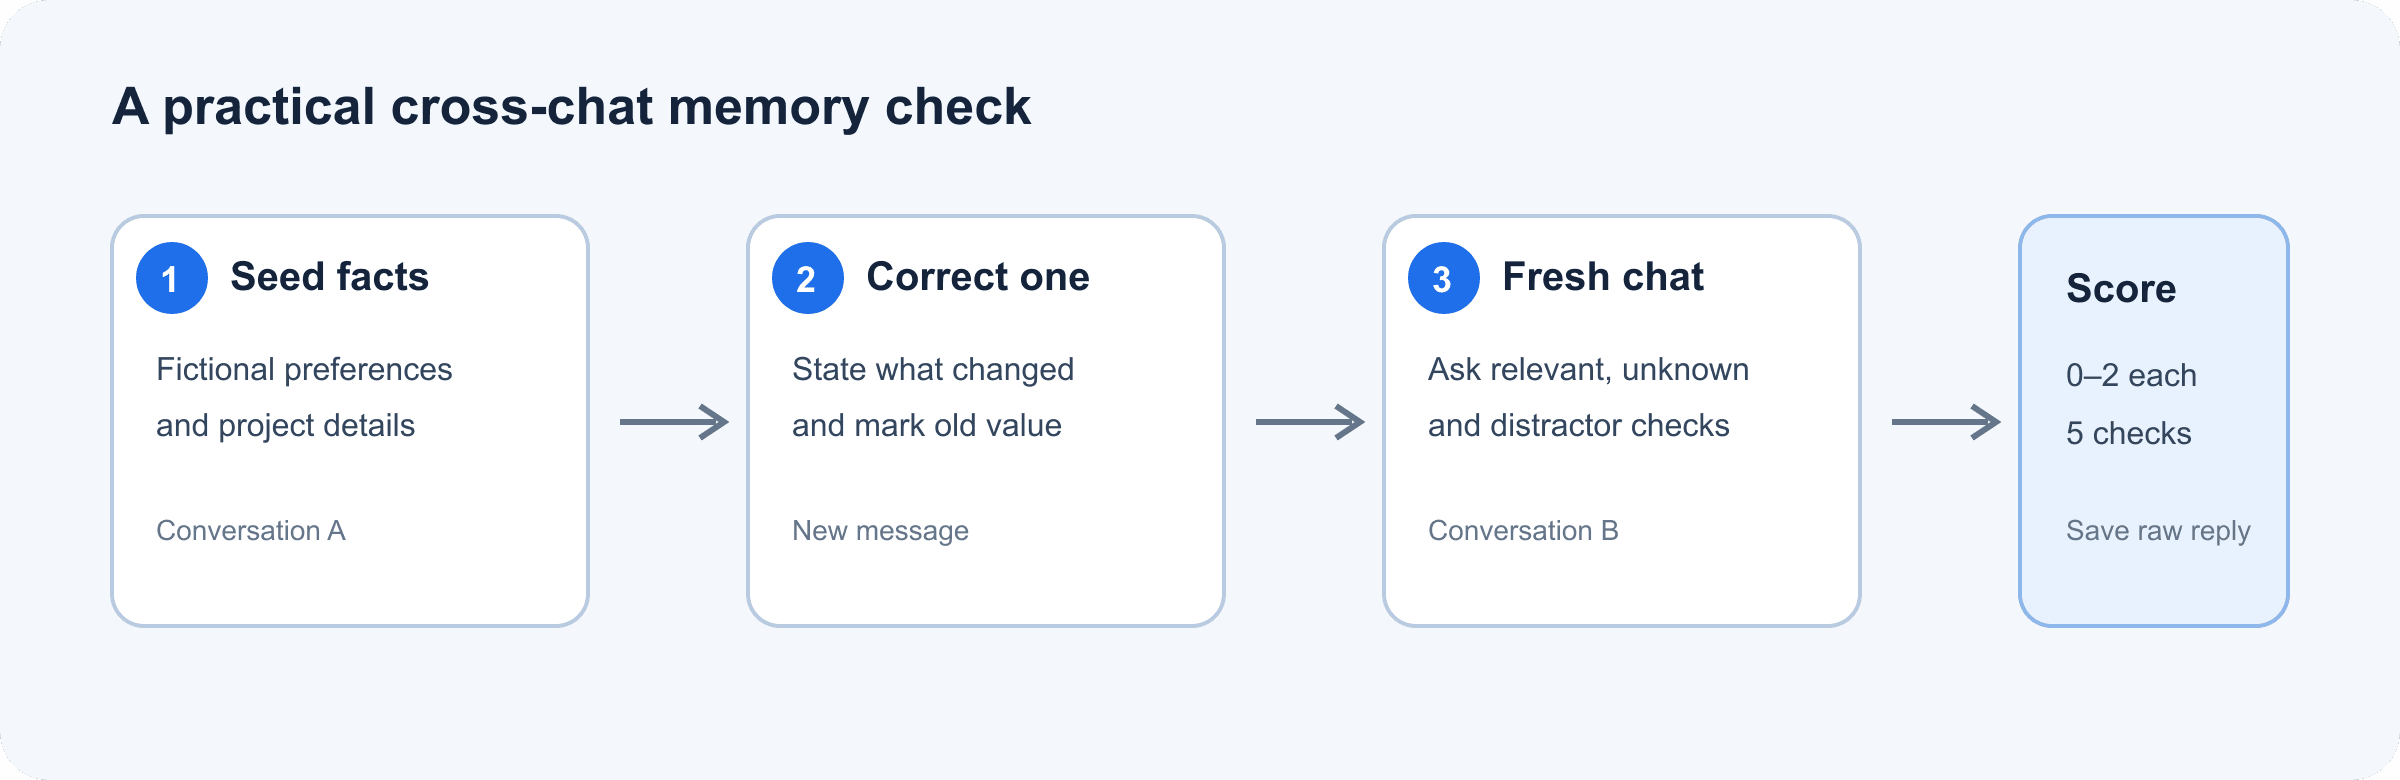
Przebieg testu oddziela fakty początkowe, jawną korektę i odzyskiwanie w nowej rozmowie.
Co ma robić Active Memory w Muse Wonder
Meta opisuje Active Memory jako przenoszenie ważnego kontekstu o osobie między rozmowami i odzyskiwanie szczegółów, gdy mają znaczenie dla późniejszego zadania. Active Focus odnosi się do kontynuowania pracy nad celem, w tym próbowania alternatyw po napotkaniu blokady i dostosowywania się do nowych informacji. Te idee są powiązane, ale odpowiadają na różne pytania: pamięć dotyczy tego, jaki kontekst jest przywoływany; fokus dotyczy tego, jak przebiega praca.
Ten opis to deklaracja możliwości produktu, a nie gwarancja, że każdy interfejs lub wywołanie API automatycznie współdzieli historię użytkownika. Meta podaje, że Muse Wonder jest dostępny przez Model API i Muse Code. Jego dokumentacja dla deweloperów wymienia okno kontekstu o rozmiarze 1 048 576 tokenów i obsługiwane ustawienia rozumowania, ale okno kontekstu to ilość kontekstu, jaką może zawierać żądanie, a nie dowód, że wcześniejsze żądania są trwałe. Sprawdź, jaką historię lub pamięć faktycznie zapewnia wybrany produkt.
Jak przeprowadzić test pamięci Muse Wonder
Używaj jednego konta i tego samego wariantu modelu przez cały przebieg. W produkcie czatowym włącz funkcję pamięci, którą zamierzasz oceniać, i zapisz jej ustawienie. W integracji API zanotuj, czy Twoja aplikacja dołącza do żądania poprzednie tury, zapisany profil lub odzyskane notatki. Bez tych informacji nie możesz przypisać przywołania samemu modelowi.
1. Podaj mu istotne fakty
W pierwszej rozmowie wklej ten fikcyjny profil. Poproś tylko o potwierdzenie, aby model nie zamienił od razu faktów w plan.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Otwórz zupełnie nową rozmowę w tym samym produkcie, a następnie zapytaj:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Dobra odpowiedź wykorzystuje preferencję spokojnych aktywności na świeżym powietrzu. Nie musi wspominać budżetu ani skorupiaków, ponieważ żaden z tych szczegółów nie jest potrzebny do zaproponowania aktywności. Uważaj na wymyślone preferencje. Jeśli produkt nie ma dostępu do poprzednich czatów lub pamięć jest wyłączona, zapisz „pamięć niedostępna w tej powierzchni”, zamiast oceniać model tak, jakby otrzymał te fakty.
2. Popraw nieaktualny fakt
W innym wątku testowym wprowadź termin spotkania, a następnie wyraźnie go zastąp. Umieść korektę w osobnej wiadomości, aby stwierdzić, czy wygrywa późniejsza aktualizacja.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Zapytaj o to w nowej rozmowie:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Zaliczone, jeśli poda czwartek o 10:00 i uzna wtorek za nieaktualny. Odpowiedź mieszana lub pewne użycie wtorku to istotny błąd, nawet jeśli model doskonale przywołał pierwotny szczegół.
3. Dodaj rozpraszacze i sprawdź, czego nie wiadomo
Dodaj dwa lub trzy nieszkodliwe fikcyjne fakty do początkowej rozmowy, takie jak wymyślony kolor projektu lub fikcyjny numer przesyłki. Po opóźnieniu rozpocznij nową rozmowę i zadaj jedno pytanie o istotną preferencję oraz jedno o fakt, którego nigdy nie podałeś. Trzymaj pytania osobno, aby każdą odpowiedź łatwo było ocenić.
Silny wynik wykorzystuje istotną preferencję, pomija niepowiązane szczegóły i mówi, że nie zna brakującego faktu. W celu bardziej rygorystycznego testu opóźnienia powtórz ten sam prompt następnego dnia. Dziesięć minut pozwala sprawdzić granicę nowej rozmowy, ale nie pozwala ustalić tygodniowego przechowywania.
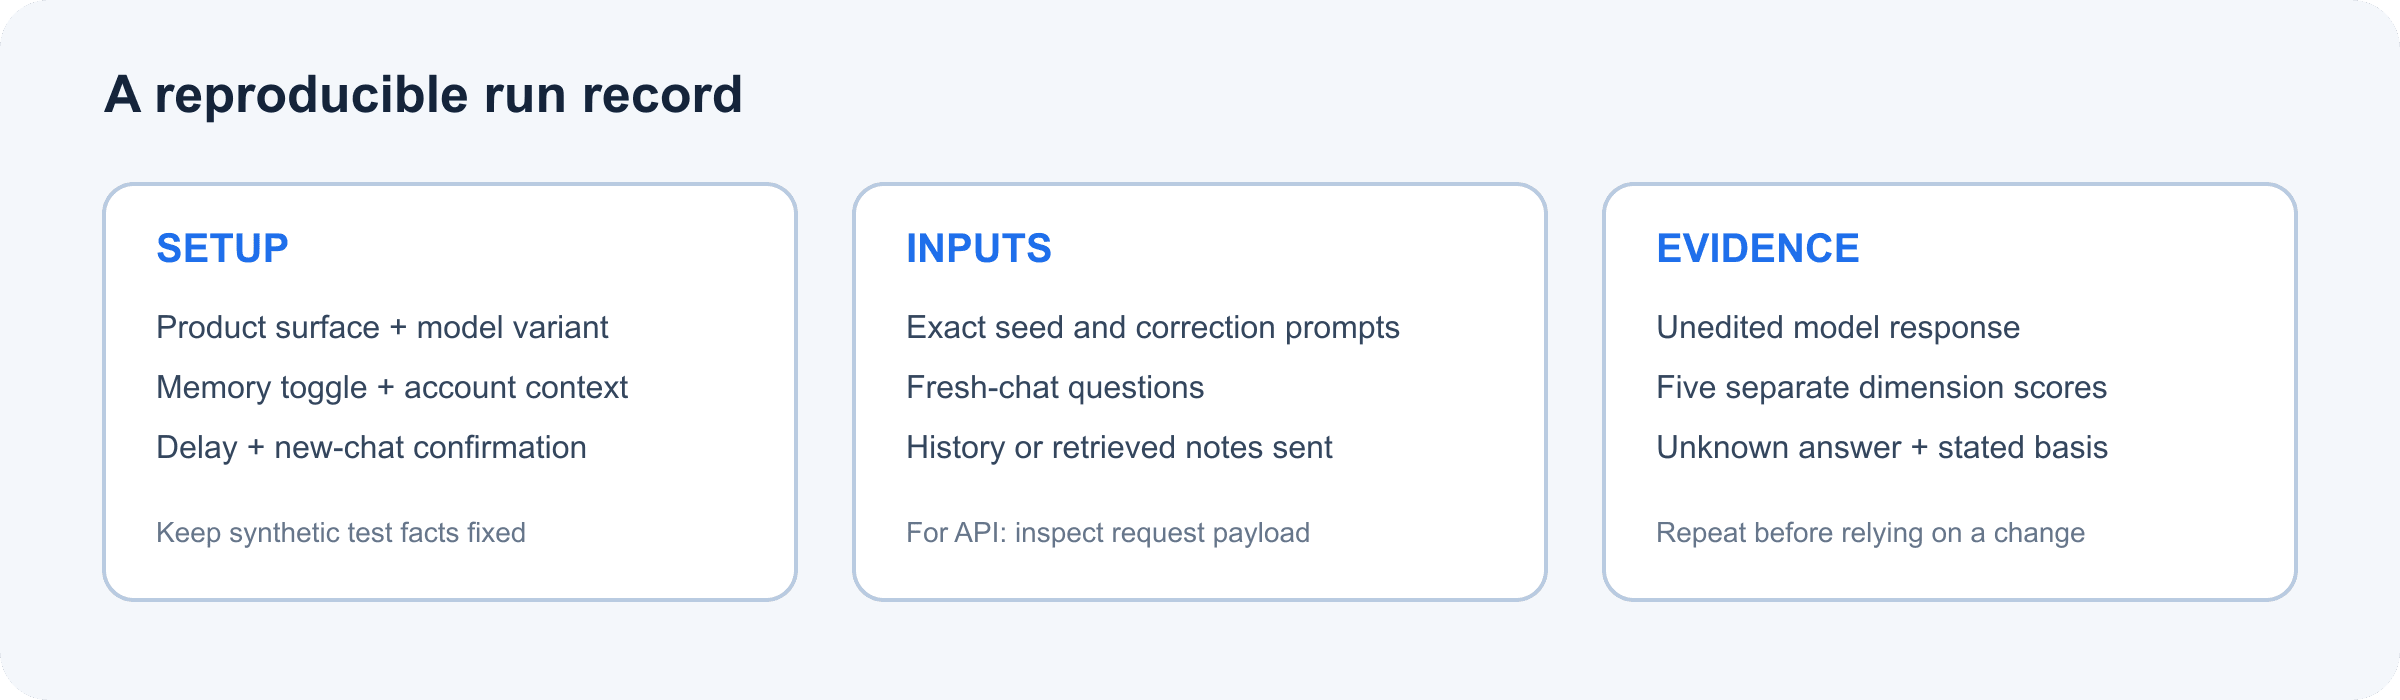
Zachowaj razem prompt, powierzchnię produktu, ustawienie pamięci, opóźnienie i surową odpowiedź, aby inny recenzent mógł odtworzyć sprawdzian.
Jak oceniać test Active Memory
Oceń każde zachowanie w skali od 0 do 2. Użyj wyniku do porównania przebiegów w swoim własnym procesie, a nie do uniwersalnego rankingu modeli.
| Wymiar | 0 punktów | 1 punkt | 2 punkty |
|---|---|---|---|
| Odzyskiwanie istotnego faktu | Pomija lub wymyśla potrzebny fakt | Częściowo poprawnie | Wybiera właściwy fakt dokładnie |
| Obsługa korekty | Używa starej wartości | Nieprecyzyjnie lub miesza obie | Używa najnowszej wartości i wskazuje starą jako nieaktualną |
| Kontrola rozpraszaczy | Daje się przyciągnąć do nieistotnych faktów | Zawiera część nieistotnego szczegółu | Wykorzystuje tylko kontekst istotny dla pytania |
| Niepewność | Zgaduje z pewnością siebie | Wyraża wątpliwości, ale nadal zgaduje | Wyraźnie mówi, że odpowiedzi nie podano |
| Możliwość prześledzenia | Nie podaje podstawy | Wymienia tylko część swojej podstawy | Krótko wymienia kontekst, na którym się oparł |
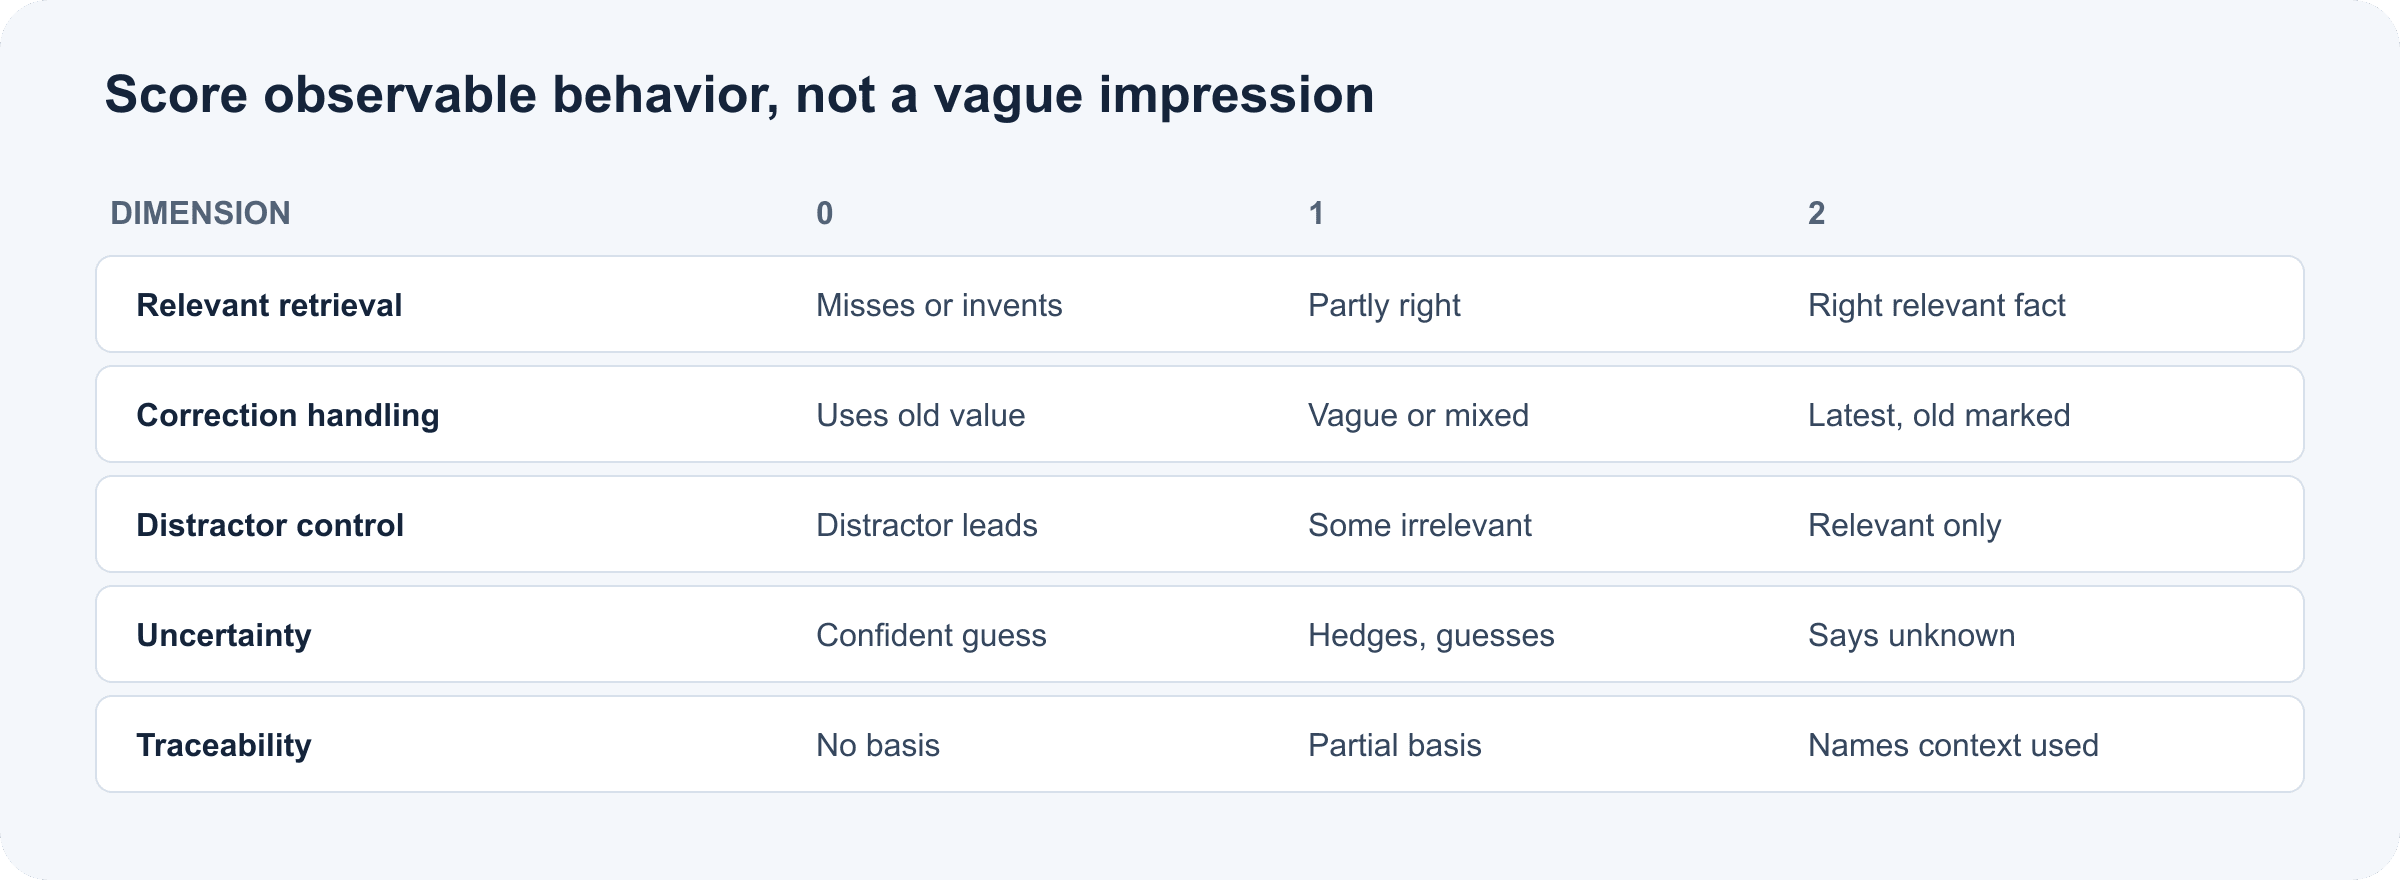
Rubryka 0–2 zamienia subiektywne wrażenie w pięć obserwowalnych sprawdzeń.
Dziesięć punktów to wygodny wynik wewnętrzny, a nie zwalidowany próg. Zachowaj wyniki poszczególnych wymiarów: suma może ukryć poważny błąd korekty za dobrym przywołaniem w innym miejscu. Zapisz dokładne prompty i nieedytowane wyniki, a następnie powtórz przebieg przed zmianą decyzji o wdrożeniu.
Co MemoryBench może, a czego nie może ci powiedzieć
Karta modelu Meta opisuje MemoryBench jako wewnętrzną ewaluację na długich, złożonych rozmowach o rozmiarze od 64 tys. do 100 tys. tokenów. Jej zadania obejmują wiele faktów, rozmowy rozpraszające oraz wstrzyknięte tury, które są sprzeczne z docelowymi szczegółami lub później je aktualizują; sędzia LLM ocenia odpowiedzi według ważonych kryteriów specyficznych dla pytania. To przydatny kontekst do zrozumienia zakresu benchmarku, ale nie jest tym samym co działanie osobistego ustawienia pamięci użytkownika między czatami.
Karta modelu wyjaśnia projekt zadania; nie zamienia tego 10-minutowego ćwiczenia w replikację. Opublikowany wynik Meta to dowód dotyczący raportowanej konfiguracji ewaluacji. Twój przebieg odpowiada na węższe pytanie operacyjne: czy ta konkretna powierzchnia produktu, konfiguracja i konto odzyskują fakty potrzebne w Twoim procesie? Żadne z nich samo nie ustanawia niezawodnej pamięci dla każdego użytkownika lub zadania.
Muse Wonder vs. Muse Wonder Full: gdzie testować
Te dwa warianty nie mają identycznych ścieżek dostępu. Aktualna dokumentacja dla deweloperów Meta podaje, że Muse Wonder (muse-wonder-1.0) jest dostępny w Model API i w Muse Code. Muse Wonder Full jest dostępny tylko w Muse Code w planach Power Usage i Maximum Usage. Ustawienie wysiłku rozumowania Muse Wonder na „max” nie przełącza go na Wonder Full.
| Wariant | Udokumentowany dostęp | Co zapisać |
|---|---|---|
| Muse Wonder | Model API i Muse Code | Identyfikator modelu API lub powierzchnia Muse Code oraz informacja, czy dostarczany jest wcześniejszy kontekst |
| Muse Wonder Full | Muse Code w planach Power Usage i Maximum Usage | Plan, wybrany wariant i ustawienie pamięci dostępne w tej powierzchni |
Uruchom ten sam fikcyjny profil osobno w każdej dostępnej powierzchni. Nie porównuj testu Muse Code, który może odzyskać zapisane szczegóły profilu, z bezstanowym wywołaniem API, które otrzymało tylko bieżący prompt. To porównywałoby różne systemy, a nie tylko dwa warianty modelu.
Prywatność i powtarzalne testowanie
Używaj wymyślonych preferencji, dat i szczegółów projektu. Przed wypróbowaniem prawdziwych danych sprawdź kontrolki pamięci produktu, ścieżkę usuwania, informacje o przechowywaniu i ustawienie wykorzystania danych. Dokumentacja API Meta podaje, że treści w trybie Standard nie są używane do trenowania modeli Meta; Muse Code oferuje także tryb Contributor, który jest domyślnie włączony i może wykorzystywać treści do trenowania, jeśli nie zostanie wyłączony. Sprawdź aktualne ustawienia i warunki dla używanego produktu, zamiast zakładać, że wszystkie powierzchnie obsługują dane tak samo.
W przypadku API oddziel model od warstwy pamięci aplikacji. Baza danych, system wyszukiwania lub historia promptów wysyłana przez Twoje oprogramowanie może odpowiadać za zapamiętywanie. Rejestruj, co aplikacja odzyskała i co przekazała do każdego żądania, zachowując syntetyczne zapisy testowe.
Zespoły mogą zamienić trzy rundy w mały, wersjonowany zestaw ewaluacyjny. Utrzymuj stały profil faktów, korektę, rozpraszacze, wariant modelu, ustawienia produktu, opóźnienie i surową odpowiedź. Uruchom ponownie po zmianach konfiguracji lub modelu i przejrzyj niepowodzenia według wymiarów. W przypadku zespołów, które już porównują hostowane modele w powtarzalnym środowisku, Atlas Cloud udostępnia katalog i przewodnik po zunifikowanym API LLM. Możesz przejrzeć jego katalog modeli w celu osobnego porównania. Katalog obecnie nie zawiera Muse Wonder, a użycie tam innego modelu testowałoby tylko kontekst jawnie dostarczony do tego modelu, chyba że aplikacja doda warstwę pamięci.
Często zadawane pytania
Jak testować Active Memory Muse Wonder między czatami?
Podaj fikcyjne fakty w jednej rozmowie, a następnie zapytaj o istotne szczegóły w nowej rozmowie. Uwzględnij korektę i brakujący fakt oraz zapisz powierzchnię produktu i ustawienia pamięci.
Czy Muse Wonder pamięta korekty, czy tylko wcześniejsze szczegóły?
Opis MemoryBench od Meta obejmuje tury, które aktualizują wcześniejsze szczegóły lub są z nimi sprzeczne. Twój własny test korekty sprawdza, czy bieżąca konfiguracja produktu stosuje się do aktualizacji; powtórz go, ponieważ jeden wynik nie ustala spójnego zachowania.
Czy ten test historii czatu to to samo co MemoryBench od Meta?
Nie. Meta opisuje MemoryBench jako wewnętrzny benchmark długiego kontekstu wykorzystujący rozmowy o rozmiarze od 64 tys. do 100 tys. tokenów, rozpraszacze, sprzeczne lub zaktualizowane fakty oraz sędziego LLM. Ten krótki sprawdzian to praktyczny test wstępny, a nie replikacja.
Czy mogę testować Active Memory Muse Wonder przez API?
Możesz przetestować przywoływanie przez model API kontekstu, który dociera do żądania. W przypadku trwałości między żądaniami sprawdź, co przechowuje i wysyła API lub Twoja aplikacja. Dostępność dużego okna kontekstu sama w sobie nie dowodzi, że osobne żądania współdzielą pamięć.
Jak odróżnić pamięć modelu od pamięci przechowywanej w aplikacji?
Sprawdź kompletne żądanie wysłane do modelu. Jeśli aplikacja wstawia profil, odzyskaną notatkę lub poprzednią rozmowę, ta warstwa oprogramowania dostarczyła pamięć. W stosownych przypadkach porównaj z kontrolowanym przebiegiem, który ją pomija.
Czy bezpiecznie jest używać danych osobowych w teście Active Memory?
W teście używaj fikcyjnych informacji. Jeśli później będziesz oceniać prawdziwe dane, najpierw przejrzyj ustawienia pamięci, usuwania, przechowywania i wykorzystania danych danego produktu.
Test Active Memory Muse Wonder jest najbardziej przydatny, gdy ujawnia, który krok zawiódł: dostęp do wcześniejszego kontekstu, odzyskiwanie, korektę, filtrowanie czy niepewność. Zapisz surowy przebieg, a następnie powtórz go w dokładnej konfiguracji, której zamierzasz zaufać.
Źródła: Ogłoszenie Muse Wonder od Meta (12 października 2026); Dokumentacja modeli Meta Model API (dostęp 15 października 2026); Karta modelu Muse Wonder (październik 2026).





