

Prowadzenie w benchmarku może wyglądać rozstrzygająco, dopóki ten sam model nie pominie wymagania w kolejnym uruchomieniu. Przydatny test niezawodności Muse Wonder zadaje węższe pytanie: czy model wykonuje Twoje zadanie, według Twojego standardu, wielokrotnie, w tych samych warunkach?
Wczesne dowody są mieszane, ponieważ testy mierzą różne rzeczy. Jeden zestaw zadań z dnia premiery przyznał standardowemu Muse Wonder bardzo wysoki wynik po jednym uruchomieniu na zadanie. Inna ocena wykazała mocne strony w analizie badawczej, obok słabszego projektowania ankiet, twierdzeń sprzedażowych i układu slajdów. Żaden z tych wyników nie dowodzi, jak konsekwentnie poradzi sobie z Twoją bazą kodu lub przepływem pracy agenta.
Najważniejsze wnioski
- Traktuj benchmarki z premiery jako sygnały dotyczące możliwości, a nie gwarancje produkcyjne.
- Muse Wonder i Muse Wonder Full to oddzielne warianty. Przechowuj ich wyniki osobno.
- Mierz współczynnik zaliczeń, powtarzalność, ukończenie i odzyskiwanie jako różne wyniki.
- Zacznij od 10 do 20 rzeczywistych zadań, zamroź konfigurację i powtarzaj ważne zadania co najmniej trzy razy.
- Wybierz próg na podstawie kosztu błędnej odpowiedzi i procesu przeglądu przez człowieka.
Czy Muse Wonder jest niezawodny? Krótka odpowiedź
Dowody dostępne na 15 października 2026 r. wspierają ocenę zadanie po zadaniu, a nie uniwersalny werdykt o niezawodności. Muse Wonder wypadł dobrze w niektórych wczesnych testach, podczas gdy inne uruchomienia ujawniły błędy lub prace prezentacyjne, które wciąż wymagały przeglądu. Badania różnią się pod względem promptów, ustawień rozumowania, oceniających, rozmiarów prób i liczby prób.
(Meta, 12 października 2026 r.) twierdzi, że Muse Wonder i Muse Wonder Full są stworzone do profesjonalnych i osobistych zadań agentowych, z funkcjami, które nazywa Active Memory i Active Focus. To twierdzenia produktowe dotyczące zamierzonego działania. Twierdzenie, że model potrafi odzyskiwać sprawność po błędach, jest powodem, by przetestować odzyskiwanie w własnym przepływie pracy, a nie dowodem, że będzie odzyskiwał niezawodnie.
Trzymaj standardowy Wonder osobno od Wonder Full. Meta wymienia standardowy Muse Wonder dla swojego Model API i Muse Code, podczas gdy Full jest oferowany w ramach subskrypcji Muse Code. Uruchamianie standardowego Wonder z wyższym ustawieniem rozumowania nie czyni go Full.
Aby podjąć decyzję, której możesz bronić, przetestuj dokładny wariant i ścieżkę, które zamierzasz wdrożyć. Uznaj zadanie za udane tylko wtedy, gdy spełnia zapisaną regułę akceptacji, a jego wynik można sprawdzić.
Co powinien mierzyć test niezawodności Muse Wonder
Dokładność i spójność to różne rzeczy
Współczynnik zaliczeń mierzy, ile prób spełnia zdefiniowaną rubrykę. Spójność mierzy, czy powtórzone uruchomienia tego samego zadania za każdym razem dają akceptowalne wyniki. Model może mieć wysoki współczynnik zaliczeń, a mimo to zmieniać się w sposób istotny dla Twojego przepływu pracy.
Śledź cztery wymiary osobno:
| Miara | Co rejestrować | Przykładowa kontrola |
|---|---|---|
| Dokładność | Próby, które przechodzą rubrykę | Czy wyodrębniona suma zgadza się z dokumentem źródłowym? |
| Spójność | Czy powtórzone próby przechodzą i są zgodne | Czy trzy uruchomienia zachowują te same wymagane ograniczenia? |
| Jakość ukończenia | Czy każdy wymagany rezultat jest obecny | Czy wszystkie pliki, cytowania i wymagane pola zostały uwzględnione? |
| Odzyskiwanie | Czy uruchomienie wznawia się poprawnie po awarii | Czy zgłasza awarię narzędzia, bezpiecznie ponawia próbę, a następnie weryfikuje stan końcowy? |
Odpowiedź, która brzmi kompletnie, niekoniecznie jest kompletna. Zmiana kodu wymaga testów; podsumowanie badawcze wymaga źródeł możliwych do prześledzenia; uruchomienie agenta wymaga dowodu, że jego końcowe działanie nastąpiło.
Oddzielaj błędy modelu od błędów przepływu pracy
Rejestruj wystarczający kontekst, aby odróżnić błąd modelu od problemu z obsługą lub narzędziem. Co najmniej rejestruj wariant i wersję modelu, ustawienie rozumowania, prompt, konfigurację narzędzi, datę, czas uruchomienia, koszt tokenów lub zadania oraz surowe dane wyjściowe.
Klasyfikuj błędy przed ich ocenianiem:
- Model: nieprawidłowy fakt, błędne rozumowanie lub pominięte wymaganie.
- Narzędzie: nieudane wywołanie API, nieprawidłowe argumenty narzędzia lub błędny wynik z systemu zewnętrznego.
- Obsługa: przekroczenie limitu czasu, przerwanie lub niedostępny punkt końcowy.
- Ocena: niejasna rubryka lub kontrola, która nie potrafi odróżnić pracy akceptowalnej od nieakceptowalnej.
Jeśli połączysz wszystkie cztery w jeden wskaźnik błędów, nie będziesz wiedzieć, co naprawić.
Co pokazują obecne testy Muse Wonder
Opublikowane porównania benchmarków Meta to dowody dostawcy dotyczące wydajności w benchmarkach. Nie są tym samym co niezależnie przeprowadzona ocena przepływu pracy. Niezależne testy również mają ograniczenia: mały publiczny zestaw zadań, jedna próba, konkretna ścieżka modelu lub ocena preferencji człowieka odpowiada tylko na wąskie pytanie.
Poniższa tabela rozdziela dowody według źródła i zakresu. To przewodnik po tym, co może potwierdzać każdy wynik, a nie łączny wynik.
| Źródło dowodów | Co testowało | Data i konfiguracja | Co może Ci powiedzieć | Główne ograniczenie |
|---|---|---|---|---|
| Ogłoszenie Meta i materiały o modelu | Benchmarki możliwości i zamierzone funkcje agentowe | Ogłoszono 12 października 2026 r.; porównania raportowane przez dostawcę | Które możliwości Meta podkreśla i które warianty wydała | Testy dostawcy nie ustalają powtarzalności w Twoim przepływie pracy |
| (Spring Prompt, 13 października 2026 r.) | Ankiety, listy produktów, slajdy, planowanie reklam, szachy i wyszukiwanie wizualne | 13 października; standardowy model API, ogólnie średnie rozumowanie; zadania publiczne | Wydajność różniła się w zależności od zadania; niektóre oceny obejmowały powtórzone uruchomienia list produktów | Większość zadań stanowiły małe próby; wiele wyników pochodziło z jednego uruchomienia na zadanie; to nie test kodowania ani Muse Code |
| (Quantslant, 12 października 2026 r.) | 23 zadania obejmujące agentów, kodowanie, pisanie, rozumowanie i jeden długi dokument | 12 października; standardowy model przez OpenRouter, niskie rozumowanie; jedno uruchomienie na zadanie | Model przeszedł ten zdefiniowany zestaw zadań z wysokim współczynnikiem w tej konfiguracji | Pojedyncze uruchomienie nie może zmierzyć spójności między uruchomieniami; wyniki bliskie 100% wymagają kontroli na poziomie zadania |
| Posty społeczności | Indywidualne reakcje na kodowanie, agenta i benchmark | Posty z okresu premiery; samodzielnie wybrani użytkownicy i zadania | Przydatne wskazówki, co testować dalej | Anegdoty i głosy nie są mierzonymi współczynnikami zaliczeń |
Kontrast źródeł ma znaczenie. Quantslant zgłosił 99,7% w swoim 23-zadaniowym zestawie, przy jednym uruchomieniu na zadanie i niskim ustawieniu rozumowania. Zauważył również jeden nieudany test jednostkowy w zadaniu kodowania polegającym na zamianie liczby na słowa. Ten wynik jest dowodem dotyczącym tego konkretnego zestawu, a nie dowodem, że 99,7% codziennych zadań zostanie zaliczonych lub że powtórzone uruchomienia będą zgodne.
Spring Prompt zgłosił bardziej zróżnicowany obraz dla standardowego Wonder przy domyślnych ustawieniach API 13 października. Jego wynik analizy badawczej wyniósł 93,6/100 w dziewięciu publicznych zadaniach, podczas gdy tylko trzy z dziewięciu planów ankiet przeszły wszystkie kontrole. W przypadku list produktów odsetek uznany za niezawodnie gotowy do publikacji w trzech powtórzeniach wyniósł 66,1% dla briefów faktograficznych i 51,8% dla briefów sprzedażowych. Pięć z sześciu zestawów slajdów wymagało poprawek układu, a jeden uznano za nadający się do prezentacji. To oddzielne miary z oddzielnymi mianownikami, a nie elementy jednego ogólnego wyniku.
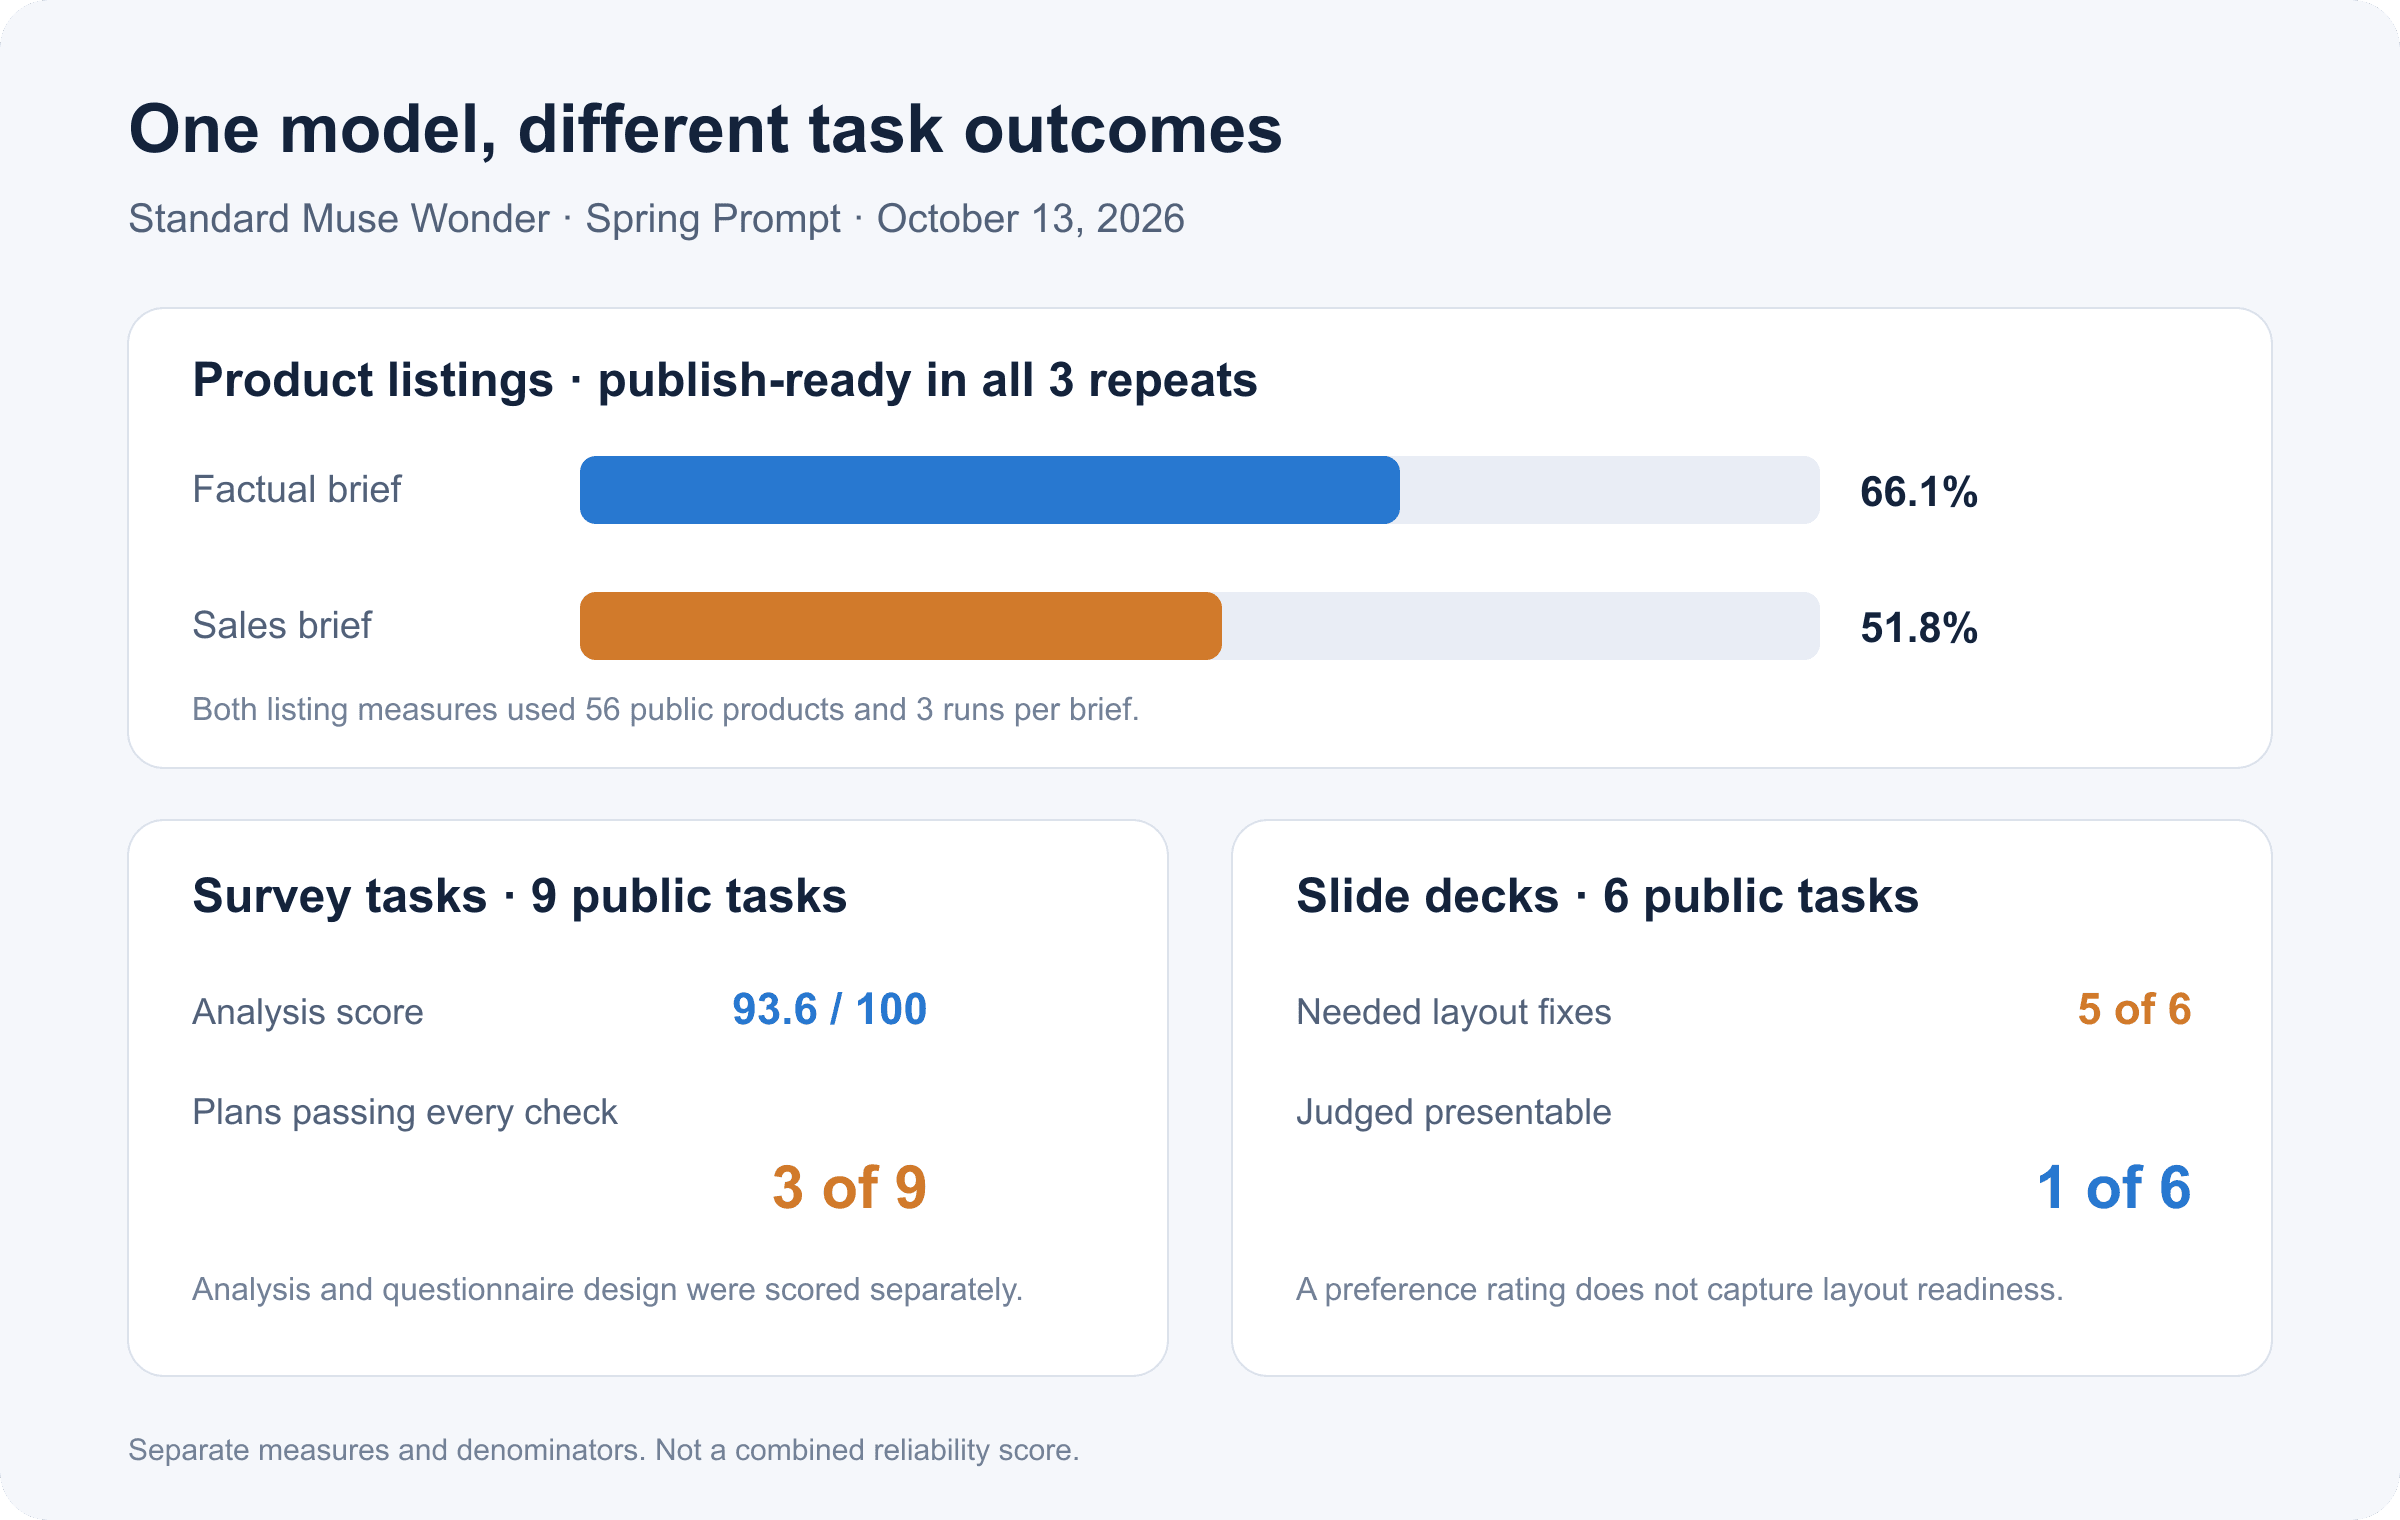
Wyniki standardowego Muse Wonder z 13 października 2026 r. od Spring Prompt: współczynniki zaliczeń list testowanych wielokrotnie, analiza ankiet i wyniki przeglądu slajdów
Niezależne wyniki zadań z jednej oceny. Miary używają różnych mianowników i są pokazane osobno, a nie połączone w jeden wynik.
Testy Spring Prompt nie mierzyły kodowania, pamięci trwałej ani Muse Code. Jego porównanie nie może więc rozstrzygnąć, czy Wonder jest niezawodny w kodowaniu ani czy Full wypada lepiej. Pokazuje jednak, dlaczego pojedyncza ogólna etykieta ukrywa istotne różnice między zadaniami.
Artykuł Meta z premiery mówi, że standardowy Muse Wonder jest dostępny przez Meta Model API i Muse Code, podczas gdy Wonder Full jest dostępny dla subskrybentów Muse Code. Opisuje Active Memory i Active Focus jako funkcje służące do zachowywania przydatnych szczegółów i kontynuowania pracy mimo błędów. Te opisy pomagają zdefiniować przypadki testowe, ale artykuł z premiery nie jest niezależnym badaniem z powtórzonymi uruchomieniami.
W przypadku twierdzeń o kodowaniu i budowaniu 3D omawianych w wątkach społeczności w tygodniu premiery traktuj posty jako hipotezy. Zamień konkretną skargę w powtarzalne zadanie i zweryfikuj dane wyjściowe. Nie zamieniaj komentarzy ani głosów poparcia we wskaźnik sukcesu.
Jak przeprowadzić powtarzalny test niezawodności Muse Wonder
1. Zbuduj mały zestaw zadań z rzeczywistej pracy
Wybierz 10 do 20 zadań, które Twój zespół faktycznie oczekuje, że model obsłuży. Podziel je na kategorie, takie jak kodowanie, ekstrakcja faktów, przestrzeganie instrukcji, długi kontekst i użycie narzędzi. Preferuj zadania z obiektywnymi testami, odpowiedziami referencyjnymi lub jasną rubryką.
Uwzględnij realistyczne przypadki brzegowe: brakujące dane wejściowe, sprzeczne wymagania, niedostępne narzędzie i zadanie, które powinno wywołać pytanie wyjaśniające. Nie umieszczaj danych wrażliwych lub regulowanych, chyba że zatwierdzony proces na to pozwala.
2. Zamroź prompt, model i ustawienia
Zapisz dokładny prompt i instrukcje systemowe. Zarejestruj nazwę i wersję modelu, poziom rozumowania, narzędzia, dostarczony kontekst, datę i wszelkie limity czasu. Nie porównuj standardowego Wonder z Full tak, jakby były tym samym modelem.
Przydatny prompt testowy może poprosić model o pokazanie dowodów i wskazanie wymagań, których nie można przetestować:
Przeczytaj załączoną specyfikację i implementację. Zwróć tylko: (1) każde wymaganie oznaczone jako PASS, FAIL lub NOT TESTABLE; (2) dokładny dowód dla każdego statusu; (3) wszelkie brakujące wymaganie; (4) minimalny powtarzalny test dla każdego FAIL. Nie twierdź, że test został zaliczony, jeśli nie możesz wskazać jego wyniku.
To dane wejściowe oceny, a nie gwarancja, że model się do nich zastosuje. Oceń wynikową odpowiedź i niezależnie zweryfikuj wszelkie deklarowane wyniki testów.
3. Powtarzaj zadania i oceniaj każdą próbę
Uruchom każde zadanie o wysokim wpływie co najmniej trzy razy w tej samej konfiguracji. Jeśli budżet pozwala tylko na jedną próbę, oznacz wynik jako próbę wstępną, a nie wynik spójności. Zachowaj każdą surową odpowiedź; nie raportuj tylko najlepszej.
Użyj jednego wiersza dla każdej próby. Utrzymuj regułę akceptacji stałą we wszystkich uruchomieniach.
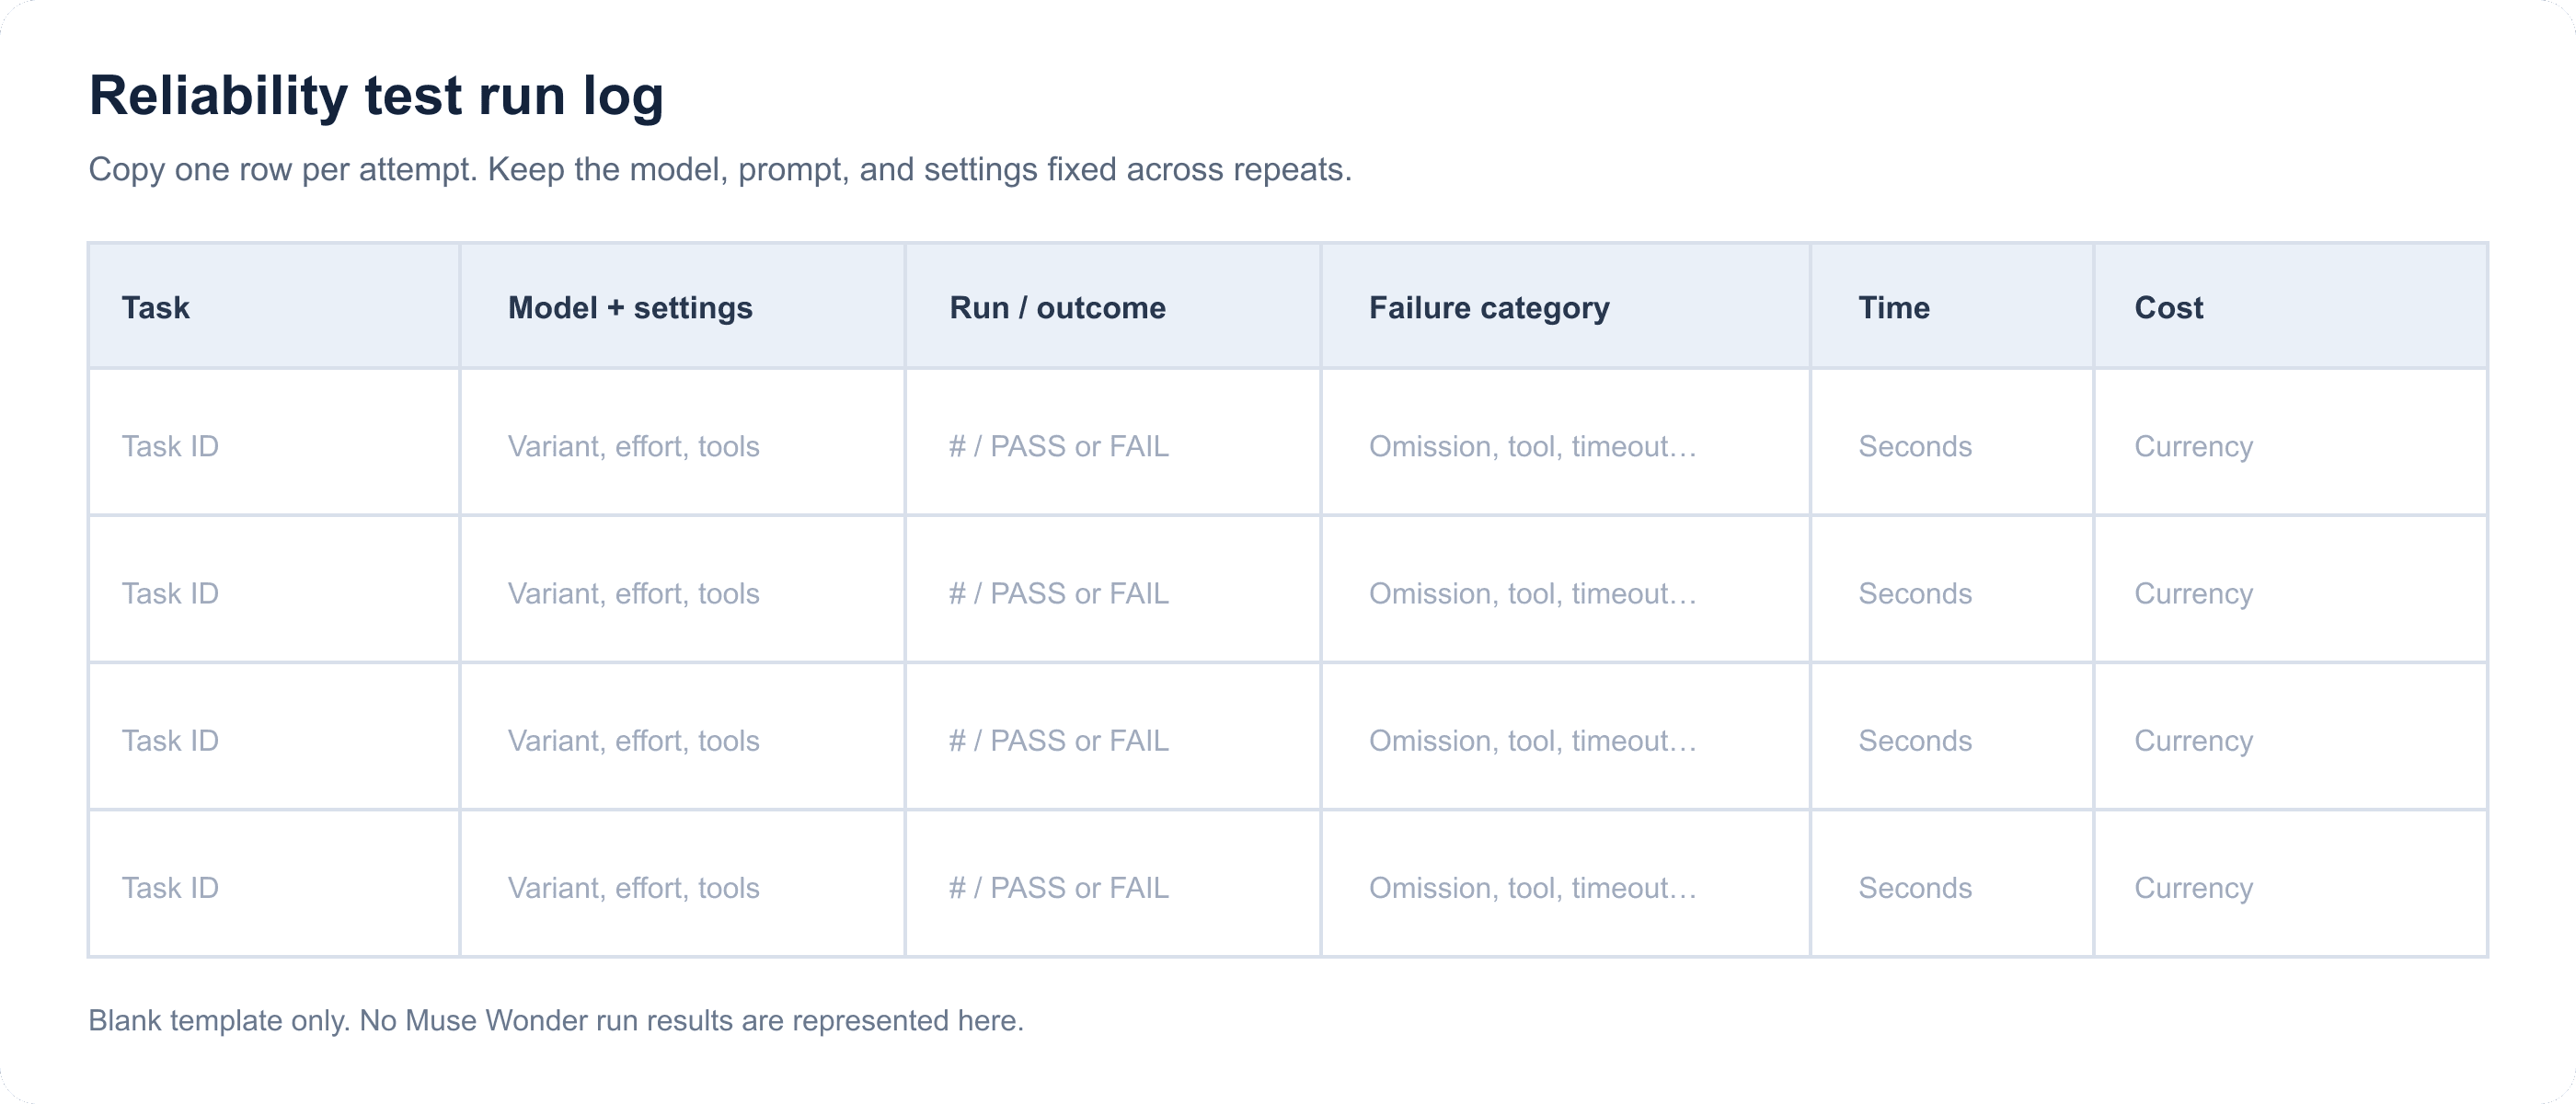
Pusty dziennik testu niezawodności Muse Wonder z polami dla zadania, modelu, uruchomienia, wyniku, błędu, czasu i kosztu
Szablon pustego rekordu do ponownego użycia. Wypełnij jeden wiersz na próbę; nie zawiera zmierzonych wyników Muse Wonder.
4. Prowadź dziennik błędów i weryfikuj odzyskiwanie
Używaj konkretnych kategorii: błąd faktograficzny, pominięcie, nieudany test kodu, błąd narzędzia, przekroczenie limitu czasu, niepotwierdzone twierdzenie o ukończeniu lub niezgodność formatu. W przypadku pracy wieloetapowej zanotuj, gdzie uruchomienie się zatrzymało i czy ponowna próba powtórzyła ukończone działania lub zweryfikowała stan końcowy.
Agent, który mówi „gotowe” bez dowodu, nie przeszedł kontroli ukończenia. Wymagaj wyniku testu, zapisanego pliku, cytowania źródła lub zweryfikowanego stanu zgodnego z zadaniem.
5. Ustal próg decyzyjny wokół kosztu błędu
Nie istnieje przydatny uniwersalny próg odcięcia współczynnika zaliczeń. Szkic, który człowiek sprawdza linia po linii, ma inny profil ryzyka niż migracja bazy danych lub automatyczna płatność.
Ustal próg na podstawie trzech czynników:
- Jak szkodliwy lub kosztowny jest błędny wynik?
- Czy człowiek może wychwycić błąd, zanim wpłynie on na kogokolwiek?
- Czy przepływ pracy zawodzi bezpiecznie, z jasnym zatrzymaniem i ścieżką audytu?
W przypadku szkiców niskiego ryzyka przegląd może wystarczyć. W przypadku zmian w kodzie, finansów, prawa, zdrowia lub działań wpływających na użytkowników stosuj silniejsze testy i niezależną weryfikację. Nie pozwól, by wysoka średnia ukryła jeden poważny tryb awarii.
Niezawodność Muse Wonder według typu zadania
Kodowanie i wieloetapowe kompilacje
Uruchom rzeczywisty zestaw testów repozytorium i sprawdź żądane zachowanie. Oceń pokrycie wymagań, błędy regresji oraz to, czy deklarowane zmiany modelu zgadzają się z plikami i wynikami testów. Przekonujące nagranie ekranu lub wyjaśnienie nie zastąpi wykonywalnej kontroli.
Wczesny zestaw Quantslant obejmował cztery zadania kodowania i zaraportował przejście 15 z 16 testów jednostkowych w jednym zadaniu zamiany liczby na słowa. To mały sygnał z pojedynczego uruchomienia. Spring Prompt wyraźnie nie testował kodowania, więc jego ustaleń nie należy używać do uogólniania o niezawodności agenta kodującego.
Badania i ekstrakcja faktów
Użyj pakietu źródeł lub odpowiedzi referencyjnych, które recenzent może sprawdzić. Sprawdź każde twierdzenie faktograficzne względem źródła pierwotnego i śledź wymyślone cytowania oraz błędne przypisanie oddzielnie od ogólnej jakości odpowiedzi.
Analiza ankiet Spring Prompt była względnie mocną stroną w jego małej ocenie, ale projektowanie pytań ankietowych było słabsze. Wysoki wynik analizy nie powinien po cichu poświadczać narzędzia ankietowego ani źródeł stojących za nowym zadaniem badawczym.
Długi kontekst i przepływy pracy agentów
Sprawdź, czy model zachowuje każde ograniczenie, poprawnie używa każdego narzędzia i weryfikuje stan końcowy. Celowo przetestuj odzyskiwanie po przerwaniu: zatrzymaj uruchomienie po znanym kroku, a następnie sprawdź, czy wznawia od punktu kontrolnego lub powtarza efekt uboczny.
Ogłoszenie Meta opisuje możliwości pamięci i odzyskiwania, ale cytowane tutaj publiczne wczesne oceny nie ustalają długoterminowej spójności pamięci trwałej ani odzyskiwania agenta. Zmierz te zachowania bezpośrednio, zanim zaczniesz na nich polegać.
Muse Wonder vs. Muse Wonder Full: trzymaj dowody osobno
Muse Wonder i Muse Wonder Full to odrębne warianty. Informacje Meta z premiery opisują oddzielne ścieżki dostępu, a niezależne testy API standardowego Wonder nie stają się wynikami Full tylko dlatego, że zmienia się ustawienie rozumowania.
| Pytanie porównawcze | Co potwierdzają dostępne dowody |
|---|---|
| Czy Full to to samo co standardowy Wonder przy maksymalnym rozumowaniu? | Nie. Traktuj je jako odrębne warianty i zapisuj dokładną nazwę. |
| Czy cytowana ocena API Spring Prompt testowała Full? | Nie. Testowała standardowy Wonder; Full był poza tym porównaniem. |
| Czy cytowane liczby dla standardowego API mogą uszeregować Full? | Nie. Nie testują Full. |
| Co umożliwiłoby uczciwe porównanie? | Ten sam zestaw zadań, rubryka oceniania, okno czasowe, dostęp do narzędzi i udokumentowane ustawienia, z powtórzeniami dla obu wariantów. |
Uczciwe porównanie zaczyna się od sparowanych zadań i dopasowanych warunków. Jeśli ścieżki dostępu narzucają różne prompty, narzędzia lub rozliczenia, udokumentuj te różnice i nazwij porównanie eksploracyjnym.
Koszt, dostęp i gdzie testować Muse Wonder
Porównuj koszt na zaakceptowane zadanie, a nie tylko podaną cenę za token. Długie prompty, ponowne próby, tokeny rozumowania, wywołania narzędzi, limity czasu i przegląd przez człowieka zmieniają koszt użytecznego wyniku. Quantslant zaraportował stawki tokenowe standardowego Wonder jako $4 za milion tokenów wejściowych i $20 za milion tokenów wyjściowych 12 października 2026 r., a jego własne uruchomienie 23 zadań kosztowało $0.64. To jedna raportowana ścieżka i obciążenie, a nie uniwersalna cena zadania.
Obecne ogłoszenie premierowe Meta wymienia standardowy Wonder przez Meta Model API i Muse Code, a Full przez subskrypcje Muse Code. Potwierdź dostęp, kwalifikowalność regionalną i bieżące rozliczenia w oficjalnym interfejsie przed planowaniem budżetu.
Zacznij od Atlas Cloud, aby uzyskać szerszy widok jego platformy dla programistów. Na 15 października 2026 r. nie mogłem potwierdzić Muse Wonder w katalogu modeli, więc ten artykuł nie przedstawia Atlas Cloud jako ścieżki wykonywania dla tego modelu. Jeśli Twój zespół porównuje inne modele już tam wymienione, biblioteka modeli Atlas Cloud może pomóc zidentyfikować kandydatów do uruchomienia na tym samym zestawie zadań.
Przydatnym wynikiem testu niezawodności Muse Wonder jest decyzja wdrożeniowa powiązana z dowodami: które zadanie zostało zaliczone, jak często je zaliczano, ile kosztowało i jaki przegląd pozostaje konieczny.
Często zadawane pytania
Czy Muse Wonder jest niezawodny w kodowaniu?
Wczesne testy z premiery dostarczają tylko małej próby kodowania. Quantslant zaraportował cztery zadania kodowania, z jednym nietrafionym testem jednostkowym w jednym zadaniu, podczas gdy Spring Prompt nie testował kodowania. Uruchom testy repozytorium na własnych zadaniach i powtórz ważne z nich przed podjęciem decyzji o przepływie pracy kodowania.
Jak samodzielnie przetestować niezawodność Muse Wonder?
Użyj stałego zestawu rzeczywistych zadań, zachowaj dokładne ustawienia modelu i promptu, zdefiniuj kryteria zaliczenia z wyprzedzeniem i zachowaj każdy wynik. Powtarzaj ważne zadania i weryfikuj wyniki za pomocą testów lub dokumentów źródłowych.
Ile razy należy powtórzyć każde zadanie Muse Wonder?
Użyj co najmniej trzech uruchomień dla zadań o wysokim wpływie jako wstępnej kontroli spójności. Trzy próby to nadal mała próba, więc rozszerz zestaw, gdy błędy są kosztowne lub wyniki się różnią.
Jaka jest różnica między Muse Wonder a Muse Wonder Full?
To oddzielne warianty modelu o różnych ścieżkach dostępności. Nie traktuj standardowego Wonder przy maksymalnym rozumowaniu jako Full ani nie przenoś między nimi wyników bez dopasowanego testu.
Czy mogę ufać wynikom benchmarków Muse Wonder od Meta?
Używaj ich jako dowodów możliwości raportowanych przez dostawcę i czytaj konfigurację benchmarku. Nie dowodzą spójnej wydajności w Twoich promptach, narzędziach i powtórzonych uruchomieniach.
Czy Muse Wonder jest dostępny w Atlas Cloud?
Nie mogłem zweryfikować go w katalogu modeli Atlas Cloud na 15 października 2026 r. Sprawdź aktualny katalog przed wyborem dostawcy wykonania.





