Awatar kursu, który porusza tylko ustami, może przyciągnąć uwagę na jedno zdanie, a potem zgubić sens lekcji. filmy instruktażowe z prowadzącym kursu OmniHuman 2.0 AI dają sposób na zaplanowanie widocznej ekspresji, celowych gestów i kierunku kamery wokół nagranego wyjaśnienia. Poniższy przykład kontrastu kolorów pokazuje pełną 30-sekundową scenę z prowadzącym, a równie przydatnie — problem z ciągłością rekwizytów, który warto wychwycić przed publikacją lekcji.
Najważniejsze wnioski
- Podstawowe dane wejściowe to zdjęcie prowadzącego i dźwięk; prompt tekstowy może kierować występem lub ujęciem kamery.
- Traktuj OmniHuman 2.0 jako etap wideo z prezentującym. Nadal odpowiadasz za lekcję, slajdy, nagrania ekranu, weryfikację faktów i montaż.
- 30-sekundowy przykład kontrastu kolorów pokazuje przydatne zmiany gestów i punktów widzenia oraz znikającą kartę, która wymaga redakcyjnej weryfikacji.
- Przed publikacją sprawdź synchronizację ust, ekspresję, gesty, stabilność obrazu i prawa.
- Atlas Cloud podaje $0.07 za sekundę i wyświetla obniżoną stawkę $0.056; potwierdź aktualną stawkę przed generowaniem.
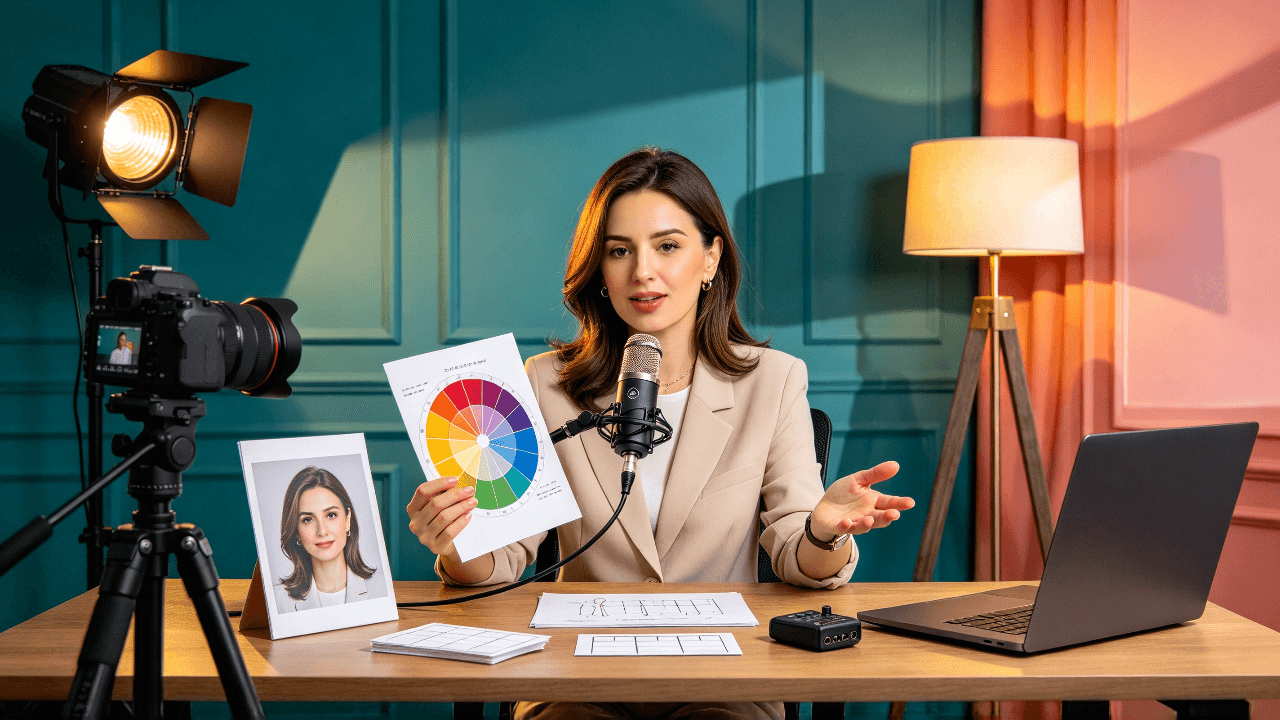
Ilustracyjna scena przygotowań: portret referencyjny, nagranie narracji i materiały lekcyjne to dane wejściowe do zaplanowania przed tworzeniem wideo z prowadzącym.
Co OmniHuman 2.0 robi dla filmów instruktażowych z prowadzącym kurs
OmniHuman 2.0 zamienia obraz referencyjny i ścieżkę audio w wideo 720p przedstawiające mówiącą lub śpiewającą postać z obrazu. Atlas Cloud model directory opisuje opcjonalne wskazówki tekstowe, dynamiczne gesty, sceny z wieloma osobami, ruch kamery i klipy do pięciu minut. To wymienione możliwości, a nie gwarancja, że każde polecenie dotyczące kursu da odpowiednie ujęcie.
(Szczegóły modelu Avatar Omni Human 2.0)
Podział odpowiedzialności ma znaczenie. Ty dostarczasz treść instruktażową i nagranie głosu. Model generuje widoczny występ. Ty decydujesz, gdzie prowadzący pomaga, a gdzie diagram, slajd, zapis ekranu lub demonstracja z bliska lepiej wyjaśniają materiał.
| Element produkcji | Co przygotowujesz lub robisz | Co wnosi model | Co sprawdzasz |
|---|---|---|---|
| Zdjęcie prowadzącego | Wyraźny portret, na który masz zgodę | Widoczna referencja tożsamości | Spójność twarzy, ubioru i tła |
| Narracja lekcji | Sprawdzone nagranie z przemyślanym tempem | Występ mówiony sterowany dźwiękiem | Czas, wymowa i pauzy |
| Wskazówki | Zwięzła notatka o kadrowaniu i sposobie prezentacji | Występ i kierunek kamery sterowane promptem | Czy ruch wspiera lekcję |
| Materiały wizualne do nauczania | Slajdy, nagrania ekranu, diagramy lub przykłady | Brak zamiennika dla tych materiałów | Czy każdy koncept jest łatwy do śledzenia |
| Finalna lekcja | Montaż, napisy i kontrola jakości | Wygenerowany fragment wideo | Dokładność, dostępność i uprawnienia |
Wczesna praca badawcza OmniHuman opisuje animację człowieka warunkowaną dźwiękiem, ale dotyczy OmniHuman-1 i nie należy jej traktować jako testu wydajności wersji 2.0. Przy decyzji o produkcji kursu opieraj się na bieżącej karcie modelu w zakresie podanych danych wejściowych i limitów wyjściowych, a następnie oceń próbkę wykonaną na własnych materiałach. (Artykuł OmniHuman-1)
Co przygotować przed wygenerowaniem filmu instruktażowego z prowadzącym AI
Przekonująca próbka zależy od czegoś więcej niż wgrania dowolnego portretu i dowolnego nagrania. Wybierz materiał, który ułatwia ocenę, czy wynik pasuje do prawdziwej lekcji.
Wybierz wyraźny wizerunek prowadzącego z potwierdzoną zgodą
Użyj portretu ustawionego przodem lub lekko odwróconego, z dobrze widoczną twarzą, ramionami w kadrze i nieprzeładowanym tłem. Unikaj bardzo małej twarzy, dużego zasłonięcia, dramatycznych cieni lub kadrowania, które nie pozostawia miejsca na naturalny ruch głowy. Jeśli chcesz mieć tego samego prowadzącego w modułach, zachowaj kopię zatwierdzonego obrazu źródłowego i konsekwentnie go używaj.
Użyj własnego zdjęcia lub potwierdź, że dana osoba wyraziła zgodę na zamierzone użycie w syntetycznym wideo. Dostępność portretu w internecie nie oznacza zgody na jego animowanie ani publikowanie.
Nagraj dźwięk lekcji, który brzmi naturalnie przed kamerą
Nagraj jeden spójny punkt dydaktyczny w spokojnym tempie. Krótki akapit łatwiej ocenić i poprawić niż cały wykład. Przed nagraniem sprawdź terminologię, nazwy, liczby i twierdzenia faktograficzne lekcji. Zachowaj naturalne pauzy między myślami, ale wytnij długie przerwy i szum tła, które mogłyby utrudnić ocenę czasu.
Posłuchaj raz z tekstem lekcji przed sobą. Jeśli liczba lub termin techniczny jest niejasny w nagraniu, najpierw popraw źródłowy dźwięk. Wygenerowana twarz nie naprawi błędnego wyjaśnienia ani niejednoznacznej wymowy.
Zadbaj, aby lekcja była użyteczna bez awatara
Napis wyjaśnienie tak, aby pozostawało zrozumiałe w połączeniu ze slajdem lub zapisem ekranu. Prowadzącego użyj do kontekstu, przejść i krótkich wyjaśnień. Do czynności w oprogramowaniu użyj nagrania ekranu, do procesu — opisanego diagramu, a do obliczeń — rozwiązanego przykładu. Następnie zmontuj te elementy razem w edytorze kursu.
Przygotuj pakiet próbny zawierający portret, jedną pełną narrację, prompt kierujący i wspierający slajd lub zapis ekranu, którego zamierzasz użyć. Daje to praktyczny test łańcucha produkcji, a nie wyizolowaną animację twarzy.
Jak stworzyć film instruktażowy z prowadzącym kurs OmniHuman 2.0
Celem pierwszego generowania jest decyzja: czy to połączenie prowadzącego i dźwięku pomaga w tej lekcji? Utrzymaj test w wąskim zakresie, aby słaby wynik łatwo było zdiagnozować.
Zacznij od jednego krótkiego fragmentu lekcji
Wybierz kompletną myśl, która wprowadza koncept, podaje jeden przykład i kończy się jasnym następnym krokiem. Nie przecinaj zdania w połowie, aby osiągnąć docelowy czas trwania. Podany poniżej przykład trwa 30 sekund — wystarczająco długo, by pokazać widoczną akcję i zmieniony punkt widzenia kamery. Przed wgraniem sprawdź rzeczywisty obsługiwany czas trwania dźwięku i aktualne zasady wprowadzania danych w aktywnym interfejsie modelu.
Wgraj obraz i narrację, a następnie pokieruj występem
Otwórz Avatar Omni Human 2.0 playground, aby sprawdzić bieżące dane wejściowe. Przygotuj obraz i narrację samodzielnie; karta modelu opisuje przepływ obraz-i-dźwięk-do-wideo, a nie przepływ tekst-na-mowę. Jeśli jeszcze nie nagrałeś głosu, utwórz go i sprawdź w preferowanym procesie audio przed tym krokiem.
W tym przepływie dostarczony dźwięk określa wypowiadane słowa i tempo. Prompt tekstowy kieruje widocznymi działaniami, ekspresją i ruchem kamery. Przejrzyj własny wygenerowany wynik, zanim opiszesz jakikolwiek planowany ruch jako udane wyjście. Atlas Cloud podaje wyjście 720p i klipy do pięciu minut, ale bieżące kontrolki i ukończone zadanie są ostatecznym sprawdzeniem dla Twojego przebiegu.
Przejrzyj klip przed tworzeniem pełnej lekcji
Obejrzyj wynik raz z dźwiękiem, a następnie raz, śledząc tekst lekcji. Zanotuj dokładny moment, w którym ruch ust, pauza lub gest wydają się rozpraszać. Jeśli problem pojawia się przy konkretnym zwrocie, skróć lub ponownie nagraj to zdanie i wygeneruj tylko poprawiony fragment. Jeśli twarz pozostaje przekonująca, ale wyjaśnienie wymaga diagramów, zachowaj ujęcie prowadzącego i dodaj te elementy wizualne podczas montażu.
Dopiero gdy jeden fragment przejdzie przegląd, użyj ponownie zatwierdzonego portretu, stylu nagrania i struktury promptu w następnej sekcji lekcji. Spójność wynika z powtarzalnego procesu przygotowania danych wejściowych; nie oznacza, że każdy wygenerowany fragment będzie identyczny.
Przykład praktyczny: 30-sekundowa lekcja kontrastu kolorów
Ta lekcja ma jedno zadanie wizualne: pokazać uczącym się, jak jaskrawa para koralowo-morska zmienia się, gdy do układu wchodzi łagodniejszy żółty. Dostarczony obraz prowadzącego, dwie klatki wybrane z gotowego wideo i pełny klip pozwalają sprawdzić rzeczywiste działanie dydaktyczne, zamiast wnioskować o nim z promptu. Przykład ilustruje projektowanie sceny i przegląd redakcyjny; przetestuj opisany powyżej przepływ na własnym zatwierdzonym obrazie i dźwięku, zanim wyciągniesz wniosek o jego wyniku.
Zacznij od kompozycji, która wspiera nauczanie
Obraz wejściowy ma wyraźną twarz i widoczne dłonie, a na stole warsztatowym leżą trzy matowe karty. Koral, morski i żółty są obecne, zanim rozpocznie się jakikolwiek ruch. Morski łuk studia, koralowy panel i bursztynowe szkło tworzą kolorową scenografię, a jednocześnie pozwalają łatwo rozróżnić karty.
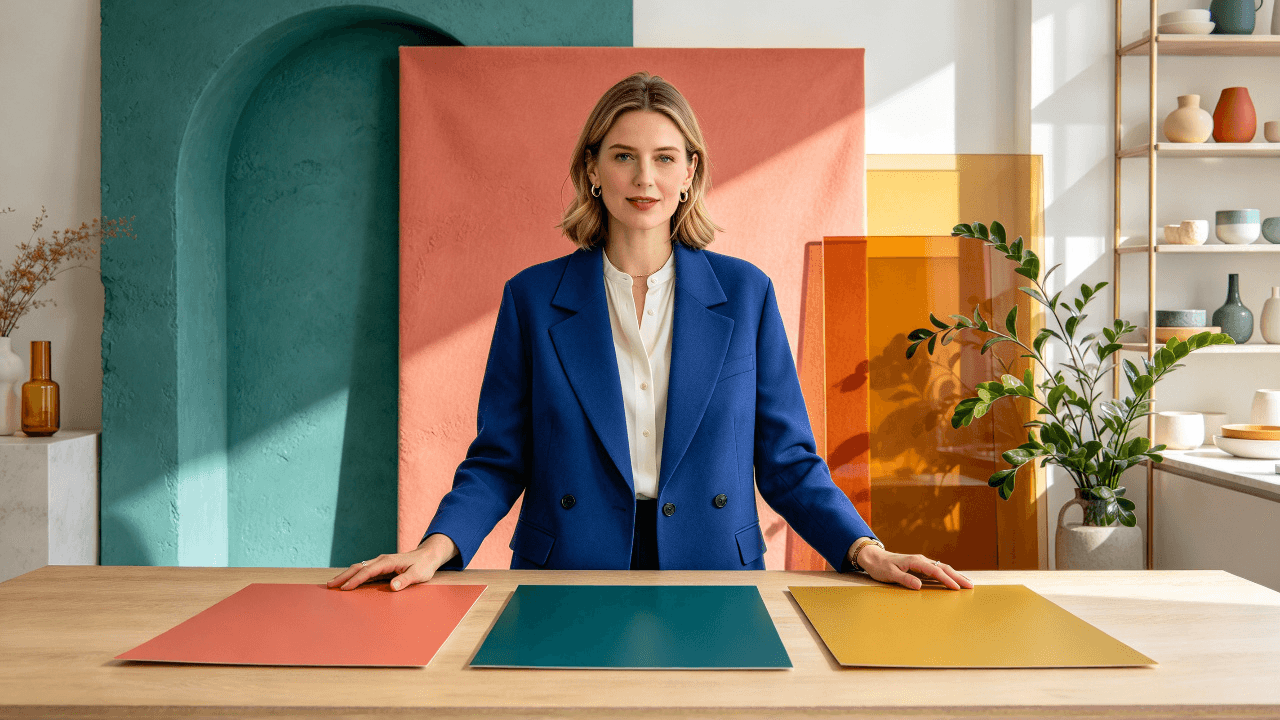
Dostarczony obraz referencyjny pozostawia twarz prowadzącego, dłonie i trzy rekwizyty dydaktyczne wyraźnie widoczne przed animacją.
Pierwsze porównanie jest czytelne
Na początku klipu prowadząca kieruje uwagę na stół warsztatowy i kładzie dłoń przy granicy koralu i morskiego. Kamera przesunęła się bliżej niż w zdjęciu referencyjnym, ale jej twarz i trzy pierwotne kolory pozostają widoczne. Ta klatka pokazuje działanie, które uczeń ma śledzić: porównać dwa sąsiadujące kolory przed zmianą układu.
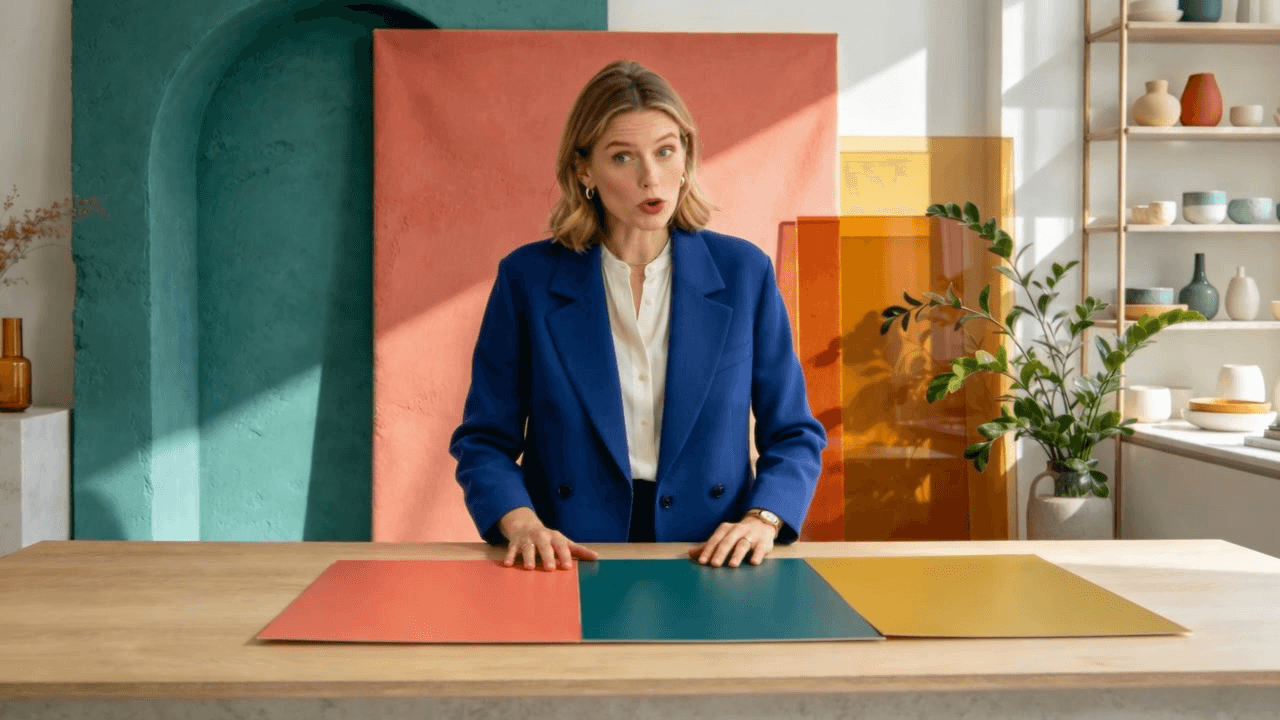
Prawdziwa klatka z dostarczonego wideo: prowadząca kieruje uwagę na krawędź koralu i morskiego, gdy wszystkie trzy karty są jeszcze widoczne.
Zmieniony punkt widzenia ujawnia problem z ciągłością
Później punkt widzenia przenosi się na drugą stronę stołu, a prowadząca gestem wskazuje żółty. Morska karta nie jest już widoczna. To różni się od planowanego układu trzech kart, w którym żółty znajdowałby się między koralem a morskim. Bliższe ujęcie i ekspresja dodają scenie urozmaicenia, ale brakująca karta zmienia przykład dydaktyczny. Gdyby to była finalna lekcja kursu, zmiana rekwizytu wymagałaby kolejnego ujęcia albo montażu, który uczyni zamierzone porównanie poprawnym.
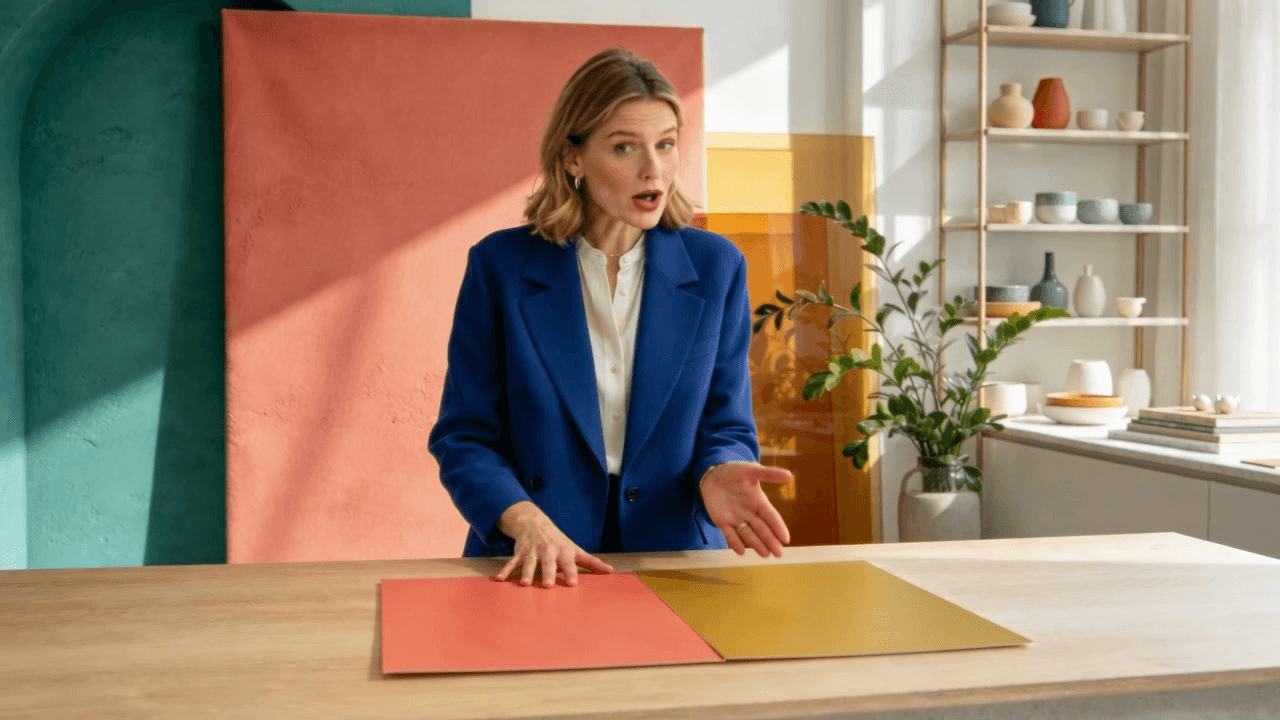
Późniejsza klatka z tego samego klipu: kąt kamery i gest się zmieniają, a morska karta zniknęła z układu.
Obejrzyj pełną scenę z dźwiękiem
Dostarczone wideo trwa nieco ponad 30 sekund i zawiera ścieżkę audio. Obejrzyj je jako jeden ciągły przykład, aby gesty, ekspresję, ruch kamery i dźwięk można było ocenić razem. Dwie powyższe klatki są dowodem różnych momentów, a nie osobnymi wygenerowanymi przypadkami.
Scena odnosi sukces, dając prowadzącej więcej do zrobienia niż stanie twarzą do kamery: obsługuje rekwizyty, zmienia spojrzenie i jest pokazywana z więcej niż jednego punktu widzenia. Znikająca morska karta to ważne ustalenie z przeglądu. Zachowaj finalną lekcję tylko wtedy, gdy przykład wizualny odpowiada temu, co uczeń ma zrozumieć, i zweryfikuj mówione wyjaśnienie względem dźwięku przed publikacją.
Jak sprawdzić, czy film instruktażowy z prowadzącym AI jest gotowy
Zastosuj przegląd, który sprawdza zarówno wygenerowany występ, jak i lekcję tak, jak zobaczą ją uczący się:
- Synchronizacja ust: Czy ruchy ust ogólnie odpowiadają kluczowym sylabom i pauzom? Odtwórz ponownie trudne nazwy i krótkie pauzy.
- Ekspresja: Czy twarz pasuje do spokojnego wyjaśnienia, czy przechodzi w niezwiązany uśmiech lub przesadną emocję?
- Gesty: Czy dłonie pozostają z dala od twarzy i nie rozpraszają od ważnego slajdu?
- Tożsamość i scena: Czy rysy twarzy, ubiór i tło pozostają stabilne przez cały klip?
- Dokładność dźwięku: Czy terminologia, nazwy i liczby są wymawiane poprawnie w dostarczonym nagraniu?
- Jasność nauczania: Czy montaż zawiera potrzebny slajd, zapis ekranu, napis lub rozwiązany przykład w odpowiednim momencie?
- Prawa i ujawnienie: Czy masz zgodę na wizerunek i głos oraz czy sprawdziłeś zasady ujawniania i politykę instytucji dla docelowej grupy odbiorców i rynku?
Zdecyduj, czy zachować klip, poprawić źródłowy dźwięk lub obraz, czy zamiast tego użyć voiceoveru ze slajdami. Nie zachowuj ujęcia prowadzącego tylko dlatego, że generowanie zajęło czas. Wyraźne nagranie ekranu może lepiej nauczyć kroku procedury.
Koszt i skalowanie dla filmów kursowych
Na dzień października 2026 r. strona modelu Atlas Cloud podaje standardową stawkę $0.07 za sekundę i wyświetla obniżoną stawkę $0.056 za sekundę z 20% rabatem. Proste szacunki na podstawie tych podanych stawek to:
| Wygenerowany czas trwania | Przy $0.07/s | Przy wyświetlanej $0.056/s |
|---|---|---|
| 20 sekund | $1.40 | $1.12 |
| 60 sekund | $4.20 | $3.36 |
| 5 minut | $21.00 | $16.80 |
To obliczenia na podstawie stawek modelu, a nie oferta dla Twojego konta ani gwarancja końcowej opłaty. Wyświetlany rabat może się zmienić, a podatki, warunki na poziomie konta lub inne opłaty mogą wpłynąć na płatność. Ponownie sprawdź szczegóły modelu i rzeczywisty ekran potwierdzenia przed produkcją.
Krótka próbka ogranicza koszt sprawdzenia nowego portretu, głosu lub promptu. W przypadku dłuższego materiału podziel lekcję na rzeczywistych granicach dydaktycznych, takich jak nowy koncept lub rozwiązany przykład. Nie dziel zdania ani nie usuwaj potrzebnego wyjaśnienia tylko po to, by dopasować się do limitu generowania. Przy podanej stawce standardowej pięciominutowe wyjście kosztowałoby $21 przed zastosowaniem jakiegokolwiek rabatu; porównaj to z krótszymi fragmentami plus czasem montażu i zdecyduj, który format służy lekcji.
Prywatność, zgoda i zaufanie do kursu
Przed generowaniem potwierdź, że możesz użyć wizerunku i głosu prowadzącego do syntetycznego wideo w zamierzonym kursie, kanale dystrybucji i czasie trwania. Jeśli występuje wykonawca, pracownik, gościnny wykładowca lub student, udokumentuj zgodę i wszelkie ograniczenia. Sprawdź wymagania swojej instytucji dotyczące mediów generowanych lub zmienianych przez AI oraz obowiązujące zasady na rynkach docelowych; ten artykuł nie określa obowiązków prawnych.
Przejrzyj gotową lekcję tak, jak zrobiłby to instruktor. Popraw scenariusz i nagranie, ujawnij syntetyczną prezentację tam, gdzie oczekuje tego Twoja publiczność lub polityka, i utrzymaj odpowiedzialność człowieka za twierdzenia kursu. Dopracowany prowadzący może sprawić, że słaby lub niesprawdzony materiał będzie wyglądał na wiarygodny, dlatego właściciel lekcji powinien zatwierdzić zarówno słowa, jak i finalny montaż.
Na pierwszą produkcję wykonaj jeden krótki fragment, przejrzyj go zgodnie z listą kontrolną i oszacuj następną partię przy użyciu bieżącej stawki za sekundę. Ta mała decyzja powie Ci, czy filmy instruktażowe z prowadzącym kursu OmniHuman 2.0 AI należą do Twojego procesu tworzenia kursów.
Często zadawane pytania
Czy OmniHuman 2.0 może tworzyć film kursowy z samego tekstu?
Karta Atlas Cloud opisuje przepływ obraz-i-dźwięk-do-wideo z opcjonalnymi wskazówkami tekstowymi. Nie podaje zwykłego tekstu jako zamiennika dźwięku narracji, więc przygotuj ścieżkę głosową osobno.
Czy mogę użyć tego samego obrazu prowadzącego w wielu lekcjach?
Możesz przygotować ten sam zatwierdzony obraz do osobnych generowań. Ponowne użycie wspiera spójną referencję wizualną, choć nie gwarantuje identycznych ekspresji, kadrowania czy gestów w każdym wyniku. Przejrzyj każdy fragment przed ich połączeniem.
Czy OmniHuman 2.0 generuje głos lekcji?
Opisany przepływ przyjmuje ścieżkę audio jako dane wejściowe. Nagraj lub wyprodukuj głos osobno, sprawdź go i wgraj gotową narrację.
Ile kosztuje 20-sekundowy klip kursowy OmniHuman 2.0 w Atlas Cloud?
Przy podanej stawce standardowej $0.07 za sekundę 20 sekund daje $1.40. Przy wyświetlanej stawce $0.056 daje $1.12. Potwierdź aktualne ceny i końcową opłatę przed uruchomieniem generowania.


