

Głos może brzmieć, jakby ktoś powstrzymywał łzy, podczas gdy animowana twarz pozostaje neutralna. W przypadku dopasowania emocjonalnego głosu i mimiki twarzy w OmniHuman 2.0 pierwszą poprawką jest często uważniejsze słuchanie, a nie dodawanie kolejnych przymiotników. Dźwięk już zawiera słowa, rytm i nacisk wokalny; krótki prompt powinien ukierunkować widoczną grę, która wspiera te sygnały.
Ten przewodnik daje twórcom powtarzalny sposób przygotowania portretu i ścieżki, napisania skupionego promptu oraz oceny wyniku pod kątem istotnych niezgodności. Omawia mowę i śpiew, jednocześnie oddzielając udokumentowane informacje od wskazówek podmiotów trzecich i niezweryfikowanych twierdzeń o produkcie.
Najważniejsze wnioski
- Traktuj dźwięk jako podstawę wykonania i kieruj wyłącznie widocznymi działaniami, kadrowaniem i szczegółami sceny.
- Zaznacz punkty emocjonalne przed pisaniem promptu, a następnie sprawdź te same momenty z wyciszonym i włączonym dźwiękiem.
- Przy każdej kolejnej próbie zmieniaj jedną zmienną; prompt nie naprawi każdego problemu ze źródłowym dźwiękiem ani generowaniem.
Jak OmniHuman 2.0 łączy dźwięk, mimikę twarzy i ruch
Przydatnym sposobem myślenia o modelu portretu sterowanym dźwiękiem jest przypisanie każdemu wejściu konkretnego zadania. Obraz zakotwicza widocznego bohatera. Nagranie dostarcza mowę lub pieśń, w tym jej rytm i sposób wykonania. Opcjonalne wskazówki tekstowe mogą opisywać wykonanie lub scenę. Dokładne zachowanie i elementy sterujące mogą się różnić w zależności od implementacji produktu, więc nie traktuj ogólnych badań OmniHuman ani instrukcji zewnętrznego studia jako oficjalnych specyfikacji OmniHuman 2.0.
Pierwotne badanie OmniHuman-1 opisuje animację człowieka warunkowaną kombinacjami obrazu, tekstu, dźwięku i pozy. Ten artykuł ustanawia szersze ramy rodziny badawczej, a nie dokładny interfejs, ograniczenia lub jakość OmniHuman 2.0 (ICCV 2025, artykuł OmniHuman-1).
| Dane wejściowe | Prawdopodobny wkład | Co możesz przygotować |
|---|---|---|
| Portret referencyjny | Wygląd bohatera i poza początkowa | Wybierz wyraźną twarz i kadrowanie odpowiednie do zamierzonego ruchu |
| Mowa lub śpiew | Słowa, kadencja, pauzy, energia wokalna | Użyj czystej ścieżki z zamierzonym wykonaniem i przytnij zbędną ciszę |
| Opcjonalny prompt kierujący | Widoczne działania, kadrowanie, scena lub wskazówki nastroju | Podaj kilka konkretnych wskazówek zgodnych z nagraniem |
Synchronizacja ust i emocjonalne wykonanie są powiązane, ale to nie ten sam test jakości. Usta mogą podążać za sylabami, podczas gdy oczy, głowa lub gest wydają się niepasujące do kwestii. Podobnie twarz może wyglądać ekspresyjnie, a wyczucie czasu może odbiegać od głosu. Sprawdzaj oba.
Przewodniki OmniHuman 2.0 od podmiotów trzecich opisują przepływ pracy z obrazem i dźwiękiem oraz opcjonalnymi wskazówkami tekstowymi, ale te strony nie są dokumentacją techniczną BytePlus. Publicznie dostępna dokumentacja Atlas obejmuje własny model Avatar Omni Human 1.5, a nie OmniHuman 2.0. Najbezpieczniejszym założeniem roboczym jest więc podejście praktyczne, a nie absolutne: pozwól dźwiękowi sugerować, czego potrzebuje wykonanie, i używaj promptu, aby prosić o widoczne wybory, które możesz sprawdzić.
Wybierz portret i ścieżkę audio, które pozwalają odczytać emocje
Model nie może reagować na sygnały, które trudno zobaczyć lub usłyszeć. Zacznij od danych wejściowych, które dają mu uczciwe, proste zadanie, a następnie trzymaj je bez zmian, testując brzmienie promptu.
| Dane wejściowe na start | Dlaczego mogą pomóc | Na co uważać |
|---|---|---|
| Ostra, nieprzysłonięta twarz przy równomiernym świetle | Ułatwia odczytanie rysów twarzy | Silne cienie, włosy, dłonie lub rekwizyty mogą zasłaniać kluczowe obszary |
| Neutralna lub łagodnie wyrazista poza początkowa | Zostawia przestrzeń na zmianę wykonania | Silny, stały wyraz twarzy może kolidować z innym nastrojem wokalnym |
| Jeden wyraźny głos na pierwszym planie | Ułatwia śledzenie mowy i pauz | Muzyka, hałas w pomieszczeniu lub nakładające się głosy mogą maskować sygnały |
| Zamierzone frazowanie ze słyszalnymi pauzami | Daje momenty do odwzorowania w widocznych działaniach | Płaskie wykonanie może oferować mniej wyraźnych zmian emocjonalnych |
| Piosenka z wyeksponowanym wokalem i wyraźnymi frazami | Ułatwia rozpoznanie śpiewanych słów i dynamiki | Fragmenty instrumentalne dają mniej wskazówek wokalnych dla ruchu ust |
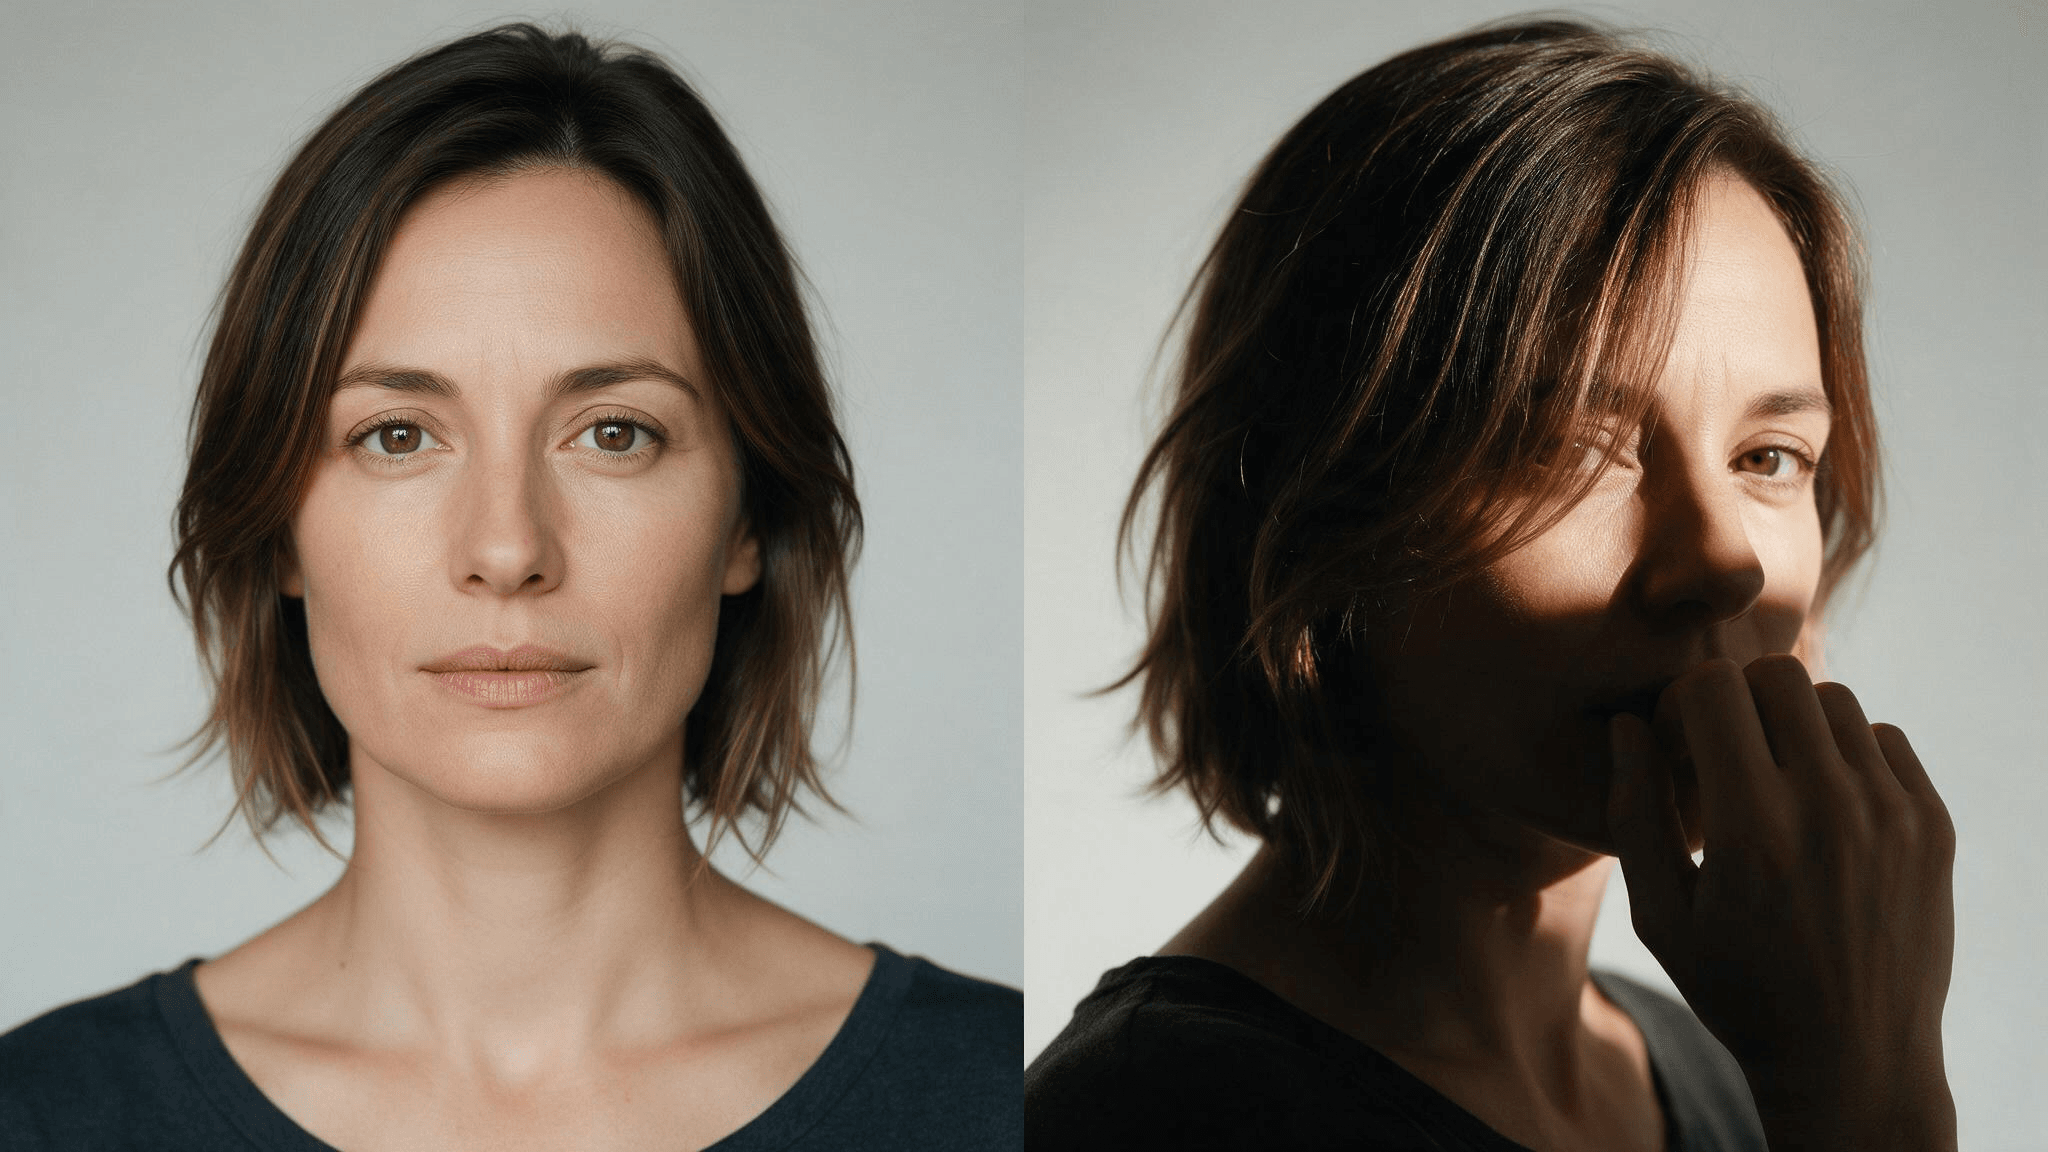 Ilustracyjne porównanie portretów: wyraźny widok z przodu ułatwia sprawdzenie sygnałów twarzy niż zacieniony, częściowo przysłonięty widok. To nie jest porównanie wyników modelu.
To kontrole produkcyjne, a nie gwarancje. Dobre dane wejściowe nadal mogą dać słabą próbę, a wizualnie ekspresyjny portret nie gwarantuje spójnej animacji. Do pierwszego testu użyj jednego portretu, jednego krótkiego fragmentu audio i jednego promptu. Unikaj jednoczesnej zmiany kadrowania, nagrania i wskazówek; w przeciwnym razie nie będziesz wiedzieć, która poprawka pomogła.
W przypadku śpiewu nasłuchuj zakończeń fraz, przeciągniętych nut i zmian intensywności. Prompt może kierować przechyleniem głowy lub ruchem dłoni wokół uderzenia muzycznego, ale nie powinien powtarzać tekstu piosenki, który już znajduje się w nagraniu. W przypadku dialogu mówionego zaznacz pauzy i wyrazy akcentowane. Prompt, który prosi o dużą zmianę nastroju podczas ciągłego spokojnego zdania, może stworzyć wykonanie sprawiające wrażenie narzuconego.
Ramy promptu do dopasowania głosu i mimiki twarzy
Trzymaj wskazówki na tyle krótko, by dało się je ocenić. Praktyczna struktura to:
Kadrowanie + osoba mówiąca i sposób podania + emocja spójna ze ścieżką + jedno lub dwa widoczne działania + opcjonalny kierunek kamery.
Na przykład, jeśli osoba mówiąca brzmi ciepło i spokojnie, możesz napisać:
Statyczne średnie zbliżenie. Kobieta mówi ciepło do kamery, zaczynając ze spokojem i pozwalając, by na ostatniej kwestii pojawił się lekki uśmiech. Po pauzie delikatnie kiwa głową. Utrzymaj stabilne kadrowanie.
To przykładowy prompt, a nie zgłoszone uruchomienie OmniHuman 2.0. Jego użyteczną cechą jest to, że każda instrukcja odnosi się do czegoś widocznego: ujęcie pozostaje stabilne, wyraz twarzy zmienia się pod koniec, a kiwnięcie głową ma sygnał. Możesz porównać wynik ze ścieżką, zamiast oceniać ogólne polecenie typu „bądź emocjonalny”.
Przewodnik po promptach podmiotu trzeciego zaleca zwięzłe wskazówki w języku naturalnym i dopasowanie żądanej emocji do głosu. Traktuj to jako praktyczną heurystykę, a nie gwarancję lub oficjalną regułę produktu (przewodnik po promptach KreatorFlow).
Przed użyciem promptu sprawdź go względem nagrania:
- Jeśli głos jest cichy i powściągliwy, poproś o subtelny wyraz, a nie szeroki uśmiech.
- Jeśli sposób podania staje się pewniejszy, umieść widoczną zmianę po słyszalnej zmianie.
- Jeśli nagranie zawiera śmiech, pauzę lub westchnienie, zdecyduj, czy twarz powinna w tym momencie pozostać bez zmian, zareagować czy się poruszyć.
- Jeśli portret początkowy już pokazuje pożądany wyraz, nie opisuj go ponownie, chyba że chcesz zmienić ten wyraz.
Używaj słów czasu, takich jak „najpierw”, „potem” i „na koniec”, tylko gdy dźwięk ma wyraźne punkty. Unikaj nakładania sprzecznych instrukcji, takich jak „statyczne kadrowanie” i „orbitująca kamera” albo „spokój” i „wściekłość”. Prompt to wskazówki dla istniejącego wykonania, a nie zastępcza ścieżka głosowa.
Trzy wzorce promptów dla mowy, zmian emocjonalnych i śpiewu
Wybierz najmniejszy wzorzec pasujący do twojego audio. Te przykłady to szablony do dostosowania, a nie zweryfikowane twierdzenia o wynikach.
Spokojne wyjaśnienie
Stabilne średnie zbliżenie. Mówiąca osoba spokojnie wyjaśnia kwestię, z opanowanym wyrazem twarzy i jednym drobnym gestem podkreślającym. Utrzymaj nieruchomą kamerę.
Użyj tego, gdy ścieżka jest miarowa i spójna. Jeden gest może uwidocznić nacisk, nie zamieniając prostego wyjaśnienia w teatralne wykonanie.
Zmiana emocji
Statyczne zbliżenie. Mówiąca osoba zaczyna poważnie, a następnie łagodnieje w lekki uśmiech po pauzie przed ostatnim zdaniem. Utrzymaj powściągliwy ruch.
Użyj tego tylko wtedy, gdy nagranie zawiera pauzę lub słyszalną zmianę, która wspiera tę zmianę. Jeśli nie ma sygnału, przejście może wyglądać arbitralnie.
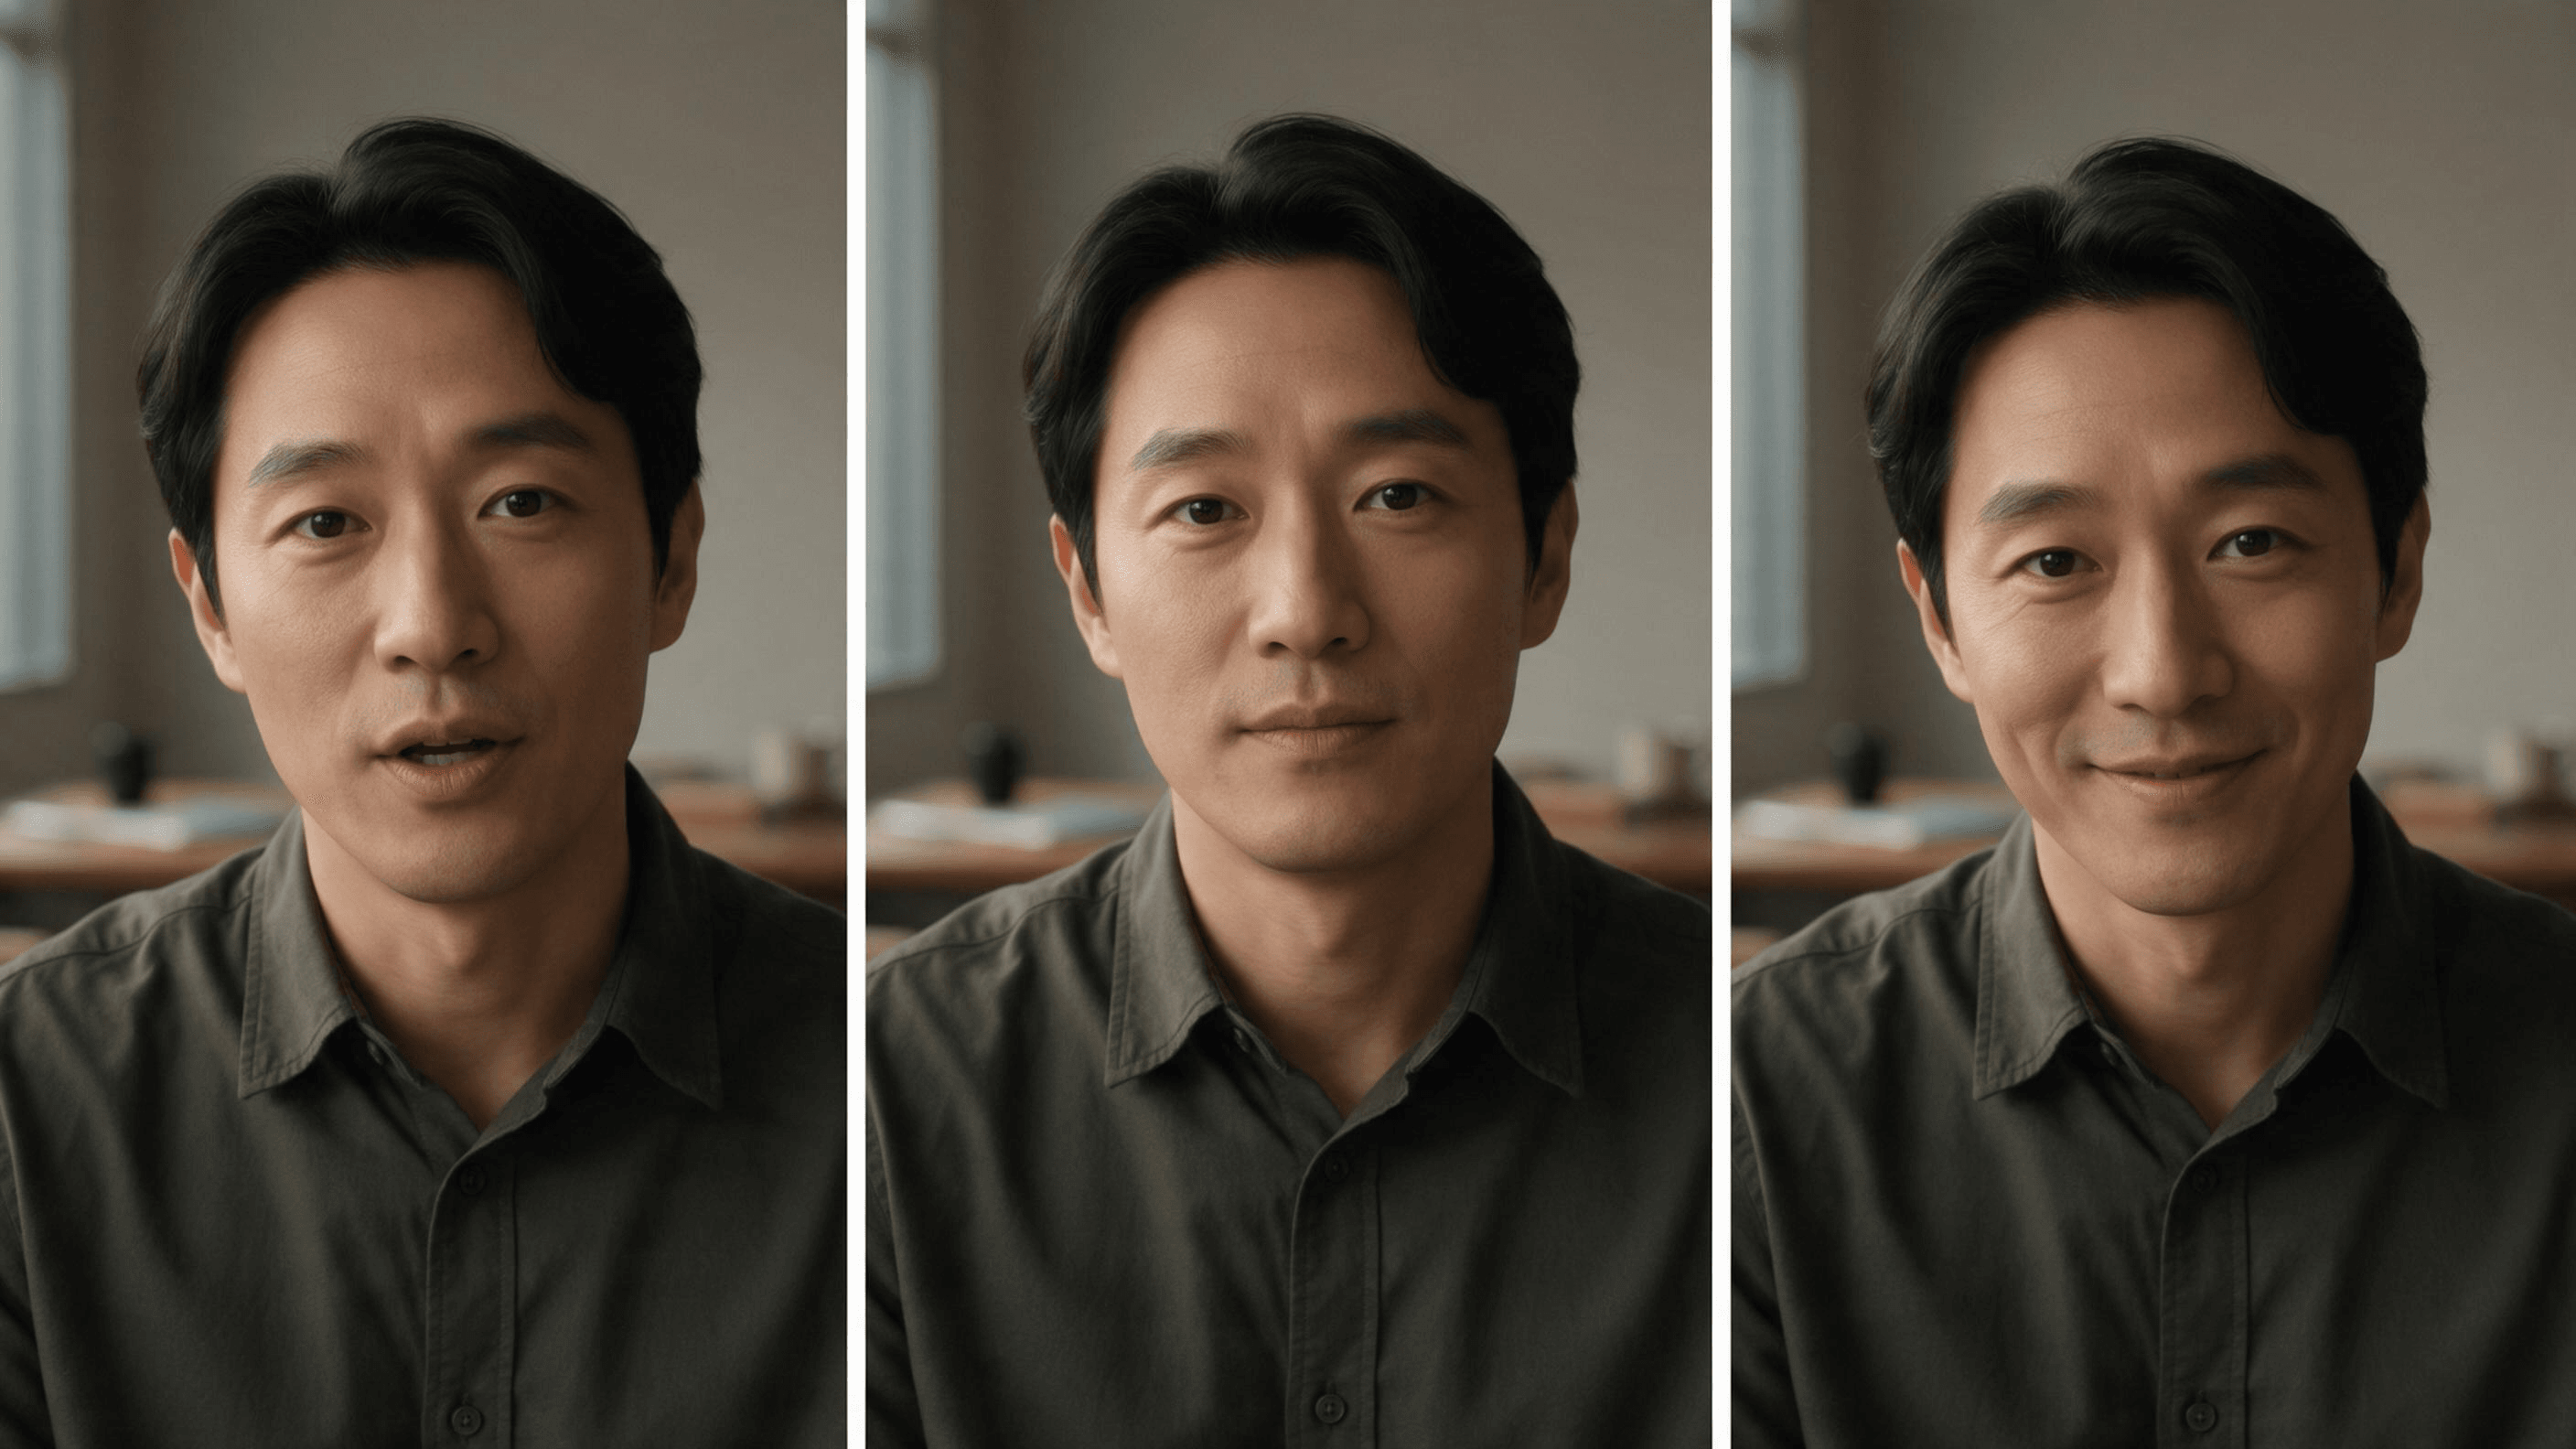 Konceptualny storyboard dla promptu mowy: poważne podanie, pauza, potem powściągliwy uśmiech. To zaplanowane punkty mimiczne, a nie klatki z generowania OmniHuman 2.0.
Śpiew
Średnie zbliżenie. Wokalistka występuje ze skupionym wyrazem twarzy, na przeciągniętej nucie na chwilę zamyka oczy, a następnie opuszcza brodę wraz z końcem frazy. Utrzymaj stabilne kadrowanie.
Kieruj wykonaniem wokół zdarzeń muzycznych, zamiast powtarzać tekst piosenki. Prompt może sugerować widoczne działanie; dostarczona ścieżka pozostaje źródłem śpiewanych słów i wyczucia czasu.
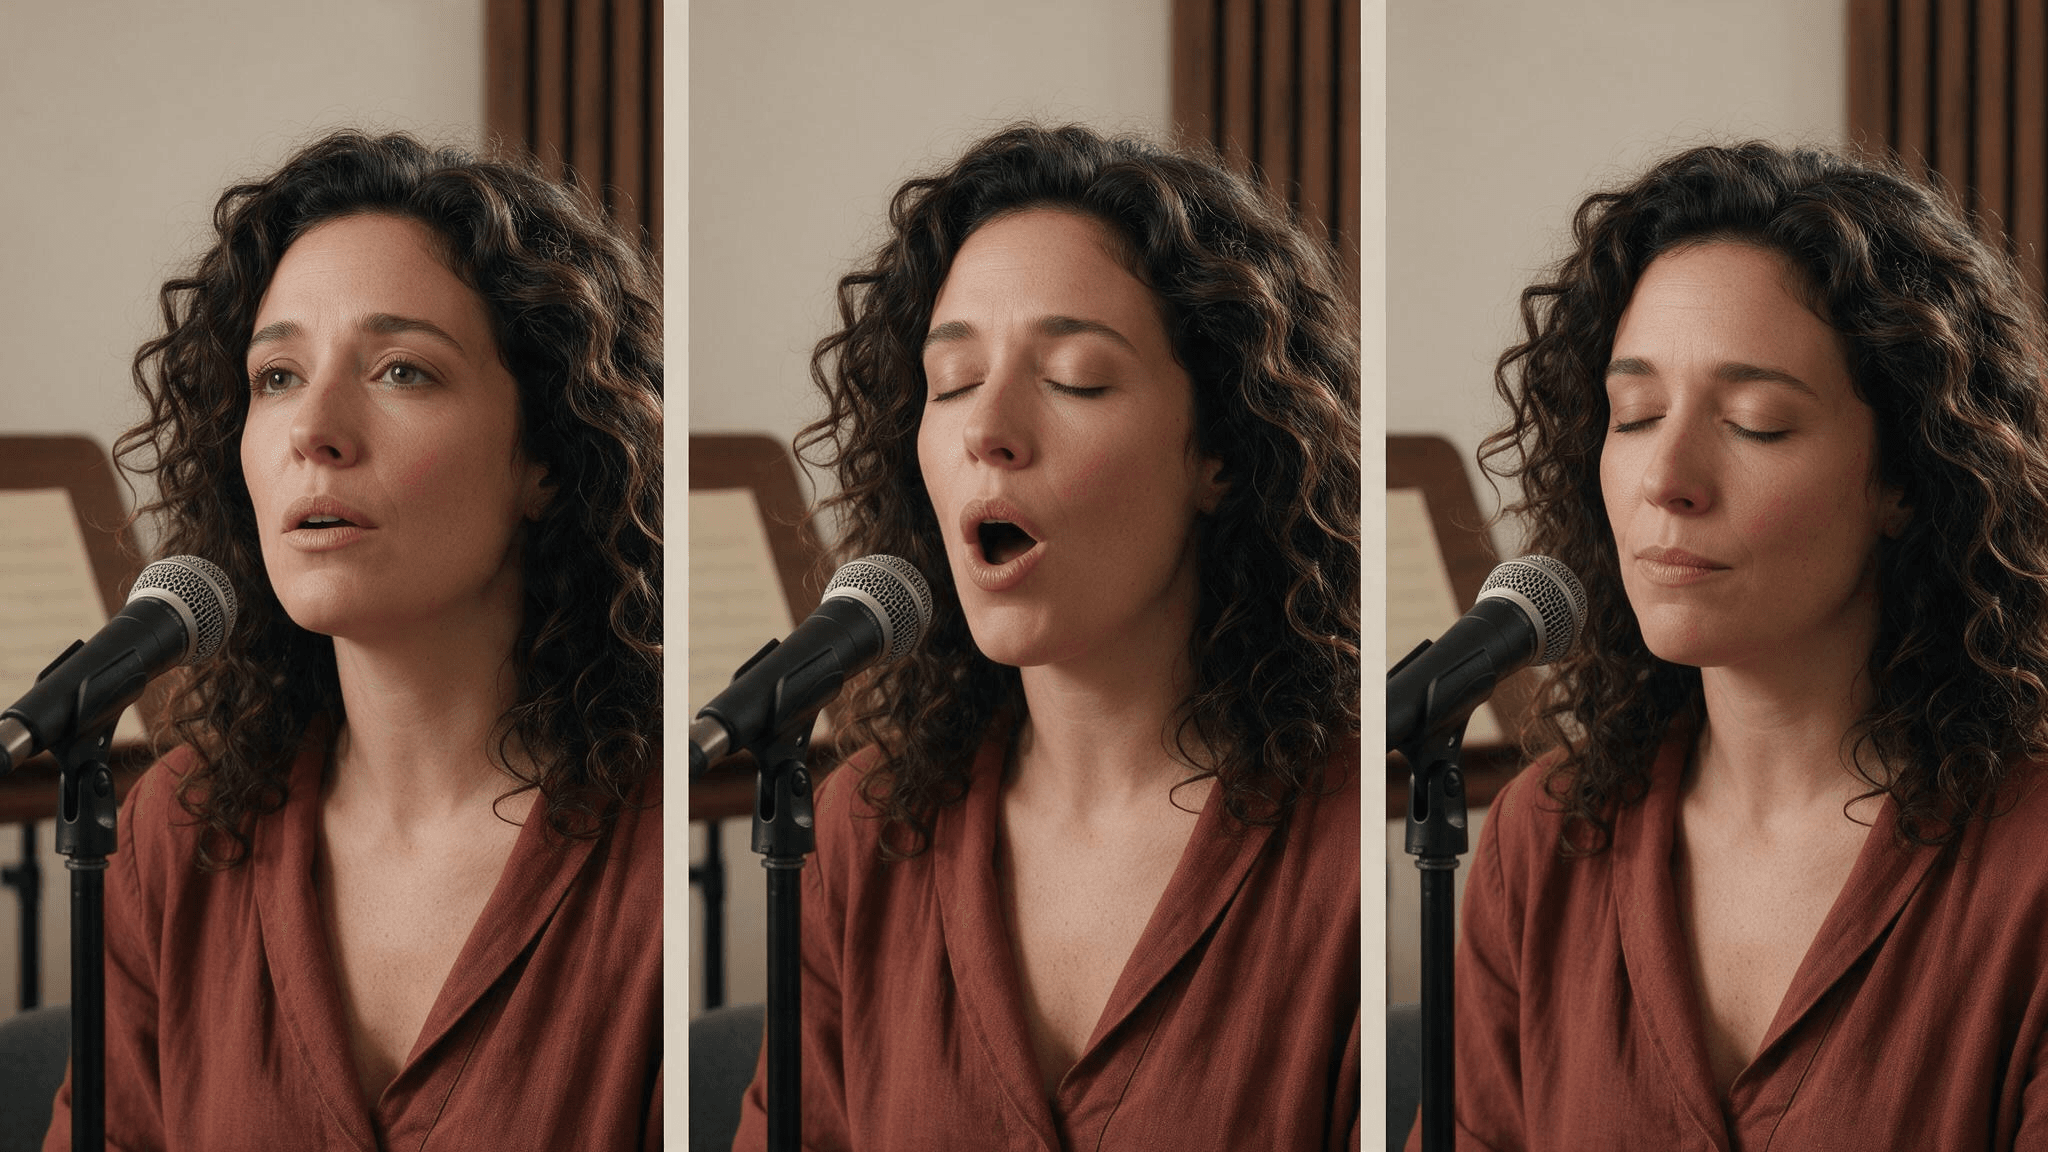 Konceptualny storyboard dla promptu śpiewu: rozpocznij frazę, przeciągnij nutę, potem osiądź na końcu. Nieruchome obrazy nie pokazują synchronizacji dźwięku.
Porównaj „bądź emocjonalny i filmowy” z „mów ciepło, a potem uśmiechnij się po pauzie”. Pierwsze pozostawia emocję, wyczucie czasu i widoczne działanie do interpretacji. Drugie daje jeden konkretny moment do sprawdzenia. Jeśli wynik nie trafia w ten moment, masz ukierunkowany następny test: przesuń sygnał, złagodź wyraz twarzy lub wybierz inną edycję audio.
Trzyetapowa kontrola zgodności głosu i twarzy
Szybka metoda przeglądu może ujawnić, czy problem tkwi w audio, w wskazówkach wizualnych czy w wygenerowanej próbie. Użyj tych samych znaczników czasu we wszystkich trzech etapach.
Poniższa pętla bez dźwięku pozwala sprawdzić widoczną część wykonania mówionego: ruch ust, spojrzenie i zmiany mimiki. Do kontroli zgodności głosu z twarzą użyj oryginalnego klipu z dźwiękiem.
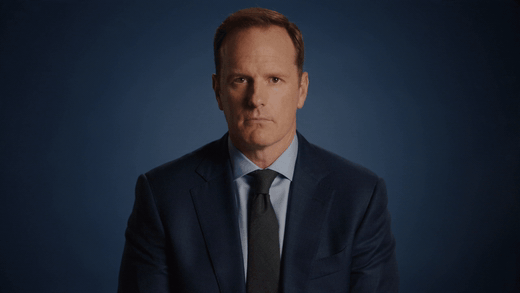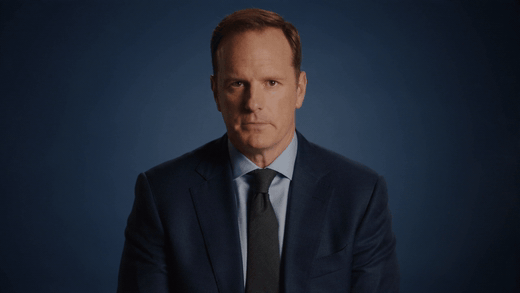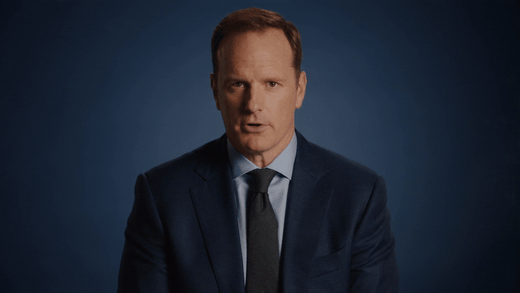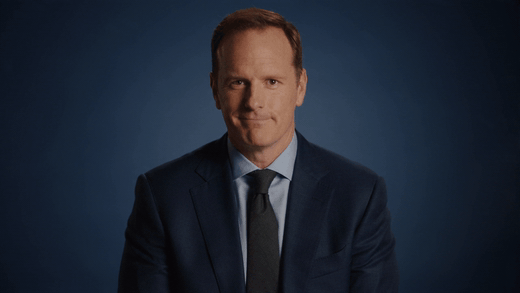
Cichy GIF przekonwertowany z dostarczonego wideo awatara. Pokazuje widoczny ruch, ale sam nie może ustalić synchronizacji dźwięku ani wykonania OmniHuman 2.0.
- Słuchaj, nie patrząc. Zaznacz zmiany emocjonalne, pauzy, nacisk, śmiech, szept i zakończenia fraz. Zapisz, co słuchacz mógłby wywnioskować z samego głosu.
- Oglądaj z wyciszeniem. Przy tych znacznikach czasu zwróć uwagę na twarz, spojrzenie, ruch głowy i gesty. Zapisz, co wykonanie zdaje się komunikować bez dźwięku.
- Odtwórz je razem. Oznacz tylko niezgodności, które zmieniają znaczenie lub odciągają uwagę od kwestii. Lekki uśmiech pod zdaniem wyrażającym zmartwienie może mieć znaczenie; drobne mrugnięcie zwykle nie.
Tabela przeglądu zamienia te obserwacje w jedno następne działanie:
| Czas | Sygnał głosowy | Sygnał widoczny | Zgodność? | Najmniejszy następny test |
|---|---|---|---|---|
| 00:04 | Cicha, napięta fraza | Szeroki uśmiech | Nie | Zmniejsz żądaną intensywność uśmiechu |
| 00:09 | Pauza przed kwestią pocieszającą | Twarz pozostaje nieruchoma | Być może | Dodaj jedno subtelne kiwnięcie głową po pauzie |
| 00:13 | Śmiech w nagraniu | Wyraz twarzy pozostaje poważny | Nie | Sprawdź, czy edycja audio wyraźnie zachowuje śmiech |
Powyższe wpisy to hipotetyczne przykłady użycia tabeli, a nie obserwacje z uruchomienia modelu. Twoje notatki z przeglądu powinny dotyczyć twojego własnego klipu. Zmieniaj jedną rzecz na raz: popraw prompt, dostosuj edycję audio lub wypróbuj inny portret. Następnie powtórz te same kontrole w tych samych momentach.
Jeśli niezgodność utrzymuje się mimo wyraźnego sygnału i skupionych wskazówek, potraktuj ją jako ograniczenie generowania dla tej próby. Więcej przymiotników może dodać szumu, nie rozwiązując problemu z wyczuciem czasu ani wykonaniem. Zdecyduj, czy warto testować inne dane wejściowe lub przepływ pracy, czy próba jest już odpowiednia dla zamierzonego kontekstu.
Rozwiązywanie problemów z płaskimi lub niedopasowanymi wyrazami twarzy
Użyj objawu, aby wybrać kontrolowany następny krok. To ogólne hipotezy dotyczące rozwiązywania problemów, a nie zweryfikowane twierdzenia o wadach OmniHuman 2.0.
| Co zauważasz | Możliwa przyczyna | Jeden następny test |
|---|---|---|
| Twarz wygląda neutralnie przez cały klip | Głos ma niewielki kontrast lub wskazówki nie zawierają widocznego sygnału | Użyj bardziej ekspresyjnego fragmentu audio albo poproś o jedno konkretne działanie w wyraźnym punkcie |
| Twarz przesadza w subtelnej kwestii | Prompt prosi o silniejszą emocję, niż wspiera ścieżka | Usuń dodatkowe działania i zmniejsz intensywność emocjonalną |
| Usta wydają się niezsynchronizowane | Nagranie zawiera hałas, nakładające się głosy, długą ciszę lub trudne cięcia | Wypróbuj czystszą edycję z ciaśniejszym wyczuciem czasu, zanim przepiszesz prompt |
| Słuchacz zdaje się mówić na obrazie grupowym | Role mówiącego i słuchacza mogą być niejednoznaczne w testowanym przepływie pracy | Zidentyfikuj każdą osobę według pozycji i określ, kto mówi, jeśli interfejs to obsługuje |
| Tożsamość lub drobne szczegóły zmieniają się podczas ruchu | Źródłowe kadrowanie lub żądany ruch mogą utrudniać ocenę spójności | Uprość ruch i porównaj krótszą, stabilniejszą próbę |
Nie zakładaj, że problem z audio naprawisz wyłącznie promptem. Najpierw sprawdź, czy słowa są wyraźne i czy cisza lub cięcia nie zaburzają rytmu. Jeśli są w porządku, uprość widoczne wskazówki. Skupiona ponowna próba daje lepszy dowód niż jednoczesne przepisanie wszystkich danych wejściowych.
Czy OmniHuman 2.0 jest dostępny w Atlas Cloud?
Aktualne publiczne strony modeli Atlas Cloud wymieniają Avatar Omni Human 1.5 i dokumentują jego dane wejściowe: obraz, audio oraz opcjonalny prompt. Podczas tej kontroli nie znalazłem OmniHuman 2.0 w liście modeli Atlas. Oznacza to, że dokładnego modelu 2.0 nie należy przedstawiać jako możliwego do uruchomienia przez Atlas Cloud.
Jeśli chcesz poznać powiązane zadanie awatara sterowanego dźwiękiem w Atlas, zapoznaj się ze stroną modelu Avatar Omni Human 1.5 i jego udokumentowanymi danymi wejściowymi. Dokumentacja określa obraz referencyjny, URL audio i opcjonalny prompt; opisuje audio do 60 sekund i zaleca 15 sekund lub mniej dla najlepszej jakości. To szczegóły wersji 1.5, a nie specyfikacje OmniHuman 2.0. Sprawdź aktualny katalog modeli Atlas, aby poznać bieżącą dostępność i ceny przed wyborem przepływu pracy. Podczas badania nie udało mi się potwierdzić aktualnej publicznej ceny tego modelu, więc ten artykuł jej nie podaje.
Sprawdź prawa i kontekst przed publikacją
Przed udostępnieniem animowanej osoby potwierdź, że masz zgodę na użycie portretu i głosu w zamierzonym celu. Sprawdź również prawa do muzyki, wizerunku, głosu i dystrybucji dla konkretnego kontekstu. Wymagania mogą się różnić w zależności od materiału źródłowego i zastosowania; ta lista kontrolna to praktyczne wskazówki, a nie konkluzja prawna.
Oznaczaj media syntetyczne lub edytowane, gdy widzowie mogliby zasadnie pomylić je z materiałem dokumentalnym lub bieżącym oświadczeniem prawdziwej osoby. Prowadź notatki projektowe dotyczące plików źródłowych i edycji, zwłaszcza w pracy dla klienta lub kampanii. Technicznie zgodne wykonanie nadal wymaga odpowiedzialnego kontekstu publikacji.
W przypadku dopasowania emocjonalnego głosu i mimiki twarzy w OmniHuman 2.0 następnym użytecznym krokiem jest kontrolowany test: wybierz wyraźny portret, zaznacz punkty emocjonalne w audio, napisz jedną krótką wskazówkę i sprawdź te same znaczniki czasu z wyłączonym i włączonym dźwiękiem. Jeśli rozważasz opcję hostowaną w Atlas, najpierw zweryfikuj dokładny model i aktualną cenę.
Często zadawane pytania
Czy OmniHuman 2.0 generuje głos?
Przepływ pracy opisywany przez przewodniki podmiotów trzecich zaczyna się od dostarczonego audio i animuje portret do niego. Nie zakładaj, że model generuje głos, chyba że konkretny interfejs produktu dokumentuje taką możliwość.
Czy OmniHuman 2.0 potrafi animować zarówno śpiew, jak i mowę?
Przewodniki OmniHuman 2.0 podmiotów trzecich opisują użycie zarówno mowy, jak i śpiewu. Do testu śpiewu użyj fragmentu z wyeksponowanym wokalem i wyraźnym frazowaniem, a następnie kieruj widocznymi działaniami wokół przeciągniętej nuty lub zakończenia frazy.
Czy prompt powinien powtarzać dialog lub tekst piosenki?
Zwykle nie. Nagranie już dostarcza słowa. Używaj promptu do widocznych wskazówek, takich jak wyraz twarzy, gest, kadrowanie lub sygnał sceniczny, i unikaj dodawania tekstu, który koliduje ze ścieżką.
Co zmienić najpierw, jeśli wyraz twarzy wydaje się nieprawidłowy?
Użyj trzyetapowej kontroli, aby zlokalizować niezgodność. Jeśli samo audio jest niejasne lub emocjonalnie płaskie, najpierw przetestuj edycję audio. Jeśli sygnał jest wyraźny, ale twarz go nie trafia, uprość i zmień wyczucie czasu jednej wskazówki w prompt.
Czy OmniHuman 2.0 jest w Atlas Cloud?
Podczas tego badania nie znalazłem OmniHuman 2.0 w publicznym katalogu modeli Atlas Cloud. Atlas dokumentuje Avatar Omni Human 1.5 jako powiązaną opcję; zweryfikuj aktualną listę, zanim ją wybierzesz.





