Najnowsza aktualizacja: Wan 3.0 jest już dostępny od 24 sierpnia 2026 roku.
Stworzyłeś folder na jeden 15-sekundowy spot. Dwa statyczne ujęcia postaci. Film w tonacji marki przesłany przez klienta. Księga marki istniejąca tylko jako PDF. Próbka głosu aktora, którego naprawdę chcesz.
Potem otworzyłeś swój model wideo, a on poprosił o jeden obraz.
Więc zrobiłeś to, co wszyscy. Przełożyłeś folder na 800-słowny prompt i modliłeś się. Twarz odpłynęła w trzecim ujęciu. Kurtka zmieniła kolor. Głos należał do kogoś innego.
Omni-referencja Wan 3.0 to pierwszy raz, kiedy model wideo mówi: dobrze, daj mi ten folder. Do 20 zasobów w jednym wywołaniu, w pięciu rodzajach wejścia, połączonych w jednym ciągłym, 30-sekundowym ujęciu.
Ten artykuł robi trzy rzeczy i pomija resztę. Rozbiera na czynniki pierwsze, czym dokładnie jest te 20 zasobów, używa oficjalnych klipów Alibaby jako dowodu i podaje równoważny przepływ pracy, który możesz uruchomić już dziś, ponieważ Wan 3.0 jest wciąż w publicznej becie na własnym chmurze Alibaby i nie jest jeszcze dostępny przez platformy zewnętrzne.
Kluczowe wnioski
- Multimodalna referencja Wan 3.0 akceptuje do 20 zasobów w jednym wywołaniu, obejmujących obrazy, filmy, audio, dokumenty i aktywne strony internetowe, i utrzymuje je spójne w ramach jednego 30-sekundowego ujęcia.
- Jest to pierwszy mainstreamowy model wideo, który traktuje PDF, prezentację lub URL jako kreatywne wejście, zamiast czegoś, co parafrazujesz w prompcie.
- Wan 3.0 wszedł w publiczną betę 6 sierpnia 2026 roku na Alibaba Cloud Model Studio i Qwen Cloud jako
wan3.0-video. Ma zamknięte wagi. Każdy, kto twierdzi, że jest już na Apache 2.0, zgaduje. - Nagłówek o 20 zasobach nie jest tym, w czym faktycznie wyprzedza konkurencję. Modele typu referencja-do-wideo, które możesz wywołać już teraz, akceptują więcej niż 20 zasobów. Różnicą są dokumenty i strony internetowe, a nie liczba.
- Możesz przetestować format z dwiema postaciami, zablokowaną referencją i w pełni udźwiękowionym dźwiękiem za darmo, korzystając z darmowego generatora AI reklam skeczowych Atlas Cloud: cztery zdjęcia produktów na wejściu, 15-sekundowy mówiony skecz na wyjściu, bez karty.
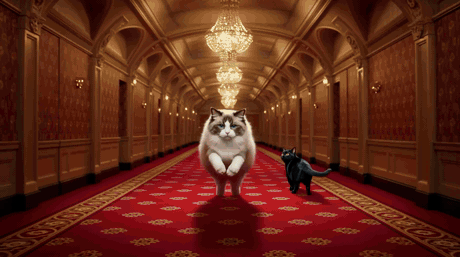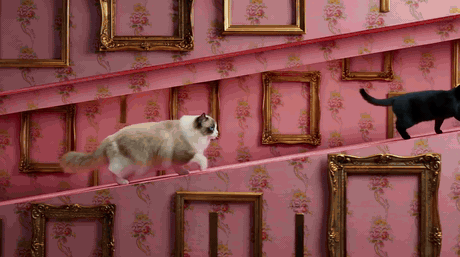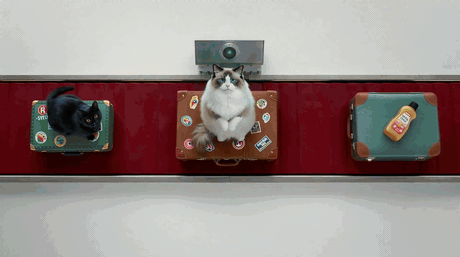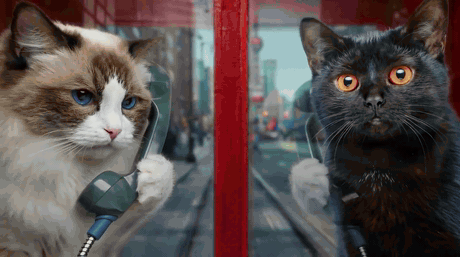
Dwa koty ścigane przez pięć różnych planów przez Wan 3.0 bez dryfu postaci_Dwa obrazy referencyjne. Pięć zupełnie różnych planów, od hotelowego korytarza po bęben pralki i czerwoną budkę telefoniczną. Ani jedna klatka dryfu. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby_ Wan 3.0 creator handbook , sierpień 2026, który jest również źródłem wszystkich innych klipów Wan 3.0 w tym artykule.
Dlaczego wideo z wieloma referencjami się rozpada i co zmienia multimodalna referencja Wan 3.0
Modele wideo nie mają pamięci między klipami. Każda generacja zaczyna się od zera. To cały problem w jednym zdaniu.
Więc w momencie, gdy twoja historia potrzebuje więcej niż jednego ujęcia, szyjesz. Ujęcie pierwsze daje ci twarz, którą kochasz. Ujęcie drugie daje ci kuzyna tej twarzy. Ujęcie trzecie cicho zmienia kurtkę ze śliwkowej na burgund, a zanim zauważysz, zapłaciłeś już za jedenaście renderów.
Referencja z pojedynczego obrazu pomogła, ale blokowała tylko jedną rzecz. Twarz. Nie mogła jednocześnie utrzymać twarzy, stroju, rekwizytu, lokacji i głosu, ponieważ było jedno miejsce i pięć zadań.
Są dwa wyjścia. Dać modelowi więcej miejsc lub przestać go zmuszać do zaczynania od nowa. Wan 3.0 robi jedno i drugie naraz i dlatego te dwie główne funkcje są w zasadzie jedną funkcją. Natywne 30-sekundowe ujęcie oznacza, że nie ma cięcia, przez które postać mogłaby dryfować. Dwadzieścia zasobów referencyjnych oznacza, że każdy element, który musi pozostać stały, dostaje swoje własne dedykowane miejsce zamiast walczyć o jedno.
Oto jak to wygląda, gdy nic nie jest szyte. Trzydzieści sekund, jedna ciągła kamera, dziecko w wózku sklepowym, które kończy wbudowane w billboard, a potem spod niego wychodzi.
Pełne 30 sekund w jednym przebiegu, bez cięć, ze ścieżką dźwiękową wygenerowaną w tym samym przebiegu. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby.
Co oznacza "20 zasobów" w multimodalnej referencji Wan 3.0
Dwadzieścia to liczba w nagłówku. Ważne jest to, że te dwadzieścia nie jest tego samego rodzaju. Omni-referencja Wan 3.0 obejmuje pięć typów wejścia, a każdy z nich kontroluje inną oś wyniku.
Obrazy kontrolują tożsamość. Karta postaci, ujęcie produktu, tabliczka lokalizacji. Wan 3.0 nazywa to spójnością na poziomie pikseli, a w przykładach Alibaby blokada rozciąga się poza twarz na garderobę: warstwowa szara szata, skórzany kaftan na paskach, ciemny pas w talii – wszystko to przetrwało szesnastosekundową walkę wręcz w trzech lokalizacjach.
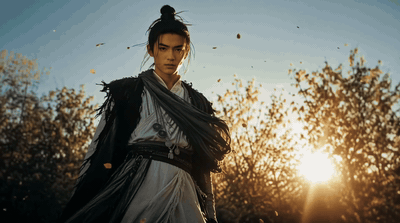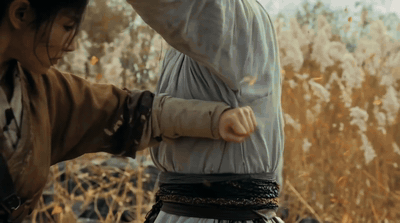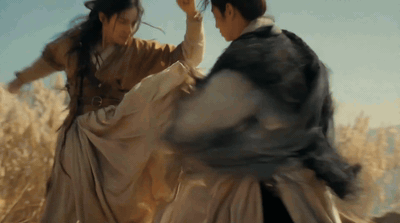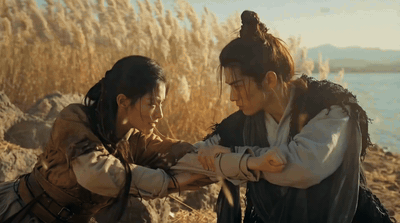
Dwie karty postaci napędzające scenę walki wuxia, a szczegóły kostiumów utrzymane od klatki do klatki
Dwie karty postaci plus jedna tabliczka lokalizacji trzcinowiska. Garderoba i sceneria utrzymują się przez wszystkie rzuty. Pokazane jako cichy GIF; dostarczony plik zawiera stereofoniczny miks 44,1 kHz. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby.
Audio kontroluje głos. To jest ta część, która sprawia, że "multimodalność" to coś więcej niż marketing. Dołączasz próbkę głosu na postać, piszesz kwestie w prompcie, a dialog wraca w tej barwie, z synchronizacją ust, w tym samym przebiegu co obraz. Dwie osoby, dwie referencje głosu, jedna siłownia.
Dwa obrazy podmiotów plus dwa osobne klipy referencyjne głosu, a dialog wraca w tych dwóch głosach. Warto włączyć dźwięk dla tego przykładu. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby.
Wideo kontroluje timing. Referencyjne wideo nie ma być kopiowane. Ma przekazać swój rytm: jak długo trwa beat, jak porusza się przejście. W tym przykładzie pięć klatek kluczowych dostarcza podmioty, a referencyjne wideo dostarcza poziomego rytmu przewracania kart między nimi.
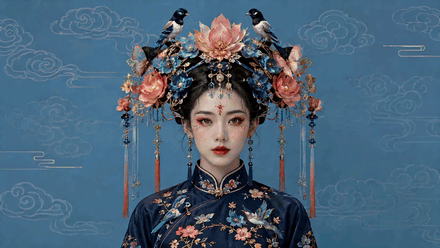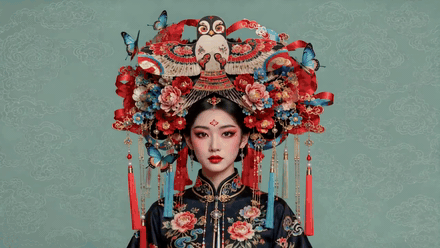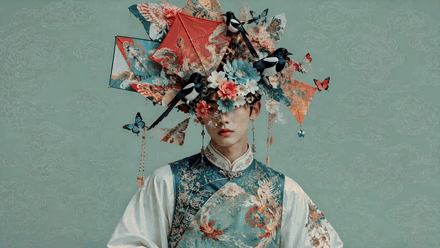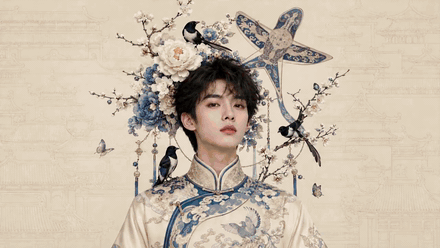
Pięć klatek kluczowych przewracanych z tempem zaczerpniętym z referencyjnego wideo_Pięć_ obrazów klatek kluczowych dla podmiotów, jedno referencyjne wideo dla rytmu przewracania. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby.
Dokumenty i strony internetowe kontrolują strukturę. To jest prawdziwie nowa rzecz. Wan 3.0 akceptuje pliki dokumentów i aktywne URL-e jako kreatywne wejście, a raporty z bety wymieniają .doc, .xls, .ppt, .pdf i .txt wśród akceptowanych formatów (AlphaSignal, sierpień 2026). Ta sama logika działa już z obrazem storyboardu: jeden storyboard na wejściu, sześć ujęć na wyjściu, w kolejności z storyboardu.
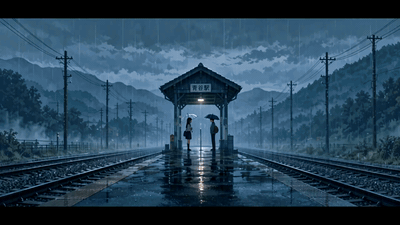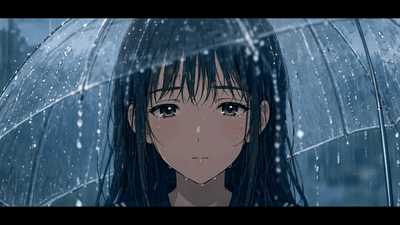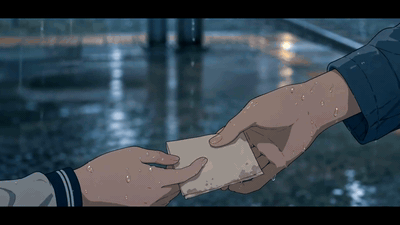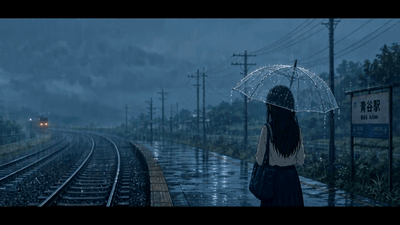
Pojedynczy arkusz storyboardu rozszerzony na sześć sekwencyjnych ujęć na deszczowej peronie kolejowej
Jeden arkusz storyboardu jako referencja, sześć ujęć wygenerowanych w jego kolejności, aż do przekazania notatki w ujęciu piątym. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby.
Pierwsza i ostatnia klatka kontrolują punkty końcowe. Najstarsza sztuczka w książce, wciąż obsługiwana, wciąż najszybszy sposób na ograniczenie ujęcia.
Oto jak to się ma do wersji, której większość ludzi faktycznie używa dzisiaj.
| Wan 2.7 Referencja-do-Wideo | Wan 3.0 omni-referencja | |
|---|---|---|
| Zasoby referencyjne | jeden obraz na podmiot, do 3 filmów, 1 klip głosu | do 20 zasobów łącznie |
| Modalności | obraz, wideo, audio | obraz, wideo, audio, dokument, strona internetowa |
| Maksymalny czas trwania, jeden przebieg | 10 s | 30 s natywnie, plus inteligentny czas trwania |
| Audio w tym samym przebiegu | tak | tak |
| Edycja i rozszerzanie wideo | nieudostępnione | edycja oparta na instrukcjach i referencjach, plus rozszerzanie |
| Dostępność | dostępne na API stron trzecich | Alibaba Cloud Model Studio i Qwen Cloud beta |
Jest jedna zasada, której nikt nie umieszcza w dokumentacji, a której wszyscy uczą się na własnej skórze: jedna referencja, jedno zadanie. Obraz1 blokuje twarz i strój. Wideo1 przekazuje tylko ruch. Audio1 przekazuje tylko barwę. W momencie, gdy dajesz pojedynczemu zasobowi dwa sprzeczne zadania lub przesyłasz obraz referencyjny z dwiema osobami, model musi zgadywać, a zgadywanie jest dokładnie tym, co chciałeś powstrzymać. Podręcznik Alibaby jest w tej kwestii równie bezpośredni: jeden podmiot na obraz referencyjny.
Przepływ pracy multimodalnej referencji Wan 3.0, który możesz uruchomić dzisiaj
Najpierw prosta odpowiedź. Wan 3.0 jest w publicznej becie na własnym chmurze Alibaby, pod identyfikatorem modelu wan3.0-video (Alibaba Wan, sierpień 2026). Nie trafił jeszcze na platformy API stron trzecich, w tym Atlas Cloud. Każdy, kto teraz sprzedaje ci dostęp do API Wan 3.0, odsprzedaje coś innego.
To, co już trafiło, to kształt przepływu pracy. Pakiet referencyjny na wejściu, jedno wywołanie, gotowy klip z dźwiękiem na wyjściu. Działa to już dzisiaj na modelach referencja-do-wideo, które możesz wywołać w karcie przeglądarki, a gdy ustawisz je wszystkie w jednym rzędzie, nagłówek o 20 zasobach wygląda inaczej.
| Model | Zasoby referencyjne | Modalności | Maks. czas trwania | Natywne audio | Cena za sekundę |
|---|---|---|---|---|---|
| Wan 3.0 (beta Alibaby, nie na Atlas) | 20 łącznie | obraz, wideo, audio, dokument, strona | 30 s | Tak | zgłaszane $0.05 do $0.20 w zależności od rozdzielczości |
| Wan 2.7 Referencja-do-Wideo | 1 obraz na podmiot, 3 filmy, 1 klip głosu | obraz, wideo, audio | 10 s | Tak | $0.10 |
| Seedance 2.5 Referencja-do-Wideo | 50 (30 obraz / 10 wideo / 10 audio) | obraz, wideo, audio | 30 s | Tak | $0.13 |
| MiniMax H3 Referencja-do-Wideo | mieszane, brak podanego limitu | obraz, wideo, audio | 15 s | Tak | $0.10 |
| Kling Video O3 Pro Referencja-do-Wideo | 7 obrazów lub 4 obrazy + 1 wideo | obraz, wideo | 15 s | Tak | $0.10 |
| Vidu Q3-Mix Referencja-do-Wideo | 4 obrazy | obraz | 16 s | Tak | $0.11 |
| Veo 3.1 Referencja-do-Wideo | 3 obrazy | obraz | 8 s | Opcjonalnie | $0.20 |
Ceny to stawki Atlas Cloud z sierpnia 2026 roku. Dane Wan 3.0 to te zgłaszane dla bety Alibaba Cloud, a nie stawki Atlas, a Alibaba nie opublikowała jeszcze publicznej strony z cenami dla tego modelu, więc traktuj ten wiersz jako tymczasowy.
Przeczytaj tę tabelę dwa razy, a prawdziwa historia się ujawni. Nagłówek o 20 zasobach nie jest tym, w czym Wan 3.0 wyprzedza konkurencję, ponieważ Seedance 2.5 już przyjmuje 50 i dorównuje 30 sekundom. Tego, czego nic innego na tej liście nie przyjmuje, to PDF.
W poniższym opisie demo działa na Wan 2.7 Referencja-do-Wideo, ponieważ jego kształt wejścia jest najbliższym żyjącym krewnym omni-referencji: wiele obrazów podmiotów, opcjonalne referencyjne wideo i klip głosu, wszystkie przypisane do etykiet character1 i character2 w prompcie. Trzy modele, jedna karta przeglądarki, brak lokalnej instalacji.
Aby uruchomić aktualnie hostowane, otwórz Wan 3.0 na Atlas Cloud i przetestuj prompt podobny do poniższego, zanim opublikujesz przepływ pracy.
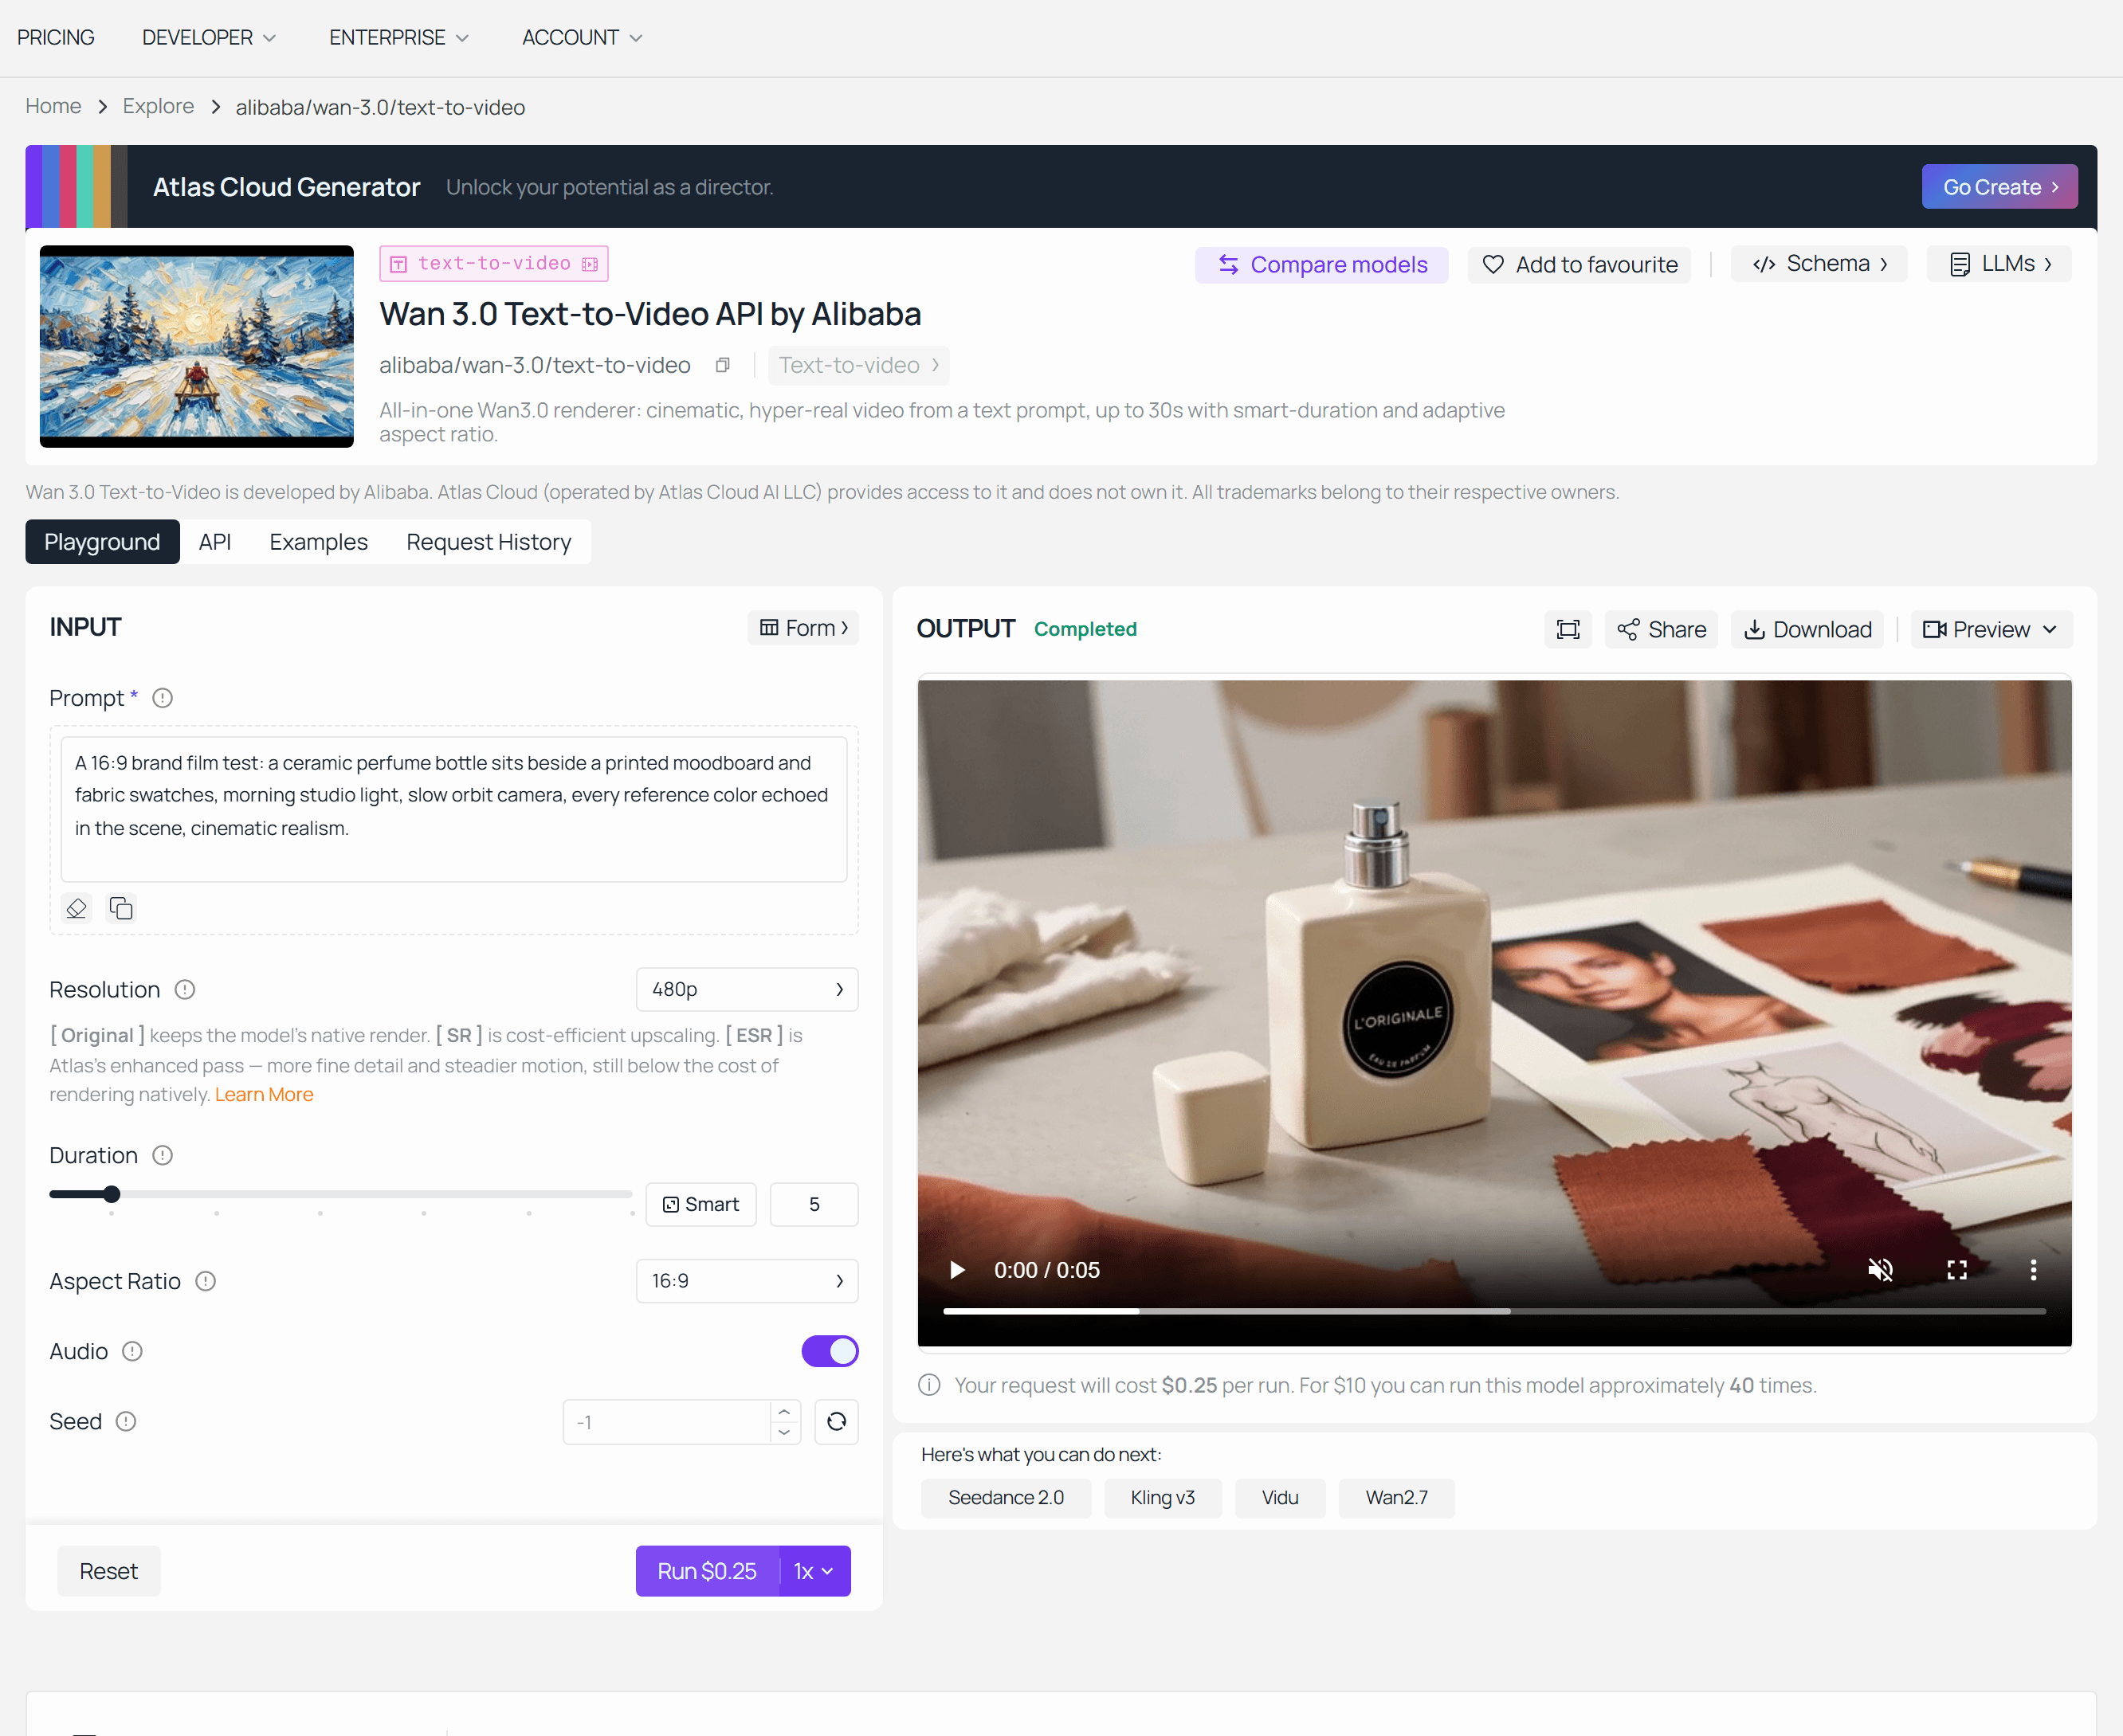
Zrzut ekranu promptu do wyniku Wan 3.0: przekazanie 20 referencji marki.
Zbuduj sam: Scena multimodalnej referencji w czterech krokach
Scena: pastelowe hotelowe recepcja. Niewzruszony portier. Podróżny trzymający ragdolla. Portier patrzy prosto w obiektyw i mówi: "Kot ma rezerwację. Pan nie."
Dwa obrazy plus jeden klip głosu, czyli trzy zasoby referencyjne w dwóch modalnościach. To najmniejsza konstrukcja, która jest uczciwie multimodalna, a nie tylko wieloobrazowa.
Krok 1. Wygeneruj obraz referencyjny 1, podmiot, który musisz zablokować
Obrazy referencyjne mają trzy zadania i tylko trzy: jeden podmiot, twarzą do kamery, czyste tło. Wszystko inne to dekoracja. Użyj GPT Image 2 z jakością high, rozmiarem 16:9, n=1.
Plain1Portret studyjny całej postaci średniego wieku hotelowego portiera z niewzruszonym wyrazem twarzy, stojącego idealnie na środku na płaskiej, zakurzonej różowej ścianie. Ma na sobie śliwkowy, dwurzędowy mundur bellhopa ze złotymi galonami i mosiężnymi guzikami, małą okrągłą czapkę typu pillbox i cienki wąsik. Idealnie symetryczne kadrowanie, miękkie, równomierne światło frontalne, brak cienia na ścianie, ziarno filmu 35 mm, stonowana pastelowa paleta. Tylko jeden podmiot, żadnych innych osób, żadnego tekstu, logo ani rekwizytów w kadrze.
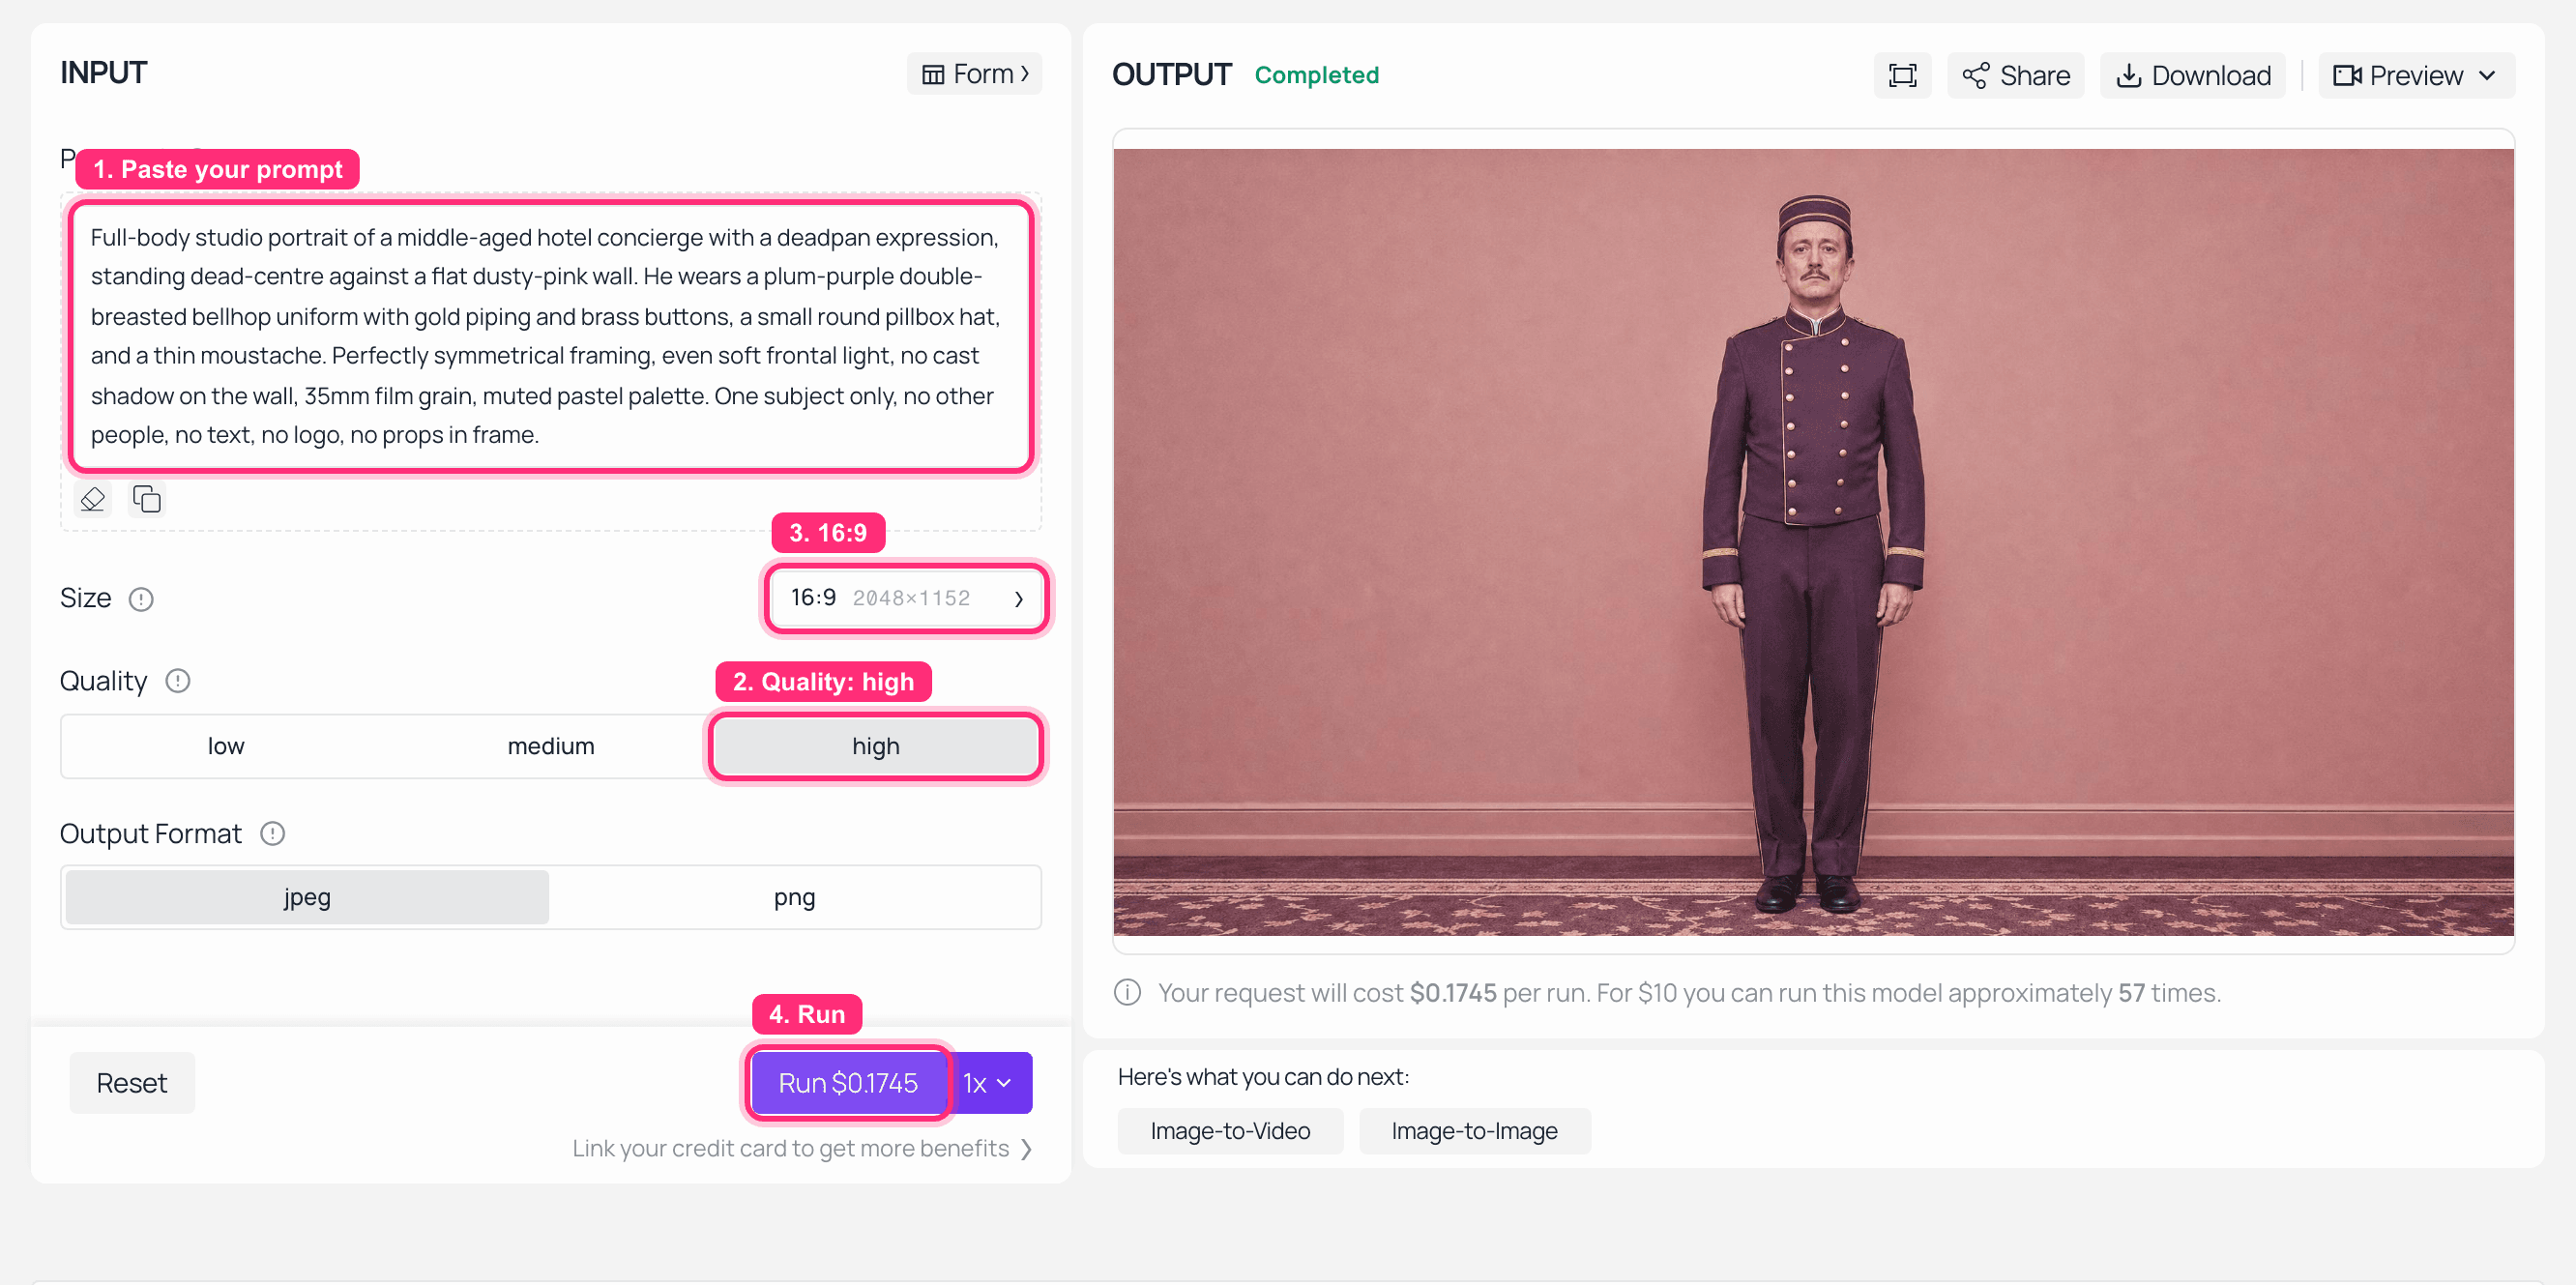
Plac zabaw GPT Image 2 na Atlas Cloud z portretem referencyjnym portiera wyrenderowanym w panelu wyjściowym
GPT Image 2 na Atlas Cloud: jakość wysoka, 16:9, jeden podmiot, płaskie tło. To jest plik, który stanie się character1.
Krok 2. Wygeneruj obraz referencyjny 2, drugi zablokowany podmiot
Ten sam model, te same ustawienia. Kontrast kolorystyczny między dwiema postaciami jest celowy, ponieważ daje modelowi łatwy sposób na odróżnienie ich, gdy dzielą kadr.
Plain1Portret studyjny całej postaci młodej podróżniczki trzymającej<|image|>ącego ragdolla przy piersi, stojącej idealnie na środku na płaskiej, musztardowo-żółtej ścianie. Ma na sobie musztardowy wełniany płaszcz, czerwony beret i okrągłe okulary w rogowej oprawce, a w wolnej ręce trzyma małą, vintage'ową skórzaną walizkę. Idealnie symetryczne kadrowanie, miękkie, równomierne światło frontalne, brak cienia na ścianie, ziarno filmu 35 mm, stonowana pastelowa paleta. Tylko jeden podmiot, żadnych innych osób, żadnego tekstu, logo.
Krok 3. Wygeneruj referencję głosu, czyli właściwą multimodalną część
Klip głosu sprawia, że z zadania wieloobrazowego staje się to zadaniem multimodalnym. Gniazdo audio Wan 2.7 chce krótkiej próbki, około 1 do 10 sekund, więc trzymaj kwestię krótko. Użyj MiniMax Speech 2.6 HD i wybierz niski, płaski, nieskrępowany męski głos.
Plain1Dobry wieczór. Melduje się? Oczywiście. Wszyscy tak.
Krok 4. Jedno wywołanie, trzy referencje, jeden gotowy klip
Teraz cały pakiet idzie razem na Wan 2.7 Referencja-do-Wideo. Ustawienia: resolution: 1080P, ratio: 16:9, duration: 10, co jest maksimum tego modelu, prompt_extend: false, seed: -1. Załaduj images w kolejności, najpierw krok 1, aby mapował się na character1, potem krok 2 jako character2, i dołącz plik z kroku 3 do audio.
Plain1Symetryczne, wyśrodkowane szerokie ujęcie pastelowego hotelowego lobby, recepcji, zakurzone różowe ściany i musztardowo-żółty stojak na klucze za nią. character1 to portier stojący za ladą; character2 to podróżniczka stojąca przed nią, wciąż trzymająca swojego ragdolla. Kamera powoli najeżdża wzdłuż idealnej osi środka i nigdy się nie przechyla. character1 patrzy prosto w obiektyw i mówi płaskim tonem: "Kot ma rezerwację. Pan nie." character2 mruga raz, powoli odwraca głowę w stronę kota, a potem z powrotem w stronę lady. Kot wpatruje się bezpośrednio w kamerę, nie ruszając się. Ziarno filmu 35 mm, miękkie, równomierne oświetlenie, stonowana pastelowa paleta, brak drgań kamery, brak cięć.
Negatywny prompt:
Plain1drgania ręczne, cięcia skokowe, napisy, tekst na ekranie, znak wodny, dodatkowe osoby, zdeformowane dłonie, morfowanie twarzy, przesunięcie kolorów, rozmycie ruchu
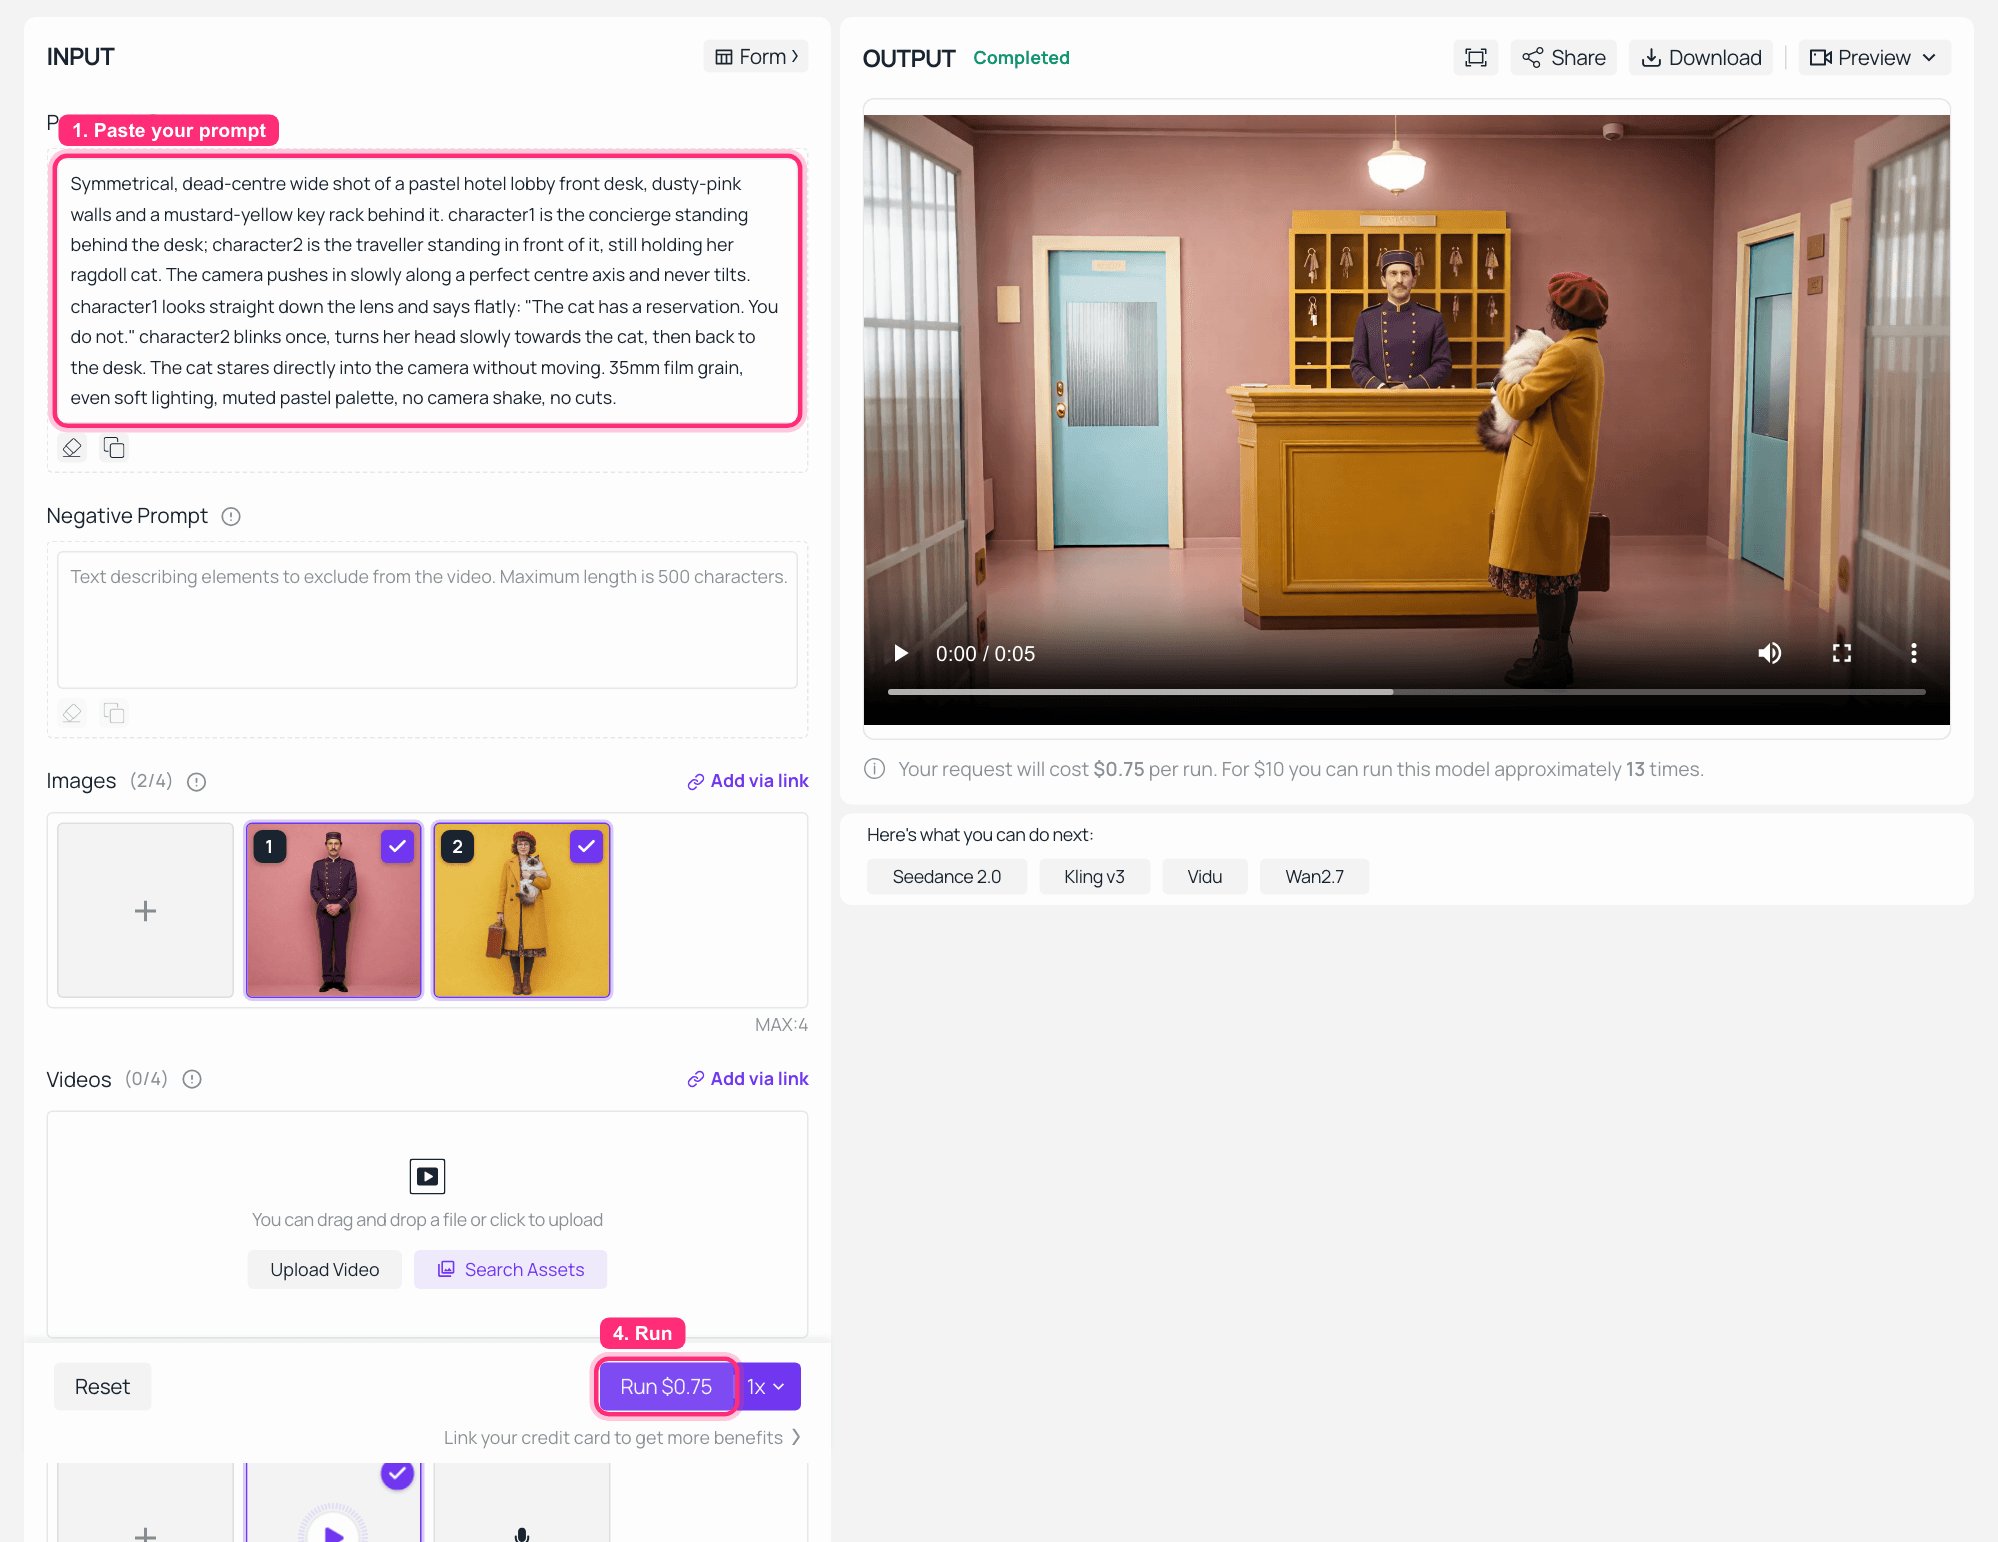
Plac zabaw Wan 2.7 Referencja-do-Wideo na Atlas Cloud z dwoma obrazami referencyjnymi i jednym plikiem audio załadowanym oraz gotowym klipem w panelu wyjściowym
Wan 2.7 Referencja-do-Wideo na Atlas Cloud: dwa obrazy referencyjne i jeden klip głosu dołączone po lewej, gotowe ujęcie odtwarzane po prawej w 1080P i 16:9. To przechwycenie uruchomiono z domyślnym czasem trwania modelu; ustaw go na 10 dla pełnej wersji poniżej.
Gotowy klip. Obie twarze utrzymane, oba stroje utrzymane, a kwestia wypowiedziana w sklonowanym głosie z kroku 3, więc ten warto odtworzyć z dźwiękiem.
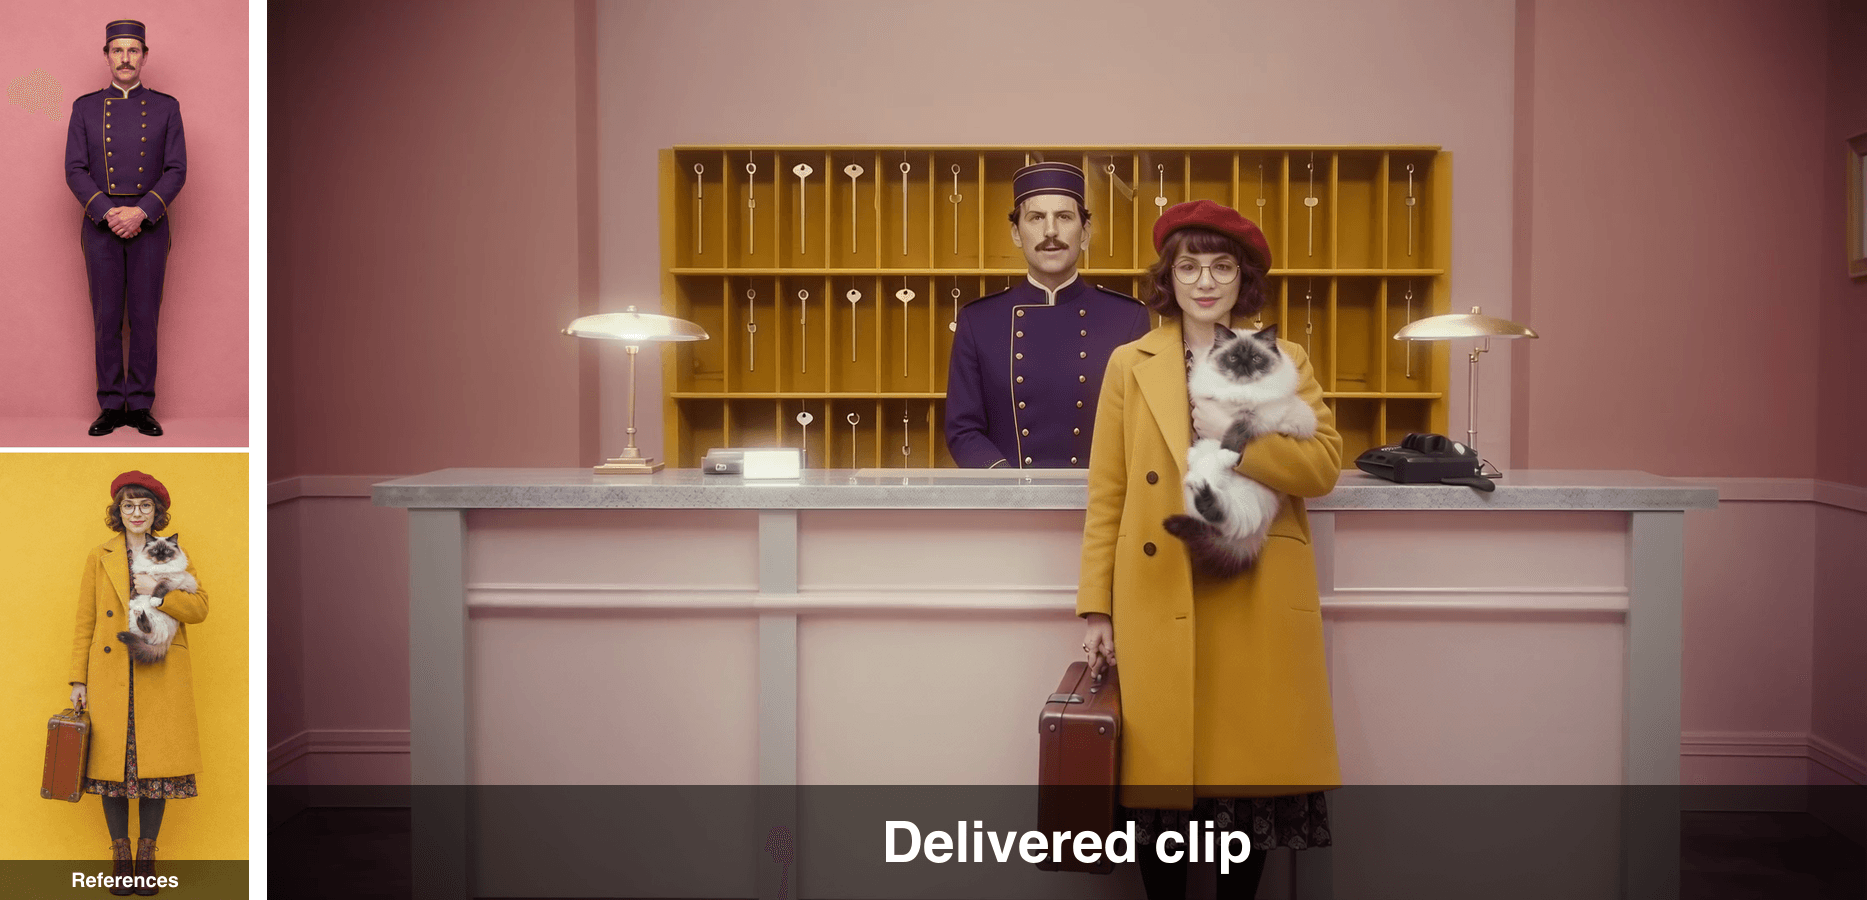
Dwa portrety referencyjne obok klatki z gotowego klipu, pokazujące te same twarze i stroje
Referencje po lewej, klatka z dostarczonego klipu po prawej. Galony munduru, beret, okulary i kot przetrwali podróż.
Wariacje na temat przepływu pracy multimodalnej referencji Wan 3.0
Zwiększ do 30 sekund. Ten sam pakiet referencyjny działa na Seedance 2.5 Referencja-do-Wideo z duration: 30, co daje długość obiecaną przez Wan 3.0 bez czekania na betę. Przyjmuje do 30 obrazów referencyjnych, 10 filmów i 10 klipów audio, więc pakiet ma miejsce na rozwój. Napisz dodatkowe 20 sekund jako beaty w prompcie, a nie jako nastroje, w przeciwnym razie model wypełni je czymś.
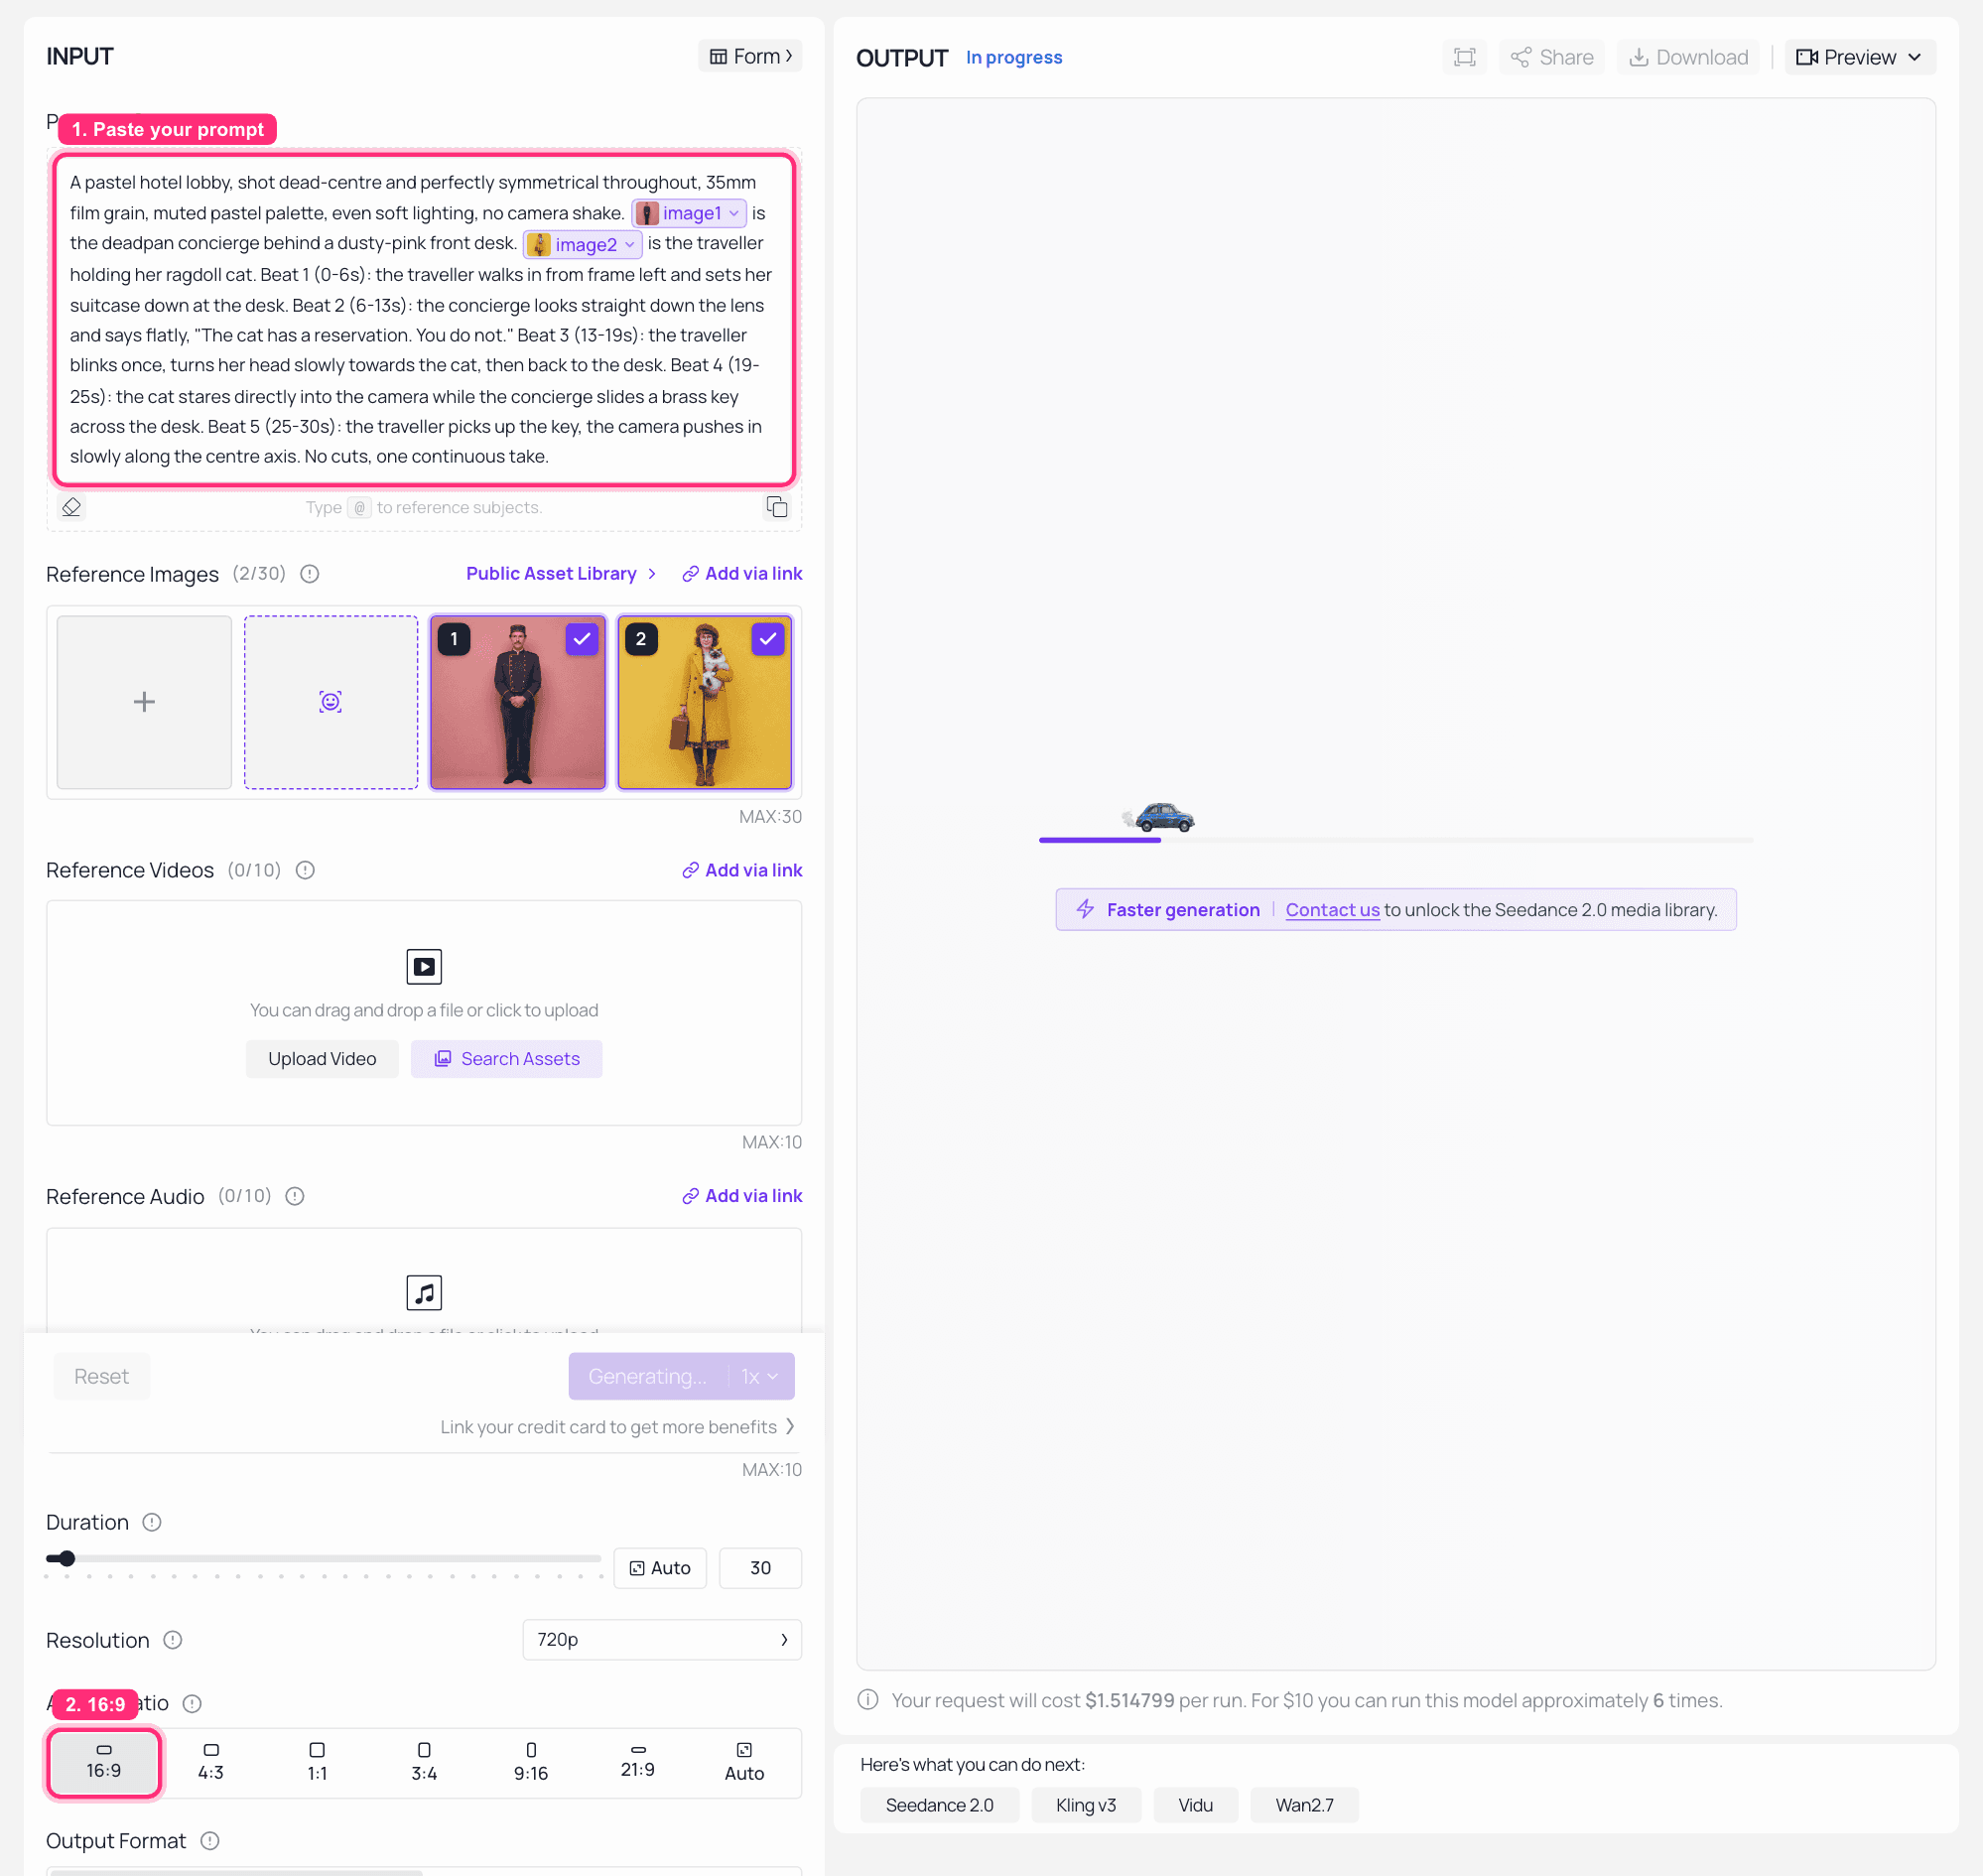
Plac zabaw Seedance 2.5 Referencja-do-Wideo na Atlas Cloud z czasem trwania ustawionym na 30 i wyrenderowanym długim ujęciem
Seedance 2.5 Referencja-do-Wideo na Atlas Cloud z czasem trwania ustawionym na 30 i tymi samymi dwoma portretami referencyjnymi dołączonymi, uchwycone w trakcie generowania. Zwróć uwagę na znaczniki @image1 i @image2 w prompcie: w ten sposób mówisz Seedance, która referencja odgrywa którą rolę. Sprawdź podaną cenę na przycisku Uruchom przed zatwierdzeniem, ponieważ odzwierciedla ona czas trwania, który zadanie faktycznie prześle.
30-sekundowa wersja tej samej sceny, ten sam pakiet referencyjny, beaty wypisane ujęcie po ujęciu.
Dodaj referencyjne wideo tylko dla ruchu. Dołącz klip, którego tempo ci się podoba, i powiedz to wyraźnie w prompcie, na przykład: "podążaj za referencyjnym wideo tylko dla rytmu cięcia, zignoruj jego podmioty i scenerię". To jest sztuczka stojąca za przykładem przewracania kart powyżej.
Napraw dryf za pomocą negatywnego promptu, zanim dotkniesz pozytywnego. Morfowanie twarzy, przesunięcie kolorów i drgania ręczne to trzy rzeczy, które psują ujęcia zablokowane referencją, a ich stłumienie jest zwykle tańsze niż opisanie ich w prompcie.
Wypróbuj format multimodalnej referencji za darmo
Jeśli chcesz poznać kształt tego narzędzia, zanim zagłębisz się w parametry, Atlas Cloud wypuścił w zeszłym tygodniu darmowy generator AI reklam skeczowych, który wykonuje ten sam łańcuch bez żadnych pokręteł.
Piszesz jedną linię o swoim produkcie i jego zaletach. On pisze dwupostaciowy scenariusz komediowy dla ciebie, haczyk, konflikt, zwrot akcji, a następnie renderuje 15-sekundowe wideo z mówionym dialogiem i wbudowanymi efektami dźwiękowymi. Możesz dołączyć do czterech prawdziwych zdjęć produktów jako referencje, a reklama zachowuje ich kształt, kolor, etykietę i logo od scenariusza do ostatniej klatki. Dostępnych jest sześć stylów, od zabawnych memów przez zwrot akcji i sitcom po luksus i twardą sprzedaż, a dialog wraca w języku, w którym napisałeś opis.
To jest ten sam łańcuch dwóch postaci plus obrazów referencyjnych plus głosu z samouczka, minus pisanie promptu i minus rachunek. Co czyni go przyzwoitym sposobem na sprawdzenie, czy ten format pasuje do twojego produktu, zanim wydasz pieniądze na jego dostrajanie.
Aby zorientować się, co stos referencyjnych nieruchomych obrazów robi z materiałem produktowym, oto własna wersja tego zadania w Wan 3.0: pięć obrazów na wejściu, jeden film startowy na wyjściu, każdy nieruchomy obraz kotwiczący jeden beat edycji.
Pięć nieruchomych obrazów referencyjnych rozszerzonych na film startowy produktu w stylu Material Design_Pięć obrazów referencyjnych napędzających dziewięciosekundowy film produktowy, każdy kotwiczący jeden beat i przekazujący pałeczkę następnemu. Źródło: Oficjalny podręcznik twórcy Wan 3.0 od Alibaby._
Ile kosztuje klip multimodalnej referencji Wan 3.0
| Krok | Model | Cena jednostkowa | Ilość | Koszt |
|---|---|---|---|---|
| 1 i 2, dwa obrazy referencyjne | GPT Image 2 | $0.009 za obraz | 2 | $0,02 |
| 3, referencja głosu | MiniMax Speech 2.6 HD | $0,08 za 1K znaków | 49 znaków | $0,00 |
| 4, 10-sekundowe ujęcie w 1080P | Wan 2.7 Referencja-do-Wideo | $0,15 za sekundę w 1080P | 10 s | $1,50 |
| Razem samouczek | około $1,52 | |||
| Wariacja, 30 sekund | Seedance 2.5 Referencja-do-Wideo | $0,134 za sekundę w 480P | 30 s | około $4,02 |
| Darmowa ścieżka | Darmowy generator AI reklam skeczowych | darmowy | 1 klip, 15 s | $0 |
Są to stawki samej platformy, sprawdzone w sierpniu 2026 roku i rozliczane z góry. Dwie rzeczy zmieniają całkowity koszt bardziej, niż ludzie się spodziewają. Rozdzielczość jest pierwsza: $0,10 za sekundę w tabeli porównawczej to stawka bazowa Wan 2.7, a 1080P jest rozliczane po $0,15, skąd bierze się $1,50 powyżej. Drugą rzeczą jest to, że Seedance wycenia według liczby pikseli, więc podane $0,134 za sekundę to wartość dla 480P, a ujęcie w 720P kosztuje więcej niż sugeruje proste pomnożenie. Dla porównania, zgłaszana stawka beta Wan 3.0 w wysokości $0,20 za sekundę w 1080P dałaby pełne 30-sekundowe ujęcie za około $6, co jest droższe niż dzisiejsza ścieżka Seedance w 480P.
Uwaga dotycząca korzystania z tego. Wan 3.0 to beta, a jego warunki mogą się zmieniać, więc przeczytaj je ponownie przed zbudowaniem na nim potoku. Jeśli twoje obrazy referencyjne przedstawiają prawdziwe osoby, uzyskaj ich zgodę, ponieważ referencja-do-wideo to właśnie ta funkcja, która sprawia, że jest to ważne. Przykładowe klipy w tym artykule są własnymi wygenerowanymi wynikami Alibaby z jej publicznego podręcznika twórcy, odtworzonymi tutaj w celach komentatorskich.
Często zadawane pytania
Ile referencji może faktycznie przyjąć multimodalna referencja Wan 3.0?
Do 20 zasobów w jednym wywołaniu, pochodzących z obrazów, filmów, audio, dokumentów i stron internetowych. Praktyczny limit jest niższy niż techniczny. Przypisz każdemu zasobowi dokładnie jedno zadanie, jeden podmiot na obraz, a dla większości scen użyjesz znacznie mniej niż 20.
Czy Wan 3.0 naprawdę może zamienić PDF lub stronę internetową w wideo?
Tak, to jest prawdziwie unikalna część. Oprócz tekstu, obrazu, audio i wideo akceptuje pliki dokumentów i aktywne URL-e, a raporty z bety wymieniają .doc, .xls, .ppt, .pdf i .txt. Żaden inny model referencja-do-wideo w powyższej tabeli porównawczej nie przyjmuje dokumentu.
Czy Wan 3.0 jest open source? Czy mogę go uruchomić w ComfyUI?
Nie i nie teraz. Wan 3.0 to zamknięta beta działająca na własnym chmurze Alibaby. Wcześniejsze generacje Wan były wydawane otwarcie, dlatego istnieje takie oczekiwanie, ale Alibaba nie potwierdziła wag dla 3.0. Strony twierdzące o wydaniu Wan 3.0 w wersji 1.3B lub 14B na Apache 2.0 nie są poparte niczym oficjalnym.
Czy Wan 3.0 jest dostępny przez API stron trzecich?
Jeszcze nie, w tym Atlas Cloud. Najbliższym, co możesz wywołać dzisiaj, jest Wan 2.7 Referencja-do-Wideo, którego kształt wejścia prawie dokładnie pasuje do omni-referencji, poza modalnościami dokumentów i stron internetowych, lub Seedance 2.5 Referencja-do-Wideo, jeśli potrzebujesz pełnych 30 sekund.
Jaki jest najtańszy sposób na przetestowanie wideo z dwiema postaciami i zablokowaną referencją?
Darmowy generator AI reklam skeczowych linkowany powyżej. Cztery zdjęcia referencyjne na wejściu, 15-sekundowy mówiony klip z dwiema postaciami na wyjściu, bez parametrów i bez wydatków. Jeśli utrzyma twój produkt i format, wtedy dostrój płatny łańcuch.
Dlaczego moje postacie wciąż dryfują, nawet z obrazami referencyjnymi?
Trzy przyczyny, w kolejności częstotliwości. Jedna referencja niesie dwa zadania, więc jest proszona o naprawienie zarówno twarzy, jak i lokalizacji. Obraz referencyjny zawiera więcej niż jedną osobę lub ruchome tło, więc model nie wie, którą część zablokować. Lub dryf jest artefaktem renderowania, a nie awarią referencji, w którym to przypadku umieść morfowanie twarzy, przesunięcie kolorów w negatywnym prompcie, zanim cokolwiek przepiszesz.


