แถบดาวน์โหลดแตะ 65 GB พัดลมเริ่มหมุน และคำถามจริงก็ตามมา: มันจะโหลดได้จริงหรือ? คำตอบสั้น ๆ สำหรับ ความต้องการหน่วยความจำของ GPT-OSS-120B คือประมาณ 61 GB สำหรับเวท บวกอีกไม่กี่ GB สำหรับพื้นที่ทำงาน ซึ่งเป็นเหตุผลที่ OpenAI วางตำแหน่ง它为โมเดลที่ใช้ GPU 80GB เพียงตัวเดียว
ด้านล่าง เราจะแยกตัวเลขนั้นออกเป็นส่วน ๆ แสดงฮาร์ดแวร์ที่รันมันได้พร้อมความเร็วที่วัดได้ และอธิบายเส้นทางแบบโฮสต์สำหรับเมื่อเครื่องของคุณไม่พอ
ประเด็นสำคัญ
- GPT-OSS-120B มาพร้อมเช็คพอยต์ MXFP4 ขนาด 60.8 GiB ซึ่งเป็นเหตุผลที่ OpenAI กำหนดเป้าหมายให้ใช้ GPU 80GB เพียงตัวเดียว
- ความยาวบริบทเพิ่มหน่วยความจำไม่มาก: แคช KV ใช้เพียงประมาณ 4.5 GiB ที่บริบทเต็ม 131K โทเคน
- หากมี VRAM น้อยกว่า 80GB llama.cpp สามารถออฟโหลดเลเยอร์ผู้เชี่ยวชาญไปยัง RAM ของระบบและยังรันได้
- Mac ที่มีหน่วยความจำมากกว่า 96GB และมินิพีซี 128GB สามารถเก็บโมเดลเต็มไว้ในเครื่องเดียวได้
- ไม่มีฮาร์ดแวร์ที่เหมาะ? เรียก Qwen3.5 122B A10B บน Atlas Cloud ผ่าน API ที่เข้ากันได้กับ OpenAI ตัวเดียว
ความต้องการหน่วยความจำของ GPT-OSS-120B: เวทบวกแคช KV
OpenAI เปิดตัว gpt-oss-120b เมื่อวันที่ 5 สิงหาคม 2025 ภายใต้สัญญาอนุญาต Apache 2.0 มันเป็นโมเดลแบบ mixture-of-experts ดังนั้นมีเพียง 5.1B จากพารามิเตอร์ 116.8B ที่ทำงานต่อโทเคนหนึ่งตัว ซึ่งช่วยเรื่องความเร็ว ไม่ใช่หน่วยความจำ: ผู้เชี่ยวชาญทุกตัวยังต้องอยู่ในหน่วยความจำเพื่อรอถูกเลือก
เทคนิคที่ทำให้มันเล็กคือ MXFP4 ตาม การ์ดโมเดล gpt-oss เวทของผู้เชี่ยวชาญ ซึ่งคิดเป็นกว่า 90% ของพารามิเตอร์ ถูกจัดเก็บที่ 4.25 บิตต่อค่า สำเนาแบบ 16 บิตของโมเดลเดียวกันจะต้องใช้พื้นที่ประมาณสี่เท่า
| ข้อมูลจำเพาะ | GPT-OSS-120B |
|---|---|
| พารามิเตอร์ทั้งหมด | 116.8B |
| พารามิเตอร์ที่ใช้งานต่อโทเคน | 5.1B |
| เลเยอร์และผู้เชี่ยวชาญ | 36 เลเยอร์, 128 ผู้เชี่ยวชาญ, ใช้งาน 4 ตัวต่อโทเคน |
| รูปแบบเวท | MXFP4 สำหรับเลเยอร์ผู้เชี่ยวชาญ, BF16 สำหรับส่วนที่เหลือ |
| ขนาดเช็คพอยต์ | 60.8 GiB |
| หน้าต่างบริบท | 131,072 โทเคน |
หน้าต่างบริบทเปลี่ยนหน่วยความจำของ GPT-OSS-120B อย่างไร
ทุกโทเคนทิ้งคีย์และค่าไว้ในแต่ละเลเยอร์ความสนใจ ที่เก็บนั้นคือแคช KV และเมื่อทุกเลเยอร์สนใจบริบทเต็ม มันจะโตตามความยาวบริบท
GPT-OSS-120B หลบเลี่ยงส่วนใหญ่ได้ ครึ่งหนึ่งของ 36 เลเยอร์ใช้ sliding window ที่มองย้อนกลับเพียง 128 โทเคน และแต่ละเลเยอร์เก็บเพียง 8 KV head ขนาด 64 มิติ มีเพียง 18 เลเยอร์ที่เก็บบริบททั้งหมด เราคำนวณแคช KV จากคอนฟิกของโมเดล และมันตรงกับยอดรวมที่วัดได้ใน คู่มือ gpt-oss ของ llama.cpp
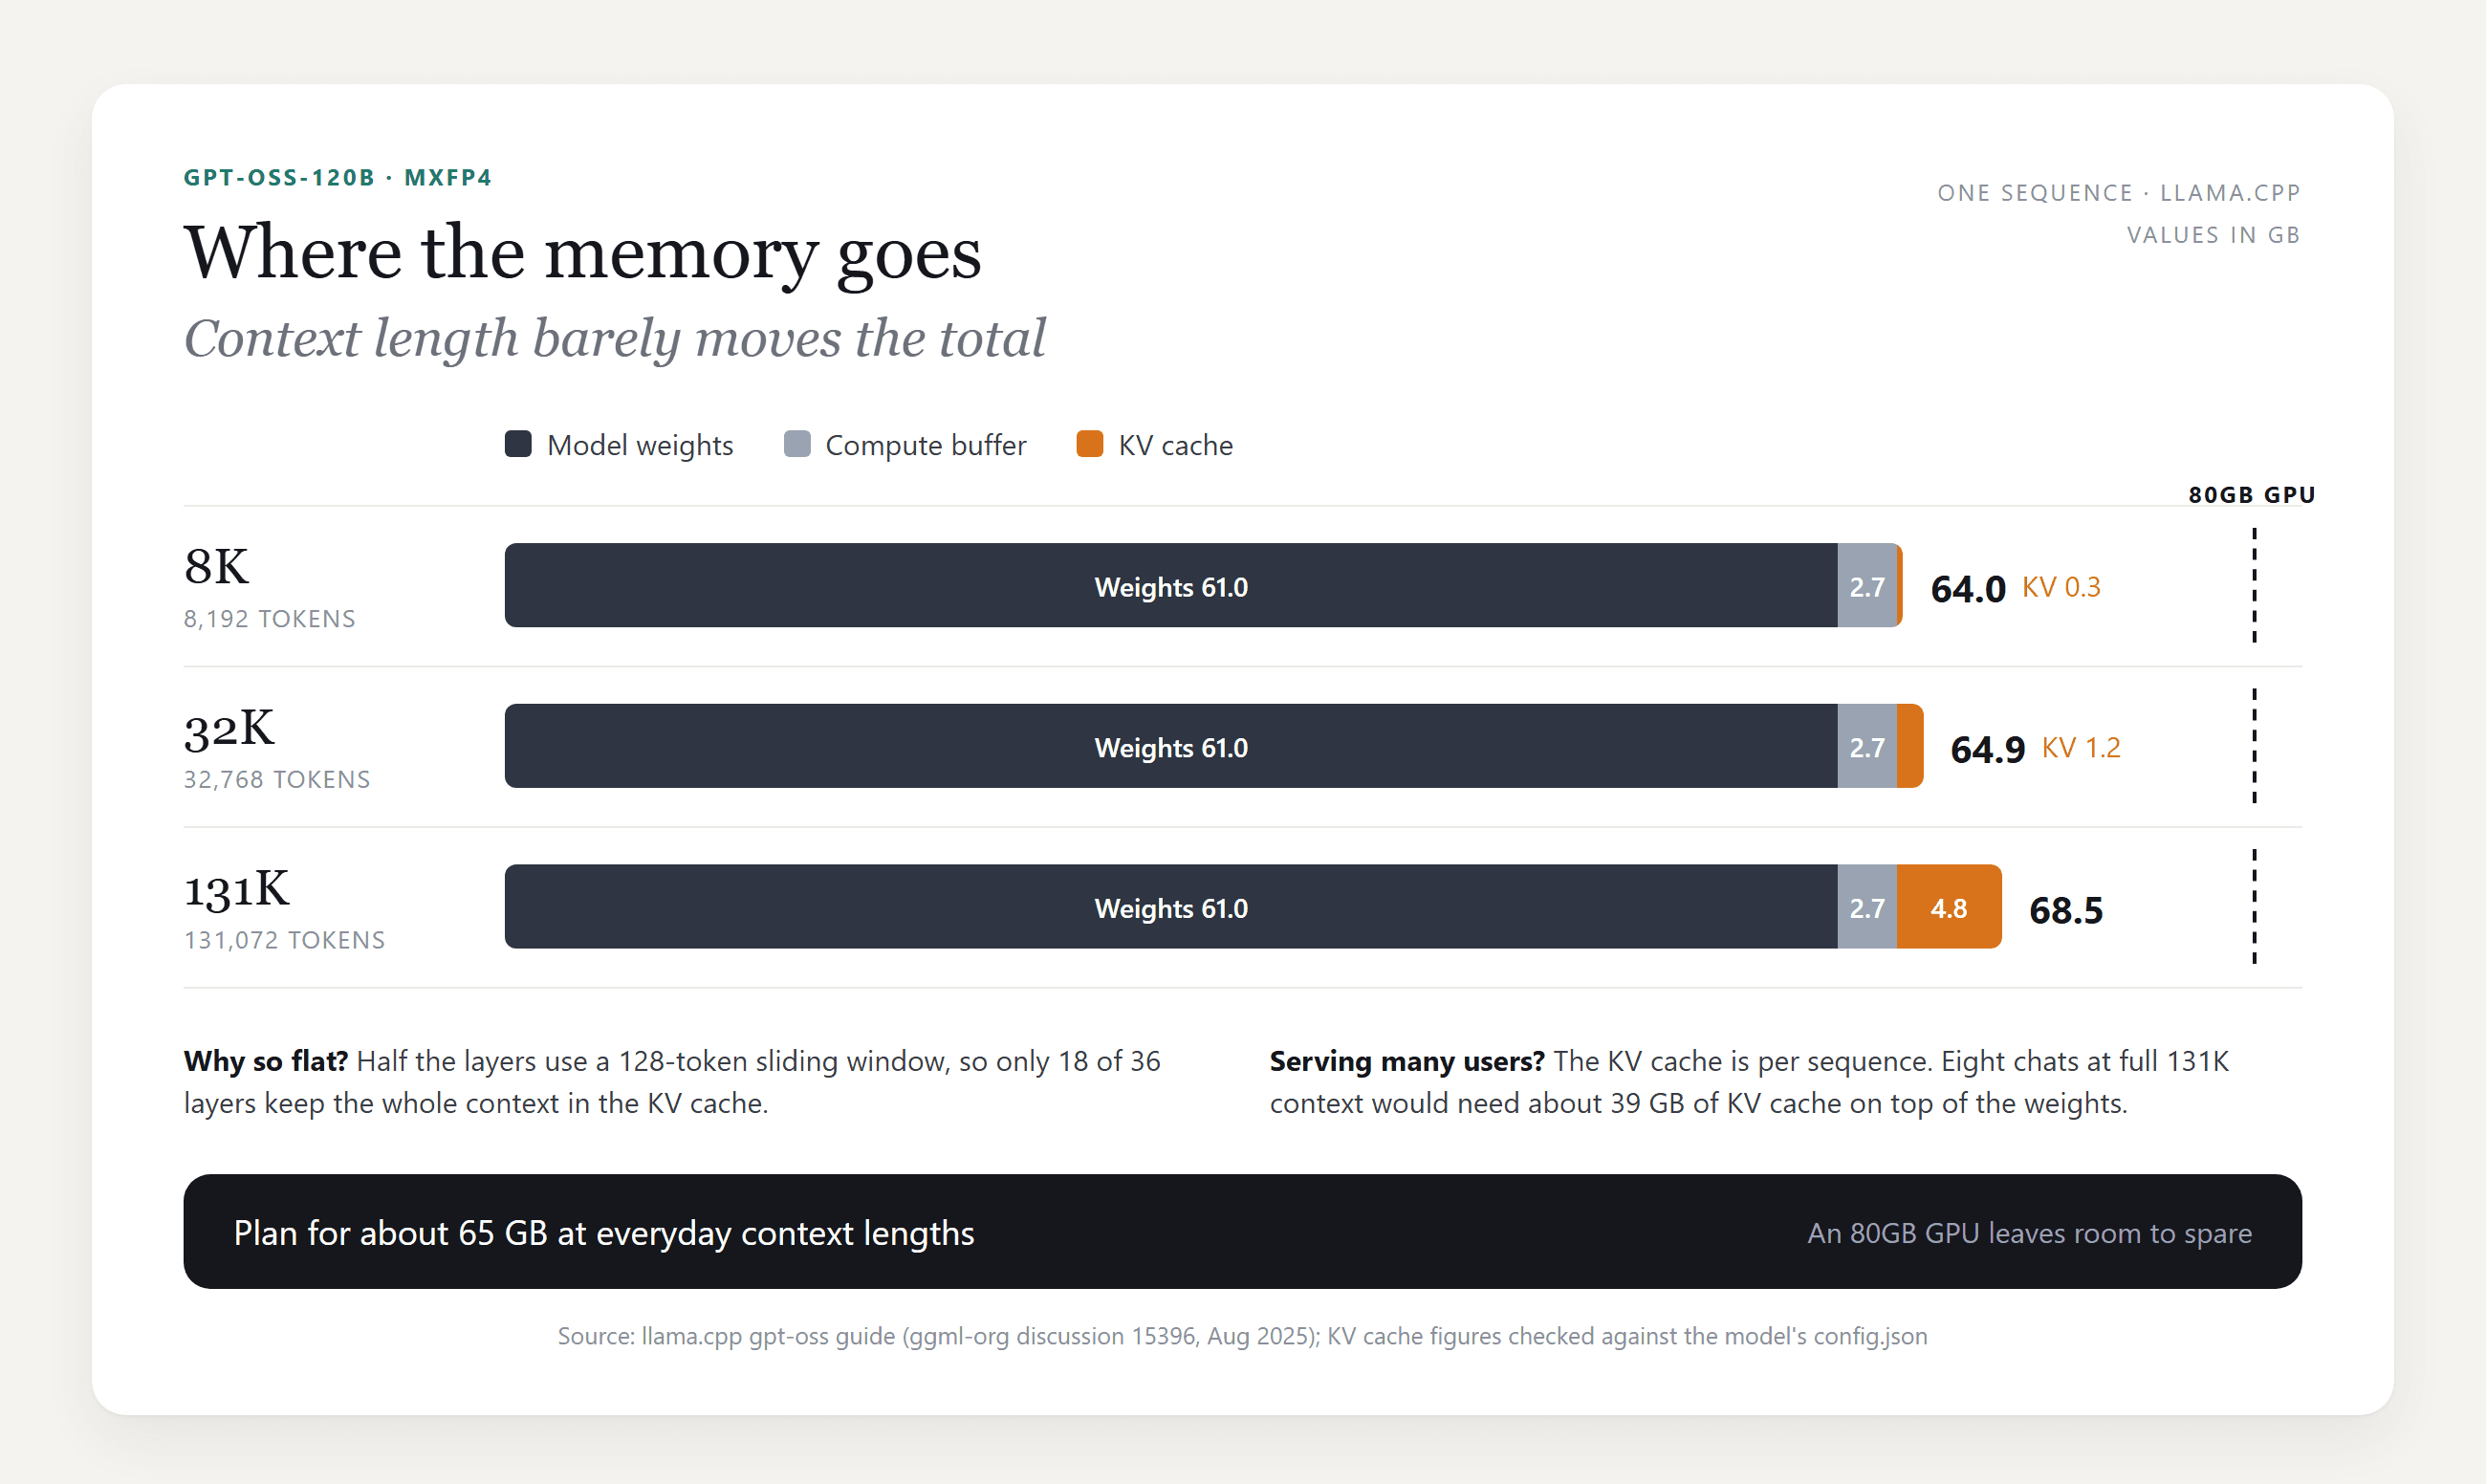
การไปจาก 8K ถึง 131K เต็มใช้หน่วยความจำเพิ่มไม่ถึง 5 GB จุดที่มันเพิ่มขึ้นจริง ๆ คือการทำงานพร้อมกัน: แคช KV คิดตามบทสนทนา ดังนั้นเซิร์ฟเวอร์ที่ถือแชตความยาวเต็มแปดรายการต้องใช้เพิ่มประมาณ 39 GB เหนือเวทขึ้นไป
ฉันสามารถรัน GPT-OSS-120B ในเครื่องได้หรือไม่? ข้อกำหนดฮาร์ดแวร์ตามการตั้งค่า
ได้ หากคุณมีพื้นที่เร็ว ๆ ประมาณ 65 GB ให้วางไว้: GPU ตัวใหญ่หนึ่งตัว, GPU บวก RAM ของระบบ หรือเครื่องที่มีหน่วยความจำแบบรวม
ข้อกำหนด GPU สำหรับ GPT-OSS-120B
กรณีที่ง่ายที่สุดคือการ์ดดาต้าเซ็นเตอร์ 80GB หนึ่งใบ สูตร vLLM สำหรับ gpt-oss กล่าวว่าโมเดล 120b "จะพอดีบน A100 ใบเดียว (80GB)" และการแยกมันไปยัง GPU หลายตัวช่วยเพิ่มอัตราการประมวลผล
ต่ำกว่า 80GB คู่มือ llama.cpp มีทางออก แฟล็ก --n-cpu-moe เก็บเลเยอร์ผู้เชี่ยวชาญบางส่วนไว้ใน RAM ของระบบ และเก็บส่วนที่เหลือบน GPU คู่มือระบุขั้นต่ำที่ VRAM ประมาณ 8GB ตราบใดที่หน่วยความจำ GPU และระบบรวมกันยังเก็บโมเดลได้
| การตั้งค่า | ที่เก็บเวท | ความเร็วในการสร้างที่รายงาน |
|---|---|---|
| RTX Pro 6000, 96GB | ทั้งหมดบน GPU | 196 โทเคน/วินาที (คู่มือ llama.cpp) |
| A100 หรือ H100, 80GB | ทั้งหมดบน GPU | พอดีบนการ์ดใบเดียว (สูตร vLLM) |
| RTX 5090, 32GB, บวก RAM ของระบบ | เก็บเลเยอร์ผู้เชี่ยวชาญ 21 ชั้นใน RAM ของระบบ | ประมาณ 30 โทเคน/วินาทีที่บริบทศูนย์ (คู่มือ llama.cpp) |
กับดักหนึ่งบน Windows จากคู่มือเดียวกัน: ไดรเวอร์อาจเงียบ ๆ เทออกไปยัง RAM ของระบบเมื่อ VRAM หมด ดังนั้นโมเดลจะโหลดได้แล้วจากนั้นก็คลานช้า ให้ดู GPU Memory ใน Task Manager และเพิ่มจำนวนออฟโหลดจนกว่าจะอยู่ใต้ขนาดการ์ดของคุณ
การรัน GPT-OSS-120B บน Mac หรือมินิพีซี 128GB
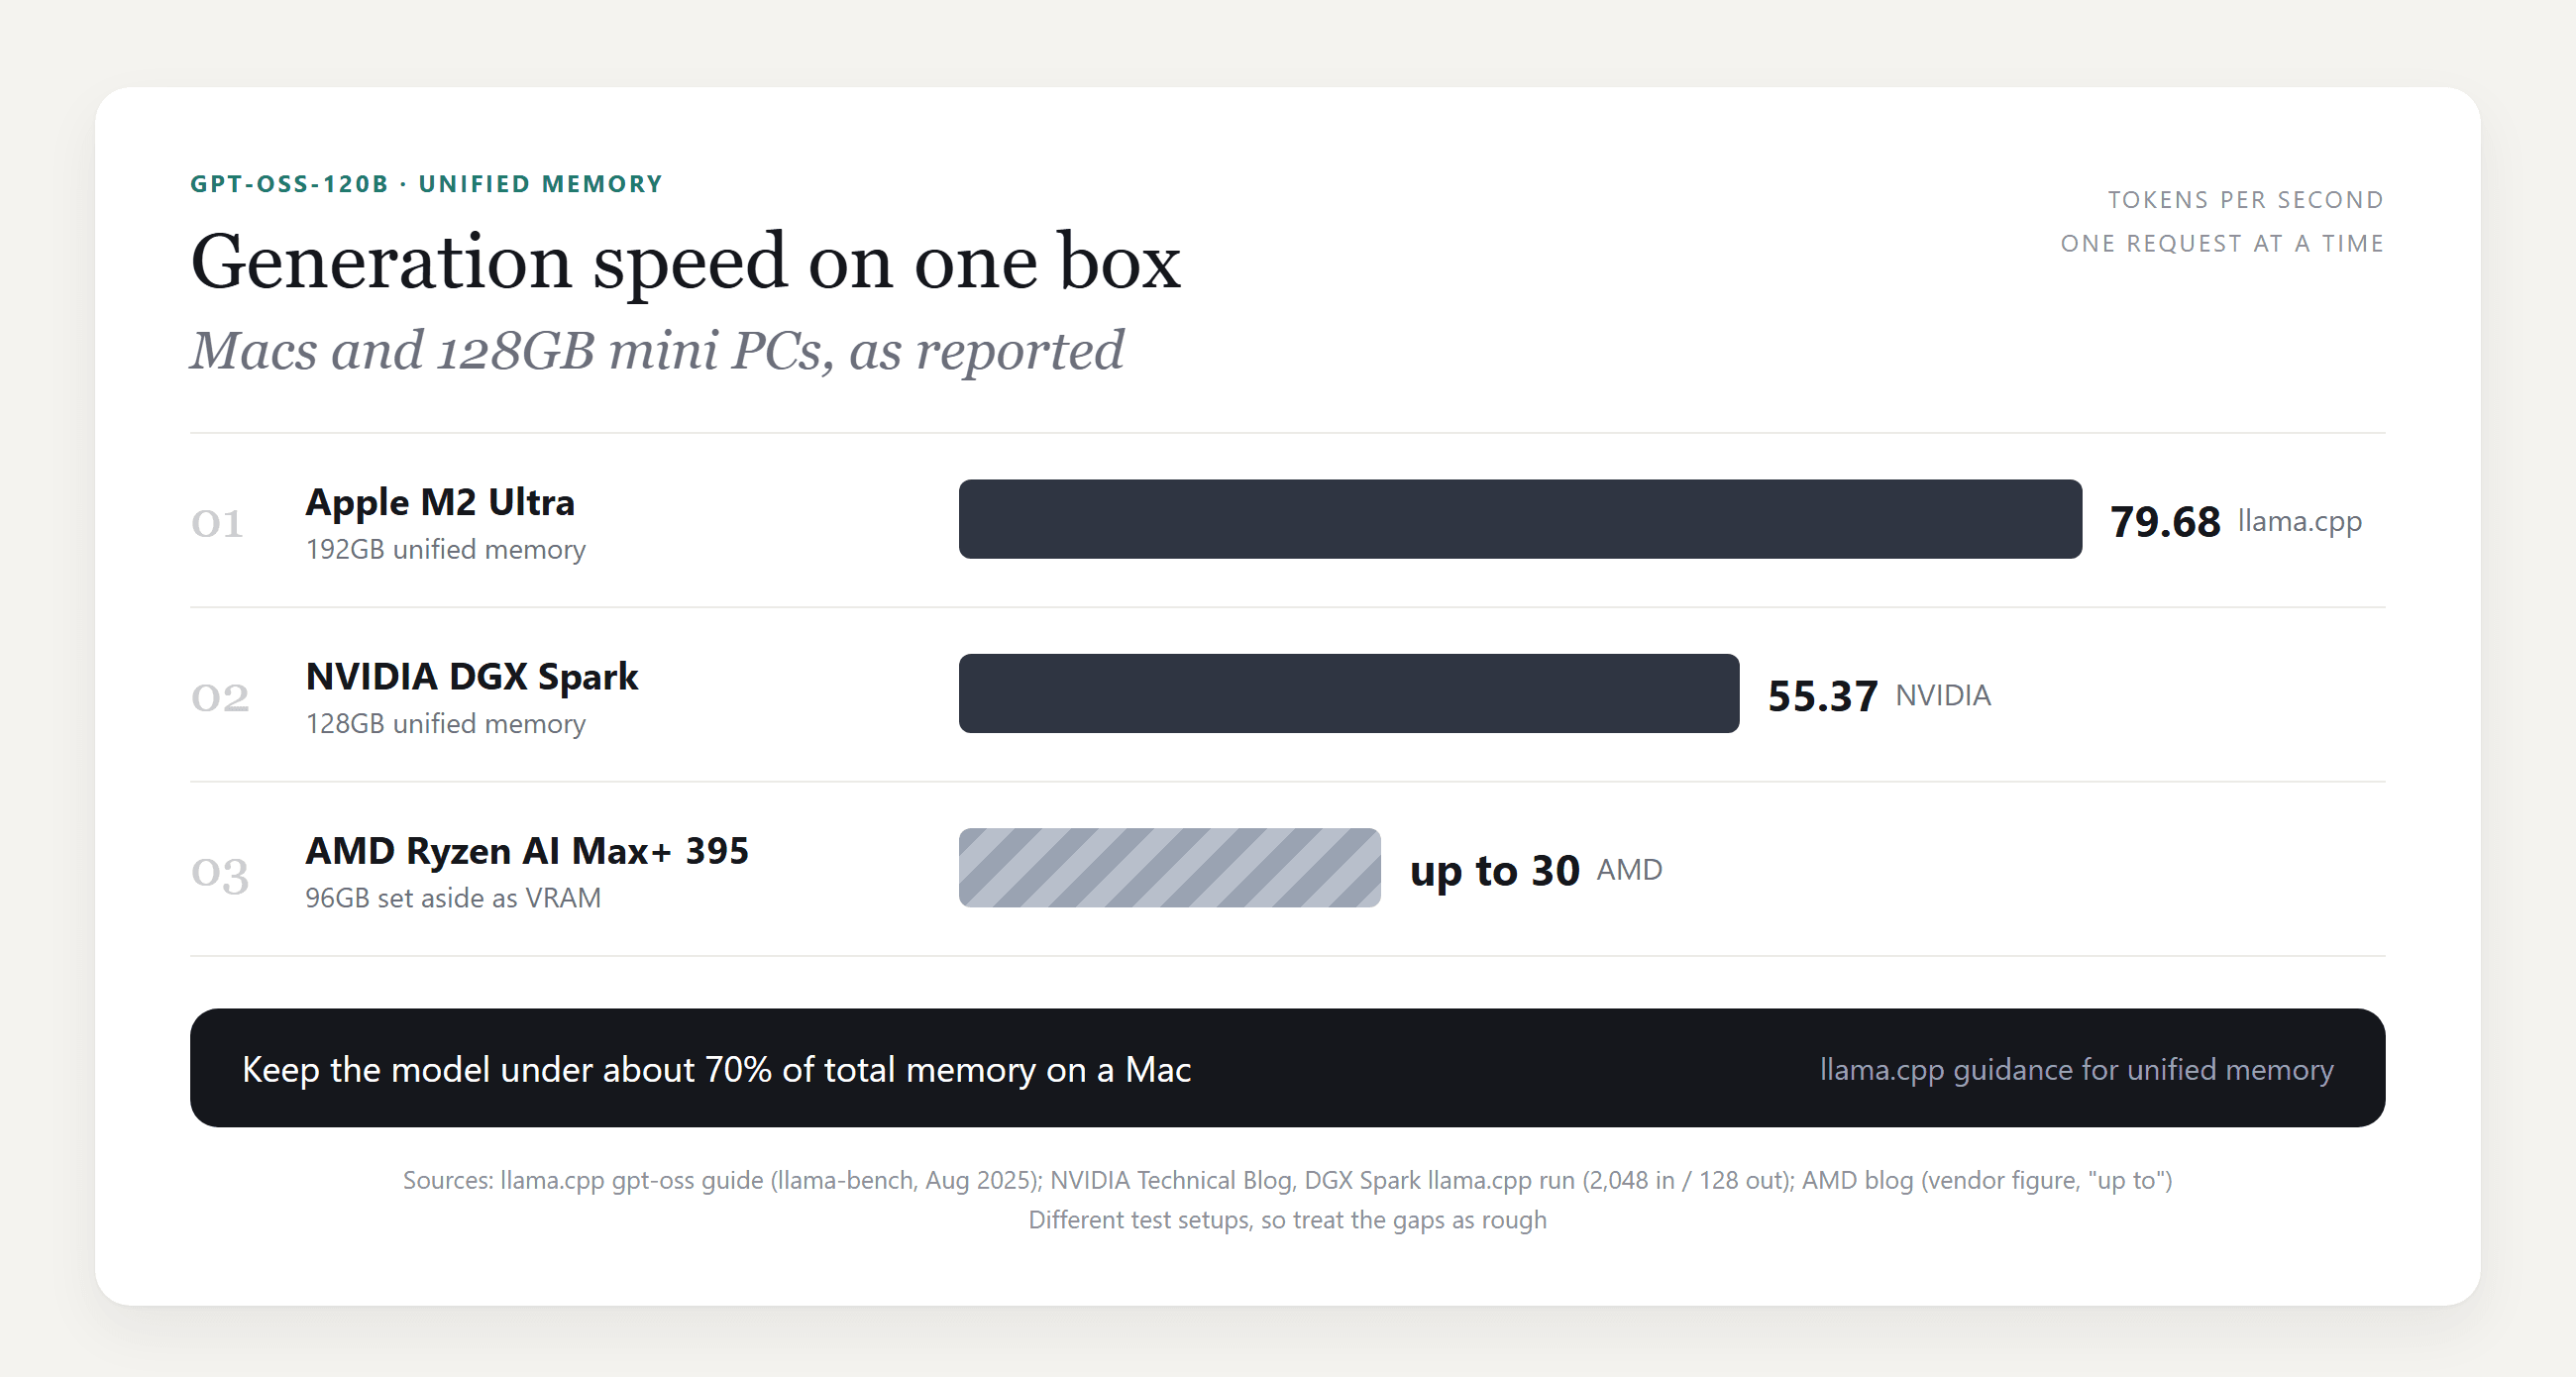
หน่วยความจำแบบรวมขจัดข้อจำกัดการแยก GPU กับ RAM คู่มือ llama.cpp กล่าวว่า Mac ที่มี RAM มากกว่า 96GB เช่นเครื่อง M2 Ultra หรือ M3 Max สามารถรันโมเดลที่บริบทเต็มได้ และแนะนำให้อยู่ในระดับต่ำกว่าประมาณ 70% ของหน่วยความจำทั้งหมด
macOS จำกัดปริมาณหน่วยความจำที่ GPU สามารถกำหนดเป็น wired ได้ตามค่าเริ่มต้น บนเครื่อง 192GB คู่มือเพิ่มขีดจำกัดนั้นจาก 154GB เป็น 180GB ด้วยคำสั่งเดียว:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
มินิพีซี 128GB รุ่นใหม่จัดอยู่ในระดับเดียวกัน NVIDIA รายงาน 55.37 โทเคน/วินาทีสำหรับ gpt-oss-120b บน DGX Spark ที่รัน llama.cpp AMD กล่าวว่าเครื่อง Ryzen AI Max+ 395 ที่กัน 96GB ไว้เป็น VRAM ทำได้ "สูงสุด 30 โทเคนต่อวินาที" ซึ่งเป็นตัวเลขของบริษัทเอง
หน่วยความจำไม่พอ? ใช้โมเดล open-weight แบบโฮสต์ผ่าน API
หากไม่มีเครื่องใดในนั้นอยู่บนโต๊ะของคุณ โมเดล open-weight แบบโฮสต์จะข้ามคำถามเรื่องฮาร์ดแวร์ไปเลย
Atlas Cloud ให้บริการ Qwen3.5 122B A10B ซึ่งเป็นส่วนหนึ่งของ กลุ่มโมเดล Qwen ในทางทฤษฎีมันใกล้เคียงกับ gpt-oss-120b มาก: โมเดล mixture-of-experts ภายใต้ Apache 2.0 จากทีม Qwen ของ Alibaba โดยมีพารามิเตอร์รวม 122B และพารามิเตอร์ที่ใช้งาน 10B อ่านบริบทได้สูงสุด 262,144 โทเคน
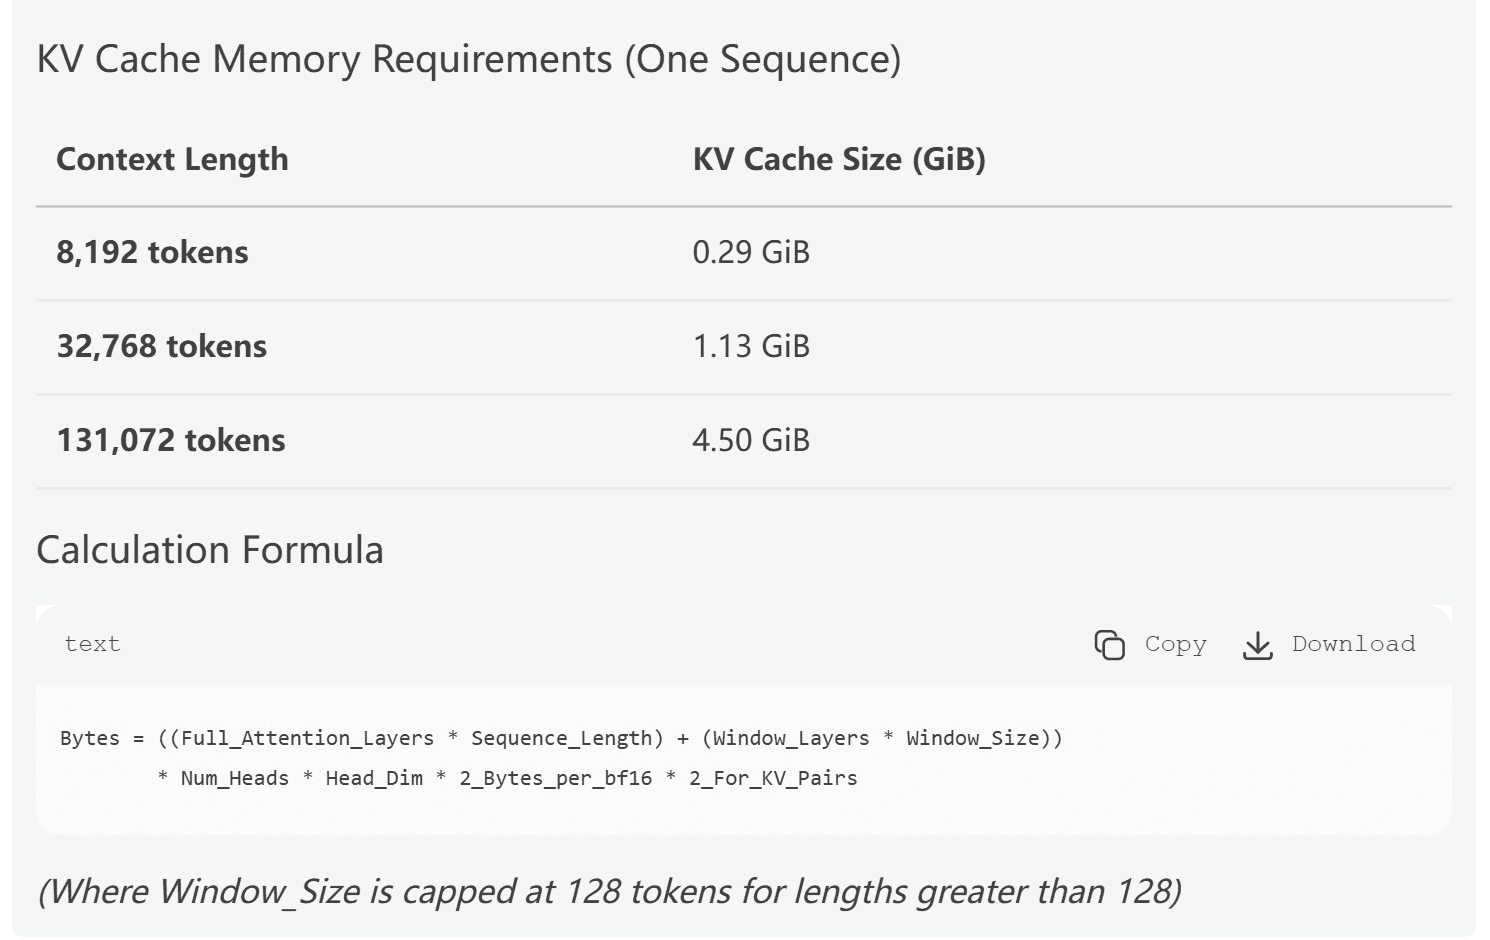
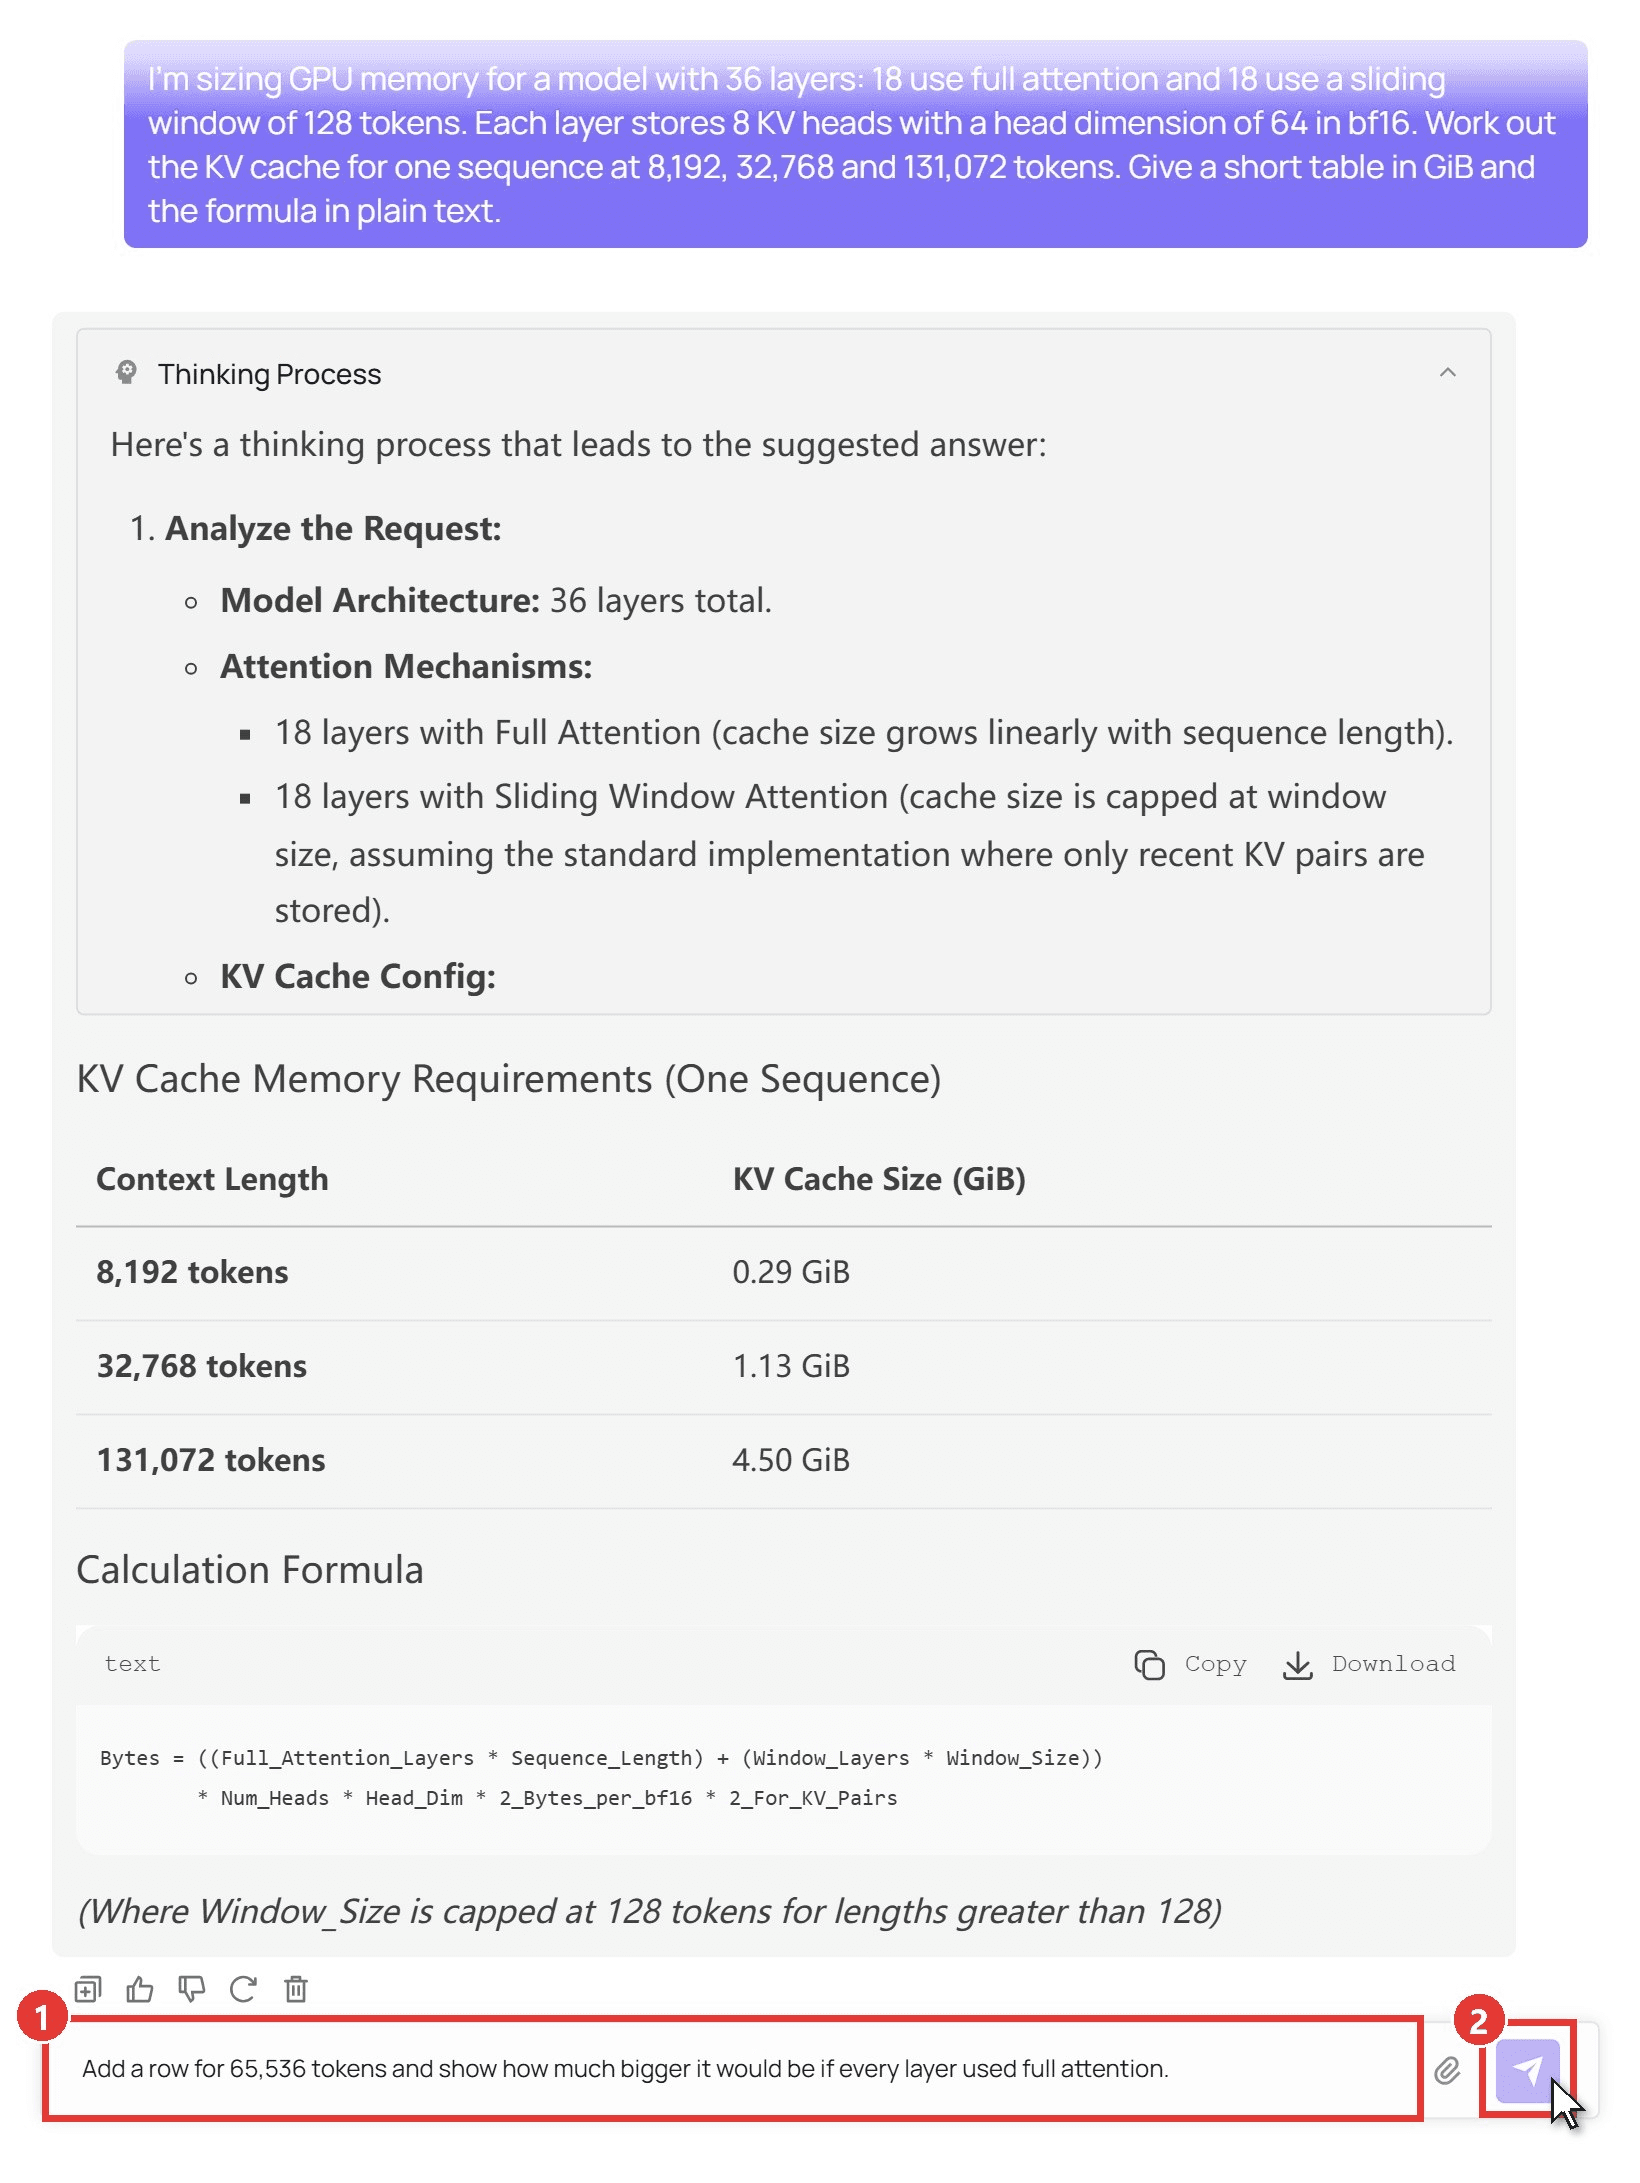
เราให้เลย์เอาต์ความสนใจจากคอนฟิก gpt-oss แก่มัน และถามหาแคช KV ที่สามความยาว ตารางของมันตรงกับการคำนวณของเราถึงทศนิยมสองตำแหน่ง หากภายหลังคุณต้องการ Qwen สำหรับเครื่องของคุณเอง คู่มือของเราเกี่ยวกับ โมเดล Qwen ที่ดีที่สุดสำหรับการเขียนโค้ดในเครื่อง จะช่วยประเมินขนาดตาม RAM
วิธีที่ 1: ลอง Qwen3.5 122B A10B ใน Playground
ลงชื่อเข้าใช้และเปิด playground ของ Qwen3.5 122B A10B จากนั้น:
- พิมพ์คำถามของคุณในกล่องข้อความ
- คลิกลูกศรส่ง ผลการคิดวิเคราะห์จะปรากฏในแผง Thinking Process เหนือคำตอบ
วิธีที่ 2: เรียก Qwen3.5 122B A10B ด้วย Atlas Cloud API
สำหรับสคริปต์และแอป:
ขั้นตอนที่ 1: สร้างคีย์ API เปิด Settings ในคอนโซล ไปที่ API Keys แล้วคลิก Create API Key เก็บมันไว้ฝั่งเซิร์ฟเวอร์
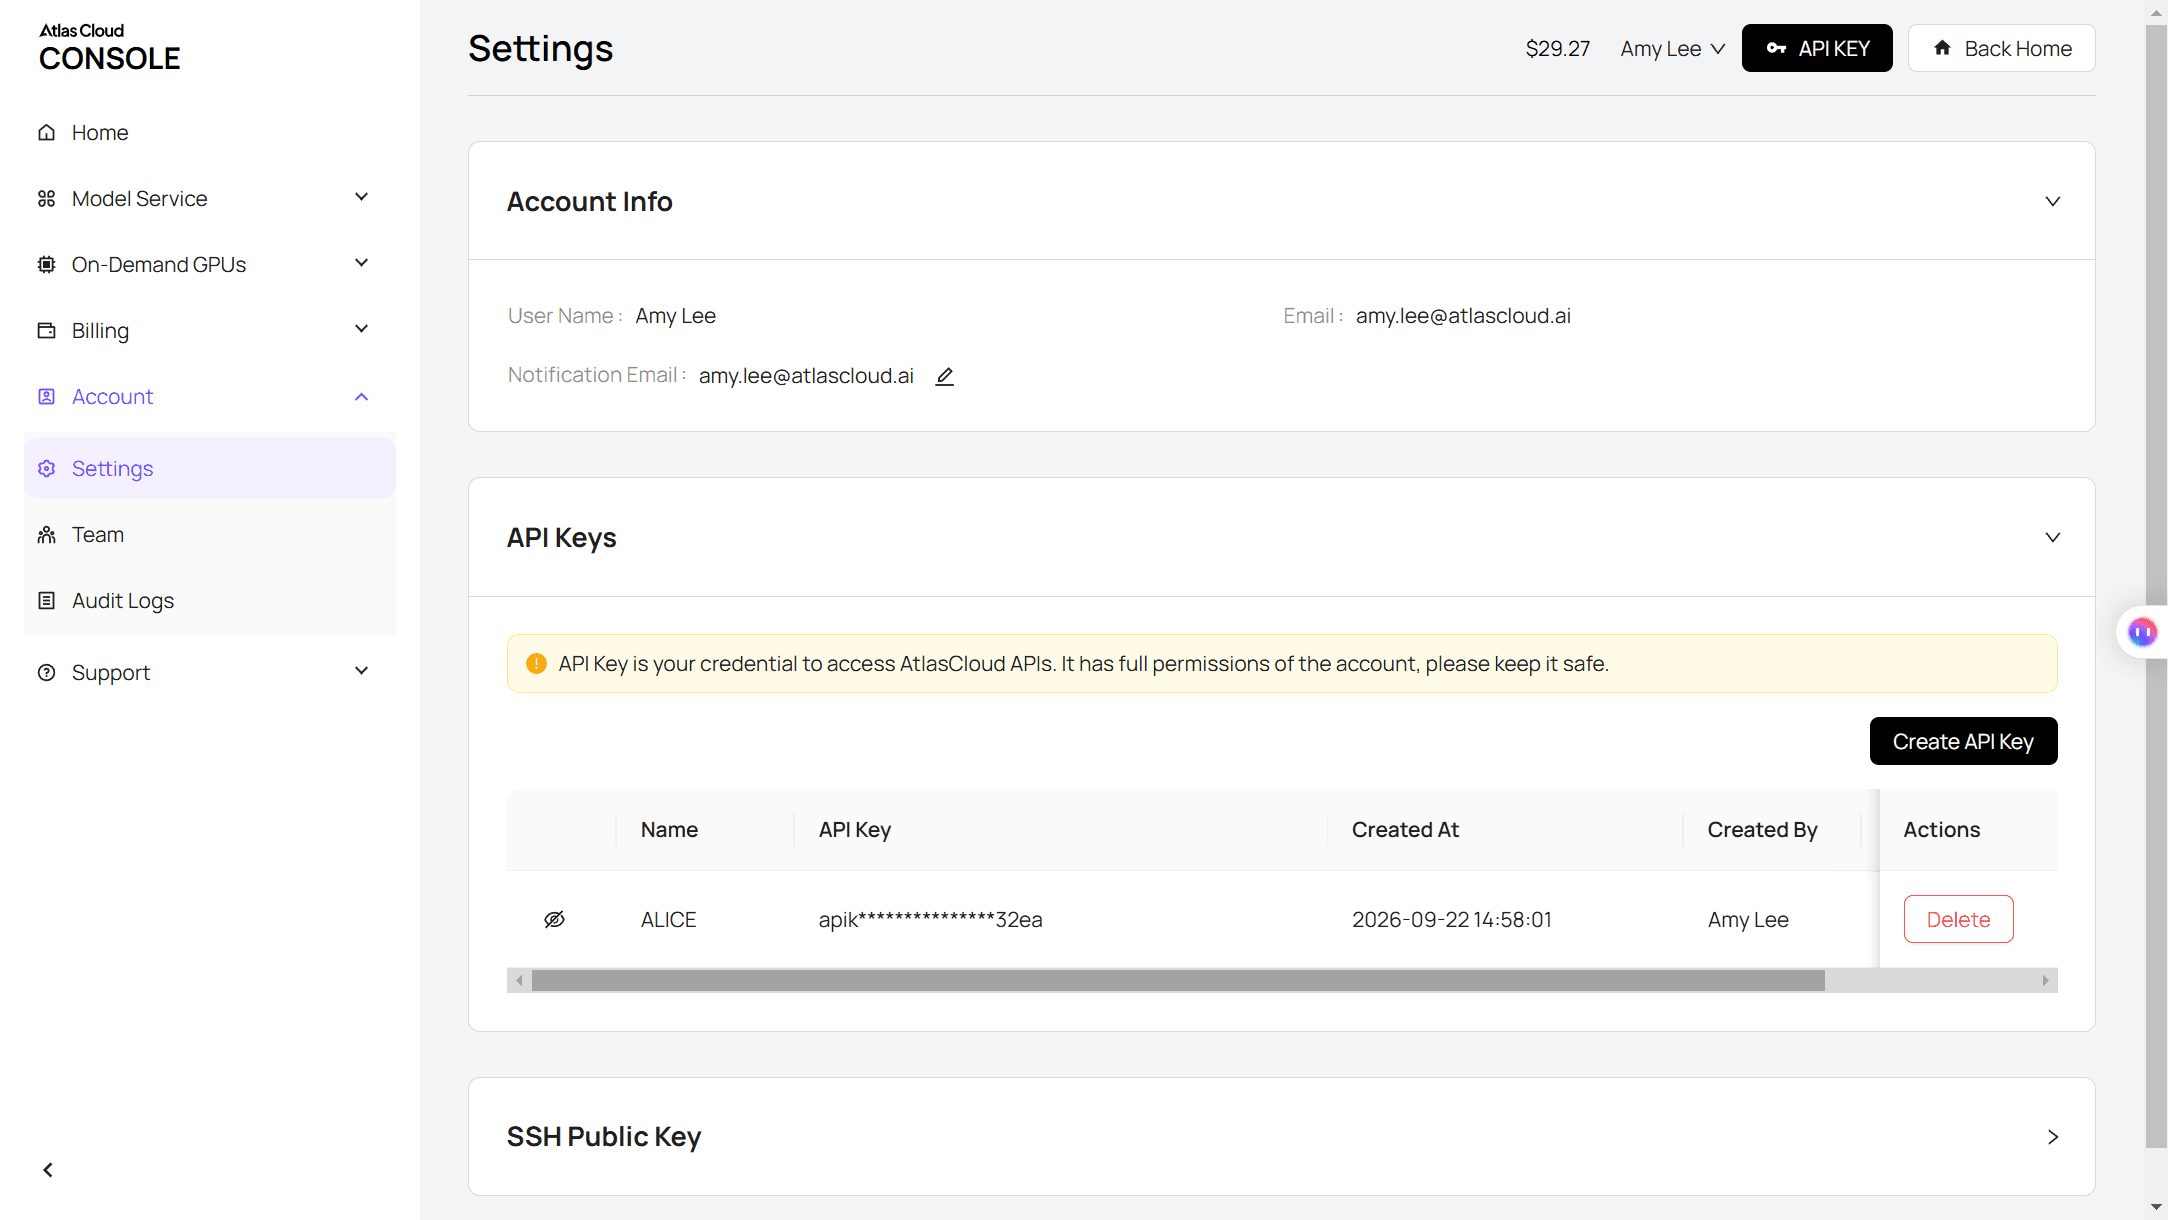
ขั้นตอนที่ 2: ตรวจสอบรูปแบบคำขอ เอกสาร API ครอบคลุมรูปแบบ chat completions และหน้าโมเดลมีแท็บ API พร้อมตัวอย่างสำเร็จรูป
ขั้นตอนที่ 3: ส่งคำขอแรกของคุณ
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
คำตอบจะกลับมาใน choices[0].message.content เนื่องจาก endpoint เป็นไปตามรูปแบบ OpenAI โค้ดที่เขียนสำหรับเซิร์ฟเวอร์ gpt-oss ในเครื่องมักต้องเปลี่ยนเพียง base URL, คีย์ และสตริงโมเดลเท่านั้น คีย์เดียวกันยังใช้ได้กับโมเดลแชตอื่น ๆ บนแพลตฟอร์ม ตามที่บทความของเราเกี่ยวกับ เกตเวย์ API LLM แบบรวม อธิบายไว้
GPT-OSS-120B vs GPT-OSS-20B: การแลกเปลี่ยนระหว่างหน่วยความจำและเบนช์มาร์ก
รุ่นน้องที่เล็กกว่าต้องใช้หน่วยความจำเพียงหนึ่งในห้า gpt-oss-20b มีพารามิเตอร์ 20.9B โดยใช้งาน 3.6B และ OpenAI กล่าวว่ามันรันได้บน "หน่วยความจำเพียง 16GB" คำถามคือคุณต้องแลกอะไรไป
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | หน่วยความจำที่บริบท 8K (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (ไม่ใช้เครื่องมือ) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (ไม่ใช้เครื่องมือ) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
คะแนนมาจากการ์ดโมเดลที่ความพยายามในการคิดวิเคราะห์สูง ช่องว่างด้านการเขียนโค้ดต่ำกว่าสองคะแนนใน SWE-Bench Verified ขณะที่ช่องว่างด้านความรู้อยู่ที่ประมาณ 9 คะแนนในวิทยาศาสตร์ระดับบัณฑิตศึกษา และ 15 คะแนนใน HealthBench สำหรับงานเขียนโค้ดเป็นหลักบนการ์ด 16GB ถึง 24GB การเลือก 20b ถือว่าสมเหตุสมผล ต้องการความรู้เพิ่มหรือไม่? นั่นคือจุดที่ 120b คุ้มกับค่าใช้จ่ายหน่วยความจำ
GGUF, Ollama หรือ vLLM: เลือก Runtime ให้เหมาะกับงบหน่วยความจำ
แต่ละตัวรันเวท MXFP4 ที่ OpenAI เผยแพร่ ต่างกันที่ว่าเวทเหล่านั้นอยู่ที่ไหนได้
| Runtime | ดาวน์โหลด | เหมาะที่สุด |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | ผู้ใช้หนึ่งคนบนเครื่องที่เก็บโมเดลทั้งหมดไว้ได้ |
| LM Studio | 65 GB | แอปเดสก์ท็อปบน Mac หรือพีซี Windows |
| llama.cpp (ggml-org GGUF) | ประมาณ 63 GB | มี VRAM น้อยกว่า 65 GB โดยออฟโหลดเลเยอร์ผู้เชี่ยวชาญไปยัง RAM |
| vLLM | ประมาณ 65 GB ของ safetensors | ให้บริการผู้ใช้หลายคนจาก GPU ดาต้าเซ็นเตอร์หนึ่งตัวหรือมากกว่า |
สำหรับการเริ่มต้นอย่างรวดเร็วบนเครื่องที่มีหน่วยความจำมาก:
plaintext1ollama run gpt-oss:120b
สำหรับ GPU ที่เล็กกว่า ให้ใช้ llama.cpp และปรับจำนวนออฟโหลด:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
ทั้งสี่ตัวรองรับรูปแบบแชต harmony ของ OpenAI ซึ่งโมเดลจำเป็นต้องใช้เพื่อทำงานได้อย่างถูกต้อง เรื่องนี้สำคัญเฉพาะเมื่อคุณเขียนโค้ดสำหรับให้บริการเอง
คำถามที่พบบ่อย
GPT-OSS-120B ดีกว่า GPT-5 หรือ Gemini 3 Pro หรือไม่?
พวกมันอยู่คนละหมวดหมู่: GPT-5 และ Gemini เป็นโมเดลปิดที่คุณเข้าถึงผ่านแอปหรือ API ส่วน gpt-oss-120b รันบนฮาร์ดแวร์ของคุณเอง นอกจากนี้ Gemini 3 Pro Preview ถูกปิดให้บริการเมื่อวันที่ 9 มีนาคม 2026 และชื่อของมันตอนนี้ชี้ไปที่ Gemini 3.1 Pro Preview หากการควบคุมในเครื่องสำคัญ สาย open-weight ของ Google คือตระกูล Gemma 4
ทำไมบางเว็บไซต์บอกว่า GPT-OSS-120B ต้องใช้ 255 GB?
ตัวเลขเหล่านั้นสมมติว่าใช้เวท 16 บิต: พารามิเตอร์ประมาณ 117B คูณ 2 ไบต์ บวกโอเวอร์เฮด เช็คพอยต์ที่ OpenAI เผยแพร่เป็น MXFP4 อยู่แล้ว ดังนั้นการดาวน์โหลดจริงจะอยู่ในช่วง 61 GB
ความพยายามในการคิดวิเคราะห์เปลี่ยนการใช้หน่วยความจำหรือไม่?
ไม่เปลี่ยนสำหรับเวท การตั้งค่า low, medium และ high เปลี่ยนระยะเวลาที่โมเดลใช้คิด ความพยายามสูงจะเขียนโทเคนการคิดวิเคราะห์มากขึ้น ซึ่งเติมหน้าต่างบริบทและทำให้แคช KV โต ดังนั้นเซสชันยาว ๆ จะค่อย ๆ ขยับไปใกล้ยอดรวมที่มากขึ้นในแผนภูมิด้านบน
ทำไมผู้คนถึงบอกว่า GPT-OSS-120B ทำงานกับเกมที่ใช้ข้อความเป็นหลักได้ยาก?
หลักฐานเป็นเพียงคำบอกเล่า บนหน้าการสนทนาของโมเดลบน Hugging Face ผู้ใช้บางคนรายงานว่าถูกปฏิเสธเมื่อเขียนนิยายรุนแรง ขณะที่คนอื่นบอกว่าการเล่นบทบาทสมมติทำงานได้ดี สำหรับนิยายแบบโต้ตอบ ให้ทดสอบพรอมป์ของคุณเองก่อนซื้อฮาร์ดแวร์เพื่อสิ่งนั้น
โมเดลคลาส 120B แบบโฮสต์มีค่าใช้จ่ายเท่าไร?
ณ ตุลาคม 2026 Qwen3.5 122B A10B มีค่าใช้จ่าย $0.3 ต่อโทเคนอินพุตหนึ่งล้านโทเคน และ $2.4 ต่อโทเคนเอาต์พุตหนึ่งล้านโทเคนบน Atlas Cloud นั่นคือส่วนลด 25% จากราคาปกติ $0.4 และ $3.2 คำถามเรื่องการประเมินขนาดของเราใช้โทเคนเอาต์พุตประมาณ 5,000 โทเคนเมื่อนับการคิดวิเคราะห์แล้ว คิดเป็นประมาณหนึ่งเซนต์ที่ราคาลดแล้ว
บทสรุป
GPT-OSS-120B จุได้ง่ายกว่าที่จำนวนพารามิเตอร์บอกไว้ วางแผนใช้ประมาณ 65 GB ที่ความยาวบริบทในชีวิตประจำวัน และต่ำกว่า 70 GB ที่ 131K เต็ม GPU 80GB หนึ่งตัว, Mac ที่มีหน่วยความจำมากกว่า 96GB หรือมินิพีซี 128GB จะเก็บมันได้ และการ์ดที่เล็กกว่าสามารถรันได้โดยย้ายเลเยอร์ผู้เชี่ยวชาญเข้าไปใน RAM ของระบบ
หากตัวเลขเหล่านั้นตัดเครื่องของคุณออก ให้ลดไปใช้ gpt-oss-20b สำหรับงานเขียนโค้ดเป็นหลัก หรือเรียกโมเดล open-weight แบบโฮสต์เมื่อคุณต้องการสมองที่ใหญ่ขึ้นโดยไม่ต้องซื้อฮาร์ดแวร์ ไม่ว่าจะทางไหน ความต้องการหน่วยความจำของ gpt oss 120b จะไม่ใช่การเดาอีกต่อไปเมื่อคุณรู้ว่าเวทใช้ 61 GB และที่เหลือคือพื้นที่เผื่อ


