


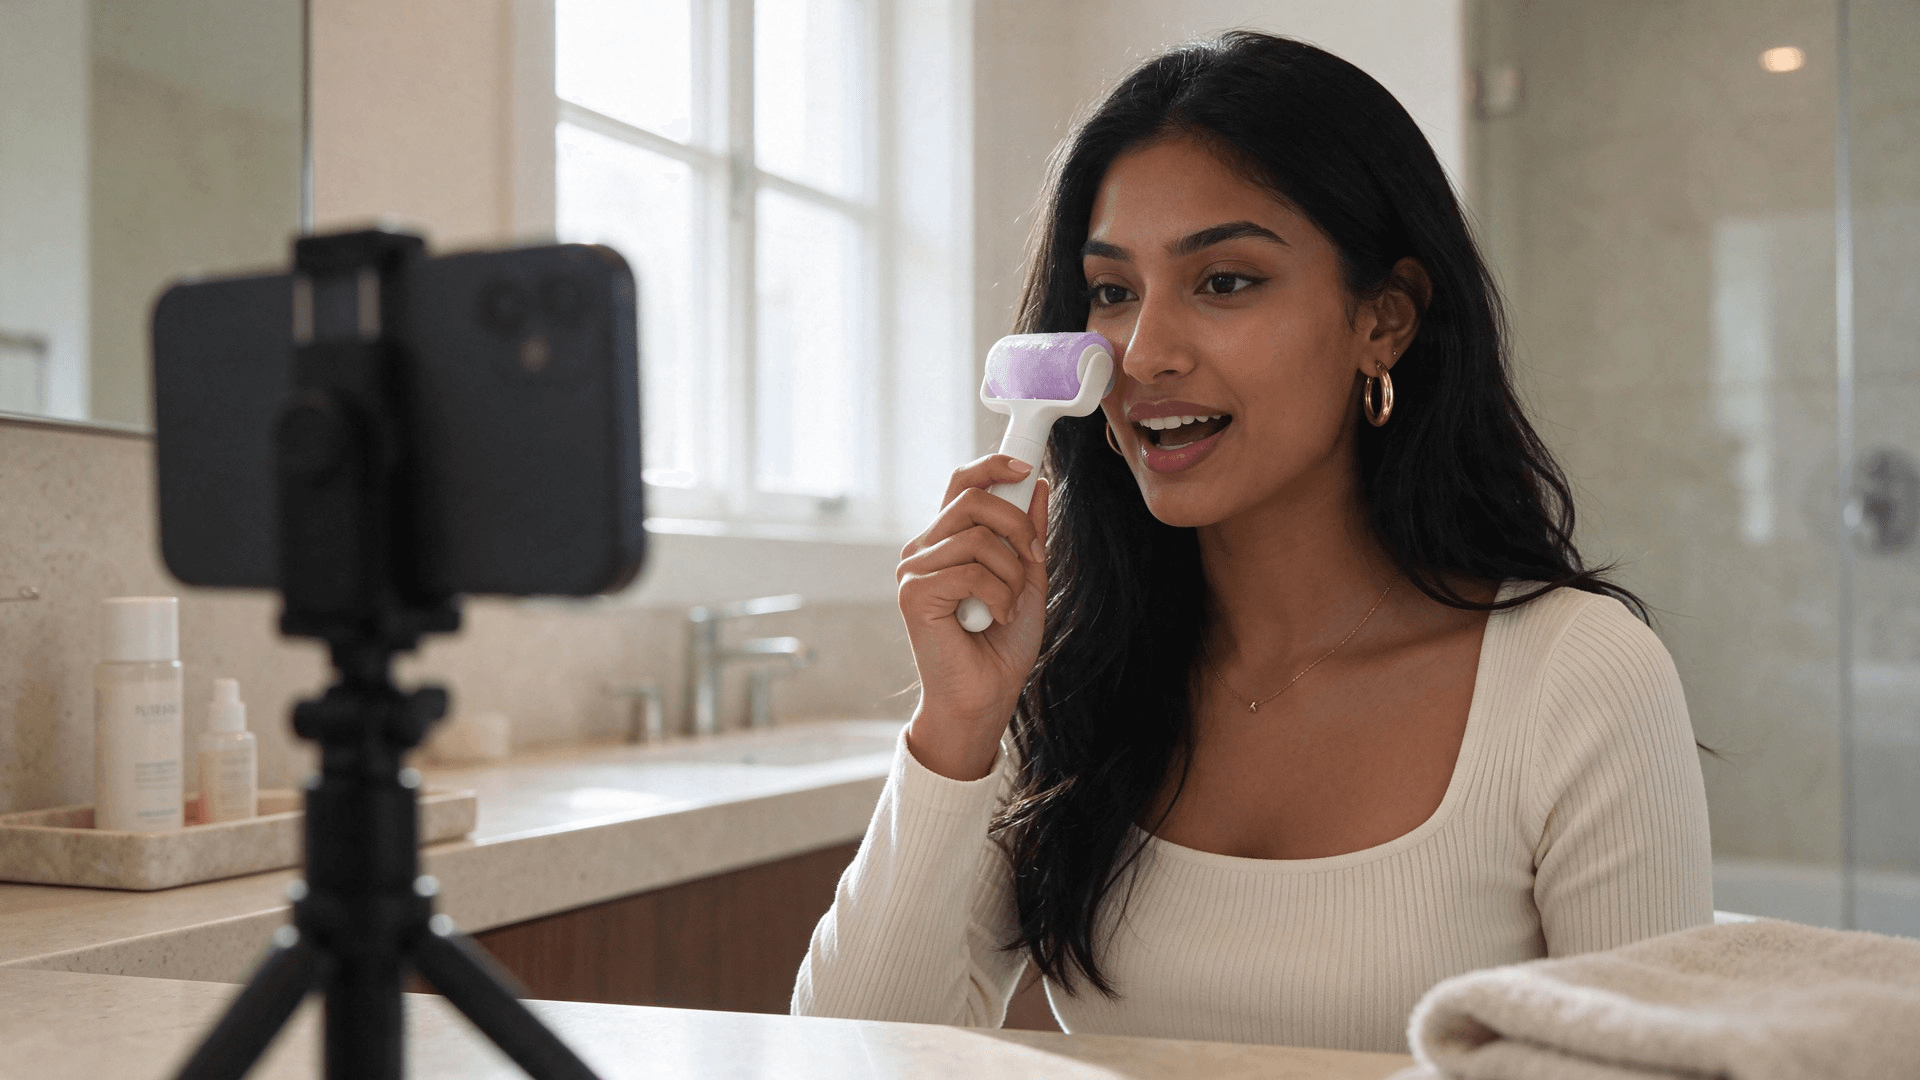
Il clip si apre su una donna davanti alla sua postazione da bagno. Fa scivolare un rullo ghiacciato opaco lungo lo zigomo e si lamenta di una call alle 7 del mattino presa con quattro ore di sonno. Nessuno ha puntato una telecamera su di lei. Il video è nato da un ritratto, una foto del prodotto e una traccia vocale di otto secondi.
Questa guida spiega come creare un AI influencer come lei per i video di brand: un volto che puoi riutilizzare in qualsiasi scena, hook presi in prestito da video già diventati virali e un clip parlante che puoi rigenerare ogni volta che cambia il copione. L'abbiamo costruito mentre scrivevamo l'articolo, così ogni passaggio mostra gli input e gli output reali.
Punti Chiave
- Un AI influencer è un unico volto coerente che riutilizzi nei video, costruito a partire da una singola foto di riferimento.
- Parti da hook TikTok già collaudati: analizza un video virale prima di scrivere una singola riga di copione.
- Seedance 2.5 trasforma un ritratto, uno scatto del prodotto e una traccia vocale in un video parlante con lip-sync.
- Scrivi tre righe di hook, esegui ciascuna come clip, poi tieni quella i cui primi tre secondi funzionano.
- Etichetta i presentatori creati con l'AI su TikTok e usa solo un volto reale per cui hai il permesso.
Cos'è un AI Influencer e Chi lo Crea
Un AI influencer è una persona generata che appare davanti alla telecamera ancora e ancora con lo stesso volto, voce e stile. La parte "ancora e ancora" è tutto il lavoro. Un singolo fotogramma di bell'aspetto è facile. Un presentatore che sembra la stessa donna in cucina il lunedì e in auto il venerdì è ciò che le persone cercano davvero.
Due gruppi li creano, e vogliono cose diverse:
| Account persona | Presentatore di brand | |
|---|---|---|
| Obiettivo | Far crescere i follower come persona virtuale | Presentare video di prodotto e annunci |
| Cosa deve restare fisso | Volto, personalità, storia personale | Volto, voce, stile di delivery |
| Output tipico | Post giornalieri, storie, live | Hook e demo da 10 a 30 secondi |
| Metrica di successo | Dimensione del pubblico | Tempo di visione e clic sul prodotto |
Questa guida copre la seconda colonna. Se sei nuovo al formato stesso, la nostra spiegazione su cos'è l'AI UGC copre prima le basi.
Trasforma una Foto in un AI Influencer Parlante su Atlas Cloud
Ecco il clip finito prima di qualsiasi teoria: dieci secondi, verticale, con la sua voce, un primo piano del rullo in azione e il prodotto sollevato alla fine.
È stato realizzato su Atlas Cloud con Seedance 2.5 Reference-to-Video. Come generatore di AI influencer, parte dai tuoi input: tu porti il volto, il prodotto e la voce, e lui costruisce l'inquadratura intorno a essi.
Accetta fino a 30 immagini di riferimento in una sola richiesta, incluse foto di persone reali, e una singola traccia audio può guidare da sola il lip sync.
Questo conta per un presentatore di brand. Il volto resta tuo in ogni video, e quando cambia il copione sostituisci un file audio invece di prenotare un nuovo shooting.
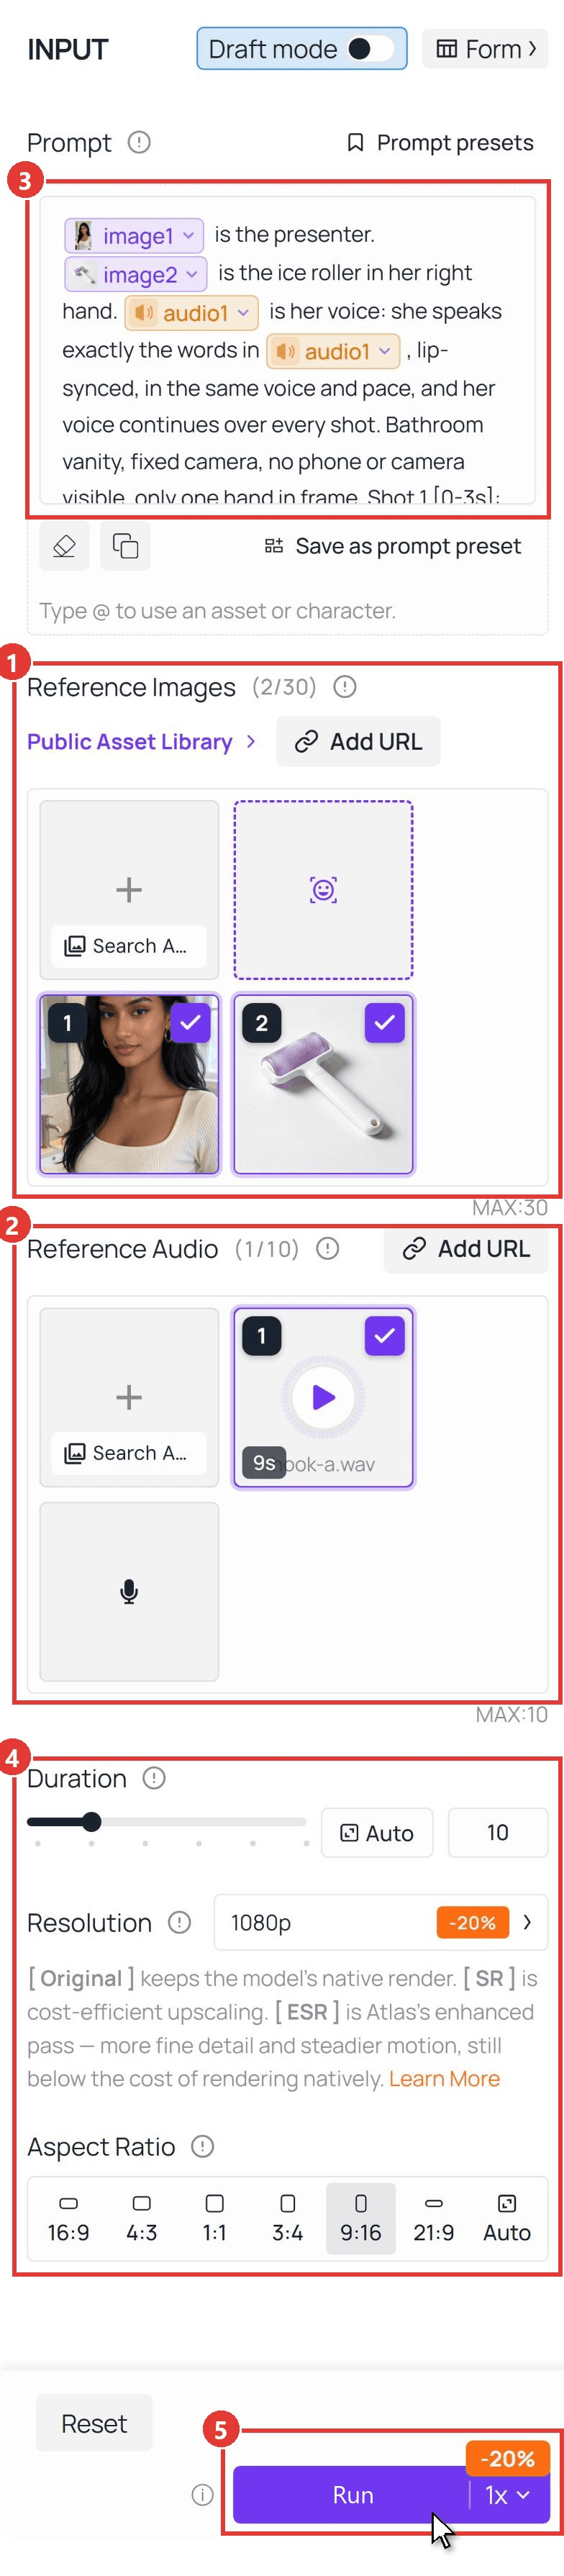
L'intera esecuzione avviene su una pagina del playground Seedance 2.5 Reference-to-Video:
- Carica prima il ritratto, poi la foto del prodotto, sotto Reference Images. L'ordine conta: il primo file diventa Image1.
- Carica la traccia vocale sotto Reference Audio.
- Incolla il prompt, poi ridigita ogni menzione @ e seleziona il file corrispondente dalla lista così diventa un tag.
- Imposta Duration su 10, Resolution su 1080p e Aspect Ratio su 9:16.
- Clicca Run.
Come Creare un AI Influencer in 5 Passaggi
Il playground è l'ultimo clic. Ciò che decide se il video ferma lo scroll è tutto ciò che gli dai in pasto, quindi ecco come creare un AI influencer dalla ricerca all'hook finito.
Passaggio 1: Analizza gli Hook TikTok da un Video Virale Reale
Non partire da un copione vuoto. Scegli uno short nella tua nicchia che ha già ottenuto visualizzazioni e smontalo.
Abbiamo usato una routine di 19 secondi dal canale All You Can Face, One Routine For A Puffy Face, Puffy Eyelids And Puffy Under Eyes. Invece di guardarlo dieci volte, abbiamo passato il link a Gemini 3.5 Flash tramite l'API di Atlas Cloud. Un link YouTube pubblico funziona direttamente come input video:
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
Ecco cosa è tornato indietro, condensato:
| Cosa abbiamo chiesto | Cosa fa il video |
|---|---|
| Riga di apertura | "Fai questo 20 volte se ti svegli con la faccia gonfia." |
| Tipo di hook | Punto dolente formulato come istruzione diretta |
| Struttura | Quattro inquadrature, una per problema, ciascuna che apre con la stessa struttura di frase |
| Testo a schermo | Una checklist che aggiunge una voce per inquadratura |
| Inquadratura | Dal petto in su, occhi sull'obiettivo per tutto il tempo |
| Schema riutilizzabile | [Azione] per [quantità] se ti svegli con [problema] |
Una lista di hook TikTok ti dà le prime righe. La parte utile di un'analisi è la struttura sotto la riga: una struttura di frase ripetuta, una ricompensa visibile per inquadratura, nessuna introduzione. È ciò che abbiamo portato nel copione.
Passaggio 2: Blocca un Volto e Riutilizzalo nelle Scene
Il tuo influencer è reale per gli spettatori solo se sembra la stessa persona ogni volta. Parti da un ritratto che hai il diritto di usare, poi cambia tutto tranne il volto: outfit, stanza, luce.
Qualsiasi modello di immagini che modifica da un riferimento può farlo. Abbiamo usato Seedream su Atlas Cloud: il modello 5.5 Edit per trasformare un ritratto in studio in un master shot da postazione da bagno, e l'editor sequenziale 5.0 Lite per generare altre tre scene da quel master in una sola richiesta.
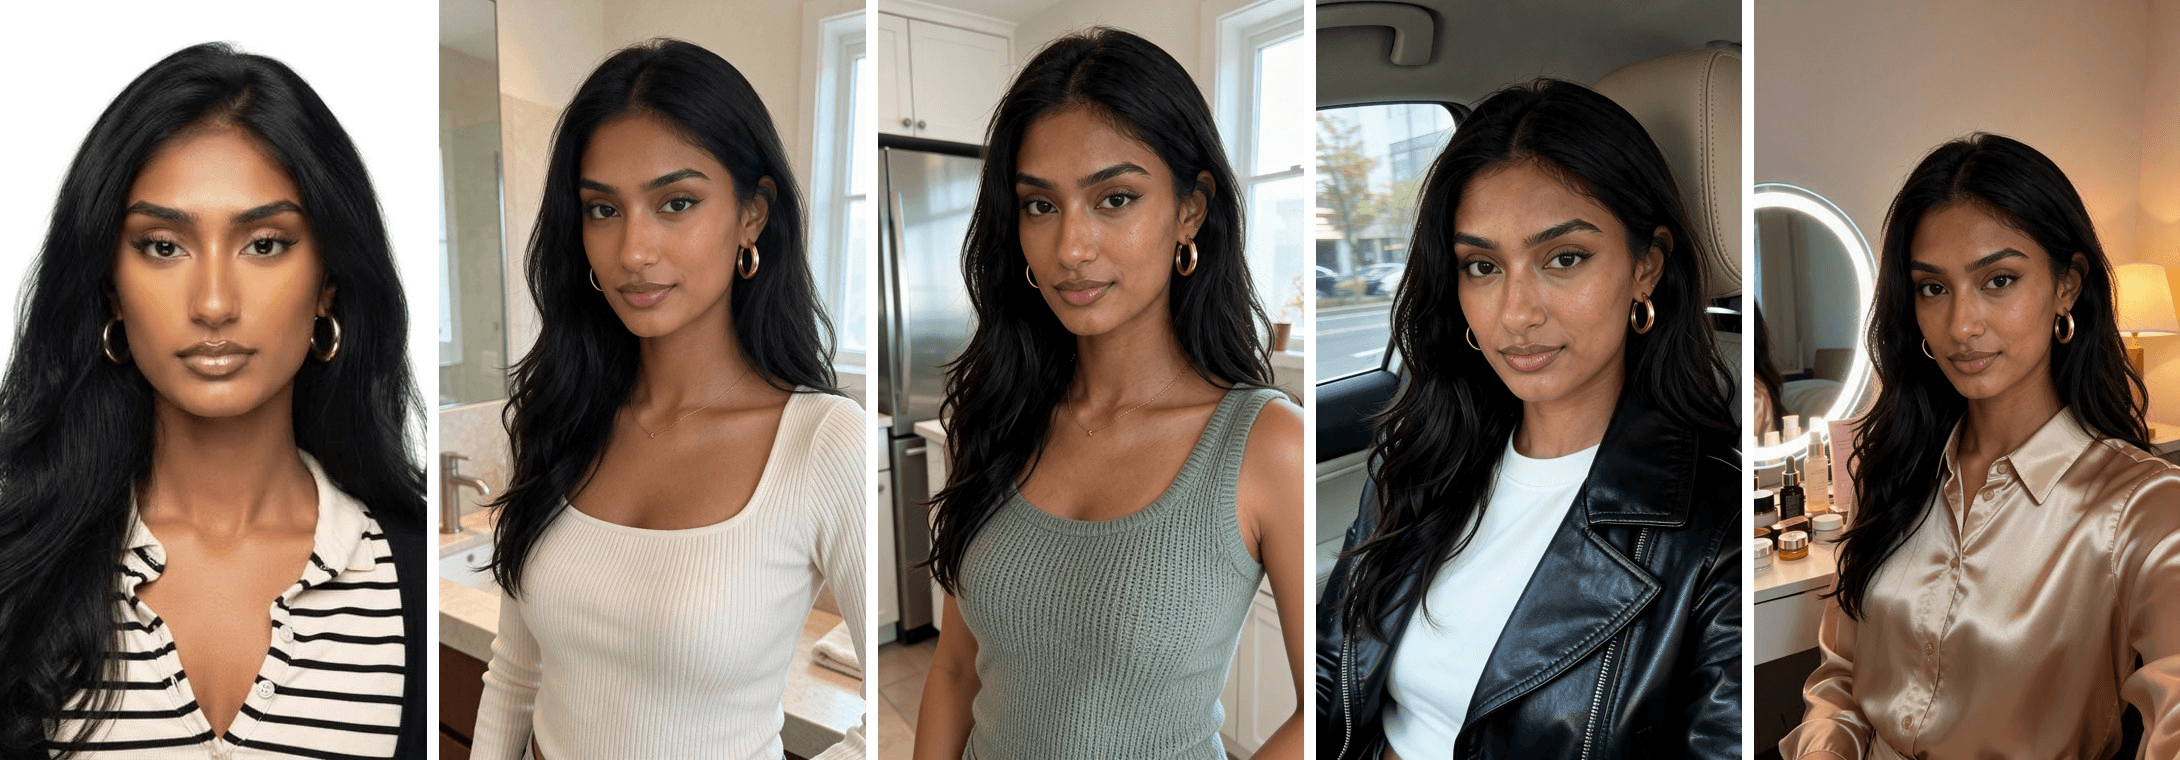
Tre cose hanno mantenuto stabile il volto per noi:
- Fissa l'identità, libera lo styling. Nomina ciò che non deve cambiare (volto, tonalità della pelle, capelli, orecchini) nella prima frase, poi descrivi il nuovo outfit e la stanza.
- Descrivi la telecamera, non il dispositivo. "Ripreso da una telecamera fissa all'altezza del petto" dà un'inquadratura pulita in stile selfie. Nomina un telefono sul bancone e il modello tende a disegnare il telefono.
- Vestila come una creator. Le felpe basic sembrano materiale di repertorio. Una maglia a costine con scollo quadrato o una camicia in satin fa pensare a qualcuno che si filma di proposito.
Passaggio 3: Scrivi Hook Virali per TikTok su uno Schema Collaudato
Con lo schema del Passaggio 1, scrivere diventa riempire gli spazi. Abbiamo abbozzato tre righe per il rullo ghiacciato, ciascuna che prende in prestito un'apertura diversa:
| Hook | Riga | Tipo di apertura |
|---|---|---|
| A | Ho dormito quattro ore e avevo una call alle sette del mattino. Due minuti con questa cosa e nessuno mi ha chiesto se ero stanca. Ecco come la uso. | Numero a effetto |
| B | Fai questo per due minuti se ti svegli con la faccia gonfia. Passa dalla mascella verso l'alto, sotto ogni occhio, poi sulla fronte. Tutto qui. | Lo schema del Passaggio 1 |
| C | Smetti di comprare creme occhi per il gonfiore. Metto questa in freezer tutta la notte, passo per due minuti, e la differenza si vede in video. | Consiglio controcorrente |
Poi dai a ogni riga la sua traccia vocale. Seedance 2.5 fa il lip-sync sull'audio di riferimento stesso, quindi l'audio è il copione: registra o genera ogni hook come file separato con la stessa voce.
Abbiamo generato il nostro con Gemini 2.5 Pro TTS su Atlas Cloud, usando la voce Sulafat e una nota di stile di una riga prima del testo che chiedeva una lettura casual, calorosa e leggermente giocosa.
Passaggio 4 (Metodo 1): Genera il Video Parlante nel Playground
Esegui i cinque clic dello screenshot qui sopra una volta per ogni hook. Tra un'esecuzione e l'altra cambia solo il file audio. Il prompt resta lo stesso:
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
Due scelte in quel prompt fanno la maggior parte del lavoro. L'inquadratura centrale è un primo piano perché i piccoli dettagli meccanici, come un cilindro che gira, si leggono meglio quando il prodotto riempie l'inquadratura. E la traccia vocale continua esplicitamente sul taglio, così il primo piano sembra B-roll all'interno di una sola ripresa.
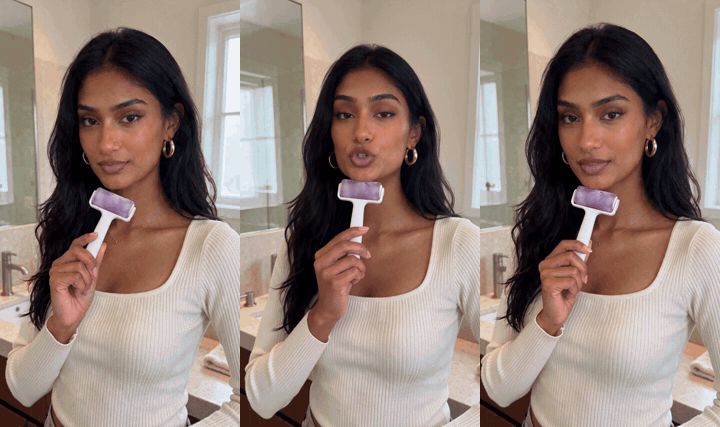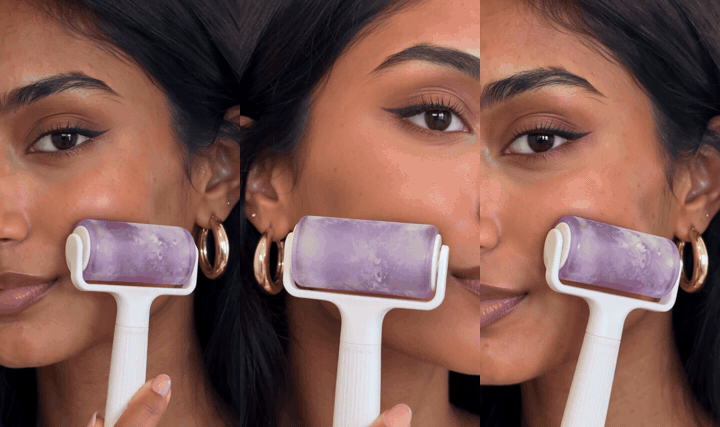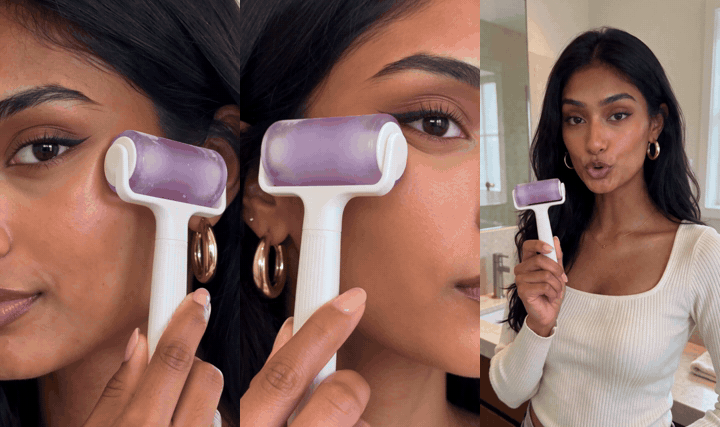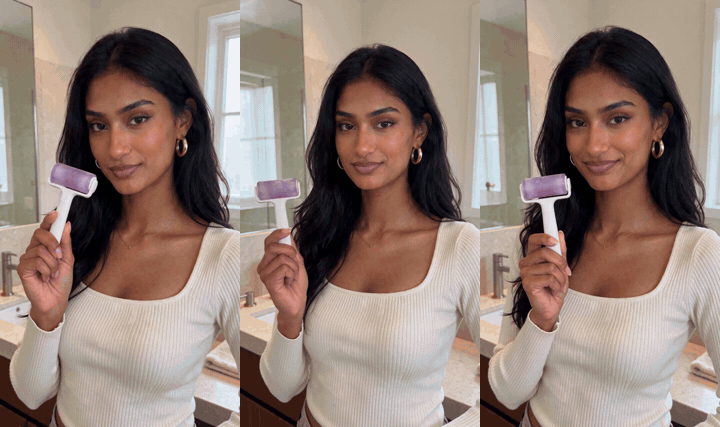
Abbiamo tenuto l'hook A per la versione 1080p. I suoi primi due secondi portano un numero e una posta in gioco (quattro ore di sonno, una call alle 7 del mattino), così lo spettatore conosce la ricompensa prima del primo taglio. Se preferisci scrivere a mano ogni fotogramma e shot list, il nostro workflow di 20 minuti per annunci AI UGC segue quella strada.
Passaggio 5 (Metodo 2): Metti in Batch gli Hook tramite l'API
Una volta che un hook funziona, l'API trasforma gli altri dieci in un ciclo sui file audio.
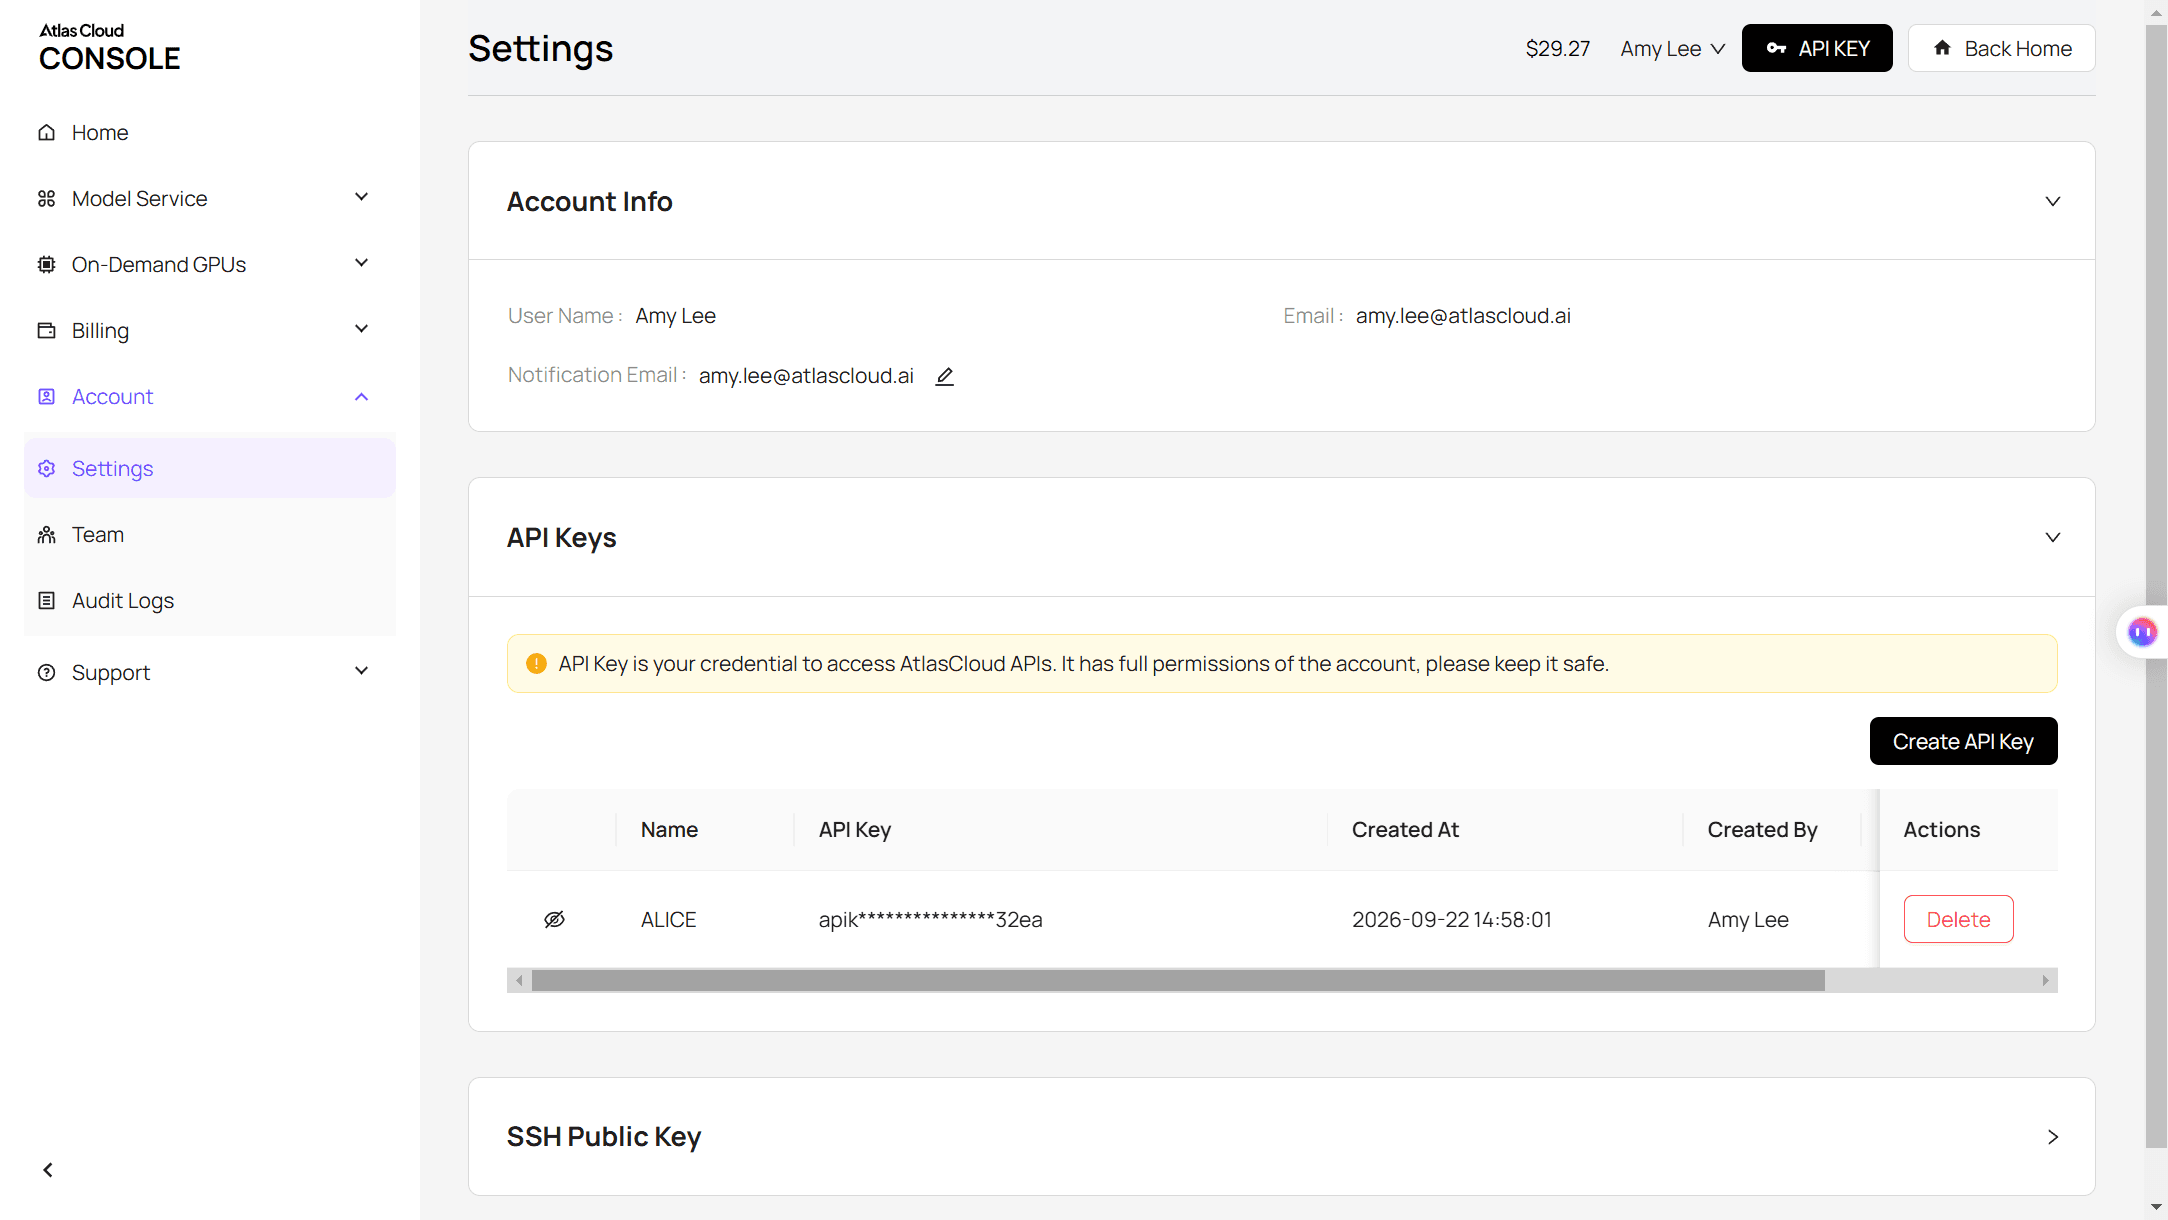
Passaggio 1: Crea e copia la tua chiave API. Apri la console di Atlas Cloud, vai su Settings, poi su API Keys e clicca Create API Key.
Passaggio 2: Controlla la documentazione API. I parametri di ogni modello, inclusi i campi di riferimento usati qui, sono nella documentazione API.
Passaggio 3: Fai la tua prima richiesta. Invia un hook:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
La risposta restituisce un ID di previsione. Fai polling finché lo stato non legge completed:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
Per mettere in batch, mantieni fisso il body e sostituisci l'URL di reference_audios per ogni hook. Atlas Cloud usa una sola API su tutti i suoi modelli: ogni modello video condivide questo endpoint, chiave e ciclo di polling, quindi cambiare modello significa cambiare la stringa del modello. I passaggi su immagini e voce qui sopra usano la stessa chiave e lo stesso schema di invio-e-polling.
Per una griglia di test completa hook-per-formato, vedi come scalare la produzione di annunci UGC.
Regole per AI Influencer: Etichette e Somiglianza
Prima che lei venda qualsiasi cosa, controlla due tipi di regole: le etichette delle piattaforme e le leggi sulle persone sintetiche negli annunci.
| Dove | Cosa chiede | Cosa fare |
|---|---|---|
| TikTok | Etichetta i contenuti generati con l'AI che mostrano scene o persone realistiche | Attiva l'etichetta AI-generated o aggiungi una didascalia o uno sticker quando pubblichi |
| Annunci dello Stato di New York | Rivela un performer sintetico in un annuncio quando l'inserzionista sa che ne viene usato uno | Aggiungi una dichiarazione chiara e visibile all'annuncio |
| Volti reali come riferimenti | Permesso dalla persona di cui usi la somiglianza | Ottieni il consenso scritto, o parti da un ritratto di cui possiedi i diritti |
TikTok ha introdotto la sua etichetta per contenuti generati con l'AI a settembre 2023 e chiede ai creator di usarla sui contenuti AI realistici. La legge sui performer sintetici di New York, S.8420-A, è stata firmata l'11 dicembre 2025 ed è entrata in vigore il 9 giugno 2026, con sanzioni civili di $1.000 per la prima violazione e $5.000 per ciascuna successiva.
Sul lato del modello, Seedance 2.5 su Atlas Cloud accetta foto di persone reali come riferimenti e le registra automaticamente come asset. La sua documentazione chiede di usare la somiglianza di una persona reale solo con la sua autorizzazione, che è la stessa regola che seguiresti con un creator umano.
Domande Frequenti
Quanto costa creare un AI influencer?
I ritratti sono venuti a circa $0,03 ciascuno con Seedream 5.5 Edit a 9:16. Il video Seedance 2.5 è prezzato per risoluzione e durata: un clip verticale di 10 secondi con due immagini di riferimento e un file vocale costa circa $3,02 a 720p e circa $5,94 a 1080p su Atlas Cloud.
Questi prezzi sono al 13 novembre 2026, con uno sconto del 20% applicato. Poiché ogni hook è il suo clip, il costo principale dell'AI UGC sta in quanti hook testi prima di scegliere un vincitore.
Esiste un generatore di hook TikTok che posso usare?
Qualsiasi modello di testo può generare hook, ma l'output migliora quando gli dai uno schema invece di un argomento. Analizza prima un video virale (Passaggio 1), poi chiedi al modello dieci righe in quella esatta struttura di frase per il tuo prodotto. Sceglierne tre da filmare batte generarne cinquanta e non filmarne nessuna.
Il mio AI influencer può parlare altre lingue?
Sì. Seedance 2.5 genera il parlato nativamente in più di 10 lingue, secondo la sua documentazione del modello. Per il lip sync più preciso, genera prima la traccia vocale nella lingua di destinazione e passala come audio di riferimento, esattamente come faresti per l'inglese.
Quanto può essere lungo un video di un AI influencer?
Una generazione Seedance 2.5 va da 4 a 30 secondi. Gli hook funzionano meglio brevi: i nostri tre clip sono da 10 secondi ciascuno, il che lascia spazio per una riga, un primo piano e una presentazione del prodotto. Per annunci più lunghi, genera le scene separatamente e montale insieme.
Conclusione
Il volto ormai è la parte facile. Ciò che distingue un presentatore che vende da uno che semplicemente ha un bell'aspetto è il lavoro intorno a lei: uno schema di hook preso da qualcosa che è già diventato virale, un singolo ritratto riutilizzato nelle scene e una traccia vocale per ogni riga così le labbra corrispondono alle parole.
Se stai capendo come creare un AI influencer per il tuo prodotto, inizia in piccolo. Analizza un video, scrivi tre righe, esegui tre clip e tieni quella che si guadagna i suoi primi tre secondi. Poi lascia che l'API ripeta il ciclo per ogni hook che viene dopo.




