


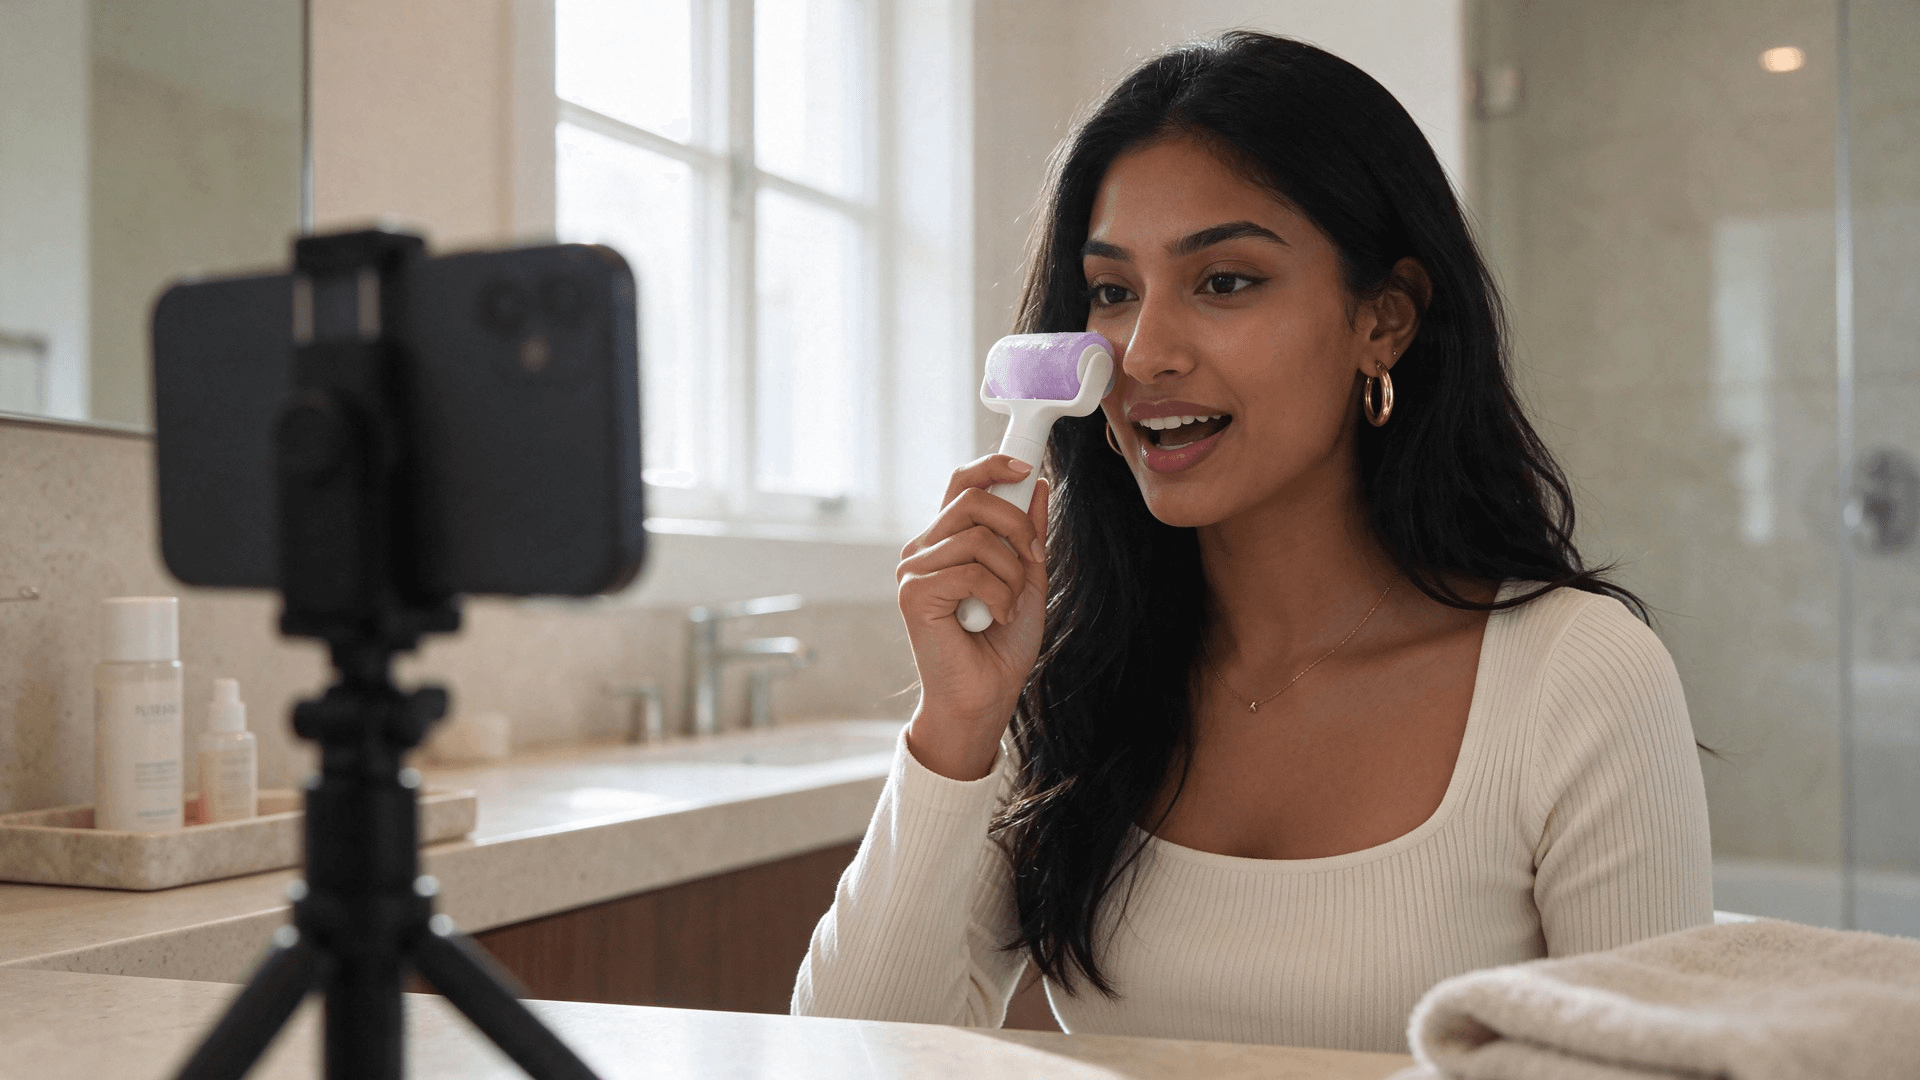
クリップは、女性がバスルームの洗面台の前にいる場面から始まる。彼女は曇ったアイスローラーを頬骨に沿って上へ転がし、4時間睡眠で受けた朝7時の通話について愚痴る。誰も彼女にカメラを向けていない。この動画は、1枚のポートレート、1枚の商品写真、8秒のボイスラインから作られた。
このガイドでは、彼女のようなAIインフルエンサーをブランド動画向けに作成する方法を順を追って説明する。どんなシーンでも再利用できる顔、すでにバイラルになった動画から借りたフック、台本が変わるたびに再生成できるトーキングクリップだ。この記事を書きながら実際に1体作ったので、各ステップで実際の入力と出力を紹介する。
主なポイント
- AIインフルエンサーとは、1枚の参照写真から作られ、動画をまたいで再利用する一貫した顔のこと。
- 実績のあるTikTokフックから始める。台本を1行書く前に、バイラル動画を1本分解する。
- Seedance 2.5 は、1枚のポートレート、1枚の商品ショット、1本のボイスラインを、リップシンクされたトーキング動画に変える。
- フックのセリフを3つ書き、それぞれをクリップとして実行し、最初の3秒が刺さるものを残す。
- TikTokではAI制作のプレゼンターにラベルを付け、使用許可を得た実在の顔だけを使う。
AIインフルエンサーとは何か、誰が作るのか
AIインフルエンサーとは、同じ顔、声、スタイルで何度もカメラに登場する生成された人物だ。「何度も」という部分が仕事のすべてだ。見栄えのいい1フレームは簡単だ。月曜はキッチン、金曜は車の中でも同じ女性に見えるプレゼンターこそ、人が実際に検索しているものだ。
作るのは主に2つのグループで、求めるものは異なる。
| ペルソナアカウント | ブランドプレゼンター | |
|---|---|---|
| 目的 | バーチャルな人物としてフォロワーを増やす | 商品動画や広告の前面に立つ |
| 固定すべきもの | 顔、性格、ストーリー | 顔、声、話し方 |
| 典型的な成果物 | 毎日の投稿、ストーリーズ、ライブ | 10〜30秒のフックとデモ |
| 成功指標 | オーディエンス規模 | 視聴時間と商品クリック |
このガイドでは2つ目の列を扱う。この形式自体が初めてなら、AI UGCとは何かの解説で基本を先に確認してほしい。
1枚の写真をAtlas Cloudで話すAIインフルエンサーに変える
理論の前に、完成したクリップを紹介する。10秒の縦型動画で、彼女の声、ローラーが動くクローズアップ、最後に商品を持ち上げる場面が入っている。
これはAtlas CloudのSeedance 2.5 Reference-to-Videoで作成した。AIインフルエンサー生成ツールとして、あなたの入力から始まる。顔、商品、声を用意すると、それを中心にショットを構築する。
1回のリクエストで最大30枚の参照画像(実在の人物の写真を含む)を受け付け、1本の音声クリップだけでリップシンクを駆動できる。
これはブランドプレゼンターにとって重要だ。どの動画でも顔はあなたのままで、台本が変わったときは再撮影を手配する代わりに音声ファイルを1つ差し替えるだけで済む。
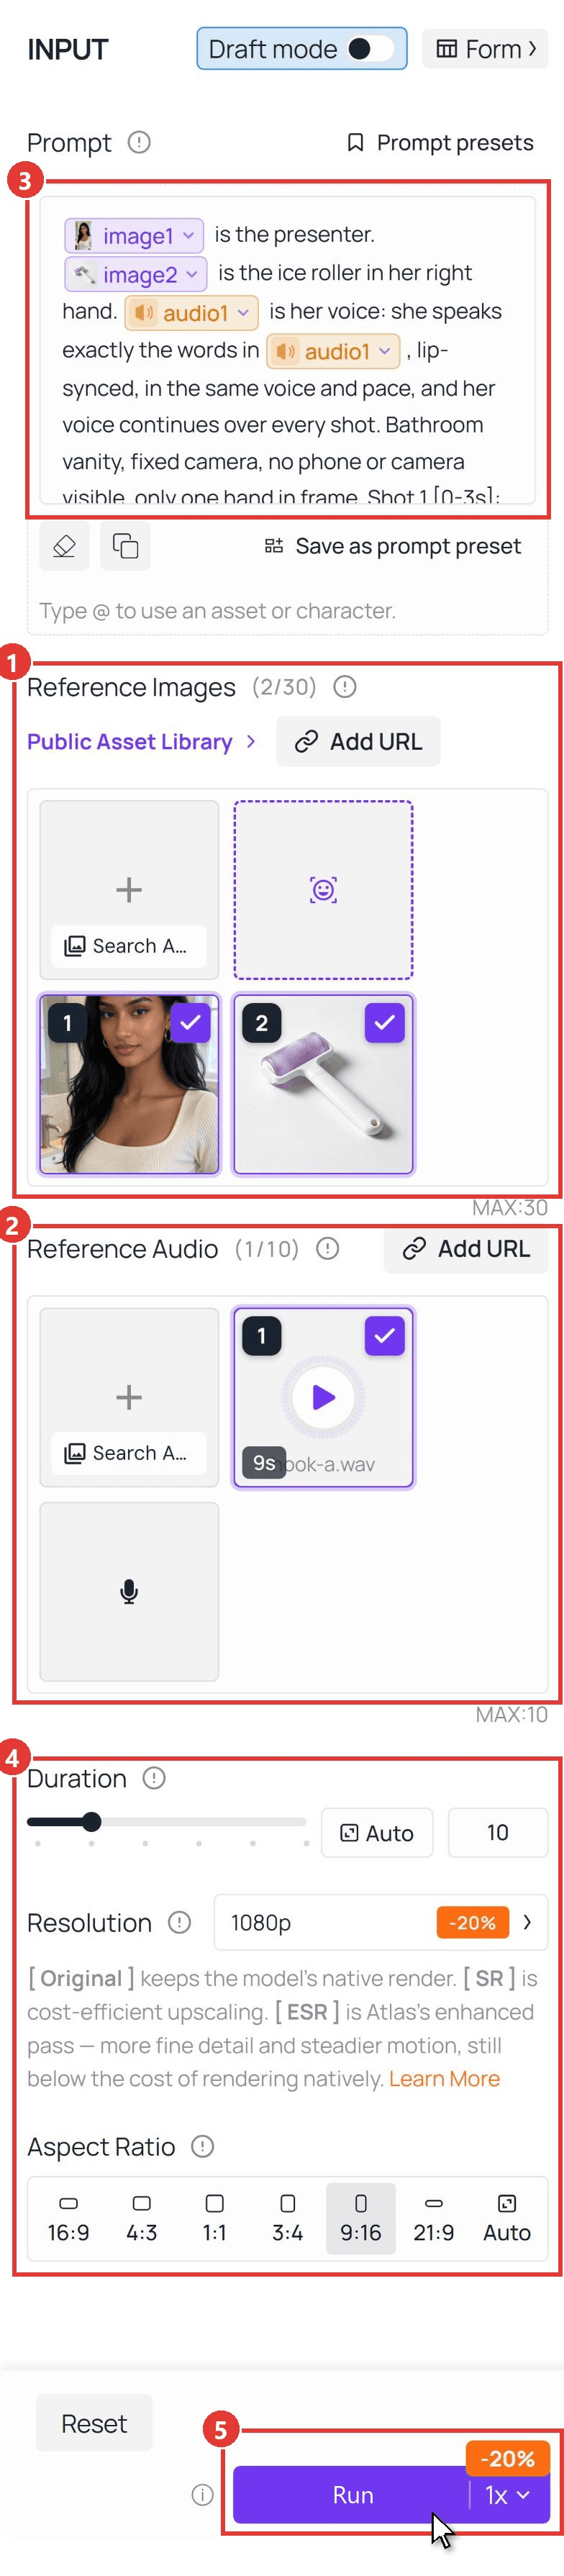
すべての実行はSeedance 2.5 Reference-to-Videoプレイグラウンドの1ページで完結する。
- まずポートレートを、次に商品写真を「Reference Images」の下にアップロードする。順番が重要で、最初のファイルがImage1になる。
- ボイスラインを「Reference Audio」の下にアップロードする。
- プロンプトを貼り付け、各@メンションを入力し直して、リストから対応するファイルを選び、タグに変える。
- Durationを10、Resolutionを1080p、Aspect Ratioを9:16に設定する。
- Runをクリックする。
AIインフルエンサーを5ステップで作る方法
プレイグラウンドは最後のクリックにすぎない。動画がスクロールを止めるかどうかを決めるのは、そこに投入するすべてだ。そこで、リサーチから完成したフックまで、AIインフルエンサーの作り方を紹介する。
ステップ1:実際のバイラル動画からTikTokフックを分解する
白紙の台本から始めない。ニッチ分野ですでに再生数を稼いだショート動画を1本選び、分解する。
私たちはAll You Can Faceチャンネルの19秒のルーティン、むくんだ顔、むくんだまぶた、むくんだ目の下のための1つのルーティンを使った。10回見る代わりに、Atlas Cloud API経由でGemini 3.5 Flashにリンクを渡した。公開YouTubeリンクはそのまま動画入力として機能する。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
返ってきた内容を要約すると次のとおり。
| 求めたこと | 動画がしていること |
|---|---|
| 冒頭のセリフ | 「朝起きて顔がむくんでいたら、これを20回やって。」 |
| フックの種類 | 悩みを直接的な指示として表現 |
| 構成 | 4ショット、問題ごとに1つ、それぞれ同じ文型で始まる |
| 画面テキスト | ショットごとに項目が1つ増えるチェックリスト |
| フレーミング | 胸から上、常にレンズを見る |
| 再利用可能なパターン | [アクション]を[回数]、朝起きて[悩み]があるなら |
TikTokフックのリストは最初のセリフを与えてくれる。分解の役立つ部分は、そのセリフの下にある構造だ。1つの繰り返し文型、ショットごとに1つの目に見える見返り、イントロなし。それを台本に持ち込んだ。
ステップ2:1つの顔を固定し、シーンをまたいで再利用する
インフルエンサーが視聴者にとって本物に感じられるのは、毎回同じ人物に見えるときだけだ。使用権を持つポートレートを1枚出発点にし、顔以外のすべてを変える。服装、部屋、光。
参照から編集できる画像モデルならどれでもできる。私たちはAtlas CloudのSeedreamを使い、5.5 Editモデルでスタジオポートレートをバスルーム洗面台のマスターショットに変換し、5.0 Liteのシーケンシャルエディターでそのマスターからさらに3シーンを1回のリクエストで生成した。
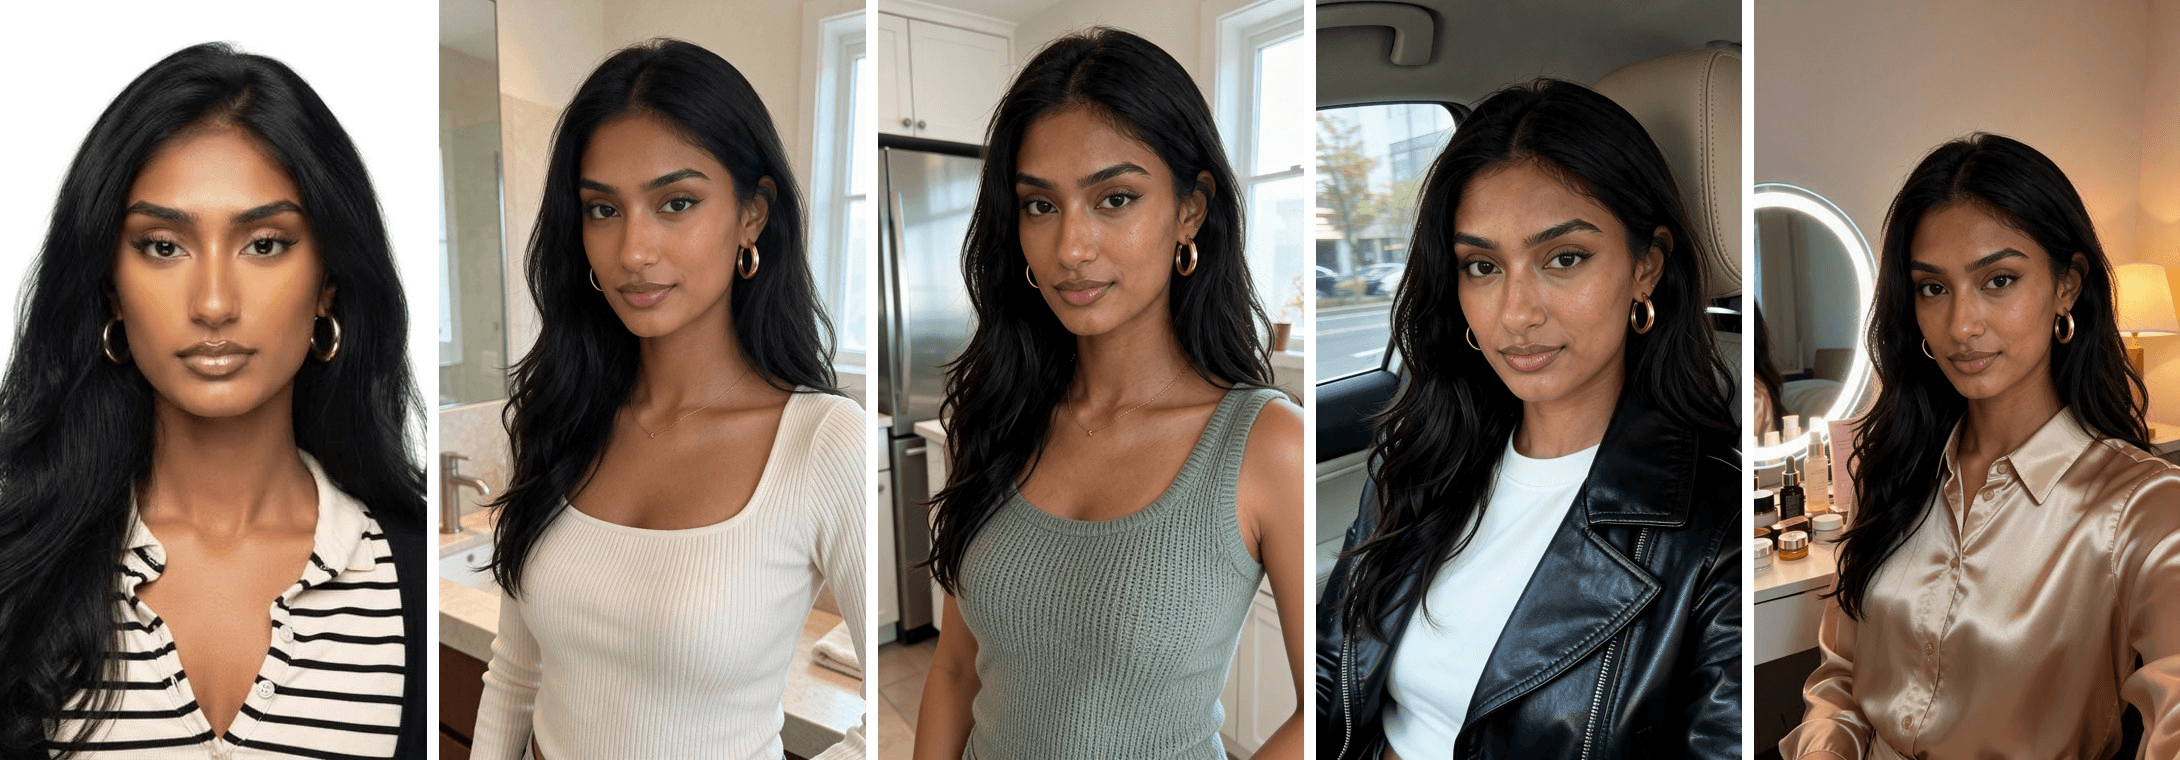
顔を安定させるために効いた3つのポイント。
- アイデンティティを固定し、スタイリングは自由にする。 変えてはいけないもの(顔、肌の色、髪、イヤリング)を最初の文で指定し、その後に新しい服装と部屋を描写する。
- ガジェットではなくカメラを描写する。 「胸の高さの固定カメラから撮影」と指定すると、きれいな自撮り風のフレームになる。カウンター上のスマホに言及すると、モデルはスマホを描きがちだ。
- クリエイターらしく服を着せる。 ありきたりなスウェットはストック映像に見える。リブのスクエアネックトップやサテンシャツは、意図的に自分を撮影する人に見える。
ステップ3:実証済みのパターンでTikTokのバイラルフックを書く
ステップ1のパターンがあれば、執筆は穴埋めになる。アイスローラー用に3つのセリフを起草し、それぞれ異なる冒頭を借りた。
| フック | セリフ | 冒頭の種類 |
|---|---|---|
| A | 「4時間しか寝ずに朝7時の通話があった。これを使って2分で、誰にも疲れてる?と聞かれなかった。使い方はこう。」 | スタント+数字 |
| B | 「朝起きて顔がむくんでいたら、これを2分やって。あごから上へ、両目の下、そして額を横切る。それだけ。」 | ステップ1のパターン |
| C | 「むくみにアイクリームを買うのはやめて。これを一晩冷凍庫に入れて、2分転がすと、その違いはカメラにも映る。」 | 逆張りアドバイス |
次に、各セリフにそれぞれのボイストラックを用意する。Seedance 2.5は参照オーディオ自体にリップシンクするので、音声が台本になる。各フックを同じ声で別ファイルとして録音または生成する。
私たちはAtlas CloudのGemini 2.5 Pro TTSで生成し、Sulafatボイスを使い、テキストの前にカジュアルで温かみがあり、少し遊び心のある読み方を求める1行のスタイル指示を入れた。
ステップ4(方法1):プレイグラウンドでトーキング動画を生成する
上のスクリーンショットの5クリックを、フックごとに1回実行する。実行間で変わるのは音声ファイルだけ。プロンプトは同じままだ。
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
そのプロンプトで最も効くのは2つの選択だ。中間ショットをクローズアップにしたのは、シリンダーが回るような小さな機械的ディテールは、商品がフレームを満たすときに最も伝わるからだ。そしてボイスラインはカットをまたいで続くことを明示しているので、クローズアップが1テイク内のBロールのように感じられる。
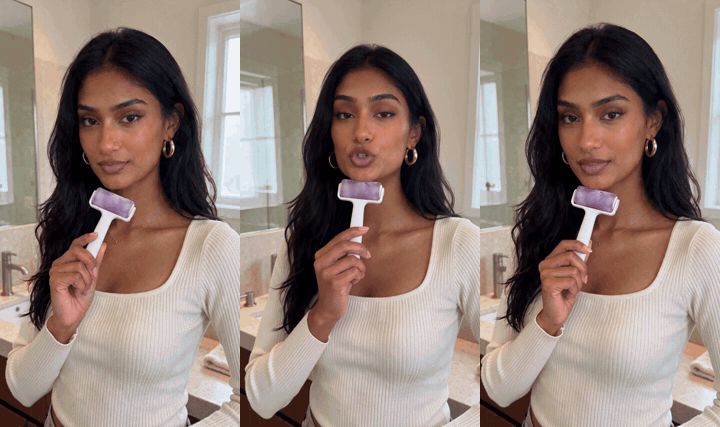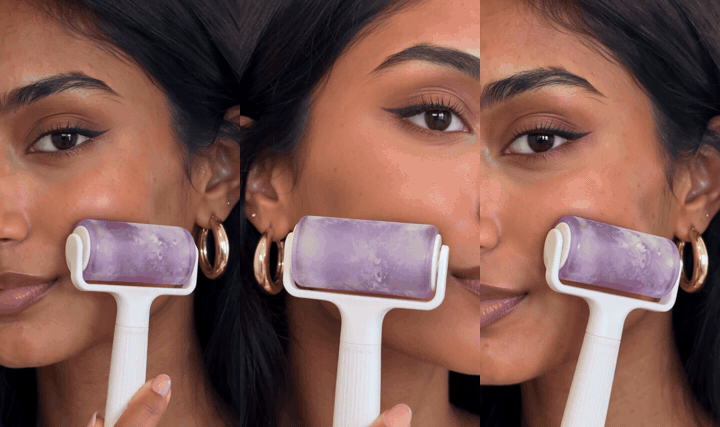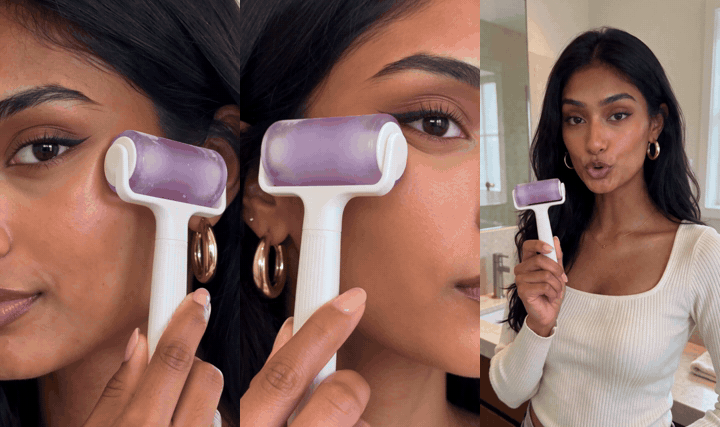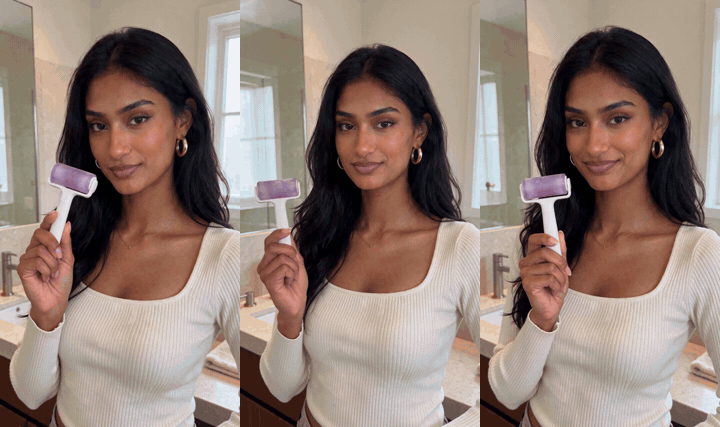
1080p版にはフックAを採用した。最初の2秒に数字とリスク(4時間睡眠、朝7時の通話)が入っているので、視聴者は最初のカットの前に見返りを知る。すべてのフレームとショットリストを手書きしたいなら、20分で作るAI UGC広告ワークフローがそのルートだ。
ステップ5(方法2):APIでフックを一括処理する
1つのフックが機能したら、APIで残り10本を音声ファイルのループ処理にできる。
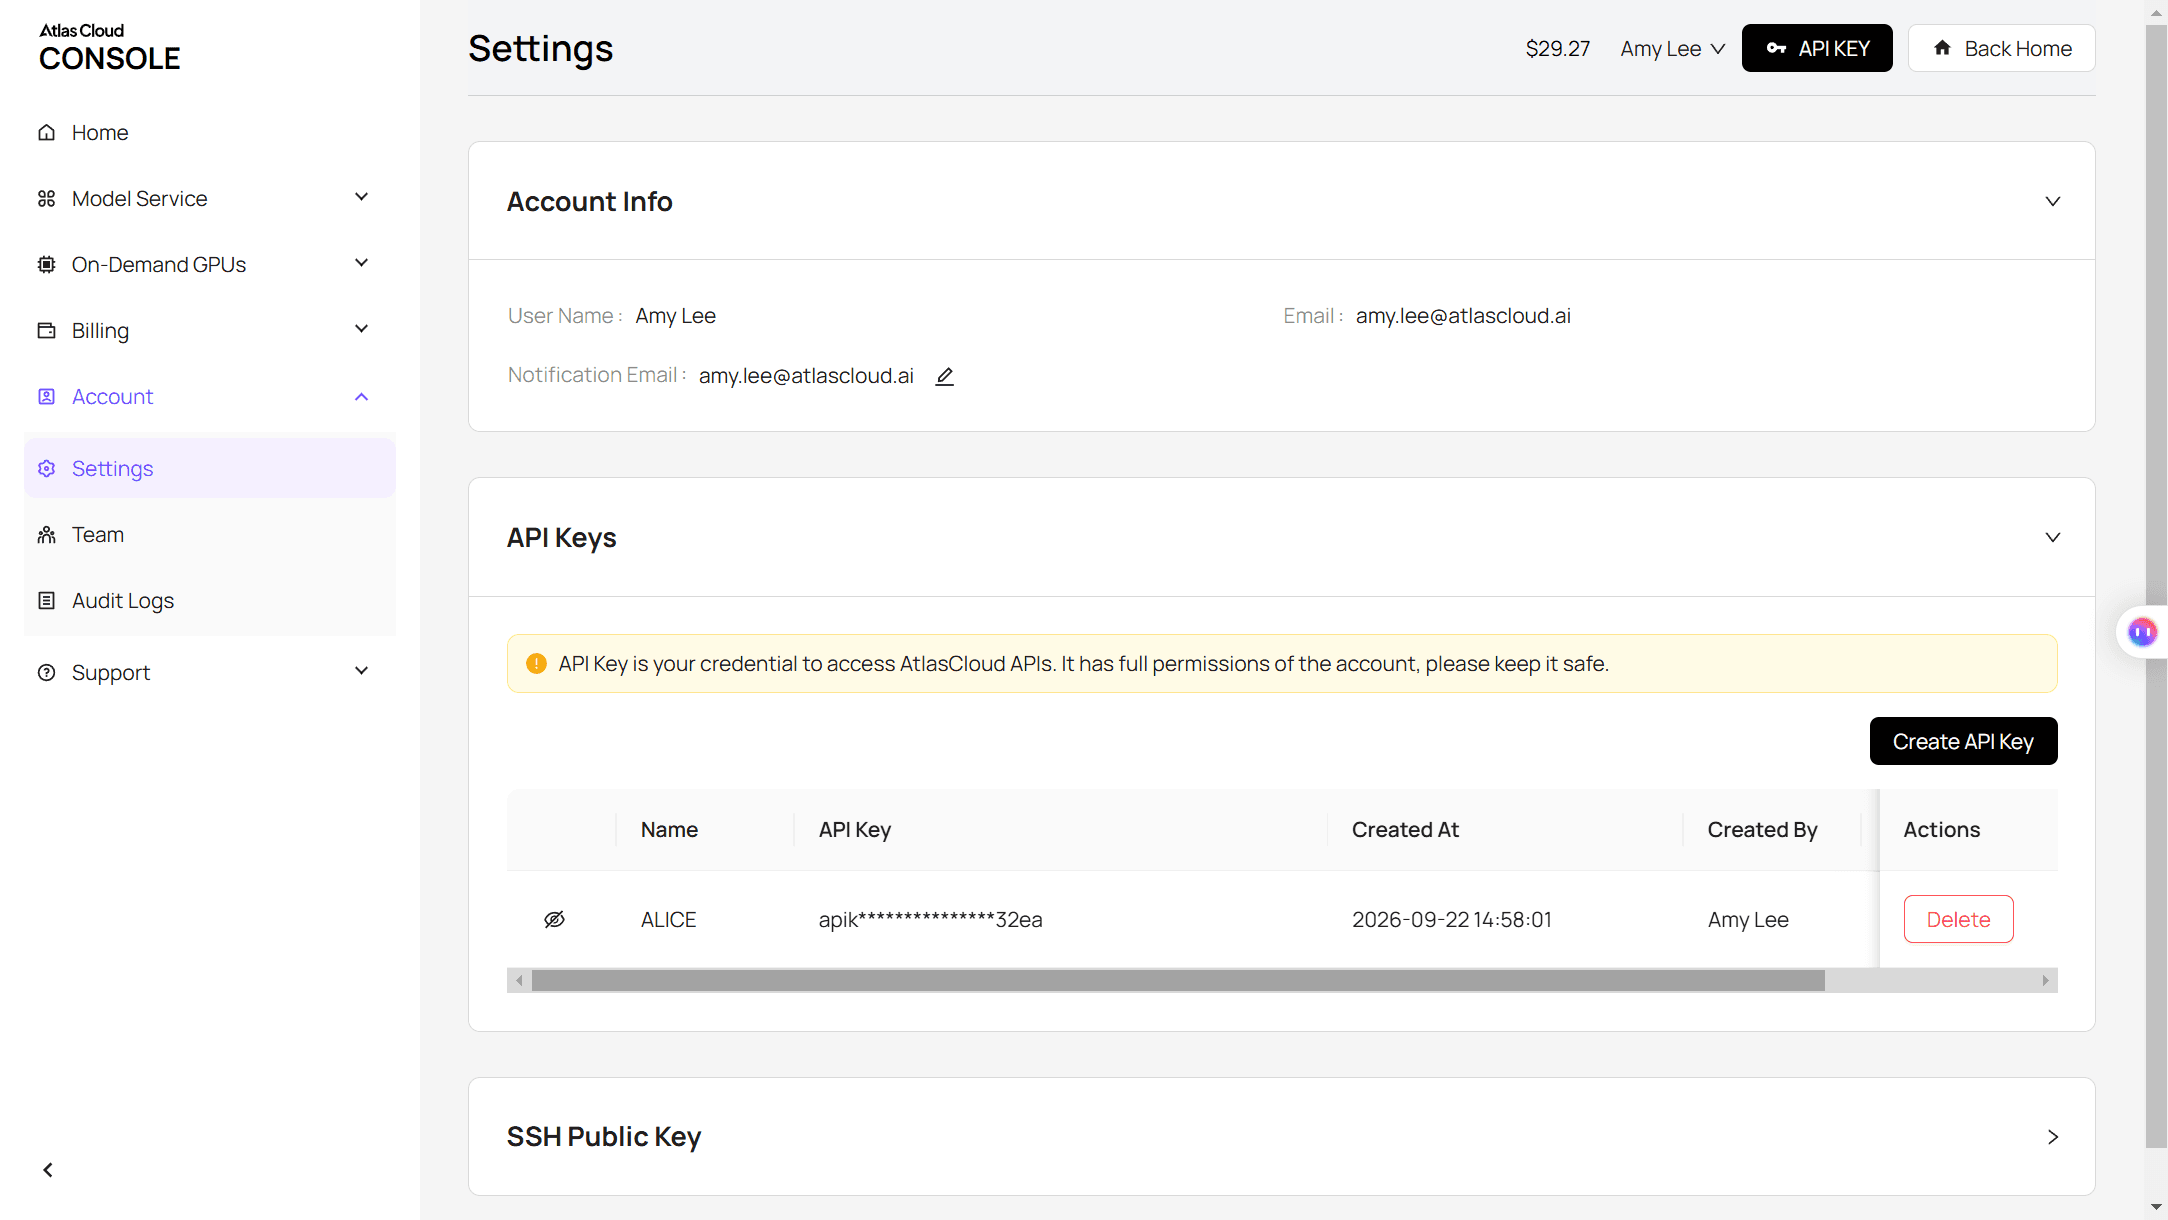
ステップ1:APIキーを作成してコピーする。 Atlas Cloudコンソールを開き、Settings、次にAPI Keysへ進み、Create API Keyをクリックする。
ステップ2:APIドキュメントを確認する。 ここで使用する参照フィールドを含め、すべてのモデルのパラメータはAPIドキュメントにある。
ステップ3:最初のリクエストを送る。 フックを1つ送信する。
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
レスポンスはprediction IDを返す。ステータスがcompletedになるまでポーリングする。
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
一括処理するには、ボディを固定したまま、フックごとにreference_audios URLを差し替える。Atlas Cloudはモデル横断で1つのAPIを提供している。すべての動画モデルがこのエンドポイント、キー、ポーリングループを共有するので、モデルを切り替えるときはモデル文字列を変えるだけだ。上記の画像と音声のステップも同じキーと同じ送信・ポーリングのパターンを使う。
フック×フォーマットの完全なテストグリッドについては、UGC広告制作を拡張する方法を参照。
AIインフルエンサーのルール:ラベルと肖像
彼女に何かを売らせる前に、2種類のルールを確認する。プラットフォームのラベルと、広告における合成人物に関する法律だ。
| どこで | 何を求めているか | どうするか |
|---|---|---|
| TikTok | 現実的なシーンや人物を映すAI生成コンテンツにラベルを付ける | 投稿時にAI生成ラベルをオンにするか、キャプションまたはステッカーを追加する |
| ニューヨーク州の広告 | 広告主が合成パフォーマーの使用を知っている場合、広告内で開示する | 広告に明確で見える開示を追加する |
| 参照としての実在の顔 | 使用する肖像の本人からの許可 | 書面による同意を得るか、使用権を持つポートレートから始める |
TikTokは2023年9月にAI生成コンテンツラベルを導入し、現実的なAIコンテンツに使用するようクリエイターに求めている。ニューヨーク州の合成パフォーマー法 S.8420-Aは2025年12月11日に署名され、2026年6月9日に発効した。民事制裁金は初回違反で$1,000、その後は1件につき$5,000。
モデル側では、Atlas CloudのSeedance 2.5は実在の人物の写真を参照として受け付け、自動的にアセットとして登録する。そのドキュメントでは、実在の人物の肖像は本人の許可がある場合にのみ使用するよう求めている。これは人間のクリエイターに対して従うのと同じルールだ。
よくある質問
AIインフルエンサーを作るにはいくらかかる?
ポートレートはSeedream 5.5 Editの9:16で1枚あたり約$0.03だった。Seedance 2.5の動画は解像度と長さで価格が決まり、参照画像2枚と音声ファイル1本を使う10秒の縦型クリップは、Atlas Cloudで720pが約$3.02、1080pが約$5.94だ。
これらの価格は2026年11月13日時点で、20%割引を適用したものだ。各フックがそれぞれクリップになるため、AI UGCの主なコストは、勝ち筋を選ぶまでに何本のフックをテストするかで決まる。
使えるTikTokフック生成ツールはある?
どんなテキストモデルでもフックは生成できるが、トピックではなくパターンを与えると出力が良くなる。まずバイラル動画を1本分解し(ステップ1)、その正確な文型で自分の商品向けのセリフを10本生成するようモデルに依頼する。3本を選んで撮る方が、50本生成して1本も撮らないより良い。
AIインフルエンサーは他の言語を話せる?
はい。Seedance 2.5のモデルドキュメントによると、10以上の言語でネイティブに音声を生成できる。最も精度の高いリップシンクには、英語の場合とまったく同じように、まず対象言語でボイスラインを生成し、それを参照オーディオとして渡す。
AIインフルエンサー動画はどれくらいの長さにできる?
Seedance 2.5の1回の生成は4〜30秒だ。フックは短い方が最も効果的で、私たちの3本のクリップは各10秒で、1つのセリフ、1つのクローズアップ、1つの商品保持を入れる余裕がある。より長い広告では、シーンを別々に生成してつなぎ合わせる。
まとめ
顔を作るのは今や簡単な部分だ。売れるプレゼンターと、ただ見た目が良いだけのプレゼンターを分けるのは、彼女の周辺の仕事だ。すでにバイラルになったものから取ったフックパターン、シーンをまたいで再利用する1枚のポートレート、そして唇とセリフを一致させるための各セリフのボイストラック。
自分の商品向けにAIインフルエンサーを作る方法を模索しているなら、小さく始めよう。動画を1本分解し、セリフを3つ書き、クリップを3本実行し、最初の3秒で成果を出すものを残す。その後は、APIに任せて、その後に続くすべてのフックでこのループを繰り返せばいい。




