Czy natknąłeś się na filmy na TikToku lub Instagramie, w których „duch” pojawia się na selfie — albo skradając się cicho od tyłu, albo nagle rzucając się do przodu? Ludzie używają tego efektu ducha, aby robić kawały swoim znajomym. Spędziłem ostatnie kilka dni, badając, jak tworzyć te efekty ducha za pomocą AI, i chciałbym podzielić się z tobą tą metodą.
Powyższy film prezentuje efekty ducha, które stworzyłem za pomocą ChatGPT i Veo 3.1. Od lewej do prawej są to:
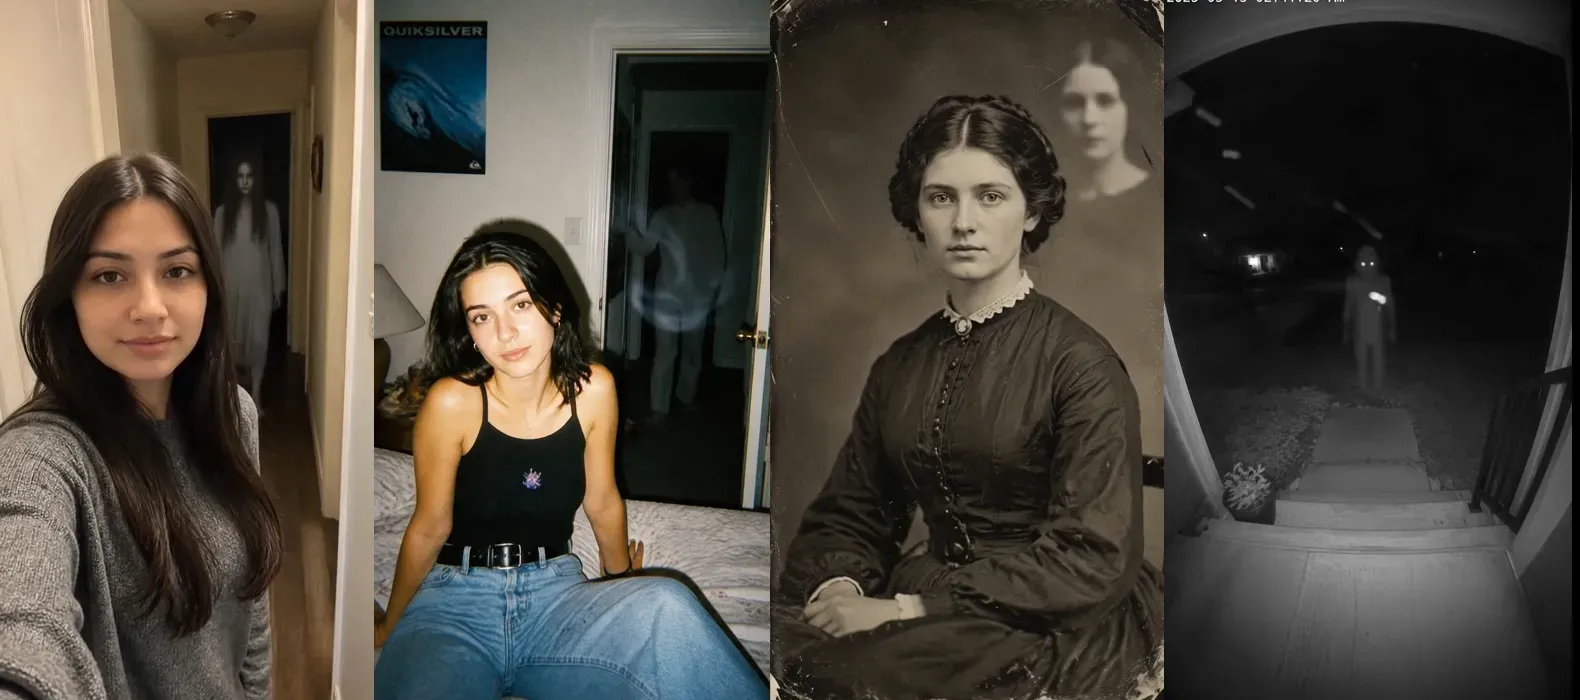
- Panel 1: Iteracja promptu w przedpokoju (testowanie przezroczystości i podobieństwa)
- Panel 2: Styl 1 – Lata 90. – jednorazowy błysk w sypialni – czający się
- Panel 3: Styl 2 – Wiktoriańska podwójna ekspozycja widmowa
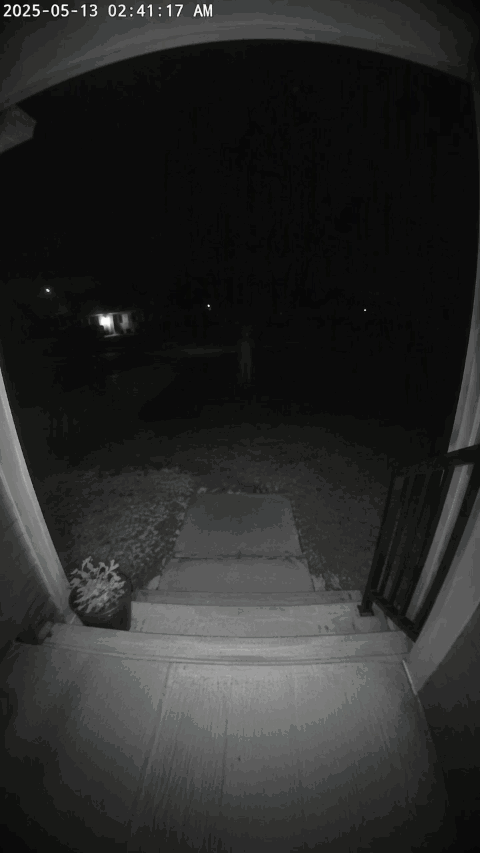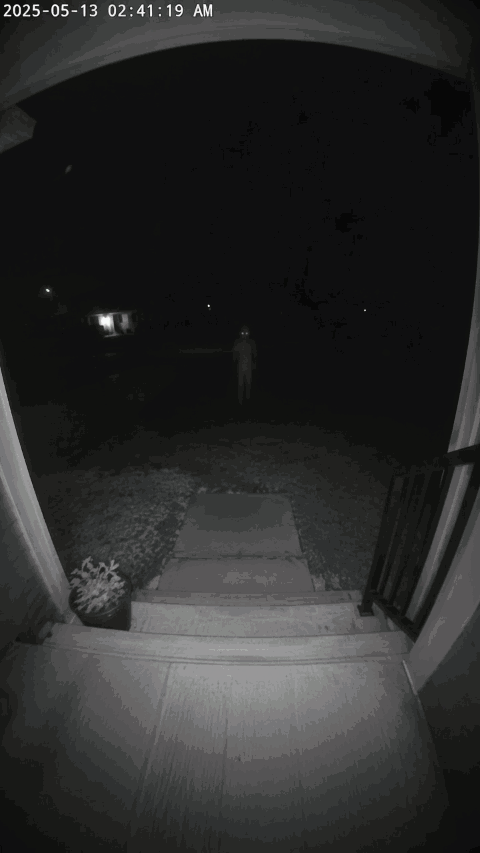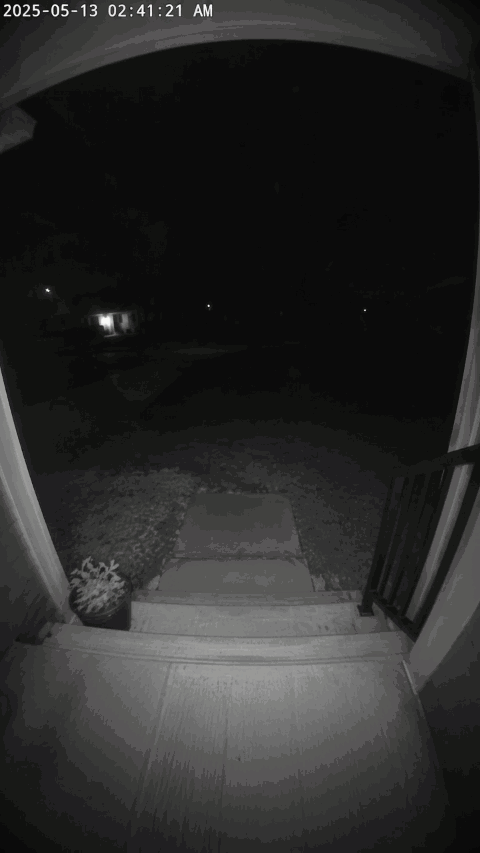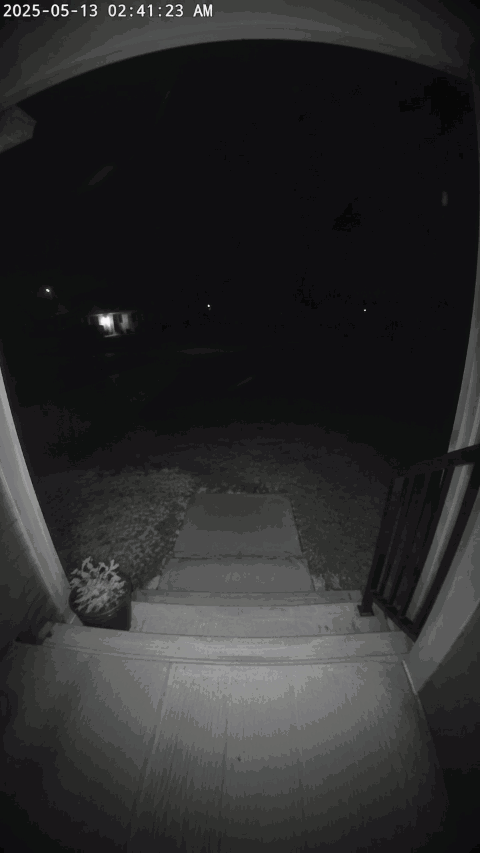
- Panel 4: Styl 3 – Glitch z kamery dzwonka w podczerwieni i noktowizji
Następnie przyjrzyjmy się, jak je stworzyłem.
Wybór odpowiedniego zdjęcia źródłowego do generowania filmów z duchem AI
Większość nieudanych transformacji w ducha ma miejsce, zanim wpiszesz prompt. Gdy przesyłasz ciasne selfie z całą twarzą, modele dyfuzyjne zniekształcają rysy twarzy w potwory, zamiast umieszczać oddzielną postać za obiektem. Skuteczny przepływ pracy od zdjęcia do filmu z duchem wymaga czystej przestrzeni negatywowej.
Kadruj obiekt od klatki piersiowej w górę przy płaskim, neutralnym oświetleniu. Zostaw co najmniej 30% tła otwarte. Puste drzwi, przyciemnione korytarze i puste rogi dają estymatorom głębi wyraźne płaszczyzny do renderowania zjawy. Unikaj wzorzystych kwiatowych tapet, zatłoczonych zdjęć z imprez i miniatur o niskiej rozdzielczości. Silna kompresja psuje wykrywanie krawędzi i rozmazuje artefakty wizualne na pierwszym planie.
Lista kontrolna zdjęcia przed rozpoczęciem
Przepuść swoje zdjęcie źródłowe przez tę techniczną bazę, zanim zaczniesz generować klatki:
- Przestrzeń tła: Zostaw wystarczająco dużo widocznego tła obok lub za obiektem, aby pomieścić ducha. Drzwi lub pusty róg mogą pomóc ustalić głębię.
- Rozdzielczość obrazu: Zacznij od rozdzielczości zalecanej przez wybrane narzędzie. Użyj wyraźnego, dobrze oświetlonego zdjęcia źródłowego i unikaj mocno skompresowanych obrazów.
- Wyraz twarzy: Zrelaksowany wyraz twarzy może ułatwić zachowanie szczegółów twarzy, ale wyniki zależą od modelu i zdjęcia źródłowego.
- Umiejscowienie obiektu: W miarę możliwości utrzymuj wyraźne oddzielenie osoby od tła, szczególnie wokół włosów, ramion i dłoni.
Proces krok po kroku animowania ducha z dowolnego zdjęcia
Wprowadzenie zwykłego zdjęcia bezpośrednio do generatora wideo psuje wynik. Większość modeli zdjęcie-do-wideo próbuje wymyślić ducha, jednocześnie przewidując ruch kamery. To rozrywa twarz obiektu w płynną gumę. Eliminujesz zniekształcenie twarzy, dzieląc potok przetwarzania wideo z filtrem ducha na dwa kontrolowane etapy.
Etap 1: Wygeneruj oryginalne zdjęcie
Zacznij od wygenerowania standardowego obrazu bez ducha, który posłuży jako punkt wyjścia dla twojego przepływu pracy. Jeśli masz już odpowiedni obraz, możesz pominąć ten krok.
Do tego testu ponownie używam ChatGPT Image 2.0, ponieważ jest opłacalny — pojedynczy obraz niskiej jakości kosztuje tylko $0.00971.
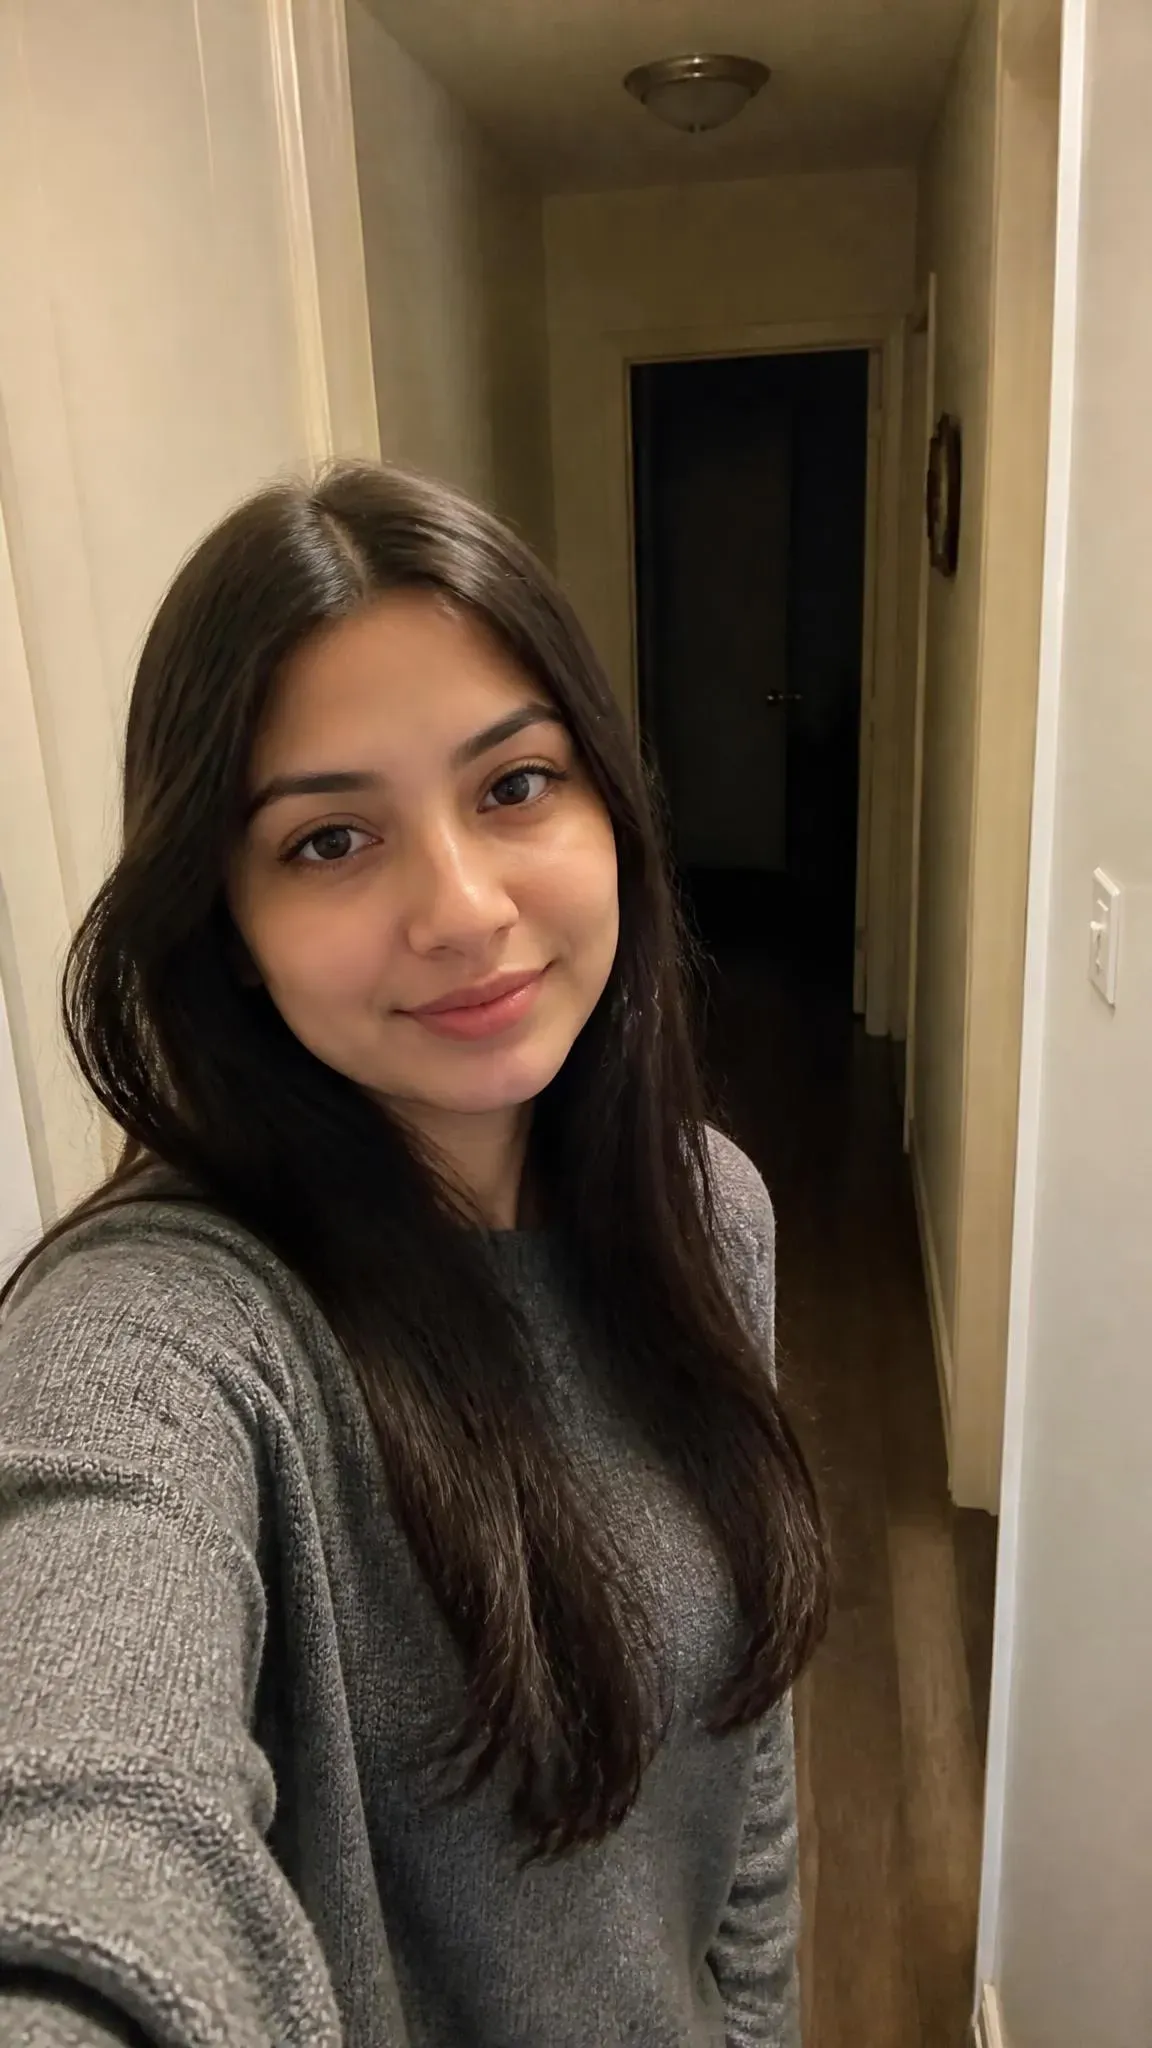
Etap 2: Skonfiguruj dyfuzję ruchu
Następnie prześlę wygenerowany obraz z powrotem do ChatGPT i użyję jego możliwości edycji obrazu, aby stworzyć zdjęcie zawierające ducha.
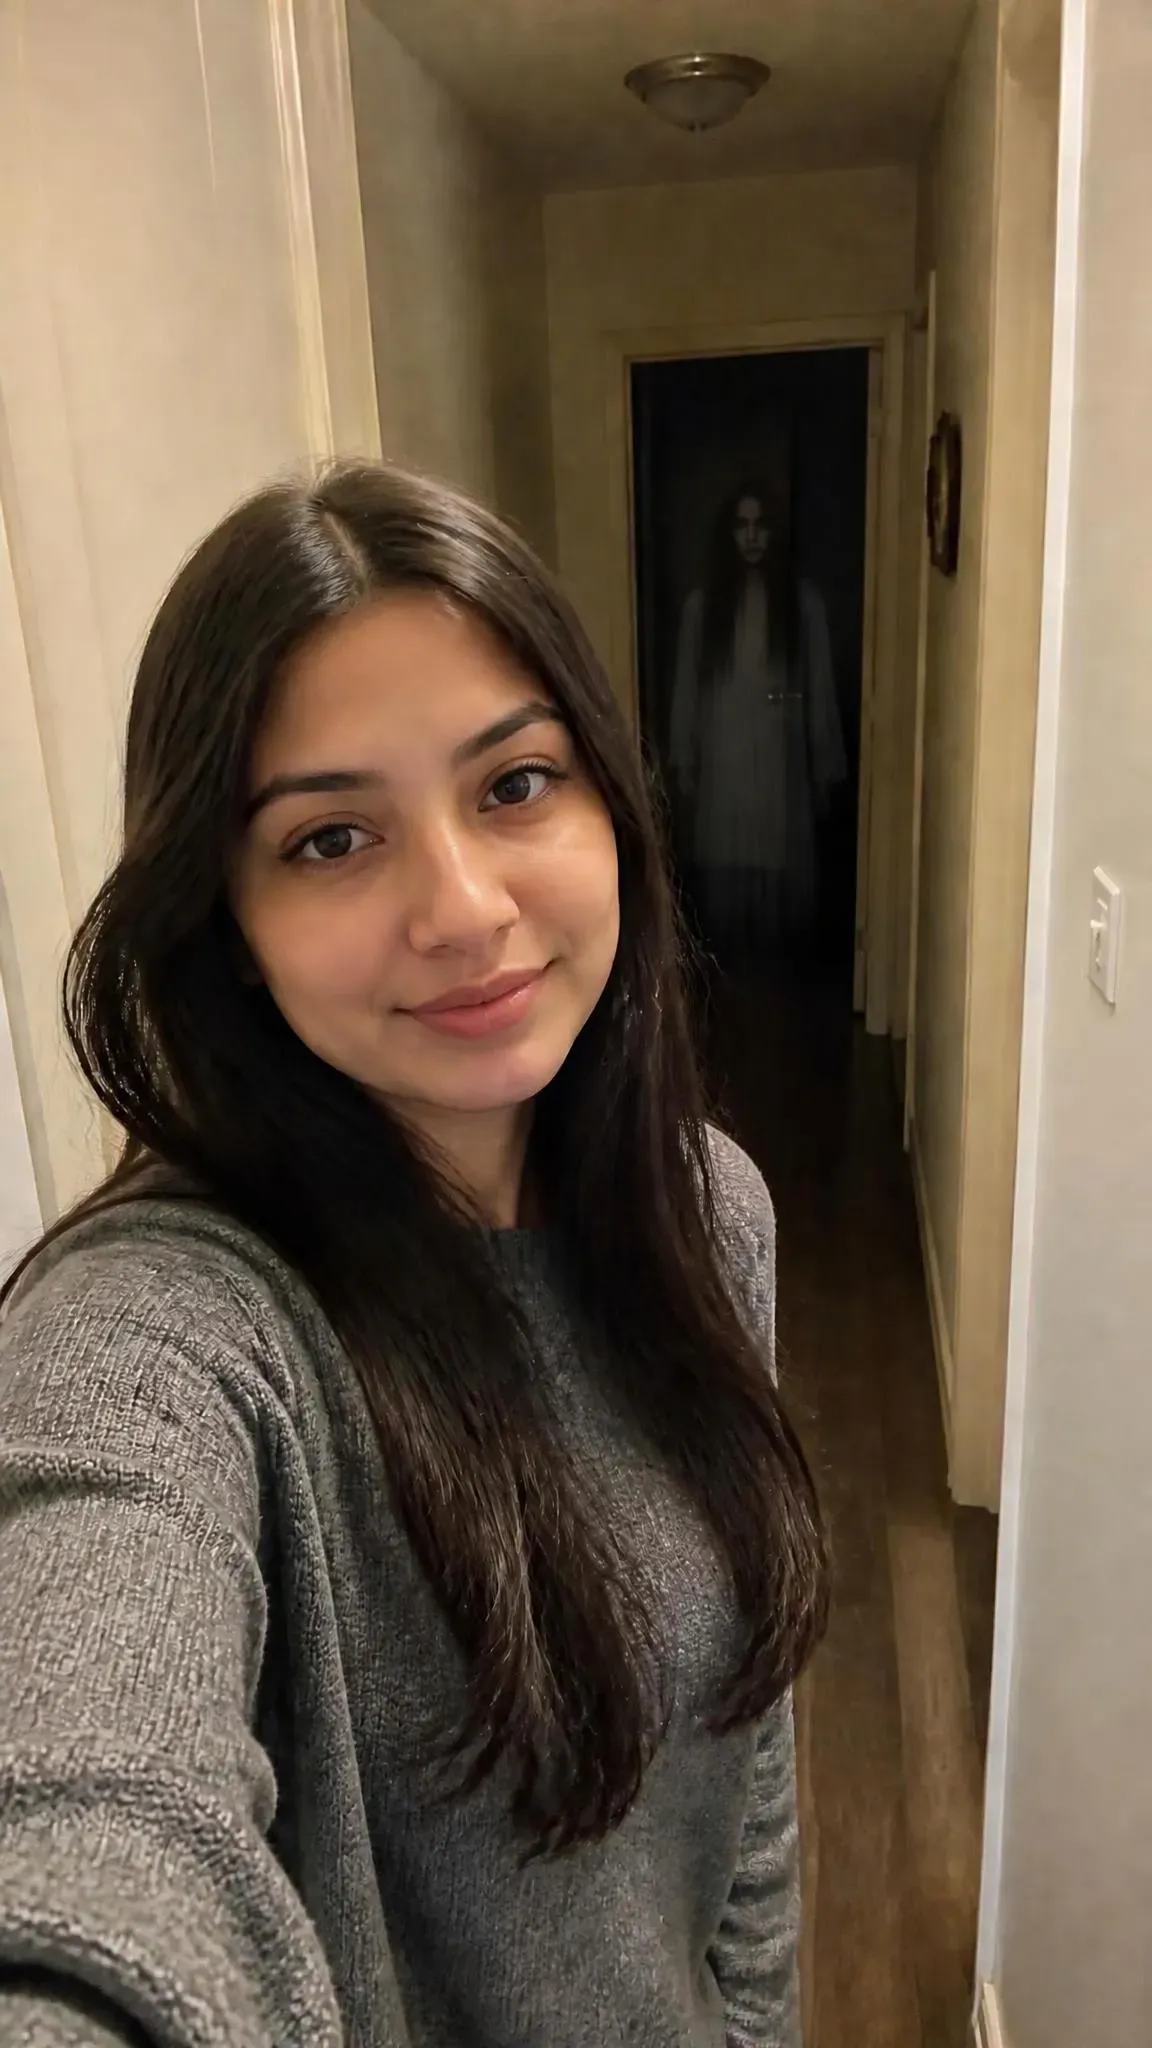
Etap 3: Animuj ducha za pomocą narzędzia AI
Przeprowadziłem 3 iteracje promptów w Veo 3.1, aby wygenerować tę sekwencję horroru, i test 3 jest tym, z którym jestem najbardziej zadowolony.
Oto wyniki:
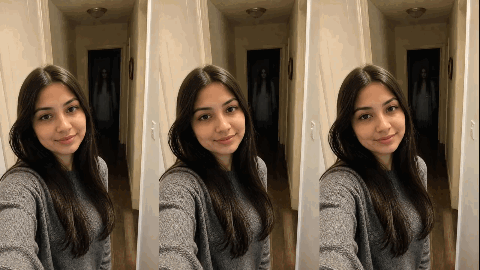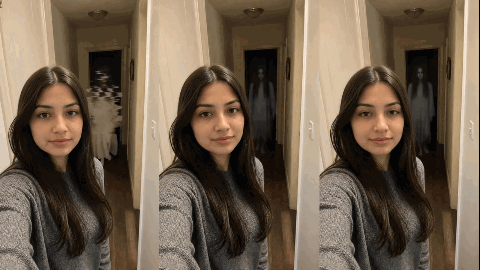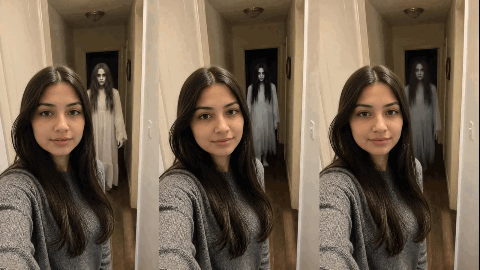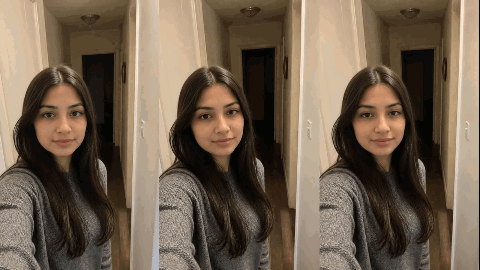
W filmie od lewej do prawej: test1, test2 i test3.
Na podstawie tego testu podsumowałem następujące kluczowe spostrzeżenia dotyczące promptów do tworzenia filmów z „duchem” AI:
1. Przezroczystość ducha kontra uprzedzenie do stałego aktora
- Używaj terminów optycznych: Opisowe słowa takie jak „duch” lub „zjawa” renderują nieprzezroczystych aktorów w białych ubraniach. Zastąp je fizycznymi deskryptorami optycznymi: słaba półprzezroczysta mgła, optyczna podwójna ekspozycja lub 5% do 10% krycia. Zmuś silnik dyfuzyjny do mieszania pikseli.
- Wymuś przejrzystość tła: Narzuć widoczność tła wprost: „Ściany korytarza i ościeżnica drzwi pozostają w 90% widoczne PRZEZ postać”. Zablokuj geometrię sceny bezpośrednio za bytem.
- Wyeliminuj szczegóły twarzy: Zablokuj rekonstrukcję twarzy. Wymagaj BRAKU wyraźnych oczu lub ostrych rysów twarzy. Powstrzymaj model dyfuzyjny przed odtwarzaniem kontrastowych konturów twarzy ze zdjęcia źródłowego.
- Kluczowe negatywne prompty: Wyeliminuj stałą geometrię ludzką i oświetlenie osadzone: solid human, opaque body, real actress, solid white dress, clear face, floor shadow
2. Dynamika manifestacji i ruchu
- Szybuj, nie chodź: Prompty chodzenia wyzwalają kinematykę nóg i symulację ubrań. Nakaz szybować do przodu cicho przez powietrze.
- Fazowanie i migotanie: Cienie otoczenia tworzą fałszywe zasłonięcie. Wymuś bezpośrednie zmiany alfa: migocze okresowo między 0% (niewidoczny) a 10% krycia. Wywołaj prawdziwą optyczną dematerializację w klatkach czasowych.
- Zakotwicz znaczniki znikania: Modele dyfuzyjne dryfują przy luźnych poleceniach rozpuszczenia. Zablokuj dokładne współrzędne osi czasu: „W sekundzie 6 całkowicie dematerializuje się w powietrzu, pozostawiając korytarz w 100% pusty przez ostatnie 2 sekundy”. Wymuś absolutną ciągłość tła po odejściu.
- Nagłe przeskoki (jump scares): Usuń stopniowe mieszanie. Wymagaj wstawienia w pojedynczej klatce: „Manifestuje się natychmiast w pojedynczej klatce w sekundzie X bez przejścia”. Wyeliminuj interpolację międzyklatkową i narastanie rozmycia ruchu.
3. Odległość przestrzenna i kadrowanie kamery
- Granice głębokości: Określ stałe ograniczenia odległości, takie jak
strictly remains 6 to 8 feet behind the subject, aby zapobiec przesuwaniu się postaci na skrajny pierwszy plan. - Naprawa błędu podwójnego telefonu: Zdefiniuj perspektywę jako
front-facing smartphone camera POV, camera handheld off-screeni dodajphone in hands, visible handsdo negatywnych promptów.
Modularne formuły promptów dla różnych estetyk ducha
Opierając się na wyżej wymienionym doświadczeniu, eksperymentowałem z tworzeniem filmów o tematyce ducha w różnych stylach. Potrzebujesz tylko ustrukturyzowanych formuł promptów, aby wyizolować zjawę, zachowując podobieństwo twarzy.
Użyj tej pięcioczęściowej modularnej formuły slotów w wielomodalnych silnikach obrazu i wideo:
Prompt = [POV Rig] + [Subject Anchor] + [Entity Optics] + [Entity Timeline] + [Negatives]
| Slot | Cel | Tokeny składni |
| POV Rig | Blokuje perspektywę poza ekranem; zapobiega generowaniu dodatkowego telefonu. | POV front-facing smartphone camera, camera off-screen, empty hands |
| Subject Anchor | Zamraża wyraz bazowy; zatrzymuje dynamiczny uśmiech i zniekształcanie twarzy. | neutral baseline expression, subtle blink only, no smile transitions |
| Entity Optics | Wymusza skrajną przezroczystość; usuwa ostre rysy twarzy. | 5%-10% opacity, see-through double exposure, no sharp face/eyes |
| Entity Timeline | Kontroluje ruch szybowania, głębokość przestrzenną, migotanie i czasowe wyjście. | glides 6-8ft behind, flickers 0%-10%, dematerializes cleanly at 6s |
| Negatives | Blokuje fizykę ludzką, nieprzezroczystą tkaninę, cienie i rekwizyty. | solid human, opaque cloth, sharp face, floor shadow, phone in hands |
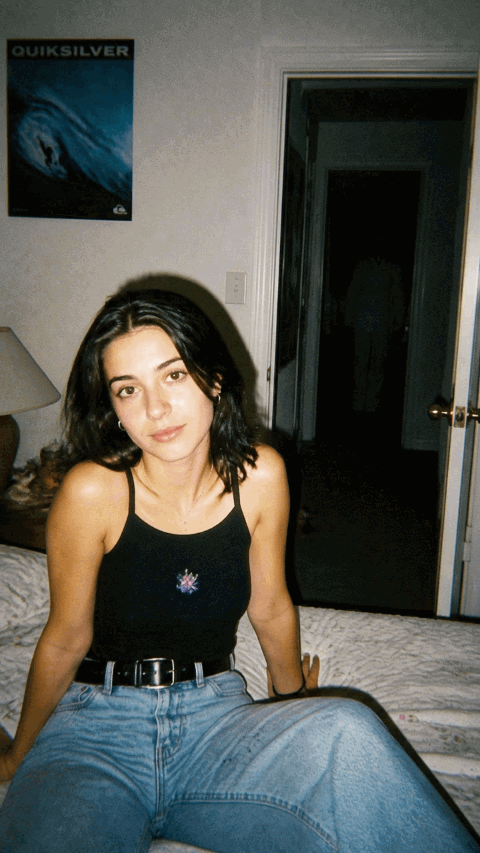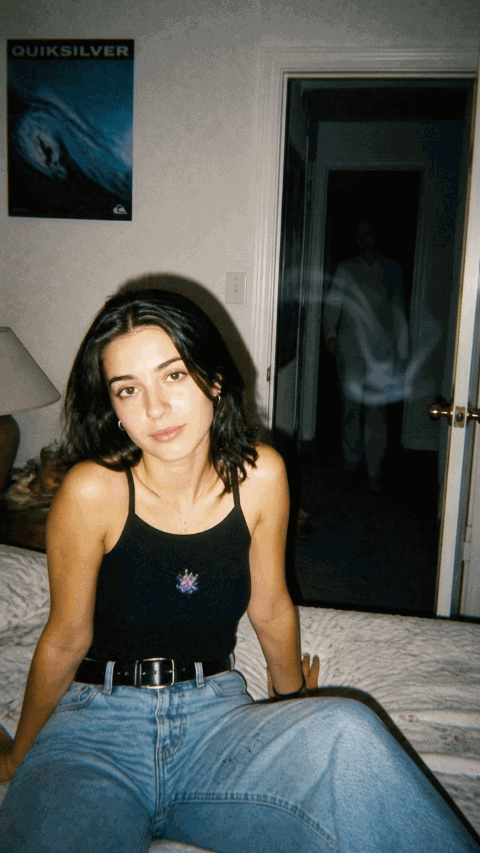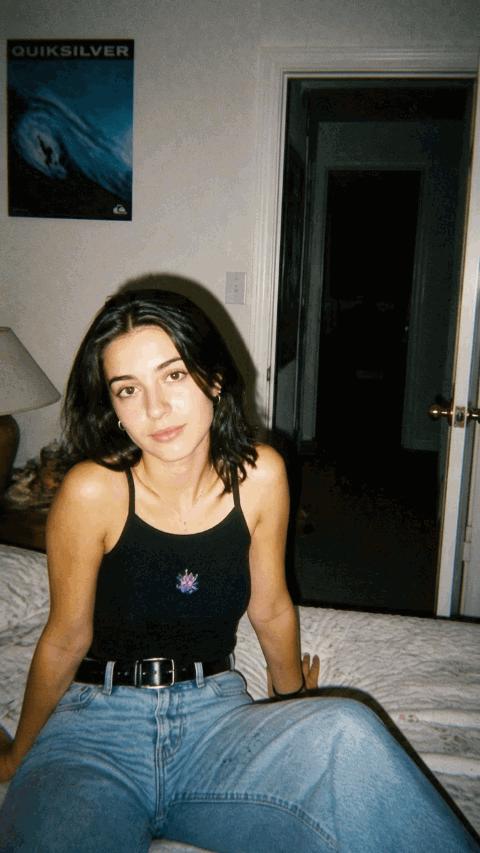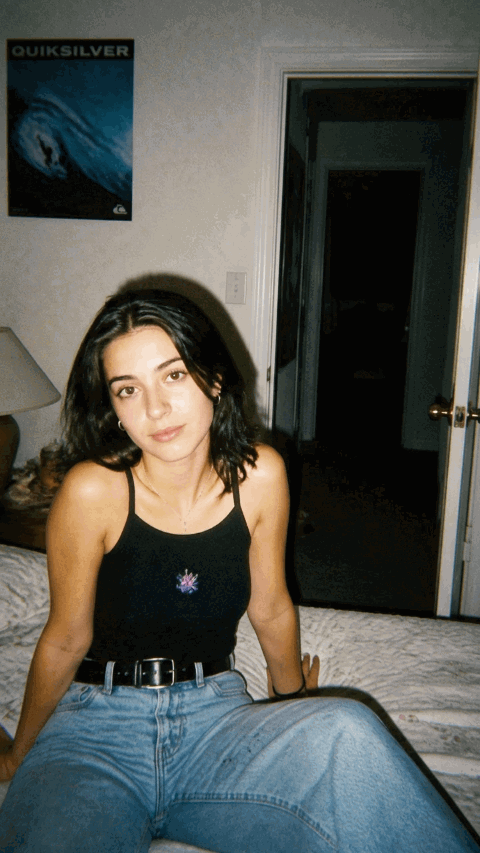
Styl 1: Lata 90. – jednorazowy błysk w sypialni – czający się
Fotografia z lampą błyskową typu point-and-shoot ukrywa szorstkie krawędzie generatywne. Ostre światło rzuca głębokie cienie na tylne ściany. To opadanie cienia daje twojemu promptowi filtra ducha czyste ugruntowanie przestrzenne.
Docelowy wygląd
Bezpośrednie oświetlenie lampą błyskową na aparacie, silne ziarno Kodak 35mm, ostre cienie na ścianach i ultradelikatny, przezroczysty widmowy miraż dryfujący po cieniach tła.
Formuła promptu do skopiowania
plaintext11996 point-and-shoot camera POV, direct disposable flash, harsh wall drop shadows, heavy 35mm grain. Camera handheld off-screen, no devices in frame. 2Foreground {SUBJECT_DESC}. Strictly locks baseline neutral expression, subtle blinks only; no smiling, no expression transitions. 3In {SPATIAL_ANCHOR}, a faint translucent {ENTITY_FORM} (strictly 5%-10% opacity, see-through double exposure). Background remains 90% visible through it. Soft-edged, no sharp facial features, no eyes, no cloned face. 4Entity {TRAJECTORY} without leg motion. Opacity flickers 0%-10%. At second {VANISH_TIME}, completely dissolves into dark air, leaving the area empty. 5Negative Prompt: solid human, opaque cloth, sharp eyes, cloned face, floor shadow, walking legs, phone in hands, smiling.
Styl 2: Wiktoriańska podwójna ekspozycja widmowa
Nowoczesne oświetlenie wnętrz często koliduje z gotycką estetyką. Formuła podwójnej ekspozycji omija ten problem, stylizując całą ramkę na zabytkową fotografię typu tintype. Daje to eteryczny, artystyczny portret ducha.
Docelowy wygląd
Monochromatyczne zarysowania dagerotypu, tekstury halogenków srebra i słaby duch podwójnej ekspozycji materializujący się poprzez błysk ekspozycji w tle.
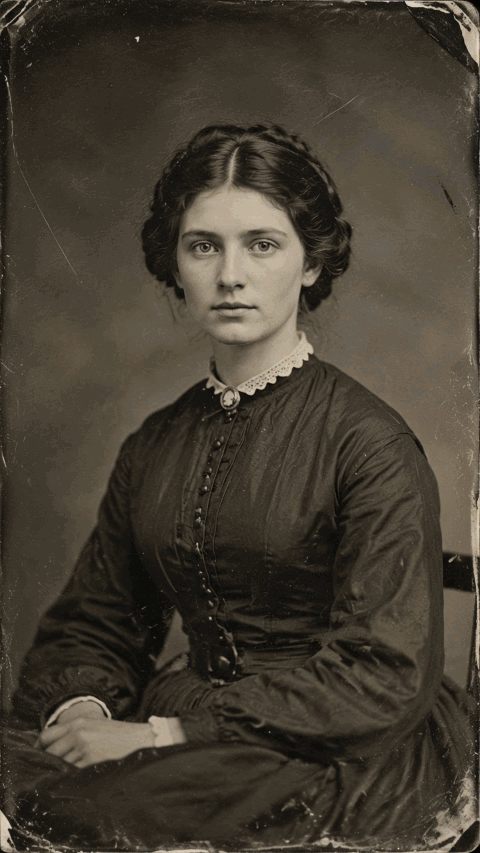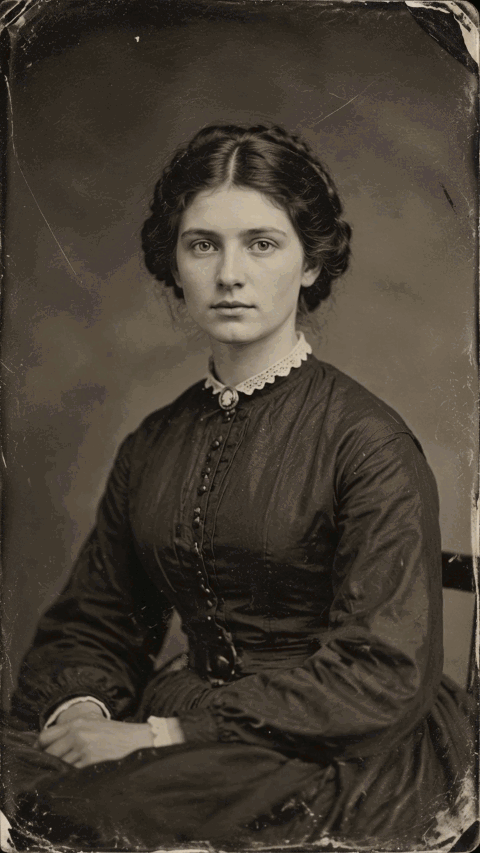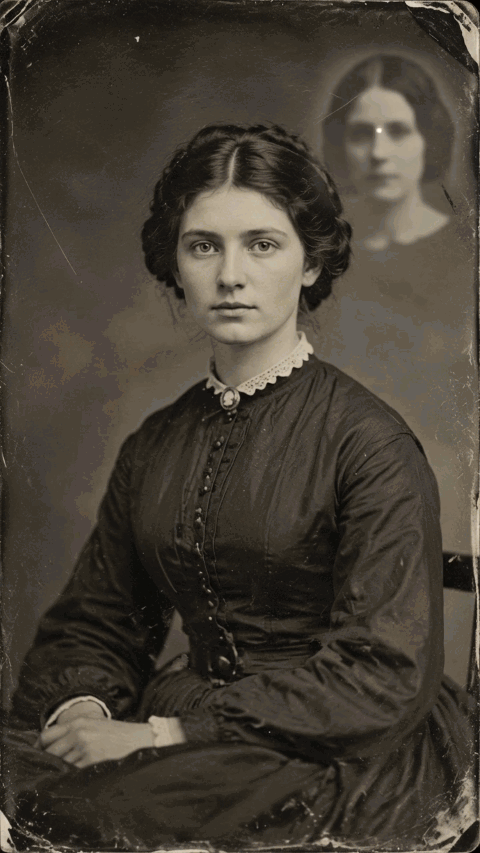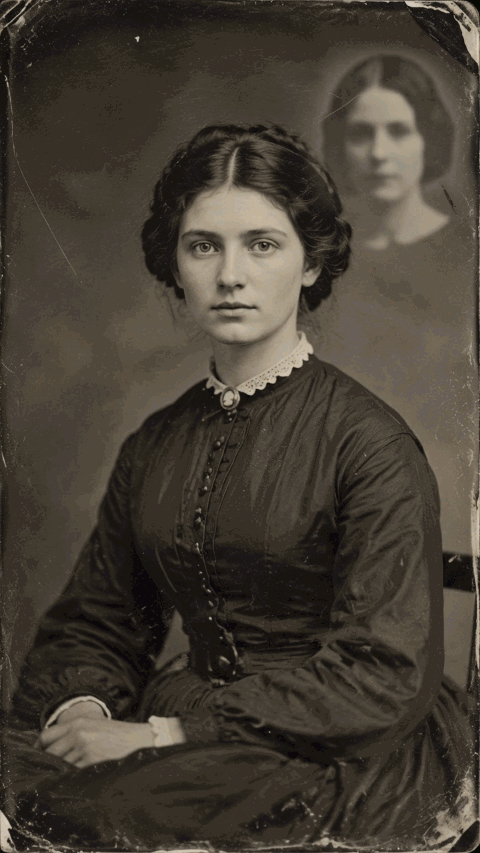
Formuła promptu do skopiowania
plaintext1Static 19th-century studio camera framing, authentic tintype aesthetic, silver halide grain, scratches, sepia tones. Zero camera movement. 2Foreground {SUBJECT_DESC}. Formal still pose, preserving exact facial identity from source image. Subtle breathing and slow eye blinks only. 3In {SPATIAL_ANCHOR}, an ultra-faint translucent ghostly haze (strictly 5%-10% opacity, double exposure effect). Blurry contour, NO sharp face, NO eyes. 4- 0 to {APPEAR_TIME}s: Subject sits calmly, background completely normal and empty. 5- {APPEAR_TIME} to {FLASH_TIME}s: Indistinct ghostly blur faintly drifts into view. 6- At {FLASH_TIME}s: Sudden bright magnesium flash fires, instantly freezing the scene into a static antique photograph for the remaining duration. 7Negative: solid human, sharp face, distinct eyes, modern digital lighting, color frames, moving after flash, cartoon.
Styl 3: Pełzający duch z kamery dzwonka w noktowizji
Materiał z monitoringu natychmiast wywołuje napięcie u widza w mediach społecznościowych. Niskorozdzielczy zielony lub szary szum kamery maskuje drobne artefakty czasowe podczas generowania wideo, co czyni ten styl idealnym dla wiralowych pętli z żartami.
Docelowy wygląd
Perspektywa kamery dzwonka, monochromatyczna noktowizja w podczerwieni, cyfrowy znacznik czasu i niesamowita blada obecność materializująca się i rozpuszczająca w cieniach odległego podwórka.
Formuła promptu do skopiowania
plaintext1Static 9:16 doorbell infrared night vision, digital sensor noise, timestamp overlay. Zero camera motion. 2Foreground {FOREGROUND_OBJ} remains completely frozen, empty, and unaltered throughout. 3In {SPATIAL_ZONE} only: an ultra-faint, barely visible translucent {ENTITY_FORM} (strictly 5% opacity, IR sensor artifact). Background remains 95% visible through it. NO clothing texture, NO hoodie, NO glowing eyes, NO distinct face. 40 to {APPEAR_TIME}s: {SPATIAL_ZONE} is completely empty. 5{APPEAR_TIME} to {VANISH_TIME}s: The faint entity drifts slightly, strictly locked {DISTANCE}. No walking steps, no forward approach. 6At {VANISH_TIME}s: Instantly dissolves into black shadows, leaving the scene 100% empty until end. 7Negative Constraints: solid human, real person, hoodie, clothes, walking legs, approaching steps, glowing eyes, intruder, burglar, solid silhouette.
Naprawa artefaktów AI i zachowanie podobieństwa twarzy w filmach z duchem
Modele dyfuzyjne wideo często blokują się na niewłaściwych pikselach twarzy podczas przetwarzania czasowego, zamieniając oczy w rozmyte zagłębienia lub rozciągając linie żuchwy. Te wizualne załamania psują realizm filmów z duchem AI. Możesz rozwiązać te błędy renderowania, izolując główny tryb awarii przed generowaniem klipów.
Macierz diagnostyczna dla filmów z duchem AI
| Artefakt wizualny | Główna przyczyna | Natychmiastowa poprawka operacyjna |
| Stały humanoid / aktor | Próg krycia ustawiony zbyt wysoko (>15%), wyzwalający syntezę nieprzezroczystej siatki. | Zablokuj krycie ściśle na 5%-10%; zastąp słowa opisujące ubranie zwrotami vapor glitch, optical smear lub double exposure. |
| Sklonowana twarz obiektu | Model dyfuzyjny zapożycza najsilniejszy token twarzy z kotwicy pierwszego planu. | Dodaj NO cloned face of subject, NO distinct eyes, no sharp facial features do slotu Optics. |
| Zbliżanie / ruch chodzenia | Model interpretuje ludzką postać jako fizycznego pieszego. | Dodaj locked distance, glides without leg motion, NO walking steps, no approaching steps. |
| Oddychanie ściany i sceny | Niezablokowana perspektywa czujnika. | Prompt zero camera motion, static camera framing, stationary background. |
Arsenał negatywnych promptów
Niekontrolowane modele wprowadzają losowe śmieci wizualne do scen o słabym oświetleniu. Wklej ten dedykowany blok negatywny bezpośrednio do swojego generatora, aby chronić geometrię twarzy i odfiltrować tekstury przypominające zabawki:
negative_prompt: [solid human, opaque body, real actor, walking legs, approaching steps, floor shadow, cloned face of subject, glowing eyes, hoodie, clothes texture, phone in hands, sudden smile, camera shake]
Blokowanie ziarna dla generowania iteracyjnego
Zmiana promptu bez zablokowania ziarna generowania niszczy spójność obiektu. Każde losowe ziarno odbudowuje cały układ przestrzenny, zmieniając linię żuchwy, włosy i ubranie obiektu. Skopiuj dokładne numeryczne ziarno z początkowej udanej generacji bazowej. Zablokuj tę liczbę całkowitą w ustawieniach generatora przed dostrajaniem umiejscowienia bytu, głębokości cienia lub wartości krycia. Ta blokada parametru izoluje zmiany w promptach do zjawy w tle, zachowując podobieństwo twarzy w każdym renderze testowym.
Ustawienia eksportu specyficzne dla platformy i wiralowe tempo dla TikToka i Reels
Piętnastosekundowe powolne palenie niszczy zasięg. Statyczne klatki wywołują przesunięcie w ciągu dwóch sekund. Algorytmy krótkich form przedkładają wskaźniki ukończenia i natychmiastowe odtwarzanie w pętli. Zjawy pojawiające się w ósmej sekundzie całkowicie tracą publiczność. Filmy z duchem o wysokiej retencji kompresują całą wizualną nagrodę w ścisłą sześciosekundową pętlę.
Ramy ujawnienia w trzy sekundy
Ustrukturyzuj os czasu swojego filmu wokół wiralowych zasad tempa, aby zmaksymalizować retencję i napędzać debaty w sekcji komentarzy:
| Znacznik czasu | Akcja wizualna | Psychologia widza |
| 0:00 do 0:02 | Normalna codzienna scena. | Widz skupia się na obiekcie lub czyta podpis. |
| 0:02 do 0:04 | Zjawa przesuwa się lub odwraca. | Widz wychwytuje ruch peryferyjny i wykonuje podwójne spojrzenie. |
| 0:04 do 0:06 | Obiekt pozostaje nieświadomy. | Widz odtwarza klip, aby zweryfikować anomalię wizualną. |
To wyczucie czasu wyzwala zaangażowanie algorytmiczne. Widzowie ponownie oglądają klip, aby zweryfikować ruch w tle. Wielu zatrzymuje się na poszczególnych klatkach lub kłóci się w komentarzach, czy materiał jest inscenizowany, co wypycha film do szerszej publiczności na TikToku i Reels.
Standardy kodowania technicznego
Algorytmy kompresji platformy degradują cienie o niskim kontraście i ciemne szczegóły korytarza. Zapobiegasz artefaktom kompresji, eksportując swój film z filtrem ducha AI przy użyciu ustawień eksportu specyficznych dla platformy:
- Rozdzielczość: 1080×1920 px (ścisły pionowy stosunek 9:16).
- Kodek wideo: H.264 w kontenerze MP4.
- Liczba klatek na sekundę: 24 fps lub 30 fps. Wyższe liczby klatek ujawniają syntetyczne wady ruchu.
- Docelowa przepływność: 15 do 20 Mbps stałej przepływności. Niskie zmienne przepływności powodują blokowe pasma w ciemnych rogach.
Sztuczka na wzrost dzięki karuzeli na Instagramie
Nigdy nie publikuj samodzielnych klipów na feedach Instagrama. Zbuduj karuzelę z dwoma slajdami.
Ustaw nieedytowane zdjęcie źródłowe na slajdzie 1. Wczytaj wyrenderowany film z duchem na slajdzie 2. Nakłoń widzów do przesunięcia w lewo w podpisie. Przesuwanie między niewinnym portretem a widmowym ujawnieniem rejestruje wiele zdarzeń interakcji. Algorytm wykrywa ten wysoki czas przebywania i ponownie wyświetla post nowej publiczności.
Wprowadzenie formuł w życie
Tworzenie hiperrealistycznych filmów z duchem AI sprowadza się do prostej równowagi: zablokuj tożsamość pierwszego planu za pomocą przestrzeni negatywowej, ogranicz krycie zjawy ściśle między 5% a 10% i pozwól, aby fizyczne wyczucie czasu opowiadało historię.
Niezależnie od tego, czy wybierasz ostry grynszpan lat 90. z jednorazowym błyskiem, artystyczny rozkład wiktoriańskiej podwójnej ekspozycji, czy niepokojący realizm glitchu inteligentnego dzwonka, ten dwuetapowy potok zachowuje nienaruszone podobieństwo twarzy, jednocześnie eliminując uprzedzenie do stałego aktora.
Wypróbuj te modularne formuły z własnymi promptami portretowymi i sprawdź, która estetyka sprawdziła się najlepiej na twoim feedzie!





