Większość twórców wybiera modele obrazu na podstawie statycznych rankingów Arena, by potem patrzeć, jak realistyczne portrety rozsypują się po trzech turach edycji. W tym realnym benchmarku GPT Image 2.5 vs Qwen Image 2.1 OpenAI wygrywa w fotorealizmie zero-shot, natomiast Qwen 2.1 prowadzi w stabilności strukturalnej tła przy kolejnych iteracjach.
Podsumowanie benchmarku empirycznego
| Metryka empiryczna | GPT Image 2.5 | Ocena | Qwen Image 2.1 | Ocena |
| Realizm zero-shot | Fotorealistyczna skóra i naturalne oświetlenie RAW | ★★★★☆ (4.5) | Ostre detale; nieco gładka/oleista skóra | ★★★☆☆ (3.0) |
| Stabilność wieloturtowa | Globalny szum i przesunięcia proporcji do tury 5 | ★★★☆☆ (3.5) | Zablokowane tło; zerowa degradacja strukturalna | ★★★★☆ (4.0) |
| Zachowanie materiałów | Autentyczna ciemna wełna i faktura cienia | ★★★★☆ (4.5) | Wysoki kontrast; ryzyko efektu glossy/plastiku | ★★★☆☆ (3.0) |
| Kontrola edycji | Wizualne punkty; pełne ponowne kodowanie kanwy | ★★★★☆ (4.0) | Malowane maski i natywne przezroczyste RGBA | ★★★★☆ (4.5) |
| Najlepsze zastosowanie produkcyjne | Materiały komercyjne high-end w jednym przebiegu | 4.1 / 5 | Workflow self-hosted i edycje z zablokowanym tłem | 3.6 / 5 |
Kluczowy wniosek
- GPT Image 2.5 doskonale radzi sobie z fotorealizmem w jednym ujęciu, renderując autentyczną półprzejrzystość skóry i dynamikę zbliżoną do RAW w pojedynczym renderze. Jednak jego pełne ponowne kodowanie kanwy powoduje globalną akumulację szumu i anatomiczne skrócenie perspektywy do tury 5.
- Qwen Image 2.1 wykorzystuje 32-warstwowy DiT z blokowaniem pamięci KV, aby geometria tła pozostawała całkowicie wolna od artefaktów w edycjach wieloturtowych. Kompromis tkwi w lokalnych przebiegach: powtarzane edycje masek docelowych mają tendencję do przesycania refleksów zwierciadlanych, przez co naturalna skóra staje się oleista, a matowe tkaniny błyszczące.
Wybierz GPT Image 2.5, gdy priorytetem jest nieskazitelny realizm w jednym ujęciu. Sięgnij po Qwen Image 2.1, jeśli Twój pipeline wymaga kontroli self-hosted, edycji z zablokowanym tłem lub natywnych wycinanek RGBA.
Fotorealizm jednego promptu: fizyka światła, faktury skóry i wierność materiałów
Twórcy korzystający z inżynierii promptów często spędzają godziny na dopracowywaniu promptów oświetleniowych, by odkryć, że wady wizualne wynikają z bazowego renderowania, a nie z iteracyjnych edycji. Testowanie wierności wizualnej zero-shot przed wydaniem instrukcji modyfikacji ustala istotny punkt odniesienia, pomagając fotografom odróżnić istniejące ograniczenia modelu od rzeczywistej degradacji przy edycji wieloturtowej.
Test 1: Mikrodetale ludzkiej skóry w ostrym świetle bezpośrednim
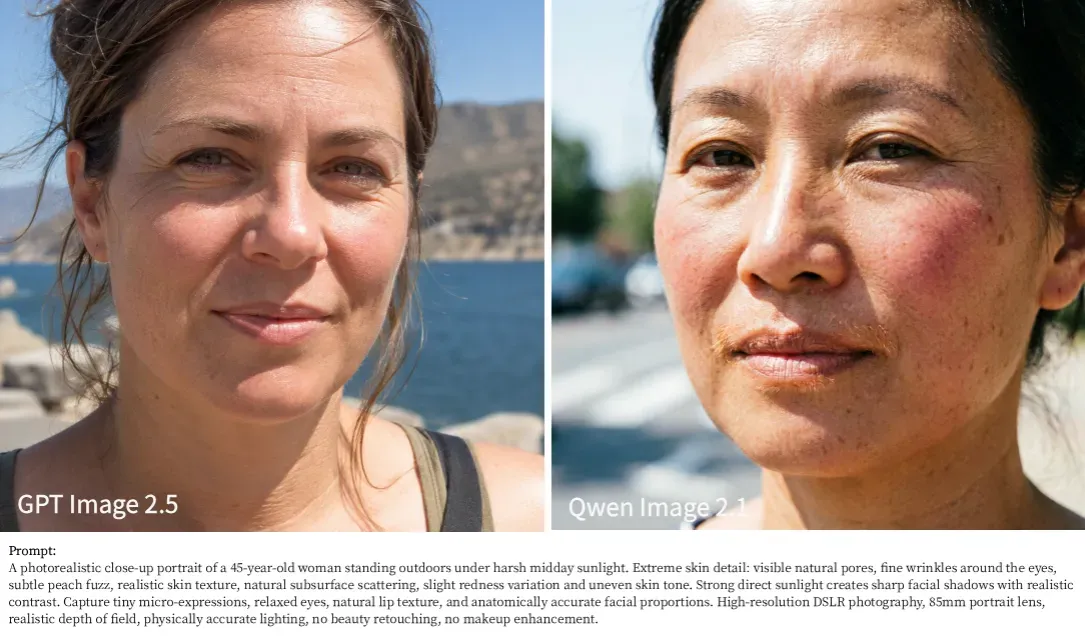
Aby ocenić mechanikę surowego renderowania w warunkach stresowych, oba modele przetestowano przy użyciu promptu zbliżenia portretowego bez retuszu, z intensywnym światłem południowego słońca, zróżnicowaniem faktury skóry i anatomicznymi mikroekspresjami.
Kluczowe obserwacje wizualne i rozbicie detali:
- Rozpraszanie podpowierzchniowe i przejścia cieni (wygrywa GPT Image 2.5):
GPT Image 2.5 symuluje fizykę optyczną z dużą dokładnością. W ustawieniu portretowym 85 mm światło rozprasza się naturalnie na policzkach i czole, tworząc autentyczne rozpraszanie podpowierzchniowe, któremu towarzyszy płynne przejście cienia wokół oczu i grzbietu nosa.
- Dosłowne trzymanie się promptu vs. plastyczność (kompromisy Qwen Image 2.1):
Qwen Image 2.1 ściśle reaguje na szczegółowe prompty, dokładnie renderując meszek na twarzy i nierówną pigmentację policzków. Jednak jego refleksy zwierciadlane mogą wydawać się zbyt ostre, pozostawiając sztuczny oleisty połysk na nosie i czole.
- Mikroekspresje i dokładność anatomiczna:
GPT Image 2.5 renderuje wyjątkowo rozluźnione mięśnie twarzy z anatomicznie precyzyjnymi zmarszczkami wokół oczu i fałdami warg. Choć Qwen 2.1 osiąga wysoką ostrość powierzchni, faktura skóry pokazuje powtarzalność mikrowzorców przy powiększeniu, ujawniając swoje syntetyczne korzenie dyfuzyjne w warunkach wysokiego kontrastu.
Test 2: Wierność tkanin i materiałów (chropowatość wełny vs. refleksy krawędziowe)
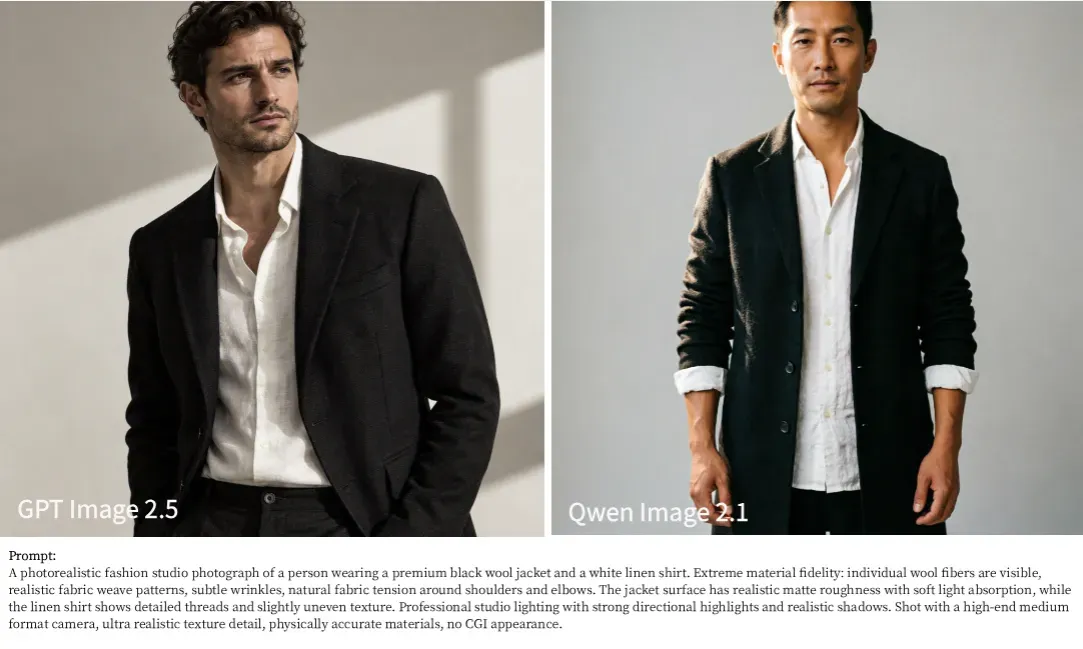
Zrozumienie fizycznych interakcji materiałów — takich jak absorpcja światła na matowej wełnie czy nierówna faktura splotu lnu — ma kluczowe znaczenie dla e-commerce i komercyjnych workflow modowych.
Kluczowe obserwacje wizualne i reakcja materiałów:
- Separacja ciemnej tkaniny i głębokość cienia (wygrywa GPT Image 2.5):
GPT Image 2.5 radzi sobie z niskoczęstotliwościowymi ciemnymi tonami bez utraty detali. Fałdy, szwy klap i subtelne mikrocienie pozostają widoczne na czarnej wełnianej kurtce, równoważone realistycznymi fakturami splotu i napięciem guzików na białej lnianej koszuli.
- Separacja krawędzi i precyzja oświetlenia krawędziowego (mocna strona Qwen Image 2.1):
Qwen Image 2.1 wykazuje wybitną kontrolę nad bezpośrednim oświetleniem kierunkowym. Światło krawędziowe wychwytujące brzegi ciemnego płaszcza wyraźnie podkreśla mikroskopijne włókna wełny wzdłuż ramion i rąk.
- Gęstość materiału i kompresja cienia (ograniczenie Qwen Image 2.1):
Choć Qwen 2.1 generuje wyjątkowo ostre zewnętrzne kontury, jego renderowanie ciemnej wełny skłania się ku kompresji cienia — zmiażdżonym czerniom w nieoświetlonych obszarach. Wewnętrzne fałdy kurtki tracą subtelne wzory splotu w porównaniu z warstwą Sunburst OpenAI, co daje płaską reakcję materiału w cieniu.
Test 3: Fotografia produktowa, szczotkowane faktury metalu i refleksy zwierciadlane
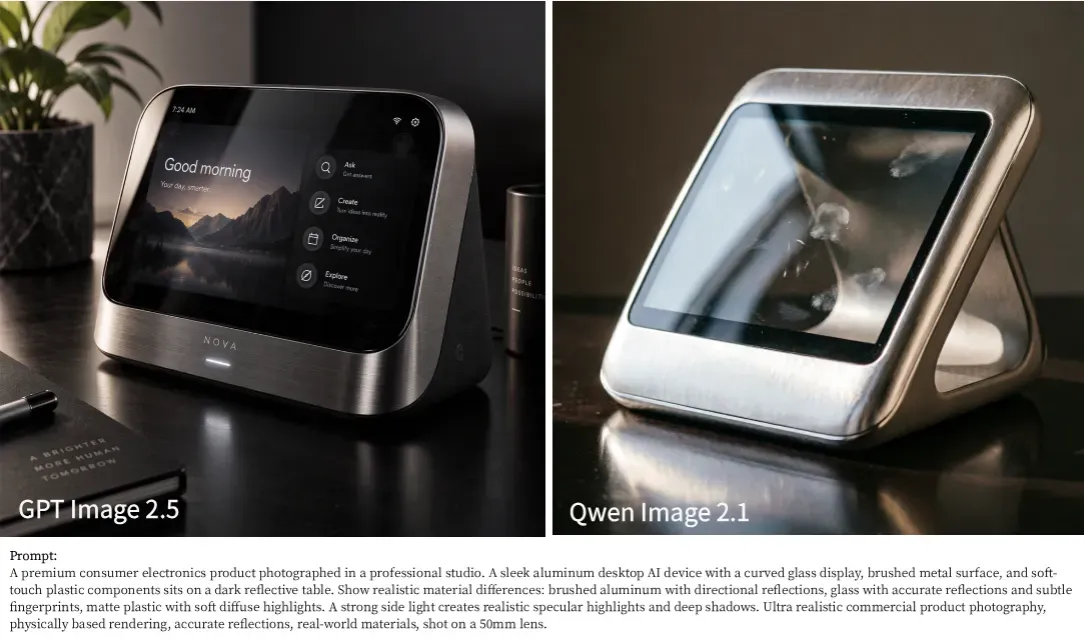
Ocena metalicznych refleksów zwierciadlanych, refrakcji szkła i odbić otoczenia pokazuje, jak wiernie model implementuje pipeline'y renderowania PBR w komercyjnej fotografii produktowej.
Kluczowe obserwacje wizualne i fizyka optyczna:
- Fizyka powierzchni metalicznych i refleksy anizotropowe (wygrywa GPT Image 2.5):
GPT Image 2.5 obsługuje szczotkowane aluminium z wysoką precyzją. Poziome ziarno na dolnej ramce odbija refleksy zwierciadlane naturalnie wzdłuż faktury, unikając płaskiego wyglądu malowanego metalu. W czytelny sposób nakłada też ostre elementy UI pod realistycznymi odbiciami szkła.
- Ostre krawędziowe refleksy zwierciadlane i smugi na szkle (mocna strona Qwen Image 2.1):
Zgodnie z hipotezą dla obiektów wzornictwa przemysłowego, Qwen Image 2.1 świetnie renderuje wysokokontrastowe refleksy zwierciadlane. Bezpośrednie odbicie softboxa na powierzchni szkła ma czystą, wyraźną geometrię granic. Model ściśle trzyma się też prośby o smugę odcisku palca, uchwytując mikroniedoskonałości na szkle z dużym efektem wizualnym.
- Zanikanie odbić na stole i rozróżnianie materiałów:
Choć Qwen 2.1 renderuje efektowne krawędzie refleksów, jego metalowa oprawa w zacienionych strefach skłania się nieco ku gładkiemu srebrnemu plastikowi. Dla kontrastu GPT Image 2.5 zachowuje wyraźne rozróżnienie materiałów między szczotkowanym metalowym przodem, ciemnym matowym plastikowym tyłem i błyszczącym szklanym wyświetlaczem, zachowując naturalne zanikanie refleksów na ciemnym blacie.
Test 4: Złożone środowiska HDR, dynamika i mgła atmosferyczna
Środowiska o wysokim kontraście, takie jak podświetlone ulice po deszczu z odbijającym się mokrym brukiem i głębokimi cieniami, wyraźnie ujawniają granice dokładności ekspozycji modelu.
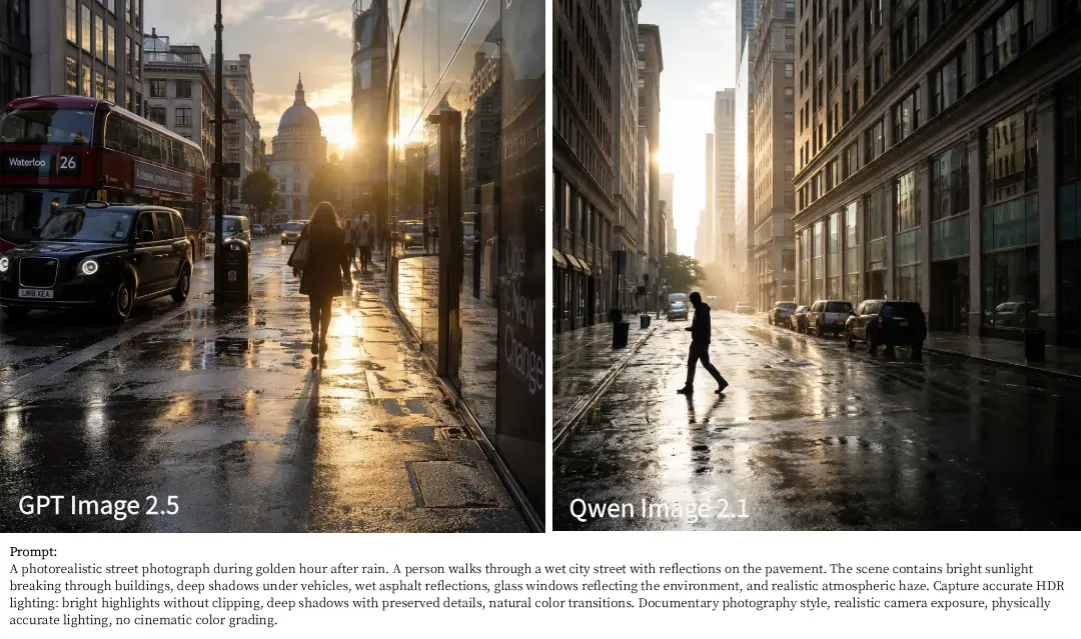
Kluczowe obserwacje wizualne i mechanika ekspozycji:
- Szeroka dynamika i zachowanie detali w cieniach (wygrywa GPT Image 2.5):
GPT Image 2.5 wykazuje wyższą emulację czujnika aparatu, naśladując ekspozycję RAW z pełnej klatki. Nawet przy bezpośrednim świetle złotej godziny przebijającym się przez architekturę tła zachowuje niezwykłe detale cieni pod piętrowym autobusem i czarną taksówką po lewej, renderując czytelny tekst tablicy rejestracyjnej i kontury opon bez przepaleń jasnych świateł na niebie.
- Wyrazistość odbić na bruku i ostrość krawędzi (mocna strona Qwen Image 2.1):
Qwen Image 2.1 świetnie renderuje wyraźne odbicia otoczenia. Mokry asfalt na pierwszym planie uchwytuje ostre jak brzytwa lustrzane odbicia przechodniów i wysokich kamiennych fasad. Jego ogólna klarowność geometryczna na złożonych oknach budynków pozostaje wyjątkowo czysta.
- Przepalenie świateł i zanikanie atmosferyczne:
Choć Qwen 2.1 renderuje efektowne smugi zwierciadlane na mokrym podłożu, jego mechanizm ekspozycji cierpi na łagodne przepalenia świateł w strefach intensywnego podświetlenia — dając czysto białe flary światła tam, gdzie słońce spotyka horyzont. Dla kontrastu GPT Image 2.5 obsługuje mgłę wolumetryczną i subtelne zanikanie złotego światła z wyższą dokładnością optyczną, unikając ostrych artefaktów przepalenia.
Tabela wyników podsumowujących: benchmark fotorealizmu (testy 1–4)
Aby zsyntetyzować nasze ustalenia z czterech rygorystycznych benchmarków fotorealizmu, poniższa tabela podkreśla, gdzie każdy model wyróżnia się w ośmiu krytycznych metrykach wierności wizualnej.
| Kategoria | GPT Image 2.5 | Qwen Image 2.1 | Kluczowa różnica optyczna |
| Pory skóry | ✓ | GPT 2.5 renderuje autentyczną mikrofakturę skóry i subtelne pory bez AI-owego airbrushingu. | |
| Mikroekspresja | ✓ | GPT 2.5 uchwytuje organiczne napięcie mięśni twarzy i ciepło, unikając sztywnych wyrazów. | |
| Głębokość cienia | ✓ | GPT 2.5 zachowuje detale ciemnych cieni pod pojazdami i budynkami z pełną dynamiką zbliżoną do RAW. | |
| Faktura tkaniny | ✓ | GPT 2.5 renderuje naturalny splot wełny i wyczuwalny organiczny meszek włókien bez nadmiernego wyostrzania. | |
| Refleksy zwierciadlane | ✓ | Qwen 2.1 tworzy wyraźne, wysokokontrastowe refleksy zwierciadlane na mokrym bruku i metalowych powierzchniach. | |
| Materiały produktowe | ✓ | GPT 2.5 osiąga fizycznie dokładną równowagę rozproszenia i odbicia w mieszanych matowych i błyszczących fakturach. | |
| Czyste krawędzie | ✓ | Qwen 2.1 świetnie radzi sobie z ostrymi liniami geometrycznymi, architekturą twardych powierzchni i definicją krawędzi. | |
| Naturalny realizm | ✓ | GPT 2.5 daje nieedytowany, dokumentalny wygląd kamery wolny od syntetycznego „AI-owego połysku”. |
Kluczowy wniosek z testów jednego promptu:
- GPT Image 2.5 — ogólny zwycięzca w fotorealizmie dokumentalnym: Dominuje w organicznej fizyce człowieka — skórze i wyrazach twarzy — złożonej głębokości cieni i naturalnej nauce koloru. Unika przepaleń w scenach o wysokim kontraście, co czyni go preferowanym wyborem do portretu komercyjnego, realistycznej fotografii ulicznej i projektowania edytorskiego.
- Qwen Image 2.1 — najlepszy do ostrej architektury i twardych powierzchni: Wykazuje wyjątkowy efekt wizualny dzięki ultra-czystym krawędziom, wyrazistym refleksom zwierciadlanym i precyzji architektonicznej, choć skłania się ku wyższemu kontrastowi optycznemu z okazjonalnymi przepaleniami świateł.
Test obciążeniowy edycji iteracyjnej wieloturtowej: benchmark degradacji w 5 turach
Dyrektywni kreatywni często patrzą, jak nieskazitelny portret AI zamienia się w rozmyte błoto po zaledwie trzech kolejnych poprawkach promptu. Aby ocenić wierność promptu w wielu krokach bez polegania na marketingowych twierdzeniach dostawców, oba systemy przeszły standaryzowany test obciążeniowy edycji w 5 turach.
Metodologia benchmarku 5-krokowego
Test obciążeniowy mierzył zachowanie obiektu, utrzymanie podmiany tła i utratę jakości w kolejnych turach w pięciu sekwencyjnych instrukcjach edycji:
- Tura 1 (bazowa): Fotorealistyczny portret człowieka o wysokim poziomie detali w ustawieniu studyjnym.
- Tura 2 (edycja obiektu): Zmiana koloru ubrania i materiału kurtki z zachowaniem tożsamości twarzy.
- Tura 3 (podmiana tła): Przeniesienie obiektu ze studia na zewnętrzną ulicę miejską o zachodzie słońca.
- Tura 4 (korekta oświetlenia): Przesunięcie źródeł światła otoczenia na wysokokontrastowe neonowe odbicia nocne.
- Tura 5 (dodanie mikrodetali): Dodanie realistycznych kropli deszczu i odbić wody na skórze.
Wydajność modeli w kolejnych turach
Ocena obu silników wizualnych tura po turze uwydatnia kluczowe różnice architektoniczne w sposobie akumulacji szumu przestrzeni ukrytej podczas retuszu wieloturtowego.
| Tura edycji | Wydajność GPT Image 2.5 | Wydajność Qwen Image 2.1 |
| Tury 1–2 | Nieskazitelne zachowanie obiektu i korekta faktury ubrania; naturalne opasanie światłem krawędziowym złotej godziny przy podmianie tła w turze 2. | Wyraźne zachowanie twarzy w turze 1; skuteczna podmiana tła w turze 2, choć opasanie światłem otoczenia i rozmycie tła wydają się nieco mniej organiczne niż w GPT 2.5. |
| Tura 3 | Płynne przejście z tłem i neonowym ponownym oświetleniem, z realistycznym odcieniem skóry i subtelnymi poświatami otoczenia. | Przesycone neonowe refleksy tworzące nienaturalnie oleistą, plastikową fakturę skóry twarzy. |
| Tura 4 | Czyste ponowne oświetlenie konturów twarzy; zachowanie matowej faktury bawełnianego płaszcza z subtelną wilgocią powierzchni. | Poważny rozpad materiału: matowy trencz zmienia się w nienaturalny błyszczący winylowy/plastikowy płaszcz przeciwdeszczowy. |
| Tura 5 | Rozszerzenie do pełnej sylwetki, ale z niezgrabnymi proporcjami ciała i nienaturalnym skróceniem perspektywy. | Dobrze proporcjonalne kadrowanie: renderuje anatomicznie dokładną pełnosylwetkową pozę kroczącą, choć utrzymujące się oleiste odbicia skóry obniżają ogólny realizm. |
Progresja iteracji wizualnej (benchmark 5 tur)
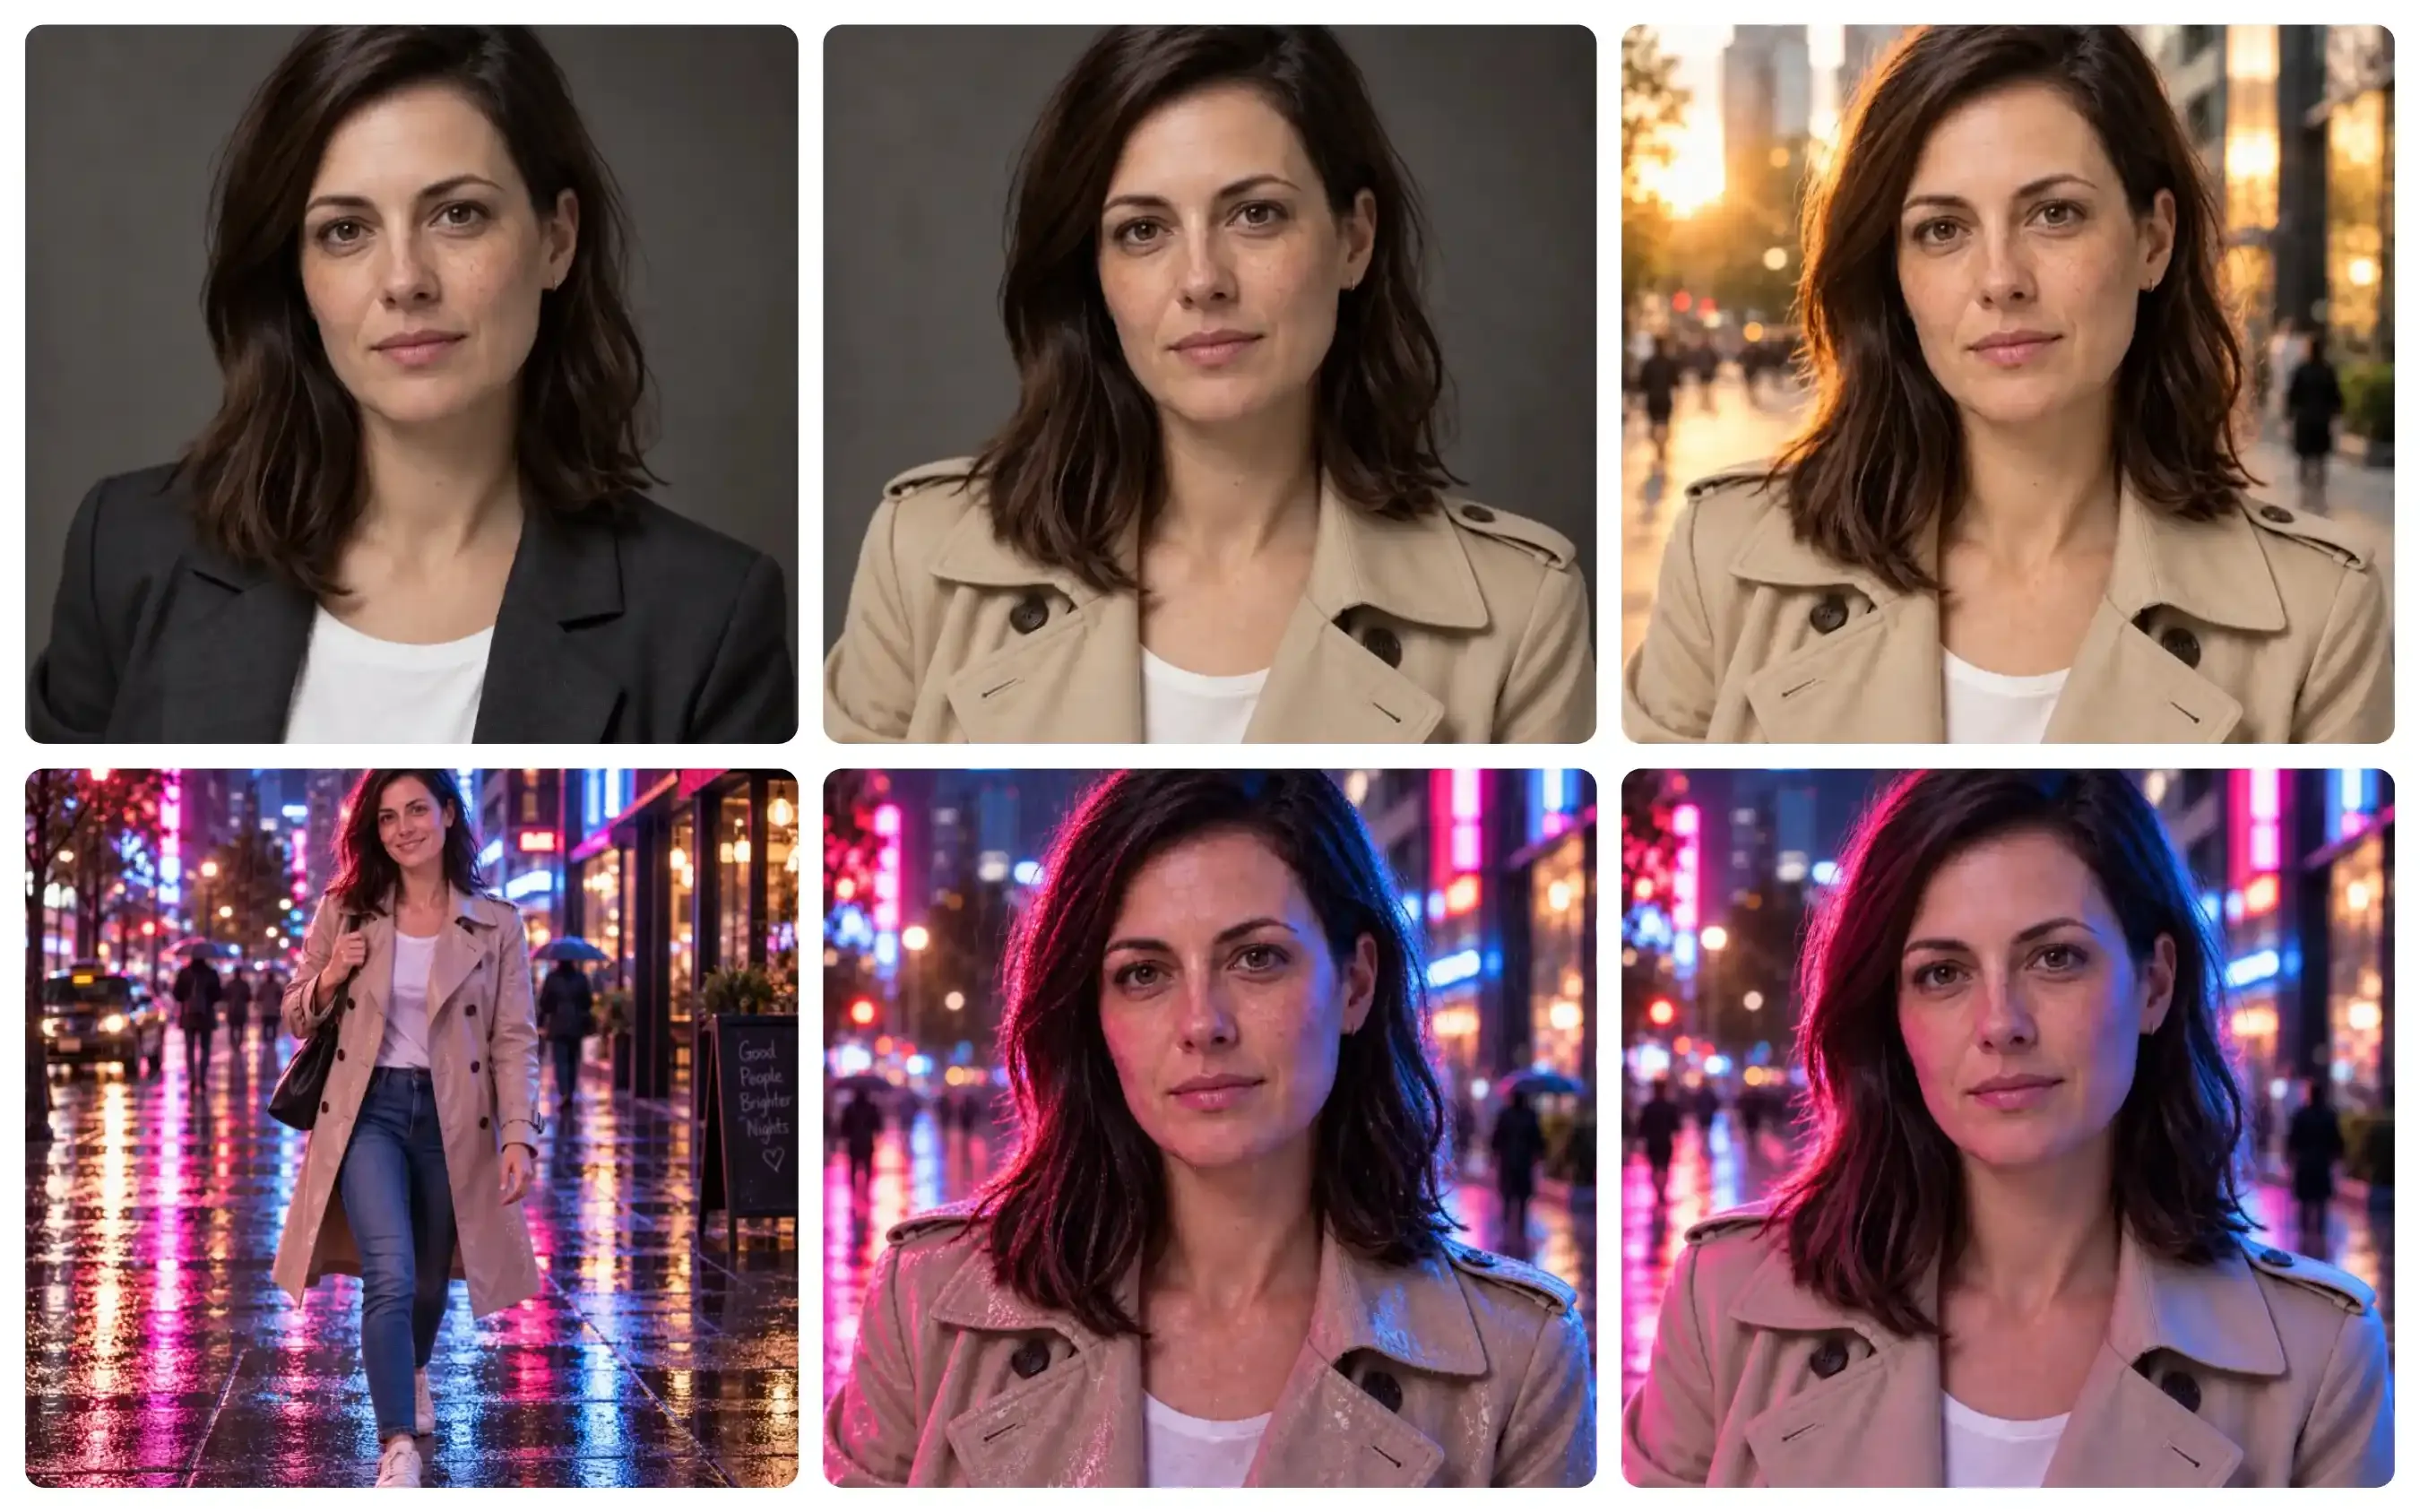
Sekwencja iteracji wieloturtowej GPT Image 2.5, panele 1–6, pierwszy obraz to obraz bazowy.
Podczas edycji iteracyjnej GPT Image 2.5 model Sunburst utrzymuje silną tożsamość twarzy i realistyczne opasanie światłem przez wszystkie tury. Naturalnie integruje złożone podświetlenie otoczenia podczas przejść z tłem i ponownym oświetleniem (tury 2 i 3), płynnie wtapiając obiekt w neonowe i złote środowiska bez artefaktów kompozycji czy rozpadu faktury tkaniny. Jednak przy rozszerzeniu do pełnej sylwetki w turze 5 wprowadza nieco zniekształcone proporcje ciała i niezgrabne skrócenie perspektywy.
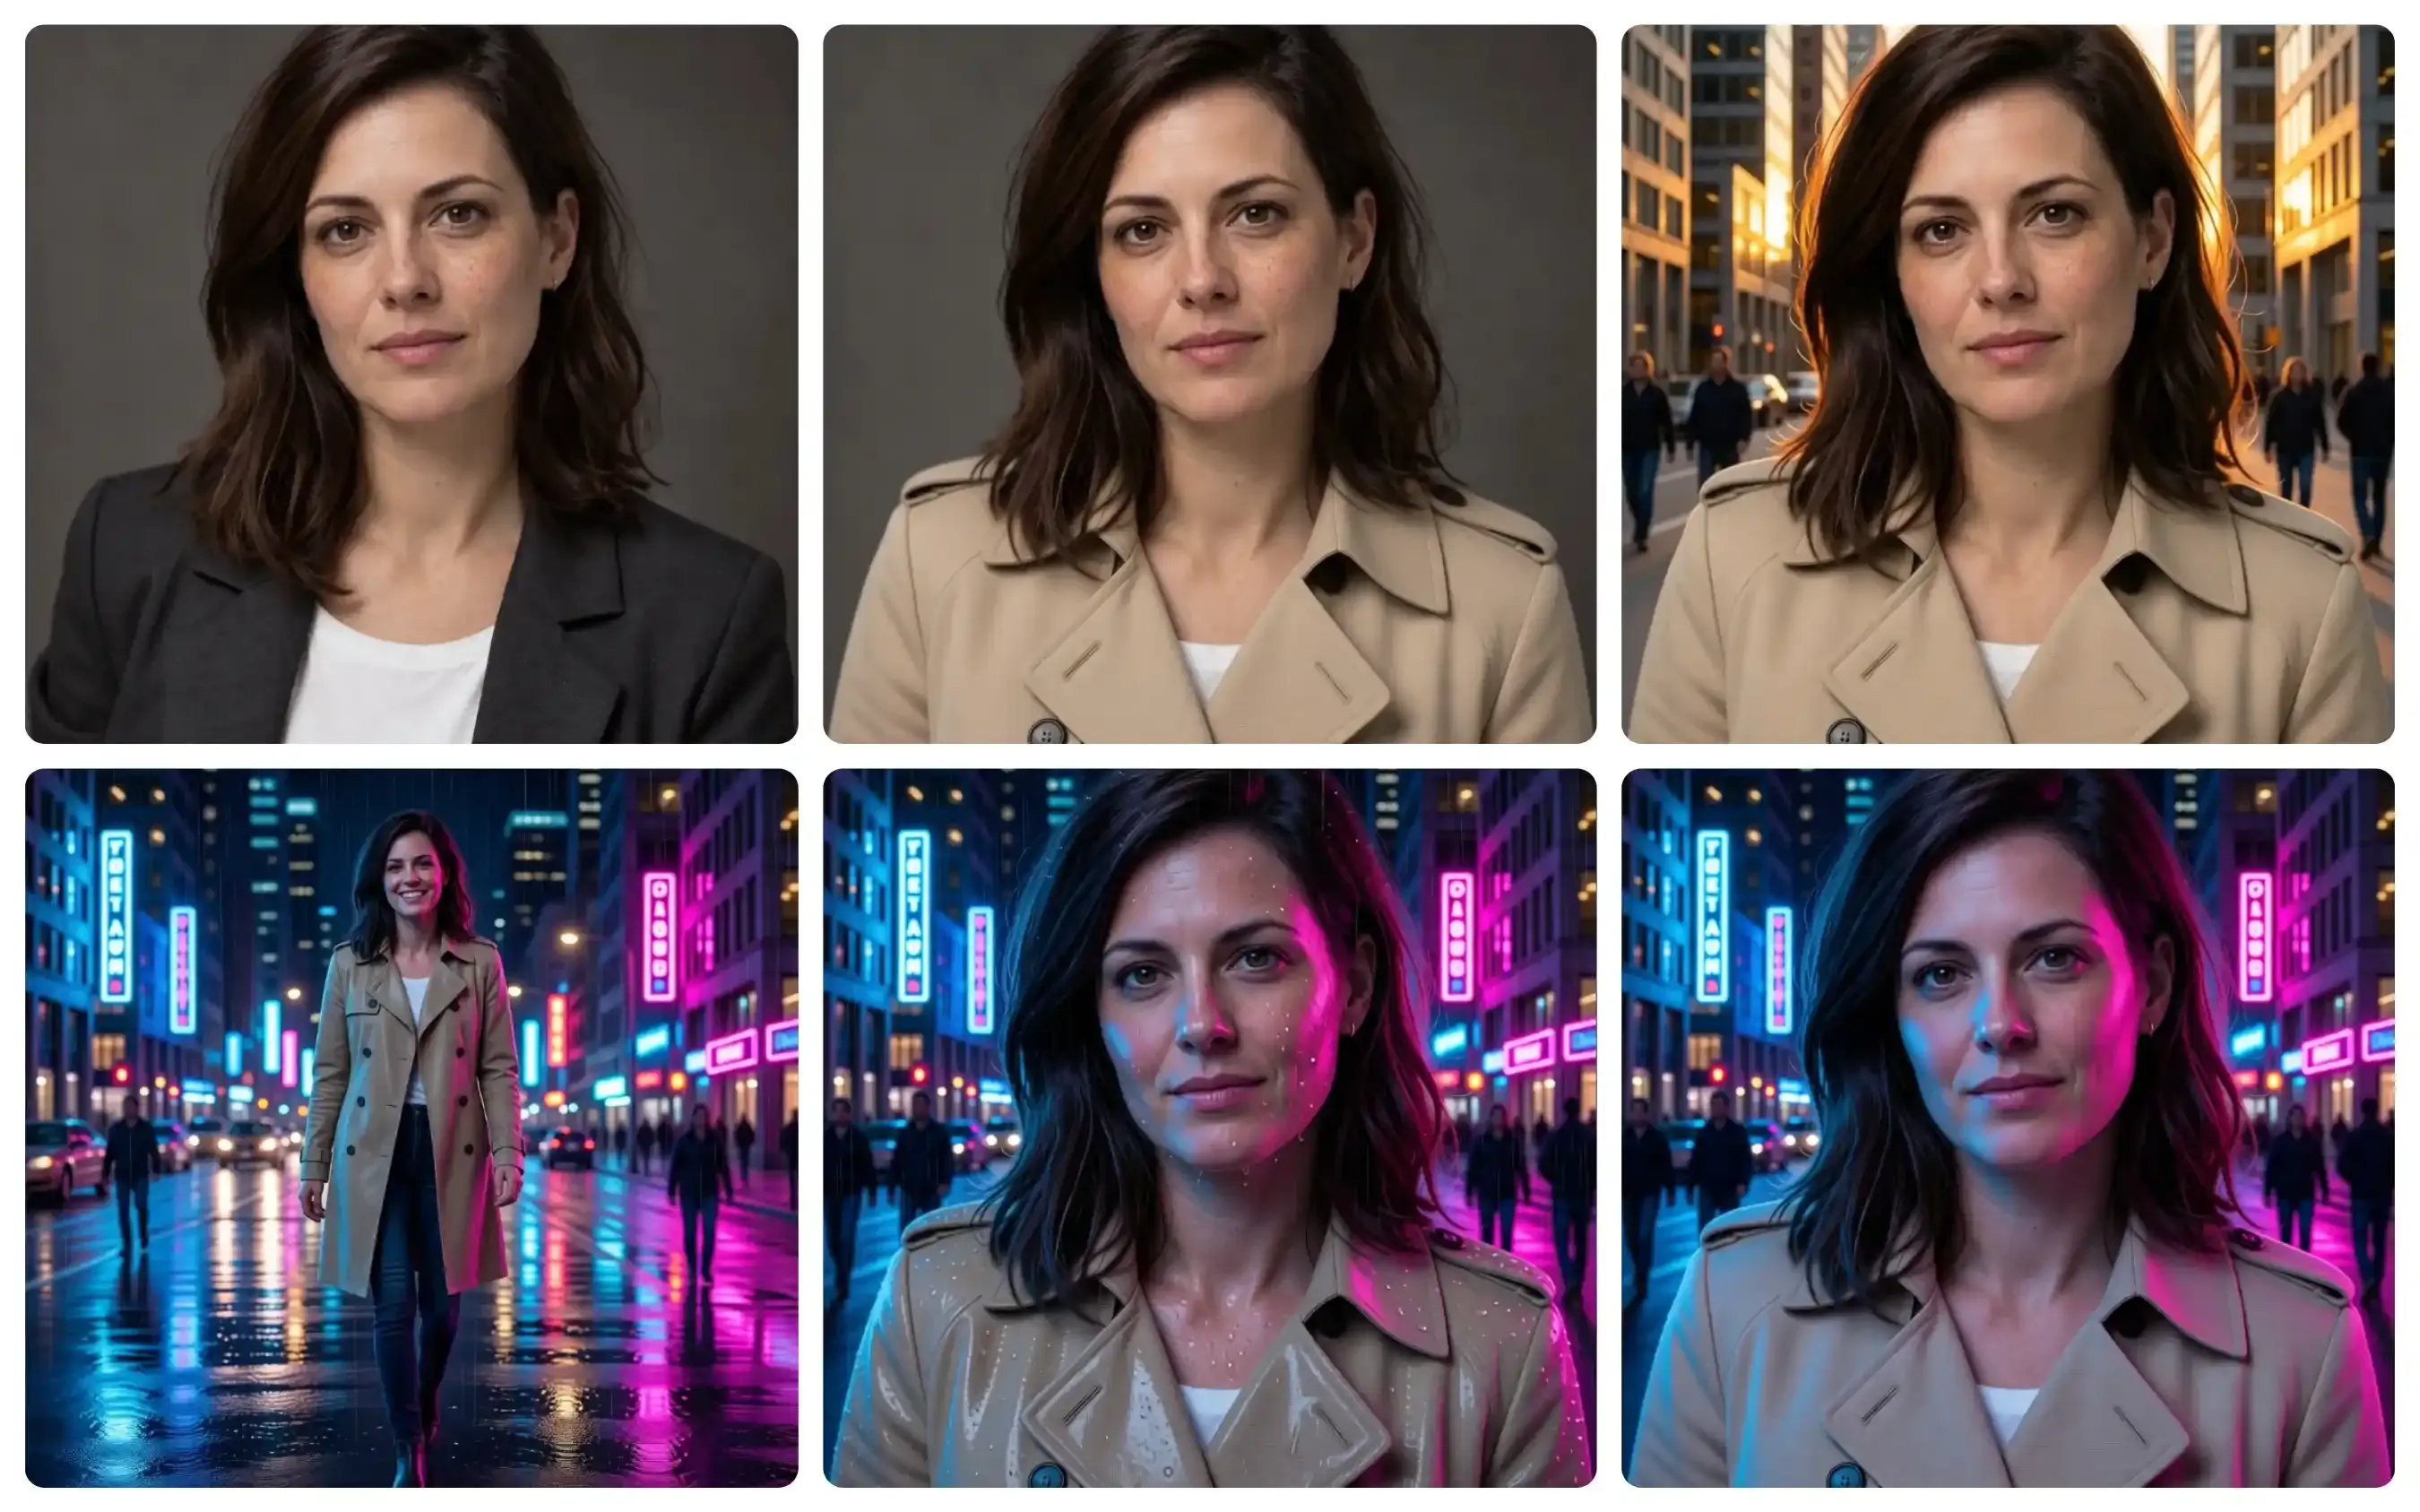
Sekwencja iteracji wieloturtowej Qwen Image 2.1, panele 1–6, pierwszy obraz to obraz bazowy.
Dla kontrastu Qwen Image 2.1 dobrze radzi sobie z początkowym zachowaniem obiektu i umieszczeniem tła, ale wykazuje zauważalny dryf przestrzeni ukrytej w miarę narastania edycji. Choć podmiana tła w turze 2 jest strukturalnie poprawna, jej integracja światła jest mniej subtelna niż w GPT. Kolejne przejścia z ponownym oświetleniem i deszczem (tury 3 i 4) wywołują zmiany materiałów, przekształcając bawełnianą fakturę ubrania w wysokopołyskujący plastikowy płaszcz przeciwdeszczowy wraz z przesyconymi refleksami skóry.
Zjawisko „klockowatych” artefaktów: dlaczego iteracyjna edycja obrazu pogarsza jakość
Powtarzane poprawki promptu często erodują mikrofaktury, zamieniając delikatne włosy w klockowate artefakty, przesycając odbicia skóry i mutując matowe tkaniny w błyszczący plastik. Ten wzorzec wynika bezpośrednio z fundamentalnych różnic architektonicznych w sposobie zarządzania transformacjami przestrzeni ukrytej przez silniki wizualne przy kolejnych edycjach.
Mechanika architektury vs. degradacja pikseli
| Parametr techniczny | Pipeline OpenAI GPT Image 2.5 | Framework DiT Qwen Image 2.1 |
| Metoda ponownego kodowania | Pełne ponowne kodowanie VAE kanwy | Ponowne użycie prefiksu pamięci KV i maskowanie fragmentów |
| Akumulacja szumu | Globalny dryf przestrzeni ukrytej | Ograniczona do lokalnych masek edycji |
| Obserwowany efekt w benchmarku 5 tur | Naturalne mieszanie światła otoczenia; subtelna globalna akumulacja szumu i przesunięcia anatomiczne/proporcji w późniejszych turach. | Wysoka sztywność strukturalna tła; lokalne ponowne przetwarzanie przestrzeni ukrytej powoduje przesycenie refleksów (oleista skóra) i rozpad materiału (bawełna w winyl). |
| Strategia mitygacji | Wydłużone próbkowanie (tryb Sunburst) | Uwaga o mieszanej granulacji i izolacja masek |
Powiązanie architektury z ustaleniami benchmarku
Zrozumienie, jak wybory architektoniczne wpływają na wieloprzebiegowy rozpad pikseli, bezpośrednio wyjaśnia wyniki naszego testu obciążeniowego w 5 turach:
- Pełne ponowne kodowanie przestrzeni ukrytej (GPT Image 2.5):
W workflow pełnoklatkowych GPT Image 2.5 ponownie koduje całą kanwę przestrzeni ukrytej podczas każdej tury edycji. Jak pokazano w naszych testach Fotorealizmu jednego promptu, to globalne podejście świetnie radzi sobie z obliczaniem złożonych interakcji optycznych — takich jak naturalne światło krawędziowe złotej godziny na włosach i skórze w turze 2. Jednak ponieważ każdy przebieg przetwarza całą kanwę, szum dyfuzyjny akumuluje się globalnie przez wiele tur. Do tur 4 i 5 powoduje to subtelną utratę detali wysokoczęstotliwościowych, makropikselową kwantyzację w cieniach i anatomiczne skrócenie perspektywy przy rozszerzaniu do pełnej sylwetki.
- Lokalne maskowanie i ponowne użycie pamięci podręcznej (Qwen Image 2.1):
32-warstwowa architektura Single-Stream DiT Qwen 2.1 wykorzystuje maskowanie na poziomie fragmentów i ponowne użycie prefiksu pamięci KV. Obliczanie statycznego kontekstu blokuje nieedytowane regiony podczas kroków odszumiania, eliminując utratę ponownego kodowania na pikselach tła i zachowując ostre jak brzytwa linie architektoniczne. Jednak ponieważ aktualizacje generatywne są ograniczone i mocno przetwarzane w lokalnych maskach, powtarzane przebiegi po tych samych podobszarach mają tendencję do przesycania refleksów zwierciadlanych — co wyjaśnia przejście do oleistych odbić skóry w turze 3 i zmianę materiału płaszcza z matowej bawełny w wysokopołyskujący winyl w turze 4.
Podczas gdy tryb Sunburst GPT Image 2.5 wykorzystuje wydłużone próbkowanie, aby utrzymać lepszą fizykę światła i organiczną fakturę skóry przez wczesne tury, jego globalne przetwarzanie z czasem powoduje subtelny dryf całej kanwy. Odwrotnie, Qwen Image 2.1 zapobiega degradacji geometrii tła, blokując nieedytowane tokeny przez pamięć KV, ale wymaga ostrożnego prowadzenia promptów, aby uniknąć lokalnego przesycenia refleksów podczas dłuższych łańcuchów retuszu.
Mechanika edycji i kontrola workflow: komentarze punktowe vs lokalne maskowanie
Zlecenie modelowi AI zastąpienia kurtki często kończy się przeprojektowaniem tła lub zmianą rysów twarzy. Precyzyjna mechanika danych wejściowych decyduje o tym, czy aktualizacja pozostanie lokalna, czy zepsuje resztę kompozycji podczas edycji iteracyjnych.
Porównanie GPT Image 2.5 vs Qwen Image 2.1 ujawnia dwa odrębne frameworki operacyjne do utrzymania wierności promptu w wielu krokach.
Interfejsy kontroli i mechanika danych wejściowych
| Możliwość | Narzędzia kanwy GPT Image 2.5 | System edycji Qwen Image 2.1 |
| Wybór celu lokalnego | Koordynaty punktów i pociągnięcia wektorowe | Malowane adnotacje, okręgi lub pliki masek binarnych |
| Zakotwiczenie obrazu referencyjnego | Obsługa do 16 obrazów referencyjnych | Obsługa do 10 obrazów referencyjnych |
| Izolacja pikseli | Pełnoklatkowy przebieg ponownego kodowania przestrzeni ukrytej | Prefiks pamięci KV z blokowaniem masek na poziomie fragmentów |
| Opcje wyjścia warstw | Standardowe wyjście RGB | Natywne generowanie przezroczystego RGBA |
Adnotacje punktowe vs maskowanie graniczne
OpenAI opiera się na koordynatach punktów i odręcznych pociągnięciach wektorowych w interfejsie ChatGPT. Umieszczanie koordynat punktów za pomocą funkcji edycji komentarzy ChatGPT sygnalizuje semantyczne aktualizacje tekstu w docelowych strefach, natomiast workflow prowadzony szkicem wykorzystuje narysowane linie wektorowe do kierowania geometrią układu. Połączenie zakotwiczenia obrazu referencyjnego z maksymalnie 16 obrazami wejściowymi utrzymuje spójność stylów obiektu w wariantach. Jednak ponieważ bazowy model ponownie koduje całą kanwę obrazu, nadal mogą wystąpić drobne wycieki pikseli poza koordynatami punktu.
Odwrotnie, Qwen Image 2.1 wymusza ścisłą edycję lokalnych masek, pozwalając użytkownikom malować adnotacje, rysować kolorowe okręgi wokół wielu celów edycji lub dostarczać osobne pliki masek binarnych. Jego wyróżniająca możliwość — natywne generowanie przezroczystego RGBA — pozwala twórcom generować lub edytować przezroczyste wycinanki bezpośrednio z prawdziwym kanałem alfa, z pominięciem narzędzi do usuwania tła w postprodukcji. Choć zakotwiczenie obrazu referencyjnego obsługuje do 10 obrazów wejściowych, zablokowanie nieedytowanych pikseli za wyraźnymi granicami masek daje wyższą dokładność intencji użytkownika i zapobiega niechcianym globalnym przesunięciom.
Praktyczne obejścia zapobiegające akumulacji artefaktów podczas wieloturtowych edycji AI
Patrzenie, jak dopracowany kompozyt komercyjny zamienia się w rozmyte piksele przy czwartej poprawce promptu, zmusza zespoły produkcyjne do wyrzucenia godzin postępu edycji. Wdrożenie ustrukturyzowanych obejść edycji wieloturtowej pozwala twórcom utrzymać klarowność obrazu i uniknąć degradacji pikseli w złożonych workflow poprawek.
Strategie produkcyjne dla czystych edycji obrazu AI
Zastosowanie czterech ukierunkowanych technik produkcyjnych pomaga zespołom zapobiegać degradacji obrazu AI podczas generowania wieloprzebiegowego:
- Ponowne zakotwiczenie referencji: Ponowne wstrzyknięcie oryginalnej generacji bazowej z tury 1 jako wyraźnego obrazu referencyjnego obok najnowszego promptu edycji zmusza model do ponownego wyrównania proporcji twarzy i wektorów oświetlenia tła. Ta technika ponownego zakotwiczenia obrazu referencyjnego pomaga zresetować dryf przestrzeni ukrytej w kolejnych przebiegach generowania.
- Strategiczny wybór poziomu precyzji: Wykonywanie szybkich szkiców wizualnych na GPT Image 2.5 Flare zmniejsza opóźnienie o 50% w porównaniu z wcześniejszymi modelami. Przełączenie na poziomy jakości Sunburst (
xhighlubmax) dla końcowych przebiegów edycji stosuje wydłużone czasy próbkowania, które zachowują złożone detale i ograniczają szum ponownego kodowania. - Izolowane lokalne maskowanie: Wykorzystanie edycji ograniczonych maskami Qwen Image 2.1 zamyka aktualizacje generatywne ściśle wewnątrz granic docelowych. Dostarczenie wyraźnej maski binarnej lub malowanej adnotacji zapewnia, że nieedytowane piksele tła całkowicie pomijają pipeline odszumiania, utrzymując oryginalną ostrość obrazu.
- Promptowanie złożone w jednym przebiegu: Połączenie wielu małych próśb o edycję w jedną skonsolidowaną instrukcję pozwala uniknąć wieloturtowego rozpadu jakości. Praktykowanie promptowania złożonego, aby zmienić kolor kurtki, środowisko tła i kąt oświetlenia w jednym kroku, zmniejsza łączną liczbę cykli ponownego kodowania.
Przestrzeganie tych praktycznych wskazówek do edycji GPT Image 2.5 pozwala projektantom dostarczać czyste edycje obrazu AI, które wytrzymują szczegółową kontrolę w wieloetapowych projektach komercyjnych.
Przewodnik po ostatecznej decyzji: który model wybrać do swojego workflow?
Wybór platformy generowania obrazu wyłącznie na podstawie statycznych wyników rankingów często prowadzi do wąskich gardeł produkcyjnych, gdy pojawiają się złożone poprawki klienta. Wybór najlepszego modelu AI do edycji zależy od tego, czy Twój zespół kreatywny stawia na komercyjną perfekcję zero-shot, czy na elastyczność open-weights w iteracyjnych pipeline'ach edycji.
Macierz porównania produkcyjnego
| Wymaganie workflow | GPT Image 2.5 (Sunburst / Flare) | Qwen Image 2.1 (7B DiT) |
| Podstawowe wdrożenie | Zarządzane API i UI ChatGPT | Open-weights self-hosted |
| Maks. natywna rozdzielczość | Wyjście API 4K (do 3840px) | Natywne wyjście 2K (2048px+) |
| Maskowanie i przezroczystość | Wizualne komentarze punktowe | Natywne naklejki przezroczystości (RGBA) |
| Kontrola kosztów wieloturtowych | Rozliczane API za generację | Darmowe uruchomienia lokalne na konsumenckich GPU |
Wybór na podstawie pipeline'ów produkcyjnych
Twoja konkretna konfiguracja techniczna decyduje o tym, który model zapewnia wyższą efektywność:
- Wybierz GPT Image 2.5, jeśli: Twój zespół prowadzi komercyjne pipeline'y fotorealizmu wymagające najwyższej klasy detali zero-shot, wyjścia API 4K i złożonego renderowania tekstu. Stworzony do high-end brandingu, plakatów reklamowych i płynnego użycia w sieci — jego poziomy jakości Sunburst zapewniają czyste oświetlenie i precyzyjną strukturę anatomiczną bezpośrednio przez interfejs ChatGPT lub zarządzane endpointy.
- Wybierz Qwen Image 2.1, jeśli: Potrzebujesz self-hostowanego modelu obrazu działającego lokalnie na sprzęcie konsumenckim bez kosztów API za generację. Działając jako architektura open-weights, daje programistom pełną prywatność danych, natywne naklejki przezroczystości poprzez 64-kanałowe generowanie RGBA i opłacalną kompozycję z wieloma referencjami z użyciem wyraźnych granic masek.
Ocena GPT Image 2.5 vs Qwen Image 2.1 względem infrastruktury Twojego studia zapewnia równowagę między początkową wiernością wizualną a długoterminowymi kosztami operacyjnymi.


