Qwen Image 3.0 pro Identity Preserving Edits
Qwen Image 3.0 pro est la famille de génération et d’édition d’images de Qwen destinée aux développeurs qui créent des workflows visuels prêts pour la production. Elle génère des images jusqu’à 2048×2048, réécrit automatiquement les prompts, sélectionne la résolution en fonction de l’intention du prompt et suit les instructions d’édition en langage naturel tout en préservant les traits du visage et l’identité. Accédez aux deux modèles via Atlas Cloud avec une seule clé compatible avec OpenAI et une tarification standard à l’usage de $0.04 par appel. Commencez à développer dès aujourd’hui.
Qwen Image 3.0 Pro est développé par Alibaba. Atlas Cloud (exploité par Atlas Cloud AI LLC) en fournit l’accès mais n’en est pas propriétaire. Toutes les marques appartiennent à leurs détenteurs respectifs.
Explorez les Modèles Leaders
Atlas Cloud vous offre les derniers modèles créatifs de pointe de l'industrie.


Qwen Image 3.0 pro — modes de génération et d’édition
Comparez les endpoints de conversion texte-image et d’édition basée sur des références disponibles pour Qwen Image 3.0 pro.
| Modalité | Description |
|---|---|
| Qwen Image 3.0 Pro API (Text to Image) | Transformez des prompts textuels en images jusqu’à une résolution de 2048×2048, avec reformulation automatique des prompts et sélection de la résolution guidée par le prompt. Le rendu précis de textes complexes et le respect fidèle des prompts prennent en charge les affiches, les visuels de produits, les illustrations et autres ressources sensibles à la composition. |
| Qwen Image 3.0 Pro API (Image Editing) | Fournissez une à trois images de référence ainsi qu’une instruction en langage naturel pour produire une image retouchée. Les détails essentiels, tels que les traits du visage et l’identité, sont préservés tandis que les modifications demandées sont appliquées, ce qui rend cet endpoint adapté au perfectionnement de portraits, aux variations visuelles et aux mises à jour contrôlées de ressources. |
Dans Qwen Image 3.0 pro : typographie, détail et contrôle
Qwen Image 3.0 pro combine le rendu de textes complexes, le respect précis des prompts, la génération jusqu’à 2048 × 2048, la réécriture automatique des prompts et les modifications préservant l’identité à partir de one à three références via l’API unifiée à l’usage d’Atlas Cloud.
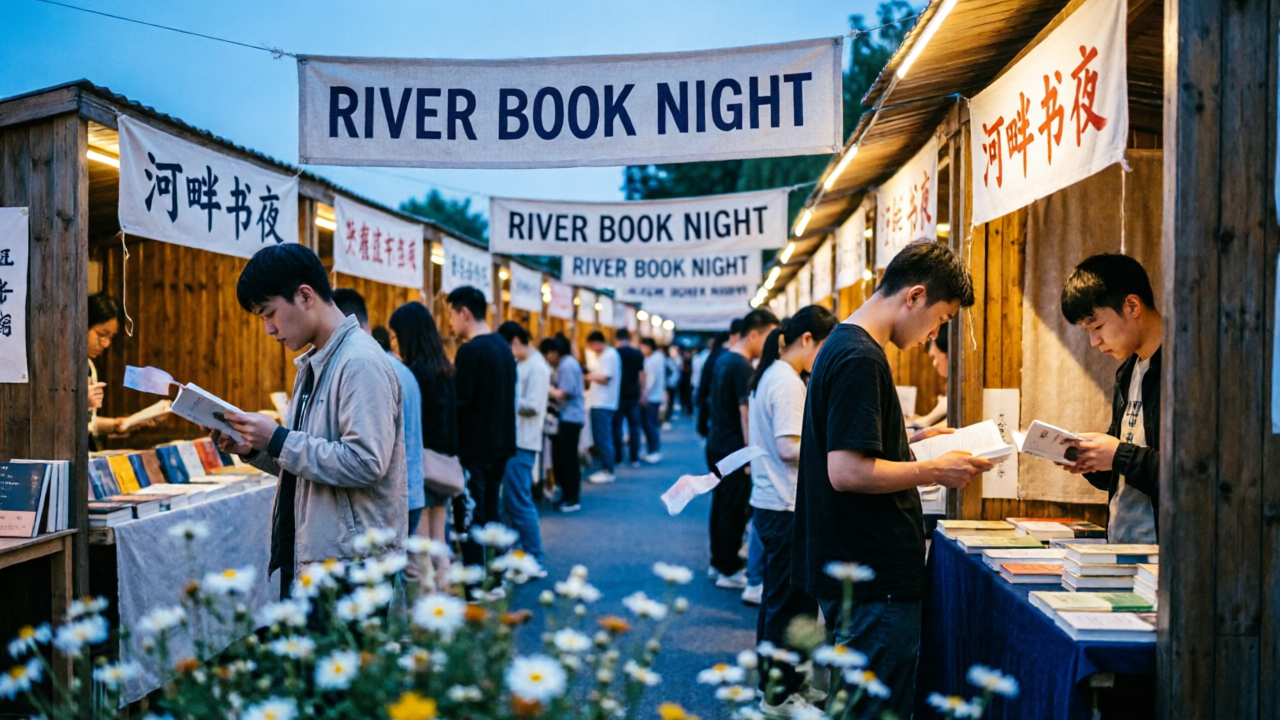
Typographie de Qwen Image 3.0 pro
Qwen Image 3.0 pro suit des prompts détaillés tout en gérant le rendu de textes complexes en anglais et en chinois. Il peut structurer des mises en page créatives denses sans dissocier le texte de la scène. Spécifiez le contenu, la hiérarchie, la composition et le style visuel dans une seule requête, puis vérifiez les noms et les chiffres avant publication. Cela le rend adapté aux bannières, aux visuels éditoriaux, aux concepts de packaging et aux créations riches en informations.
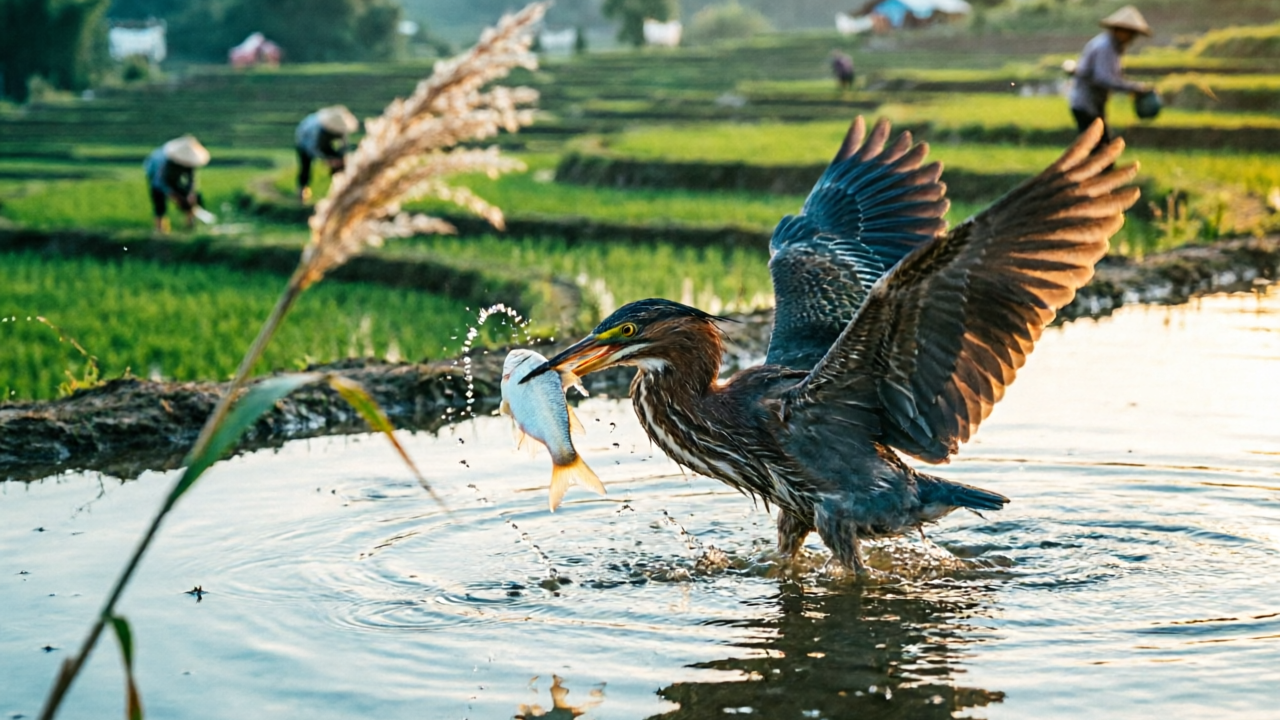
Détails en 2048 × 2048
Générez des images avec des résolutions allant jusqu’à 2048 × 2048 lorsque les textures fines et les détails lisibles sont importants. La sélection de la taille guidée par le prompt peut choisir automatiquement une résolution de sortie, tandis qu’une taille explicite vous permet de cibler un canevas défini. De la photographie de produit aux portraits éditoriaux, ce budget de pixels supplémentaire facilite l’inspection détaillée, les recadrages flexibles en aval et la création d’éléments prêts pour la production.
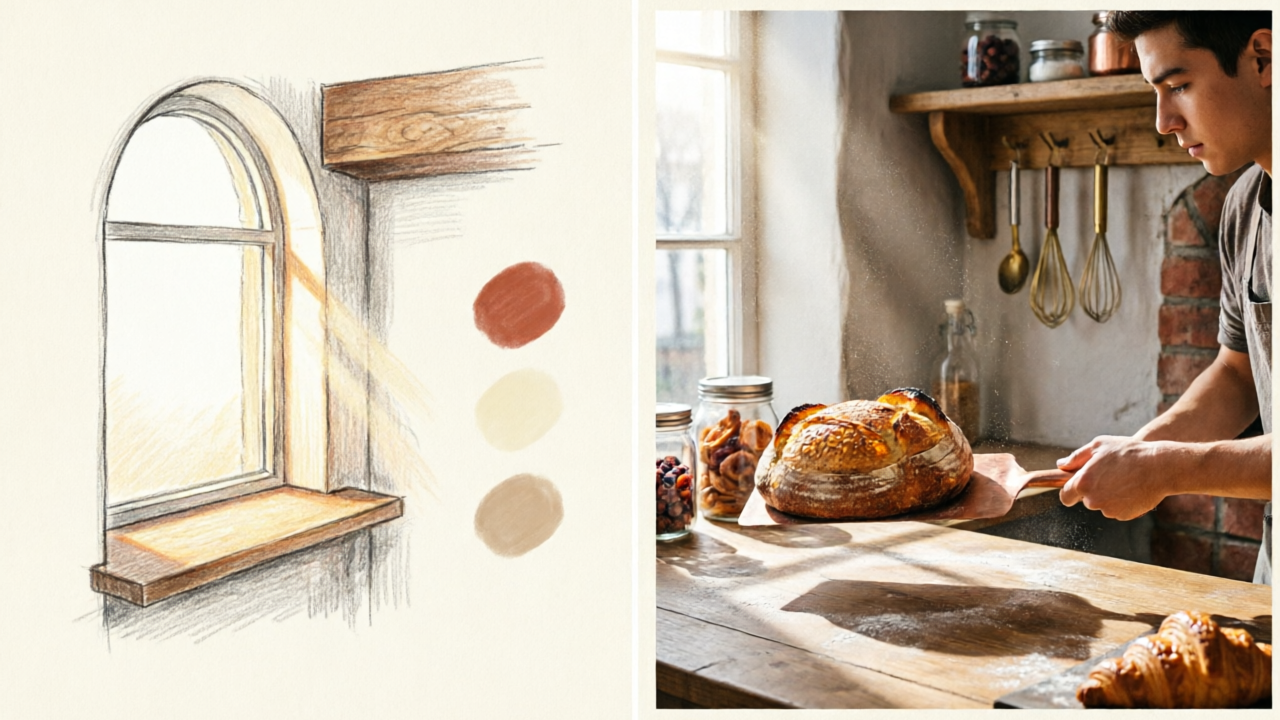
Two Prompt Rewrite Modes
Les prompts courts peuvent être automatiquement développés avant la génération, la réécriture étant activée par défaut. Sur le text generation endpoint, le mode Direct effectue une seule passe de réécriture, tandis que le mode Agent utilise un pipeline agentic pour enrichir le brief. Laissez la réécriture activée pour explorer des concepts ou désactivez-la lorsque la formulation exacte et des instructions strictement contrôlées sont prioritaires en production.
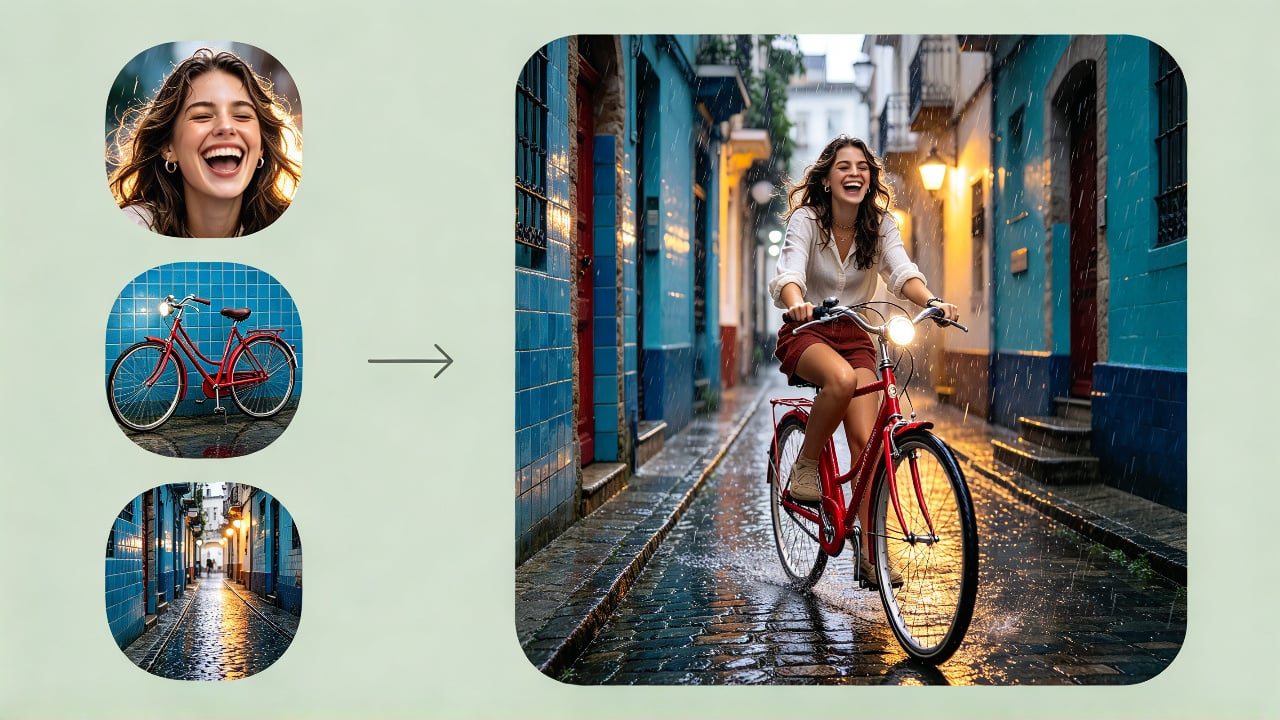
Modifications à partir de one à three références
Importez one à three images de référence dans une modification et décrivez le changement en langage naturel. Le modèle peut utiliser ces sources pour le sujet, le contexte ou les indications visuelles, tout en préservant les principaux traits du visage et l’identité. Demandez un nouvel environnement, un nouveau style ou une nouvelle composition sans recréer le sujet approuvé depuis zéro. Cette approche convient aux variantes de campagne, à la continuité des personnages et aux scènes de produits guidées par des références.
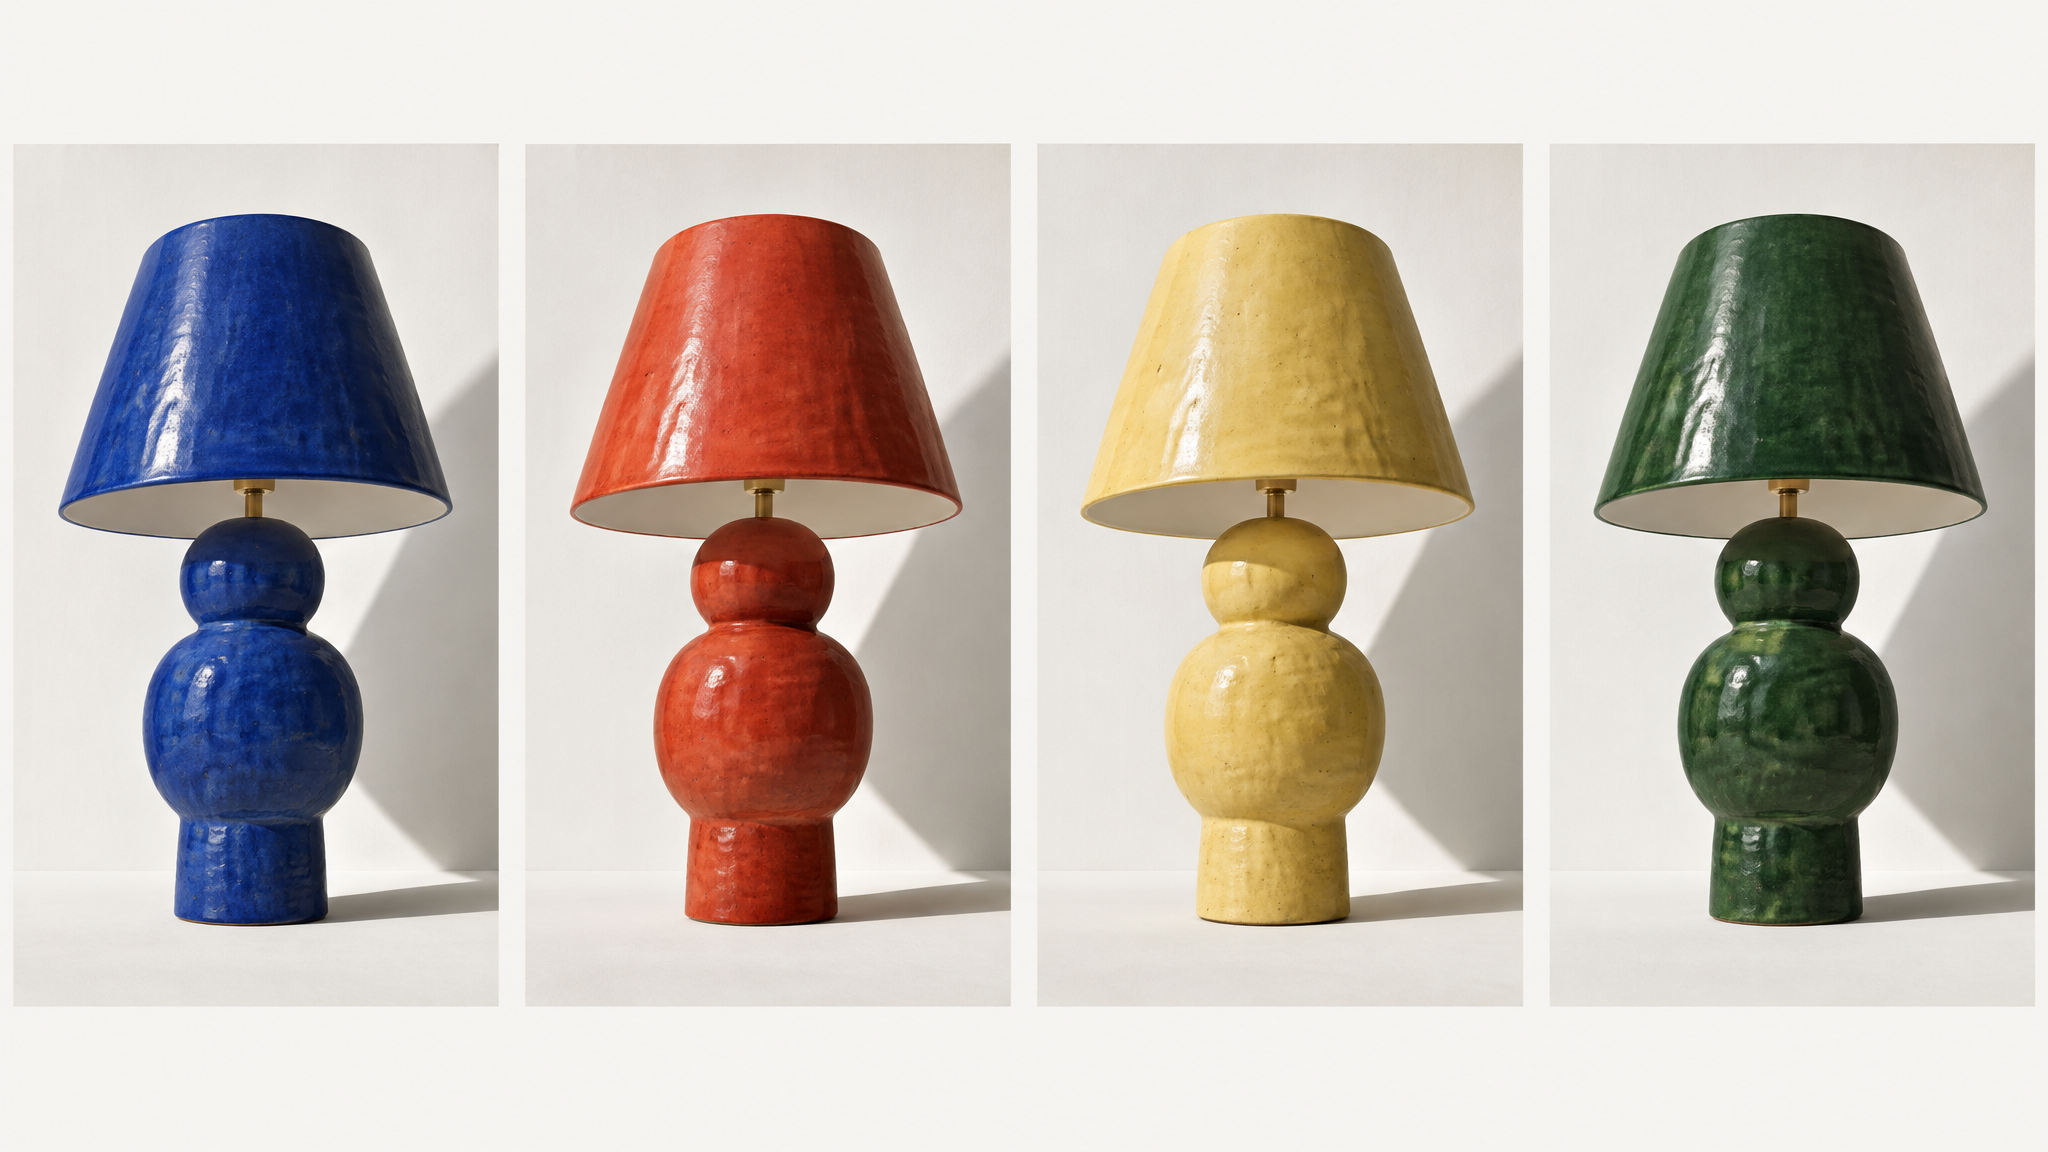
Contrôles de batch reproductibles
Besoin d’expériences répétables ? Définissez un seed fixe de 0 à 2147483647, ajoutez un negative prompt et demandez jusqu’à four sorties dans un seul appel de génération. Ces contrôles facilitent la comparaison des révisions de prompts, l’exclusion des contenus indésirables et l’évaluation d’un petit ensemble d’options dans des conditions cohérentes. Utilisez-les pour des tests créatifs structurés plutôt que pour des essais ponctuels au hasard.
Un prompt, trois visions : comparaison de Qwen Image 3.0 pro
Découvrez comment Qwen Image 3.0 pro, un concurrent externe de premier plan et son prédécesseur de la même série interprètent des prompts identiques dans des créations riches en typographie et des photographies documentaires.
Dans un bazar d’épices animé en plein midi, capturez l’instant décisif et humoristique où un jeune vendeur fait tournoyer dans les airs un sac en toile de jute grossière rempli de safran, au moment précis où un pigeon flou en plein mouvement heurte un monticule de curcuma, projetant un nuage éclatant de poudre dorée suspendu dans la scène ; les clients surpris réagissent naturellement et avec comique, l’un protégeant clairement plusieurs grenades rouges brillantes à deux mains tandis qu’un autre serre simultanément contre sa poitrine des sachets d’épices en papier pliés, chaque bras, main, doigt, objet et interaction étant anatomiquement correct, distinct et facile à lire. Cadrez le marché à travers des arcades de pierre superposées pour créer une composition marquée de cadre dans le cadre, avec un point de vue en légère plongée et un angle néerlandais ; des blocs répétitifs de piments cramoisis, des bols en céramique bleu indigo profond et des tas de curcuma jaune vif créent une palette disciplinée limitée au rouge, au jaune et au bleu. La lumière zénithale directionnelle et dure de midi découpe des ombres géométriques nettes sur les étals, les visages et les pavés usés. Préservez le réalisme tactile des granules de poudre en suspension, des fibres tressées de la toile de jute, des filaments de safran semblables à du papier, des tas d’épices poussiéreux, des balances en cuivre martelé, de la poterie vernissée, du grain de bois patiné, des sachets en papier froissés, de la peau jeune naturelle et d’un subtil grain de pellicule analogique. Incluez une large enseigne horizontale peinte à la main indiquant exactement « ÉPICES, SOLEIL & SURPRISE » en grandes lettres parfaitement lisibles, ainsi que plusieurs étiquettes de prix manuscrites distinctes indiquant exactement « SAFRAN 12 », « CURCUMA 4 », « PIMENTS 6 » et « GRENADES 3 », toutes correctement orthographiées, soigneusement formées et naturellement intégrées à l’étal. Photographie documentaire de voyage de magazine des années 1970, chaleur humaine spontanée, réalisme maîtrisé, objectif environnemental 28mm, mise au point profonde et stratifiée avec un bord de premier plan doucement obstrué, léger flou de mouvement du pigeon, visages et mains nets, exposition authentique, aucune pose, aucun rendu excessivement huileux, aucun aspect HDR, aucune peau plastique, aucune couleur boueuse, aucune lueur excessive, aucun éclairage épique fantastique, aucune palette arc-en-ciel désordonnée, aucune main malformée, aucun doigt supplémentaire, aucune duplication de personnes, aucun texte illisible, aucune bordure, aucune maquette, format paysage horizontal 16:9, pleine largeur.
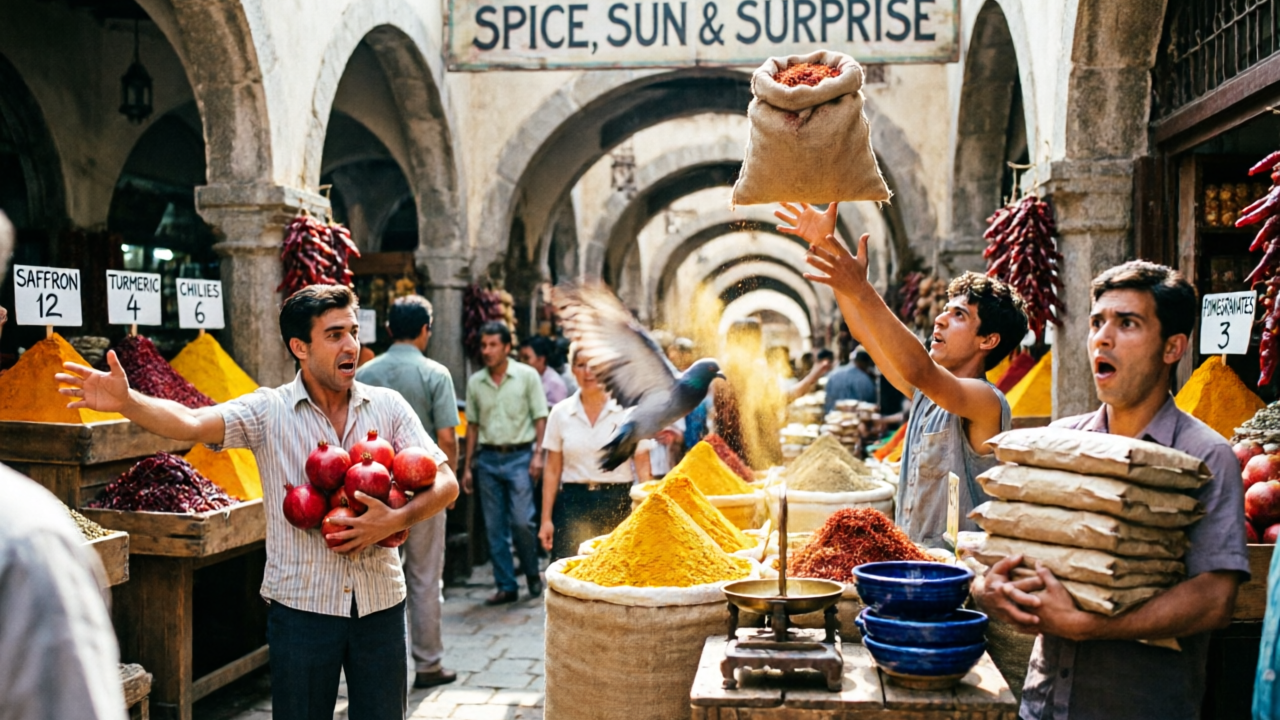
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
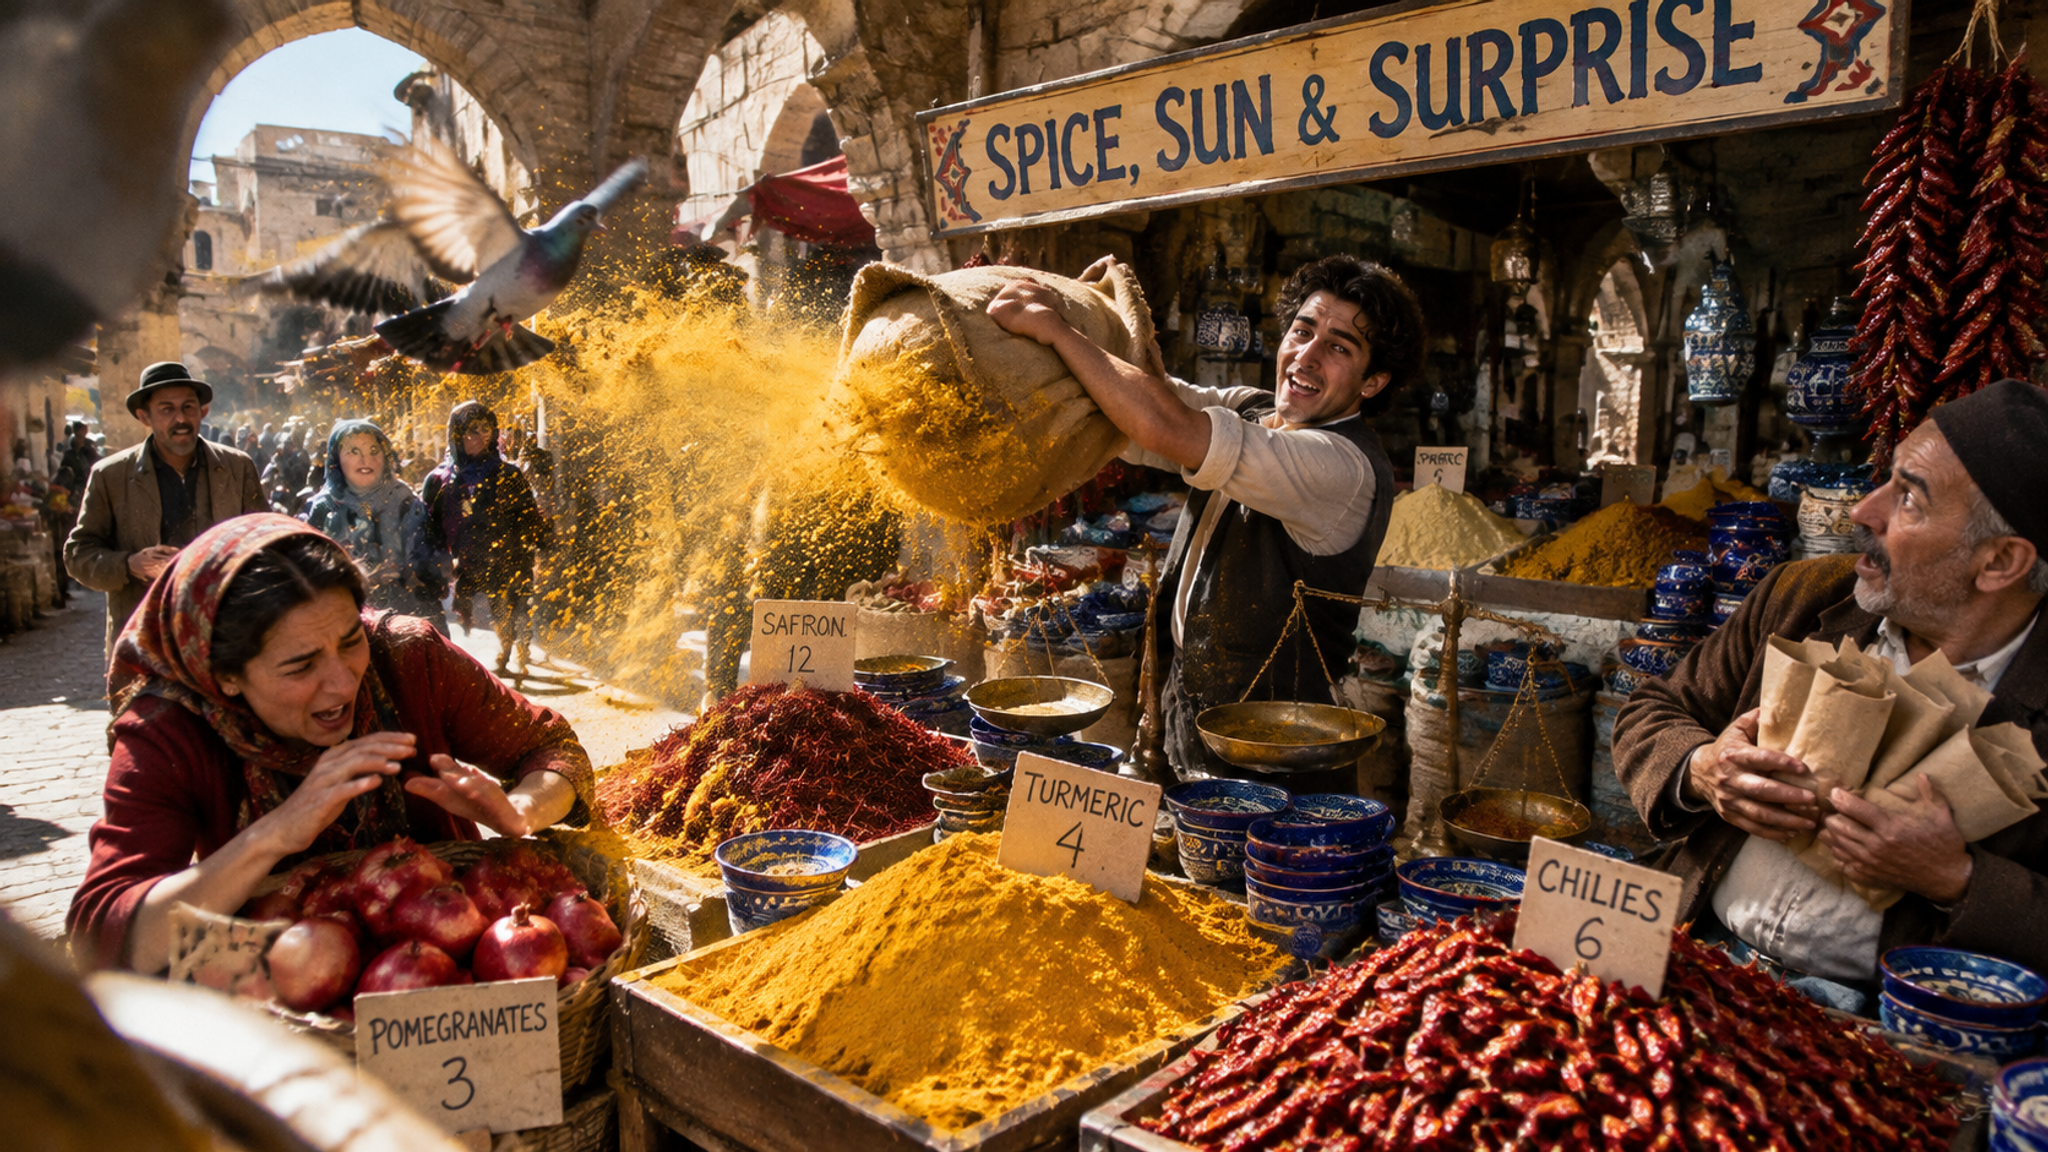
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
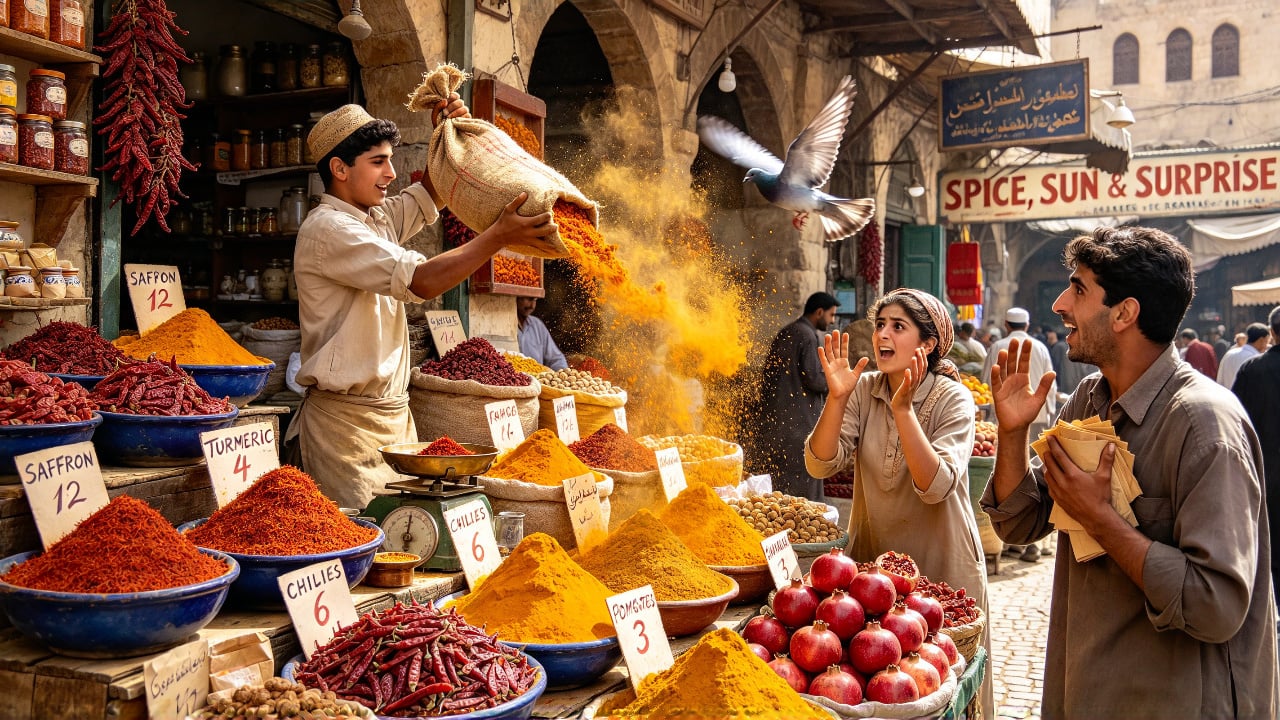
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Photographie documentaire cinématographique à l’intérieur d’une laverie automatique en libre-service par une nuit pluvieuse, capturant l’instant décisif où une machine à laver à chargement frontal déverse soudainement une immense cascade de mousse blanche ; une jeune femme en imperméable jaune vif rit spontanément en recueillant le flot avec une bassine de lavage en plastique rouge, ses mains agrippant naturellement le rebord avec des doigts anatomiquement corrects, tandis que son amie se tient derrière la vitre embuée et écrit clairement du doigt le texte exact inversé dans le miroir « DERNIER LAVAGE 11:30 », lisible depuis l’intérieur de la laverie ; au même moment, une chaussette mouillée claque contre la vitre et y reste collée. Les rangées de hublots circulaires des machines créent une géométrie répétitive audacieuse et de fortes lignes directrices plongeant dans l’espace profond, tandis que les reflets stratifiés de la fenêtre révèlent à la fois l’action ludique à l’intérieur et la rue néon détrempée par la pluie à l’extérieur, formant un double récit cohérent. La lumière directionnelle blanc froid des plafonniers fluorescents découpe des silhouettes nettes et des contours propres sur les visages, l’imperméable, les mains, la mousse et le chrome ; un néon magenta maîtrisé filtre à travers la fenêtre et se reflète dans les flaques du trottoir, avec une palette disciplinée en trois couleurs : cyan-bleu, jaune vif et magenta. Gouttelettes d’eau photoréalistes sur la vitre, bulles translucides, tissu tissé humide, métal brossé, joints en caoutchouc des hublots, condensation, reflets dans les flaques, léger flou de mouvement dans la mousse projetée, grain délicat de pellicule à ISO élevé, texture naturelle de la peau jeune, expressions spontanées, reflets et surfaces transparentes complexes mais cohérents dans l’espace. Reportage environnemental à hauteur des yeux, objectif 35mm, profondeur de champ modérée, réalisme cinématographique, imperfections subtiles, aucune pose mise en scène, aucun rendu excessivement gras, aucun aspect HDR, aucune peau plastique, aucune couleur boueuse, aucune lueur excessive, aucun éclairage épique bon marché, format paysage horizontal 16:9, pleine largeur.
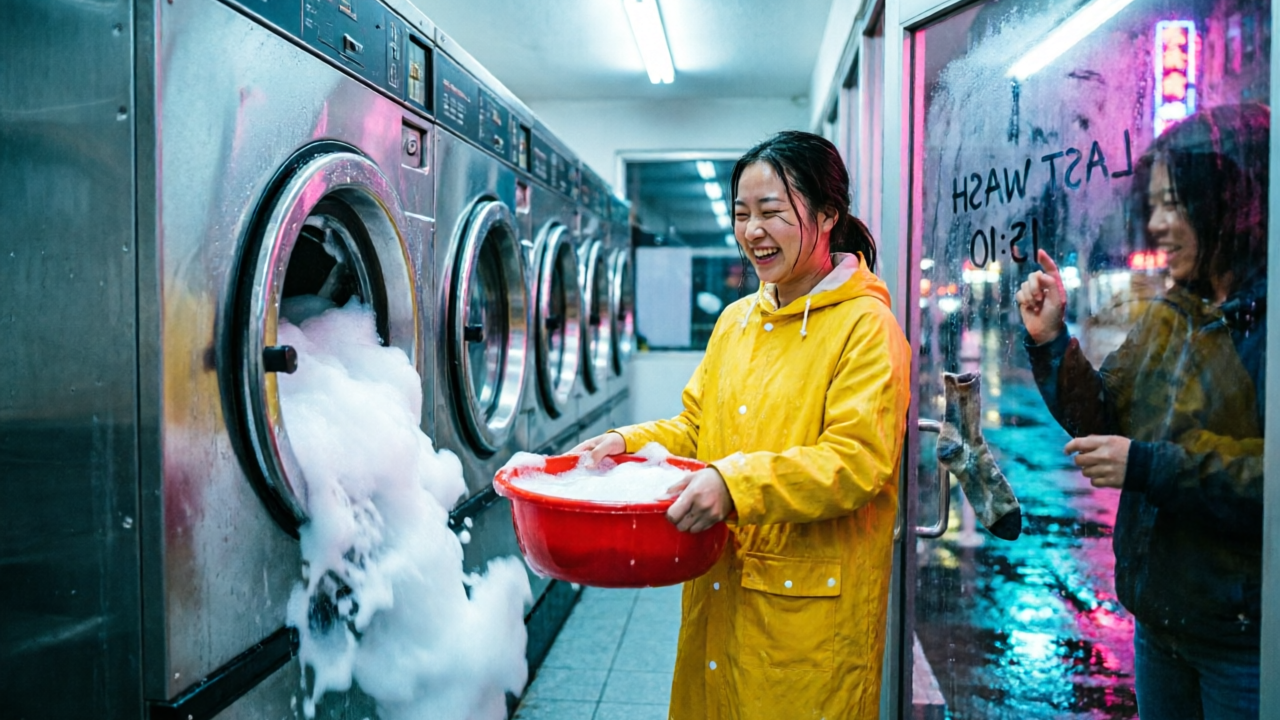
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
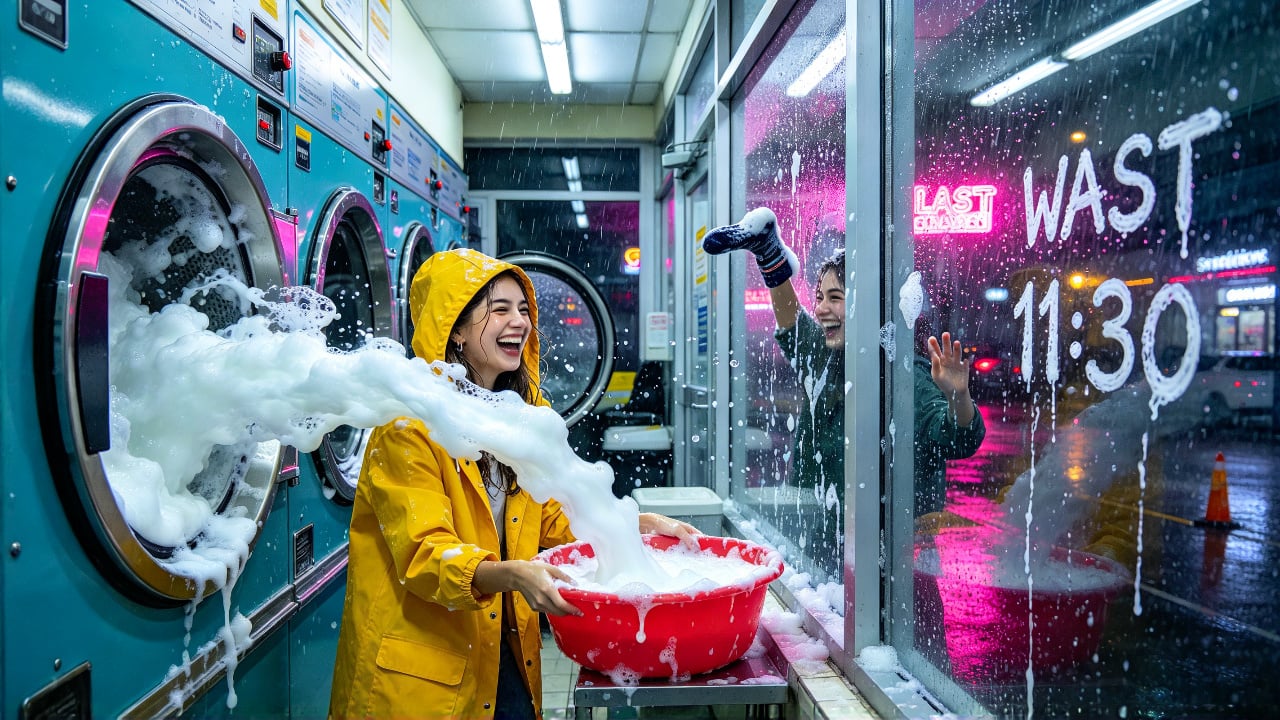
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
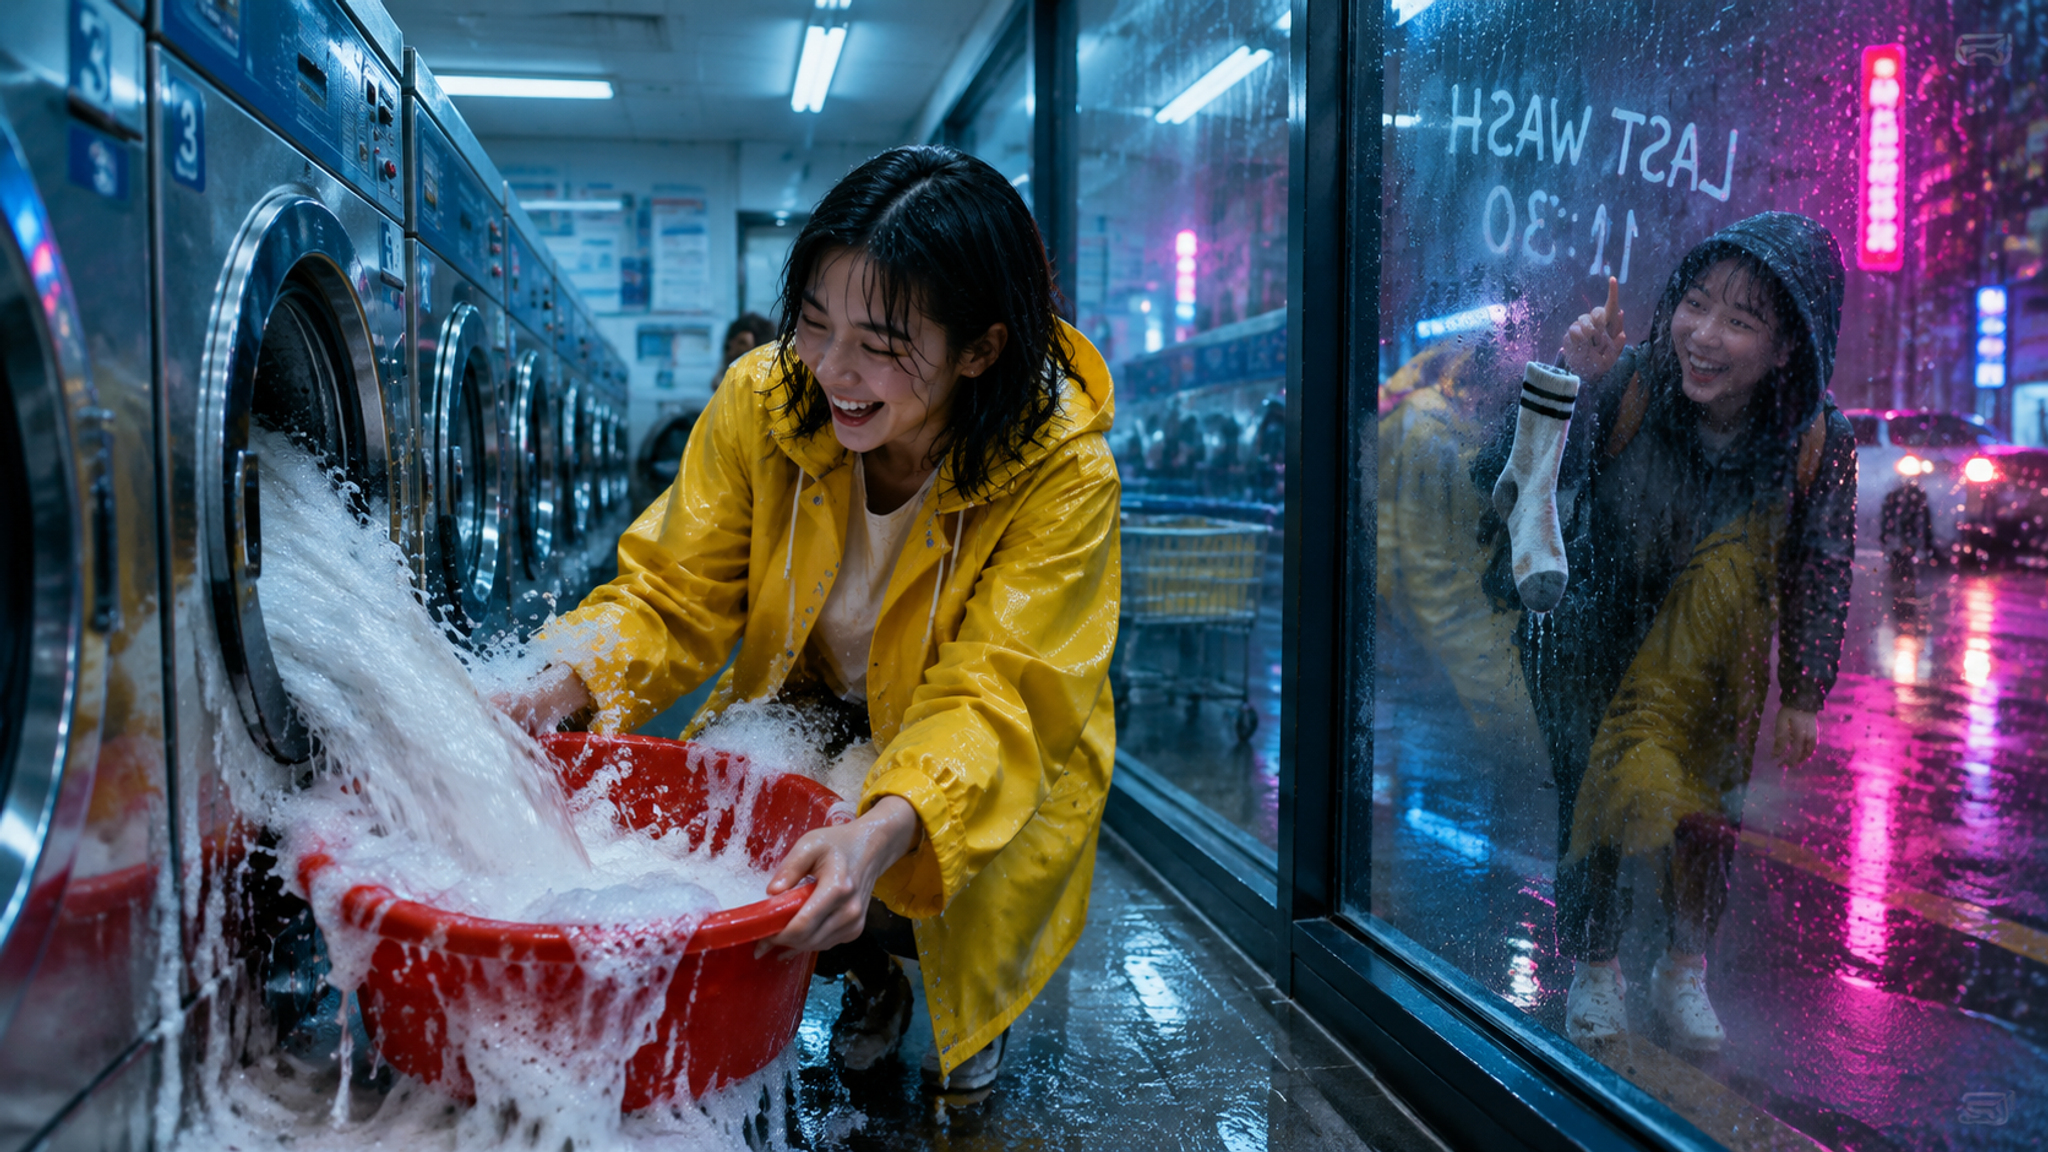
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Créez des systèmes visuels avec Qwen Image 3.0 Pro
Qwen Image 3.0 Pro prend en charge les visuels de campagne, les visuels produit, les concepts d’interface, les storyboards et les retouches préservant l’identité grâce au respect précis des prompts, au rendu de textes complexes, à une résolution allant jusqu’à 2048×2048 et à l’utilisation d’une à trois images de référence.

Affiches de campagne avec Qwen Image 3.0 Pro
Transformez des prompts exigeants en affiches de campagne, bannières et visuels pour les réseaux sociaux grâce à la maîtrise du rendu de textes complexes et au respect précis des prompts de Qwen. Créez des éléments de marque jusqu’en 2048×2048 pour les lancements, événements et promotions.

Visuels produit avec Qwen Image 3.0 Pro
Générez des scènes produit à partir de texte, tandis que la réécriture automatique des prompts enrichit les idées succinctes et que le dimensionnement guidé par prompt sélectionne un canevas adapté. Le résultat convient aux images de catalogue, aux promotions e-commerce et au test rapide de concepts pour les petites équipes.

Retouches de portraits préservant l’identité
Préservez les traits du visage et l’identité tout en modifiant la tenue, le décor, l’éclairage ou le style visuel grâce à des retouches en langage naturel. Les studios de portrait et les applications pour créateurs peuvent produire des variantes de campagne reconnaissables à partir d’une à trois images de référence.

Concepts d’interfaces et d’infographies
Besoin de visuels riches en informations à partir d’instructions détaillées ? Utilisez le respect précis des prompts et le rendu de textes complexes pour prototyper des concepts d’interface, des schémas pédagogiques, des supports explicatifs annotés et des visuels de présentation pour les équipes produit ou pédagogiques.

Compositions multi-références
Intégrez jusqu’à trois images de référence dans une seule demande de retouche, puis indiquez les modifications en langage naturel tout en préservant les détails essentiels. Cette approche convient aux compositions, aux variantes de produits dérivés et aux workflows créatifs centrés sur les personnages.

Storyboards avec Qwen Image 3.0 Pro
Esquissez des scènes séquentielles à partir de prompts soigneusement rédigés, en vous appuyant sur le respect des prompts pour que chaque image suive les sujets, décors et orientations visuelles demandés. Les cinéastes, agences et équipes de jeu vidéo peuvent transformer leurs premières idées en planches de storyboard.
Qwen Image 3.0 pro face aux principales API d’image
Comparez Qwen Image 3.0 pro aux endpoints Seedream et Nano Banana selon le workflow, la taille de sortie maximale, le nombre maximal d’images de référence, les outils de prompt et le tarif standard d’Atlas Cloud.
| Modèle | Workflow | Taille de sortie maximale | Nombre maximal d’images de référence | Outils de prompt | Tarif standard |
|---|---|---|---|---|---|
| Qwen Image 3.0 Pro Text-to-Image | Texte vers image | 2048×2048 | - | Réécriture automatique des prompts | $0.04/image |
| Qwen Image 3.0 Pro Edit | Édition d’image | 1440×1440 | 3 | Réécriture automatique des prompts | $0.04/image |
| Seedream v5.0 Pro Text-to-Image | Texte vers image | Jusqu’à 4.19 MP | - | Raisonnement et optimisation des prompts | $0.045/image |
| Seedream v5.0 Pro Edit | Édition d’image | Jusqu’à 4.19 MP | 10 | Raisonnement et optimisation des prompts | $0.045/image |
| Nano Banana 2 Text-to-Image | Texte vers image | 4K | - | Raisonnement et ancrage dans la recherche | $0.08/image |
| Nano Banana 2 Edit | Édition d’image | 4K | 14 | Raisonnement et ancrage dans la recherche | $0.08/image |
Comment utiliser Qwen Image 3.0 Pro sur Atlas Cloud
Soyez opérationnel en quelques minutes — suivez ces étapes simples pour intégrer et déployer des modèles via la plateforme Atlas Cloud.
Créer un compte Atlas Cloud
Inscrivez-vous sur atlascloud.ai et complétez la vérification. Les nouveaux utilisateurs reçoivent des crédits gratuits pour explorer la plateforme et tester les modèles.
Pourquoi Utiliser Qwen Image 3.0 Pro sur Atlas Cloud
Combiner les modèles Qwen Image 3.0 Pro avancés avec la plateforme accélérée par GPU d'Atlas Cloud offre des performances, une évolutivité et une expérience développeur inégalées.
Performance et Flexibilité
Faible Latence :
Inférence optimisée par GPU pour un raisonnement en temps réel.
API Unifiée :
Exécutez Qwen Image 3.0 Pro, GPT, Gemini et DeepSeek avec une seule intégration.
Tarification Transparente :
Facturation prévisible par token avec options serverless.
Entreprise et Échelle
Expérience Développeur :
SDK, analytiques, outils de fine-tuning et modèles.
Fiabilité :
99,99% de disponibilité, RBAC et journalisation conforme.
Sécurité et Conformité :
SOC 2 Type II, alignement HIPAA, souveraineté des données aux États-Unis.
Questions sur l’API Qwen Image 3.0 Pro, réponses
Qwen Image 3.0 Pro est le modèle d’Alibaba dédié à la génération et à l’édition d’images à partir de texte ou à la modification d’éléments visuels existants au moyen d’instructions en langage naturel. Sur Atlas Cloud, il prend en charge des sorties allant jusqu’à 2048×2048 ainsi que l’édition à partir d’une à trois images de référence.
Utilisez-le pour générer des images nécessitant un respect précis du prompt, un rendu complexe du texte ou une sortie en haute résolution. Pour les workflows d’édition, des instructions en langage naturel peuvent modifier une image tout en préservant des détails importants comme les traits du visage et l’identité.
Choisissez la route texte vers image ou édition, puis appelez-la via l’API compatible avec OpenAI d’Atlas Cloud en utilisant l’identifiant de modèle correspondant. Considérez le schéma des paramètres du Playground lié comme la référence faisant foi lors de la construction et de la validation de votre requête.
Sélectionnez qwen-image-3.0-pro/text-to-image pour générer une image à partir d’un prompt, ou qwen-image-3.0-pro/edit pour modifier des images de référence. Les deux routes disposent de schémas Playground distincts ; utilisez donc le schéma associé au workflow choisi.
La génération texte vers image prend en charge des résolutions allant jusqu’à 2048×2048. Lorsque la résolution n’est pas sélectionnée manuellement, le modèle peut s’appuyer sur le prompt pour guider son choix de résolution.
Fournissez une à trois images de référence accompagnées d’une instruction d’édition en langage naturel. Le modèle d’édition utilise ces entrées pour appliquer les modifications demandées tout en conservant les principaux détails visuels, notamment les traits du visage et l’identité.
Oui. Le modèle texte vers image inclut une réécriture automatique des prompts ainsi qu’une sélection de résolution guidée par le prompt. Vérifiez les sorties par rapport à vos instructions d’origine lorsque la formulation, la mise en page ou le texte intégré doivent être précis.
Atlas Cloud indique un tarif de base standard de $0.04 par image pour les modèles texte vers image et d’édition. La facturation suit un modèle à l’usage, ce qui permet aux développeurs d’utiliser l’un ou l’autre workflow sans engagement d’abonnement.
Les deux versions prennent en charge la génération texte vers image et l’édition d’images. La présentation officielle d’Alibaba décrit le modèle standard comme un compromis entre qualité et rapidité, mais les sources vérifiées examinées ici ne fournissent pas de comparaison quantitative avec Pro. Testez des prompts représentatifs sur les deux versions avant de choisir une configuration par défaut pour la production.
Commencez par une image de référence claire et indiquez explicitement les traits du visage ou détails d’identité qui doivent rester inchangés. L’endpoint d’édition accepte jusqu’à trois références et est conçu pour préserver ces détails. Si la dérive persiste, simplifiez la transformation demandée et évaluez une autre génération.
Explorer Plus de Familles
Seedance 2.5
L'API Seedance 2.5 est désormais disponible sur Atlas Cloud ! Elle offre aux développeurs le tout dernier modèle vidéo de ByteDance. Il génère jusqu'à 30 secondes de vidéo native en un seul passage à partir de texte, d'une seule image ou de jusqu'à 50 références multimodales, avec un son synchronisé et du texte multilingue dans le cadre. Sur Atlas Cloud, vous y accédez via une clé unique, la cohérence du sujet et la physique améliorée maintenant la fluidité des plans longs.

Wan 3.0
L'API Wan 3.0 est la nouvelle génération de la famille vidéo Wan d'Alibaba, conçue pour repousser les limites de la génération de formats longs, du contrôle multi-références et de la qualité audiovisuelle à de nouveaux sommets. Atlas Cloud héberge déjà Wan 2.7, 2.6 et 2.5, et Wan 3.0 fonctionne sur la même clé unifiée sans configuration distincte. Commencez à créer dès aujourd'hui. Faites défiler vers le bas jusqu'à la vitrine pour découvrir ce que Wan 3.0 peut créer.
MiniMax H3
MiniMax H3 est la famille vidéo multimodale de MiniMax, conçue pour la création guidée par du texte, des images et des références. Sur les routes prises en charge, elle préserve les sujets des médias de référence, offre des rapports d’aspect flexibles et associe un son généré aux visuels via H3 Developer, avec des profils de sortie sélectionnés par endpoint. Atlas Cloud unifie cette famille derrière une seule clé compatible avec OpenAI, avec une tarification transparente à l’usage à partir du tarif standard de 0,038 $ par seconde. Commencez à développer dès aujourd’hui.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre aux développeurs le modèle d'édition d'images contrôlable de ByteDance sur Atlas Cloud. Elle positionne les modifications avec précision à l'aide d'ancrages et de coordonnées, sépare les images en calques modifiables, fusionne de multiples références et fait correspondre les couleurs et matériaux exacts, avec du texte multilingue en 2K et 3K. Sur Atlas Cloud, vous y accédez via une seule clé !
Seedance 2.0
Seedance 2.0 est le modèle vidéo de production de ByteDance pour créer des plans avec précision. Transformez vos prompts en vidéos, animez une image de première image avec un guidage facultatif par la dernière image, ou façonnez vos résultats à l’aide de médias de référence et d’une recherche web facultative. Atlas Cloud regroupe ces workflows dans une API unifiée, avec une tarification transparente à l’usage et une clé compatible avec OpenAI. Commencez à développer dès aujourd’hui.
GPT Image 2.5
La famille gpt-image-2.5 d’OpenAI offre aux développeurs le choix entre Flare et Sunburst pour leurs workflows de génération d’images en production. Générez des images à des résolutions arbitraires allant jusqu’à 3840x2160 et choisissez parmi cinq niveaux de qualité, dont xhigh et max, pour répondre à des exigences de sortie spécifiques. Atlas Cloud fournit une inférence REST prête à l’emploi, sans démarrage à froid, avec une tarification standard à partir de $0.004 par génération. Commencez à développer dès aujourd’hui.
GPT Image 2
L'API GPT Image 2 offre aux développeurs un accès au dernier modèle d'image d'OpenAI, le successeur de GPT Image 1.5. Elle génère et modifie des images avec un rendu de texte précis pour les caractères latins et CJK, ainsi qu'une composition solide pour les affiches, les maquettes et les infographies. Sur Atlas Cloud, vous y accédez via une API unifiée aux côtés de plus de 300 modèles, avec des crédits gratuits, une disponibilité de 99,99 % et sans aucune vérification d'organisation OpenAI requise.
Gemini Omni Flash
L’API gemini omni met à la disposition des développeurs la famille Gemini Omni Flash nativement multimodale de Google DeepMind, notamment Gemini Omni 1.1 Flash. Créez des vidéos cinématographiques avec un audio natif synchronisé, animez des images fixes avec un contrôle précis des images de début et de fin, ou révisez des séquences existantes grâce à des modifications guidées par texte qui préservent le contenu inchangé. Atlas Cloud fournit une clé compatible OpenAI, un accès unifié et une tarification transparente à l’usage. Commencez à développer dès aujourd’hui.
Grok Imagine
L'API Grok Imagine couvre les modèles d'image, vidéo et parole d'xAI, de Image 2.0 à Video 1.5 et xAI TTS v1. Générez des images statiques en 1K ou 2K selon 14 rapports d'aspect, créez une vidéo de 15 secondes en 1080p, guidez les plans avec jusqu'à 7 images de référence, ou narrez-les dans 20 langues. Atlas Cloud exécute chaque mode sur un seul point de terminaison, avec un tarif à l'utilisation à partir de $0.02 par image et $0.05 par seconde. Commencez à créer aujourd'hui.
Les modèles créatifs les plus puissants de Google sont tous disponibles sur Atlas Cloud. Veo 3.1 offre une génération de vidéos cinématographiques, Nano Banana 2 permet de créer des images haute fidélité, et Gemini apporte une intelligence multimodale à chaque flux de travail. Accédez à la suite complète de modèles Google via une seule API key avec une disponibilité Day-0 et une tarification à l'usage (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini apporte la génération de vidéos multimodale de ByteDance aux flux de travail où la vitesse et les coûts sont primordiaux. Il offre les capacités de base de Seedance 2.0 avec une empreinte plus légère — une génération plus rapide, un coût par vidéo réduit et la même intégration API que celle que vous utilisez déjà. Pour les équipes qui gèrent des pipelines à haut volume ou du prototypage à grande échelle, Mini est le choix par défaut pratique.
ByteDance
De la génération de vidéos cinématiques à la création d'images haute fidélité, les modèles les plus puissants de ByteDance sont disponibles sur Atlas Cloud. Exécutez Seedance et Seedream à grande échelle avec les prix d'inférence les plus bas et aucune surcharge d'infrastructure.
Articles recommandés
Guides, tutoriels et actualités produit pour tirer le meilleur d'Atlas Cloud.


