
 Atlas Cloud è ora rivenditore autorizzato negli Stati Uniti di Dreamina Seedance 2.5 e Seedream 5.0 Pro.Atlas Cloud è ora rivenditore autorizzato negli Stati Uniti di Dreamina Seedance 2.5 e Seedream 5.0 Pro.

GPT 6 Astra è il modello più intelligente e allineato di OpenAI, progettato per l’uso avanzato del computer, la navigazione web, l’ingegneria del software, la sicurezza informatica, la ricerca scientifica e le attività professionali. La sua capacità di giudizio supporta flussi di lavoro complessi tra codice, ricerca e strumenti digitali. Atlas Cloud offre Astra e Astra Codex tramite un’unica chiave compatibile con OpenAI, con tariffe standard di $10 per milione di token di input e $50 per milione di token di output. Inizia a sviluppare oggi.
GPT 6 Astra è sviluppato da OpenAI. Atlas Cloud (gestita da Atlas Cloud AI LLC) ne fornisce l’accesso ma non ne è proprietaria. Tutti i marchi appartengono ai rispettivi titolari.
Scopri come ogni endpoint GPT 6 Astra supporta flussi di lavoro conversazionali, di generazione di contenuti e di IA personalizzata.
| Modalità | Descrizione |
|---|---|
| GPT 6 Astra API (Text) | GPT 6 Astra elabora prompt testuali e restituisce testo generato attraverso un profilo del modello creativo e intuitivo. Sceglilo per conversazioni naturali, generazione di contenuti ed esperienze di IA personalizzate. |
| GPT 6 Astra Codex API (Text) | Per l'endpoint GPT 6 Astra Codex, le richieste di testo producono risposte testuali utilizzando il profilo creativo e intuitivo verificato. È adatto ai flussi di lavoro conversazionali, di creazione di contenuti e di esperienze personalizzate che richiedono un endpoint di modello separato. |
GPT 6 Astra offre un contesto da 1,050,000 token, cinque livelli di ragionamento, comprensione di testo e immagini, capacità di utilizzo del computer, due endpoint dei modelli Atlas e prezzi trasparenti a più livelli in un'unica integrazione compatibile con OpenAI.
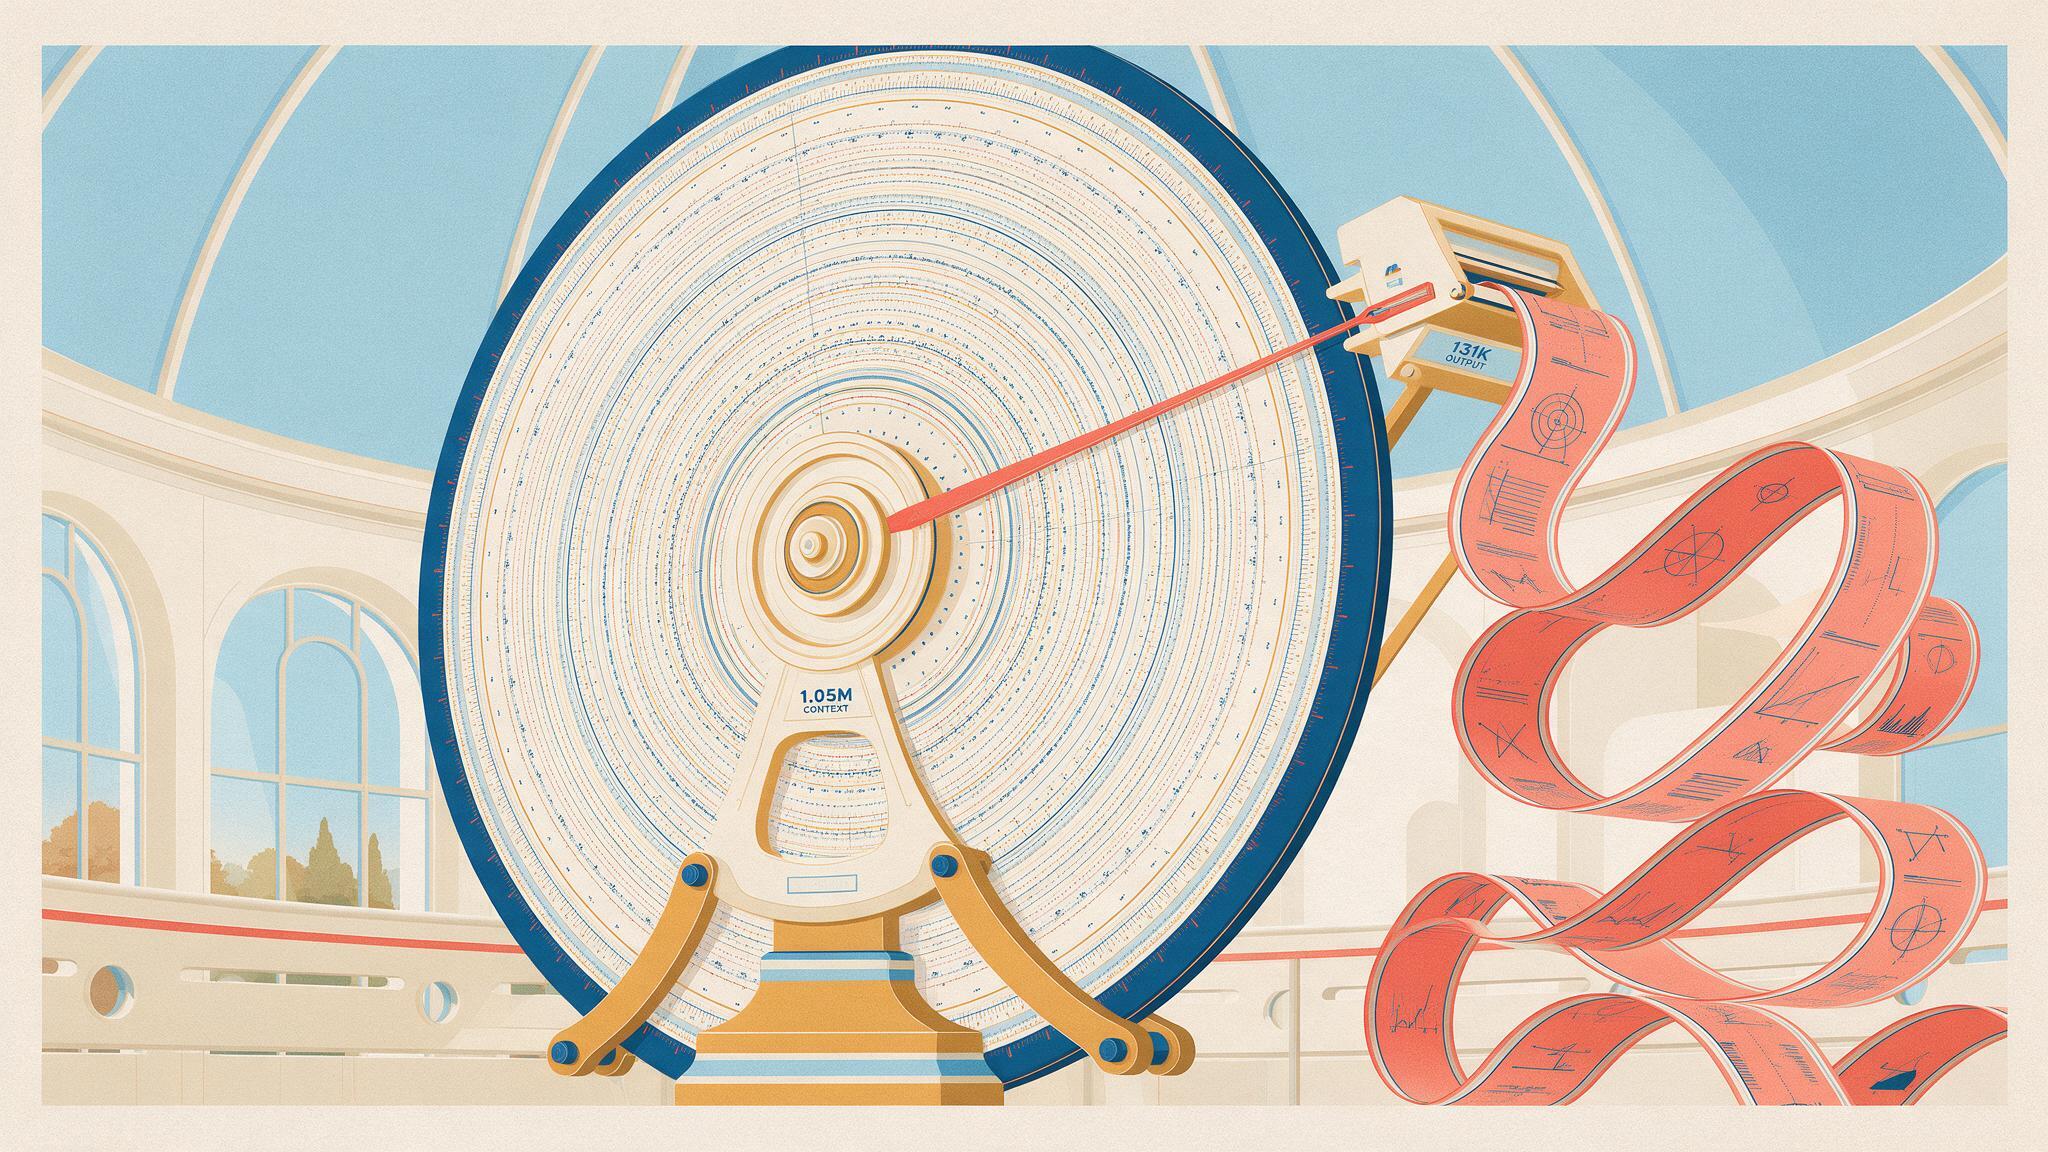
GPT 6 Astra accetta fino a 1,050,000 token di contesto e può restituire fino a 131,072 token di output. Inviagli repository estesi, raccolte di ricerche o cronologie di conversazioni molto lunghe in un'unica richiesta. L'ampiezza operativa estesa riduce la necessità di frammentare il materiale sorgente in numerose chiamate scollegate, rendendolo ideale per revisioni approfondite, analisi prolungate e contesti di progetto complessi.
Cinque livelli di intensità del ragionamento consentono di regolare la quantità di deliberazione dedicata a ogni richiesta: low, medium, high, xhigh e max. Scegli un'impostazione più leggera per le attività semplici, quindi aumenta l'intensità quando la pianificazione, l'analisi scientifica o il debugging complesso richiedono una riflessione più approfondita. Questo controllo del livello della richiesta aiuta i team a bilanciare velocità di risposta, utilizzo dei token e profondità della soluzione senza cambiare modello.
OpenAI presenta Astra come una soluzione all'avanguardia per l'utilizzo del computer e la navigazione web. Quando l'applicazione fornisce gli strumenti e le autorizzazioni necessari, il modello può interpretare lo stato dell'interfaccia, pianificare azioni in più passaggi e reagire ai risultati lungo un flusso di lavoro più articolato. Questa combinazione è adatta alla ricerca sul web, all'assistenza operativa e alle attività gestite dal software, dove il giudizio conta quanto il clic successivo.
Atlas Cloud rende disponibili sia openai/gpt-6-astra sia openai/gpt-6-astra-codex tramite un'unica chiave compatibile con OpenAI. Entrambi offrono una finestra di contesto da 1,050,000 token e fino a 131,072 token di output, con gli stessi prezzi verificati a più livelli. Cambia gli ID dei modelli in base all'evoluzione del flusso di lavoro, mantenendo coerenti l'integrazione e il percorso di autenticazione. In questo modo, i team possono confrontare concretamente le varianti generale e Codex all'interno di un unico stack.
Gli input testuali e visivi consentono ad Astra di ragionare su prosa, schermate, diagrammi e documenti visivi misti, producendo al contempo risposte testuali. Abbina le informazioni visive alle istruzioni scritte, così il modello può collegare ciò che vede all'attività descritta. Gli sviluppatori possono utilizzare questo percorso di input combinato per la revisione di documenti, l'analisi delle interfacce, l'interpretazione di grafici e altri flussi di lavoro in cui il solo testo lascia fuori informazioni importanti.
Atlas Cloud applica prezzi trasparenti a consumo e a più livelli per entrambe le varianti di Astra. Per prompt fino a 272,000 token di input, le tariffe standard sono 10 $ per milione di token di input, 50 $ per milione di token di output, 12,50 $ per la creazione della cache e 1 $ per la lettura della cache. Oltre questa soglia, le tariffe corrispondenti sono 20 $, 75 $, 25 $ e 2 $, aiutando gli sviluppatori a stimare i costi dei contesti lunghi prima della distribuzione.
Confronta come GPT 6 Astra e due alternative di punta trasformano prompt identici in esperienze HTML interattive e rifinite.
Crea una pagina web HTML interattiva completa e contenuta in un unico file, intitolata “Midnight Letterpress Accident Laboratory”. Restituisci esclusivamente il documento HTML finito, con tutto il CSS e il JavaScript incorporati. Deve aprirsi e funzionare direttamente in un browser moderno, senza dipendenze esterne, CDN, librerie, font, link a immagini, file SVG o altre risorse. Questa è una pagina web responsive, non un’immagine fissa in formato 16:9 né una composizione su canvas; deve adattarsi con naturalezza a schermi desktop, tablet e dispositivi mobili. Costruisci un simulatore tattile di tipografia sperimentale in cui l’utente compone una stampa trascinando singoli blocchi di caratteri in piombo su un foglio centrale, ruotandoli e riposizionandoli, quindi regolando la quantità d’inchiostro, la pressione della pressa e l’umidità della carta prima di azionare una grande leva meccanica d’impressione. Il risultato stampato deve reagire proceduralmente a questi parametri: l’inchiostro in eccesso causa sbavature e controforme intasate, una quantità ridotta d’inchiostro crea bordi secchi e spezzati, la pressione modifica l’incisione e la deformazione, l’umidità aumenta la sfumatura e il danneggiamento delle fibre della carta, un posizionamento imperfetto dei caratteri crea un fuori registro e le impressioni ripetute producono ombre sfalsate e immagini fantasma. Consenti più passaggi colore usando esclusivamente rosso vermiglio, blu oltremare e giallo acido, con una sovrastampa realistica, ordine dei livelli visibile, visibilità per singolo livello, annullamento/ripristino passo passo e la possibilità di sollevare l’angolo della carta per rivelare la stampa in evoluzione. Concentra il dramma visivo principale sull’istante in cui il rullo della pressa si è appena sollevato e la stampa finita sta per essere rivelata. La carta centrale deve sembrare un palcoscenico teatrale. Disponi blocchi tipografici, rulli d’inchiostrazione, pinzette, perni di registro, ritagli, indicatori e controlli in un anello asimmetrico attorno a essa. Rendi tutto tramite CSS, elementi HTML, Canvas e texture procedurali, adottando lo stile ruvido della serigrafia fisica e del collage artigianale: bordi strappati, grana fibrosa della carta, pigmento irregolare, puntinatura mezzatinta, metallo graffiato, macchie d’inchiostro, frammenti di nastro adesivo, lieve prospettiva, registro imperfetto e ombre stratificate. Evita gradienti lucidi, stile SaaS sterile, schede generiche, colori cyberpunk al neon, immagini fotorealistiche, emoji, illustrazioni stock e geometrie vettoriali perfettamente pulite. Includi un ampio inventario di caratteri mobili con lettere, punteggiatura, numeri e diversi blocchi decorativi. Gli utenti devono poter trascinare i blocchi dall’inventario all’area di composizione, selezionare più blocchi, ruotarli tramite maniglie o scorciatoie da tastiera, spostarli con i tasti freccia, eliminarli o duplicarli e modificare il contenuto testuale senza perdere l’aspetto fisico del blocco. Aggiungi guide di allineamento attivabili o disattivabili, mantenendo però piccole irregolarità manuali. Fornisci stati hover, attivo, selezionato, disabilitato e focus chiaramente distinguibili. Supporta interazioni tramite puntatore e touch, controlli da tastiera intuitivi, etichette accessibili e indicatori di focus visibili. Crea tre controlli tattili per quantità d’inchiostro, pressione e umidità, i cui valori aggiornino in tempo reale l’anteprima della carta, la simulazione della texture, gli indicatori, le etichette di avviso e il comportamento ambientale della macchina. Il sistema deve rivelare stati d’incidente giocosi con combinazioni estreme, come violente esplosioni d’inchiostro, lettere raddoppiate, caratteri scivolati, crepe frastagliate nelle fibre, vibrazioni del rullo e segni di registro schizzati, mantenendo comunque leggibile la composizione. Aggiungi un registro compatto degli esperimenti che annoti ogni impressione e i relativi parametri. Gli utenti devono poter selezionare un colore di passaggio, azionare la leva trascinandola lungo un arco convincente, assistere a un ciclo di stampa breve ma dettagliato e poi sollevare la carta. L’animazione deve includere la resistenza della leva, la vibrazione della macchina, il movimento del rullo, la compressione della carta, particelle di polvere, un lieve tremolio della lampada e una pausa carica di suspense prima della rivelazione. Rispetta prefers-reduced-motion. Rendi annullamento e ripristino realmente funzionali per posizionamento, rotazione, modifiche dei parametri, stampa, passaggi colore e azioni di rivelazione. Includi i controlli Reimposta, Incidente casuale, Riinchiostra, Aggiungi passaggio, Annulla e Ripristina, oltre a un breve suggerimento introduttivo che scompaia dopo l’interazione. Precompila la pagina con un poster intrigante parzialmente composto, così che la prima visualizzazione sia ricca dal punto di vista visivo, ma fai in modo che ogni elemento importante resti modificabile. Aggiungi un feedback visivo sottile, simile a un suono, senza usare risorse audio. Mantieni, quando pratico, texture procedurali deterministiche affinché l’annullamento ripristini lo stesso aspetto. L’esperienza deve sembrare cerimoniale, artigianale, tesa e maliziosamente incontrollabile, non semplicemente decorativa. Dai priorità ai dettagli raffinati dell’interazione, all’accoppiamento convincente dei parametri, agli artefatti di stampa procedurali stratificati, ai tempi di animazione curati e a una composizione responsive eccellente. Usa HTML semantico e JavaScript vanilla pulito e ben strutturato. La risposta finale deve contenere esclusivamente il documento HTML completo ed eseguibile.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
Crea una pagina web HTML interattiva completa, rifinita e contenuta in un unico file, intitolata “Midnight Ramen Soundscape Theater”. Restituisci esclusivamente il documento HTML finale, con tutto il CSS e il JavaScript incorporati. Deve funzionare direttamente in un browser moderno, senza fase di build e senza dipendenze esterne, librerie, font, immagini, file audio, risorse CDN, richieste di rete o asset collegati. Costruisci una scena interattiva espressiva ambientata in un surreale ristorante di ramen a mezzanotte. L’oggetto centrale è un unico fascio continuo di noodles elastici, renderizzato con Canvas, SVG o una combinazione accuratamente integrata dei due. Il fascio di noodles deve attraversare diagonalmente il primo piano e sembrare fisicamente tangibile: gli utenti devono poterlo afferrare in qualsiasi punto con mouse o touch, trascinarlo, allungarlo, farlo schioccare, ripiegarlo su sé stesso e rilasciarlo. Implementa una fisica elastica convincente con inerzia, smorzamento, gravità, più segmenti collegati, risposta alle collisioni e movimento secondario visibile. Mantieni la simulazione stabile anche durante trascinamenti aggressivi, rapidi cambi di direzione, ridimensionamenti della finestra o interazioni ripetute. Disponi almeno tre ciotole di ramen distinte e diversi ingredienti lungo un arco ampio che attraversi la composizione, creando un ritmo visivo deciso attorno al noodle diagonale. Ogni ciotola deve avere il proprio motivo illustrato del brodo, identità cromatica, etichetta e carattere sonoro. Quando il noodle tocca una ciotola o vi cade dentro, attiva una risposta audiovisiva sincronizzata: un battito percussivo unico sintetizzato con la Web Audio API, un getto crescente di vapore, spruzzi di particelle verde cipollotto, increspature nel brodo, piccole gocce, tremolio del registro in stile serigrafico e onomatopee animate scritte a mano in stile giapponese come “ZURU!”, “PON!”, “JUU!” o “BASHAN!”, create con testo stilizzato anziché con font esterni. L’intensità della collisione deve influenzare volume, tonalità, numero di particelle, dimensione delle increspature, scala delle lettere e forza dell’animazione. L’audio deve iniziare solo dopo la prima interazione dell’utente e includere un controllo chiaro per disattivare/riattivare l’audio. Lo stato visivo culminante deve evocare un fermo immagine in cui il noodle è spettacolarmente teso nell’aria mentre il brodo resta sospeso appena prima dello schizzo. Supporta questa modalità con un controllo “CONGELA LO SCHIZZO” e con la barra spaziatrice: entrando in modalità congelata, applica una breve transizione energica, sospendi la scena fisica senza perderne lo stato, enfatizza le gocce sospese e la tensione del noodle allungato, mostra una tipografia cinetica audace in stile poster e conserva un sottile tremolio procedurale delle linee affinché la pagina continui a sembrare viva. Premendo di nuovo la barra spaziatrice o il controllo, la scena deve riprendere senza interruzioni. Aggiungi un controllo di ripristino, un indicatore compatto dello stato audio e una lettura discreta dal vivo di “tempo/impatto” guidata dalle collisioni recenti. I controlli da tastiera devono essere individuabili in un piccolo pannello integrato di aiuto: la barra spaziatrice attiva/disattiva il congelamento, R ripristina, M disattiva/riattiva l’audio e i tasti freccia applicano impulsi direzionali al noodle. Usa un ibrido visivamente sofisticato tra il design dei poster serigrafici vintage e l’animazione procedurale delle linee. Deve dominare uno sfondo indaco intenso, interrotto dal calore localizzato del fuoco dei fornelli attorno alle ciotole e ai punti di collisione. Usa colori spot stratificati — rosso vermiglio, giallo zenzero, verde cipollotto, crema calda e quasi nero — con texture mezzatinta, bordi d’inchiostro ruvidi, lieve fuori registro cromatico, ombre grafiche decise e linee di contorno animate. Il risultato deve sembrare artigianale e teatrale, non lucido o fotorealistico. Includi vapore ambientale discreto, bagliore tremolante dei fornelli, grana fluttuante e linee in movimento, mantenendo però un contrasto elevato e controlli leggibili. Evita lo stile cyberpunk generico al neon. Rendi la composizione responsive su schermi desktop ampi, tablet e dispositivi mobili; questa è una pagina web, quindi non imporre un rapporto fisso 16:9. Adatta fluidamente la posizione delle ciotole, la tipografia, i controlli, i limiti della simulazione e le aree touch senza ritagliare contenuti essenziali. Usa gli eventi del puntatore per unificare mouse, penna e touch. Impedisci lo scorrimento della pagina solo mentre il noodle viene manipolato attivamente. Rispetta prefers-reduced-motion riducendo l’animazione ambientale, ma mantenendo funzionale l’interazione principale. Mantieni prestazioni fluide tramite un sistema efficiente di riutilizzo delle particelle o limiti rigidi al loro numero, requestAnimationFrame, rendering consapevole del device-pixel-ratio con un limite ragionevole alla risoluzione e gestione delle coordinate sicura durante il ridimensionamento. Requisiti di contenuto e rifinitura: includi un trattamento atmosferico del titolo, un breve invito all’interazione su una sola riga, almeno tre ciotole etichettate, molteplici guarnizioni visivamente distinguibili, parole sonore scritte a mano in modo contestuale, stati dei controlli rifiniti, stili di focus chiari, etichette accessibili per i pulsanti e un suggerimento d’interazione discreto che svanisca dopo il primo utilizzo. La scena iniziale deve sembrare già un poster da collezione finito prima di qualsiasi interazione, mentre lo stato attivo deve trasformarsi in un giocattolo ritmico vivace, con feedback stratificati e movimenti emergenti sorprendenti. Vincoli negativi: nessun asset o dipendenza esterna; nessun URL di immagini; nessun audio preregistrato; nessun framework; nessun segnaposto incompleto; nessun commento TODO; nessun controllo non funzionante; nessun canvas fisso 16:9; nessuna interfaccia predefinita semplice; nessuno sfondo composto esclusivamente da gradienti generici; nessuna emoji usata come elemento grafico principale; nessun testo esplicativo eccessivo; nessun audio in autoplay; nessuna crescita incontrollata delle particelle; nessuna fisica fragile che esploda o produca valori NaN; nessuna interazione funzionante solo con il mouse; nessun contenuto al di fuori dell’unico documento HTML completo.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
GPT 6 Astra trasforma il ragionamento avanzato, la navigazione web, l’uso del computer, l’ingegneria del software, l’analisi multimodale e il contesto lungo in flussi di lavoro pratici per sviluppatori, ricercatori, team di sicurezza e professionisti della conoscenza.

GPT 6 Astra gestisce attività di uso del computer e navigazione web che richiedono più passaggi coordinati. Puoi impiegarlo per operazioni basate sul browser, raccolta di informazioni e flussi di lavoro digitali in cui un agente deve passare dalle istruzioni al completamento.

All’interno di codebase esistenti, GPT 6 Astra può supportare attività complesse di ingegneria del software. Gli sviluppatori possono usarlo per esaminare il contesto, eseguire il debug, implementare modifiche e verificare i risultati prima di integrarli nei flussi di lavoro di produzione.

Trasforma ampie raccolte di fonti in ricerche strutturate con le funzionalità di navigazione web e contesto lungo di GPT 6 Astra. Gli analisti possono confrontare le evidenze, mantenere il contesto dell’intero progetto e produrre risultati chiari per prendere decisioni informate.

Quando il lavoro sulla sicurezza richiede un ragionamento accurato, GPT 6 Astra può esaminare codice, configurazioni ed evidenze tecniche. Usa i suoi risultati per supportare la revisione delle vulnerabilità, la pianificazione delle correzioni e passaggi di consegne documentati per i team di sicurezza.

I team scientifici possono applicare GPT 6 Astra ad analisi impegnative che combinano testo, immagini e un contesto esteso. Aiuta i ricercatori a organizzare le osservazioni, verificare le linee di ragionamento e preparare output da sottoporre alla validazione di esperti.

Porta documenti estesi, riferimenti visivi e materiali di progetto in un unico flusso di lavoro professionale. Con GPT 6 Astra, i team possono armonizzare i materiali e preparare report, briefing o decisioni preservando il contesto circostante.
Confronta GPT 6 Astra con i principali modelli multimodali disponibili su Atlas Cloud in base al supporto per gli input, alla capacità del contesto, al limite di output e ai prezzi standard per token.
| Modello | Tipi di input | Finestra di contesto | Output massimo | Prezzo standard per 1M token |
|---|---|---|---|---|
| GPT 6 Astra | Testo, Immagine | 1.050.000 token | 131.072 token | 10 $ in ingresso / 50 $ in uscita; per prompt oltre 272K: 20 $ in ingresso / 75 $ in uscita |
| GPT 6 Astra Codex | Testo, Immagine | 1.050.000 token | 131.072 token | 10 $ in ingresso / 50 $ in uscita; per prompt oltre 272K: 20 $ in ingresso / 75 $ in uscita |
| Gemini 3.1 Pro Preview | Testo, Immagine, Video | 1.000.000 token | 64.000 token | 2 $ in ingresso / 12 $ in uscita; per prompt oltre 200K: 4 $ in ingresso / 18 $ in uscita |
| Grok 4.6 | Testo, Immagine | 500.000 token | 500.000 token | 2 $ in ingresso / 6 $ in uscita; per prompt oltre 200K: 4 $ in ingresso / 12 $ in uscita |
| Kimi K3 | Testo, Immagine, Video | 1.048.576 token | 1.048.576 token | 3 $ in ingresso / 15 $ in uscita |
Inizia in pochi minuti — segui questi semplici passaggi per integrare e distribuire i modelli tramite la piattaforma Atlas Cloud.
Registrati su atlascloud.ai e completa la verifica. I nuovi utenti ricevono crediti gratuiti per esplorare la piattaforma e testare i modelli.
Combinando i modelli avanzati di GPT 6 Astra con la piattaforma GPU-accelerata di Atlas Cloud, ottieni prestazioni, scalabilità ed esperienza di sviluppo senza pari.
Bassa Latenza:
Inferenza ottimizzata su GPU per elaborazione in tempo reale.
API Unificata:
Esegui GPT 6 Astra, GPT, Gemini e DeepSeek con un'unica integrazione.
Prezzi Trasparenti:
Fatturazione prevedibile per token con opzioni Serverless.
Esperienza Sviluppatore:
SDK, analytics, strumenti di fine-tuning e template.
Affidabilità:
99,99% di uptime, RBAC e logging conforme alle normative.
Sicurezza e Conformità:
SOC 2 Type II, allineamento HIPAA, sovranità dei dati negli USA.
GPT-6 Astra è il modello di frontiera di OpenAI per attività impegnative di utilizzo del computer, navigazione, ingegneria del software, cybersicurezza, scienza e lavoro professionale. Atlas Cloud offre accesso a consumo a GPT 6 Astra e GPT 6 Astra Codex tramite un'unica chiave compatibile con OpenAI.
Progettato per attività complesse, Astra supporta ragionamento, programmazione, navigazione, utilizzo del computer, ricerca e analisi con contesto esteso. Accetta input testuali e immagini e produce testo per flussi di lavoro con agenti, creazione di documenti e altre attività professionali impegnative.
Indirizza un client compatibile con OpenAI all'endpoint di Atlas Cloud, aggiungi la tua chiave API di Atlas e seleziona openai/gpt-6-astra o openai/gpt-6-astra-codex. Atlas Cloud mette a disposizione la famiglia tramite il protocollo Chat Completions, consentendo di mantenere le familiari strutture di richiesta e risposta.
Atlas Cloud supporta input testuali e immagini con output testuale. La finestra di contesto indicata è di 1,050,000 token, l'output massimo è di 131,072 token e la data limite della conoscenza è il 30 aprile 2026.
Sì. Lo streaming è supportato e lo sforzo di ragionamento può essere impostato su low, medium, high, xhigh o max. Le impostazioni più basse favoriscono la velocità e un minore utilizzo di token, mentre quelle più alte consentono un ragionamento più approfondito per le attività difficili.
Il prezzo standard è di $10 per milione di token di input e $50 per milione di token di output. L'input memorizzato nella cache costa $1 per milione di token, mentre la creazione della cache costa $12.50 per milione. Per prompt superiori a 272,000 token, le rispettive tariffe sono $20, $75, $2 e $25 per milione di token.
Inizia con uno sforzo di ragionamento low o medium e misura l'utilizzo dei token su attività rappresentative prima di aumentare l'impostazione. La memorizzazione nella cache dei prompt può ridurre il costo degli input riutilizzabili, mentre un modello meno costoso potrebbe essere più adatto per richieste di routine o ad alto volume.
Atlas Cloud elenca due ID modello distinti: openai/gpt-6-astra e openai/gpt-6-astra-codex. Entrambi utilizzano lo stesso piano tariffario verificato, ma le informazioni disponibili sul backend non consentono di stabilire una differenza quantificabile in termini di capacità o latenza. Esegui benchmark di entrambi sui tuoi carichi di lavoro di programmazione e generali prima di selezionare un'impostazione predefinita per la produzione.
Scegli Astra per le attività difficili in cui la qualità è fondamentale, tra cui l'utilizzo agentico del computer, l'ingegneria del software complessa, l'analisi con contesto esteso e le attività scientifiche o professionali impegnative. Per richieste di routine, traffico ad alto volume o flussi di lavoro in cui la latenza è importante, confronta un modello più piccolo in base al successo delle attività e al costo totale.
L'API Seedance 2.5 è ora disponibile su Atlas Cloud! Offre agli sviluppatori il più recente modello video di ByteDance. Genera fino a 30 secondi di video nativo in un unico passaggio da testo, una singola immagine o fino a 50 riferimenti multimodali, con audio sincronizzato e testo multilingue nell'inquadratura. Su Atlas Cloud vi si accede tramite un'unica chiave, con la coerenza del soggetto e la fisica migliorata che mantengono coerenti le riprese lunghe.

L'API Wan 3.0 è la generazione successiva della famiglia di video Wan di Alibaba, creata per spingere la generazione di formati lunghi, il controllo multi-riferimento e la qualità audiovisiva a nuovi livelli. Atlas Cloud ospita già Wan 2.7, 2.6 e 2.5, e Wan 3.0 funziona sulla stessa chiave unificata senza alcuna configurazione separata. Inizia a costruire oggi stesso. Scorri verso il basso fino alla vetrina per vedere cosa è in grado di creare Wan 3.0.
MiniMax H3 è la famiglia di modelli video multimodali di MiniMax per la creazione guidata da testo, immagini e riferimenti. Sulle route supportate, mantiene i soggetti presenti nei media di riferimento, offre rapporti d’aspetto flessibili e abbina l’audio generato alle immagini tramite H3 Developer, con profili di output selezionati in base all’endpoint. Atlas Cloud riunisce l’intera famiglia dietro un’unica chiave compatibile con OpenAI, con prezzi trasparenti a consumo a partire dalla tariffa standard di $0.038 al secondo. Inizia a sviluppare oggi stesso.
La famiglia gpt-image-2.5 di OpenAI offre agli sviluppatori la scelta tra Flare e Sunburst per i flussi di lavoro di produzione delle immagini. Esegui il rendering a risoluzioni arbitrarie fino a 3840x2160 e scegli tra cinque livelli di qualità, inclusi xhigh e max, per soddisfare requisiti di output specifici. Atlas Cloud offre un’inferenza REST pronta all’uso, senza avvii a freddo e con prezzi standard a partire da $0.004 per generazione. Inizia a creare oggi stesso.
L'API Seedream 5.0 Pro offre agli sviluppatori il modello di editing delle immagini controllabile di ByteDance su Atlas Cloud. Posiziona le modifiche con precisione tramite ancore e coordinate, separa le immagini in livelli modificabili, fonde più riferimenti e abbina colori e materiali esatti, con testo multilingue a 2K e 3K. Su Atlas Cloud puoi accedervi tramite una sola chiave!
Seedance 2.0 è il modello video di produzione di ByteDance per la creazione precisa di inquadrature. Trasforma i prompt in video, anima un’immagine del primo fotogramma con una guida opzionale dell’ultimo fotogramma oppure modella i risultati con contenuti multimediali di riferimento e la ricerca web opzionale. Atlas Cloud riunisce questi flussi di lavoro in un’unica API, con prezzi trasparenti a consumo e una chiave compatibile con OpenAI. Inizia a sviluppare oggi.
La Kling 3.0 API porta la suite video di punta di Kuaishou su Atlas Cloud tramite una chiave compatibile con OpenAI. Include due modelli: Kling 3.0 per lo storytelling di AI Director, la sincronizzazione labiale multilingue e testi a schermo precisi, e Kling 3.0 Omni (O3) per la clonazione di soggetti e voci da un breve video o un'immagine. Entrambi generano audio nativo nello stesso passaggio, con un output fino a 4K. Costruisci narrazioni cinematografiche, marketing globale, annunci multilingue e contenuti per personaggi serializzati su un'infrastruttura affidabile.
Grok Imagine Video offre agli sviluppatori l’accesso alla famiglia di modelli video di xAI per creare, animare, estendere e modificare clip. Genera video da 1 a 15 secondi a partire da prompt, guida persone, oggetti o stili con fino a sette immagini di riferimento e lavora a 480p o 720p. Atlas Cloud riunisce queste funzionalità tramite endpoint compatibili con OpenAI e prezzi trasparenti secondo il consumo. Inizia a sviluppare oggi stesso.
Vidu Q4 è l’ultimo modello video di punta di Vidu, progettato per la generazione da immagine a video e da riferimento a video. Può animare una singola immagine statica e creare transizioni automatiche tra le scene, offrendo agli sviluppatori due modalità di input per diversi flussi di lavoro dei prodotti. Atlas Cloud mette a disposizione endpoint API dedicati con schemi dei parametri pubblicati, al prezzo standard verificato di $0.04 al secondo. Inizia a sviluppare oggi.
Gemini Omni 1.1 Flash è la famiglia video nativamente multimodale di Google DeepMind, progettata per flussi di produzione flessibili. Modifica filmati esistenti tramite istruzioni testuali, mantieni la coerenza visiva con fino a 10 immagini di riferimento e 3 clip video oppure estendi un’inquadratura in segmenti concatenabili fino a 40 secondi. Accedi a tutti i flussi di lavoro su Atlas Cloud con un’unica chiave API compatibile con OpenAI, prezzi a consumo e disponibilità dal giorno zero. Inizia a sviluppare oggi.
Nano Banana 2.1 è la famiglia di modelli di immagini di Google basata su Gemini 3.6 Flash. Offre generazione e modifica a livello Pro con la velocità di Flash, supporta modifiche e fusioni in linguaggio naturale tra 1 e 14 immagini di input e mantiene la coerenza fino a 4 personaggi e 10 oggetti. Tramite Atlas Cloud, gli sviluppatori possono accedere alla famiglia con una sola chiave compatibile con OpenAI, uptime affidabile e disponibilità dal Day-0. Inizia a costruire oggi.
Costruisci con l'API Nano Banana 2, basata sul modello Gemini 3.1 Flash Image di Google. Genera immagini in 4K nativo fino a 4096x2304 con un rendering accurato del testo e personaggi coerenti su un massimo di 14 immagini di riferimento, sia per la generazione che per la modifica. Su Atlas Cloud puoi accedervi tramite un'unica API unificata insieme a oltre 300 modelli, con prezzi a partire da $0,04 per immagine, uptime del 99,99% e crediti gratuiti per iniziare.
Guide, tutorial e novità di prodotto per sfruttare al meglio Atlas Cloud.



