Qwen Image 3.0 Precise Text Rendering
Qwen Image 3.0は、ビジュアル製品を開発する開発者向けのQwenの画像生成・編集モデルファミリーです。高精度なプロンプト追従と複雑なテキストレンダリングに加え、プロンプトの自動リライトや、プロンプトに基づく解像度の自動選択にも対応しています。Atlas Cloudを通じて、生成モデルと編集モデルの両方を、1回あたり$0.03の標準的な従量課金で利用できます。今すぐ開発を始めましょう。
Qwen Image 3.0 は Alibaba が開発したモデルです。Atlas Cloud(運営:Atlas Cloud AI LLC)は本モデルへのアクセスを提供するものであり、その所有者ではありません。すべての商標は各所有者に帰属します。
主要モデルを探索
Atlas Cloudは、業界をリードする最新のクリエイティブモデルを提供します。


Qwen Image 3.0:生成と編集の比較
Qwen Image 3.0の各エンドポイントを、入力方法、検証済みの機能、最適なワークフロー、標準料金の観点から比較します。
| モダリティ | 説明 |
|---|---|
| Qwen Image 3.0 Text-to-Image API (Text to Image) | テキストプロンプトから、最大2048×2048の解像度で画像を生成します。プロンプトの自動書き換えや、プロンプトに基づく解像度選択にも対応しています。複雑なテキストの描画とプロンプトへの高い忠実度により、ポスター、商品ビジュアル、コンセプトアートなど、プロンプト主導のワークフローに適しています。Atlas Cloudの標準基本料金は$0.03です。 |
| Qwen Image 3.0 Edit API (Image Editing) | 1〜3枚の参照画像と自然言語による指示を入力し、顔の特徴やアイデンティティなどの重要なディテールを維持しながら画像を編集します。スタイルの意図的な変更、部分的な修正、キャラクターの一貫性維持、反復的なビジュアル調整に利用できます。Atlas Cloudの標準基本料金は$0.03です。 |
Qwen Image 3.0:プロンプトから編集まで高精度に
Qwen Image 3.0は、複雑なテキスト描画、2048 × 2048までの適応型出力、インテリジェントなプロンプト書き換え、1〜3枚の参照画像による編集、そして1枚あたり$0.03で利用できる1つのAtlas Cloud APIを通じた制御可能な生成を実現します。
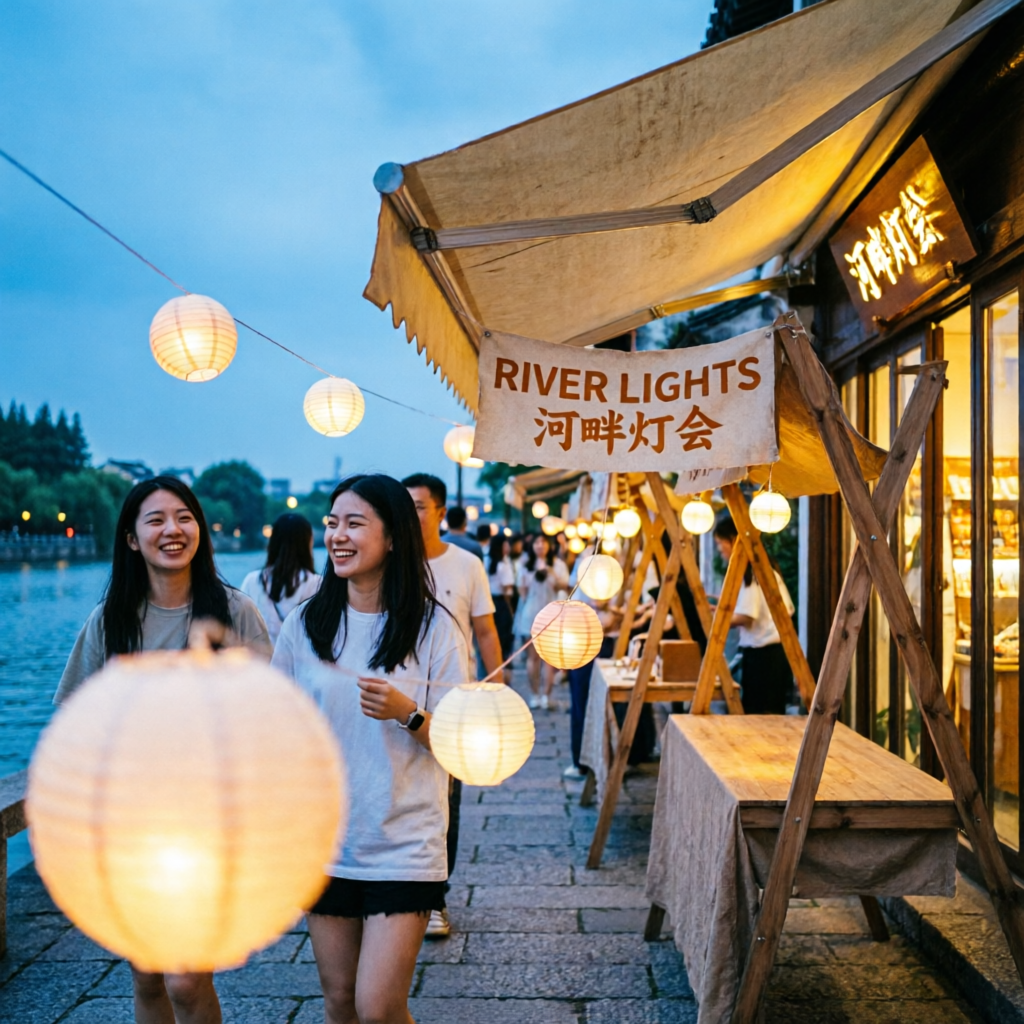
Qwen Image 3.0による複雑なテキスト描画
Qwen Image 3.0は、詳細なプロンプトを正確な指示追従と優れた複雑なテキスト描画を備えた画像へと変換します。階層、配置、ビジュアルスタイルを自然言語で指定すれば、モデルがその制約に沿って構図を組み立てます。横長のキャンペーングラフィック、情報量の多いイラスト、文字とビジュアルの連携が求められるプロダクトビジュアルに適した、実用的な選択肢です。
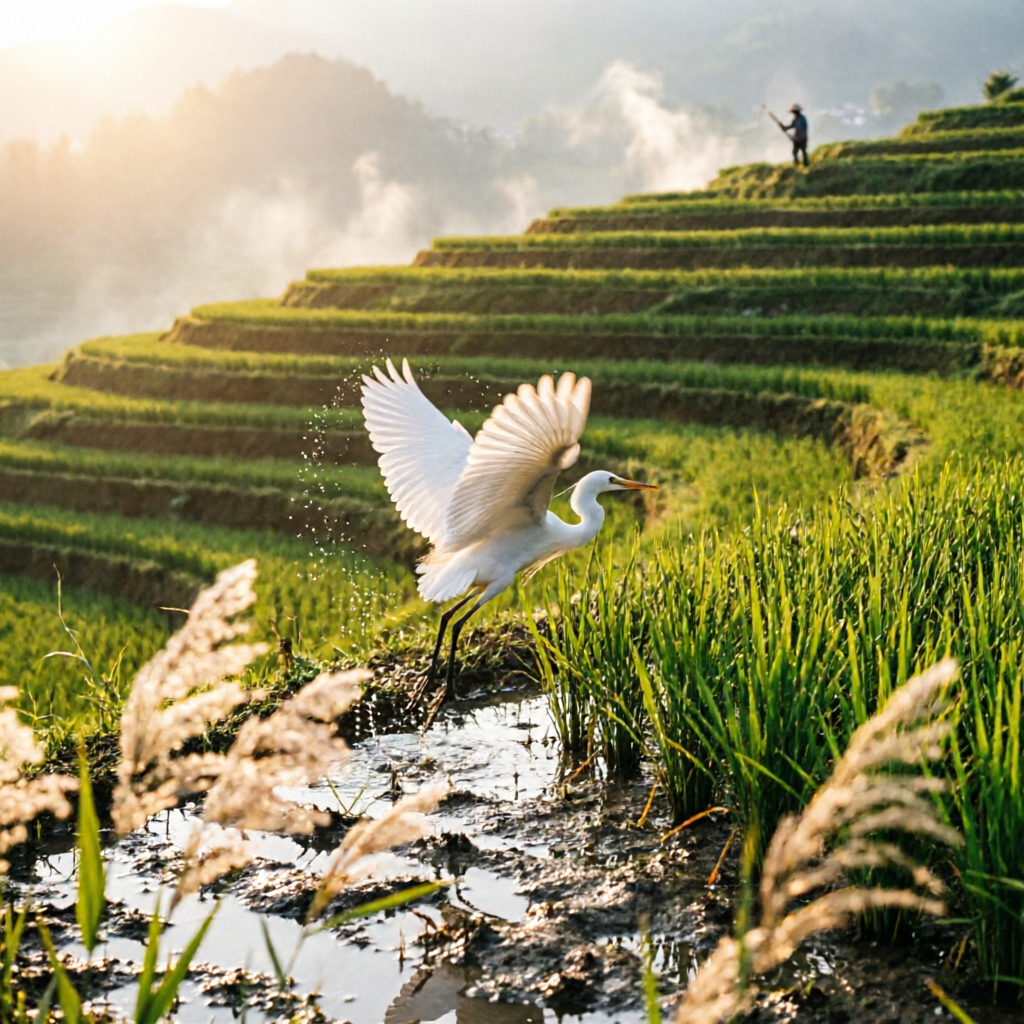
適応型2048ピクセル出力
512 × 512から2048 × 2048までの解像度で生成できます。サイズを省略すれば、Qwen Image 3.0がプロンプトに基づいて解像度を選択します。自動解像度ガイダンスにより、あらゆるアイデアを1つのプリセットに押し込むのではなく、要求されたシーンに合わせてキャンバスを調整できます。詳細な風景、横長バナー、正方形アセットなど、本番投入可能な鮮明さが必要なさまざまな納品形式に利用できます。
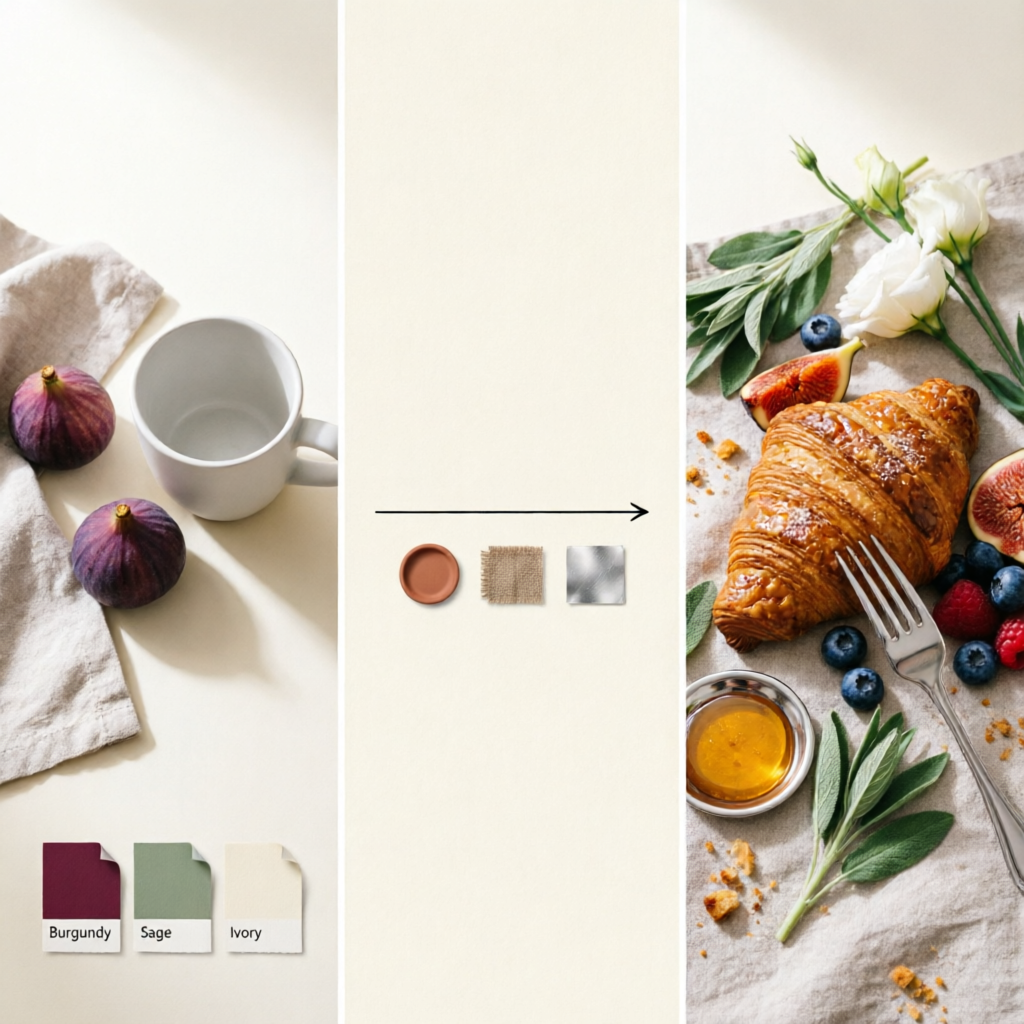
2つのプロンプト拡張パス
短いプロンプトは、Qwen Image 3.0が画像を生成する前に自動で拡張できます。1回で書き換えるダイレクトモードか、エージェント型の書き換えパイプラインを使うエージェントモードを選択でき、拡張を無効にして完全な手動制御を維持することも可能です。この柔軟性により、専門ユーザーを1つのプロンプト作成方法に縛ることなく、簡潔なブリーフからより豊かなシーンへ迅速に展開できます。
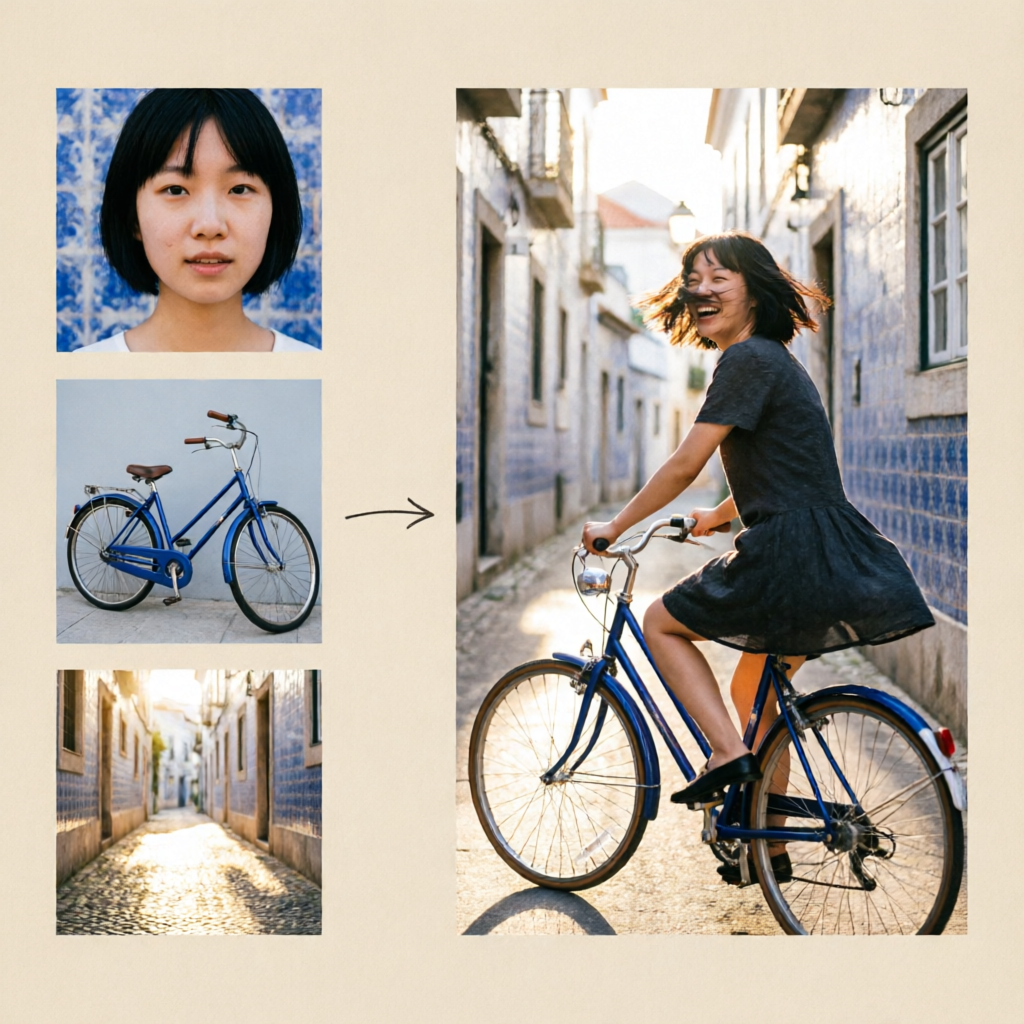
Qwen Image 3.0の複数参照画像編集
1枚、2枚、または3枚の参照画像と自然言語の指示を使って編集できます。Qwen Image 3.0は、顔の特徴を含む主要なアイデンティティ情報を維持しながら、指定された変換を新しい結果全体に適用します。人物、プロダクト、背景を参照画像として組み合わせたり、1枚の元画像を調整したりできます。キャンペーンのバリエーション作成、キャラクターの一貫性維持、制御されたビジュアル再構成に適したワークフローです。
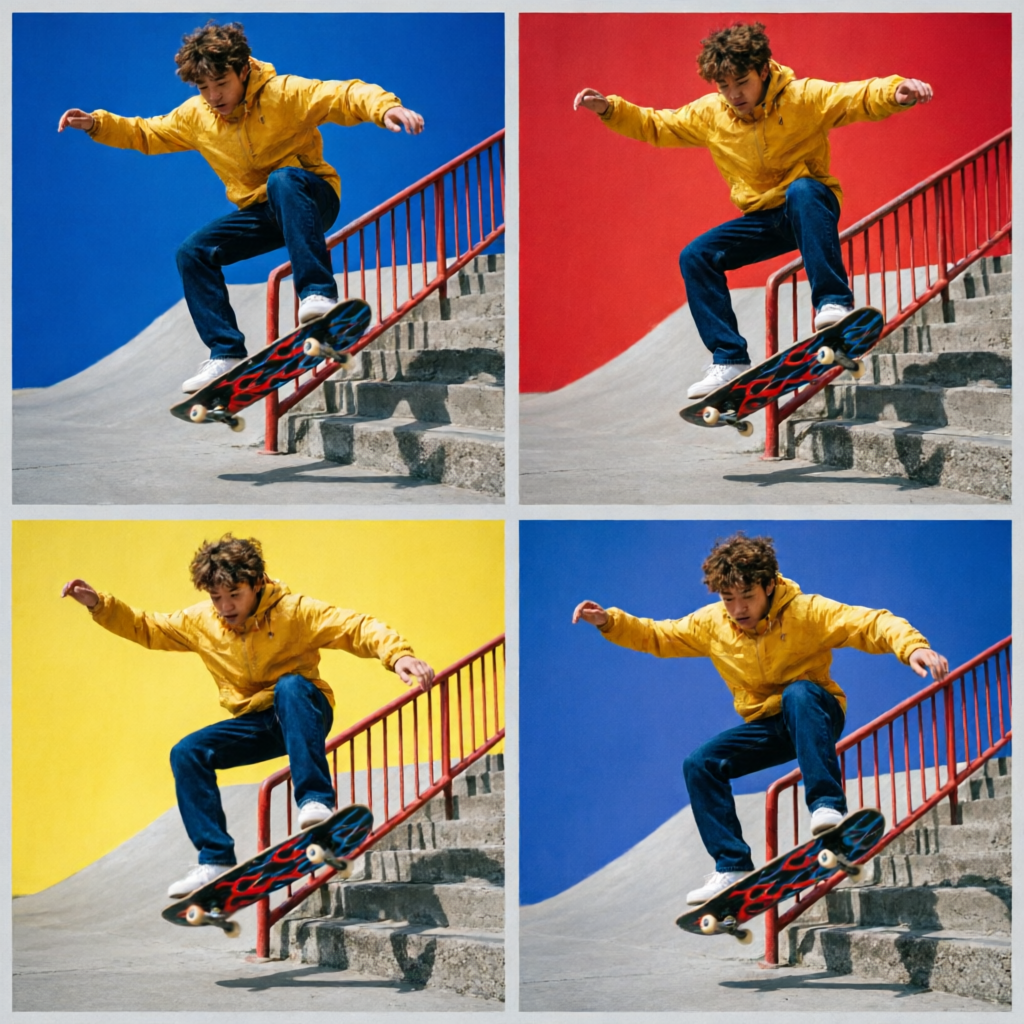
バッチ生成とシード制御
1回のリクエストで最大4枚の画像を作成し、ネガティブプロンプトで除外対象を指定できます。再現性が必要な場合は、0から2147483647までのシードを設定してください。新鮮なバリエーションが欲しい場合は、シードを未指定のままにします。これらの制御機能により、安定した再実行と意図的な多様性のどちらが必要な場合でも、アートディレクション、アセットの一括生成、テストワークフローでの比較と反復が容易になります。
1つのキー、1枚あたり$0.03
Qwen Image 3.0の生成と編集は、どちらもAtlas Cloudで確認済みの標準価格である1枚あたり$0.03で利用できます。1つのAPIキーで両方のモデルルートにアクセスできるため、別々のプロバイダーアカウントを用意せずに、新しいビジュアルの作成と参照画像の修正を切り替えられます。透明性の高い1枚単位の課金により、プロトタイプ、バッチ生成、反復編集を1つの予測可能なワークフローで管理できます。
Qwen Image 3.0:同一プロンプトによる画像比較
Qwen Image 3.0と比較対象となる2つの画像モデルが、タイポグラフィ、人物のディテール、ライティング、構図、素材のリアリティにおいて、同じ実用レベルのプロンプトをどのように解釈するかを確認します。
現代的な屋内飛び込み競技場で撮影した、ハイスピードの水面上下分割スポーツ写真。若いエリートダイバーが水面を突き抜ける決定的瞬間を捉える。鋭く切り立った水面より上には、完全に伸び切った足とつま先だけが、鮮明な白い水しぶきの爆発的な王冠の中に見えている。水面下には、選手の流線型に伸びた全身が、層状のターコイズ色の水中を下降していく様子を描き、乱流する気泡の軌跡、屈折した身体、きらめく歪んだ反射、プール底のレーンマーキングをはっきり見せる。プールサイドの電子スコアボードには、完全に読みやすい正確な文字「ROUND 03 / 9.6」を表示し、オレンジレッドのスイムキャップをかぶったチームメイトが、本物の驚きと歓喜に包まれて跳び上がっている。硬質で指向性のある正午の太陽光が天窓から斜めに差し込み、クリーンなボリューム光、エッジの鋭い影、発光する波状のコースティクス、人工的なグローに頼らない透明感のある奥行きを生み出す。水面をフレーム全体に水平に走らせ、繰り返すプールレーンがダイバーへ向かう強いリーディングラインを形成する構図。広がりのあるシアンと深いアクアを基調に、オレンジレッドのキャップを控えめなアクセントとして使用し、節度あるブルーとオレンジのカラーコントラストにする。フォトリアルな水の屈折、自然な若々しい肌の質感、正確なアスリートの身体構造、空中に浮かぶ水滴、重層的な透明感、水しぶきのエッジにのみごくわずかなモーションブラー、微細なアナログフィルムグレイン。本格的なエディトリアル・スポーツ写真、スプリットショット対応のドームポート付き水中ハウジング、速いシャッタースピード、24mm広角レンズ、明確な焦点の階層。過度に処理されたHDR、過剰なマイクロディテール、プラスチックのような肌、濁った色、ファンタジー風のグロー、濁った深海の暗さ、シネマティックなティールとオレンジのカラーグレーディング、奇形の手足、重複した身体、文字化けしたタイポグラフィ、枠線、フレーム、レターボックスは避ける。横長16:9のアスペクト比、フルブリード。
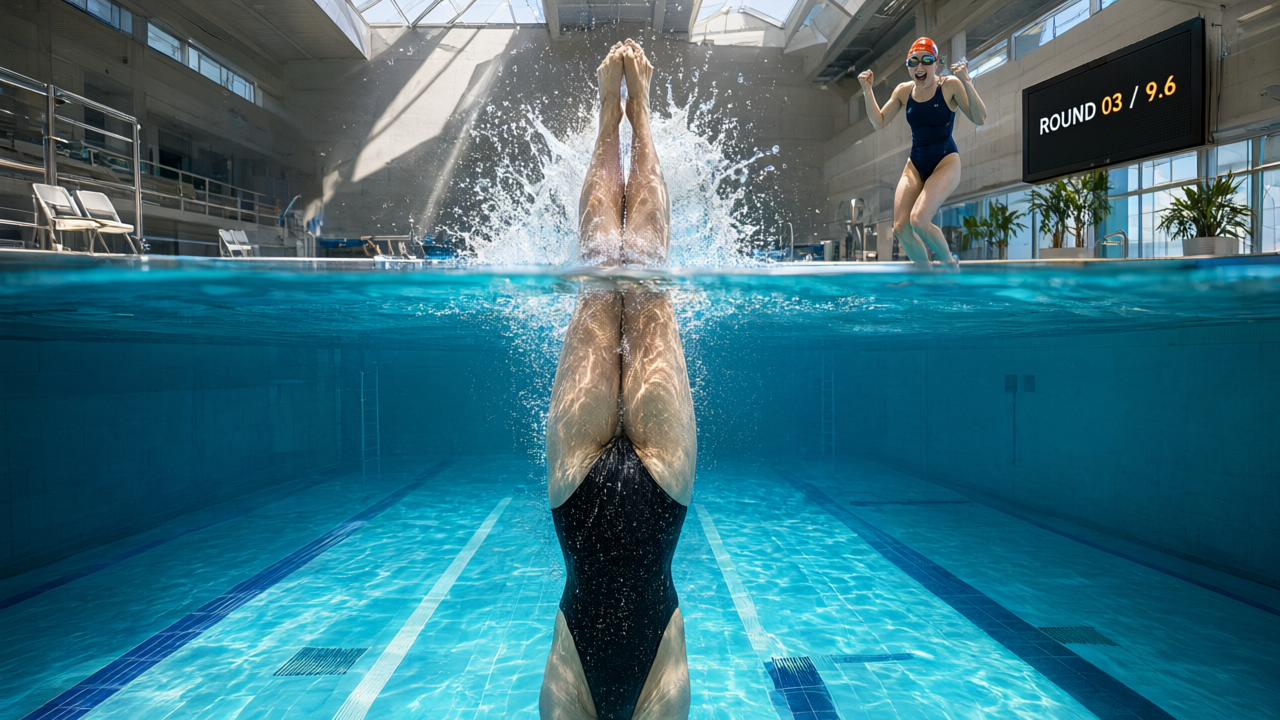
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
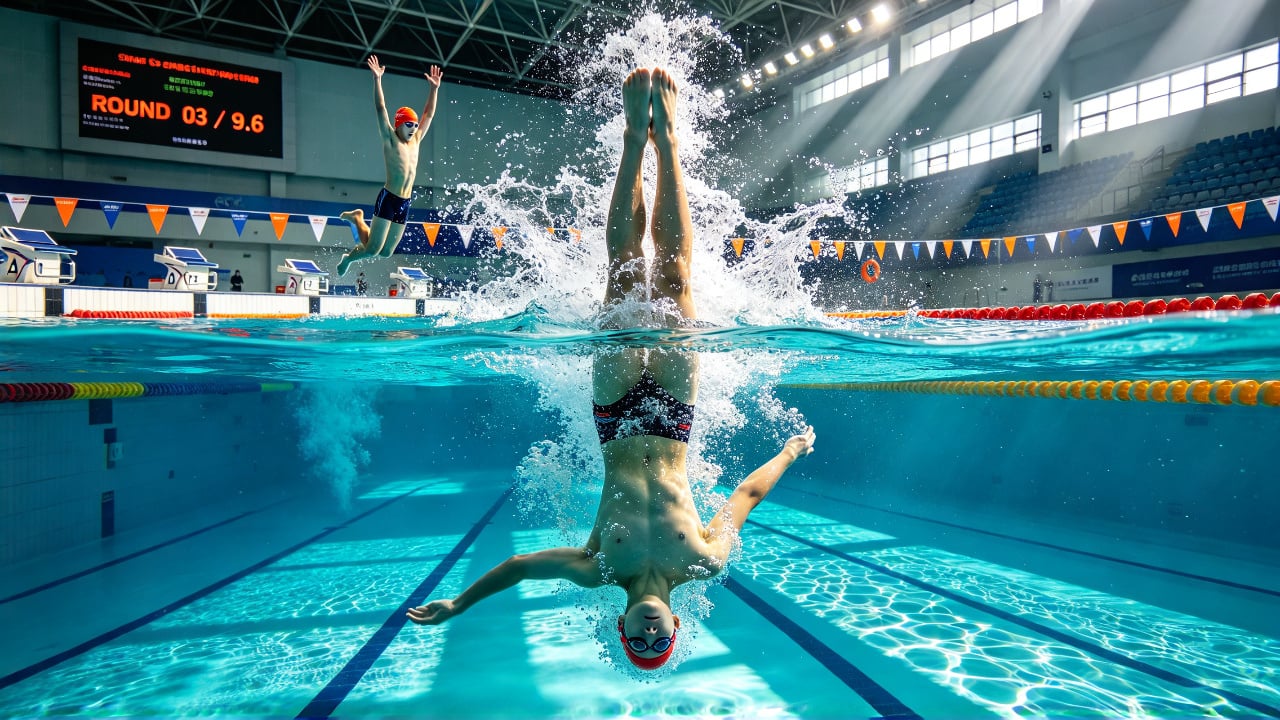
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
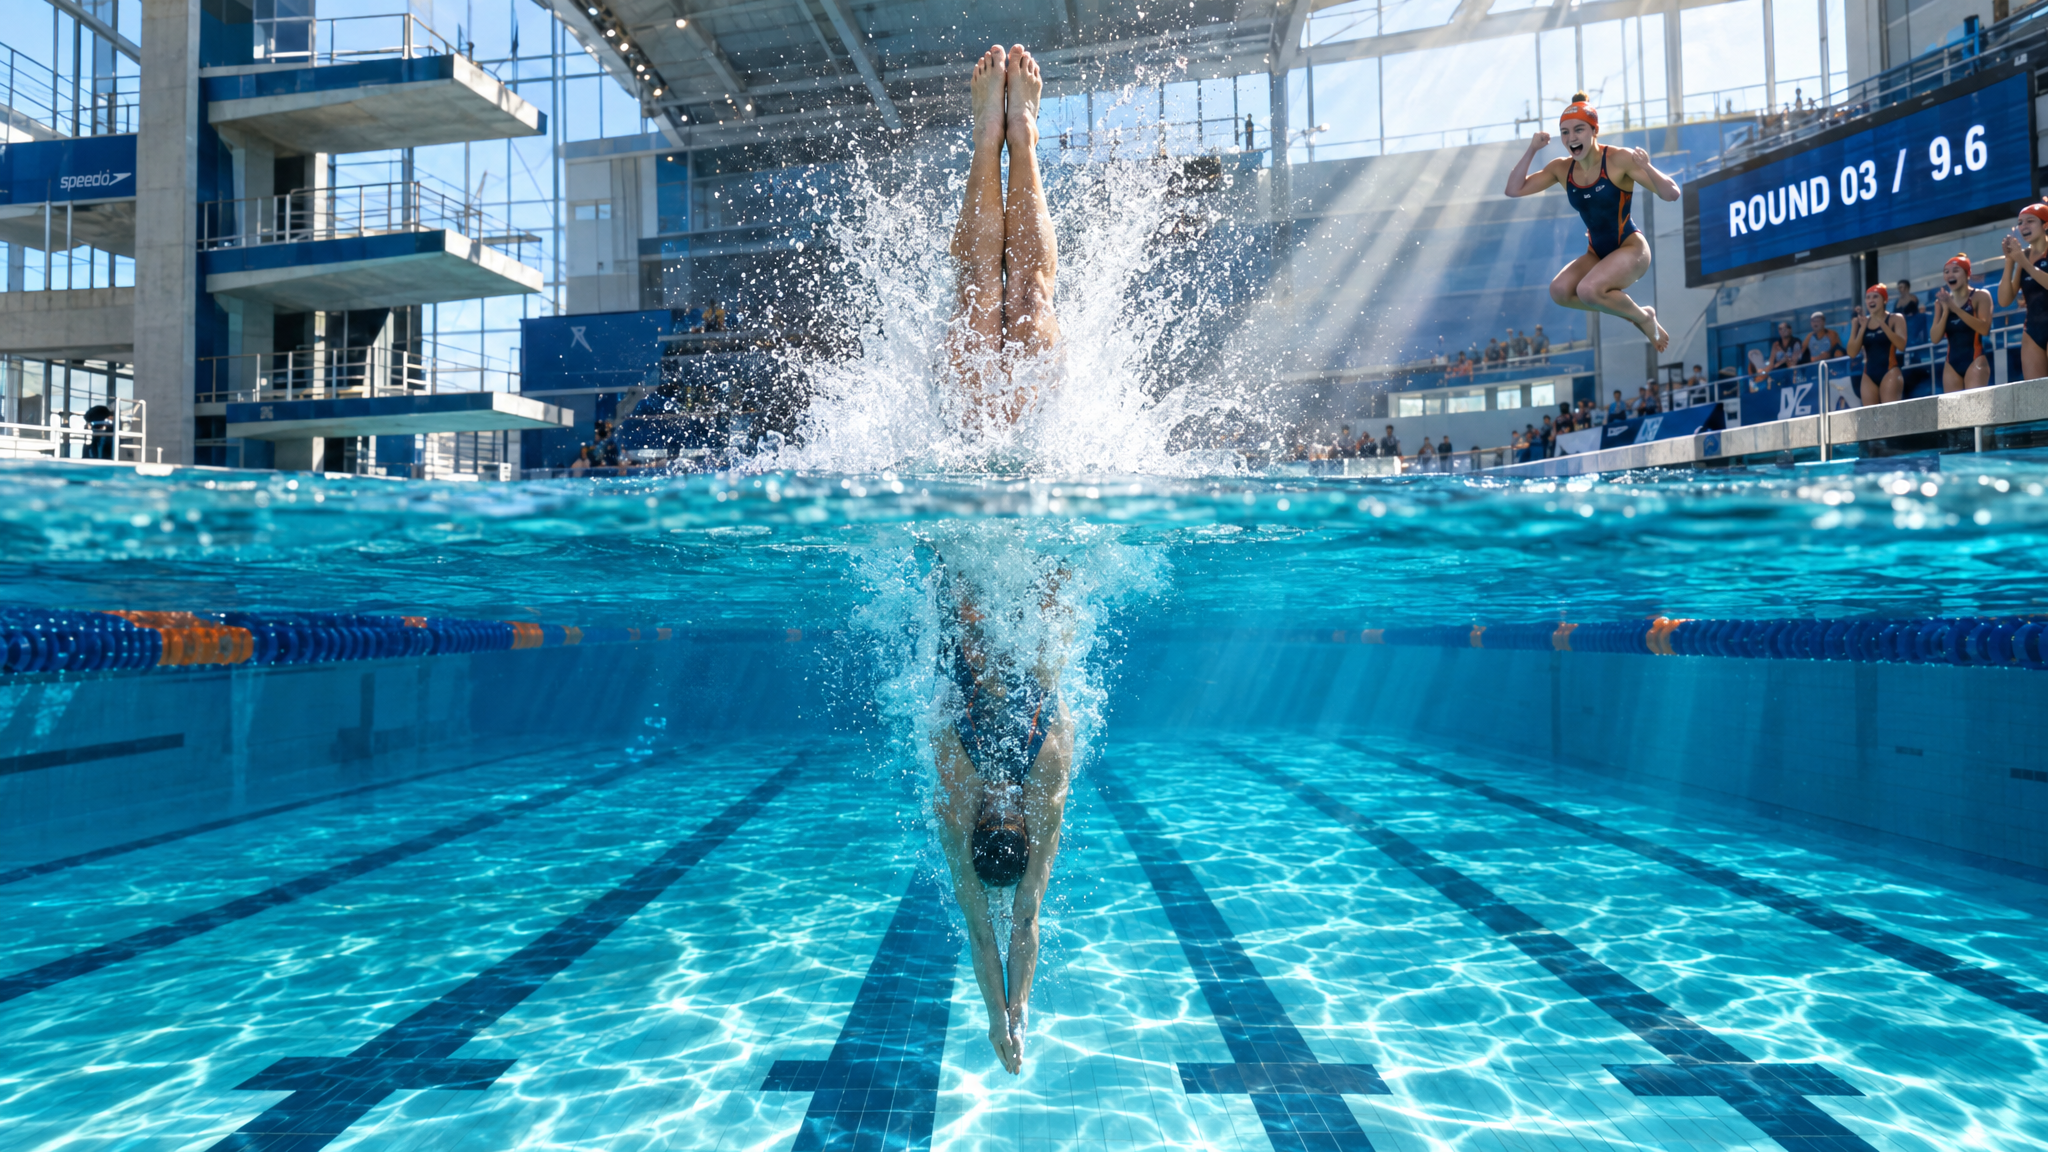
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
真夏の日差しが差し込む屋内飛び込み競技場で撮影した、超広角のプロフェッショナルなスポーツ写真。2人の若い成人による男女混合シンクロナイズドダイバーが飛び込み台を離れた直後の決定的な一瞬を捉える。2人のタイミングはわずかにずれており、印象的な鏡像のポーズを生み出す。一方の選手は直立し、もう一方は逆さまになっている。両者とも身体構造は正確で、明らかに空中に浮かび、濡れた髪、引き締まった筋肉、伸びたつま先、本物の競技用水着を備えている。プールサイドのチームメイトたちは上を見上げ、思わず驚いて息をのんでいる。明瞭に読み取れる電子スコアボードには、正確な文字「FINAL DIVE / 9.8」を表示する。高いクリアストーリー窓から冷たい白色の斜光が差し込み、細かな湿った霧を切り裂く。同時に、プールから反射したコバルトブルーの波紋が打ち放しコンクリートの壁を這い上がる。飛び込み台の構造を強いフレーム・イン・フレームとして使い、水面を第2の反射構図として扱う。建築的な遠近感は鮮明にし、スケールは説得力を持たせ、横方向には十分な空間的緊張感を確保する。抑制されたコバルトブルー、温かみのある自然な肌色、小さなセーフティオレンジのアクセント。リアルな水蒸気、水滴、湿った布地、微細なフィルムグレイン、ダイバーの手足と乱れた空気にのみ入るわずかな方向性モーションブラー。オリンピック級のエディトリアル・スポーツフォトジャーナリズム。ドラマチックでありながら自然な表現、低い位置からの広角視点、18mmレンズ、制御されたモーションの軌跡を伴う高速シャッター、シャープな焦点面、繊細なハイライトのロールオフ、ありのままの肌の質感。油っぽい過剰レンダリング、過剰なHDRディテール、プラスチックのような肌、濁った色、どこにでもあるようなグロー、安っぽく壮大なファンタジー表現、演出過剰なポーズ、歪んだ身体構造、重複した手足、読めない、またはスペルミスのあるスコアボード文字は避ける。横長の構図、16:9のアスペクト比、フルブリード。
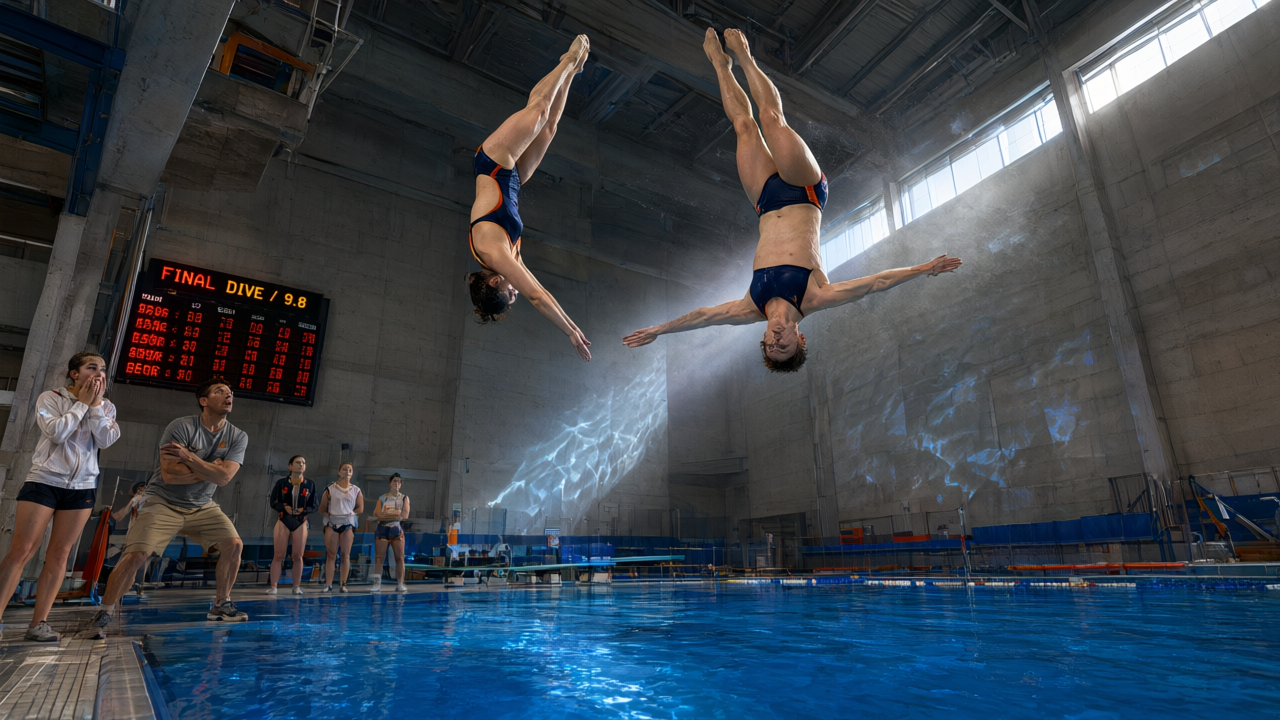
Generated with Qwen Image 3.0 Pro Text-to-Image on Atlas Cloud
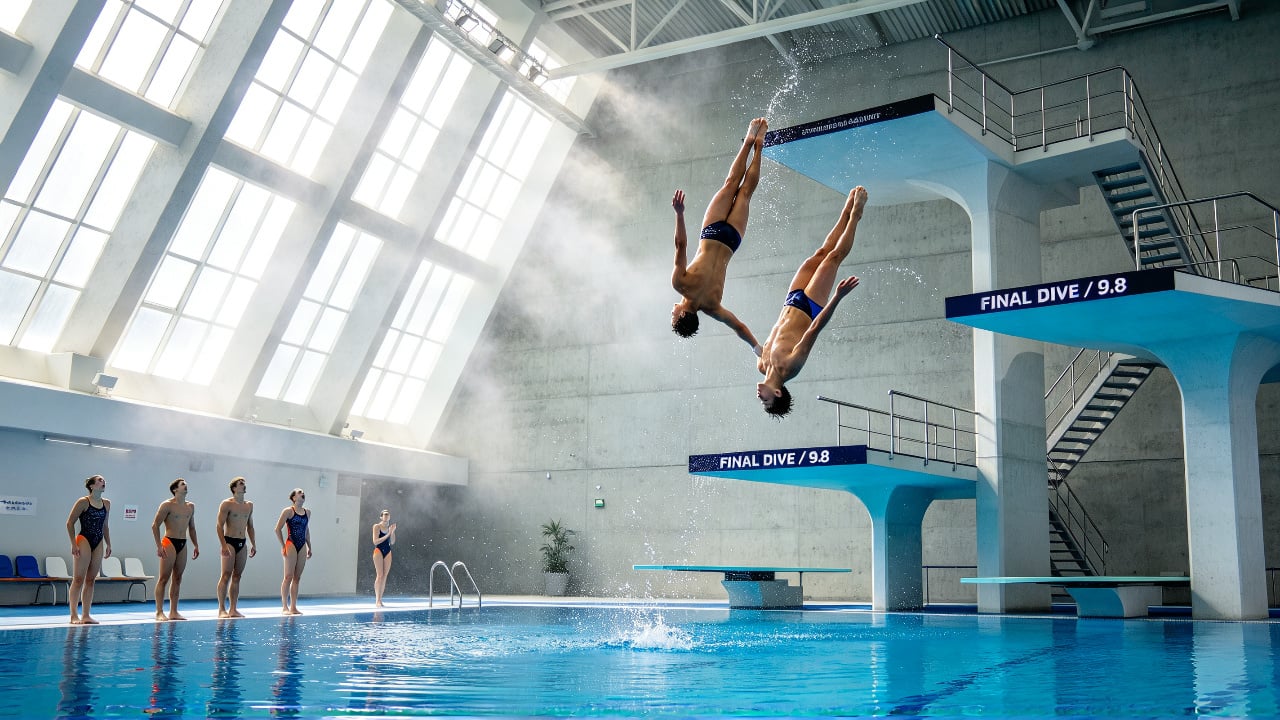
Generated with Seedream v5.0 Pro Text-to-Image on Atlas Cloud
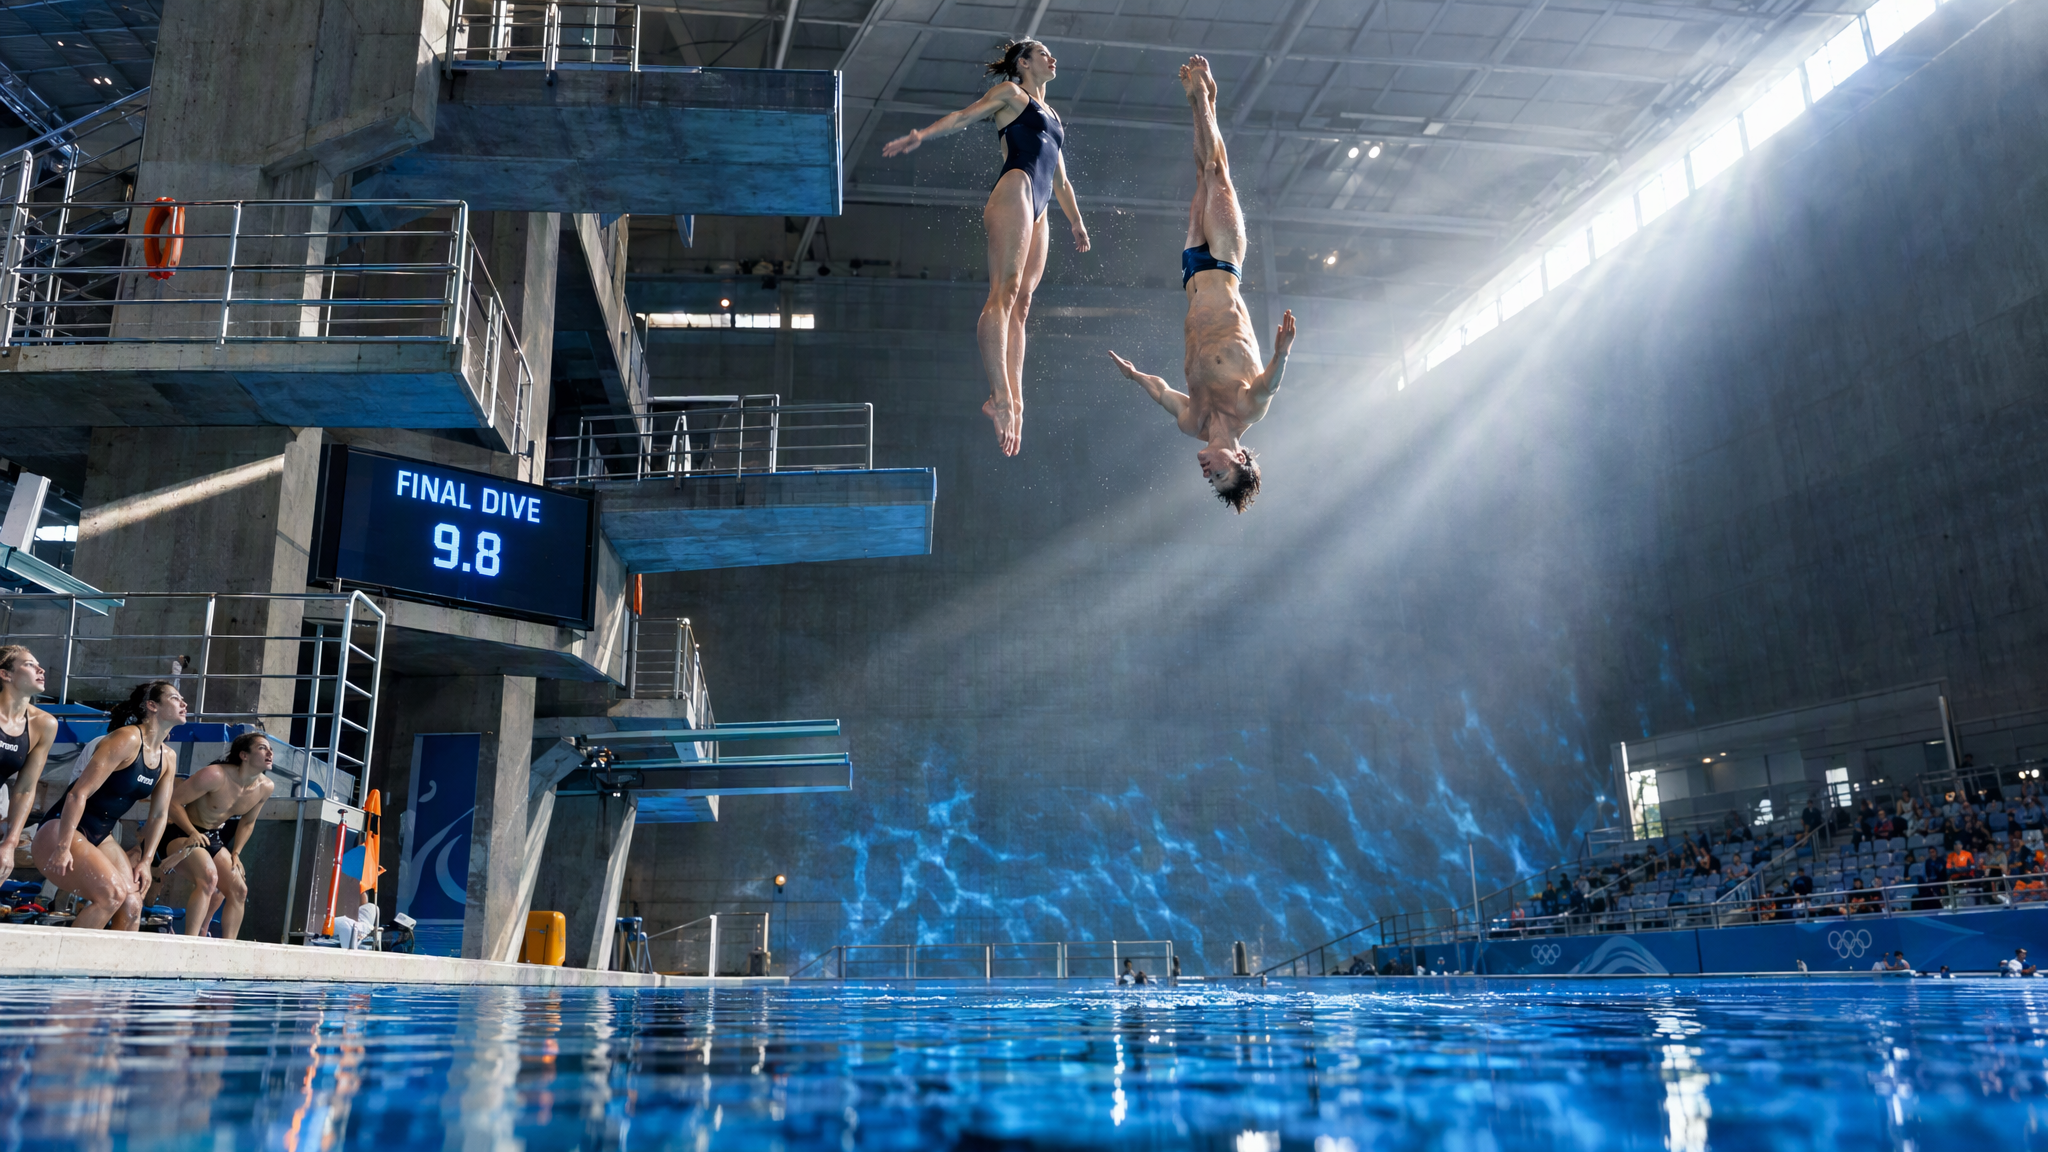
Generated with Qwen Image 3.0 Text-to-Image on Atlas Cloud
Qwen Image 3.0で本番用ビジュアルを制作
Qwen Image 3.0は、テキスト主導のキャンペーングラフィックや製品コンセプトの制作から、人物の同一性を保持した編集や複数参照画像によるアートディレクションまで対応し、マーケティングチーム、ストア運営者、デザインスタジオ、クリエイティブアプリケーション向けに最大2048×2048の画像を生成します。

Qwen Image 3.0のキャンペーングラフィック
詳細なプロンプトからキャンペーン画像を作成できます。プロンプトへの忠実な追従と、複雑なテキストの高精度な描画により、マーケティングチームは最大2048×2048の解像度で、ポスター、ローンチ用グラフィック、ソーシャルメディア用アセットを複数チャネル向けに制作できます。

製品コンセプトのビジュアル化
製品概要を、プロンプトの自動書き換えとプロンプトに基づく解像度選択を活用した詳細なコンセプト画像に変換します。デザイナーは、制作や撮影にリソースを投入する前に、パッケージ、グッズ、シーンの方向性を検討できます。

人物の同一性を保持したポートレート編集
自然言語の指示でポートレートのスタイルを変更しながら、元画像の顔立ちと人物の同一性を保持します。クリエイティブスタジオは、毎回被写体をゼロから作り直すことなく、衣装、背景、ビジュアル表現を更新できます。

Qwen Image 3.0の複数参照画像編集
1〜3枚の参照画像と自然言語の指示で編集をコントロールします。エージェンシーは、キャンペーン、カタログ、ブランドコンテンツの各バリエーションに合わせて構図を調整しながら、重要な人物の同一性やディテールを保持できます。

テキスト量の多いインターフェースのモックアップ
テキスト量の多いインターフェースのコンセプトが必要ですか?詳細な指示を、複雑なテキストを高精度に描画した画像モックアップへ変換できます。開発開始前の初期レビュー、デザイン検討、関係者間の認識合わせに向けて、プロダクトチームにより明確な検討材料を提供します。

Qwen Image 3.0によるビジュアルバリエーション
既存の画像から始め、重要なビジュアルのディテールを維持しながら、変更内容を正確に指定できます。開発者は、クリエイタープラットフォーム、コンテンツパイプライン、プロジェクト横断の迅速なアセット反復に向けた修正ツールを構築できます。
生成および編集の競合モデルにおけるQwen Image 3.0
ワークフロー、解像度、リファレンス画像数、標準の画像あたり価格に基づいて、Qwen Image 3.0と主要な画像生成・編集モデルを比較します。
| モデル | プロバイダー | ワークフロー | 最大出力解像度 | 最大リファレンス画像数 | 標準価格 |
|---|---|---|---|---|---|
| Qwen Image 3.0 Text-to-Image | Qwen | テキストから画像 | 2048×2048 | - | $0.03 / 画像 |
| Qwen Image 3.0 Edit | Qwen | 画像編集 | 2048×2048 | 3 | $0.03 / 画像 |
| Seedream v5.0 Flash Text-to-Image | ByteDance | テキストから画像 | 2K | - | $0.018 / 画像 |
| Seedream v5.0 Flash Edit | ByteDance | 画像編集 | 2K | 10 | $0.018 / 画像 |
| Grok Imagine Image 2.0 Text-to-Image | xAI | テキストから画像 | 2K | - | $0.04 / 画像 |
| Grok Imagine Image 2.0 Edit | xAI | 画像編集 | 2K | 5 | $0.04 / 画像 |
Atlas Cloud で Qwen Image 3.0 を使う方法
数分で始められます — 以下の簡単なステップに従って、Atlas Cloud プラットフォームでモデルを統合・デプロイしましょう。
Atlas Cloud アカウントを作成
atlascloud.ai でサインアップし、認証を完了します。新規ユーザーには無料クレジットが付与され、プラットフォームの探索やモデルのテストに使用できます。
Atlas CloudでQwen Image 3.0を使用する理由
高度なQwen Image 3.0モデルとAtlas CloudのGPU加速プラットフォームを組み合わせることで、比類のないパフォーマンス、スケーラビリティ、開発者エクスペリエンスを提供。
パフォーマンスと柔軟性
低レイテンシ:
リアルタイム推論のためのGPU最適化推論。
統合API:
1つの統合でQwen Image 3.0、GPT、Gemini、DeepSeekを実行。
透明な料金:
サーバーレスオプション付きの予測可能なtoken単位の課金。
エンタープライズとスケール
開発者エクスペリエンス:
SDK、分析、ファインチューニングツール、テンプレート。
信頼性:
99.99%の稼働率、RBAC、コンプライアンス対応ロギング。
セキュリティとコンプライアンス:
SOC 2 Type II、HIPAA準拠、米国内のデータ主権。
Qwen Image 3.0 API よくある質問
Qwen Image 3.0は、テキストからの画像生成と、指示ベースの画像編集に対応した画像モデルファミリーです。複雑なテキスト描画、プロンプトへの正確な追従、細部まで表現されたビジュアルの作成を目的に設計されています。
テキストプロンプトから画像を直接生成したり、自然言語による指示で既存のビジュアルを変換したりできます。詳細な構図、テキストを多く含むグラフィック、ポートレート、商品ビジュアル、提供された画像への制御された変更に対応しています。
Atlas Cloudのプレイグラウンドを使用するか、API経由で認証済みリクエストを送信してください。プロンプトベースの生成にはテキストから画像生成用のエンドポイントを、参照画像を使用する場合は編集用のエンドポイントを選択します。
新しい画像を生成する場合は、`qwen-image-3.0/text-to-image`を選択してテキストプロンプトを指定してください。既存のコンテンツを編集する場合は、自然言語による指示と1枚以上の参照画像を指定して`qwen-image-3.0/edit`を使用します。
テキストから画像生成の出力は最大2048 × 2048の解像度に対応しています。サイズを指定しない場合は、プロンプトに応じてモデルが適切な解像度を選択できます。利用可能な制御機能には、画像サイズ、出力枚数、ネガティブプロンプト、シード、プロンプトの書き換えがあります。
編集エンドポイントでは、自然言語による指示とともに1〜3枚の参照画像を指定できます。顔の特徴、アイデンティティ、構図、ビジュアルコンテキストなど、変更内容と維持したい要素の両方を説明してください。
Atlas Cloudでは、テキストから画像生成用と編集用の両エンドポイントを1回呼び出すごとに、標準料金として$0.03がかかります。サブスクリプションは不要で、透明性の高い従量課金制が適用されます。
短いプロンプトに、より詳しい説明や構造が必要な場合は、自動プロンプト書き換えを有効にしてください。プロンプトがすでに正確で、その文言により忠実に従わせたい場合は、無効にします。
このFAQの確認対象となった公式APIドキュメントでは、ホスト型アクセスについて説明されていますが、ダウンロード可能なQwen Image 3.0のモデルウェイトについては確認されていません。セルフホスティングが必要な場合は、アーキテクチャを選定する前に、Qwenの最新リリースとライセンス情報を確認してください。
さらにファミリーを探索
Seedance 2.5
Seedance 2.5 APIがAtlas Cloudで利用可能になりました!これにより、開発者はByteDanceの最新の動画モデルを利用できます。テキスト、単一の画像、または最大50のマルチモーダルな参照から、同期されたオーディオとフレーム内の多言語テキストを含む最大30秒のネイティブ動画をシングルパスで生成します。Atlas Cloudでは1つのキーでアクセスでき、被写体の一貫性と改善された物理演算により、ロングショットの整合性が保たれます。

Wan 3.0
Wan 3.0 APIは、AlibabaのWanビデオファミリーの次世代モデルであり、長尺動画生成、マルチリファレンス制御、およびオーディオビジュアル品質を新たな高みへと押し上げるために構築されました。Atlas CloudはすでにWan 2.7、2.6、2.5をホストしており、Wan 3.0は追加のセットアップなしで同じ統合キーで実行されます。今日から開発を始めましょう。Wan 3.0で何を作成できるかを確認するには、下のショーケースまでスクロールしてください。
MiniMax H3
MiniMax H3は、テキスト、画像、リファレンスによる生成に対応したMiniMaxのマルチモーダル動画ファミリーです。対応するルート全体で参照メディアの被写体を保持し、柔軟なアスペクト比を提供します。また、H3 Developerを通じて生成音声と映像を組み合わせ、出力プロファイルはエンドポイントごとに選択されます。Atlas Cloudは、1つのOpenAI互換キーのもとでこのファミリーを統合し、標準料金である1秒あたり$0.038からの明瞭な従量課金制を提供します。今すぐ開発を始めましょう。
Seedream 5.0 Pro
Seedream 5.0 Pro API は、開発者に Atlas Cloud 上で ByteDance の制御可能な画像編集モデルを提供します。アンカーと座標を使用して編集を正確に配置し、画像を編集可能なレイヤーに分離し、複数の参照を融合し、正確な色と素材を一致させ、2K および 3K での多言語テキストをサポートします。Atlas Cloud では、単一のキーでアクセスできます!
Seedance 2.0
Seedance 2.0は、正確なショット作成に対応したByteDanceの本番向け動画モデルです。プロンプトから動画を生成したり、オプションの最終フレームガイダンスを使って先頭フレームの画像をアニメーション化したり、参照メディアとオプションのウェブ検索で結果を形作ったりできます。Atlas Cloudは、これらのワークフローを透明性の高い従量課金と1つのOpenAI互換キーで、統合されたAPIにまとめます。今すぐ開発を始めましょう。
GPT Image 2.5
OpenAIのgpt-image-2.5ファミリーでは、本番の画像ワークフロー向けにFlareとSunburstを選択できます。最大3840x2160までの任意の解像度でレンダリングし、xhighやmaxを含む5段階の品質ティアから、具体的な出力要件に合ったものを選択できます。Atlas Cloudでは、コールドスタートなしですぐに使えるREST推論を、生成1回あたり$0.004からの標準料金で提供しています。今すぐ開発を始めましょう。
GPT Image 2
GPT Image 2 API は、GPT Image 1.5 の後継となる OpenAI の最新画像モデルへのアクセスを開発者に提供します。ラテン文字およびCJKスクリプト全体で正確なテキストレンダリングを使用して画像を生成および編集できるほか、ポスター、モックアップ、インフォグラフィック向けの強力なコンポジション(構図)機能を備えています。Atlas Cloud では、300以上のモデルと並んで1つの統合 API を通じてアクセスでき、無料クレジット、99.99% のアップタイムが提供され、OpenAI の組織検証は不要です。
Gemini Omni Flash
Gemini Omni APIは、Gemini Omni 1.1 Flashを含む、Google DeepMindのネイティブマルチモーダルなGemini Omni Flashファミリーを開発者に提供します。ネイティブ音声を同期したシネマティックな動画の作成、正確な開始フレームと終了フレームの制御による静止画のアニメーション化、または変更していない部分を保持したテキスト指示による既存映像の編集が可能です。Atlas Cloudは、OpenAI互換のキー1つで、統合されたアクセスと透明性の高い従量課金制を提供します。今すぐ開発を始めましょう。
Grok Imagine
Grok Imagine API は、Image 2.0 から Video 1.5 および xAI TTS v1 まで、xAI の画像、ビデオ、音声モデルをカバーしています。1K または 2K の静止画を 14 のアスペクト比でレンダリング、シーンを 15 秒の 1080p モーション映像に変換、最大 7 つの参照画像でショットを操作、または 20 言語でナレーション可能です。Atlas Cloud はすべてのモードを 1 つのエンドポイント上で実行でき、画像あたり $0.02、秒あたり $0.05 からの従量課金制です。今すぐビルドを開始してください。
Googleの最も強力なクリエイティブモデルはすべてAtlas Cloudで利用可能です。Veo 3.1はシネマティックな動画生成を実現し、Nano Banana 2は高忠実度な画像作成を強化し、Geminiはあらゆるワークフローにマルチモーダルなインテリジェンスをもたらします。Day-0の可用性と従量課金制(pay-as-you-go)の料金体系を備えた単一のAPI keyを通じて、Googleモデルスイート全体にアクセスできます。
Seedance 2.0 Mini
Seedance 2.0 Mini は、速度とコストが最も重視されるワークフローに ByteDance のマルチモーダル動画生成をもたらします。より軽量なフットプリントで Seedance 2.0 のコア機能を提供し、より高速な生成、動画あたりのコスト削減、そしてすでに使用しているものと同じ API 統合を実現します。大容量のパイプラインを運用したり、大規模なプロトタイピングを行ったりするチームにとって、Mini は実用的なデフォルトの選択肢です。
ByteDance
シネマティックな動画生成から高忠実度の画像作成まで、ByteDanceの最も強力なモデルがAtlas Cloudで利用可能になりました。最低水準の推論価格とゼロのインフラストラクチャオーバーヘッドで、SeedanceとSeedreamを大規模に実行できます。
おすすめ記事
Atlas Cloud を最大限に活用するためのガイド、チュートリアル、製品アップデート。


