GPT Image 2.6 API: 50% Faster Image Generation with Animated GIF Output
Interfejs API GPT Image 2.6 udostępnia programistom model obrazu OpenAI wydany 4 listopada 2026 r. w dwóch wersjach: Flare do szybkiej iteracji i Sunburst do szczegółowej pracy wizualnej. Generuje obrazy o 50% szybciej niż poprzednio i dodaje obsługę animowanych plików GIF, eksport do SVG, edycję znaczników skierowaną na zakreślony obszar oraz ustawienie złożoności. Atlas Cloud obsługuje oba modele za pomocą jednego klucza zgodnego z OpenAI w modelu płatności za użycie.
GPT Image 2.6 został opracowany przez OpenAI. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.


GPT Image 2.6 Flare API vs Sunburst API
Te same funkcje, dwa priorytety. Wybierz w zależności od tego, jak szybko potrzebujesz wyników i w jakim stopniu zamierzasz je edytować.
GPT Image 2.6 Flare API: Szybka iteracja i przejrzyste układy
GPT Image 2.6 Flare został stworzony z myślą o interaktywnym generowaniu i edycji, gdzie użytkownik oczekuje na każdy wynik. Przy niskiej jakości może zwrócić obraz w zaledwie sześć sekund, co zapewnia płynność pracy nad szkicami, wariantami i edycjami w aplikacji. OpenAI poprawiło również jakość układu Flare dla plakatów, zdjęć produktów i innych profesjonalnych materiałów wizualnych, dzięki czemu może on dostarczać gotowe zasoby marketingowe, jak również wstępne koncepcje. Połącz go z niską złożonością, aby uzyskać najszybszą edycję.
GPT Image 2.6 Sunburst API: Detale, które zostają zachowane mimo edycji
GPT Image 2.6 Sunburst to wybór dla szczegółowych kompozycji i edycji, które wymagają kilku etapów pracy. Zapewnia wyższą jakość generowania, a przy średniej lub wysokiej jakości utrzymuje większą spójność postaci, produktów i detali marki pomiędzy kolejnymi edycjami. Stosuj go w kluczowych wizualizacjach kampanii, zestawach produktów, które muszą do siebie pasować, oraz w przypadku postaci przechodzących liczne poprawki. Praktycznym rozwiązaniem jest eksploracja w Flare, a następnie przeniesienie wybranego kierunku do Sunburst w celu wykonania finalnego renderowania.
Poza statycznymi obrazami: Co dodaje API GPT Image 2.6
Niezależnie od tego, czy wywołujesz Flare czy Sunburst, GPT Image 2.6 API potrafi animować prompt do pliku GIF, eksportować edytowalne pliki SVG, podążać za edycjami zaznaczonymi na obrazie oraz pozwala ustawić stopień planowania modelu przed renderowaniem.
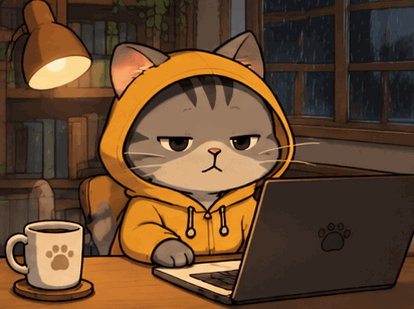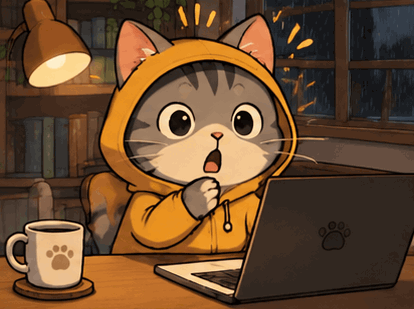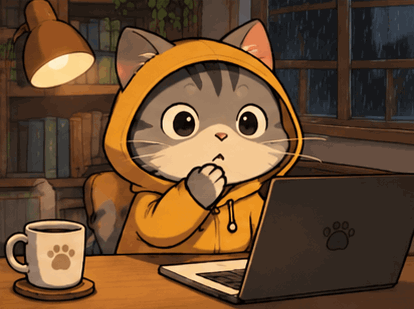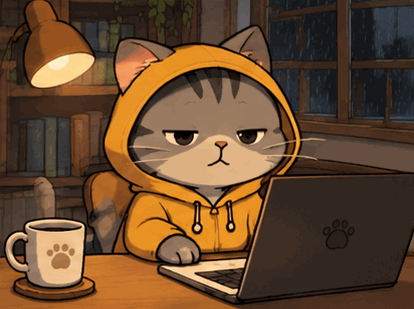
Animowane GIF-y z Jednego Promptu
Opisz obiekt, jego ruch i pożądaną pętlę, a API GPT Image 2.6 zwróci gotowy animowany GIF. Wybierz od 2 do 64 klatek i od 20 do 2000 milisekund na klatkę – zakres ten idealnie nadaje się do maskotek marek, reakcji w mediach społecznościowych i storyboardów testujących ruch postaci przed produkcją wideo.
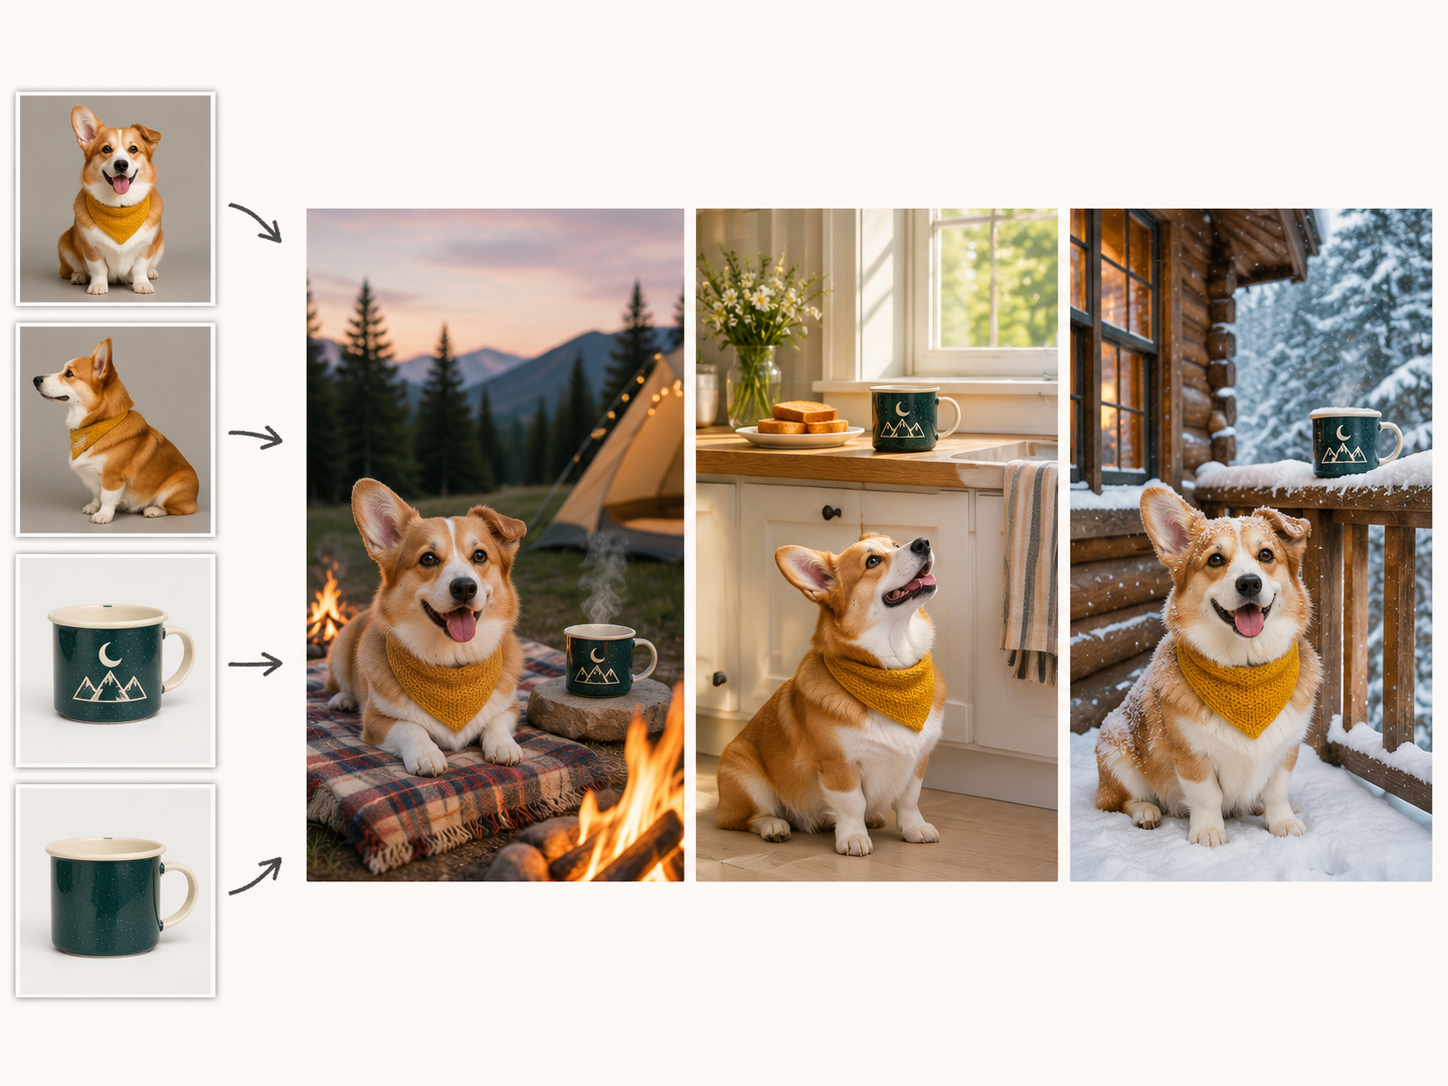
Ponownie użyj swojego zestawu referencyjnego
Prześlij zdjęcia postaci, produktu lub zwierzaka raz, a następnie w każdym nowym żądaniu wskaż te same pliki za pomocą adresu URL lub identyfikatora pliku zamiast wysyłać je ponownie. Każde żądanie edycji akceptuje do 16 obrazów referencyjnych, a Sunburst w średniej lub wysokiej jakości zachowuje te szczegóły bardziej spójnie podczas wprowadzania poprawek.
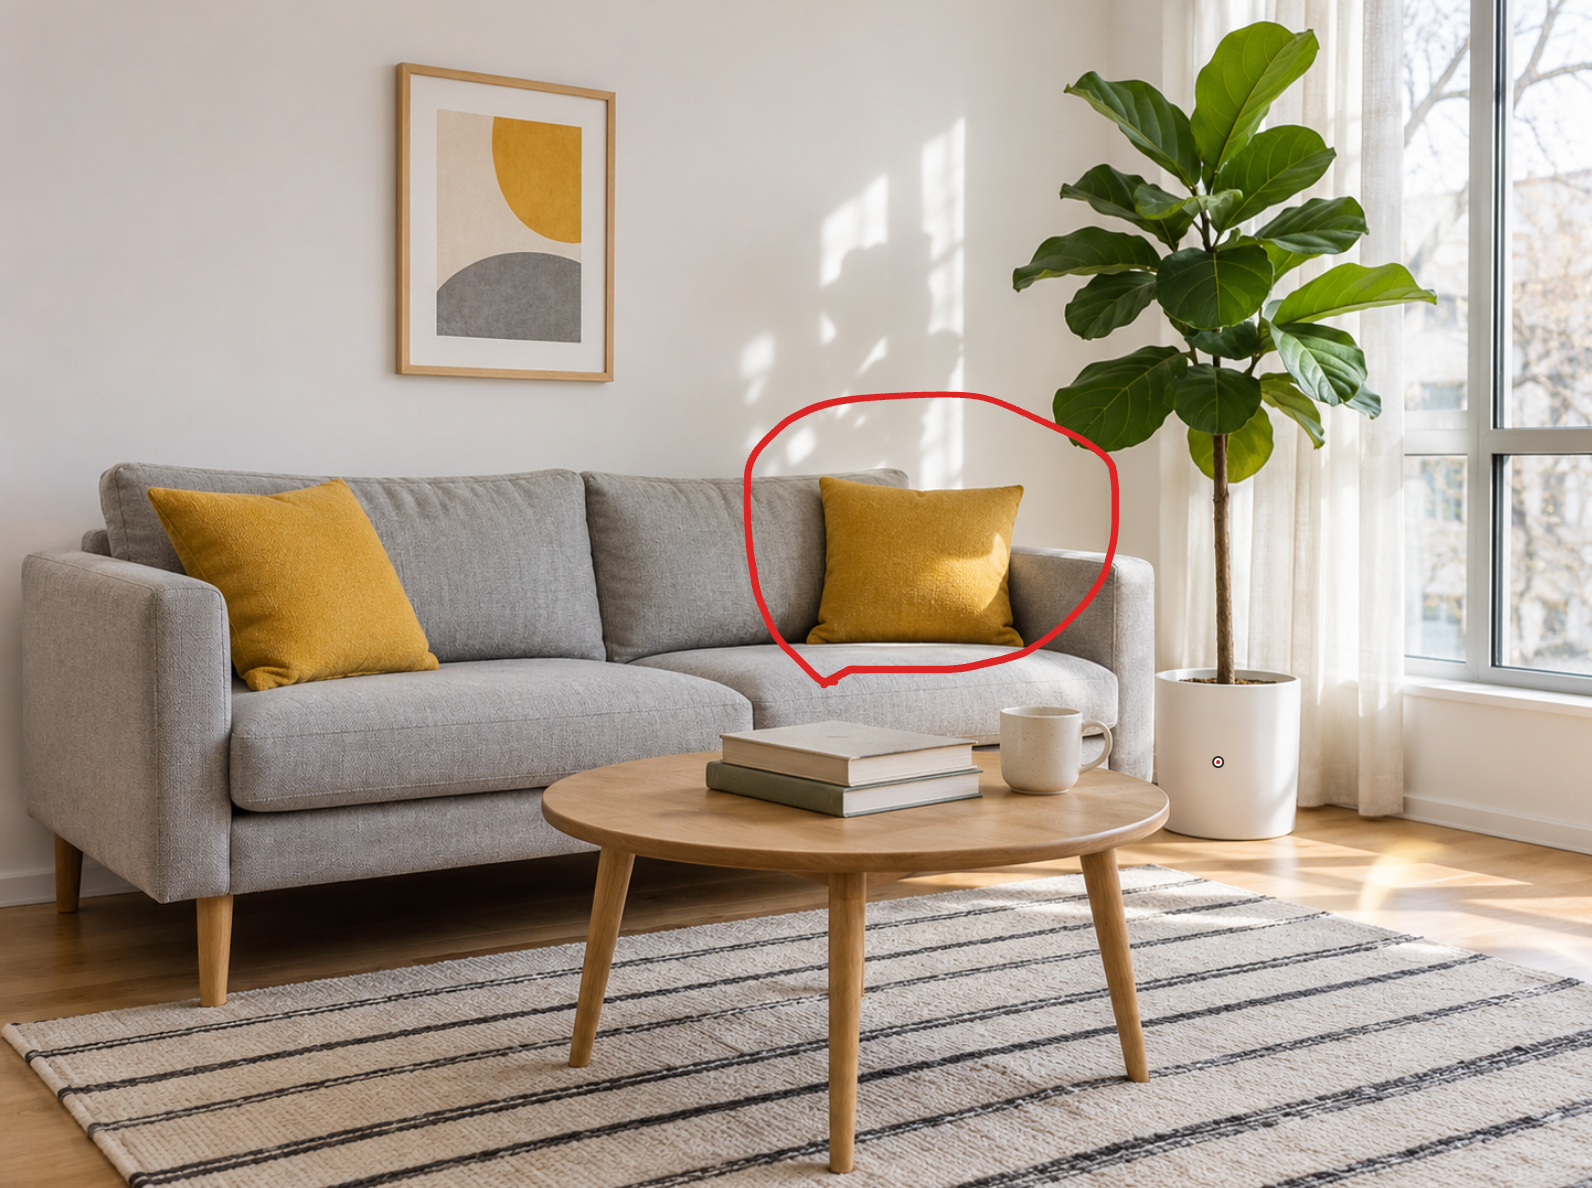
Zaznacz miejsce, a następnie edytuj
Narysuj okręgi lub szkice na przezroczystej warstwie, prześlij ją jako oznaczenie (markup) wraz z oryginalnym zdjęciem i wskaż, co należy zmienić. Model wykorzystuje Twoje oznaczenia do zlokalizowania obszaru edycji, a wszelkie dodatkowe załączone obrazy służą jako materiały referencyjne. Po debiucie w ChatGPT funkcja Markup trafia do interfejsu API w tym wydaniu.
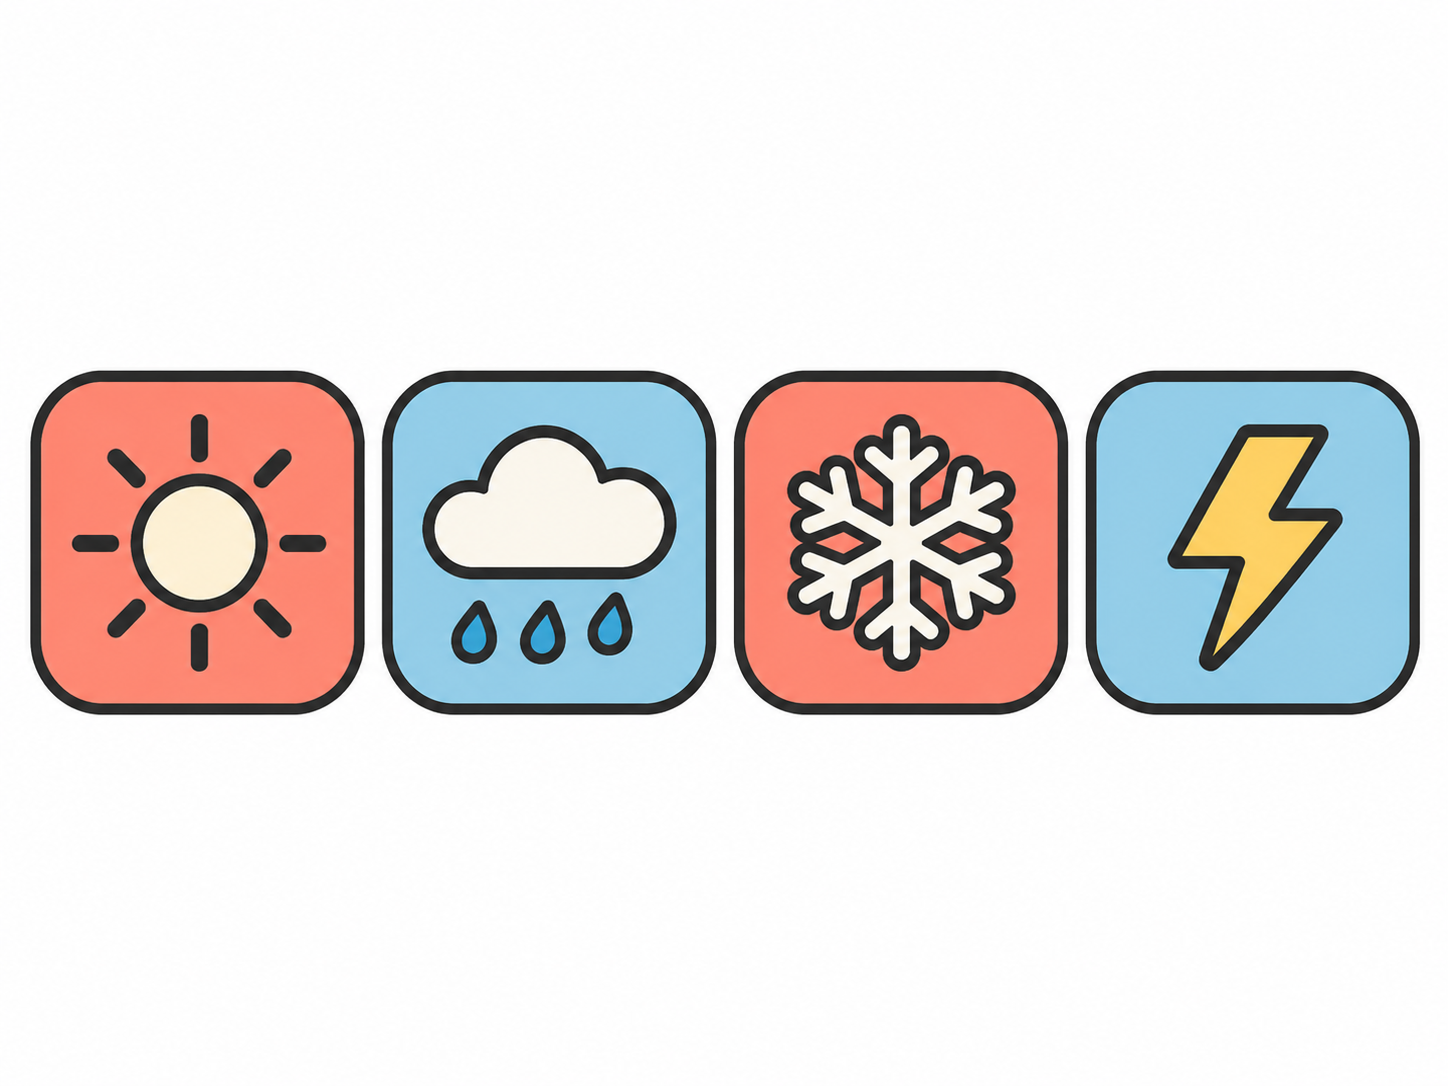
Edytowalne pliki wektorowe
Potrzebujesz logo lub ikony, które skalują się bez utraty jakości? Ustaw format wyjściowy na SVG, a GPT Image 2.6 API zwróci statyczny plik wektorowy z edytowalnymi ścieżkami, kształtami i kolorami, gotowy do użycia na stronach internetowych, w aplikacjach i druku. Format SVG pochodzi z punktu końcowego generowania w ilości jednego obrazu na żądanie.
Szybsze szkice, stabilniejsze poprawki
Według OpenAI, GPT Image 2.6 generuje obrazy o 50% szybciej niż wcześniej. Przy niskiej jakości, Flare może zwrócić obraz w zaledwie sześć sekund i czyściej układa plakaty oraz zdjęcia produktów, podczas gdy Sunburst przy średniej lub wysokiej jakości utrzymuje większą spójność postaci, produktów i szczegółów marki między edycjami.
Jak używać GPT Image 2.6 na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać GPT Image 2.6 na Atlas Cloud
Połączenie zaawansowanych modeli GPT Image 2.6 z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj GPT Image 2.6, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
GPT Image 2.6 FAQ
API GPT Image 2.6 to model OpenAI do generowania i edycji obrazów, wydany 4 listopada 2026 roku w dwóch wersjach: Flare do szybkiej iteracji oraz Sunburst do szczegółowych prac wizualnych. Obie wersje akceptują wprowadzanie tekstu i obrazów oraz zwracają gotowe grafiki. Ta wersja dodaje obsługę animowanych plików GIF, eksport do formatu SVG, edycję sterowaną znacznikami oraz ustawienie złożoności; OpenAI informuje, że generuje obrazy o 50% szybciej niż wcześniej.
Flare został stworzony do pracy interaktywnej i może wygenerować obraz w zaledwie sześć sekund w niskiej jakości, oferując ulepszone układy dla plakatów i zdjęć produktów. Sunburst generuje obrazy wyższej jakości, a przy średniej lub wysokiej jakości zapewnia większą spójność postaci, produktów i detali marki podczas edycji. Obie wersje korzystają z tych samych danych wejściowych, funkcji i stawek tokenów OpenAI, więc wybór sprowadza się do balansu między szybkością a szczegółowością.
Według OpenAI, GPT Image 2.6 generuje obrazy o 50% szybciej niż wcześniej, a Flare poprawia jakość układu plakatów i zdjęć produktów. API dodaje obsługę animowanych plików GIF i SVG w punkcie końcowym generowania, a także ustawienie złożoności, które kontroluje poziom planowania modelu. Wraz z tą wersją do API wprowadzono również edycję wspomaganą znacznikami, która działa także z GPT Image 2.5.
OpenAI podaje, że GPT Image 2.6 generuje obrazy o 50% szybciej niż wcześniej. Przy niskiej jakości Flare może zwrócić obraz w zaledwie sześć sekund, podczas gdy wyższe poziomy jakości, większa złożoność i gęste prompty wymagają więcej czasu, do dwóch minut w przypadku skomplikowanych żądań. Aby uzyskać najszybsze rezultaty, połącz Flare z niską jakością, niską złożonością i wyjściem JPEG.
Za token, nie. Obie wersje GPT Image 2.6 rozliczają generowanie obrazów w cenie 30 USD za milion tokenów, co jest taką samą stawką jak w przypadku GPT Image 2.5. Za obraz niższe poziomy kosztują więcej, ponieważ zużywają więcej tokenów: kalkulator OpenAI wycenia obraz 1024x1024 na około 0,025 USD na poziomie low i 0,043 USD na poziomie medium, w porównaniu do około 0,006 USD i 0,013 USD w GPT Image 2.5, podczas gdy poziomy high, xhigh i max kosztują tyle samo w obu wersjach. W przypadku dużej liczby wersji roboczych, które nie wymagają nowych funkcji, GPT Image 2.5 pozostaje tańszą opcją.
Tak. Ustaw format wyjściowy na SVG w punkcie końcowym generowania, a API GPT Image 2.6 zwróci statyczny plik wektorowy z edytowalnymi ścieżkami, kształtami i kolorami, odpowiedni dla logotypów, ikon i ilustracji. Każde żądanie SVG zwraca jeden obraz i nie obsługuje przesyłania strumieniowego ani punktu końcowego edycji. Model najpierw renderuje obraz referencyjny, a następnie zapisuje plik SVG, więc koszt obejmuje oba te kroki.
Złożoność (Complexity) kontroluje stopień, w jakim model planuje scenę przed renderowaniem, niezależnie od ustawienia jakości, które odpowiada za szczegółowość i wierność odwzorowania. Przyjmuje wartości low, medium lub high, a w przypadku pominięcia domyślnie przyjmuje wartość high. OpenAI zaleca low w przypadku większości zadań edycyjnych, takich jak zmiana tła lub znaku, oraz medium lub high w przypadku scen z gęstym tekstem, wieloma elementami lub ścisłymi ograniczeniami. Wyższa złożoność może wydłużyć czas oczekiwania i wprowadzić niepożądane modyfikacje, dlatego warto porównać rezultaty pod kątem konkretnego zadania.
Znacznik (markup) to przezroczysty plik PNG z okręgami, szkicami lub notatkami nałożony na pierwszy obraz wejściowy, wysyłany z promptem opisującym zmianę. Maska (mask) to obraz z kanałem alfa, który kieruje edycję na określony region, przy czym model może nie podążać dokładnie za jej kształtem. Tych dwóch elementów nie można łączyć w jednym żądaniu. Warstwa znaczników musi odpowiadać wymiarom pierwszego obrazu, a każdy z nich jest ograniczony do 16 777 216 pikseli, z limitem 50 MB dla pliku adnotacji.
OpenAI zauważa, że modele GPT Image mogą nadal mieć trudności z precyzyjnym rozmieszczaniem tekstu, z zachowaniem spójności powtarzających się postaci lub elementów marki w oddzielnych generacjach oraz z dokładnym umieszczaniem elementów w kompozycjach wrażliwych na układ. Przetwarzanie złożonych promptów może potrwać do dwóch minut. Przed dostarczeniem zasobu należy sprawdzić mały tekst i drobne szczegóły, a gdy spójność ma kluczowe znaczenie, używać narzędzia Sunburst z obrazami referencyjnymi.
Tak. Atlas Cloud udostępnia swoje modele, w tym GPT Image 2.5, za pomocą jednego klucza API z płatnościami zgodnie z rzeczywistym użyciem (pay-as-you-go), a GPT Image 2.6 Flare i Sunburst działają na tym samym koncie. Przełączanie między wersjami oznacza zmianę nazwy modelu w żądaniu, dzięki czemu można przygotować wersję roboczą na jednym modelu i ukończyć ją na innym bez konieczności używania nowych danych uwierzytelniających.
Poznaj Więcej Rodzin
Kling 4.0
Interfejs API Kling 4 udostępnia Kling 4.0, model wideo wydany przez Kuaishou 15 października 2026 r. Generuje do 30 sekund w jednym przebiegu, podąża za maksymalnie 10 klatkami kluczowymi, łączy 15 obrazów, filmów i obiektów za pośrednictwem Omni Reference oraz dodaje dźwięk stereo z synchronizacją ruchu warg. Atlas Cloud obsługuje wszystkie cztery punkty końcowe, w tym edycję wideo, za pomocą jednego klucza kompatybilnego z OpenAI w cenie od 0,11 USD za sekundę. Rozpocznij budowanie już dziś.

Seedance 2.5
API Seedance 2.5 udostępnia programistom wspólny model audio i wideo ByteDance Seed, generujący od 4 do 30 sekund w jednym przejściu na podstawie tekstu, pierwszej klatki lub do 50 odniesień z obrazów, wideo i audio. Edytuje wybrane obszary, wydłuża klipy i podąża za wejściami typu white-model oraz green-screen. Atlas Cloud, autoryzowany sprzedawca w USA, dodaje tryb roboczy 480p, natywne wersje końcowe 1080p oraz ulepszone dostarczanie 4K w modelu cenowym pay-as-you-go.
Wan 3.0
Wan 3.0 to najnowszy model wideo od Alibaba, generujący do 30 sekund wideo 1080p przy 30fps z dźwiękiem w jednym procesie generowania. Steruj nim za pomocą promptu tekstowego, pierwszej klatki, do 10 obrazów referencyjnych lub dokumentu. Wersja Standard kosztuje mniej za sekundę, podczas gdy Prime zachowuje te same możliwości i szybciej zwraca wyniki. Obie wersje działają na tym samym kluczu Atlas Cloud co Wan 2.7, 2.6 i 2.5.
GPT Image 2.6
Interfejs API GPT Image 2.6 udostępnia programistom model obrazu OpenAI wydany 4 listopada 2026 r. w dwóch wersjach: Flare do szybkiej iteracji i Sunburst do szczegółowej pracy wizualnej. Generuje obrazy o 50% szybciej niż poprzednio i dodaje obsługę animowanych plików GIF, eksport do SVG, edycję znaczników skierowaną na zakreślony obszar oraz ustawienie złożoności. Atlas Cloud obsługuje oba modele za pomocą jednego klucza zgodnego z OpenAI w modelu płatności za użycie.
MiniMax H3
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
GPT Image 2.5
GPT Image 2.5 to model OpenAI do generowania i edycji obrazów, wydany 8 września 2026 roku w dwóch wersjach API. Flare to wersja domyślna, charakteryzująca się o 50% niższą latencją niż GPT Image 2, podczas gdy Sunburst działa wolniej, aby zapewnić bardziej precyzyjną kontrolę nad szczegółowymi edycjami. Obie wersje obsługują do 16 obrazów referencyjnych, pięć poziomów jakości, przezroczyste tła oraz niestandardowe rozmiary do 3840px. Atlas Cloud udostępnia API GPT Image 2.5 według stawek za token OpenAI lub w cenie stałej za obraz w podziale na poziomy 1K, 2K lub 4K.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling V3.0
Rodzina API Kling V3 firmy Kuaishou obsługuje przepływy pracy z tekstem, obrazami i wideo referencyjnym. Przenoś ruch, zachowując tożsamość postaci, kieruj generowaniem za pomocą odniesień wizualnych i edytuj filmy poleceniami w języku naturalnym. Atlas Cloud oferuje endpointy Standard i Pro dostosowane do różnych potrzeb produkcyjnych. Aktualizacja: Kling V4 jest już dostępny w Atlas Cloud. Poznaj go na stronie [Kling V4](https://www.atlascloud.ai/zh/models/kling-v4).
Grok Imagine Video
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 Preview
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.


